
基于模糊C均值的聚类分析
4.8339e+006 4.8339e+006 4.8339e+006 4.8339e+006 4.8339e+006 4.8339e+006 4.8339e+006 4.8339e+006 4.8339e+006
4.8339e+006 4.8339e+006 4.8339e+006 4.8339e+006 4.8339e+006
0.029278
• Columns 25 through 30
0.068372 0.026621 0.96861 0.96367 0.98434 0.006666 0.036258 0.03739 0.0060731 0.0085095 0.0033354 0.0069366 0.14864 0.86903 0.0092717 0.011597 0.0048348 0.95254 0.74673 0.066961 0.016046 0.016226 0.007487 0.033862
此时,目标函数在 4.8339e+006 处收敛, 算法结速
由得出的聚类中心矩阵及隶属度矩阵就 可以进行分类了:聚类中心矩阵有4行, 每一行代表一类及四类,3列,每一列代 表一种颜色;由隶属度矩阵中Columns 1 through 6为例:
0.033201 0.97007 0.029789 0.056082 0.92626 0.071666 0.029521 0.0058525 0.047123 0.020886 0.017596 0.020368 0.64897 0.0088617 0.84987 0.11948 0.023937 0.076162 0.28831 0.015217 0.073223 0.80355 0.032208 0.8318
(2)
这里 , =1,⋯ ,n,是等式的n个约束 式的拉格朗日乘子。对所有输入参量求 导,使式(1)达到最小的必要条件为:
(3)
(4 )
由上述两个必要条件,模糊c均值聚类算 法是一个简单的迭代过程。在批处理方 式运行时,FCM采用下列步骤确定聚类中 心 和隶属矩阵 U: 步骤1 用值在0,1间的随机数初始 化隶属矩阵 U ,使其满足式 (2) 中的约束 条件。 步骤2 用式(3)计算c个聚类中心 , i=1,⋯ ,c。
• end
• • • • •
expo = options(1);%u矩阵指数 max_iter = options(2);%迭代最大次数 min_impro = options(3);%改进的最小值 display = options(4); obj_fcn = zeros(max_iter, 1);%目标函 数的建立 • U = initfcm(cluster_n, data_n); %初始 化模糊分割矩阵
得出聚类中心及隶属度矩阵:
• CENTER2 = 314.72 3194.7 2330.5 3250 1748.8 1733.2 1211.8 1879
2283.5 958.33 1927.7 2821.1
• U2 = • Columns 1 through 6
0.033201 0.97007 0.029789 0.056082 0.92626 0.071666
0.018067 0.01343 0.91889 0.016791 0.047375 0.026058
• Columns 13 through 18
0.95896
0.010641 0.012668 0.017729
0.024654
0.03003
0.014714
0.026868
0.015067
0.91928 0.90032 0.0081124 0.029539 0.94815 0.035832 0.045317 0.061914 0.80249 0.02370 0.020235 0.024333 0.91526 0.1411 0.013072
%以下为主循环: • for i = 1:max_iter, • [U, center, obj_fcn(i)] = stepfcm(data, U, cluster_n, expo); • if display, • fprintf('Iteration count = %d, obj. fcn = %f\n', i, obj_fcn(i)); • end %检查终止情况:
基于模糊C均值的聚类分析
1 模糊c均值聚类(FCM)方法
模糊 C 均值聚类 (FCM) 方法是一种在已 知聚类数的情况下,利用隶属度函数和迭 代算法将有限的数据集分别聚类的方法。 其目标函数为:
式中, 为样本数; 为聚类数; 为第 个 样本相对于第 个聚类中心的隶属度; 为
第 个类别的聚类中心; 为样本到聚类 中心的欧式距离。聚类的结果使目标函 数 最小,因此,构造如下新的目标函 数:
• Columns 37 through 39
0.022453 0.97193 0.048398 0.022367 0.0061355 0.028522 0.80825 0.0083348 0.23214 0.14693 0.013595 0.69094
• OBJ_FCN2 =
1.9285e+007 1.352e+007 8.2142e+006 5.4477e+006 4.9316e+006 4.85e+006 4.8367e+006 4.8344e+006 4.834e+006
0.029521 0.0058525 0.047123 0.020886 0.017596 0.020368 0.64897 0.0088617 0.84987 0.11948 0.023937 0.076162 0.28831 0.015217 0.073223 0.80355 0.032208 0.8318
先看上述矩阵的第一列,从中找出最大 值是0.64897 ,在第三行,由最大隶属 度原则可得:样本1属于第三类,以此类
2949.16 1692.62 1680.67 2802.88 172.78 2063.54 1449.58 1651.52 341.59 291.02
3244.44 1867.5 1575.78 3017.11 3084.49 3199.76 1641.58 1713.28 3076.62 309 if abs(obj_fcn(i) - obj_fcn(i-1)) < min_impro, break; end, • end • end • iter_n = i;% • obj_fcn(iter_n+1:max_iter) = [];
调用上述程序建立起来的模糊聚 类函数,得到以下运行程序:
1571.17 104.8 499.85 2297.28 2092.62 1418.79 1845.59 2205.36
1731.04 3389.83 3305.75 3340.14 3177.21 1775.89 1918.81 3243.74
1735.33; 2421.83; 2196.22; 535.62; 584.32; 2772.9; 2226.49; 1202.69;
• • • • • •
tmp = default_options; tmp(1:length(options)) = options; options = tmp; end nan_index = find(isnan(options)==1); options(nan_index) = default_options(nan_index); • if options(1) <= 1, • error('The exponent should be greater than 1!'); • end
• Columns 7 through 12
0.01486
0.015919 0.88683 0.082394
0.070257
0.97808
0.931
0.017272 0.020349 0.031376
0.015668
0.94372
0.54463 0.0055741 0.2854 0.0068329 0.099713 0.009517
662.42; 2108.97; 1725.1; 1984.98; 2328.65; 1257.21; 3405.12; 1570.38; 2438.63; 2088.95;
237.63 3077.78 2251.96; 1702.8 1639.79 2068.74; 1877.93 1860.96 1975.3; 867.81 2334.68 2535.1; 1831.49 1713.11 1604.68; 460.69 3274.77 2172.99; 2374.98 3346.98 975.31; 2271.89 3482.97 946.7; 1783.64 1597.99 2261.31; 198.83 3250.45 2445.08; 1494.63 2072.59 2550.51]; [CENTER2, U2, OBJ_FCN2]=FCM(A,4)
步骤3 根据式(1)计算目标函数。 如果它小于某个确定的阈值,或它相对 上次价值函数值的改变量小于某个阈值, 则算法停止。 步骤4 用式(4)计算新的U阵。近回 步骤2。 当算法收敛时,就得到了各类的聚 类中心和各个样本对于各类的隶属度值, 从而完成了模糊聚类划分。
上述算法中,由于引入 的归一化 条件,在样本集不理想的情况下可能导 致结果不好。比如,如果某个野值样本 远离各类的聚类中心,本来它严格属于 各类的隶属度都很小,但由于归一化条 件的限制,将会使它对各类都有较大的 隶属度(比如两类情况下各类的隶属度都 是0.5),这种野值的存在将影响迭代的 最终结果。
基于模糊C均值聚类与相关性分析的长三角城市群演化探析
收 稿 日期 :0 8— 9— 3 2 0 0 2
基金项 目: 国家发改 委专项课题“ 基于要素流动和产业转 移的区域 协调发展 内生机制研究” 作者简介 : 陈建军 (9 5一) 男 , 15 , 浙江杭州人 , 浙江大学公共管理学院 、 浙江大学区域 与城市 发展研究 中心 主任, 教授 , 博士生导师 , 主要从事产业经济 、 区域经济 、 城市经 济、 国民经济研究 。
分析 的方 法 , 构建 反 映城 市化发展 的综合 指标 体 系 , 长三 角 l 对 6个城 市在 不 同阶段 的发展 状 况进 行 比较 , 发
现 长三 角城 市群 演化是 伴 随地 区城 市化 水平提 高 , 集聚 势 能的扩散 按 照城 市等级 由 高到低 , 着点一 轴一 面 沿 路 径 , 过 中心一 外 围的 空 间结 构不 断复 制来 实现 的 。研 究表 明 : 三 角一体化 的 形成 是整 体城 市化 水 平发 通 长
展 到一 定阶段 , 市群 空 间体 系以及城 市功能 互动 和演 化 的结果 ; 城 是整 个 区域 系统 由低 水平 的均 质 空间 向 高
水平的 一体化 方 向均衡 发展 的 必然趋 势 。为政 策制 定 者采取 有 效途径 解 决 区域 协调 发展 提供 科 学依 据 。
关键 词 : 糊 C均值 聚类 ; 关性分析 ; 市群 ; 体化 模 相 城 一
陈建军 葛宝琴 ,
( 浙江大学 & 公共管理 学院 ..经济学院 , 江 杭州 b 浙 302 ) 10 7
摘要 : 长三 角经 济的发展 历 程 实 际上 也是 以城 市群 体 系不 断演化 的 过程 。过 去对 长 三 角城 市群 的研 究 大 多
停 留在 对功 能 、 征 的描 述 , 其 空间 结构 演 化 的机 理 缺 乏 理论 分 析 。 文章 采 用模 糊 c均值 聚 类 与 相 关性 特 对
关于模糊c均值聚类算法
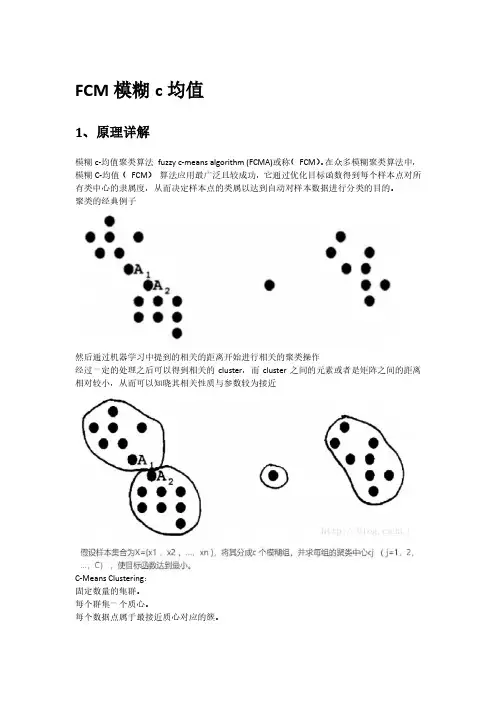
FCM模糊c均值1、原理详解模糊c-均值聚类算法fuzzy c-means algorithm (FCMA)或称(FCM)。
在众多模糊聚类算法中,模糊C-均值(FCM)算法应用最广泛且较成功,它通过优化目标函数得到每个样本点对所有类中心的隶属度,从而决定样本点的类属以达到自动对样本数据进行分类的目的。
聚类的经典例子然后通过机器学习中提到的相关的距离开始进行相关的聚类操作经过一定的处理之后可以得到相关的cluster,而cluster之间的元素或者是矩阵之间的距离相对较小,从而可以知晓其相关性质与参数较为接近C-Means Clustering:固定数量的集群。
每个群集一个质心。
每个数据点属于最接近质心对应的簇。
1.1关于FCM的流程解说其经典状态下的流程图如下所示集群是模糊集合。
一个点的隶属度可以是0到1之间的任何数字。
一个点的所有度数之和必须加起来为1。
1.2关于k均值与模糊c均值的区别k均值聚类:一种硬聚类算法,隶属度只有两个取值0或1,提出的基本根据是“类内误差平方和最小化”准则,进行相关的必要调整优先进行优化看是经典的欧拉距离,同样可以理解成通过对于cluster的类的内部的误差求解误差的平方和来决定是否完成相关的聚类操作;模糊的c均值聚类算法:一种模糊聚类算法,是k均值聚类算法的推广形式,隶属度取值为[0 1]区间内的任何数,提出的基本根据是“类内加权误差平方和最小化”准则;这两个方法都是迭代求取最终的聚类划分,即聚类中心与隶属度值。
两者都不能保证找到问题的最优解,都有可能收敛到局部极值,模糊c均值甚至可能是鞍点。
1.2.1关于kmeans详解K-means算法是硬聚类算法,是典型的基于原型的目标函数聚类方法的代表,它是数据点到原型的某种距离作为优化的目标函数,利用函数求极值的方法得到迭代运算的调整规则。
K-means算法以欧式距离作为相似度测度,它是求对应某一初始聚类中心向量V最优分类,使得评价指标J最小。
基于模糊C-均值聚类算法的刀具磨损预测
x2 , …, xn } , 首先, 设有样本集为 X = { x1 , 每个样本为 r 维向 x i2 , …, x ir } · 然后引入 C 个不同的 “类 ” 量, 有 x i = { x i1 , 这个 让每一个样本与各个 C 之间都产生映射关系,最后用 概念, — —隶属度( μ ij ) 来描述映射的数值关系即, 一个概念— 第i个 用以下约束条件来描述隶属度: 样本对第 j 个类的隶属度, [ 0 , 1 ] ( 1) μ ij ∈
模糊 C 均值聚类算法的迭代流程如下: 步骤 1. 求各个隶属度, 构成隶属度矩阵; 步骤 2. 用式 5 - 5 计算聚类中心; 步骤 3. 用式 5 - 4 计算目标函数, 若小于确定的最小阈 算法停止; 值时, 步骤 4. 计算新的 U 矩阵, 返回步骤 2 。 ( 二) 模糊集合贴近度理论。 贴近度是指两个模糊集接 近的程度, 在于贴近度的计算方式, 贴近度通常包括: 海明 测量贴近度、 欧几里得贴近度以及格贴近度等, 其中 贴近度、 以欧几里得贴近度的应用最为广泛, 定义如下: u2 , …, un } 则 若 U = { u1 ,
c i =1 n j =1
∑ μ ij = 1 n) ∑ μ ij ∈( 0 ,
( 2) ( 3)
对目标函数则采用总体组内误差平方和, 其定义如下: m 2 J( U, V) = ∑∑( μ IJ ) ( d ij ) ( 4) U 为原始隶属度矩阵; m∈( 1 , + ∞ ) 为权重指数 V 式中, = ( v1 , v2 , …, v n ) T ; d ij 为样本去中心矢量距离, 定义 d ij x j - x j 为第 j 个样本, v i 为第 i 类聚类中心矢量, v i , 定义为: vi =
模糊c均值聚类算法

模糊c均值聚类算法C均值聚类算法(C-Means Clustering Algorithm)是一种常用的聚类算法,目的是将一组数据点分成若干个类群,使得同一类群内的数据点尽可能相似,不同类群之间的数据点尽可能不相似。
与K均值聚类算法相比,C均值聚类算法允许一个数据点属于多个类群。
C均值聚类算法的基本思想是随机选择一组初始聚类中心,然后通过迭代的方式将数据点分配到不同的类群,并调整聚类中心,直到满足停止条件。
算法的停止条件可以是固定的迭代次数,或者是聚类中心不再改变。
具体而言,C均值聚类算法的步骤如下:1.随机选择k个初始聚类中心,其中k是预先设定的类群数量。
2.根据欧氏距离或其他距离度量方法,计算每个数据点到每个聚类中心的距离。
3.将每个数据点分配到距离最近的聚类中心的类群。
4.根据聚类中心的分配情况,更新聚类中心的位置。
如果一个数据点属于多个类群,则根据各个类群的权重计算新的聚类中心位置。
5.重复步骤2到4,直到满足停止条件。
C均值聚类算法的优点是灵活性高,可以允许一个数据点属于多个类群。
这在一些应用场景中非常有用,例如一个商品可以属于多个类别。
然而,C均值聚类算法的缺点是计算复杂度较高,对初始聚类中心的选择敏感,以及类群数量k的确定比较困难。
为了解决C均值聚类算法的缺点,可以采用如下方法进行改进:1.使用聚类效度指标来评估聚类结果的好坏,并选择最优的聚类中心数量k。
2. 采用加速算法来减少计算复杂度,例如K-means++算法可以选择初始聚类中心,避免随机选择的可能不理想的情况。
3.对数据进行预处理,例如归一化或标准化,可以提高算法的收敛速度和聚类质量。
4.针对特定应用场景的需求,可以根据数据属性来调整聚类中心的权重计算方式,以适应特定的业务需求。
总结起来,C均值聚类算法是一种常用的聚类算法,与K均值聚类算法相比,它可以允许一个数据点属于多个类群。
然而,C均值聚类算法也存在一些缺点,例如计算复杂度高,对初始聚类中心的选择敏感等。
在Matlab中使用模糊C均值聚类进行图像分析的技巧

在Matlab中使用模糊C均值聚类进行图像分析的技巧在图像分析领域,模糊C均值聚类(FCM)是一种常用的工具,它可以帮助我们发现图像中隐藏的信息和模式。
通过使用Matlab中的模糊逻辑工具箱,我们可以轻松地实现FCM算法,并进行图像分析。
本文将介绍在Matlab中使用FCM进行图像分析的技巧。
首先,让我们简要了解一下FCM算法。
FCM是一种基于聚类的图像分割方法,它将图像的像素分为不同的聚类,每个聚类代表一类像素。
与传统的C均值聚类算法不同,FCM允许像素属于多个聚类,因此能够更好地处理图像中的模糊边界。
在Matlab中使用FCM进行图像分析的第一步是加载图像。
可以使用imread函数将图像加载到Matlab的工作区中。
例如,我们可以加载一张名为“image.jpg”的图像:```matlabimage = imread('image.jpg');```加载图像后,可以使用imshow函数显示图像。
这可以帮助我们对图像有一个直观的了解:```matlabimshow(image);```接下来,我们需要将图像转换为灰度图像。
这是因为FCM算法通常用于灰度图像分析。
可以使用rgb2gray函数将彩色图像转换为灰度图像:```matlabgrayImage = rgb2gray(image);```在使用FCM算法之前,我们需要对图像进行预处理。
预处理的目的是消除图像中的噪声和不必要的细节,从而更好地提取图像中的特征。
常用的图像预处理方法包括平滑、锐化和边缘检测等。
Matlab中提供了许多图像预处理函数。
例如,可以使用imnoise函数向图像中添加高斯噪声:```matlabnoisyImage = imnoise(grayImage, 'gaussian', 0, 0.01);```还可以使用imfilter函数对图像进行平滑处理。
常见的平滑方法包括均值滤波和高斯滤波:```matlabsmoothImage = imfilter(noisyImage, fspecial('average', 3));```一旦完成预处理步骤,我们就可以使用模糊逻辑工具箱中的fcm函数执行FCM算法。
模糊C均值聚类算法的C++实现代码
算法描述 模糊 C 均值聚类算法的步骤还是比较简单的,模糊 C 均值聚类(FCM),即众
所周知的模糊 ISODATA,是用隶属度确定每个数据点属于某个聚类的程度的一种 聚类算法。1973 年,Bezdek 提出了该算法,作为早期硬 C 均值聚类(HCM)方法 的一种改进。
研究背景
模糊 C 均值聚类算法的实现
聚类分析是多元统计分析的一种,也是无监督模式识别的一个重要分支,在 模式分类 图像处理和模糊规则处理等众多领域中获得最广泛的应用。它把一个 没有类别标记的样本按照某种准则划分为若干子集,使相似的样本尽可能归于一 类,而把不相似的样本划分到不同的类中。硬聚类把每个待识别的对象严格的划 分某类中,具有非此即彼的性质,而模糊聚类建立了样本对类别的不确定描述, 更能客观的反应客观世界,从而成为聚类分析的主流。
FCM 把 n 个向量 xi(i=1,2,…,n)分为 c 个模糊组,并求每组的聚类中心, 使得非相似性指标的价值函数达到最小。FCM 与 HCM 的主要区别在于 FCM 用模糊 划分,使得每个给定数据点用值在 0,1 间的隶属度来确定其属于各个组的程度。 与引入模糊划分相适应,隶属矩阵 U 允许有取值在 0,1 间的元素。不过,加上 归一化规定,一个数据集的隶属度的和总等于 1:
c
uij 1,j 1,..., n
i 1
(6.9)
那么,FCM 的价值函数(或目标函数)就是式(6.2)的一般化形式:
c
cn
J (U , c1,..., cc ) Ji
u
m ij
d
2 ij
模糊聚类算法的原理和实现方法
模糊聚类算法的原理和实现方法模糊聚类算法是一种数据分类和聚类方法,它在实际问题中有着广泛的应用。
本文将介绍模糊聚类算法的原理和实现方法,包括模糊C均值(FCM)算法和模糊神经网络(FNN)算法。
一、模糊聚类算法的原理模糊聚类算法是基于模糊理论的一种聚类方法,它的原理是通过对数据进行模糊分割,将每个数据点对应到多个聚类中心上,从而得到每个数据点属于各个聚类的置信度。
模糊聚类算法的原理可以用数学公式进行描述。
设有n个数据样本点X={x1, x2, ..., xn},以及m个聚类中心V={v1, v2, ..., vm}。
对于每个数据样本点xi,令uij为其属于第j个聚类中心的置信度,其中j=1,2,..., m,满足0≤uij≤1,且∑uij=1。
根据模糊理论,uij的取值表示了xi属于第j个聚类中心的隶属度。
为了达到聚类的目的,我们需要对聚类中心进行调整,使得目标函数最小化。
目标函数的定义如下:J = ∑∑(uij)^m * d(xi,vj)^2其中,m为模糊度参数,d(xi,vj)为数据点xi与聚类中心vj之间的距离,常用的距离度量方法有欧氏距离和曼哈顿距离。
通过不断调整聚类中心的位置,最小化目标函数J,即可得到模糊聚类的结果。
二、模糊C均值(FCM)算法的实现方法模糊C均值算法是模糊聚类算法中最经典的一种方法。
其具体实现过程如下:1. 初始化聚类中心:随机选取m个数据点作为初始聚类中心。
2. 计算隶属度矩阵:根据当前聚类中心,计算每个数据点属于各个聚类中心的隶属度。
3. 更新聚类中心:根据隶属度矩阵,更新聚类中心的位置。
4. 判断是否收敛:判断聚类中心的变化是否小于设定的阈值,如果是则停止迭代,否则返回第2步。
5. 输出聚类结果:将每个数据点分配到最终确定的聚类中心,得到最终的聚类结果。
三、模糊神经网络(FNN)算法的实现方法模糊神经网络算法是一种基于模糊理论和神经网络的聚类方法。
其实现过程和传统的神经网络类似,主要包括以下几个步骤:1. 网络结构设计:确定模糊神经网络的层数和每层神经元的个数。
matlab模糊c均值聚类算法
matlab模糊c均值聚类算法模糊C均值聚类算法是一种广泛应用于数据挖掘、图像分割等领域的聚类算法。
相比于传统的C均值聚类算法,模糊C均值聚类算法能够更好地处理噪声数据和模糊边界。
模糊C均值聚类算法的基本思想是将样本集合分为K个聚类集合,使得每个样本点属于某个聚类集合的概率最大。
同时,每个聚类集合的中心点被计算为该聚类集合中所有样本的均值。
具体实现中,模糊C均值聚类算法引入了模糊化权重向量来描述每个样本点属于各个聚类集合的程度。
这些权重值在每次迭代中被更新,直至达到预设的收敛精度为止。
模糊C均值聚类算法的目标函数可以表示为:J = ∑i∑j(wij)q||xi-cj||2其中,xi表示样本集合中的第i个样本,cj表示第j个聚类集合的中心点,wij表示第i个样本点属于第j个聚类集合的权重,q是模糊指数,通常取2。
不同于C均值聚类算法,模糊C均值聚类算法对每个样本点都考虑了其属于某个聚类集合的概率,因此能够更好地处理模糊边界和噪声数据。
同时,模糊C均值聚类算法可以自适应地确定聚类的数量,从而避免了事先设定聚类数量所带来的限制。
在MATLAB中,可以使用fcm函数实现模糊C均值聚类算法。
具体来说,fcm函数的使用方法如下:[idx,center] = fcm(data,k,[options]);其中,data表示样本矩阵,k表示聚类数量,options是一个包含算法参数的结构体。
fcm函数的输出包括聚类标签idx和聚类中心center。
MATLAB中的fcm函数还提供了其他参数和选项,例如模糊权重阈值、最大迭代次数和收敛精度等。
可以根据具体应用需求来设置这些参数和选项。
利用模糊C-均值聚类分析法实现织物组织结构自动识别
找 出经 纬交叉 区 , 后提 取 图像 特 征 并 分 别将 它 然 们归 入经 浮点 集 和纬 浮点 集 。模 糊 C一均 值 聚类
分析 法可 以 提 取 每 一 个 经 纬 交 叉 区 的 4种 特 征 值 , 括 均 值 、 准 差 等 适 用 于 各 种 织 物 的 特 征 包 标 值 。该 聚类法适 应 于 非监督 分类 识 别相似 的样 本 对象 , 外 , 糊 C一均值 聚 类法 能 产 生较 好 的 聚 此 模 类结 果 。本文 提 供 了一种 可 以 自动 识别织 物 组织
不 同原 料 或 不 同组 织 的织 物 , 它们 的织 物组
织 图像 都是 由 2种基 本 结 构 组 成 , 即经 浮 点 和 纬
收 稿 日期 :05 6 0 20 —0 —2
类 分 析法 通过 对样 本 进行 归类来 判 断样 本集 模 式 之 间的关 系 。从 而 使 相 似 的样 本 属 于 一类 , 不 而 相 似 的样本 属 于不 同类 。由于这 里 的样 本是 实 数
督学 习 的 自动 识别 法 。 1 模糊 C一均值聚 类分 析 法 11 特点 .
法对 经 纬浮点 结 构特 征分类 以实现 织 物组织 结 构
的 自动识 别 。
12 原 理 .
在图像分割、 模式识别和向量量化等许 多领
域, 聚类 过程 是 这 些 问题 中不 可 或 缺 的 步骤 。 聚
2 0 年 第 4期 06
名d , 删 :
C是聚类 数, 01 , u ∈[ ] 表示样本 x 对第 i j 个模糊集的从属度 , l埘 — d = l 是第 i 个聚
模糊C均值聚类算法的C 实现代码讲解
模糊C均值聚类算法的实现研究背景模糊聚类分析算法大致可分为三类1)分类数不定,根据不同要求对事物进行动态聚类,此类方法是基于模糊等价矩阵聚类的,称为模糊等价矩阵动态聚类分析法。
2)分类数给定,寻找出对事物的最佳分析方案,此类方法是基于目标函数聚类的,称为模糊C均值聚类。
3)在摄动有意义的情况下,根据模糊相似矩阵聚类,此类方法称为基于摄动的模糊聚类分析法聚类分析是多元统计分析的一种,也是无监督模式识别的一个重要分支,在模式分类图像处理和模糊规则处理等众多领域中获得最广泛的应用。
它把一个没有类别标记的样本按照某种准则划分为若干子集,使相似的样本尽可能归于一类,而把不相似的样本划分到不同的类中。
硬聚类把每个待识别的对象严格的划分某类中,具有非此即彼的性质,而模糊聚类建立了样本对类别的不确定描述,更能客观的反应客观世界,从而成为聚类分析的主流。
模糊聚类算法是一种基于函数最优方法的聚类算法,使用微积分计算技术求最优代价函数,在基于概率算法的聚类方法中将使用概率密度函数,为此要假定合适的模型,模糊聚类算法的向量可以同时属于多个聚类,从而摆脱上述问题。
我所学习的是模糊C均值聚类算法,要学习模糊C均值聚类算法要先了解虑属度的含义,隶属度函数是表示一个对象x隶属于集合A的程度的函数,通常记做μA(x),其自变量范围是所有可能属于集合A的对象(即集合A所在空间中的所有点),取值范围是[0,1],即0<=μA (x)<=1。
μA(x)=1表示x完全隶属于集合A,相当于传统集合概念上的x∈A。
一个定义在空间X={x}上的隶属度函数就定义了一个模糊集合A,或者叫定义在论域X={x}上的模糊子集~A。
对于有限个对象x1,x2,……,xn模糊集合~A可以表示为:}|)),({(~XxxxAiiiA∈=μ (6.1)有了模糊集合的概念,一个元素隶属于模糊集合就不是硬性的了,在聚类的问题中,可以把聚类生成的簇看成模糊集合,因此,每个样本点隶属于簇的隶属度就是[0,1]区间里面的值。