
常用正则表达式
匹配中文字符的正则表达式: [\u4e00-\u9fa5]
评注:匹配中文还真是个头疼的事,有了这个表达式就好办了
匹配双字节字符(包括汉字在内):[^\x00-\xff]
评注:可以用来计算字符串的长度(一个双字节字符长度计2,ASCII字符计1)
匹配空白行的正则表达式:\n\s*\r
评注:可以用来删除空白行
匹配HTML标记的正则表达式:< (\S*)[^>]*>.*|< .* />
评注:网上流传的版本太糟糕,上面这个也仅仅能匹配部分,对于复杂的嵌套标记依旧无能为力
匹配首尾空白字符的正则表达式:^\s*|\s*$
评注:可以用来删除行首行尾的空白字符(包括空格、制表符、换页符等等),非常有用的表达式
匹配Email地址的正则表达式:\w+([-+.]\w+)*@\w+([-.]\w+)*\.\w+([-.]\w+)*
评注:表单验证时很实用
匹配网址URL的正则表达式:[a-zA-z]+:d+\.\d+\.\d+
评注:提取ip地址时有用
匹配特定数字:
^[1-9]\d*$ d*|0\.\d*[1-9]\d*$ d*|0\.\d*[1-9]\d*)$ d*|0\.\d*[1-9]\d*|0\.0+|0) $ d*|0\.\d*[1-9]\d*|0\.0+|0$ d*|0\.\d*[1-9]\d*))|0\.0+|0$ //匹配非正浮点数(负浮点数 + 0)
评注:处理大量数据时有用,具体应用时注意修正
匹配特定字符串:
^[A-Za-z]+$ //匹配由26个英文字母组成的字符串
^[A-Z]+$ //匹配由26个英文字母的大写组成的字符串
^[a-z]+$ //匹配由26个英文字母的小写组成的字符串
^[A-Za-z0-9]+$ //匹配由数字和26个英文字母组成的字符串
^\w+$ //匹配由数字、26个英文字母或者下划线组成的字符串。
常用正则表达式语法大全
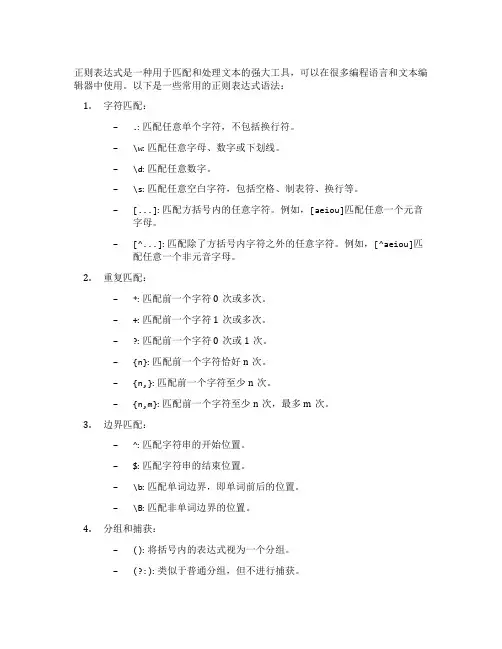
正则表达式是一种用于匹配和处理文本的强大工具,可以在很多编程语言和文本编辑器中使用。
以下是一些常用的正则表达式语法:1.字符匹配:–.: 匹配任意单个字符,不包括换行符。
–\w: 匹配任意字母、数字或下划线。
–\d: 匹配任意数字。
–\s: 匹配任意空白字符,包括空格、制表符、换行等。
–[...]: 匹配方括号内的任意字符。
例如,[aeiou]匹配任意一个元音字母。
–[^...]: 匹配除了方括号内字符之外的任意字符。
例如,[^aeiou]匹配任意一个非元音字母。
2.重复匹配:–*: 匹配前一个字符0次或多次。
–+: 匹配前一个字符1次或多次。
–: 匹配前一个字符0次或1次。
–{n}: 匹配前一个字符恰好n次。
–{n,}: 匹配前一个字符至少n次。
–{n,m}: 匹配前一个字符至少n次,最多m次。
3.边界匹配:–^: 匹配字符串的开始位置。
–$: 匹配字符串的结束位置。
–\b: 匹配单词边界,即单词前后的位置。
–\B: 匹配非单词边界的位置。
4.分组和捕获:–(): 将括号内的表达式视为一个分组。
–(?:): 类似于普通分组,但不进行捕获。
–\n: 反向引用,引用第n个分组的内容。
5.特殊字符转义:–\: 转义字符,用于匹配特殊字符本身。
6.修饰符:–i: 忽略大小写。
–g: 全局匹配,不仅匹配第一个结果。
–m: 多行匹配,使^和$匹配每一行的开始和结束。
这里列举了一些常用的正则表达式语法,但实际使用中,还有更多复杂的语法和特性,可以根据具体需求查阅更详细的正则表达式文档和教程。
不同编程语言和文本编辑器对正则表达式的支持也有所不同,所以在实际应用中需要根据具体的环境进行调整。
常用的正则表达式代码汇总

常⽤的正则表达式代码汇总常⽤的正则表达式代码汇总常⽤的正则表达式代码汇总:1。
^\d+$ //匹配⾮负整数(正整数 + 0)2。
^[0-9]*[1-9][0-9]*$ //匹配正整数3。
^((-\d+)|(0+))$ //匹配⾮正整数(负整数 + 0)4。
^-[0-9]*[1-9][0-9]*$ //匹配负整数5。
^-?\d+$ //匹配整数6。
^\d+(\.\d+)?$ //匹配⾮负浮点数(正浮点数 + 0)7。
^(([0-9]+\.[0-9]*[1-9][0-9]*)|([0-9]*[1-9][0-9]*\.[0-9]+)|([0-9]*[1-9][0-9]*))$ //匹配正浮点数8。
^((-\d+(\.\d+)?)|(0+(\.0+)?))$ //匹配⾮正浮点数(负浮点数 + 0)9。
^(-(([0-9]+\.[0-9]*[1-9][0-9]*)|([0-9]*[1-9][0-9]*\.[0-9]+)|([0-9]*[1-9][0-9]*)))$ //匹配负浮点数10。
^(-?\d+)(\.\d+)?$ //匹配浮点数11。
^[A-Za-z]+$ //匹配由26个英⽂字母组成的字符串12。
^[A-Z]+$ //匹配由26个英⽂字母的⼤写组成的字符串13。
^[a-z]+$ //匹配由26个英⽂字母的⼩写组成的字符串14。
^[A-Za-z0-9]+$ //匹配由数字和26个英⽂字母组成的字符串15。
^\w+$ //匹配由数字、26个英⽂字母或者下划线组成的字符串16。
^[\w-]+(\.[\w-]+)*@[\w-]+(\.[\w-]+)+$ //匹配email地址17。
^[a-zA-z]+://匹配(\w+(-\w+)*)(\.(\w+(-\w+)*))*(\?\S*)?$ //匹配url18。
匹配中⽂字符的正则表达式: [\u4e00-\u9fa5]19。
匹配双字节字符(包括汉字在内):[^\x00-\xff]20。
正则表达式书写规则

正则表达式书写规则正则表达式(Regular Expression)是一种用来匹配、查找和替换文本的工具。
它使用一种特殊的语法规则来描述一系列字符的模式,从而实现对文本的高效处理。
在本文中,我们将介绍一些常用的正则表达式规则及其应用。
1. 匹配数字:使用\d来匹配任意一个数字,例如\d可以匹配到"1"、"2"、"3"等。
2. 匹配字母:使用[a-zA-Z]来匹配任意一个字母,其中a-z表示小写字母,A-Z表示大写字母。
3. 匹配任意字符:使用.来匹配任意一个字符,例如使用 a.b可以匹配到"a1b"、"a@b"、"a_b"等。
4. 匹配多个字符:使用*来匹配前面的字符出现0次或多次,例如ab*可以匹配到"a"、"ab"、"abb"等。
5. 匹配至少一个字符:使用+来匹配前面的字符出现至少一次,例如ab+可以匹配到"ab"、"abb"、"abbb"等。
6. 匹配特定次数的字符:使用{n}来匹配前面的字符出现n次,例如a{3}可以匹配到"aaa"。
7. 匹配特定范围的字符:使用[a-z]来匹配指定范围内的字符,例如[a-zA-Z]可以匹配任意一个字母。
8. 匹配空白字符:使用\s来匹配任意一个空白字符,例如\s可以匹配到空格、制表符、换行符等。
9. 匹配非空白字符:使用\S来匹配任意一个非空白字符,例如\S 可以匹配到字母、数字、符号等。
10. 匹配单词边界:使用\b来匹配单词的边界,例如\btest\b可以匹配到"test",但不能匹配到"atestb"。
11. 匹配开头和结尾:使用^来匹配字符串的开头,使用$来匹配字符串的结尾,例如^abc$可以匹配到"abc",但不能匹配到"abcd"。
正则表达式150种表达方式

正则表达式150种表达方式1、删除所有数字。
只要查找:\d就OK。
为了不留空行:替换处:\d2、删除所有英文字母。
只要查找:\a就OK。
为了不留空行:替换处:\d3、删除除换行符以外的所有。
只要查找:. 为了不留空行:替换处:\d4、既删除英文字母又删除数字。
只要查找:\w。
为了不留空行:替换处:\d5、删除数字加字母加等于(如:3a=或3zz=)只要查找:\d+\a+\=。
为了不留空行:替换处:\d6、删除换行。
只要查找:$。
替换处:\d(还原查找:\a+=\f。
替换:\0\n)。
如在换行后加一空格,查找:(\a)$。
替换:\0 \d。
7、删除空行只要查找:^$。
为了不留空行:替换处:\d8、删除首尾空格。
只要查找:^\s*|\s*$就OK9、删除行前数字及顿号。
只要查找:\d+、替换为空10、删除末尾标点符号。
只要查找:\P+$|\P+\s+$,“|”前面是没有空格的,“|”后面有空格,P后的加是为了……而用的。
11、删除末尾空格。
只要查找:\s+$。
替换为空。
12、删除第一个字如:“的我们”中的“的”只要查找:^\的。
13、删除第几个字。
查找:查找:^().(.+)。
替换:\1\2。
去掉前面的拼音:查找:^\a+替换为空。
第一个括号里可加“.”且可变。
14、删含的。
查:.*的.*替:\d。
的头查:.*=的.*替:\d。
的尾查:\a.*\c.*的$替:\d(留它不匹配)●删非的行查:^[^的]+$替:\d15、删除几码以上的码查:^(...)...替:\1。
删第几位码。
查:^(...).(.+)替:\1\2(变成\1,\2则其位则改成,了)首括号的.可变。
16、删除各类型的几字词,但必须是码前词后或纯词。
三字词:查找:^\~f{}\f{3}$替换:\d。
替换:\d “3”可以改。
17、删除11字词及其以上的词条查找(自定义格式):\a{}\=(\c|\P|\p){11,}。
替换:\d。
11可改。
正则表达式公式大全

正则表达式公式大全正则表达式是一种处理字符串的强大工具,它可以帮助我们快速、高效地匹配、替换、删除、提取字符串。
很多编程语言,包括Python、Java、JavaScript等都支持正则表达式,所以掌握正则表达式是非常重要的。
下面是一些常用的正则表达式公式:1. 匹配单个字符:(1).点号(.)表示匹配任何单个字符,除了换行符。
(2)\d表示数字,等价于[0-9]。
(3)\D表示非数字,等价于[^0-9]。
(4)\w表示字符,包括数字、字母和下划线,等价于[a-zA-Z0-9_]。
(5)\W表示非字符,等价于[^a-zA-Z0-9_]。
(6)\s表示空白字符,包括空格、制表符、换行符等。
(7)\S表示非空白字符。
2. 匹配重复字符:(1)*表示重复0次或更多次。
(2)+表示重复1次或更多次。
(3)?表示重复0次或1次。
(4){n}表示重复n次。
(5){n,}表示重复n次或更多次。
(6){n,m}表示重复n到m次。
3. 匹配位置:(1)^表示匹配开头位置。
(2)$表示匹配结尾位置。
(3)\b表示匹配单词边界。
(4)\B表示匹配非单词边界。
4. 匹配分组:(1)( )表示一个分组。
(2)\1、\2、\3等表示对之前的分组的引用。
(3)(?: )表示一个非捕获分组。
5. 匹配字符集:(1)[ ]表示一个字符集,例如[abc]表示匹配a、b、c中的任意一个字符。
(2)[^ ]表示一个否定字符集,例如[^abc]表示匹配除了a、b、c以外的任意一个字符。
(3)[a-z]表示一个范围,表示匹配a至z中的任意一个字母。
6. 匹配转义字符:(1)\表示转义字符,例如\\.表示匹配点号。
(2)\n表示匹配换行符。
(3)\r表示匹配回车符。
(4)\t表示匹配制表符。
(5)\xx表示匹配十六进制字符。
以上是一些常用的正则表达式公式,如果我们能够熟练掌握这些公式,就可以很好地应用正则表达式来处理字符串。
当然,对于不同编程语言来说,对于正则表达式的支持也会有所不同,所以需要我们在实际应用中注意区别。
常用的正则表达式

70. [xyz] 字符集合。
71.
72. [^xyz] 负值字符集合。
73.
74. [a-z] 字符范围,匹配指定范围内的任意字符。
75.
76. [^a-z] 负值字符范围,匹配任何不在指定范围内的任意字符。
77.
23. "^(d{1,2}|1dd|2[0-4]d|25[0-5]).(d{1,2}|1dd|2[0-4]d|25[0-5]).(d{1,2}|1dd|2[0-4]d|25[0-5]).(d{1,2}|1dd|2[0-4]d|25[0-5])$" //IP地址
24.
25. 匹配中文字符的正则表达式: [\u4e00-\u9fa5]
52.
53. {n,} n 是一个非负整数,至少匹配n 次。
54.
55. {n,m} m 和 n 均为非负整数,其中n <= m。最少匹配 n 次且最多匹配 m 次。在逗号和两个数之间不能有空格。
56.
匹配中文字符的正则表达式: [u4e00-u9fa5]
1. 平时做网站经常要用正则表达式,下面是一些讲解和例子,仅供大家参考和修改使用:
2. "^\d+$" //非负整数(正整数 + 0)
3. "^[0-9]*[1-9][0-9]*$" //正整数
4. "^((-\d+)|(0+))$" //非正整数(负整数 + 0)
^-[1-9]d*|0$ //匹配非正整数(负整数 + 0)
^[1-9]d*.d*|0.d*[1-9]d*$ //匹配正浮点数
^-([1-9]d*.d*|0.d*[1-9]d*)$ //匹配负浮点数
正则表达式实用语法大全
正则表达式实用语法大全正则表达式是一种强大的文本匹配和处理工具,它可以用来在字符串中查找、替换和提取特定的模式。
下面是一些常用的正则表达式实用语法:1. 字符匹配。
\d: 匹配数字。
\w: 匹配字母、数字、下划线。
\s: 匹配空白字符。
. : 匹配任意字符。
2. 重复匹配。
: 匹配前面的元素零次或多次。
+ : 匹配前面的元素一次或多次。
: 匹配前面的元素零次或一次。
{n} : 匹配前面的元素恰好n次。
{n,} : 匹配前面的元素至少n次。
{n,m} : 匹配前面的元素至少n次,至多m次。
3. 边界匹配。
^ : 匹配字符串的开头。
$ : 匹配字符串的结尾。
\b : 匹配单词的边界。
4. 分支条件。
| : 匹配多个表达式中的一个。
5. 分组。
( ) : 将表达式分组。
(?: ) : 只匹配不捕获分组。
(?<name> ) : 命名捕获分组。
6. 贪婪与非贪婪。
: 匹配前面的元素零次或多次,尽量少匹配。
+? : 匹配前面的元素一次或多次,尽量少匹配。
: 匹配前面的元素零次或一次,尽量少匹配。
{n,m}? : 匹配前面的元素至少n次,至多m次,尽量少匹配。
7. 反义。
\D : 匹配非数字。
\W : 匹配非字母、数字、下划线。
\S : 匹配非空白字符。
8. 转义字符。
\ : 转义特殊字符。
以上是一些常用的正则表达式实用语法,通过灵活运用这些语法,可以实现对文本的高效处理和匹配。
希望这些内容对你有所帮助。
正则表达式15个常用实例
正则表达式15个常用实例正则表达式是一种文本模式语言,它允许用户通过指定模式来查找或替换文本。
它在编程语言和许多计算机应用程序中都有用,特别是在解析和处理文本时。
下面我们就来看看正则表达式的15个常用实例。
1.匹配字符串中的数字:\d+ 。
2.匹配字符串中的小写字母:[a-z] 。
3.匹配字符串中的大写字母:[A-Z] 。
4.匹配字符串中的所有单词字符:\w+ 。
5.匹配字符串中的空格字符:\s+ 。
6.匹配字符串中的日期:\d{4}-\d{2}-\d{2} 。
7.匹配字符串中的邮箱地址:[a-zA-Z0-9]+@[a-z]+\.[a-z]+ 。
8.匹配字符串中的URL:https?:\/\/[a-zA-Z0-9]+\.[a-z]+ 。
9.匹配字符串中的IP地址:\d{1,3}\.\d{1,3}\.\d{1,3}\.\d{1,3} 。
10.匹配字符串中的HTML标签:<[a-zA-Z0-9]+> 。
11.匹配字符串中的HTML属性:\w+=".*?" 。
12.匹配字符串中的中文字符:[\u4e00-\u9fa5] 。
13.匹配字符串中的特殊字符:[\^\.\?\*\+\$\[\]\(\)\{\}\\\/\|] 。
14.匹配字符串中的任意字符:. 。
15.匹配字符串中的任意位置:^$ 。
正则表达式非常强大,它可以用来检测字符串中的任何模式,并执行替换或提取操作。
正则表达式的15个常用实例只是用来提醒用户,它们只是正则表达式的一小部分。
正则表达式的应用种类很多,可以用来检测文本格式、搜索特定字符串、数据验证和替换文本。
有了正则表达式,开发者可以更有效地处理文本,从而大大提高工作效率。
20个常用的正则表达式
20个常用的正则表达式摘要:1.正则表达式的概念2.为什么需要正则表达式3.20 个常用的正则表达式a.匹配数字b.匹配字母c.匹配字符串d.匹配空白字符e.匹配特殊字符f.匹配范围g.匹配零次或多次h.匹配一次或多次i.匹配两次或多次j.匹配正则表达式k.匹配非正则表达式l.匹配开头m.匹配结尾n.匹配子字符串o.匹配连续字符p.匹配非连续字符q.匹配可选字符r.匹配分组s.匹配替换t.匹配转义字符u.匹配反向引用v.匹配贪婪与懒惰匹配w.匹配并匹配下一个字符x.匹配字符集合y.匹配字符范围z.匹配Unicode 字符正文:正则表达式是一种强大的文本处理工具,它可以用来检查文本是否符合某种模式、提取文本中的特定部分或者替换文本中的某些内容。
在Python 等编程语言中,正则表达式被广泛应用于文本分析、网页抓取、数据分析等领域。
本文将介绍20 个常用的正则表达式,帮助你更好地掌握正则表达式的使用。
1.匹配数字:`d` 匹配任意数字,`d+` 匹配一个或多个数字,`d{3}` 匹配三个数字。
2.匹配字母:`[a-zA-Z]` 匹配任意字母,`[a-zA-Z]+` 匹配一个或多个字母,`[a-zA-Z]{3}` 匹配三个字母。
3.匹配字符串:`".*"` 匹配任意字符串,`".*?"` 匹配一个或多个字符串,`".*?{"` 匹配一个包含在大括号内的字符串。
4.匹配空白字符:`s` 匹配任意空白字符,包括空格、制表符、换行符等,`s+` 匹配一个或多个空白字符。
5.匹配特殊字符:`[!@#$%^&*(),.?":{}|<>]` 匹配任意特殊字符。
6.匹配范围:`-` 匹配数字范围,如`d-` 匹配0-9 的数字,`[a-zA-Z]` 匹配所有字母。
7.匹配零次或多次:`*` 匹配前面的字符出现零次或多次,如`d*` 匹配零个或多个数字。
20个常用的正则表达式 单字母
正则表达式(Regular Expression)是一种用于匹配字符串的强大工具。
它通过使用特定的符号和字符来描述和匹配一系列字符串,能够满足我们在处理文本时的各种需求。
在这篇文章中,我们将深入探讨20个常用的单字母正则表达式,并通过实例来展示它们的使用方法。
1. \b在正则表达式中,\b表示单词的边界。
它可以用来匹配单词的开头或结尾,用于查找特定单词而不是单词的一部分。
2. \d\d表示任意一个数字字符。
它可以用来匹配任何数字,例如\d+可以匹配一个或多个数字字符。
3. \w\w表示任意一个字母、数字或下划线字符。
它可以用来匹配单词字符,例如\w+可以匹配一个或多个单词字符。
4. \s\s表示任意一个空白字符,包括空格、制表符、换行符等。
它可以用来匹配空白字符,例如\s+可以匹配一个或多个空白字符。
5. \.\.表示匹配任意一个字符,包括标点符号和空格等。
它可以用来匹配任意字符,例如\.可以匹配任意一个字符。
6. \A\A表示匹配字符串的开始。
它可以用来确保匹配发生在字符串的开头。
7. \Z\Z表示匹配字符串的结束。
它可以用来确保匹配发生在字符串的结尾。
8. \b\b表示单词的边界。
它可以用来匹配单词的开头或结尾,用于查找特定单词而不是单词的一部分。
9. \D\D表示任意一个非数字字符。
它可以用来匹配任何非数字字符。
10. \W\W表示任意一个非单词字符。
它可以用来匹配任何非单词字符。
11. \S\S表示任意一个非空白字符。
它可以用来匹配任何非空白字符。
12. \[\[表示匹配方括号。
它可以用来匹配包含在方括号内的字符。
13. \]\]表示匹配方括号。
它可以用来匹配包含在方括号内的字符。
14. \(\(表示匹配左括号。
它可以用来匹配包含在左括号内的字符。
15. \)\)表示匹配右括号。
它可以用来匹配包含在右括号内的字符。
16. \{\{表示匹配左花括号。
它可以用来匹配包含在左花括号内的字符。
17. \}\}表示匹配右花括号。