
神经网络及深度学习(包含matlab代码)
(包含 MATLAB 仿真) 人工神经网络(Artificial Neural Network,即 ANN ) ,作为对人脑最简单的一种抽象和 模拟,是人们模仿人的大脑神经系统信息处理功能的一个智能化系统,是 20 世纪 80 年代 以来人工智能领域兴起的研究热点。 人工神经网络以数学和物理方法以及信息处理的角度对 人脑神经网络进行抽象, 并建立某种简化模型, 旨在模仿人脑结构及其功能的信息处理系统。 人工神经网络最有吸引力的特点就是它的学习能力。因此从 20 世纪 40 年代人工神经 网络萌芽开始, 历经两个高潮期及一个反思期至 1991 年后进入再认识与应用研究期, 涌现 出无数的相关研究理论及成果, 包括理论研究及应用研究。 最富有成果的研究工作是多层网 络 BP 算法,Hopfield 网络模型,自适应共振理论,自组织特征映射理论等。因为其应用价 值, 该研究呈愈演愈烈的趋势, 学者们在多领域中应用人工神经网络模型对问题进行研究优 化解决。 人工神经网络是由多个神经元连接构成,因此欲建立人工神经网络模型必先建立人工 神经元模型,再根据神经元的连接方式及控制方式不同建立不同类型的人工神经网络模型。 一、人工神经元及神经网络 1.1 人工神经元模型 仿生学在科技发展中起着重要作用,人工神经元模型的建立来源于生物神经元结构的 仿生模拟,用来模拟人工神经网络。人们提出的神经元模型有很多,其中最早提出并且影响 较大的是 1943 年心理学家 McCulloch 和数学家 W. Pitts 在分析总结神经元基本特性的基础上 首先提出的 MP 模型。该模型经过不断改进后,形成现在广泛应用的 BP 神经元模型。人工 神经元模型是由人量处理单元厂泛互连而成的网络,是人脑的抽象、简化、模拟,反映人脑 的基本特性。一般来说,作为人工神经元模型应具备三个要素: (1) 具有一组突触或连接,常用 wij 表示神经元 i 和神经元 j 之间的连接强度。 (2) 具有反映生物神经元时空整合功能的输入信号累加器 。 (3) 具有一个激励函数 f 用于限制神经元输出。激励函数将输出信号限制在一个允许 范围内。 一个典型的人工神经元模型如图 1-11-1 所示。
神经网络结构图
2.2 BP 神经算法原理 BP 算法由正向传播和反向传播两部分组成。在正向传播过程中,输入信息从输入层经 隐层单元处理后,传至输出层。每一层神经元的状态只影响下一层神经元的状态。当实际输 出与期望输出不符时,进入误差的反向传播阶段。把误差通过输出层沿连接路径返回,按误 差梯度下降的方式修正各层权值,向隐层、输入层逐层反传。周而复始的信息正向传播和误 差反向传播过程,是各层权值不断调整的过程,通过修改各层神经元之间的连接权值,也是 神经网络学习训练的过程,此过程一直进行到网络输出的误差信号减少到可以接受的程度, 或者预先设定的学习次数为止。 BP 神经网络模型包括其输入输出模型、作用函数模型、误差计算模型和自学习模型。 (1) 节点的输出模型 BP 神经网络的节点输出包括隐层节点输出和输出节点输出。其中,隐层节点输出模型 为:
f (x) tanh(x)
1 e x 1 e x
(2.4)
(3) 误差计算模型 误差计算模型是反映神经网络期望输出与计算输出之间误差大小的函数, 其计算如下:
E
其中 T p 网络目标输出。 (4) 自学习模型
N 1 (Tp Qp )2 2 N p 1
(2.5)
神经网络的学习过程, 即连接下层节点和上层节点之间的权重矩阵 Wij 的设定和误差修 正过程。BP 网络学习分为有监督学习和无监督学习。有监督学习需要设定期望值,无监督
X k [ J T ( X k ) J ( X k ) k I ]1 J T ( X k )V ( X k )
其中, V T [v1 , v2
(2.8)
vn ] [e1,1e2,1
eS M ,1 , e1,2
eS M ,Q ]
图(a) 前向网络
图(b) 有反馈前向网络
图(c) 层内互边前向网络 图 1-2 神经网络拓扑结构图
图(d) 互联网络
二、BP 神经网络原理 BP 神经网络是一种按误差逆传播 BP(Back Propagation)算法训练的多层前馈网络,由它 最初是由 Pau1werboSS 在 1974 年提出,但未传播,直到 20 世纪 80 年代中期 Rumelhart、 Hinton 和 Williams、 David Parker 和 Yann Le Cun 重新发现了 BP 算法, 同时因此算法被包括在 《并行分布处理》(Parallel Distributed Processing),此算法才广为人知。目前 BP 算法已成为 应用最广泛的神经网络学习算法,据统计有近 90%的神经网络应用是基于 BP 算法的。 BP 神经网络学习是由信息的正向传播和误差的反向传播两个过程组成。 BP 神经网络的 学习规则是使用最速下降法, 通过反向传播来不断调整网络的权值和阈值, 使网络的误差平 方和最小。 BP 网络的神经元采用的传递函数通常是 Sigmoid 型可微函数, 所以可以实现输入 和输出间的任意非线性映射, 这使得它在诸如信号处理、 计算机网络、 过程控制、 语音识别、 函数逼近、模式识别及数据压缩等领域均取得了成功的应用。 2.1BP 神经网络结构 BP 网络的基本结构如图 2-1 所示, 其模型拓扑结构包括输入层 (input) 、 隐层(hidden layer) 和输出层(output layer)三层结构。 输入层各神经元负责接收来自外界的输入信息,并传递给中间层各神经元;中间层是 内部信息处理层,负责信息变换,根据信息变化能力的需求。中间层可以设计为单隐层或者 多隐层结构;最后一个隐层传递到输出层各神经元的信息,经进一步处理后,完成一次学习 的正向传播处理过程,由输出层向外界输出信息处理结果。隐层节点一般采用 Sigmoid 型函 数,输入和输出节点可以采用 Sigmoid 型函数或者线性函数。
x1 x2
xj
wi1 wi 2
wij
f
yi
wiN
b
i
xN
图 1-1 人工神经元模型 其中 x j 为神经元 i 的输入信号, wij 为连接权重,b 为外部刺激, f 为激励函数, yi 为
神经元的输出,其输出计算公式如(1.1)。
N yi f wij x j b j 1
设置初始权系数
给定输入/输出样本对
计算隐层单元的输出
权值调整
计算输出层单元的输出
求误差梯度
计算输出层单元的误差
计算隐层单元误差
N
误差满足要求?
Y
结束
图 2-2BP 学习算法框图 2.3BP 神经网络算法分析及改进 BP 算法现在已成为目前应用最广泛的神经网络学习算法,它在函数逼近、模式识别、 分类、数据压缩等领域有着更加广泛的应用。但它存在学习收敛速度慢、容易陷入局部极小 点而无法得到全局最优解、且对初始权值的选取很敏感等缺点。具体如下: (1) 在权值调整上采用梯度下降法作为优化算法,极易陷入局部极小。 (2) 学习算法的收敛速度很慢,收敛速度还与初始权值和传输函数的选择有关。 (3) 网络的结构设计,即隐节点数的选择,尚无理论指导,具有很大的盲目性。 (4) 新加入的样本对已经学好的样本影响较大, 且每个输入样本的特征数目要求相同, 泛化能力较差。
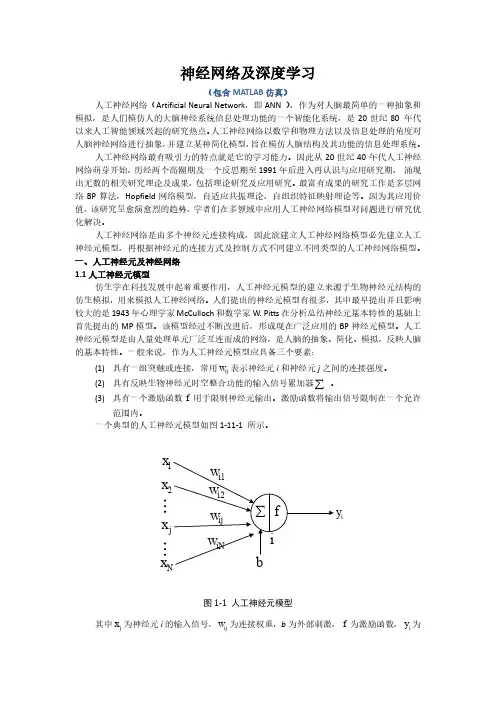
f ( x)
1 1 e Qx
(2.3)
它反映了神经元的饱和特性。 上式中, Q 为表示神经元非线性的参数, 称增益值(Gain), 也称调节参数。 Q 值越大, S 形曲线越陡峭; 反之, Q 值越小, S 形曲线越平坦; 一般取 Q=1。 (b)双曲正切激励函数,一般取为(-1,1)内连续取值:
1.05* t , E t 1 E t t 1 0.75* t , E t 1 E t t , 其他
(2) BP 算法的数值优化 采用共轭梯度法和 Levenberg - Marqardt 算法可以提高数值精度。共轭梯度法选择与梯 度相反的方向作为第一次搜索方向,再使函数沿搜索方向极小化,再确定下一个搜索方向, 直至收敛。而 Levenberg - Marqardt 算法是牛顿法的变形,用以最小化那些作为其他非线性 函数平方和的函数,这非常适合于性能指数是均方误差的神经网络训练。 Levenberg - Marqardt 算法为:
学习方式只需输入模式之分。自学习模型为
Wij n 1 h Фi O j Wij n ?
(2.6)
其中, h 为学习因子; i 输出节点 i 的计算误差; Q j 为输出节点 j 的计算输出; 为 动量因子。 BP 模型把一组输入输出样本的函数问题转变为一个非线性优化问题,并使用了优化技 术中最普通的梯度下降法。 如果把神经网络看成是输入到输出的映射, 则这个映射是一个高 度非线性映射。BP 算法程序框图如图 2-2 所示。
针对 BP 算法存在的缺陷,目前国内外已有不少人对 BP 网络进行了大量的研究,提出 了各种不同的改进方案,如优化训练输入参数,加入动量参数,以及学习步长的适应调整, 采用带动量的自学习率 BP 算法, 动态全参数自调整学习算法, 记忆式初值权值和阀值方法, 快速自适应学习算法等,这些方案均提高 BP 神经网络收敛速度。 比较典型的改进方法如下: (1) 启发式改进 为了使学习速率足够大,又不易产生振荡,根据 Rumelhart 的建议,在权值调整算式 中,加入“动量项” ,即
(1.2)
1.2 人工神经网络模型 建立神经元模型后,将多个神经元进行连接即可建立人工神经网络模型。神经网络的 类型多种多样, 它们是从不同角度对生物神经系统不同层次的抽象和模拟。 从功能特性和学 习特性来分,典型的神经网络模型主要包括感知器、线性神经网络、BP 网络、径向基函数 网络、自组织映射网络和反馈神经网络等。一般来说,当神经元模型确定后,一个神经网络 的特性及其功能主要取决于网络的拓扑结构及学习方法。 从网络拓扑结构角度来看, 神经网 络可以分为以下四种基本形式:前向网络、有反馈的前向网络、层内互边前向网络和互连网 络。 神经网络结构如图 1-2,其中子图的图(a)为前向网络结构,图(b)有反馈的前向网络结 构、图(c)层内互边前向网络结构和图(d)互连网络结构。 根据有无反馈,亦可将神经网络划分为:无反馈网络和有反馈网络。无反馈网络为前 馈神经网络(Feed Forward NNs, FFNNs), 有反馈网络为递归神经网络和(Recurrent NNs, RNNs) 。
神经网络与深度学习——基于MATLAB的仿真与实现
目录分析
第1章神经网络概 述
读书笔记
读书笔记
这是《神经网络与深度学习——基于MATLAB的仿真与实现》的读书笔记模板,可以替换为自己的心得。
精彩摘录
精彩摘录
这是《神经网络与深度学习——基于MATLAB的仿真与实现》的读书笔记模板,可以替换为自己的精彩内容 摘录。
谢谢观看
第6章径向基神经网络
6.1径向基神经网络的基本结构与算法基础 6.2径向基神经网络的MATLAB实现 6.3关于径向基神经网络的几点讨论
第7章 Hopfield神经网络
7.1 Hopfield神经网络的基本结构与算法基础 7.2 Hopfield神经网络的MATLAB实现 7.3关于Hopfield神经网络的几点讨论
第9章概率神经 网络
第3章感知机
3.1感知机的基本结构与算法基础 3.2感知机的MATLAB实现
第4章线性神经网络
4.1线性神经网络的基本结构与算法基础 4.2线性神经网络的MATLAB实现 4.3关于线性神经网络的几点讨论
第5章 BP神经网络
5.1 BP神经网络的基本结构与算法基础 5.2 BP神经网络的MATLAB实现 5.3关于BP神经网络的几点讨论
第8章 SOM神经网络
8.1 SOM神经网络的基本结构与算法基础 8.2 SOM神经网络的MATLAB实现 8.3关于SOM神经网络的几点讨论
第9章概率神经网络
在Matlab中实现神经网络的方法与实例
在Matlab中实现神经网络的方法与实例神经网络是一种模拟人类大脑神经系统的计算模型,它能够通过学习数据的模式和关联性来解决各种问题。
在计算机科学和人工智能领域,神经网络被广泛应用于图像识别、自然语言处理、预测等任务。
而Matlab作为一种功能强大的科学计算软件,提供了一套完善的工具箱,可以方便地实现神经网络的建模和训练。
本文将介绍在Matlab中实现神经网络的方法与实例。
首先,我们会简要介绍神经网络的基本原理和结构,然后详细讲解在Matlab中如何创建并训练神经网络模型,最后通过几个实例展示神经网络在不同领域的应用。
一、神经网络的原理和结构神经网络模型由神经元和它们之间的连接构成。
每个神经元接收输入信号,并通过权重和偏置进行加权计算,然后使用激活函数对结果进行非线性变换。
这样,神经网络就能够模拟复杂的非线性关系。
常见的神经网络结构包括前馈神经网络(Feedforward Neural Network)和循环神经网络(Recurrent Neural Network)。
前馈神经网络是最基本的结构,信号只能向前传递,输出不对网络进行反馈;而循环神经网络具有反馈连接,可以对自身的输出进行再处理,适用于序列数据的建模。
神经网络的训练是通过最小化损失函数来优化模型的参数。
常用的训练算法包括梯度下降法和反向传播算法。
其中,梯度下降法通过计算损失函数对参数的梯度来更新参数;反向传播算法是梯度下降法在神经网络中的具体应用,通过反向计算梯度来更新网络的权重和偏置。
二、在Matlab中创建神经网络模型在Matlab中,可以通过Neural Network Toolbox来创建和训练神经网络模型。
首先,我们需要定义神经网络的结构,包括输入层、隐藏层和输出层的神经元数量,以及每个神经元之间的连接权重。
例如,我们可以创建一个三层的前馈神经网络模型:```matlabnet = feedforwardnet([10 8]);```其中,`[10 8]`表示隐藏层的神经元数量分别为10和8。
MATLAB神经网络与深度学习教程
MATLAB神经网络与深度学习教程神经网络与深度学习是当今计算机科学领域最热门的研究方向之一。
在过去的几年中,深度学习通过其卓越的性能在众多领域中取得了突破性的进展,如图像识别、语音识别、自然语言处理等。
MATLAB作为一种功能强大的科学计算软件,在神经网络和深度学习领域也有着广泛的应用。
本文将以MATLAB为基础,介绍神经网络和深度学习的基本理论和实践。
第一章:MATLAB简介1.1 MATLAB基本概念1.2 MATLAB的应用领域1.3 MATLAB在神经网络和深度学习中的作用第二章:神经网络基础2.1 神经网络的定义和应用2.2 神经元和神经网络模型2.3 前向传播和反向传播算法2.4 MATLAB实现神经网络的基本步骤第三章:深度学习概述3.1 深度学习的定义和历史3.2 深度学习的基本框架3.3 深度学习的优势和挑战3.4 MATLAB在深度学习中的应用第四章:卷积神经网络 (CNN)4.1 CNN的基本原理和结构4.2 CNN在图像识别中的应用4.3 搭建和训练CNN的步骤4.4 MATLAB实现CNN的案例分析第五章:循环神经网络 (RNN)5.1 RNN的基本原理和结构5.2 RNN在自然语言处理中的应用5.3 搭建和训练RNN的步骤5.4 MATLAB实现RNN的案例分析第六章:深度学习模型的训练和优化6.1 数据预处理和特征工程6.2 激活函数和损失函数的选择6.3 参数初始化和正则化方法6.4 MATLAB实现深度学习模型的训练和优化技巧第七章:深度学习模型的评估和应用7.1 模型评估指标7.2 混淆矩阵和ROC曲线7.3 深度学习在实际应用中的案例7.4 MATLAB实现深度学习模型的评估和应用第八章:MATLAB深度学习工具箱8.1 神经网络工具箱的概述8.2 深度学习工具箱的概述8.3 MATLAB深度学习工具箱的使用方法8.4 MATLAB深度学习工具箱的案例展示总结:本文以MATLAB为基础,全面介绍了神经网络和深度学习的理论与实践。
MATLAB程序代码 bp神经网络通用代码
实用标准文案MATLAB程序代码--bp神经网络通用代码matlab通用神经网络代码学习了一段时间的神经网络,总结了一些经验,在这愿意和大家分享一下,希望对大家有帮助,也希望大家可以把其他神经网络的通用代码在这一起分享感应器神经网络、线性网络、BP神经网络、径向基函数网络%通用感应器神经网络。
P=[-0.5 -0.5 0.3 -0.1 -40;-0.5 0.5 -0.5 1 50];%输入向量T=[1 1 0 0 1];%期望输出plotpv(P,T);%描绘输入点图像net=newp([-40 1;-1 50],1);%生成网络,其中参数分别为输入向量的范围和神经元感应器数量hold onlinehandle=plotpc(net.iw{1},net.b{1});net.adaptparam.passes=3;for a=1:25%训练次数[net,Y,E]=adapt(net,P,T);linehandle=plotpc(net.iw{1},net.b{1},linehandle);drawnow;end%通用newlin程序%通用线性网络进行预测time=0:0.025:5;T=sin(time*4*pi);Q=length(T);P=zeros(5,Q);%P中存储信号T的前5(可变,根据需要而定)次值,作为网络输入。
精彩文档.实用标准文案P(1,2:Q)=T(1,1:(Q-1));P(2,3:Q)=T(1,1:(Q-2));P(3,4:Q)=T(1,1:(Q-3));P(4,5:Q)=T(1,1:(Q-4));P(5,6:Q)=T(1,1:(Q-5));plot(time,T)%绘制信号T曲线xlabel('时间');ylabel('目标信号');title('待预测信号');net=newlind(P,T);%根据输入和期望输出直接生成线性网络a=sim(net,P);%网络测试figure(2)plot(time,a,time,T,'+')xlabel('时间');ylabel('输出-目标+');title('输出信号和目标信号');e=T-a;figure(3)plot(time,e)hold onplot([min(time) max(time)],[0 0],'r:')%可用plot(x,zeros(size(x)),'r:')代替hold offxlabel('时间');ylabel('误差');精彩文档.实用标准文案title('误差信号');%通用BP神经网络P=[-1 -1 2 2;0 5 0 5];t=[-1 -1 1 1];net=newff(minmax(P),[3,1],{'tansig','purelin'},'traingd');%输入参数依次为:'样本P范围',[各层神经元数目],{各层传递函数},'训练函数'%训练函数traingd--梯度下降法,有7个训练参数.%训练函数traingdm--有动量的梯度下降法,附加1个训练参数mc(动量因子,缺省为0.9)%训练函数traingda--有自适应lr的梯度下降法,附加3个训练参数:lr_inc(学习率增长比,缺省为1.05;% lr_dec(学习率下降比,缺省为0.7);max_perf_inc(表现函数增加最大比,缺省为1.04)%训练函数traingdx--有动量的梯度下降法中赋以自适应lr的方法,附加traingdm和traingda的4个附加参数%训练函数trainrp--弹性梯度下降法,可以消除输入数值很大或很小时的误差,附加4个训练参数:% delt_inc(权值变化增加量,缺省为1.2);delt_dec(权值变化减小量,缺省为0.5);% delta0(初始权值变化,缺省为0.07);deltamax(权值变化最大值,缺省为50.0)% 适合大型网络%训练函数traincgf--Fletcher-Reeves共轭梯度法;训练函数traincgp--Polak-Ribiere共轭梯度法;%训练函数traincgb--Powell-Beale共轭梯度法%共轭梯度法占用存储空间小,附加1训练参数searchFcn(一维线性搜索方法,缺省为srchcha);缺少1个训练参数lr %训练函数trainscg--量化共轭梯度法,与其他共轭梯度法相比,节约时间.适合大型网络% 附加2个训练参数:sigma(因为二次求导对权值调整的影响参数,缺省为5.0e-5);% lambda(Hessian阵不确定性调节参数,缺省为5.0e-7)% 缺少1个训练参数:lr精彩文档.实用标准文案%训练函数trainbfg--BFGS拟牛顿回退法,收敛速度快,但需要更多内存,与共轭梯度法训练参数相同,适合小网络%训练函数trainoss--一步正割的BP训练法,解决了BFGS消耗内存的问题,与共轭梯度法训练参数相同%训练函数trainlm--Levenberg-Marquardt训练法,用于内存充足的中小型网络net=init(net);net.trainparam.epochs=300; %最大训练次数(前缺省为10,自trainrp后,缺省为100)net.trainparam.lr=0.05; %学习率(缺省为0.01)net.trainparam.show=50; %限时训练迭代过程(NaN表示不显示,缺省为25)net.trainparam.goal=1e-5; %训练要求精度(缺省为0)%net.trainparam.max_fail 最大失败次数(缺省为5)%net.trainparam.min_grad 最小梯度要求(前缺省为1e-10,自trainrp后,缺省为1e-6)%net.trainparam.time 最大训练时间(缺省为inf)[net,tr]=train(net,P,t); %网络训练a=sim(net,P) %网络仿真%通用径向基函数网络——%其在逼近能力,分类能力,学习速度方面均优于BP神经网络%在径向基网络中,径向基层的散步常数是spread的选取是关键%spread越大,需要的神经元越少,但精度会相应下降,spread的缺省值为1%可以通过net=newrbe(P,T,spread)生成网络,且误差为0%可以通过net=newrb(P,T,goal,spread)生成网络,神经元由1开始增加,直到达到训练精度或神经元数目最多为止%GRNN网络,迅速生成广义回归神经网络(GRNN)P=[4 5 6];T=[1.5 3.6 6.7];精彩文档.实用标准文案net=newgrnn(P,T);%仿真验证p=4.5;v=sim(net,p)%PNN网络,概率神经网络P=[0 0 ;1 1;0 3;1 4;3 1;4 1;4 3]';Tc=[1 1 2 2 3 3 3];%将期望输出通过ind2vec()转换,并设计、验证网络T=ind2vec(Tc);net=newpnn(P,T);Y=sim(net,P);Yc=vec2ind(Y)%尝试用其他的输入向量验证网络P2=[1 4;0 1;5 2]';Y=sim(net,P2);Yc=vec2ind(Y)%应用newrb()函数构建径向基网络,对一系列数据点进行函数逼近P=-1:0.1:1;T=[-0.9602 -0.5770 -0.0729 0.3771 0.6405 0.6600 0.4609...0.1336 -0.2013 -0.4344 -0.500 -0.3930 -0.1647 -0.0988...0.3072 0.3960 0.3449 0.1816 -0.0312 -0.2189 -0.3201];%绘制训练用样本的数据点plot(P,T,'r*');title('训练样本');精彩文档.实用标准文案xlabel('输入向量P');ylabel('目标向量T');%设计一个径向基函数网络,网络有两层,隐层为径向基神经元,输出层为线性神经元%绘制隐层神经元径向基传递函数的曲线p=-3:.1:3;a=radbas(p);plot(p,a)title('径向基传递函数')xlabel('输入向量p')%隐层神经元的权值、阈值与径向基函数的位置和宽度有关,只要隐层神经元数目、权值、阈值正确,可逼近任意函数%例如a2=radbas(p-1.5);a3=radbas(p+2);a4=a+a2*1.5+a3*0.5;plot(p,a,'b',p,a2,'g',p,a3,'r',p,a4,'m--')title('径向基传递函数权值之和')xlabel('输入p');ylabel('输出a');%应用newrb()函数构建径向基网络的时候,可以预先设定均方差精度eg以及散布常数sceg=0.02;sc=1; %其值的选取与最终网络的效果有很大关系,过小造成过适性,过大造成重叠性net=newrb(P,T,eg,sc);%网络测试精彩文档.实用标准文案plot(P,T,'*')xlabel('输入');X=-1:.01:1;Y=sim(net,X);hold onplot(X,Y);hold offlegend('目标','输出')%应用grnn进行函数逼近P=[1 2 3 4 5 6 7 8];T=[0 1 2 3 2 1 2 1];plot(P,T,'.','markersize',30)axis([0 9 -1 4])title('待逼近函数')xlabel('P')ylabel('T')%网络设计%对于离散数据点,散布常数spread选取比输入向量之间的距离稍小一些spread=0.7;net=newgrnn(P,T,spread);%网络测试A=sim(net,P);hold onoutputline=plot(P,A,'o','markersize',10,'color',[1 0 0]);精彩文档.实用标准文案title('检测网络')xlabel('P')ylabel('T和A')%应用pnn进行变量的分类P=[1 2;2 2;1 1]; %输入向量Tc=[1 2 3]; %P对应的三个期望输出%绘制出输入向量及其相对应的类别plot(P(1,:),P(2,:),'.','markersize',30)for i=1:3text(P(1,i)+0.1,P(2,i),sprintf('class %g',Tc(i)))endaxis([0 3 0 3]);title('三向量及其类别')xlabel('P(1,:)')ylabel('P(2,:)')%网络设计T=ind2vec(Tc);spread=1;net=newgrnn(P,T,speard);%网络测试A=sim(net,P);Ac=vec2ind(A);%绘制输入向量及其相应的网络输出plot(P(1,:),P(2,:),'.','markersize',30)精彩文档.实用标准文案for i=1:3text(P(1,i)+0.1,P(2,i),sprintf('class %g',Ac(i)))endaxis([0 3 0 3]);title('网络测试结果')xlabel('P(1,:)')ylabel('P(2,:)')P=[13, 0, 1.119, 1, 26.3;22, 0, 1.135, 1, 26.3;-15, 0, 0.9017, 1, 20.4;-30, 0, 0.9172, 1, 26.7;24,0,1.238,0.9704,28.2;3,24,1.119,1,26.3;0,52,1.089,1,26.3;0,-73,1.0889,1,26.3;1,28,0.8748,1,2 6.3;-1,-39,1.1168,1,26.7;-2, 0, 1.495, 1, 26.3;0, -1, 1.438, 1, 26.3;4, 1,0.4964,0.9021, 26.3;3, -1, 0.5533, 1.2357, 26.7;-5, 0, 1.7368, 1, 26.7;1, 0, 1.1045, 0.0202,26.3;-2, 0, 1.1168, 1.3764, 26.7;-3, -1, 1.1655, 1.4418,27.5;3, 2, 1.0875, 0.748, 27.5;-3, 0, 1.1068, 2.2092, 26.3;4, 1, 0.9017, 1, 13.7;3, 2, 0.9017, 1, 14.9;-3, 1, 0.9172, 1, 13.7;-2, 0, 1.0198, 1.0809, 16.1;0, 1, 0.9172, 1, 13.7]T=[1, 0, 0, 0, 0 ;1, 0, 0, 0, 0 ;1, 0, 0, 0, 0 ;1, 0, 0, 0, 0 ;1, 0, 0, 0, 0;0, 1, 0, 0, 0;0, 1, 0, 0, 0;0, 1, 0, 0, 0;0, 1, 0, 0, 0;0, 1, 0, 0, 0;0, 0, 1, 0, 0;0, 0, 1, 0, 0;0, 0, 1, 0, 0;0, 0, 1, 0, 0;0, 0, 1, 0, 0;0, 0, 0, 1, 0 ;0, 0, 0, 1, 0 ;0, 0, 0, 1, 0 ;0, 0, 0, 1, 0 ;0, 0, 0, 1, 0 ;0, 0, 0, 0, 1;0, 0, 0, 0, 1;0, 0, 0, 0, 1;0, 0, 0, 0, 1;0, 0, 0, 0, 1 ];%期望输出plotpv(P,T);%描绘输入点图像精彩文档.。
深度强化算法 matlab代码
深度强化学习是一种结合了深度学习和强化学习的方法,可以用于解决复杂的决策问题。
Matlab是一种功能强大的科学计算软件,提供了丰富的工具和函数,可以很好地支持深度强化学习算法的实现。
本文将介绍深度强化学习算法的原理,并给出在Matlab上的实现代码。
一、深度强化学习算法介绍深度强化学习是一种用于训练智能体(agent)学习在复杂环境下做出最优决策的方法。
它结合了深度学习和强化学习的技术,通过神经网络来近似值函数和策略函数,从而实现对大规模状态空间和动作空间的建模和学习。
在深度强化学习中,智能体通过与环境的交互来不断优化其策略,以最大化累积奖励。
二、深度强化学习算法的实现在Matlab中,可以使用深度学习工具箱来实现深度强化学习算法。
下面是一个简单的深度Q网络(DQN)算法的实现代码:1. 定义神经网络模型。
```Matlablayers = [imageInputLayer([4 1 1])fullyConnectedLayer(24)reluLayerfullyConnectedLayer(24)reluLayerfullyConnectedLayer(2)regressionLayer];```2. 初始化深度Q网络模型。
```Matlabnet = dlnetwork(layers);```3. 定义训练参数。
```MatlabnumEpisodes = 1000; maxStepsPerEpisode = 200; miniBatchSize = 64; discountFactor = 0.99; learnRate = 0.001;```4. 开始训练。
```Matlabfor episode = 1:numEpisodes 初始化环境state = env.reset();for step = 1:maxStepsPerEpisode选取动作[action, stateValue] = chooseAction(net, state);与环境交互nextState, reward, isDone = env.step(action);计算目标Q值targetQ = reward + discountFactor * maxQValue(net, nextState) * ~isDone;计算损失dLoss = calculateLoss(net, state, action, targetQ);更新网络参数[net, loss] = adamupdate(net, dLoss, learnRate);endend```通过上面的代码,我们可以使用Matlab来实现深度强化学习算法,并在环境中学习最优策略。
神经网络及深度学习(包含matlab代码)
f ( x)
1 1 e Qx
(2.3)
它反映了神经元的饱和特性。 上式中, Q 为表示神经元非线性的参数, 称增益值(Gain), 也称调节参数。 Q 值越大, S 形曲线越陡峭; 反之, Q 值越小, S 形曲线越平坦; 一般取 Q=1。 (b)双曲正切激励函数,一般取为(-1,1)内连续取值:
神经网络及深度学习
(包含 MATLAB 仿真) 人工神经网络(Artificial Neural Network,即 ANN ) ,作为对人脑最简单的一种抽象和 模拟,是人们模仿人的大脑神经系统信息处理功能的一个智能化系统,是 20 世纪 80 年代 以来人工智能领域兴起的研究热点。 人工神经网络以数学和物理方法以及信息处理的角度对 人脑神经网络进行抽象, 并建立某种简化模型, 旨在模仿人脑结构及其功能的信息处理系统。 人工神经网络最有吸引力的特点就是它的学习能力。因此从 20 世纪 40 年代人工神经 网络萌芽开始, 历经两个高潮期及一个反思期至 1991 年后进入再认识与应用研究期, 涌现 出无数的相关研究理论及成果, 包括理论研究及应用研究。 最富有成果的研究工作是多层网 络 BP 算法,Hopfield 网络模型,自适应共振理论,自组织特征映射理论等。因为其应用价 值, 该研究呈愈演愈烈的趋势, 学者们在多领域中应用人工神经网络模型对问题进行研究优 化解决。 人工神经网络是由多个神经元连接构成,因此欲建立人工神经网络模型必先建立人工 神经元模型,再根据神经元的连接方式及控制方式不同建立不同类型的人工神经网络模型。 一、人工神经元及神经网络 1.1 人工神经元模型 仿生学在科技发展中起着重要作用,人工神经元模型的建立来源于生物神经元结构的 仿生模拟,用来模拟人工神经网络。人们提出的神经元模型有很多,其中最早提出并且影响 较大的是 1943 年心理学家 McCulloch 和数学家 W. Pitts 在分析总结神经元基本特性的基础上 首先提出的 MP 模型。该模型经过不断改进后,形成现在广泛应用的 BP 神经元模型。人工 神经元模型是由人量处理单元厂泛互连而成的网络,是人脑的抽象、简化、模拟,反映人脑 的基本特性。一般来说,作为人工神经元模型应具备三个要素: (1) 具有一组突触或连接,常用 wij 表示神经元 i 和神经元 j 之间的连接强度。 (2) 具有反映生物神经元时空整合功能的输入信号累加器 。 (3) 具有一个激励函数 f 用于限制神经元输出。激励函数将输出信号限制在一个允许 范围内。 一个典型的人工神经元模型如图 1-11-1 所示。
MATLAB中的深度学习与卷积神经网络原理
MATLAB中的深度学习与卷积神经网络原理引言深度学习是当今最热门的领域之一,不仅在学术界引起了广泛的关注,也在实际应用中展现出了巨大的潜力。
而卷积神经网络(CNN)作为深度学习的重要工具之一,被广泛应用于图像识别、自然语言处理等领域。
在本文中,我们将探讨MATLAB中深度学习与卷积神经网络的原理和应用。
一、深度学习基础深度学习是机器学习的一个分支,其核心思想是通过构建多层神经网络并使用大规模数据进行训练,从而达到自动学习和提取高阶抽象特征的目的。
深度学习模型通常包含输入层、隐藏层和输出层,其中隐藏层的数量决定了模型的深度。
通过不断调节模型的权重和偏置,深度学习算法可以在训练数据上进行优化,从而实现对未知数据的准确预测。
MATLAB提供了丰富的深度学习工具箱,包括神经网络、卷积神经网络、循环神经网络等。
这些工具箱提供了一系列函数和算法,可以方便地构建、训练和评估深度学习模型。
二、卷积神经网络(CNN)原理卷积神经网络是深度学习中非常重要的模型之一,其设计灵感来自生物学中的视觉系统。
CNN通过局部感受野、权重共享和下采样等操作,实现对图像数据中的特征进行高效提取。
在MATLAB中,我们可以使用convnet工具箱构建和训练卷积神经网络。
首先,我们需要选择网络的结构,包括卷积层、池化层和全连接层等。
接下来,我们可以通过调节网络的超参数,如学习率、批量大小和正则化参数等,来优化网络的性能。
三、使用MATLAB进行图像分类图像分类是深度学习的一个重要应用领域,其目标是根据图像的内容将其归类到预先定义的类别中。
在MATLAB中,我们可以使用CNN工具箱快速构建图像分类器。
首先,我们需要准备一个包含大量图像和对应标签的数据集。
然后,我们可以使用MATLAB的图像预处理函数对数据进行处理,如缩放、裁剪和增强等。
接下来,我们可以使用CNN工具箱构建一个卷积神经网络,并将数据集分为训练集和测试集。
在训练过程中,我们通过不断更新网络的参数来最小化损失函数,从而使得网络对训练数据的预测结果和真实标签之间的差异最小化。
神经网络及深度学习(包含matlab代码).pdf
神经网络及深度学习(包含matlab代码).pdf
神经网络可以使用中间层构建出多层抽象,正如在布尔电路中所做的那样。
如果进行视觉模式识别,那么第1 层的神经元可能学会识别边;第2 层的神经元可以在此基础上学会识别更加复杂的形状,例如三角形或矩形;第3 层将能够识别更加复杂的形状,以此类推。
有了这些多层抽象,深度神经网络似乎可以学习解决复杂的模式识别问题。
正如电路示例所体现的那样,理论研究表明深度神经网络本质上比浅层神经网络更强大。
《深入浅出神经网络与深度学习》PDF+代码分析
《深入浅出神经网络与深度学习》PDF中文,249页;PDF英文,292页;配套代码。
提取码: 6sgh
以技术原理为导向,辅以MNIST 手写数字识别项目示例,介绍神经网络架构、反向传播算法、过拟合解决方案、卷积神经网络等内容,以及如何利用这些知识改进深度学习项目。
学完后,将能够通过编写Python 代码来解决复杂的模式识别问题。
MATLAB中常见的深度学习技术介绍
MATLAB中常见的深度学习技术介绍深度学习作为人工智能领域的重要分支,近年来取得了显著的发展,并在各个应用领域展现出了强大的能力。
作为一种流行的编程语言和开发环境,MATLAB为深度学习研究和应用提供了强大的支持和丰富的工具。
本文将介绍MATLAB中常见的深度学习技术及其应用。
一、卷积神经网络(Convolutional Neural Networks,CNN)卷积神经网络是深度学习领域最常用的模型之一,特别适用于处理图像和视频数据。
MATLAB提供了丰富的工具箱和函数,支持构建、训练和部署卷积神经网络。
通过使用MATLAB的深度学习工具箱,可以轻松地构建CNN模型,并利用GPU加速进行训练和推理。
此外,MATLAB还提供了预训练的神经网络模型,可以直接应用于各种图像分类、目标检测、语义分割等任务。
二、循环神经网络(Recurrent Neural Networks,RNN)循环神经网络是一种能够处理序列数据的深度学习模型,常被应用于语音识别、自然语言处理、时间序列预测等领域。
在MATLAB中,可以利用深度学习工具箱构建各种类型的循环神经网络,例如简单循环神经网络(Simple Recurrent Neural Network,SRN)、长短期记忆网络(Long Short-Term Memory,LSTM)和门控循环单元(Gated Recurrent Unit,GRU)等。
这些网络模型提供了丰富的功能和灵活性,可以满足不同应用场景的需求。
三、深度强化学习(Deep Reinforcement Learning)深度强化学习结合了深度学习和强化学习的技术,旨在让机器能够通过与环境交互,自动学习获取最优策略。
在MATLAB中,可以利用深度强化学习工具箱构建各种强化学习模型,并通过神经网络进行值函数估计和策略优化。
深度强化学习可以应用于机器人控制、自动驾驶、游戏智能等领域,具有广泛的应用前景。
四、生成对抗网络(Generative Adversarial Networks,GAN)生成对抗网络是一种通过两个网络相互博弈的方式,实现对抗性训练和生成新样本的技术。
神经网络与深度学习基于MATLAB的仿真与实现
目录分析
目录分析
《神经网络与深度学习基于MATLAB的仿真与实现》是一本介绍神经网络和深 度学习理论的书籍,由电子工业社于2016年。该书以通俗易懂的方式,结合 MATLAB仿真与实现,详细阐述了神经网络与深度学习的基本概念、原理和实践。 下面,我们对其目录进行简要分析。
目录分析
本书的目录结构清晰明了,逻辑性强。它以循序渐进的方式引导读者从基础 知识入手,逐步深入到高级主题。全书共分为11章,各章的主题相对独立,又相 互,形成了一个完整的神经网络和深度学习知识体系。
精彩摘录
“循环神经网络(RNN)是一种能够处理序列数据的神经网络。它们通过使用 循环结构来捕捉序列数据的时间依赖关系。”这句话解释了循环神经网络的特点 和应用领域,对于处理序列数据具有重要的指导意义。
精彩摘录
“长短期记忆(LSTM)是一种特殊的RNN,它通过引入记忆单元来解决普通 RNN存在的长期依赖问题。”这句话介绍了LSTM的特点和应用领域,对于处理序 列数据中的长期依赖关系具有重要的指导意义。
精彩摘录
“Dropout是一种正则化技术,它通过在训练过程中随机地丢弃一部分神经元 来防止过拟合。”这句话说明了Dropout的作用和效果,有助于读者理解如何防 止过拟合这一重要问题。
精彩摘录
“卷积神经网络(CNN)是一种专门用于处理图像数据的神经网络。它们通过 使用卷积层来捕捉图像中的空间结构信息。”这句话揭示了卷积神经网络的特点 和应用领域,对于处理图像数据具有重要的指导意义。
精彩摘录
“反向传播算法是训练神经网络的核心步骤。这个算法通过计算损失函数关 于权重的梯度,并使用梯度下降法来更新权重,从而减小预测误差。”这句话解 释了反向传播算法的工作原理和目的,对于理解神经网络的训练过程至关重要。