
碎纸片拼接复原
m0 :0-0配对的个数 m1 :1-1配对的个数
m2 :不配对的个数
问题1:仅有纵切的情形
建模思想一 相邻碎片的灰度比较接近
假设从左往右进行拼接,最左侧碎片的序号为 k1
ki1
arg
min jIi
dki
j,
i 1, 2,
,n1
Ii {1, 2, , n} \ {k1, k2, , ki },
3. 所有碎片尺寸大小相等,边缘轮廓为规则的矩形。 4. 假设文字从左往右、从上往下书写的。
5. 所有碎片均已摆放端正,即碎片中的文字端正。
建模准备:数据的读取与处理
A= imread (filename) 读取文件名为filename的 图像文件到矩阵A BW= im2bw (A) 读将图像A转换成二值图像BW
2. 若i=n, 则停止, 输出拼接复原图序号index; 否则 计算第j( j I)个碎片最左侧列与第 ki 个碎片最右 侧列之间的距离,记距离最小的碎片的编号为 ki1
3. 置 index = index ki1, I I \ {ki1}, i i 1 ,转2
缺点 1.局部寻优方法,计算复杂度高;2.不易推 广到问题2和问题3中
2013年B题:碎纸片的拼接复原
【数据文件说明】 每一附件为同一页纸的碎片数据。 附件1、附件2为纵切碎片数据,每页纸被切为
19条碎片。 附件3、附件4为纵横切碎片数据,每页纸被切
为11×19个碎片。 附件5为纵横切碎片数据,每页纸被切为
11×19个碎片,每个碎片有正反两面。该 附件中每一碎片对应两个文件,共有 2×11×19个文件,例如,第一个碎片的 两面分别对应文件000a、000b。
2013年B题:碎纸片的拼接复原
【结果表达格式说明】 复原图片放入附录中,表格表达格式如下: 附件1、附件2的结果:将碎片序号按复原后
顺序填入1×19的表格; 附件3、附件4的结果:将碎片序号按复原后
顺序填入11×19的表格; 附件5的结果:将碎片序号按复原后顺序填入
两个11×19的表格; 不能确定复原位置的碎片,可不填入上述表
2013年B题:碎纸片的拼接复原
1. 对于给定的来自同一页印刷文字文件的 碎纸机破碎纸片(仅纵切),建立碎纸片拼 接复原模型和算法,并针对附件1、附件2给 出的中、英文各一页文件的碎片数据进行拼 接复原。如果复原过程需要人工干预,请写 出干预方式及干预的时间节点。复原结果以 图片形式及表格形式表达(见【结果表达格 式说明】)。
2013年B题:碎纸片的拼接复原
2. 对于碎纸机既纵切又横切的情形,请设 计碎纸片拼接复原模型和算法,并针对附件3、 附件4给出的中、英文各一页文件的碎片数据 进行拼接复原。如果复原过程需要人工干预, 请写出干预方式及干预的时间节点。复原结
果表达要求同上。
2013年B题:碎纸片的拼接复原
3. 上述所给碎片数据均为单面打印文件, 从现实情形出发,还可能有双面打印文件的 碎纸片拼接复原问题需要解决。附件5给出的 是一页英文印刷文字双面打印文件的碎片数 据。请尝试设计相应的碎纸片拼接复原模型 与算法,并就附件5的碎片数据给出拼接复原 结果,结果表达要求同上。
i j
n
s.t. xij 1, i 1, 2, , n 每个顶点只有一条边出去
j 1
n
xij 1, j 1, 2, , n 每个顶点只有一条边进去
i 1
xij 0,1, i, j 1, 2, , n, i j 取1表示路线从i到j
仅有一个回路
旅行商问题(TSP)的规划模型
min z cij xij
则(该列留白)重复该步骤直至将B中的碎片均判 断完
3. 若B中碎片的个数大于 n ,则 1, 转2;若 l
B中碎片的个数等于 n 问题1:仅有纵切的情形
建模思想一 相邻碎片的灰度比较接近
1. 找出最左侧碎片(设编号为 k1 ), 置 index =k1, I {1, 2, , n} \ {k1}, i 1
i j
n
s.t. xij 1, i 1, 2, , n 每个顶点只有一条边出去
dki j
d
(
Abw ki
(:,
q
),
Abj w (:,1)).
问题1:仅有纵切的情形
最左侧碎片查找算法:
1. 初始化, 置 B={ A1bw , A2bw , , Anbw }, 1
2. 从B中依次选出需要判别的碎片 Akbw。若 Akbw 的第
列中包含0(黑像素),则将 Akbw 从B中删除,否
imshow(A) 将灰度矩阵A以图像的形式展现
imwrite(A, filename) 将数字图像A写入图像 文件filename中
建模准备:距离的定义
若数据没有二值化
绝对值距离,Euclid距离等 若数据已经二值化
Hamming距离(绝对值距离)
Jaccard距离 d m2 m1 m2
d m2
格,单独列表。
符号说明
Ai :第i个碎片对应的灰度矩阵,阶数为p*q Aibw:第i个碎片对应的二值化矩阵,阶数为p*q dij :碎片j拼接在碎片i后的匹配距离 aibw :第i个碎片对应二值化矩阵按行求平均值后
的向量,阶数为p*1
模型假设
1.假设需要复原的碎片是来自同一张纸,且对于该张 纸具有完备性。 2.假设同一页中,文字的种类、颜色、行间距,段落 分布情况和背景颜色是相同的。
问题1:仅有纵切的情形
建模思想二 转化为旅行商问题(TSP)
旅行商问题
有一个推销员,从城市 1 出发,要遍访城市 2, 3,…,n各一次,最后返 回城市 1。已知从城市
i到j的旅费为 cij ,问他应
按怎样的次序访问这些城 市,使得总旅费最少?
1
2
3
4
5
旅行商问题(TSP)的规划模型
min z cij xij
碎纸片拼接复原的数学方法
2013年B题:碎纸片的拼接复原
破碎文件的拼接在司法物证复原、历史文 献修复以及军事情报获取等领域都有着重要的 应用。传统上,拼接复原工作需由人工完成, 准确率较高,但效率很低。特别是当碎片数量 巨大,人工拼接很难在短时间内完成任务。随 着计算机技术的发展,人们试图开发碎纸片的 自动拼接技术,以提高拼接复原效率。请讨论 以下问题:
碎纸片拼接复原的数学方法

碎纸片拼接复原的数学方法拼图游戏,一种看似简单却富含深度的游戏,给人们带来了无穷的乐趣。
然而,大家是否想过,这样的游戏其实与数学有着密切的?让我们一起探索碎纸片拼接复原背后的数学方法。
碎纸片拼接复原,其实就是一个计算几何问题。
在数学领域,欧几里得几何和非欧几里得几何是两个基本而又重要的分支。
欧几里得几何主要研究的是在平面上两点之间的最短距离,这是我们日常生活中常见的几何学。
而非欧几里得几何则研究的是曲面上的几何学,这种几何学并不符合我们日常生活中的直觉。
碎纸片拼接复原的问题就是一种非欧几里得几何问题。
在计算机科学中,图论是研究图形和网络的基本理论。
其中,图形遍历算法可以用来解决碎纸片拼接复原问题。
这种算法的基本思想是:从一点出发,尽可能多地遍历整个图形,并在遍历的过程中对图形进行重建。
对于碎纸片拼接复原问题,我们可以将每一张碎纸片看作是图中的一个节点,当两张碎纸片拼接在一起时,它们就形成了一个边。
通过这种方式,我们可以将所有的碎纸片连接起来,形成一个完整的图形。
在计算机科学中,碎纸片拼接复原问题被广泛应用于图像处理、数据恢复等领域。
例如,在数字图像处理中,如果一张图片被切割成若干块,我们可以通过类似的方法来恢复原始的图片。
在数据恢复领域,当一个文件被删除或格式化时,我们也可以通过类似的方法来恢复文件。
碎纸片拼接复原的问题不仅是一个有趣的拼图游戏,更是一个涉及计算几何、图论等多个领域的数学问题。
通过运用这些数学方法,我们可以有效地解决这个问题,从而更好地理解和应用这些数学理论。
在我们的日常生活中,我们经常会遇到一些破碎的物品,例如碎镜子、破碎的瓷器,或是碎纸片等。
这些物品的复原过程都需要一种科学的方法来帮助他们重新拼接起来。
这种科学方法就是碎纸片拼接复原技术。
碎纸片拼接复原技术是一种基于数学模型的方法,它通过比较碎纸片边缘的形状、纹理、颜色等特征,来找到碎纸片之间的相似性和关联性,从而将它们拼接起来。
碎纸片自动拼接复原模型的实现
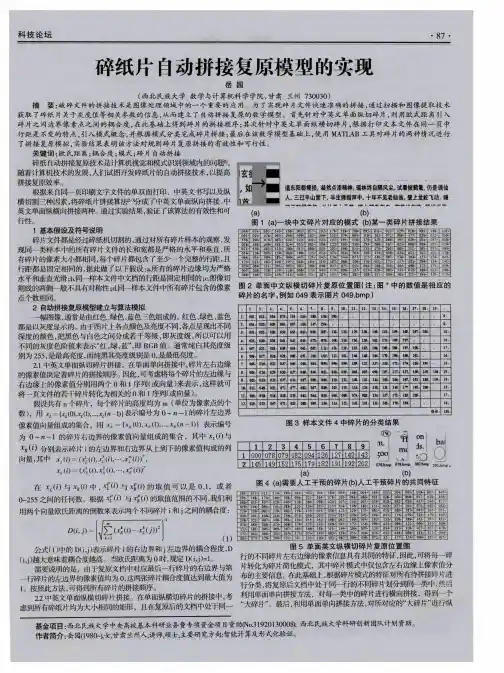
式) a =( a , 1 , …, 口 : ) 与a , =( 日 , 以 1一 , ), 我们定义相似度:
通过对图 中碎片的观察与分析 , 我们发现这些碎片具有共同的
特征。 如图 4 6 ) 中碎片上被标记的部分所示。 l 8 O ∑n 0 n 由图 4 6 ) 可以看出, 这些图片都是有一行 缺少英文字符 , 使得碎片 ( , Z ) 这些特殊的5 ' , -  ̄ l t 图片都是可以人工干预处理的。 ( 2 ) 对应的模式比较异常。 在 此基 础上 考虑 碎 片拼接 过程 , 先 对分 类 的碎 片左 右 拼接 , 匹配 仅 其中 为临界值。若 , x o 则我们认为 与 同属一类, 对于 在所在行匹配合成 。 上下匹配还要考虑行内其他元素的上下匹配。 合成 那些存在特殊情况的碎片 , 我们在分好类的基础上 , 再进行人工干预处 时整行都要合成。 综合考虑以上因素 , 我们对所有可以拼接的数据进行 理。c 同 类碎片拼接。 按照单面纵向拼接方法对每—类中的所有碎片进 拼接整 合 。( 图5 ) 行拼接 ,则可得到 同一类中碎片的拼接方案 ,进而得到横 向的 “ 大碎 在这里,处理特殊碎片需遵循 的原则 :以第二次拼接 的图片为底 片” 。c L 不同类“ 大碎片” 的拼接。“ 大碎片” 为横向的, 但此 问题- 仍 属于单 图, 剩下的 1 8 块依次和底图匹配 , 匹配原则包含经此处理之后便于观 面单向的拼接问题 , 因此可采用计算灰度值耦合度的方法进行拼接。 察整体拼接隋况, 但是拼接后在合成部分已做断开划线处理 , 这样便于 2 . 2 . 2英文单面纵横切碎片拼接。 考虑到英文的特殊 陛, 根据英文的 将剩下 的碎片进行拼接分析。 经过此次拼接过程 , 可以观察已组合部分 书写版式原则 , 可以将整篇文章放在带有英文四线格的底面中。 既然可 是否匹配正确 , 若不匹配 的话 , 可 以暂时先将那块碎片剔除, 放到第 三 以放在 四线格中, 这里我们把一行四线格看成一行, 可以确定每相邻行 部分再进行匹配组合。 碎片四边都要依次匹配 , 匹配度最高的就是缺少 的行间距是一定的。行宽也是一定的, 考虑字母仅占有上中、 中、 中下 、 块部分。按 以上方法对样本文件 4中的碎片进行拼接 ,结果见图 5所 上中下等几种情况 , 可 以确定每一个字母都是在中间有书写笔画的, 四 不 。 线格中上下行都具有英文笔画的是少数。 结束 语 基于这种考虑, 可以对每一行四线格的中间内容进行求和, 当其和 通过 研究 规 则切割 碎 纸片 的拼 接复原 问题 ,我们 针 对单 面 中英 文 的值小于某一值的时候我们忽略四线格上面和下面的内容 ,进而只考 纵向切割碎片以及单面中英文纵横双向切割碎片提 出了不同的拼接复 虑 四线 格 的中 间部 分 。 对 于那些 特殊 的碎 片 , 我们 可采用 人 工干预 的方 原模型以及方法。该方法将一张张碎片文件转换成 了一个个像素点值 式将其挑出, 所以将英文中四线格的上半部分和下半部分的内容忽略 , 矩阵, 对于计算机来说 , 碎片文件 的处理就变成了矩阵集合 的操作 ; 另 可以采取中文碎片模式转换的类似方法, 从而到英文碎片的模式。 外引入欧式距离将图像的拼接转化为耦合度的计算 ;接着考虑到印刷 3 实验 结果 及分析 文本文件的排版特点 , 引入模式识别的概念 , 可 以将大量杂乱碎片进行 实验是在 Mi c r o s o f t Wi n d o w s 7系统上进行 ,内存限定是 2 G B , 算 分类 , 然后逐类拼接 , 最终将双向拼接问题转化为单 向拼接问题 ; 最后 法实现语言为 M A T L A B 7 . 0版本。根据不同的样本文件使用相应的拼 所建立的模型效率好 , 精度高, 从实验结果上可以看 出该模型的可行性 接算 法 , 从 而得到 下面 的模拟 结果 。 和有 效 胜。 3 . 1 中英文单面纵切拼接实验。 样本文件 1 和2 分别为中英文单面 致谢 纵切碎片数据 ,其中每页纸被切为 1 9 条碎片 ,分别用 O 0 0 . b mp 一 0 1 8 . 感谢对此项研究工作提供基金资助的西北民族大学 中央高校基本 b mp 编号命名。利用 MA T L A B工具中的 自 带 函数 i m2 b w和 i m r e a d , 将 科研业务费专项资金 N o . 3 1 9 2 0 1 3 0 0 0 8 ) t ) 2 及西北民族大学科研创新 团 图像转化为仅包含 0和 1 的向量 ,接着根据中英文单面纵切算法可以 队计划 , 同时感谢参与本论文讨论的赵习猛 、 任宗秀和王本涛。 得到碎片的耦合度矩阵 , 由此可得样本文件 1 , 即中文单面纵切碎片的 参考 文献 拼接 复 利l 赙 为:
纸张撕碎重新复原的方法

纸张撕碎重新复原的方法
将纸张撕成小块后,可以试用以下方法重新复原:
1. 拼图法:根据纸张上的图案或文字的特征,将撕碎的纸张小块一一拼接在一起。
可以使用胶水或透明胶带将小块粘接在一起,直到整张纸张还原为完整的状态。
2. 粘贴法:将所有纸张小块按照纸张上的线条方向,粘贴在一张背景纸上。
根据纸张上的文字或图案特征,可以推测纸张的排列顺序。
3. 数字法:对每个纸张小块进行编号,然后根据编号重新排列纸张小块。
4. 计算机辅助法:使用扫描仪或相机将撕碎的纸张进行扫描或拍照,然后使用图像处理软件将图像还原,最后打印出完整的纸张。
请注意,纸张撕碎再复原的难度取决于撕碎的程度和纸张的特性。
有些纸张可能不易复原或需要特殊的技术手段,如复印纸、碎纸机处理后的纸张等。
碎纸片的拼接还原研究

碎纸片的拼接复原摘要碎纸片的拼接复原是一门借助计算机,把大量碎纸片重新拼接成初始纸张的技术。
针对问题一,本文首先利用碎纸片图像灰度矩阵的边缘矩阵,建立了两个碎纸片之间的匹配度函数,求得了每一张图片之间左右边缘匹配度矩阵。
然后根据左边边缘位置的碎片的左边空白部分最多的特点,确定了左边位置的碎纸片。
接着根据拼接碎纸片的拼接复原时,所有碎纸片匹配度之和取极大值的原则,采用贪心算法,得到了所有碎纸片的初始位置,拼接复原了附件1和附件2中纸片。
针对问题二,由于附件3碎片数量太多,并且碎片的拼接复原,是一个以碎纸片总匹配度为目标函数的组合优化问题。
所以本文采用遗传算法将碎纸片的编号作为基因,并将基因均匀分成19段,按顺序每一段对应一个初始纸片列位置,进行了求解。
然后,根据边缘碎纸片某些边的空白部分多的特征,对初始基因进行了优化。
接着,根据碎纸片的黑色像素密度不同的特点,将碎纸片分成三类,根据同类纸片优先匹配的原则,对遗传算法的运行过程进行了优化,拼接复原了附件3和附件4中纸片。
针对问题三,随着碎纸片量的增多,计算量急剧增加。
在上述拼接复原碎纸片的基础上,又引进了同行位置碎纸片的上部(或下部)空白位置宽度相近的聚类思想。
先对每个类内部拼接,在合并所有类并做一次整体拼接。
由于时间有限,我们未能完成最后一次的整体的拼接,但我们会在比赛后继续探究。
关键词:边缘矩阵匹配度函数遗传算法聚类一、问题重述碎片拼接实际用途已经越来越广泛,传统上拼接复原工作由人工完成,碎片拼接的准确率较高,但效率很低。
并且当碎片数量很大时,人工短时间内拼接出来几乎是不可能的。
所以开发碎纸的拼接技术,以提高拼接复原效率已成为越来越多人的期望。
现在,在碎纸片是规则的情况下,题目要求我们在以下条件建立碎纸片拼接复原模型和算法。
1.来自同一页印刷文字文件(中文、英文各一页)的碎纸机破碎纸片(仅纵切)拼接复原,并将附件1和附件2复原。
2.对碎纸机既纵切又横切文件的情形,将碎纸片拼接完整。
碎纸片的拼接复原分析最终

碎纸片的拼接复原分析最终引言碎纸片的拼接复原是一项有趣且具有挑战性的任务。
无论是为了还原重要文件还是拼接有意义的图像,我们都需要使用各种技巧和方法来完成这项任务。
本文将介绍一种基于分析的碎纸片拼接复原方法,通过对碎纸片的形状、颜色和纹理等特征进行分析,最终达到拼接复原的目标。
碎纸片的特征提取在进行碎纸片的拼接复原之前,首先需要提取碎纸片的特征。
这些特征包括碎纸片的形状、颜色和纹理等。
形状特征提取为了提取碎纸片的形状特征,可以通过计算碎纸片的边界和角度来获得。
首先,使用图像处理技术,如Canny边缘检测算法,将碎纸片的边缘提取出来。
然后,使用霍夫变换来检测碎纸片的直线和角点,从而计算出角度和边界。
颜色特征提取碎纸片的颜色特征可以通过计算图像的颜色直方图来得到。
颜色直方图表示了图像中每个颜色的像素数量。
我们可以使用像素级别的颜色分布来比较不同碎纸片的颜色特征,并找到相似的碎纸片来进行拼接。
纹理特征提取碎纸片的纹理特征可以通过计算图像的纹理描述符来得到。
纹理描述符是用于描述图像纹理的数值特征。
其中,最常用的纹理描述符包括灰度共生矩阵(GLCM)和局部二值模式(LBP)。
通过计算碎纸片的纹理描述符,我们可以比较不同碎纸片之间的纹理相似度,并选择相似的碎纸片进行拼接。
碎纸片的拼接策略在完成碎纸片特征提取后,接下来需要制定碎纸片的拼接策略。
拼接策略将基于碎纸片的特征相似度和拼接的整体目标来确定。
相似度匹配根据碎纸片的形状、颜色和纹理特征,我们可以计算两个碎纸片之间的相似度。
一种常用的相似度计算方法是使用余弦相似度,它衡量两个向量之间的夹角。
通过计算碎纸片之间的相似度,我们可以找到最相似的碎纸片来进行拼接。
拼接顺序在进行碎纸片的拼接时,需要制定一个拼接顺序。
一种常用的策略是首先选择与已拼接部分最相似的碎纸片进行拼接,然后逐渐增加已拼接部分的面积,直到最终完成拼接。
拼接约束为了保证拼接的准确性,我们需要制定一些拼接约束。
碎纸片的拼接复原的数学模型
碎纸片的拼接复原摘要本文主要采用了模糊模型识别、灰度相关、傅里叶变换等方法对碎纸自动拼接进行了深入探讨。
文中主要结合司法物证复原、历史文献修复、军事情报获取这一背景,针对横纵切碎自动拼接展开探究。
提出一种基于最大梯度和灰度相关的全景图拼接法。
同时采用边界提取法使图像预处理达到最好的效果,期间采用傅里叶变换对图像进行处理,最后再利用匹配准则等方法处理图像的拼接。
最终应用模糊模型识别法建立模型,通过隶属函数的建立实现最终的碎纸拼接。
期间有些碎纸片计算机无法识别,需要进行人工干预,从而才能得到一副完整的复原图。
图像拼接的主要工作流程可以概括为以下三个步骤:(1) 对图像碎片进行预处理,即对物体碎片数字化,得到碎片的数字图像。
(2) 图像碎片匹配,通过匹配算法找到相互匹配的图像碎片。
(3) 图像碎片的拼接合并,将相互匹配的图像碎片拼接在一起得到最终结果。
针对问题一:将图像导入MATLAB 进行相应的转化,由于数据量较大,所以对数据进行优化提取。
计算提取数据的均值与方差,找出其模糊集,建立符合题意的隶属函数。
由于模糊集的边界是模糊的,如果要把模糊概念转化为数学语言,需要选取不同的置信水平(01)λλ≤≤ 来确定其隶属关系,从而实现纵切图像的全景拼接。
(如表一、表二)针对于问题二:由于是横纵切碎纸片,所得图像较多,采用提取像素法对图片进行灰度分析,通过中介量阈值的确定来找出像素点的差别,梯度值在这一过程中也是作为衡量两张碎纸片是否匹配的标准。
从而对数据进行处理,最后导入MATLAB 软件实现拼接。
(如表三、表四)针对问题三:它是在问题一和问题二上加深了难度,采用提取像素点,傅里叶变换,灰度相关、模糊相似优先比等方法对问题进行分析,通过(0,1)矩阵的简化运算以及傅里叶变换得到最后的结果,但对于傅里叶变换需说明一点,变换之后的图像在原点平移之前四角是低频,最亮,平移之后中间是低频最亮,也就是说幅角比较大。
此过程中同时也需要人工干预,最终实现拼接。
碎纸片的拼接复原
碎纸片的拼接复原摘要本文研究了碎纸片的复原问题。
对已有的碎纸片,我们利用Matlab求碎纸片边各侧边线的灰度值,通过最小偏差平方和法进行碎纸片间的相互匹配,中间加入人工干预进行筛选,将附件中的碎纸片全部还原。
之后,我们将该方法进行推广,可用以处理更复杂形状碎图片的的还原问题。
对问题一:首先假定附件一所给仅纵切的碎纸片的行文方向与各碎纸片两侧边线垂直,在此基础上先人工干预,根据碎纸片的剪切规范,甄选出原始图片的第一张和最后一张碎纸片,编号分别为008和006。
其次通过Matlab求出图片边线处各小网格点的灰度值,采用最小偏差平方和法,对编号008碎片右边线处的灰度值和其它碎纸片的左边线处的灰度值进行对应网格点的数值匹配,找到最匹配的碎纸片。
附件二碎片的处理进行了类似处理,给出的复原图片见附表4。
对问题二:附件三文本既纵切又横切,同样我们假设所给附件三中碎纸片的行文方向与碎纸片的上下左右边线分别平行或垂直。
在问题一的算法基础上,通过Matlab求出各碎纸片的4条边线的边界灰度值,然后利用最小偏差平方和法,对上下左右四边进行灰度值匹配,当结果多个时,我们进行了人工干预。
附件四依照附件三的方法类似处理,最终的复原见附表7和附表9。
对问题三:附件五中的图片既纵切又横切而且是正反面。
我们参照问题一、二的处理方法,加入反面的灰度值测算,随机选择一张碎纸片与其他碎纸片进行遍历匹配,得出4张匹配的碎纸片后,以这4张碎纸片为下一起点,扩张匹配,最终给出的复原图见附表12。
为适应更一般的情形,我们在模型改进部分,给出了当碎纸片的文字行文方向与碎纸片两侧边线不垂直时的处理方法(只处理了边线为直线的情形)。
首先是通过测算出的碎纸片灰度值确定出碎纸片的边缘线,其次定出碎纸片边缘线附近网格点的灰度值,最后完成边线的的匹配。
关键词:人工干预灰度矩阵灰度值最小偏差平方和法一问题重述1.1问题背景纸片文字是人们获取和交换信息的主要媒介,尤其是在计算机技术飞速发展、数码产品日益普及的今天。
碎纸片拼接复原matlab程序
碎纸片拼接复原是一个有趣的图像处理问题,通常需要使用计算机视觉或图像处理技术。
下面是一个简单的 MATLAB 程序示例,用于演示碎纸片拼接复原的基本思路。
请注意,这只是一个简单的示例,实际应用中可能需要更复杂的算法和技术。
这个简单的 MATLAB 程序包含了三个函数:
1.shredImage: 将原始图像切成碎片。
2.shufflePieces: 随机打乱碎纸片的顺序。
3.reconstructImage: 进行拼接复原。
请注意,这只是一个基本的示例,实际应用中可能需要更复杂的图像处理技术,例如特征匹配、拼接算法等。
碎纸片的拼接复原数学模型的构建
碎纸片的拼接复原数学模型的构建摘要院本文讨论在碎纸机以不同方式破碎纸片的情况下建立碎纸片的拼接复原模型,以解决碎片数量巨大时人工拼接的难题,本文建立了三个具有针对性的模型。
模型一:方差分析法下的碎纸片拼接模型。
在以纵切方式破碎纸片的情况下,提取碎纸片左右边缘的灰度列向量,利用碎纸片边缘处为单边同宽空白区域的特殊性对碎纸片进行定位,再利用方差分析法和欧式距离解决了纵切碎纸片的拼接复原问题。
模型二:文字行间距一致性的碎纸片拼接模型。
以纵横方式破碎纸片,利用同行文字行间距一致性的主要特性可解决横向碎纸片的拼接复原问题,简化了模型,将离散的像素灰度矩阵平均化处理,进而利用欧氏距离对碎纸片进行匹配,得到了碎纸片复原后的完整图片。
模型三:二值化Otsu 算法的碎纸片拼接复原模型。
本文从双面纵横破碎纸片的问题出发,建立了纸片二值化Otsu 法拼接模型,先对碎纸片分组预处理,为将复杂模型简单化,再利用全局阈值方法中典型的Otsu 法求取碎纸片的最佳阈值,以该阈值对碎纸片中所含灰度值信息进行划分实现二值化处理,将边缘区域明显化,利用统计学方法求取拼接后的纸片间成功匹配的像素点占纸片边缘的概率,最终双面纵横破碎纸片的拼接复原问题得以解决。
Abstract: This paper discusses the construction of splicing scrap recovery model under the condition of shredder breaking paper intopieces in different ways, so as to solve the problem of artificial splicing when there is a great amount of pieces. This paper establishes threecorresponding model.Model One: Paper Scrap Splicing Model under Analysis of Variance.Shredding paper through longitudinal mode, the paper selects the gray scraps of paper around the edge extraction column vector,locates the paper scrap by using edge of paper scraps as blank area with same width, then solves the problem of reconstruction of thelongitudinal cutting paper splicing through analysis of variance method and Euclid Distance.Model Two: Paper Scrap Splicing Model with Consistency of Text Line Spacing.Shredding paper through vertical and horizontal mode, its main characteristics of peer text line spacing consistency can solve theproblem of reconstruction of splicing transverse paper scraps, simplifies the model, processes the pixel matrix of discrete in average andmatches the paper scraps through Euclid Distance and then gets the complete picture of paper scrap afterrecovery.Model Three: Paper Scrap Splicing Model Based on Binaryzation Otsu Algorithm.This paper firstly expounds the double side's vertical and horizontal mode, establishes the paper scrap splicing model based onbinaryzation Otsu algorithm. The paper firstly does preconditioning for paper scraps into groups, simplifies the complex model, and then getsthe optimal threshold of the paper scraps by using typical Otsu algorithm of global threshold method. The paper classifies the gray valueinformationof paper scraps through this threshold to realize binaryzation processing, specifies the edge area, evaluates the probability ofsuccessful matching pixels on edge of splicing paper, and finally solves the mosaic and restoration problems of double side's vertical andhorizontal mode.关键词院离散;方差分析;置信区间;阈值;Otsu 算法Key words: discrete;analysis of variance;confidence interval;threshold;Otsu algorithm中图分类号院TQ018 文献标识码院A 文章编号院1006-4311(2014)25-0238-031模型一考虑以为空间拼接情况,为了获取拼接图像所必须的数据,文章以像素为单位离散所得碎片:利用VC++使用了Windows.H 头文件并调用RGB 等结构定义获得不同像素点的g 值[1],生成了多个灰度矩阵。
关于碎纸片的拼接复原探讨
关于碎纸片的拼接复原探讨摘要对碎纸片进行还原与拼接,在我们的日常生活中具有重要的意义,特别是在对一些重要的领域如军事情报的获取以及历史文献的修复。
本文主要讨论了对破碎纸片进行自动拼接的复原技术,通过对破碎的纸片进行图像扫描后,得到了碎纸片的位图图像,用matlab对位图进行读取处理后,得到了图片文件的数据,图片的文件数据简单地说来,就是上面存储着一张图片各个像素点的灰度值的一个二维数组。
经过对图像进行中值滤波去噪的处理后,提取出每张图片的边缘灰度值,得到了一个边缘矩阵,通过对图片边缘的灰度值进行比较,找到差最小即为相匹配的图片,最后把找到相邻的图片进行拼接复原工作。
针对各个问题,建立了具体的模型来求解,最后得出碎纸片拼接复原的方法。
针对问题一,由于纸片只进行了纵向方向上的切割,所以我们只需要考虑其左右边缘的像素灰度值是否相吻合,如果纸片相吻合,则相邻的纸片灰度差的平方和应该为最小。
相吻合时我们把相邻的切片进行链接后拼接复原得到了原图形。
在分析过程中我们发现最边缘的一列下来是基本上是空白,因此在边缘矩阵提取找到值全只有255或者0的纸条,确定为起始的碎片。
以此张碎片为标准,拿其他的图片与其进行比较。
怎样才能算是相吻合的情况,我们根据边缘矩阵像素的灰度值来进行比较,如果碎片为相邻的情况,其边缘的像素值是连续的,由此我们把矩阵Y求出来后,进行比较找到最小值的列就是与其相匹配的碎纸片。
针对问题二,由于碎纸片既有纵切又有横切的情形,故我们除了要考虑纸片的左右边缘相互匹配的情况外还要考虑纸片上下边缘的匹配情况,即在问题一的基础上增加了对纸片上下边缘的像素灰度匹配的情形的考虑。
也就是增加多了两个矩阵U和B,分别保存每一张图片的第一行和最后一行的信息。
首先也是进行找到边缘的碎片片,因此我们在进行完左右纸片的拼接后,然后再考虑上下相邻纸片边缘的拼接情形。
这时可以用到问题一的模型来参照计算得出左右碎纸片的匹配情况,之后进行行的拼接。