
元数据驱动的异构数据模型双向映射策略
*
通信作者简介: 袁
满( 1965 —) 、 男、 黑龙江大庆人、 教授。研究方
mail: yuanman @ enpu. 向: 信息集成与分布式计算、 移动计算等。 Eedu. cn。
32 期
黄
等: 元数据驱动的异构数据模型双向映射策略 刚,
8751
定义 2 : 表级映射: 设定 Ts 为源数据库中的数 Tt 为来自目标数据库的数据表, Ts 与 Tt 之间 据表, , Tt) 。 使得 F’( Ts, 存在对应关系 F’ B 分别为来自源表 定义 3 : 字段级映射: 设定 A、 Ts 和目标表 Tt 的两个非空的字段集合, 若存在一个 对应规则 f, 使 A 字段集合中的字段 a i ( 1 < i < n ) 通 过转换 函 数 f 处 理, 有 B 字 段 集 合 中 的 字 段 bi = f( a i ) ,记为f( a i ,b i ) 。
图1
属性映射关系
模型结构越复杂, 对应字段的 模型结构息息相关, 映射关系越繁琐。 为了理清映射关系, 本文遵循确 定映射关系的步骤进行分析, 共整理出 13 种映射 关系。 2. 2 映射关系的表现形式 映射关系是通过数据映射规则表示的, 数据映 映 射规则是通过元数据的形式存储在数据库中的 , 射规则的描述采用映射规则模版的形式 , 解析模版 中的映射规则公式, 将解析的参数信息存储为对应 的元数据形式。映射规则公式中包含源字段、 目标 字段、 映射模式、 数据转换配置参数等元数据信息。 根据元数据对参与映射的数据源和映射规则的描 述, 实现映射规则的定义与维护工作 。 2. 3 双向映射关系描述 E&P 与 EPDM 数据库之间映射关系是双向性 的, 体现在映射过程中的双向映射描述 , 如图 2 所示 的源库与目标库之间的对应映射关系示意图 。 从 源库向目标库映射定制两套映射关系, 分别为正向 映射和逆向映射。
第 12 卷 第 32 期 2012 年 11 月 1671 — 1815 ( 2012 ) 32-8750-07
科
学
技
术
与
工
程
Science Technology and Engineering
Vol. 12 No. 32 Nov. 2012 2012 Sci. Tech. Engrg.
元数据驱动的异构数据模型双向映射策略
复合映射可以推广到多个映射的情况, 源数据通过 多次映射得到目标格式数据。 复合映射关系可以通过多于一次的转换处理 或通过多次间接引用的关系转换得到目标格式数 据的关系。在整个模型映射关系中, 虽然复合映射 关系占少数, 但在处理复合映射关系时需要更为全 面的考虑。 复合映射关系包括目标字段通过多次 参照目标表及源表获取字段的情况; 来自源数据表 的多个属 性 值 之 间 运 算 处 理 情 况 等 的 映 射 关 系。 例如目标数据表的多级自引用或多个具有继承关 系目标数据表字段的引用, 映射关系的复杂程度与
黄 刚
1
袁
满
1*
吴秀英
2
陈兴童
1
( 东北石油大学计算机与信息技术学院1 ,大庆 163318 ; 中国石油大庆石化公司信息技术中心2 ,大庆 163319 )
摘
要
重点研究异构数据模型间的映射关系, 并参考 ETL 框架思想, 设计了针对异构数据模型间数据映射 、 转换和加载于
一身的双向映射策略。分析并定义了数据模型间的映射关系与映射规则 。 基于元数据驱动理论方法设计了数据映射元模 型。并将映射关系按照复杂程度分类, 分为简单映射与复合映射关系 。 明确给出了分类原则。 还对双向映射关系进行了描 述, 并分析了双向映射中遇到的问题 。 关键词 元数据驱动 双向映射 异构数据模型 文献标志码 A 中图法分类号 TP311. 11 ;
[5 ] 例如国外的 Information Manifold 的数据集成系统,
1
映射关系定义
在文献
[8 ]
中给出了对映射关系的描述, 是指同
Piazza 系统、
[6 ]
系 统 以 及 国 内 的 Versatile 系 统 等。
一数据领域内, 存储相关数据的不同关系数据库数 据模型之间的对应关系。 定义 1 、 映射关系: 设定由一个三元组关系表示 S 代表源模型的所有实 映射关系 M = ( S,T,Σ ) , T 代表目标模型中的所有实例集合, 例集合, Σ 代表 < S, T > 之间的逻辑规则公式, 是源与目标之间元 totarget TupleGenerating De组 依 赖 关 系 Sourcependencies( 简称 st tgds 或 tgds) 的有限集合。 映射关系分为模式映射、 表级映射、 字段级映 射三个层次。 ST 为目标 定义 1 : 模式映射: 设定 SS 为源模式, 两模式间存在从 SS 向 ST 转换的对应关系 F, 模式, 记为 F( SS,ST) 。
数据映射是两个不同数据模型间建立数据元 素对应映射关系的过程
[1 ]
的构建方法。该系统提供了一个通用的查询接口, 提高了多数据源集成过程中的查询效率。 总之, 数 据映射的发展方向将不断融合先进的数据映射与 集成技术, 在数据映射阶段提高整个系统的可扩展 性、 灵活性、 易维护性及自动化的发展趋势。 本文 ETL 技术的应用与研究, 通过对元模型驱动技术、 并 对异构数据模型的分析, 提出了基于元数据驱动的 数据映射策略技术, 来解决异构关系模型间的双向 映射问题。
。 数据映射是建立特定
[2 ]
领域数据集成的首要步骤。 文献
中指出目前数
据集成项目所遇到的问题主要是建立模式映射 、 查 询优化与查询执行上, 但这些问题的核心和前提是 建立映射关系。 文献 确匹配问题。文献
[4 ] [3 ]
中的作者指出数据集成问
题面临的主要问题是异构数据源之间的数据的正 中的作者 P. Ziegler 在 2006 年 会议文章中提到, 数据集成项目索引中共包含 183 个项目, 其中包括目前已经结题或正在研究中的项 目。在整个发展过程中, 国内外有一些具有代表性
Information Manifold 系 统 的 作 者 在 国 际 会 议 ( Very Large Data Bases06 ) 中提出了一种关于映射关系的 — —本 地 视 图 映 射 ( LocalasView , 构 建 方 法— LAV) [7], 在以后构建映射的项目中广泛应用这样
面向多源异构数据库的SQL_解析与转换方法研究

第 22卷第 12期2023年 12月Vol.22 No.12Dec.2023软件导刊Software Guide面向多源异构数据库的SQL解析与转换方法研究练金栋1,陈志1,岳文静2,赵培1,3,吕伟初1,3(1.南京邮电大学计算机学院; 2.南京邮电大学通信与信息工程学院,江苏南京 210003;3.金篆信科有限责任公司,江苏南京 210012)摘要:传统的单一数据库模式难以适应如今多样化的数据管理需求。
如何将多个异构独立的数据库进行集成,对数据库系统进行整体控制和协同操作成为研究热点。
针对此问题进行面向多源异构数据库的SQL解析与转换方法研究,通过建立通用的中间表示模型,对异构数据库请求进行语法树解析、语义分析与模型转换,实现了不同数据库之间的互操作。
在基于TPC-H基准测试数据集的功能测试中,测试系统对数据类型和语法操作的支持度达到100%。
在性能测试中,测试系统在跨平台的增删改查操作时间上,较官方工具分别快了13.1 ms、8.8 ms、22.5 ms与2.3ms。
实验验证了该方法的正确性与可行性。
关键词:异构数据库;中间表示;语法解析;语法转换DOI:10.11907/rjdk.232028开放科学(资源服务)标识码(OSID):中图分类号:TP391 文献标识码:A 文章编号:1672-7800(2023)012-0124-08Research on SQL Parsing and Transformation Method for Multi-SourceHeterogeneous DatabaseLIAN Jindong1, CHEN Zhi1, YUE Wenjing2, ZHAO Pei1,3, LYU Weichu1,3(1.School of Computer Science, Nanjing University of Posts and Telecommunications;2.School of Communications and Information Engineering, Nanjing University of Posts and Telecommunications, Nanjing 210003, China;3.JINZHUAN Information Technology Co., Ltd., Nanjing 210012, China)Abstract:Nowadays, the traditional mode with single database has difficulty meeting with the demand of in diversified data management. The integration of multi-mode heterogeneous databases has become a research hotspot for overall control and collaborative operation of the global database system. Aiming at this problem, this paper studies the SQL parsing and transformation methods for heterogeneous databases. And in‐teroperability between different database has been achieved through universal intermediate-representation-model establishing,syntax tree parsing, semantic analysis and model transformation. In the functional test based on the TPC-H benchmark dataset, the frame-based test sys‐tem has 100% support for data types and syntax operations, while the framework has advantages over official tools in terms of operation speed for cross platform addition, deletion, modification, and query, with 13.1 ms, 8.8 ms, 22.5 ms, and 2.3 ms, respectively. The experiment ver‐ifies the correctness and feasibility of the proposed method.Key Words:heterogeneous database; intermediate representation; syntax parsing; grammar transformation0 引言随着数据量的爆发式增长,传统的单一数据库模式愈发难以满足存储和查询的实时性要求。
华阳集团企业级数据管理体系建设与应用实践研究

标准实践华阳集团企业级数据管理体系建设与应用实践研究■ 王 辉 邢 伟 曹 帅 阴鹏飞 史梦瑶 姜志萍 刘 佳 杨 敏(山西阳煤联创信息技术有限公司)摘 要:目前,根据不同的业务需求,数据库是独立设计和开发的。
数据的异构性和不共享性限制了数据资产的有效性。
本文介绍了华阳集团企业数据管理体系建设过程,描述了数据管理系统框架和数据治理系统框架,阐述了元数据、数据标准、数据质量、数据安全、数据模型、数据监管、数据生命周期管理、数据服务和数据分析算法等关键技术,重点展示了智能推荐、智能搜索、履约、智能问答、用户画像等企业数据资产与AI智能相结合的应用结果。
关键词:元数据,数据模型,算法,标准数据库,数据采集,智能检索,智能问答,用户画像DOI编码:10.3969/j.issn.1002-5944.2023.22.021Research on Construction and Application Practice of Enterprise DataManagement System in Huayang GroupWANG Hui XING Wei CAO Shuai YIN Peng-fei SHI Meng-yaoJIANG Zhi-ping LIU Jia YANG Min(Shanxi Yangmei Lianchuang Information Technology Co., Ltd.)Abstract:At present, databases are designed and developed independently according to different business requirements. The heterogeneity and non-sharing of data limit the effectiveness of data assets. This paper introduces the construction process of Huayang group enterprise data management system, describes the framework of data management system and data governance system, and expounds the key technologies such as metadata, data standards, data quality, data security, data model, data supervision, data life cycle management, data service and data analysis algorithm. It focuses on the application results of intelligent recommendation, intelligent search, contract performance, intelligent Q&A, user portrait and other enterprise data assets combined with AI intelligence.Keyword: metadata, data model, algorithm, standards database, data acquisition, intelligent retrieval, intelligent Q&A, user portrait0 引 言随着企业蓬勃发展,华阳集团致力于科技创新、数据驱动和企业转型优化的发展战略新思路,逐步形成“一主两翼七大板块”的产业格局。
面向多源异构数据的数据关联分析技术研究

面向多源异构数据的数据关联分析技术研究随着科技的不断进步和互联网的普及,数据量不断增加,各种数据呈现异构分布的情况越来越普遍。
如何将不同来源、格式和类型的数据整合起来,以提供更完整和精确的信息,成为了数据分析领域面临的重要问题之一。
本文将探讨面向多源异构数据的数据关联分析技术研究。
一、多源异构数据的特点与挑战多源异构数据,指的是来自不同系统、不同领域、不同格式的数据,如结构化数据、半结构化数据、非结构化数据等。
这些数据具有以下特点:1. 数据来源复杂。
不同数据来自不同业务系统、不同数据源、不同地区等,数据获取困难。
2. 数据格式多样。
不同数据有不同的格式,结构差异大,常常需要通过转换、映射等方式进行处理。
3. 数据质量参差不齐。
不同数据源的数据质量可能会有所不同,数据质量低下可能会影响关联分析的结果。
4. 数据量巨大。
随着数据量不断增加,数据关联分析的计算量也将大大增加。
这些特点都会对数据关联分析的效率、准确度、成本等方面带来挑战,因此,如何有效地整合和分析多源异构数据成为了数据分析领域研究的热点之一。
二、数据关联分析技术的研究现状数据关联分析是一种用于分析多个数据集之间相关性的技术,包括关联规则、聚类、分类、回归分析等方法。
针对多源异构数据的关联分析技术研究主要集中在以下几个方面:1. 数据预处理。
由于多源异构数据的差异性,数据预处理是进行数据关联分析的必要步骤。
常用的方法包括数据清洗、数据集成、数据转换、数据标准化等。
2. 特征选择。
在进行数据关联分析时,通常需要进行变量选择,即选择对结果影响较大的变量。
针对异构数据的特征选择主要是如何处理特征空间的不一致性。
3. 多距离度量。
不同类型的数据之间的距离定义方式是不同的。
多距离度量方法主要用于解决不同数据类型之间距离计算的问题。
4. 多模型融合。
不同数据类型可能需要不同的分析方法,多模型融合方法主要用于将不同的模型有效地融合起来。
三、面向多源异构数据的关联分析技术的应用场景面向多源异构数据的关联分析技术能够应用于众多领域,如金融、医疗、电商、社交网络等。
第12章元数据管理-DAMA-DMBOK:数据管理知识体系(第二版)
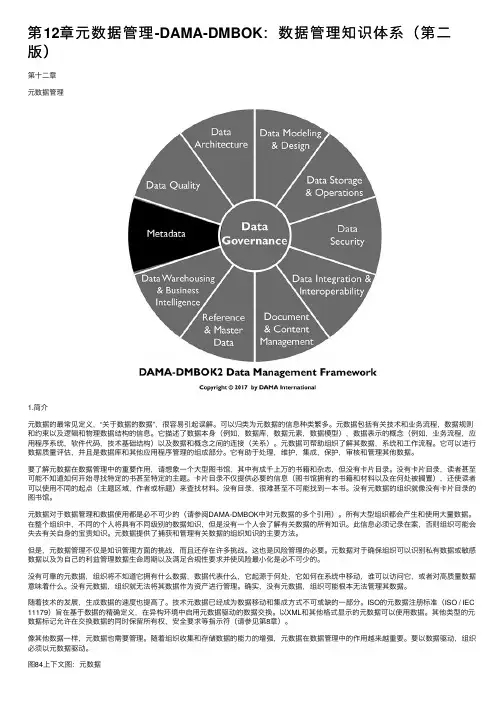
第12章元数据管理-DAMA-DMBOK:数据管理知识体系(第⼆版)第⼗⼆章元数据管理1.简介元数据的最常见定义,“关于数据的数据”,很容易引起误解。
可以归类为元数据的信息种类繁多。
元数据包括有关技术和业务流程,数据规则和约束以及逻辑和物理数据结构的信息。
它描述了数据本⾝(例如,数据库,数据元素,数据模型),数据表⽰的概念(例如,业务流程,应⽤程序系统,软件代码,技术基础结构)以及数据和概念之间的连接(关系)。
元数据可帮助组织了解其数据,系统和⼯作流程。
它可以进⾏数据质量评估,并且是数据库和其他应⽤程序管理的组成部分。
它有助于处理,维护,集成,保护,审核和管理其他数据。
要了解元数据在数据管理中的重要作⽤,请想象⼀个⼤型图书馆,其中有成千上万的书籍和杂志,但没有卡⽚⽬录。
没有卡⽚⽬录,读者甚⾄可能不知道如何开始寻找特定的书甚⾄特定的主题。
卡⽚⽬录不仅提供必要的信息(图书馆拥有的书籍和材料以及在何处被搁置),还使读者可以使⽤不同的起点(主题区域,作者或标题)来查找材料。
没有⽬录,很难甚⾄不可能找到⼀本书。
没有元数据的组织就像没有卡⽚⽬录的图书馆。
元数据对于数据管理和数据使⽤都是必不可少的(请参阅DAMA-DMBOK中对元数据的多个引⽤)。
所有⼤型组织都会产⽣和使⽤⼤量数据。
在整个组织中,不同的个⼈将具有不同级别的数据知识,但是没有⼀个⼈会了解有关数据的所有知识。
此信息必须记录在案,否则组织可能会失去有关⾃⾝的宝贵知识。
元数据提供了捕获和管理有关数据的组织知识的主要⽅法。
但是,元数据管理不仅是知识管理⽅⾯的挑战,⽽且还存在许多挑战。
这也是风险管理的必要。
元数据对于确保组织可以识别私有数据或敏感数据以及为⾃⼰的利益管理数据⽣命周期以及满⾜合规性要求并使风险最⼩化是必不可少的。
没有可靠的元数据,组织将不知道它拥有什么数据,数据代表什么,它起源于何处,它如何在系统中移动,谁可以访问它,或者对⾼质量数据意味着什么。
模型映射是什么原理的应用
模型映射是什么原理的应用什么是模型映射?在计算机科学中,模型映射是一种将一个数据模型(或对象模型)转换为另一个数据模型的过程。
它是软件开发中的重要概念,用于将不同的数据结构之间进行转换和交互。
在许多软件应用中,常常需要将数据从一种格式转换为另一种格式,或者在不同的模块之间传递数据。
模型映射就提供了一种方便的机制,使得我们可以轻松地在不同的模型之间进行转换。
模型映射原理模型映射的原理可以简单描述为以下几个步骤:1.定义源模型和目标模型:首先,我们需要明确源模型和目标模型的数据结构和字段。
源模型是数据的来源,而目标模型是需要转换到的数据结构。
2.建立映射规则:接下来,我们需要建立源模型和目标模型之间的映射规则。
这些规则描述了如何将源模型的字段映射到目标模型的字段。
3.执行转换操作:一旦建立了映射规则,我们可以开始执行转换操作。
此时,我们会遍历源模型中的每个实例,并根据映射规则将数据从源模型转换到目标模型。
4.验证和处理异常情况:在转换操作中,可能会出现一些异常情况,比如无法找到对应的映射规则,或者源模型和目标模型之间存在不兼容的数据类型。
在这种情况下,我们需要进行适当的处理,以确保数据的准确性和完整性。
模型映射的应用模型映射在软件开发中具有广泛的应用。
下面是一些常见的应用场景:数据库映射在使用数据库时,经常需要将数据从数据库表中读取并转换为对象或数据结构。
模型映射可以帮助我们快速地将数据库表的数据映射到对象模型中,使得数据访问更加方便。
API调用当我们调用外部API获取数据时,通常会将返回的数据映射到本地模型中。
这样做可以使得外部API的数据和本地数据模型保持一致,方便后续的处理和分析。
数据转换和整合不同的系统和应用程序可能使用不同的数据模型和数据格式。
在数据转换和整合的过程中,模型映射可以帮助我们将数据从一个模型转换为另一个模型,以实现系统之间的数据交互和整合。
表单数据转换在Web开发中,用户提交的表单数据通常以键值对的形式传递。
多源异构数据融合技术

多源异构数据融合技术多源异构数据融合技术是指将来自不同数据源、不同数据格式、不同数据类型的数据进行集成、转化、处理和分析,以得到更全面、准确、可靠、实用的信息和知识。
它是数据挖掘和大数据分析的基础和关键,也是实现智能化、数字化、网络化的重要手段和途径。
一、多源异构数据融合的意义和挑战1、意义多源异构数据融合的意义在于:(1)提高数据利用率和价值:通过将多个数据源的数据进行融合,可以得到更全面、准确、可靠、实用的信息和知识,从而提高数据利用率和价值,促进数据驱动的创新和发展。
(2)拓展数据应用场景和领域:通过将不同领域、不同类型、不同格式的数据进行融合,可以拓展数据应用场景和领域,为各行各业提供更多的数据支持和决策依据,推动跨领域、跨行业的合作和创新。
(3)增强数据安全和隐私保护:通过对多源异构数据进行融合,可以更好地掌握数据的流向、使用和保护,增强数据安全和隐私保护,防止数据泄露、滥用和侵权。
2、挑战多源异构数据融合的挑战主要包括:(1)数据质量问题:不同数据源的数据质量可能存在差异,如格式不一致、精度不同、完整性不足、一致性不强等,需要进行数据清洗、校验和修复。
(2)数据集成问题:不同数据源的数据可能存在重复、冗余、不完整等情况,需要进行数据集成和去重,保证数据的一致性和完整性。
(3)数据转化问题:不同数据源的数据格式和类型可能不同,需要进行数据转化和映射,以便进行统一的数据分析和处理。
(4)数据安全和隐私问题:多源异构数据的融合可能涉及敏感信息和个人隐私,需要采取有效的数据保护措施,保障数据安全和隐私。
二、多源异构数据融合的方法和技术多源异构数据融合的方法和技术主要包括:1、数据清洗和预处理数据清洗和预处理是多源异构数据融合的基础和前提,它包括数据去重、数据校验、数据修复、数据转化等处理过程,以保证数据的质量和一致性。
2、数据集成和整合数据集成和整合是将多个数据源的数据进行整合和融合的过程,它包括数据匹配、数据映射、数据转换、数据合并等处理过程,以得到更全面、准确、可靠的数据。
多源异构数据资源的统一表征与融合管理机制_概述及解释说明
多源异构数据资源的统一表征与融合管理机制概述及解释说明1. 引言1.1 概述多源异构数据的统一表征与融合管理机制是当前信息时代面临的一个重要问题。
随着信息技术的快速发展和互联网的普及,越来越多的数据以各种形式和结构存在于多个不同的来源和格式中。
这些数据资源具有不同的数据类型、语义、存储结构和访问接口,给数据集成、共享和利用带来了巨大困难。
为了有效地整合这些多源异构数据资源,需要一种统一的表征方法和融合管理机制,以确保不同数据源之间的相互理解和无缝协作。
本文旨在探讨如何进行多源异构数据资源的统一表征与融合管理,从而提高对复杂数据资源的整体理解能力。
1.2 文章结构本篇文章按照以下结构组织内容:引言部分介绍了多源异构数据资源统一表征与融合管理的概述,并明确了文章撰写目标;第二部分详细探讨了多源异构数据资源统一表征与融合管理机制相关内容;第三部分介绍了规范化数据表征方法与模型选择;第四部分则从技术和实践角度对多源数据融合管理进行了深入分析和案例研究;最后的结论部分总结了本文的主要研究成果,并展望了未来发展方向。
1.3 目的本文的目的是介绍多源异构数据资源统一表征与融合管理机制的重要性、挑战以及应用场景。
通过探讨数据标准化基本概念、常见数据表征方法的优缺点,以及模型选择与适配策略的探讨,读者将能够更好地理解多源异构数据资源的统一表征与融合管理机制。
在介绍数据预处理与清洗技术、数据集成与匹配算法研究现状,以及面向多源异构数据融合的管控策略设计和实施案例分析之后,读者将能够了解到多源异构数据融合管理技术在实践中的应用情况。
最后,通过对主要研究成果总结和存在问题与未来发展方向的展望,我们希望为进一步推动多源异构数据资源统一表征与融合管理机制的发展提供参考和思路。
2. 多源异构数据资源的统一表征与融合管理机制2.1 数据资源的多样性与异构性介绍在当前数字化时代,各种组织和个体产生了大量的数据资源,这些数据资源具有多样性和异构性。
面向多源异构数据的表示学习方法
面向多源异构数据的表示学习方法在当今信息爆炸的时代,各种异构数据以快速增长的趋势被广泛生成和使用,例如文本、图像、音频和视频等。
不同类型的数据通常存在于不同的领域,并且往往具有不同的特征表示方式。
由于这些数据的差异性,如何有效地将多源异构数据进行表示学习成为一个重要的问题。
本文将介绍一些面向多源异构数据的表示学习方法,并探讨它们在不同领域中的应用。
1. 异构数据的表示学习意义在传统的数据处理中,往往需要手动设计特征提取的算法,然后将数据映射到特征空间中。
然而,对于多源异构数据而言,不同的数据类型往往需要不同的特征表达方式。
而传统的手动设计特征提取算法往往需要专家领域知识以及大量的时间和资源。
因此,面向多源异构数据的表示学习方法的出现具有重要意义。
通过表示学习,我们可以自动地从多源异构数据中学习到具有较好表达能力的特征。
这些特征能够更好地捕捉数据的内在分布和结构信息,为后续的数据分析和应用提供更好的基础。
因此,开展面向多源异构数据的表示学习方法的研究具有重要的理论和应用意义。
2. 同源和异源数据的表示学习方法在多源异构数据的表示学习中,一种常见的情况是存在同源和异源数据。
同源数据指的是来自不同数据源但仍然属于同一领域的数据,例如来自不同维度的图像。
异源数据则指的是来自不同领域的数据,例如图像和文本数据。
针对同源数据,我们可以使用传统的深度学习方法,例如卷积神经网络(CNN)和循环神经网络(RNN)等,来进行特征提取。
这些方法可以在同一领域的不同维度数据上进行共享参数的训练,从而获得具有较好表达能力的特征表示。
而对于异源数据,我们需要考虑特征融合的问题。
一种常用的方法是基于神经网络的跨模态学习,通过构建多个分支网络来分别学习不同模态数据的特征表示,并通过特定的融合方法将这些特征进行结合。
还有一些方法是基于主题模型和矩阵分解等技术,将异构数据映射到低维的表示空间中,并利用融合算法将它们进行整合。
3. 多源异构数据表示学习的应用场景面向多源异构数据的表示学习方法在各个领域都有广泛的应用。
异构数据库技术的研究与实践
异构数据库技术的研究与实践异构数据库技术,是指不同类型、不同结构的数据库系统之间进行融合、整合、共享的技术。
它具有很高价值和实用性,近年来已得到广泛应用。
本文将从异构数据库技术的基本概念、应用场景、关键技术、发展趋势等方面进行论述,以期使读者对异构数据库技术有更加深入的了解。
一、异构数据库技术的基本概念异构数据库技术是多个不同型号、不同结构的数据库之间进行交互、共享、集成的技术。
异构数据库的实现需要解决如下问题:数据的语意(Semantic)和结构(Structure)的描述方法、异构数据的逻辑互操作能力、异构数据的物理互操作能力等问题。
异构数据库技术是解决异构数据集成问题的有效手段。
异构数据集成的大部分问题是由于不同组织机构、不同应用系统、不同数据库管理系统中所使用的数据模型、数据结构、数据语言不同所造成的,这些问题可以通过合理运用异构数据库的技术来解决。
二、异构数据库技术的应用场景异构数据库技术适用于以下应用领域:1、数据库整合异构数据库技术可以将多个类型、多个结构的数据库进行整合,从而形成一个大型的复合数据库。
通过异构数据库技术,可以实现异构数据库之间的数据共享和互通,减少了信息孤岛,提高了数据共享利用率。
2、异构数据的共享随着信息化进程的不断发展,数据库中的数据已经具有了很高的价值,而很多企事业单位内部的数据库多为异构数据库,无法进行互通和共享。
通过异构数据库技术,可以将分散在不同数据库之中的数据整合起来进行管理和查询,提高了数据的共享利用率。
3、数据挖掘数据挖掘是从大量的数据中发现有价值的知识和信息的过程。
异构数据库中存储了大量的数据,通过异构数据库技术,可以将这些数据矿藏挖掘出来,获取更多的商业价值和决策支持信息。
4、数据集成异构数据库技术可以将不同数据源的数据进行集成,从而形成一个统一的数据源。
通过数据集成,可以最大限度地充分利用各个数据源的有用信息,进而为决策者提供更为准确的决策支持信息。
基于元数据驱动的异构数据模型映射算法
s l e aa t n fr n . ov sd t r s r g a ei Ke wo d Daa c n e so ;Me a aa d v n;E L;Ma p n c e s y rs t o v ri n t d t- r e i T p i g s h ma
目前 , 企业 f趋信 息化 、 准化的发展方 向 , 3 标 决定 当前企 业 中的大 量生产信息及管理数据 的集成与转换成为亟待解决 的问题 。由于石油领域 生产 、 管理 、 研上地域 分散 的特 点 , 科 使得企业 内存 在大 量采用不 同数 据库存储 的异构数 据 , 各个 企业应用 之间存在信 息壁垒 , 阻碍信 息之 间的共 享 。完 整的 数据迁移 系统 包括 数据 抽取 、 据转换 和数 据加 载… , 数 当前 的迁移方法包括 : ①利用 Pw ru dr o e i e 的数据管道 ( aaPp — Bl D t ie Ln ) 术 J 数 据 窗 口( aa n o s 和 动 态 S L语 句 实 ie 技 、 D t dw ) Wi Q 现 。数据管道技术虽然简单 , 』 但对于 大量且模 型结构 复杂 的数据 , 不提供纠错 和质量控 制机 制 ; 采用 动态 S L语 句虽 Q 然适用范 围广 , 在进行迁 移过程 中, 于数 据模 型复杂或数 但 对 据量庞大 的情况 , 使迁移任务 繁琐且效率低下 , 缺少可视化操 作界面 。②采用源数据库 自带的导出工 具和 目标 数据库的导 人工具 , 中间需要 经过必要 的转换处理 ; 采用手工迁移和数据 库 自带工具进行迁移需 要编写大 量辅助程 序 , 求迁 移人员 要 对源库与 目标库的结构 和业务规则 有 比较透 彻的 了解 , 加 增 了用户 的工作 量。③采 用已有 的一些数 据迁移 软件 , S L 如 Q