
基于案例讲解Storm实时流计算
Storm简介 Storm的主要特点 Storm组件 Storm编程模型 Storm安装 Storm实例讲解
电商实时推荐 淘宝双十一实时销售额统计
车辆7*24小时监控
电信行业重大节假日实时保障监控
1. Storm是一个分布式的、容错的实时计算系统,它采用Clojure编写的 2. Storm可被用于“流处理”之中,实时处理消息并更新数据库 3. Storm可以进行连续查询并把结果即时反馈给客户,比如将Twitter上 的热门话题发送到客户端 4. Storm可以用来并行处理密集查询,Storm的拓扑结构是一个等待调 用信息的分布函数,当它收到一条调用信息后,会对查询进行计算,并 返回查询结果。
1.简单的编程模型。类似于MapReduce降低了并行批处理复杂性,Storm 降低了进行实时处理的复杂性。 2.可以使用各种编程语言。你可以在Storm之上使用各种编程语言。默认支 持Clojure、Java、Ruby和Python。
3.水平扩展。计算是在多个线程、进程和服务器之间并行进行的。
4.可靠的消息处理。Storm保证每个消息至少能得到一次完整处理。任务失 败时,它会负责从消息源重试消息。 5.快速。系统的设计保证了消息能得到快速的处理,使用ZeroMQ作为其底 层消息队列。 6.本地模式。Storm有一个“本地模式”,可以在处理过程中完全模拟 Storm集群。这让你可以快速进行开发和单元测试。
Bolt
可实现接口IBolt,或BaseRichbolt
主要方法:
IBolt继承了java.io.Serializable,我们在nimbus上提交了topology以后,创建出来的bolt会序列化后发送到具体 执行的worker上去。worker在执行该Bolt时,会先调用prepare方法传入当前执行的上下文execute接受一个tuple 进行处理,并用prepare方法传入的OutputCollector的ack方法(表示成功)或fail(表示失败)来反馈处理结果 cleanup 同ISpout的close方法,在关闭前调用。同样不保证其一定执行 execute 最重要的方法,用来处理自己的业务逻辑
<=120 实时监控超速车辆 在高速上,速度 是否>120
>120
存入超 速数据 库
Spout 数据源
是否在高速 上 >80 不在高速上,速 度是否>80 <=80
Spout
简而言之,Spout从来源处读取数据并放入topology。 Spout分成可靠和不可靠两种;当Storm接收失败时,可靠的Spout会对 tuple(元组,数据 项组成的列表)进行重发;而不可靠的Spout不会考虑接收成功与否只发射一次。而Spout中 最主要的方法就是 nextTuple(),该方法会发射一个新的tuple到topology,如果没有新 tuple发射则会简单的返回一个Topology是由Spout组件(数据源)和Bolt组件(数据操作)通过 Stream
mq
Spout从mq中 接受订单信息
MergeBolt汇 总,写入 Mysql
前台界面 展示,每 30秒查一 次数据库
仿淘宝双十一实时监控销售额
1.从activemq中接受订单信息(数据格式:用户id|时间|金额|商品id|商家id)
仿淘宝双十一实时监控销售额
2.计算订单金额,一分钟输出一次
仿淘宝双十一实时监控销售额 3.合并计算结果,并写入mysql
仿淘宝双十一实时监控销售额 本地测试与部署
集群部署 storm jar storm_taobao.jar com.wxj.taobao.TaoBaoTopology taobao_double11_bill_topology
Q& Grouping
Stream Grouping定义了一个流在Bolt任务间该如何被切分。 随机分组(Shuffle grouping):随机分发tuple到Bolt的任务,保证每个任务获得相等数量的tuple。 字段分组(Fields grouping):根据指定字段分割数据流,并分组。例如,根据“user-id”字段,相同 “user-id”的元组总是分发到同一个任务,不同“user-id”的元组可能分发到不同的任务。 全部分组(All grouping):tuple被复制到bolt的所有任务。这种类型需要谨慎使用。 全局分组(Global grouping):全部流都分配到bolt的同一个任务。明确地说,是分配给ID最小的那个 task。 无分组(None grouping):你不需要关心流是如何分组。目前,无分组等效于随机分组。但最终, Storm将把无分组的Bolts放到Bolts或Spouts订阅它们的同一线程去执行(如果可能)。 直接分组(Direct grouping):这是一个特别的分组类型。元组生产者决定tuple由哪个元组处理者任务 接收。 当然还可以实现CustomStreamGroupimg接口来定制自己需要的分组。
数据处理完就结束 一旦运行,根本停 不下来。。。
Nimbus:负责资源分配和任务调度。 Supervisor:负责接受nimbus分配的任务,启动和停止属于自己管理的worker进程。 Worker:运行具体处理组件逻辑的进程。 Task:worker中每一个spout/bolt的线程称为一个task. 在storm0.8之后,task不再与物理线 程对应,同一个spout/bolt的task可能会共享一个物理线程,该线程称为executor。
首先我们通过一个 storm 和hadoop的对比来了解storm中的基本概念。
hadoop Jobtracker 系统角色 Tasktracker Child 应用名称 组件接口 运行状态 Job M/R storm Nimbus Supervisor Worker Topology Spout/Bolt
Bolt
Topology中所有的处理都由Bolt完成。
Bolt可以完成任何事,比如:连接的过滤、聚合、访问文件/数据库、等等。 Bolt从Spout中接收数据并进行处理,如果遇到复杂流的处理也可能将tuple发送给另一个 Bolt进行处理。而Bolt中最重要的方法是execute(),以新的tuple作为参数接收。不管是 Spout还是Bolt,如果将tuple发射成多个流,这些流都可以通过declareStream()来声明。
Spout
可实现接口Ispout,或继承BaseSpout
主要方法:
open方法是初始化动作。允许你在该spout初始化时做一些动作,传入了上下文,方便取上下文的一些数据。 close方法在该spout关闭前执行,但是并不能得到保证其一定被执行。spout是作为task运行在 worker内,在 cluster模式下,supervisor会直接kill -9 woker的进程,这样它就无法执行了。而在本地模式下,只要不是kill -9, 如果是发送停止命令,是可以保证close的执行的。 activate和deactivate :一个spout可以被暂时激活和关闭,这两个方法分别在对应的时刻被调用。 nextTuple 用来发射数据。 ack(Object) 传入的Object其实是一个id,唯一表示一个tuple。该方法是这个id所对应的tuple被成功处理后执行。 fail(Object) 同ack,只不过是tuple处理失败时执行。 declareOutputFields 申明要发射的字段
下面这个图描述了以上几个角色之间的关系。
Supervisor zookeeper
主控节点,用于提 交任务,分配集群 任务,监控集群状 态
Supervisor Worker
Supervisor
zookeeper Supervisor Supervisor Supervisor
协调,存放集群的公共数据 (心跳,集群状态,配置信 息),Nimbus分配给Supervisor 的任务
仿淘宝双十一实时监控销售额
1.从activemq中接受订单信息(数据格式:用户id|时间|金额|商品id|商家id) 2.计算订单金额,一分钟输出一次
3.合并计算结果,并写入mysql CountBolt计算 金额
CountBolt计算 金额 CountBolt计算 金额 CountBolt计算 金额
Worker Worker
具体的处理 逻辑组件
Nimbus
zookeeper
接受Nimbus分配的任务,管 理自己的Worker进程
Topology
在storm中,应用程序的实现实时处理的逻辑被封装在Topology中
一个Topology是由Spout组件(数据源)和Bolt组件(数据操作)通过Stream Groupings进行连接的
declareOutputFields 申明要发射的字段
搭建Zookeeper集群 安装Storm依赖库(ZeromQ,JZMQ,JDK,Python)
下载并解压Storm发布版本
修改storm.yaml配置文件 启动Storm各个后台进程
Nimbus:bin/storm nimbus Supervisor:bin/storm supervisor UI:storm ui
Storm - 大数据Big Data实时处理架构
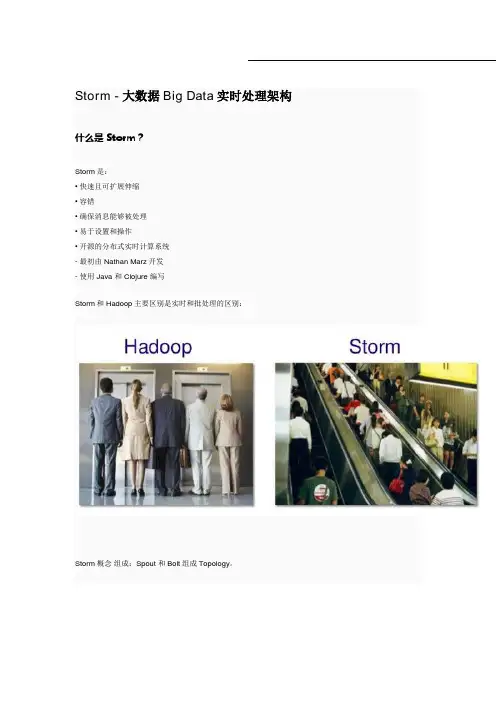
Storm - 大数据Big Data实时处理架构什么是Storm?Storm是:• 快速且可扩展伸缩• 容错• 确保消息能够被处理• 易于设置和操作• 开源的分布式实时计算系统- 最初由Nathan Marz开发- 使用Java 和 Clojure 编写Storm和Hadoop主要区别是实时和批处理的区别:Storm概念组成:Spout 和Bolt组成Topology。
Tuple是Storm的数据模型,如['jdon',12346]多个Tuple组成事件流:Spout是读取需要分析处理的数据源,然后转为Tuples,这些数据源可以是Web日志、 API调用、数据库等等。
Spout相当于事件流的生产者。
Bolt 处理Tuples然后再创建新的Tuples流,Bolt相当于事件流的消费者。
Bolt 作为真正业务处理者,主要实现大数据处理的核心功能,比如转换数据,应用相应过滤器,计算和聚合数据(比如统计总和等等) 。
以Twitter的某个Tweet为案例,看看Storm如何处理:这些tweett贴内容是:“No Small Cell Lung #Cancer(没有小细胞肺癌#癌症)” "An #OnCology Consult...."这些贴被Spout读取以后,产生Tuple,字段名是tweet,内容是"No Small Cell Lung #Cancer",格式类似:['No Small Cell Lung #Cancer',133221]。
然后进入被流消费者Bolt进行处理,第一个Bolt是SplitSentence,将tuple内容进行分离,结果成为:一个个单词:"No" "Small" "Cell" "Lung" "#Cancer" ;然后经过第二个Bolt进行过滤HashTagFilter处理,Hash标签是单词中用#标注的,也就是Cancer;再经过HasTagCount计数,可以本地内存缓存这个计数结果,最后通过PrinterBolt打印出标签单词统计结果。
分布式实时计算系统Storm

3/17
1956
Storm简介
Storm主要特点
– – – – – 编程模型简单。Storm降低了进行实时处理的复杂度 可扩展。计算是在多个线程、进程和服务器之间并行进行的 高可靠性。可保证每个消息至少能得到一次完整处理 高容错性。Storm会管理工作进程和节点的故障 支持多种编程语言。默认支持 Clojure 、 Java 、 Ruby 和 Python 。其它语言秩序实现一个简单的Storm通信协议即可 – 支持本地模式。可在处理过程中完全模拟Storm集群 – 高效。系统的设计保证了消息能得到快速处理
Storm简单应用—统计单词出现频率
具体实现
– 设计RaceSentenceSpout类
• Storm的Spout一般均实现了IRichSpout接口。其中open方法主要功能是 拓扑开始时的启动工作,nextTuple方法声明了Spout发送到下一级Bolt
的输出数据
public void open(Map conf, TopologyContext context, SpoutOutputCollector collector) { _collector = collector; ……
Storm主要适用场景
– 信息流处理
• 可用来实时处理源源不断流进来的数据,处理后将结果写入存储中。
如互联网的数据实时监控、微博热门话题发送到浏览器中等
– 分布式RPC
• 由于 Storm的处理组件是分布式的,而且处理延迟极低,所以可作为 一个通用的分布式 rpc框架来使用。当然,其实我们的搜索引擎本身 也是一个分布式rpc系统。
U e STC
14/17
1956
Storm简单应用—统计单词出现频率
Storm实时流处理框架PPT演讲
RPC。
RPC(RemoteProcedureCallProtocol)远程过程调用协议 参考: 1. /2012/12/storm入门教程-第一章-前言?spm=0.0.0.0.BuyqS9 《storm入门教程 第一章 前言》 2./tj/88ca09aa33002dsh.html?qq-pf-to=pcqq.c2c 《流处理框架Storm简介》
《Storm集群安装部署步骤【详细版】》
火龙果整理
SSH免密码配置
为使各台计算机间Zookeeper同步数据、应配置SSH免密码登录 1 确认本机sshd的配置文件(root) $ vi /etc/ssh/sshd_config 找到以下内容,并去掉注释符"#" RSAAuthentication yes PubkeyAuthentication yes AuthorizedKeysFile .ssh/authorized_keys 2 如果修改了配置文件需要重启sshd服务(root) $ vi /sbin/service sshd restart 3 ssh登陆系统 后执行测试命令 $ ssh localhost 回车会提示你输入密码,因为此时我们还没有生成证书。 4 生成证书公私钥 $ ssh-keygen -t dsa -P '' -f ~/.ssh/id_dsa $ cat ~/.ssh/id_dsa.pub >> ~/.ssh/authorized_keys
火龙果整理
安装Zeromq
jzmq的安装是依赖zeromq的,所以应该先装zeromq,再装jzmq。 # wget /zeromq-2.1.7.tar.gz # tar zxf zeromq-2.1.7.tar.gz # cd zeromq-2.1.7 # ./configure # make # make install # sudo ldconfig 2)安装jzmq
论Storm分布式实时计算工具

论Storm分布式实时计算工具作者:沈超邓彩凤来源:《中国科技纵横》2014年第03期【摘要】互联网的应用催生了一大批新的数据处理技术,storm分布式实时处理工具以其强大的数据处理能力、可靠性高、扩展性好等特点,在近几年得到越来越广泛的关注和应用。
【关键词】分布式实时计算流处理1 背景及特点互联网的应用正在越来越深入的改变人们的生活,互联网技术也在不断发展,尤其是大数据处理技术,过去的十年是大数据处理技术变革的十年,MapReduce,Hadoop以及一些相关的技术使得我们能处理的数据量比以前要大得多得多。
但是这些数据处理技术都不是实时的系统,或者说,它们设计的目的也不是为了实时计算。
没有什么办法可以简单地把hadoop变成一个实时计算系统。
实时数据处理系统和批量数据处理系统在需求上有着本质的差别。
然而大规模的实时数据处理已经越来越成为一种业务需求了,而缺少一个“实时版本的hadoop”已经成为数据处理整个生态系统的一个巨大缺失。
而storm的出现填补了这个缺失。
Storm出现之前,互联网技术人员可能需要自己手动维护一个由消息队列和消息处理者所组成的实时处理网络,消息处理者从消息队列取出一个消息进行处理,更新数据库,发送消息给其它队列等等。
不幸的是,这种方式有以下几个缺陷:单调乏味:技术人员花费了绝大部分开发时间去配置把消息发送到哪里,部署消息处理者,部署中间消息节点—设计者的大部分时间花在设计,配置这个数据处理框架上,而真正关心的消息处理逻辑在代码里面占的比例很少。
脆弱:不够健壮,设计者要自己写代码保证所有的消息处理者和消息队列正常运行。
伸缩性差:当一个消息处理者的消息量达到阀值,需要对这些数据进行分流,配置这些新的处理者以让他们处理分流的消息。
Storm定义了一批实时计算的原语。
如同hadoop大大简化了并行批量数据处理,storm的这些原语大大简化了并行实时数据处理。
storm的一些关键特性如下:适用场景广泛:storm可以用来处理消息和更新数据库(消息流处理),对一个数据量进行持续的查询并返回客户端(持续计算),对一个耗资源的查询作实时并行化的处理(分布式方法调用),storm的这些基础原语可以满足大量的场景。
基于storm的实时计算架构

应用场景@阿里巴巴
业务监控
效果监控中心
实时GMV 效果监控 实时流量 效果监控
推荐
网站实时推荐
首页实时推荐
店铺实时推荐
卖家360
买家实时活动
404页面实时推荐
Top likes/trends
实时访问动态 实时搜索动态
实时活动 效果监控
实时营销 效果监控
实时反馈动态 实时订阅动态
异常监控中心
日志异常实时报警 恶意点击 实时报警
配置服务 • 任务管理中心,直观反应当前任 务执行状态,能够中止、暂时、 重设任务 • 监控:系统(内存,cpu,网络, io等),功能(redis,meta, storm等),任务,数据质量 • storm集群管理
5.1 storm topology开发效率
简单统计场景(中文站UV,PV统计):
1.1 业务背景 • • • • • Big data数据量膨胀 业务快速变化,商业模式的创新 SNS,移动互联网 用户体验个性化,实时化 …
1.2 离线计算 vs. 流计算
From <IBM InfoSphere Streams: Harnessing Data in Motion>
1.3 数据分析演进趋势
message connector message adaptor
meta
MSC manager
supervisor bolt spout
nimbus
Data output service
file …
zookeper
DB
Engine state storage
Local buffer cache
Persistence storage
Storm分布式实时计算在物联网系统中的应用

事务处理过程:
程序部署:
1、生成JAR包 cd /opt/storm/jar/iot-flow-stat/source jar cfm ../iot-flow-stat.jar META-INF/MANIFEST.MF *
2、 topology发布 args[0] : topology名称 args[1] : NumWorkers args[2] : 1 表示最新,0表示最旧。 /opt/storm/apache-storm-1.0.3/bin/storm jar /opt/storm/jar/iot-flow-stat/iot-flow-
实时:数据不写磁盘,延迟低(毫秒级) 流式:不断有数据流入、处理、流出 开源:twitter开源,社区很活跃
1、简单的编程模型。类似于MapReduce降低了并行批处理复杂性, Storm降低了进行实时处理的复杂性。 2、可以使用各种编程语言。你可以在Storm之上使用各种编程语言。默 认支持Clojure、Java、Ruby和Python。 3、水平扩展。计算是在多个线程、进程和服务器之间并行进行的。
数据之间有关系(聚合等):如日志pv/uv统计、访问热点统计
N行日志
Client
N行日志
N行日志
ip
MQ
Spout
Bolt1
pv/uv
Bolt2
Storage
received
Ø 16年物联网卡流量数据通过日增量文件方式每天提供一次,流量数据当时使用 hadoop+spark(独立部署的集群,不是基于YARN)进行入库。内存消耗大、服务器 间数据交互不稳定,导致每天需要几个小时才能把全省流量数据清洗处理完入库, 流量数据整体延时在36小时到48小时左右。 Ø 17年为了缩短批量数据的时延,物联网平台与BOSS数据接口实现重大优化, BOSS提供海量物联网数据的实时订购关系、用户状态变化、流量数据(误差1M) 的实时推送。目前,归属广东移动的物联网卡活跃号码每天产生的流量话单数据大 概是48G左右。
大数据开发技术之Storm原理与实践
大数据开发技术之Storm原理与实践一、Storm简介1. 引例在介绍Storm之前,我们先看一个日志统计的例子:假如我们想要根据用户的访问日志统计使用斗鱼客户端的用大数据培训户的地域分布情况,一般情况下我们会分这几步:•取出访问日志中客户端的IP•把IP转换成对应地域•按照地域进行统计Hadoop貌似就可以轻松搞定:•map做ip提取,转换成地域•reduce以地域为key聚合,计数统计•从HDFS取出结果如果有时效性要求呢?•小时级:还行,每小时跑一个MapReduce Job•10分钟:还凑合能跑•5分钟:够呛了,等槽位可能要几分钟呢•1分钟:算了吧,启动Job就要几十秒呢•秒级:… 要满足秒级别的数据统计需求,需要•进程常驻运行;•数据在内存中Storm正好适合这种需求。
2. 特性Storm是一个分布式实时流式计算平台。
主要特性如下:•简单的编程模型:类似于MapReduce降低了并行批处理复杂性,Storm降低了实时处理的复杂性,只需实现几个接口即可(Spout实现ISpout接口,Bolt实现IBolt接口)。
•支持多种语言:你可以在Storm之上使用各种编程语言。
默认支持Clojure、Java、Ruby和Python。
要增加对其他语言的支持,只需实现一个简单的Storm通信协议即可。
•容错性:nimbus、supervisor都是无状态的, 可以用kill -9来杀死Nimbus和Supervisor进程, 然后再重启它们,任务照常进行; 当worker失败后, supervisor会尝试在本机重启它。
•分布式:计算是在多个线程、进程和服务器之间并行进行的。
•持久性、可靠性:消息被持久化到本地磁盘,并且支持数据备份防止数据丢失。
•可靠的消息处理:Storm保证每个消息至少能得到一次完整处理。
任务失败时,它会负责从消息源重试消息(ack机制)。
•快速、实时:Storm保证每个消息能能得到快速的处理。
流式计算strom,Strom解决的问题,实现实时计算系统要解决那些问题,离线计算是什么
流式计算strom,Strom解决的问题,实现实时计算系统要解决那些问题,离线计算是什么,流式计算什么,离线和实时计算区别,strom应用场景,Strorm架构图和编程模型(来自学习资料)1、背景-流式计算与storm2011年在海量数据处理领域,Hadoop是人们津津乐道的技术,Hadoop不仅可以用来存储海量数据,还以用来计算海量数据。
因为其高吞吐、高可靠等特点,很多互联网公司都已经使用Hadoop来构建数据仓库,高频使用并促进了Hadoop 生态圈的各项技术的发展。
一般来讲,根据业务需求,数据的处理可以分为离线处理和实时处理,在离线处理方面Hadoop提供了很好的解决方案,但是针对海量数据的实时处理却一直没有比较好的解决方案。
就在人们翘首以待的时间节点,storm横空出世,与生俱来的分布式、高可靠、高吞吐的特性,横扫市面上的一些流式计算框架,渐渐的成为了流式计算的首选框架。
如果庞麦郎在的话,他一定会说,这就是我要的滑板鞋!在2013年,阿里巴巴开源了基于storm的设计思路使用java重现编写的流式计算框架jstorm。
那jstorm是什么呢?在jstorm早期的介绍中,一般会出现下面的语句:JStorm 比Storm更稳定,更强大,更快,Storm上跑的程序,一行代码不变可以运行在JStorm上。
在最新的介绍中,jstorm的团队是这样介绍的:JStorm 是一个类似Hadoop MapReduce的系统,用户按照指定的接口实现一个任务,然后将这个任务递交给JStorm系统,Jstorm将这个任务跑起来,并且按7 * 24小时运行起来,一旦中间一个Worker 发生意外故障,调度器立即分配一个新的Worker 替换这个失效的Worker。
因此,从应用的角度,JStorm 应用是一种遵守某种编程规范的分布式应用。
从系统角度,JStorm一套类似MapReduce的调度系统。
从数据的角度,是一套基于流水线的消息处理机制。
基于案例讲解Storm实时流计算课件
实时监控超速车辆
在高速上,速度 是否>120
Spout 数据源
是否在高速 上
不在高速上,速 度是否>80
➢ 字段分组(Fields grouping):根据指定字段分割数据流,并分组。例如,根据“userid”字段,相同“user-id”的元组总是分发到同一个任务,不同“user-id”的元组可能分发 到不同的任务。
➢ 全部分组(All grouping):tuple被复制到bolt的所有任务。这种类型需要谨慎使用。 ➢ 全局分组(Global grouping):全部流都分配到bolt的同一个任务。明确地说,是分配
zookeeper
协调,存放集群的公共数据 (心跳,集群状态,配置信 息),Nimbus分配给Supervisor
的任务
Supervisor Supervisor
Worker Worker Worker
具体的处理 逻辑组件
接受Nimbus分配的任务,管 理自己的Worker进程
Storm组件
Topology
• 3.水平扩展。计算是在多个线程、进程和服务器之间并行进行的。 • 4.可靠的消息处理。Storm保证每个消息至少能得到一次完整处理。任
务失败时,它会负责从消息源重试消息。 • 5.快速。系统的设计保证了消息能得到快速的处理,使用ZeroMQ作为
其底层消息队列。 • 6.本地模式。Storm有一个“本地模式”,可以在处理过程中完全模拟
CountBolt计算 金额
实时计算Storm 核心技术及其在报文系统中的应用
实时计算Storm 核心技术及其在报文系统中的应用摘要1随着应用创新的层出不穷和数据类型的不断丰富,企业面对的数据量急剧增长,随之而来的实时处理需求给管理者和开发人员带来了多方面的困难。
一方面,源源不断的数据流带来了硬件成本增加、难以有效管控等诸多问题;另一方面,传统的数据批处理系统无法满足实时数据处理需求,服务延迟及业务连续性不佳等问题比较严重。
为解决上述问题,作为一个优秀的实时计算框架,Storm迅速在业界得到广泛应用与认可。
本文对Storm平台特点及其背后的核心技术进行了深入剖析,并结合公司实时服务现状,特别是现有的报文系统需求,得到了一个基于Storm 的、满足高并发及业务隔离要求的原型系统,以期对下一代报文系统的设计与实现提供帮助。
目录1. Storm及报文系统概述 (1)1.1 流式数据与Storm的诞生 (1)1.2 我司实时服务现状 (2)1.3 报文系统概述 (2)2. Storm关键技术 (3)2.1 系统架构 (3)2.1.1 调度系统 (3)2.1.2 通信模型 (5)2.2 拓扑与数据流 (6)2.2.1 Topology、Spout及Bolt (6)2.2.2 数据流Grouping策略 (9)2.3 Ack机制 (10)3. Storm中的高层机制 (11)3.1 事务处理 (11)3.2 Trident API (13)3.3 DRPC (14)4. 基于Storm的报文系统初探 (14)4.1 报文系统需求分析 (14)4.2 原型系统设计 (15)4.3 原型系统实现 (17)5. 总结与展望 (20)1. Storm及报文系统概述1.1 流式数据与Storm 的诞生随着互联网的高速发展,各类数据应用层出不穷,而数据除了规模的爆炸性增长之外,新的形态也不断涌现。
流式数据便是这些新型大数据中的一类典型。
与传统数据的静态、批处理和持久化不同,流式数据是连续、无边界且瞬间性的。