
统计分析方法实验课后习题
第四章实验二描述支付方式统计量标准误消费金额现金支付均值8.8392 .85657均值的 95% 置信区间下限7.1036上限10.57485% 修整均值8.6812中值7.4050方差27.881标准差 5.28024极小值 1.09极大值20.48范围19.39四分位距8.74偏度.435 .383峰度-.859 .750 个人支票均值42.7320 2.47003均值的 95% 置信区间下限37.7359上限47.72815% 修整均值42.7256中值41.3400方差244.043标准差15.62186极小值 2.67极大值78.16范围75.49四分位距21.88偏度-.033 .374峰度.267 .733 信用卡支付均值40.8768 3.17111均值的 95% 置信区间下限34.2821上限47.47155% 修整均值40.7751中值45.3300方差221.230标准差14.87382极小值14.44极大值69.77范围55.33四分位距25.98偏度-.117 .491 峰度-1.000 .953M-估计器支付方式Huber 的 M-估计器a Tukey 的双权重b Hampel 的 M-估计器cAndrews波d消费金额现金支付8.3486 8.4076 8.5938 8.4097个人支票42.6936 42.6233 42.7790 42.6423信用卡支付41.3742 41.4101 40.9178 41.4139a. 加权常量为 1.339。
b. 加权常量为 4.685。
c. 加权常量为 1.700、3.400 和 8.500d. 加权常量为 1.340*pi。
均值和M均值没有较大差异,说明数据中没有异常值由于样本是大样本,所以看Kolmogorov-Smirnov检验,个人支票Sig.值为0.2,现金支付和信用卡支付Sig.值都为0.088,大于0.05,接受原假设,即服从正态分布。
方差齐性检验Levene 统计量df1 df2 Sig.消费金额基于均值15.832 2 97 .000基于中值12.568 2 97 .000基于中值和带有调整后的 df12.568 2 68.577 .000基于修整均值15.940 2 97 .000由于P值均小于0.05,所以认为三组数据的方差不相等。
从茎叶图、Q-Q图等可以看出其较好的符合正态分布。
从箱体图可以看出各种支付方式不存在奇异值。
(图略)实验三卡方检验值df 渐进 Sig. (双侧)Pearson 卡方24.733a22 .310似然比23.435 22 .378有效案例中的 N 37a. 46 单元格(100.0%) 的期望计数少于 5。
最小期望计数为 .16。
从卡方检验的结果看出,各种检验方法的显著性水平均大于0.05,因此接受原假设,认为处分情况和上网时间是不相关的。
第五章实验一age * sexagesex 均值N 标准差男78.47 40 7.158女79.85 40 7.177总计79.16 80 7.155实验结果表明,女性的年龄平均比男性要高,但二者年龄的标准差大致相当,说明二者年龄的差异性大致相当。
age * areaagearea 均值N 标准差长江以北78.60 40 7.253长江以南79.73 40 7.104总计79.16 80 7.155实验结果表明,生活在长江以南的人的年龄平均比生活在长江以北的人的年龄要高,但二者年龄的标准差大致相当,说明二者年龄的差异性大致相当。
实验二单个样本统计量N 均值标准差均值的标准误纤度 6 1.4767 .07448 .03040实验结果表明。
双侧t检验的显著性水平Sig.取值为0.477,大于0.05,所以不拒绝原假设,即认为样本均值与总体均值没有显著的差异。
实验三组统计量激励方法N 均值标准差均值的标准误业绩增长dimension1甲7 17.0143 .63095 .23848 乙7 16.5143 .50474 .19077由表可得,甲乙两种激励方法业绩增长的均值差距不大,但标准差略有差距。
由表可得,方差方程的 Levene 检验的显著性水平为0.734,远大于0.05,所以认为两样本的方差是相等的,因此我们选择第一行的结果,由于t检验的显著性水平为0.128,大于0.05,所以不拒绝原假设,即认为两样本的均值是相等的,即甲乙两种激励方法的效果不存在显著性差异。
实验四成对样本统计量均值N 标准差均值的标准误对 1 卷A 149.60 20 2.542 .568由表可知,卷A结果的得分的均值与卷B结果的得分的均值大致相当,标准差也大致相当成对样本相关系数N 相关系数Sig.对 1 卷A & 卷B 20 .711 .000由表可知,t检验的显著性水平为0.130,大于0.05,即认为两套问卷所得结果的平均值没有显著差异。
第七章实验一描述性统计量均值标准差N投入人年数2144.387 1634.3769 31课题总数(当年)960.000 838.1887 31相关性投入人年数课题总数(当年)投入人年数Pearson 相关性 1 .959**显著性(双侧).000平方与叉积的和8.014E7 3.941E7协方差2671187.845 1313583.600N 31 31课题总数(当年)Pearson 相关性.959** 1显著性(双侧).000平方与叉积的和 3.941E7 2.108E7协方差1313583.600 702560.333N 31 31**. 在 .01 水平(双侧)上显著相关。
从表中可以看出Pearson相关系数为0.959,即课题总数与投入人年数的相关系数为0.959,双侧检验值为0.000,小于0.05,拒绝原假设,认为总体相关系数与0有显著差异,因此认为二者存在相关关系,由于0.959接近于1,所以认为二者存在较强的线性关系。
同理,课题总数与投入高级职称的人年数存在较强线性关系(相关系数0.944)课题总数与投入科研事业费存在较强线性关系(相关系数0.862)课题总数与专著数存在较强线性关系(相关系数0.868)课题总数与论文数存在较强线性关系(相关系数0.887)课题总数与获奖数不存在较强线性关系(相关系数0.665)实验二相关性控制变量城镇居民家庭人均消费城镇居民家庭人均可支配收入农村居民家庭人均纯收入-无-a城镇居民家庭人均消费相关性 1.000 .990 .990 显著性(双侧). .000 .000 df 0 14 14城镇居民家庭人均可支配收入相关性.990 1.000 .995 显著性(双侧).000 . .000 df 14 0 14农村居民家庭人均纯收入相关性.990 .995 1.000 显著性(双侧).000 .000 . df 14 14 0农村居民家庭人均纯收入城镇居民家庭人均消费相关性 1.000 .385显著性(双侧). .157df 0 13 城镇居民家庭人均可支配收入相关性.385 1.000显著性(双侧).157 .在一般相关分析下,城镇居民家庭人均消费与城镇居民家庭人均可支配收入相关系数取值为0.990,其Sig.值为0.000,小于0.01,说明二者相关性是显著的。
但在控制了农村居民家庭人均纯收入这个变量的偏相关分析下,乡姑纳西助威0.385,Sig.值为0.157,大于0.05,说明此事二者的相关性是不显著的。
同理城镇居民家庭人均消费与农村居民家庭人均纯收入在一般相关分析下相关性显著,偏相关分析下不显著。
输入/移去的变量b模型输入的变量移去的变量方法相关性控制变量城镇居民家庭人均消费农村居民家庭人均纯收入城镇居民家庭人均可支配收入-无-a城镇居民家庭人均消费相关性 1.000 .990 .990 显著性(双侧). .000 .000 df 0 14 14农村居民家庭人均纯收入相关性.990 1.000 .995 显著性(双侧).000 . .000 df 14 0 14城镇居民家庭人均可支配收入相关性.990 .995 1.000 显著性(双侧).000 .000 . df 14 14 0城镇居民家庭人均可支配收入城镇居民家庭人均消费相关性 1.000 .284显著性(双侧). .305df 0 13 农村居民家庭人均纯收入相关性.284 1.000显著性(双侧).305 .df 13 0a.单元格包含零阶 (Pearson) 相关。
、第八章实验一进入法下,五个变量都进入了。
从表中可以看出,本里的拟合优度是0.997.说明拟合程度非常高。
Anova b模型平方和df 均方 F Sig.1127.806 .000a1 回归 1.382E7 5 2763773.202残差24505.740 10 2450.574总计 1.384E7 15a. 预测变量: (常量), X5, X3, X4, X2, X1。
b. 因变量: Y从表中可以得到,回归模型的Sig.值接近0,说明该回归模型有显著的统计意义。
系数a模型非标准化系数标准系数 t Sig. 共线性统计量B标准 误差试用版 容差 VIF 1(常量)451.138 178.1272.533.030X1.354.085 2.447 4.151 .002 .001 1963.669X2 -.561 .125 -2.485-4.476.001 .001 1740.724X3 -.007 .002 -.083 -3.51.006 .3153.172X4 21.5774.031 .5315.353 .000 .018 55.490X5 .435 .052 .564 8.439 .000 .040 25.194a. 因变量: Y从表中可以看出,本里的拟合结果是Y=0.354X1-0.561X2-0.007X3+21.577X4+0.435X5+451.138,而且每个变量的系数的Sig.值都接近于0,说明每个系数都是有统计学意义的。
因此,就不进行共线性诊断了。
实验二经过结果分析,认为二次曲线的模型最符合实际,现将二次曲线模型拟合优度的检验结果进行分析。
其调整的判定系数值为0.600,说明模型的拟合效果很好。
从方差分析表中可以看出,其P 值为0,说明该模型具有显著的统计学意义。
系数从各系数的P值可知,各系数Sig.值都小于0.05,说明各系数具有显著的统计学意义。
因此我们可以得到拟合方程: Y=5.280+6.302X-3.996X^2其他两种(线性和三次方的模型)为什么不行的原因:线性也可以,但拟合优度为0.832,不如二次模型,所以二次模型更好。
而对于三次模型系数未标准化系数标准化系数t Sig.B 标准误BetaAdvertisingspending3.471 1.701 2.967 2.041 .055Advertisingspending ** 2-.422 .474 -2.663 -.891 .384Advertisingspending ** 3.015 .041 .603 .377 .710(常数) 3.283 1.811 1.813 .085其每个系数的Sig.值都大于0.05,且二次项和三次项还超出很多,说明其各系数并不具有统计学意义。
食品试验设计与统计分析习题答案【最新】

食品试验设计与统计分析习题答案【最新】食品试验设计与统计分析习题答案课程大纲:一、课程性质与目的本课程是为食品质量与安全专业本科生开设的专业基础选修课,通过本课程的学习将使学生掌握正确地收集、整理、分析数据的方法,培养学生分析问题和解决问题的能力,使学生能够独立进行试验设计,并能利用统计知识对试验结果进行正确的处理,为以后的学习打下必要的基础。
二、课程简介《食品试验设计与统计分析》是数理统计的原理和方法在食品科学研究中的应用,通过该门课程的学习,将学习到如何正确地收集、整理、分析数据,从而得出客观、科学的结论的方法,以及掌握基本的试验(调查)设计和统计分析方法,从而可以对食品科学研究中拟通过试验解决的具体问题提出科学而合理的试验方案,并用科学的统计方法进行数据处理,得出可靠的结论,从而为今后的工作和学习打下必要的基础。
三、教学内容第一章绪论(1学时)主要内容:介绍试验设计与统计分析课程的性质、地位及其重要性,介绍本门课程对今后学习及工作的影响;介绍食品科学试验的特点与要求。
学习要求:了解试验设计与统计分析在食品科学研究中的应用及发展概况;熟悉食品科学实验的特点与要求。
自学:试验设计与统计学发展概况。
第二章数据资料的整理与特征数(2.5学时)主要内容:统计常用术语概念;资料的分类及整理方法;常用统计表和统计图的绘制;资料特征数的计算;异常数据的检出。
学习要求:理解统计常用术语的含义;理解不同类型资料的性质并掌握资料的整理方法;掌握统计表和统计图的绘制;掌握资料特征数的计算方法;掌握异常数据的检出方法。
自学:部分统计表和统计图的绘制;部分异常数据的检出方法。
作业:课后习题。
第三章理论分布与抽样分布(2.5学时)主要内容:介绍有关随机变量的几种常用理论分布、平均数和均数差数的抽样分布及t分布。
学习要求:掌握常用理论分布的规律及相互间的关系;正确进行有关随机变量的概率计算;掌握t分布规律及其与标准正态分布的关系;理解均数标准误和均数差数标准误的意义,并掌握其计算方法。
《统计分析和SPSS的应用(第五版)》课后练习答案与解析(第5章)
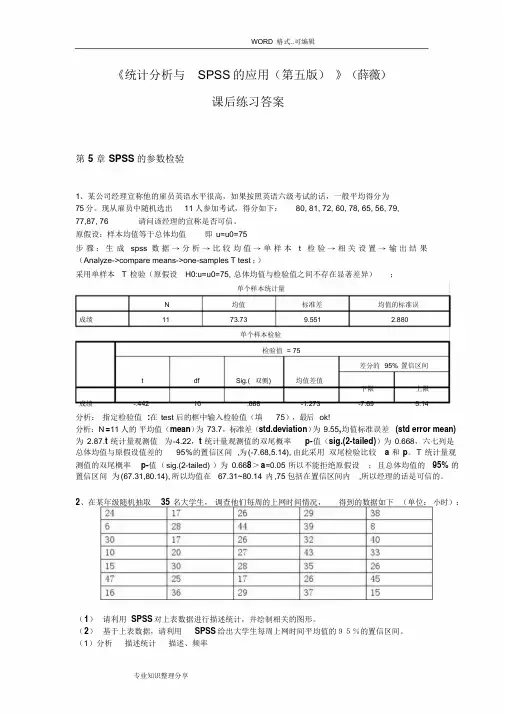
《统计分析与SPSS的应用(第五版)》(薛薇)课后练习答案第5 章SPSS的参数检验1、某公司经理宣称他的雇员英语水平很高,如果按照英语六级考试的话,一般平均得分为75分。
现从雇员中随机选出11人参加考试,得分如下:80, 81, 72, 60, 78, 65, 56, 79,77,87, 76 请问该经理的宣称是否可信。
原假设:样本均值等于总体均值即u=u0=75步骤:生成spss 数据→分析→比较均值→单样本t 检验→相关设置→输出结果(Analyze->compare means->one-samples T test ;)采用单样本T 检验(原假设H0:u=u0=75, 总体均值与检验值之间不存在显著差异);单个样本统计量N 均值标准差均值的标准误成绩11 73.73 9.551 2.880单个样本检验检验值= 75差分的95% 置信区间t df Sig.( 双侧) 均值差值下限上限成绩-.442 10 .668 -1.273 -7.69 5.14分析:指定检验值:在test 后的框中输入检验值(填75),最后ok!分析:N=11 人的平均值(mean)为73.7,标准差(std.deviation)为9.55,均值标准误差(std error mean) 为2.87.t 统计量观测值为-4.22,t 统计量观测值的双尾概率p-值(sig.(2-tailed))为0.668,六七列是总体均值与原假设值差的95%的置信区间,为(-7.68,5.14), 由此采用双尾检验比较 a 和p。
T 统计量观测值的双尾概率p-值(sig.(2-tailed) )为0.668>a=0.05 所以不能拒绝原假设;且总体均值的95% 的置信区间为(67.31,80.14), 所以均值在67.31~80.14 内,75 包括在置信区间内,所以经理的话是可信的。
2、在某年级随机抽取35 名大学生,调查他们每周的上网时间情况,得到的数据如下(单位:小时):(1)请利用SPSS 对上表数据进行描述统计,并绘制相关的图形。
试验统计分析方法

名词1 变量:数据所具有的变异特征或性。
2 观察值:变量所测得的具体观测数据,或每一个体的某一性状,特征的测定数据。
3 总体:具有共同性质的个体所组成的集体。
4 个体:总体中的一个成员。
5 样本:从总体中抽出的部分个体的总和。
即总体的一部分样本容量:样本中所包含的个体数目。
6 参数:由总体的全部观察值而算得的总体特征值。
7.统计数:由样本观察值而算得的样本特征数。
8. 算数平均数:指资料中各观察值总和除以观测值个数所得的商。
9. 中位数:将资料内所有观测值从小到大依次排列,位于中间的那个观测值。
10.众数:资料中出现次数最多的那个观测值或次数最多一组的组中值。
11.无偏估计量:当一个统计量的数学期望等于所估计的总体参数时则称此统计量为该总体参数的无偏估计量12.极差:指样本观察值中最大值与最小值之差,也称变异幅度或全距。
13.变异系数:标准差与平均数的百分率称为变异系数,记为C.V。
14.试验:通常我们把根据某一研究目的,在一定条件下对自然规律现象所进行的观察或试验统称为试验。
15.小概率原理:在统计学上,把小概率事件在一次试验中看成是实际不可能发生的事件称为小概率事件实际不可能性原理16.试验指标:为衡量试验结果的好坏或处理效应的高低,在试验中具体测定额性状或观测的项目。
17.试验因素:试验中所研究的影响试验指标的因素。
18.试验水平:试验因素所处的某种特定状态或数目等级。
19.试验处理:每一试验因素不同或多因素间的水平组合构成了实验处理。
20.L8(27):L代表正交表的符号 L右下角的数字“8”代表8行,包含8个处理(水平组合);“2”表示因素水平数,“7“表示有7列,用这张正交表最多可以安排7个2水平因素。
22.单一差异原则;除需要比较的因素外,其他因素都必须保持的相同的水平上23.β-错误:无效假设是错误的,备择假设是正确的,可是测验结果却接受了无效假设,这种错误称为第二类错误,即参数见本来有差异,可是测验结果却认为参数见无差异。
统计学第五版课后习题答案(完整版)

统计学(第五版)课后习题答案(完整版)第一章思考题1.1什么是统计学统计学是关于数据的一门学科,它收集,处理,分析,解释来自各个领域的数据并从中得出结论。
1.2解释描述统计和推断统计描述统计;它研究的是数据收集,处理,汇总,图表描述,概括与分析等统计方法。
推断统计;它是研究如何利用样本数据来推断总体特征的统计方法。
1.3统计学的类型和不同类型的特点统计数据;按所采用的计量尺度不同分;(定性数据)分类数据:只能归于某一类别的非数字型数据,它是对事物进行分类的结果,数据表现为类别,用文字来表述;(定性数据)顺序数据:只能归于某一有序类别的非数字型数据。
它也是有类别的,但这些类别是有序的。
(定量数据)数值型数据:按数字尺度测量的观察值,其结果表现为具体的数值。
统计数据;按统计数据都收集方法分;观测数据:是通过调查或观测而收集到的数据,这类数据是在没有对事物人为控制的条件下得到的。
实验数据:在实验中控制实验对象而收集到的数据。
统计数据;按被描述的现象与实践的关系分;截面数据:在相同或相似的时间点收集到的数据,也叫静态数据。
时间序列数据:按时间顺序收集到的,用于描述现象随时间变化的情况,也叫动态数据。
1.4解释分类数据,顺序数据和数值型数据答案同1.31.5举例说明总体,样本,参数,统计量,变量这几个概念对一千灯泡进行寿命测试,那么这千个灯泡就是总体,从中抽取一百个进行检测,这一百个灯泡的集合就是样本,这一千个灯泡的寿命的平均值和标准差还有合格率等描述特征的数值就是参数,这一百个灯泡的寿命的平均值和标准差还有合格率等描述特征的数值就是统计量,变量就是说明现象某种特征的概念,比如说灯泡的寿命。
1.6变量的分类变量可以分为分类变量,顺序变量,数值型变量。
变量也可以分为随机变量和非随机变量。
经验变量和理论变量。
1.7举例说明离散型变量和连续性变量离散型变量,只能取有限个值,取值以整数位断开,比如“企业数”连续型变量,取之连续不断,不能一一列举,比如“温度”。
统计分析与SPSS的应用(第五版)课后练习答案(第6章)

《统计分析与SPSS的应用(第五版)》(薛薇)课后练习答案第6章SPSS的方差分析1、入户推销有五种方法。
某大公司想比较这五种方法有无显著的效果差异,设计了一项实验。
从应聘人员中尚无推销经验的人员中随机挑选一部分人,并随机地将他们分为五个组,每组用一种推销方法培训。
一段时期后得到他们在一个月内的推销额,如下表所示:1)请利用单因素方差分析方法分析这五种推销方式是否存在显著差异。
2)绘制各组的均值对比图,并利用LSD方法进行多重比较检验。
(1)分析→比较均值→单因素ANOV A→因变量:销售额;因子:组别→确定。
ANOVA销售额平方和df 均方 F 显著性组之间405.534 4 101.384 11.276 .000组内269.737 30 8.991总计675.271 34概率P-值接近于0,应拒绝原假设,认为5种推销方法有显著差异。
可知,1和2、1和5、2和3,2和4,2和5,3和5,4和5有显著差异。
2、从两个总体中分别抽取n 1 =7 和和n 2 =6 的两个独立随机样本,经计算得到下面的方差分析表。
请补充表中单元格的两个独立随机样本,经计算得到下面的方差分析表。
请补充表中单元格“A”和单元格“B”内的计算结果。
答:已知组内均方=组内偏差平方和/自由度,所以A=26.4/11=2.4F 统计量=组间均方/组内均方所以B=7.5/2.4=3.1253、为研究某种降血压药的适用特点,在五类具有不同临床特征的高血压患者中随机挑选了若干志愿者进行对比试验,并获得了服用该降压药后的血压变化数据。
现对该数据进行单因素方差分析,所得部分分析结果如下表所示。
1)请根据表格数据说明以上分析是否满足方差分析的前提要求,为什么?2)请填写表中空缺部分的数据结果,并说明该降压药对不同组患者的降压效果是否存在显著差异。
3)如果该降压药对不同组患者的降压效果存在显著差异,那么该降压药更适合哪组患者?(1)因F检验的概率P值小于显著性水平(0.05),拒绝原假设,方差不齐,不满足方差分析的前提假设。
试验统计方法第四版课后答案
试验统计方法第四版课后答案1. 什么是试验统计方法?试验统计方法是一种用于分析实验数据的统计学方法。
它包括了设计实验、收集数据、分析数据和得出结论的过程。
通过试验统计方法,我们可以对实验结果进行客观、科学的分析,从而得出科学结论。
2. 试验统计方法的基本原理是什么?试验统计方法的基本原理是根据样本数据对总体参数进行推断。
通过对样本数据的分析,我们可以了解总体参数的可能取值范围,并对总体参数进行推断。
试验统计方法的基本原理是建立在统计推断的基础上的,通过对样本数据的分析,我们可以对总体参数进行推断。
3. 试验统计方法的应用范围是什么?试验统计方法广泛应用于医学、生物学、工程学、经济学等领域。
在医学领域,试验统计方法被用于临床试验数据的分析;在生物学领域,试验统计方法被用于实验数据的分析;在工程学领域,试验统计方法被用于质量控制和可靠性分析;在经济学领域,试验统计方法被用于市场调查和经济预测。
4. 试验统计方法的步骤是什么?试验统计方法的步骤包括,确定研究目的、设计实验方案、收集数据、分析数据、得出结论。
在确定研究目的时,我们需要明确研究的目的和问题;在设计实验方案时,我们需要确定实验的对象、实验的方法和实验的过程;在收集数据时,我们需要收集实验数据,并对数据进行整理和统计;在分析数据时,我们需要对数据进行统计分析和推断;在得出结论时,我们需要根据数据分析的结果得出结论,并对结论进行验证和解释。
5. 试验统计方法的常用技术有哪些?试验统计方法的常用技术包括,描述统计分析、推断统计分析、方差分析、回归分析、相关分析、非参数统计分析等。
描述统计分析是对实验数据进行总体特征的描述;推断统计分析是根据样本数据对总体参数进行推断;方差分析是用于比较多个总体均值是否相等的统计方法;回归分析是用于研究变量之间的因果关系的统计方法;相关分析是用于研究变量之间的相关关系的统计方法;非参数统计分析是用于对总体分布进行推断的统计方法。
2012统计课后习题复习资料汇总
第一章绪论2.计量资料(数值):对观察单位某个变量用测量或其他定量方法准确获得的定量结果,一般有计量单位。
如:体重、年龄、皮试直径、脉搏次数、白细胞计数、腹泻发生资料等。
计数资料(分类):将观察单位按某种属性分组计数的定性观察结果。
二分类:性别、痰培养阳性/阴性结果、存活情况无序分类:就医地点、民族、药物种类、病人血型有序(等级):指观察单位按某种属性的不同程度或次序分成等级后分组计数的观察结果,具有半定量性质。
痰涂片阴性/可疑/阳性、尿蛋白定性的结果3. 西部农村A、B两县,每年各约有2000名婴儿出生,一位研究者分别从两县县医院的出生记录中获得50名儿童的出生体重,A县50名儿童平均出生体重为2980g,B县50名儿童平均出生体重为3055g。
正确说法为:B县县医院的这50名儿童的平均出生体重高于A县县医院的50名儿童。
第二章简答题:3.研究设计中应遵循的基本原则?答:对照原则、随机原则、重复原则。
4.研究设计中为什么要设立对照?设立对照时应注意什么?答:设立对照的目的是衬托处理因素的效应。
对照组的设臵必须具备三个条件:对等、同步、专设。
5.随机化的含义是什么?随机化的目的是什么?答:随机化的含义是:抽样随机、分组随机、实验顺序的随机。
随机化的目的是:保证样本的代表性,保证各处理组间在大量不可控的非处理因素的分布方面尽量保持均衡可比。
第三章一、选择题1.算术均数和中位数相比,算术均数更充分利用数据信息2.计算几何均数时,采用以e为底的自然对数In(X)和采用以10为底的常用对数Ig(X),所得计算结果相同3.一个变量的所有观察值同加上一个非零常数后,不变的是标准差4.在服从正态分布条件下,样本标准差S的值与算术均数无关5.比较身高和体重两组数据的变异大小,宜采用变异系数6.变异系数CV的数值可以大于1也可以小于17.计算乙肝疫苗接种后血清学检验的阳转率,分母是乙肝疫苗接种人数8.计算标准化死亡率的目的是消除各地区内部构成不同的影响9.某研究者打算利用横断面调查资料描述职业与肝炎患病率的关系,其统计图宜采用条图10.可以用来描述近视率与儿童年龄的关系的是线图11.某研究者打算比较1975-2000年之间两种疾病的死亡率的变化趋势。
实验统计方法复习题(有部分答案)
一、选择题1、算术平均数的重要特性之一是离均差的总和(C )。
A、最小B、最大C、等于零D、接近零2、对某鱼塘不同年龄鱼的尾数进行统计分析时,可做成()图来表示。
A、条形图B、直方图C、多边形图D、折线图3、当p<q时,二项式分布曲线应该是( B )。
A、左偏B、右偏C、对称D、不对称4 A )。
A、正态分布B C、F分布D5、如测验k()个样本方否来源于方差相等的总体,这种测验在统计上称为( A )。
A. 方差的同质性测验B. 独立性测验C. 适合性测验D. F测验6)。
A B C D7、在简单线性回归分析中,剩余平方和反映了()。
A BC D8、对于常用次数分布图,下列说确的是()A、条形图只适用于计数资料B、坐标轴都必须加箭头以示数值增大的方向C、多边形图主要用于表示计量资料的次数分布D、方形图可以将多组资料绘制在同一幅图上比较9、具有一定原因引起观察值与试验处理真值之间的偏差称为( C )。
A、试验误差B、随机误差C、系统误差D、混合误差10、从N(10, 10)的正态总体中以样本容量10抽取样本,其样本平均数差数服从( C )分布。
A、N(10, 10)B、N(0, 10)C、N(0, 2)D、N(0, 20)11、A、B两个事件不可能同时发生,则称为A和B事件是( C )。
A、和事件B、积事件C、互斥事件D、对立事件12、当样本容量增加时,样本平均数的分布趋于( A )。
A、正态分布B、t分布C、u分布D、F分布13、对比法和间比法试验结果的统计分析一般采用( D )。
A、假设测验法B、方差分析法C、回归分析法D、百分数法14、在5×5拉丁方试验的方差分析中总变异的平方和与自由度可以细分成( C )部分。
A、2 部分B、3 部分C、4 部分D、5 部分15、从N(10, 80)( B )。
A、0.10B、0.05C、0.025D、0.0116、算术平均数的重要特性之一是离均差的平方和( C )。
田间试验与统计分析课程课后习题spss分析结果模板(第五章、第六章)
一、实验信息软件版本:spss19 姓名:任志强学号:201607309 班级:农区1601 日期:2018.6.21 二、实验内容(1)安装sas软件;(2)结合spss软件操作讲解课本第139页例题;(3)利用spss软件对课本习题5-12,、5-13、5-14、6-1、6-6、6-7进行数据的具体分析。
三、实验目的学习使用sas和spss的数据分析功能生成实验结果。
四、指导教师:刘永建教授五、实验结果及分析(一)习题5-121.实验数据(产量单位:Kg/666.67m2)a. R 方 = 1.000(调整 R 方 = 0.999)不同品种产量差异显著性值=0.006<0.05,所以不同品种产量存在显著性差异,不同种植密度产量差异显著性值=0.007<0.05,所以不同种植密度产量之间存在显著性差异。
因而还必须进行品种和密度两因素不同水平平均产量的多重比较。
2.多重比较①不同品种平均产量的多重比较(显著性水平=0.05)对于不同品种玉米产量的多重比较采用SSR法,得出品种1产量显著高于和品种2、3产量,品种2、3产量之间没有显著差异。
对于不同密度玉米产量的多重比较采用SSR法,得出密度2、3产量显著高于密度1、4,密度2、3产量之间没有显著差异,密度2、4产量之间没有显著差异,密度4产量显著高于密度1产量。
②不同品种平均产量的多重比较(显著性水平=0.01)已显示同类子集中的组均值。
基于观测到的均值。
误差项为均值方 (错误) =202.083。
a. 使用调和均值样本大小 = 4.000。
b. Alpha = 0.01。
已显示同类子集中的组均值。
基于观测到的均值。
误差项为均值方 (错误) = 202.083。
a. 使用调和均值样本大小 = 3.000。
b. Alpha = 0.01。
对于不同品种玉米产量的多重比较采用SSR法,得出品种1、2产量极显著高于和品种3产量,品种2、3产量之间没有极显著差异,品种1、2产量之间没有极显著差异。
田间试验与统计分析课后答案
田间试验与统计分析课后答案1. 田间试验的概念和意义田间试验是一种农业科学研究方法,旨在通过对农作物在实际田间环境中的种植和管理,对其生长发育、产量和品质等因素进行观察和分析,以便得出科学合理的农业管理建议和决策。
田间试验的意义在于:•评估新的农作物品种和栽培技术的效果和适应性。
•研究不同环境因素对农作物生长和产量的影响,为合理选择适应性更强的品种和种植技术提供依据。
•评估农药、肥料和其他农业生产输入品质及其使用方法对农作物产量和品质的影响,为农业生产提供技术指导。
•收集和处理试验数据,进行统计分析,提供科学的试验结果,为农业科学研究提供数据支持。
2. 田间试验的步骤田间试验一般包括以下几个步骤:2.1. 试验目标确定试验目标的确定是田间试验的第一步。
根据研究的目的和问题,确定试验的主要内容和指标,并制定相应的试验方案。
2.2. 试验设计与样本选择试验设计的选择是田间试验的关键环节。
常见的试验设计包括随机区组设计、区组设计、蛇形区组设计等。
根据试验要求和资源条件,选择适当的试验设计,并确定样本数量和选择方法。
2.3. 试验布置与操作根据试验设计和样本选择的结果,制定试验布局和操作流程。
包括土壤处理、播种、施肥、灌溉、农药处理等。
在试验过程中,要注意保持试验田地的统一性和稳定性,尽量减少误差。
2.4. 数据采集与处理根据试验目标和指标,采集相关的数据。
数据采集要确保准确性和完整性,可以采用现场测量、采样和实验室分析等方法。
采集到的数据要经过预处理和整理,以便进行后续的分析和推断。
2.5. 数据分析与结果阐释对采集到的数据进行统计分析,包括描述统计和推断统计。
描述统计主要包括数据的集中趋势、离散程度和相关性等指标的计算和分析。
推断统计主要包括参数估计、假设检验和方差分析等。
分析结果应该结合试验目标和指标,对试验结果进行解释和阐述。
3. 统计分析在田间试验中的应用统计分析在田间试验中起到了至关重要的作用,主要包括以下几个方面:3.1. 试验设计和样本选择统计分析方法可以帮助确定适当的试验设计和样本选择,以保证试验结果的可靠性和有效性。