
医学统计学整理
名词解释1.医学统计学是一门“运用统计学的原理和方法,研究医学科研中有关数据的收集、整理和分析的应用科学,研究对象为医学中具有不确定性结果的事物。
2.总体(population):根据研究目的所确定的同质观察单位的全体。
只包括(确定的时间和空间范围内)有限个观察单位的总体,称为有限总体(finite population)。
假想的,无时间和空间概念的,称为无限总体(infinite population)。
3.参数(parameter):总体的统计指标或特征值。
总体参数是事物本身固有的、不变的。
4.样本(sample):从总体中随机抽取的部分个体。
5.变量(variable):观察对象个体的特征或测量的结果。
由于个体的特征或指标存在个体差异,观察结果在测量前不能准确预测.变量的观察值称为数据。
6.定量资料:指构成其的变量值是定量的,其表现为数值大小,有单位。
对每个观察单位用定量的方法测定某项指标的数值,组成的资料。
7.计数资料:将全体观测单位按照某种性质或特征分组,再分别清点各组观察单位的个数。
8.有序数据:其取值是定性的,但各类别(属性)之间有程度或顺序上的差别。
9.变异(variation):同质事物间的差别.由于观察单位通常即为观察个体,故亦称为个体变异10.同质:指根据研究目的所确定的观察单位其性质应大致相同。
11.抽样误差(sampling error):由于抽样造成的统计量与参数之间的差别,特点是不能避免的,可用标准误描述其大小。
12.误差:统计上所说的误差泛指测量值与真值之差,样本指标与总体指标之差。
主要有系统误差和随机误差13.可信区间(confidence interval, CI):按一定的概率或可信度(1-α)用一个区间估计总体参数所在范围,这个范围称作可信度1-α的可信区间14.平均数:是一组(群)数据典型或有代表性的值.这个值趋向于落在根据数据大小排列的数据的中心,包括算术平均数(arithmetic mean)、几何平均数(geometric mean)、中位数(median)等。
算术均数:简称均数,可用于反映一组呈对称分布的变量值在数量上的平均水平。
几何均数:反映一组经对数转换后呈对称分布的变量值在数量上的平均水平,常适用于免疫学的指标。
15.中位数:将一组观察值按升序或降序排列,位次居中的数,常用M表示。
适用于偏态分布资料或不规则分布资料和开口资料。
17.百分位数(percentile):是一种位置指标,以Px表示,一个百分位数Px将全部观察值分为两个部分,理论上有x%的观察值小于Px小,有(1-x%)的观察值大于Px。
18.极差:即一组变量值的最大值与最小值之差,可用于任何分布资料。
四分位数间距:是把全部变量值分为四部分的分位数,即第1四分位数(QL=P25)、第2四分位数(M=P50)、第3四分位数(QU=P75)。
四分位数间距QR= QU﹣QL,一般和中位数一起描述偏态分布资料的分布特征。
方差:也称均方差,反映一组数据的平均离散水平,总体方差用σ2表示,样本方差记为S2。
标准差:是方差的正平方根,其单位与原变量值相同,总体标准差用σ表示,样本标准差记为S。
方差和标准差用于描述正态分布计量资料的离散程度。
均数和标准差结合用于全面描述正态分布计量资料的集中趋势与离散趋势。
19.变异系数(coefficient of variance, CV):亦称离散系数,为标准差与均数之比,常用百分数表示。
变异系数没有度量衡单位,常用于比较度量单位不同或均数相差悬殊的两组或多组资料的离散程度。
20. 统计表(statistical table):统计表就是以表格的形式,表达被研究对象的特征、内部构成及研究项目分组之间的数量关系。
21.频率(relative frequency):在n次随机试验中,事件A发生了m次,则比值称为事件A在n次试验中出现的频率,m称为出现的频数(frequency)。
22.概率(probability):在重复试验中,事件A的频率,随着试验次数的不断增加将愈来愈接近一个常数p,这个常数p就称为事件A出现的概率,记作P(A)或P。
23.小概率事件:我们把概率很接近于0(即在大量重复试验中出现的频率非常低)的事件称为小概率事件24.相关系数(correlation coefficient):用以说明具有直线关系的两个变量间相关关系的密切程度和相关方向的指标,称为相关系数,总体相关系数用希腊字母ρ表示,而样本相关系数用r表示,取值范围均为[-1, 1]。
25.回归系数(regression coefficient):直线回归方程= a+bX的系数b称为回归系数,也就是回归直线的斜率,表示X 每增加一个单位,Y 平均改变 b 个单位。
26.参考值范围(reference range):也称为正常值范围(normal range),医学上常把绝大多数正常人的某指标值范围称为该指标的正常值范围。
是指特定健康人群的解剖、生理、生化等各种数据的波动范围。
习惯上是确定包括95%的人的界值。
制定方法:①正态分布法:数据服从或近似服从正态分布;②百分位数法:偏态分布资料,样本含量不低于100。
正常人:不是指健康人,而是指排除了影响所研究指标的疾病和有关因素的同质人群。
27.正偏态和负偏态分布:频数分布可分为对称分布和非对称分布两种类型。
非对称分布又称为偏态分布,是指观察值偏离中央的分布。
当尾部偏向数轴正侧(或右侧)时,称正偏态(或右偏态)分布,反之,尾部偏向数轴负侧(或左侧)时,则称为负偏态(或左偏态)分布。
28.统计推断(statistic inference):从总体中随机抽取一定含量的样本进行研究,目的是通过样本的信息判断总体的特征,这一过程称为统计推断。
29.标准误(standard error, SE):在统计理论上将样本统计量的标准差称为标准误,用来衡量抽样误差的大小。
30.参数估计(parameter estimation):由样本信息估计总体参数。
它包括两种:点估计(point estimation)和区间估计(interval estimation)。
点估计:直接用样本统计量作为对应的总体参数的估计值。
区间估计:按一定的概率或可信度(1-α)用一个区间估计总体参数所在范围,这个范围称作可信度1-α的可信区间40.构成比(proportion):又称构成指标,它说明一种事物内部各组成部分所占的比重或分布,常以百分数表示41. 比(ratio):又称相对比,是A、B两个有关指标之比,说明A为B的若干倍或百分之几,它是对比的最简单形式。
简答题1.医学统计工作的基本步骤:①设计(是影响研究能否成功的最关键环节,是提高观察或实验质量的重要保证);②收集资料(统计报表+经常性工作记录+专题调查或实验研究+统计年鉴和统计数据专辑);③整理资料(是将原始数据净化、系统化和条理化,以便为下一步计算和分析打好基础的过程);④分析资料/统计分析(统计分析包括统计描述和统计推断,统计学的主要任务是进行统计推断,包括参数估计和假设检验)。
2.频数分布表编制步骤:①找极值;②求极差(全距),即最大值和最小值之差R;③确定组段数和组距;④根据组距写出组段;⑤分组划记并统计频数;⑥列表并求出频率、累计频数、累计频率。
3。
频数分布的用途:①描述频数分布的类型:频数分布分为对称分布和偏态分布②描述频数分布的特征;③便于发现一些特大或特小的离群值;④便于进一步做统计分析和处理。
4.集中趋势:统计学用平均数这一指标体系来描述一组变量值的集中位置或平均水平,常用的平均数有算术均数、几何均数和中位数。
离散趋势:描述数据变异大小的常用指标有极差、四分位数间距、方差、标准差、变异系数。
5.正态分布:德国数学家德莫阿弗尔于1733年提出,德国数学及高斯使正态分布广为人知。
特征:①在直角坐标的横轴上方呈钟型曲线,两端与X轴永不相交,且以X=μ为对称轴,左右完全对称。
②在X=μ处f(X)取最大值;X越远离μ,f(X)值越小。
③正态分布有两个参数,即位置参数μ和形态参数σ。
若固定σ,改变μ值,曲线沿着X轴平行移动,其形状不变。
若固定μ,σ越小,曲线越陡峭;反之,σ越大,曲线越平坦。
④正态曲线下的面积分布有一定的规律:正态分布曲线下面积为1,X±1.96S的面积为95%,X±2.58S的面积为99%。
标准正态分布:通过u=(X﹣μ)/ σ将X~N(μ,σ2)的正态分布转换为u~N (0,12)的标准正态分布,u称为标准正态变量。
6.标准正态分布(u分布)与t分布有何异同?相同点:集中位置都为0,都是单峰分布,是对称分布,标准正态分布是t分布的特例(自由度是无限大时);不同点:t分布是一簇分布曲线,t 分布的曲线的形状是随自由度的变化而变化,标准正态分布的曲线的形状不变,是固定不变的,因为它的形状参数为1。
7.标准差与标准误有何区别和联系?区别:(1)含义不同: ①s描述个体变量值(x)之间的变异度大小,s越大,变量值(x)越分散;反之变量值越集中,均数的代表性越强。
②标准误是描述样本均数之间的变异度大小,标准误越大,样本均数与总体均数间差异越大,抽样误差越大;反之,样本均数越接近总体均数,抽样误差越小。
(2)与n的关系不同:n增大时,①s→σ(恒定)。
②标准误减少并趋于0(不存在抽样误差)。
(3)用途不同: ①s:表示x的变异度大小,计算cv,估计正常值范围,计算标准误等②:参数估计和假设检验。
联系:二者均为变异度指标,样本均数的标准差即为标准误,标准差与标准误成正比。
8.抽样中要求每一个样本应该具有哪三性:从总体中抽取样本,其样本应具有“代表性”、“随机性”和“可靠性”。
(1)代表性: 就是要求样本中的每一个个体必须符合总体的规定。
(2)随机性: 就是要保证总体中的每个个体均有相同的几率被抽作样本。
(3)可靠性: 即实验的结果要具有可重复性,即由科研课题的样本得出的结果所推测总体的结论有较大的可信度。
由于个体之间存在差异, 只有观察一定数量的个体方能体现出其客观规律性。
每个样本的含量越多,可靠性会越大,但是例数增加,人力、物力都会发生困难,所以应以“足够”为准。
需要作“样本例数估计”。
9.简述直线回归与直线相关的区别:(1)资料要求上不同:直线回归分析适用于应变量是服从正态分布的随机变量,自变量是选定变量;直线相关分析适用于服从双变量正态分布的资料。
(2) 两种系数的意义不同:回归系数是表明两个变量之间数量上的依存关系,回归系数越大回归直线越陡峭,表示应变量随自变量变化越快;相关系数是表明两个变量之间相关的方向和紧密程度的,相关系数越大,两个变量的关联程度越大10.假设检验:是利用小概率反证法思想,从问题的对立面(H0)出发间接判断要解决的问题(H1)是否成立,然后在H0成立的条件下计算检验统计量,最后获得P值来判断。
医学统计学公式整理简洁版

医学统计学公式整理简洁版1. 平均数(Mean):一组数据的平均值,通过将所有值相加然后除以数据的个数得到。
公式:X̄=ΣX/n其中,X̄表示平均数,ΣX表示所有数据的总和,n表示数据的个数。
2. 中位数(Median):一组数据的中间值,将所有数据按升序排列,如果数据个数为奇数,则中位数是中间的值;如果数据个数为偶数,则中位数是中间两个值的平均数。
3. 众数(Mode):一组数据中出现次数最多的数值。
4. 标准差(Standard Deviation):衡量数据的离散程度,计算每个数据值与平均值的差的平方和的平均值的平方根。
公式:σ=√(Σ(X-X̄)²/n)其中,σ表示标准差,Σ(X-X̄)²表示每个数据值与平均值的差的平方和,n表示数据的个数。
5. 方差(Variance):标准差的平方。
公式:σ²=Σ(X-X̄)²/n6. 相关系数(Correlation Coefficient):度量两个变量之间的线性关系的强度和方向。
相关系数的值介于-1和1之间,接近-1表示负相关,接近1表示正相关,接近0表示无线性相关。
7. t检验(t-test):用于比较两组样本均值是否有显著差异。
8. 卡方检验(Chi-square test):用于比较观察频数与期望频数之间的差异是否显著。
9. 线性回归(Linear Regression):用于预测一个变量与另一个变量之间的关系,并且可以根据这个关系进行预测。
10. 生存分析(Survival Analysis):用于分析事件发生的概率和时间关系,常用于研究患者生存率和治疗效果。
医学统计学考试重点整理

一、基本概念1.总体与样本总体:所有同质观察单位某种观察值(即变量值)的全体样本:是总体中抽取部分观察单位的观察值的集合2.普查与抽样调查普查:就是全面调查,即调查目标总体中全部观察对象抽样调查:是一种非全面调查,即从总体中抽取一定数量的观察单位组成样本,对样本进行调查3.参数与统计量参数:总体的某些数值特征统计量:根据样本算得的某些数值特征4.Ⅰ型与Ⅱ型错误假设检验的结论真实情况拒绝H0不拒绝H0H0正确Ⅰ型错误(ɑ)推断正确(1−ɑ)H0不正确推断正确(1−β) Ⅱ型错误(β)Ⅰ型错误(ɑ错误):H0为真时却被拒绝,弃真错误Ⅱ型错误(β错误): H0为假时却被接受,取伪错误5.随机化原则与安慰剂对照随机化原则:是将研究对象随机分配到实验组和对照组,使每个研究对象都有同等机会被分配到各组中去,以平衡两组中已知和未知的混杂因素,从而提高两组的可比性,避免造成偏倚。
(意义:①是提高组间均衡性的重要设计方法;②避免有意扩大或缩小组间差别导致的偏倚;③各种统计学方法均建立在随机化基础上)安慰剂对照:是一种常用的对照方法。
安慰剂又称伪药物,是一种无药理作用的制剂,不含试验药物的有效成分,但其感观如剂型、大小、颜色、质量、气味及口味等都与试验药物一样,不能被受试对象和研究者所识别。
(安慰剂对照主要用于临床试验,其目的在于控制研究者和受试对象的心理因素导致的偏倚,并提高依从性。
安慰剂对照还可以控制疾病自然进程的影响,显示试验药物的效应)6.误差与标准误(区分率与均数)㈠均数抽样误差:由个体变异产生的、随机抽样引起的样本统计量与总体参数间的差异。
标准误:是指样本均数的标准差,反映抽样误差大小的定量指标,其公式表示为S x =S/√n㈡样本率率的抽样误差:样本率p和总体率π的差异率的标准误:样本率的标准差,公式为σp=√π(1-π)/n7。
方差分析方差分析:又称F检验,是通过对数据变异按设计类型的不同,分解成两个或多个样本均数所代表总体均数是否有差别的一种统计学方法。
医学统计学整理资料

统计有三大特性,用三句话予以简单的概括:实用性丰富性公平性统计学是研究数据搜集、整理与分析的科学,是认识社会和自然现象数量特征的重要工具。
医用统计学(Medical Statistics):运用概率论和数理统计的原理,方法,结合医学实际,研究数字资料的搜集,整理,分析,推断的一门学科。
统计结论的正确取决于:实验设计,资料搜集,数据管理等;随机事件(Random event):一次试验结果不确定,,在一定数量重复条件下呈现出规律性。
同质(homogeneity)的事物 : 研究的事物性质基本相同总体(population:是根据研究目的确定的、同质的全部研究对象中所有观察单位某种变量值的集合有有限总体和无限总体之分。
样本:根据随机化原则从总体中抽取的一定数量(sample size)的个体,称为样本,用样本信息来推断总体特征。
从总体中抽取部分个体的过程称为抽样。
抽样必须遵循随机性、可靠性、可比性、代表性代表性:指样本中的每一个个体必须符合总体规定的同质性。
随机性:指总体中的每个个体都有相同几率被抽作样本。
随机不是随便或随意。
可靠性:实验结果的可重复性即由样本结果推测总体的结论有较大的可信度。
可比性:即处理组的样本与对照组的样本,除处理因素不同外,其他可能影响实验结果的因素应基本保持相同。
同质:是指影响被研究指标的非实验因素相同。
变异:同质基础上的各观察单位(亦称为个体)之间的差异为变异。
统计学是研究变异的科学。
没有变异就不需要统计学。
总体的统计指标称为参数;样本的统计指标称为统计量。
误差:观察值与实际值的差异,成为误差。
分为:过失误差(可以避免);系统误差(可以);随机测量误差(无法避免);随机抽样误差(无法避免);抽样误差: 总体中存在个体变异,抽样研究中所抽取的样本,只包含总体中一部分个体,因而样本均数(或率)往往不等于总体均数(或率),表现为多次抽样的样本均数或率不同。
这种由抽样引起的差异称为抽样误差。
医学统计学统计资料的整理与描述-医学课件

频数表编制步骤
求极差 选定适当的组段数后估计组距 列出组段 划记归组获得频数 求频率,完成频数表
2024/9/28
6
频数分布表的编制
求极差或全距(Range): R=Xmax-Xmin
– R = 6.18-3.29=2.89
选定适当的组段数后估计组距( i )
– 组段数的选取以能反映资料的分布特征为宜 – 一般取8 ~ 15组 – i =2.89/10=0.289≈0.3
Medical statistics 医学统计学
统计资料的整理与描述
数值变量资料
主要内容
个体变异 频数分布表(图) 定量指标的描述
集中位置 离散趋势
总结
2 2024/9/28
个体变异(individual variation)
是同质观察对象间表现出的差异。 变异是生物体在一种或多种、已知或未知的不可
2024/9/28
7
频数分布表的编制
列出组段
– 组段的含义:包括组段的下限而不含组段的上 限 。如:3.20~ 等价于 [3.20,3.50)
–第一个组段应包含最小值 –最后一个组段应包含最大值
2024/9/28
8
频数分布表的编制
划记归组获得频数
– 常用的划记方法: “正” ;“||||”
求频率,完成频数表
2024/9/28
4
频数分布表和频数分布图
原因:由于个体变异的存在,医学研究中某指标 在各个体上的观察结果不是恒定不变的,但也不 是杂乱无章的,而是有一定规律的,呈一定的分 布(distribution)。
解决:频数分布表的基本思想:将原始数据按照 一定的标准划分为若干各组,合计各组的频数, 得到频数分布表;在将频数表绘制成频数分布图。
医学统计学公式整理

医学统计学公式整理1. 平均数(Mean):平均数是一组数据的所有观察值之和除以观察值的个数。
用数学符号表示为:μ = (x1 + x2 + ... + xn) / n。
其中,μ表示总体均值,x1,x2,...,xn表示样本数据,n表示样本容量。
2. 中位数(Median):中位数是将一组数据按照大小排序后,位于中间位置的数值。
对于有奇数个数的数据,中位数是中间的那个数;对于有偶数个数的数据,中位数是中间两个数的平均值。
3. 众数(Mode):众数是一组数据中出现次数最多的数值,可以有一个或多个。
4. 方差(Variance):方差是一组数据与其均值之差的平方的平均值,用来衡量数据的离散程度。
用数学符号表示为:σ^2 = ( (x1-μ)^2 + (x2-μ)^2 + ... + (xn-μ)^2 ) / n。
5. 标准差(Standard Deviation):标准差是方差的平方根,用来衡量数据的离散程度。
用数学符号表示为:σ = sqrt( ( (x1-μ)^2 + (x2-μ)^2 + ... + (xn-μ)^2 ) / n )。
6. 相对风险(Relative Risk):相对风险是比较两个暴露组之间罹患其中一种疾病的风险大小的指标。
计算方式为:相对风险=(发病率在暴露组中的比例)/(发病率在非暴露组中的比例)。
相对风险大于1表示暴露组的风险大于非暴露组,相对风险小于1表示暴露组的风险小于非暴露组,相对风险等于1表示两组风险相等。
7. 绝对风险差(Absolute Risk Difference):绝对风险差是比较两个暴露组之间发病率差异的指标。
计算方式为:绝对风险差=(发病率在暴露组中的比例)-(发病率在非暴露组中的比例)。
绝对风险差大于0表示暴露组的发病率高于非暴露组,绝对风险差小于0表示暴露组的发病率低于非暴露组,绝对风险差等于0表示两组发病率相等。
8. 相对危险度(Relative Risk Ratio):相对危险度是比较两个暴露组之间发病率的相对大小的指标。
(完整word版)医学统计学公式整理
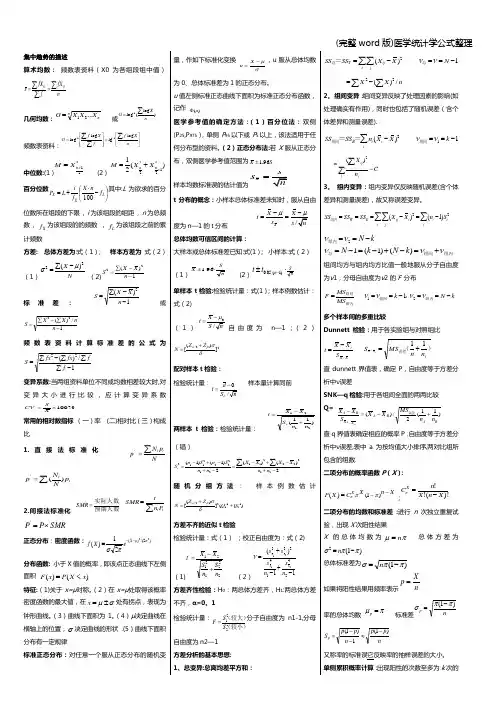
集中趋势的描述算术均数: 频数表资料(X0为各组段组中值)n fX ffX x OO∑∑∑==几何均数:n nX X X G ...21= 或)log (log 1nX G ∑-=频数表资料:⎥⎦⎤⎢⎣⎡=⎥⎥⎦⎤⎢⎢⎣⎡=∑∑∑--n X f f X f G log lg log log 11 中位数:(1)*21+=n XM (2) )(21*12*2++=n n X X M百分位数⎪⎭⎫⎝⎛-⋅+=L X X f n X f i L P 100其中:L 为欲求的百分位数所在组段的下限 , i 为该组段的组距 , n 为总频数 , X f 为该组段的的频数 , L f 为该组段之前的累计频数方差: 总体方差为:式(1); 样本方差为 式(2) (1)N X 22)(μσ-∑=(2)1)(22--∑=n X X S标准差:1)(2--∑=n X X S或 1/)(22-∑-∑=n nX X S频数表资料计算标准差的公式为1/)(22-∑∑∑-∑=f f fx fx S变异系数:当两组资料单位不同或均数相差较大时,对变异大小进行比较,应计算变异系数%100⨯=X SCV常用的相对数指标 (一)率 (二)相对比(三)构成比1.直接法标准化NpN p ii∑='∑=i i p NN p )('2.间接法标准化预期人数实际人数=SMR∑=ii P n rSMRSMR P P ⨯='正态分布:密度函数:)2/()(2221)(σμπσ--=X e X f分布函数: 小于X 值的概率,即该点正态曲线下左侧面积 )()(x X P x F <=特征:(1)关于x=μ对称。
(2)在x=μ处取得该概率密度函数的最大值,在σμ±=x 处有拐点,表现为钟形曲线。
(3)曲线下面积为1。
(4)μ决定曲线在横轴上的位置,σ决定曲线的形状 .(5)曲线下面积分布有一定规律标准正态分布:对任意一个服从正态分布的随机变量,作如下标准化变换σμ-=X u ,u 服从总体均数为0、总体标准差为1的正态分布。
新版医学统计学知识点归纳总结
新版医学统计学知识点归纳总结医学统计学是医学研究中不可或缺的一部分,它涉及到数据的收集、分析和解释,帮助医学工作者从大量数据中提取有价值的信息。
以下是新版医学统计学的知识点归纳总结:1. 研究设计:研究设计是统计分析的前提,包括观察性研究和实验性研究。
观察性研究如队列研究、病例对照研究,而实验性研究如随机对照试验(RCT)。
2. 数据类型:医学统计学中的数据可分为定性数据和定量数据。
定性数据如性别、血型,定量数据如血压、体重。
3. 描述性统计:描述性统计用于描述数据集的特征,包括集中趋势(均值、中位数、众数)和离散程度(方差、标准差、极差)。
4. 概率分布:在统计学中,概率分布描述了随机变量取值的概率。
常见的分布有正态分布、二项分布和泊松分布。
5. 假设检验:假设检验是统计推断的核心,用于判断样本数据是否支持某个假设。
常见的检验方法有t检验、卡方检验和F检验。
6. 置信区间:置信区间提供了一个范围,用以估计总体参数的可能值。
95%的置信区间意味着有95%的把握认为总体参数落在这个区间内。
7. 回归分析:回归分析用于研究一个或多个自变量对因变量的影响。
简单线性回归和多元线性回归是常见的回归分析方法。
8. 生存分析:生存分析关注个体生存时间的分布和相关因素,常用于肿瘤学和流行病学研究。
Kaplan-Meier估计和Cox比例风险模型是生存分析中的重要工具。
9. 诊断试验评价:诊断试验评价涉及敏感性、特异性、阳性预测值和阴性预测值等指标,用于评估诊断方法的准确性。
10. 样本量计算:样本量计算是研究设计的重要环节,它决定了研究的可行性和结果的可靠性。
样本量计算需要考虑效应大小、显著性水平和检验力。
11. 多变量分析:多变量分析用于同时考虑多个变量对结果的影响,如多元回归分析和判别分析。
12. 统计软件的应用:统计软件如SPSS、SAS和R在医学统计分析中扮演着重要角色,它们提供了数据处理和统计分析的功能。
医学统计学护理知识点总结
医学统计学护理知识点总结一、基本统计学概念1.总体和样本总体是指某一特定性质的全部个体的集合,而样本则是从总体中选取的一部分个体。
在临床实践中,医护人员常常需要根据样本数据来对总体进行推断。
2.参数和统计量参数是总体的特征值,统计量是样本的特征值。
统计量通常用来估计参数,比如样本平均值用来估计总体均值。
3.变量和常量变量是指在研究对象中取值不同的特征,可以分为定量变量和定性变量。
定量变量是以数字表示的,比如身高、体重;定性变量是以类别表示的,比如性别、婚姻状况。
常量是指在研究对象中取值不变的特征。
4.测量水平测量水平分为名义尺度、顺序尺度、区间尺度和比率尺度。
名义尺度是指仅代表对象分类的变量,如性别;顺序尺度是指变量的数值表示有序的关系,但不能准确比较差异,如疼痛程度的分级;区间尺度是指能够比较大小和进行加减运算,但没有绝对零点的变量,如体温;比率尺度是指能进行所有数学运算并有绝对零点的变量,如年龄、收入。
5.描述统计和推断统计描述统计是根据样本数据对总体进行描述和概括,它使用一些常见的指标,如平均值、标准差、百分比等。
推断统计是根据样本数据对总体的特征进行推断,如参数估计和假设检验。
二、概率论基础1.随机事件和概率随机事件是指在一定条件下可以出现也可以不出现的事件,它的出现是偶然的。
概率是描述随机事件发生可能性大小的一个数,通常用P(A)表示事件A发生的概率,概率的取值范围是0≤P(A)≤1。
2.独立事件和相关事件独立事件是指两个事件的发生互不影响,事件A和事件B同时发生的概率等于事件A发生的概率乘以事件B发生的概率,P(A∩B)=P(A)×P(B)。
相关事件是指两个事件的发生互相影响,事件A和事件B同时发生的概率不等于事件A发生的概率乘以事件B发生的概率。
3.概率分布概率分布是随机变量取值和相应概率的对应关系,包括离散型随机变量的概率分布和连续型随机变量的概率分布。
常见的离散型随机变量有二项分布、泊松分布等;常见的连续型随机变量有正态分布、t分布、F分布等。
医学统计学知识点
医学统计学知识点医学统计学是一门应用统计学方法和原理,研究医学领域中数据的收集、整理、分析和解释的科学。
它为医学研究、临床实践和公共卫生决策提供了重要的工具和方法。
下面让我们来了解一些关键的医学统计学知识点。
一、数据类型在医学研究中,我们会遇到不同类型的数据。
主要包括:1、定量数据:也称为数值数据,是可以用数字进行测量和记录的数据,如身高、体重、血压等。
定量数据又可分为连续型数据(可以在一定区间内取任意值,如身高)和离散型数据(只能取整数,如白细胞计数)。
2、定性数据:也称分类数据,是按照某种属性或类别进行划分的数据,如性别(男、女)、疾病的诊断(是、否)等。
定性数据又分为无序分类数据(各类别之间没有顺序关系,如血型)和有序分类数据(各类别之间有顺序关系,如疾病的严重程度分为轻、中、重)。
二、数据的收集为了获得准确和有用的数据,我们需要遵循科学的方法进行收集。
1、抽样方法:包括简单随机抽样、系统抽样、分层抽样和整群抽样等。
简单随机抽样是从总体中随机抽取个体;系统抽样是按照一定的间隔抽取样本;分层抽样是将总体按照某些特征分层,然后从各层中抽样;整群抽样则是以群体为单位进行抽样。
2、样本量的确定:样本量的大小取决于研究的目的、总体的变异程度、研究的精度和检验效能等因素。
一般来说,样本量越大,结果的准确性越高,但研究成本也会增加。
三、数据的整理收集到数据后,需要对其进行整理,以便后续的分析。
1、频数分布:将数据按照不同的类别或区间进行分组,计算每组的频数(出现的次数)和频率(频数与总例数的比值),可以了解数据的分布特征。
2、统计图表:常用的图表有直方图、折线图、饼图等,用于直观地展示数据的分布和趋势。
四、描述性统计描述性统计是对数据的基本特征进行概括和描述。
1、集中趋势的描述:包括算术均数、中位数和众数。
算术均数适用于正态分布的数据;中位数适用于偏态分布或分布不明的数据;众数是出现次数最多的数据值。
2、离散程度的描述:常用的指标有标准差、方差和极差。
医学统计学知识点汇总
医学统计学知识点汇总医学统计学是指应用统计学原理和方法进行医学研究设计、数据分析和结果解释的学科。
医学统计学的知识点非常丰富,包括统计学基础知识、研究设计、样本量计算、控制方法、参数估计、假设检验和数据分析等方面。
以下是医学统计学知识点的一些精华汇总。
1.统计学基本概念:包括基本统计量(均值、中位数、众数)、数据类型(定量数据、定性数据)、数据的描述方法(频数分布表、直方图等)。
2.研究设计:包括随机对照试验、队列研究、病例对照研究等,了解不同研究设计的优缺点及适用场景。
3.样本量计算:确定研究样本量是保证研究结果可靠性的重要一环,需要根据研究目的、效应量和统计显著性水平确定样本量。
4.控制方法:包括随机分组、盲法、配对设计等,用于减少实验误差和避免偏倚。
5.参数估计:常用的参数估计方法有点估计和区间估计。
点估计是通过样本数据得到总体参数的一个点估计值,区间估计是对总体参数的一个区间估计。
6.假设检验:假设检验是用来判断样本数据与总体假设之间的差异是否显著的统计方法。
常用的假设检验方法有t检验、卡方检验、方差分析等。
7.数据分析:包括描述性统计分析和推断性统计分析。
描述性统计分析用来描述研究变量的基本情况,推断性统计分析用来推断样本数据与总体数据之间的关系。
8.相关分析:用来分析变量之间的关联程度,包括皮尔逊相关系数和斯皮尔曼等级相关系数等。
9. 回归分析:用来分析因变量与自变量之间的关系,包括线性回归分析和 logistic回归分析等。
10.生存分析:用来分析时间到达事件发生的概率,包括生存曲线的绘制、生存率的估计和影响因素的分析等。
11. 多变量分析:用来分析多个自变量对因变量的影响,包括多元方差分析、多元回归分析和多元Logistic回归分析等。
12. Meta分析:用于综合多个独立研究结果,对总体效应进行定量分析和综合评价。
以上是医学统计学的一些精华知识点的汇总。
医学统计学的应用非常广泛,不仅在医学研究中需要应用统计学的原理和方法,也在临床实践中需要对医学统计学知识有一定的了解和应用。