
算符优先分析算法(3)
24
作业
P133—3
25
A. 正确 B. 错误
自左至右,终结符对终结符,非 终结符对非终结符,而且对应的 终结符相同。
N → X1 X2 … Xk-j
↕↕
↕
S[j+1] S[j+2] … S[k]
10
算符优先分析一般并不等价于规范归约
E E
E
+P
E
+T
P
+T
E
+T
F
i
i
P* P
T
T * FP
i
i
F
F
Pi
考虑下面的文法G(E): (1) E→E+T | T (2) T→T*F | F
可归约串,句型,短语,直接短语,句柄, 规范归约
一个文法G的句型的素短语是指这样一个短 语,它至少含有一个终结符,并且,除它 自身之外不再含任何更小的素短语
最左素短语是指处于句型最左边的那个素 短语
4
考虑下面的文法G(E):
(1) E→E+T | T
(2) T→T*F | F
(3) F→P F | P
UNTIL a=‘#’
8
算符优先分析算法
在算法的工作过程中,若出现j减1后的值 小于等于0时,则意味着输入串有错。在 正确的情况下,算法工作完毕时,符号栈 S应呈现:# N #。
由于非终结符对归约没有影响,因此,非 终结符根本可以不进符号栈S。
9
分析树 vs.语法树
对于文法的句子来说,它的算符优先分析 的结果就是语法树
至于a b和a b的情形,只须证明其一。
19
如果a b,则有从fa到gb的弧。也就是, gb能到达的任何结点fa也能到达。因此, f(a) g(b)
我们所需证明的是,在这种情况下,f(a) =g(b)不应成立
我们将指出,如果f(a)=g(b),则根本不 存在优先函数
假若f(a)=g(b),那么必有如下的回路:
Q:=S[j];
IF S[j-1]VT THEN j:=j-1 ELSE j:=j-2 UNTIL S[j] Q;
把S[j+1]…S[k]归约为某个N;
k:=j+1;
S[k]:=N
END OF WHILE;
IF S[j] a OR S[j] a THEN
BEGIN k:=k+1;S[k]:=a END ELSE ERROR /*调用出错诊察程序*/
E
(4) P→(E) | i
对于句型:T+F*P+i
T
短语: T, F, P, i , F*P,
T+F*P , T+F*P+i 直接短语:T, F, P, i 句柄:T 素短语:F*P , i 最左素短语:F*P
E
E
+T
+T
F
T* F
FP Pi
5
算符优先文法句型(括在两个#之间)的一般 形式写成: #N1a1N2a2…NnanNn+1#
20
fa
fa1
…
fam
gb
gb1
…
gbm
因此有
a b, a1 b, a1 b1, …, am bm, a bm
对任何优先函数f’和g’来说,必定有
f’(a)> g’(b) f’(a1) g’(b1) … f’(am) g’(bm) f’(a)
从而导致f’(a)> f’(a),产生矛盾。因此,不存在优 先函数f和g。
7
k:=1;
自左至右,终结符对终结符,非
பைடு நூலகம்
S[k]:=‘#’;
终结符对非终结符,而且对应的
REPEA把T下一个输入符号读进a中终;结符相同。
IF S[k]VT WHILE S[j]
THEN a DO
j:=k
NEL→SEX1 j:X=2k-1…;
↕↕
Xk-j
↕
BEGIN REPEAT
S[j+1] S[j+2] … S[k]
21
例:取前面文法G(E) (1) E→E+T | T (2) T→T*F | F (3) F→P F | P (4) P→(E) | i
的终结符+,*,↑,i
22
+* i + * i
f+
f*
f
fi
+ *↑ i
f 2447
g+
g*
g
gi g 1 3 6 6
23
小结
算符优先分析算法
最左素短语
的优先函数如下表
+ *↑( ) i # F2440660 G1 3 5 5 0 5 0
14
讨论:优先函数
对于任何无冲突优先关系表都存在优先函 数?
A. 是 B. 不是
15
有许多优先关系表不存在优先函数,如:
ab a b
不存在对应的优先函数f和g 假定存在f和g,则有
f(a)=g(a),f(a)>g(b), f(b)=g(a),f(b)=g(b) 导致如下矛盾: f(a) > g(b) = f(b) = g(a) = f(a)
b,则从fa画一条弧至gb,如果a 条弧从gb至fa 。
现在必须证明
b,则画一
若a b,则f(a)=g(b)
若a b,则f(a) < g(b)
若a b,则f(a) > g(b)
第一个关系可从函数的构造直接获得
若a b,则既有从fa到gb的弧,又有从gb到fa 的弧。所以,fa和gb所能到达的结是全同的。
若1 若1 若1
2,则f(1) < g(2) 2,则f(1) = g(2) 2,则f(1) > g(2)
f称为入栈优先函数,g称为比较优先函数。
优点
便于比较,节省空间
缺点
原来不存在优先关系的两个终结符,由于自然数相对应, 变成可以比较的
要进行一些特殊的判断
13
文法G(E) (1) E→E+T | T (2) T→T*F | F (3) F→P F | P (4) P→(E) | i
2. 数数:对每个结点都赋予一个数,此数等于从 该结点出发所能到达的结点(包括出发点自身)。 赋给fa的数作为f(a),赋给ga的数作为g(a)。
3. 验证:检查所构造出来的函数f和g是否与原来 的关系矛盾。若没有矛盾,则f和g就是要求的 优先函数,若有矛盾,则不存在优先函数。
18
1 对于每个终结符a,令其对应两个符号fa和ga, 画一以所有符号和为结点的方向图。如果a
编译原理
第五章 语法分析——自下而上分析
1
第五章 语法分析——自下而上分析
自下而上分析的基本问题 算符优先分析算法 LR分析法
2
第五章 语法分析——自下而上分析
自下而上分析的基本问题 算符优先分析算法
计算FIRSTVT和LASTVT(P)集合 构造算符优先关系表
LR分析法
3
算符优先分析算法
其中,每个ai都是终结符,Ni是可有可无的非 终结符。
定理:一个算符优先文法G的任何句型的最 左素短语是满足如下条件的最左子串 Njaj…NiaiNi+1, aj-1 aj aj aj+1,…,ai-1 ai ai ai+1
6
算符优先分析算法
使用一个符号栈S,用它寄存终结符和非终结 符,k代表符号栈S的使用深度
(3) F→P F | P (4) P→(E) | i 的句子i+i*i+i
P
P
i
i
i
11
算符优先分析算法
算符优先分析法特点
优点: 简单,快速 缺点: 可能错误接受非法句子,能力有限
算符优先分析法是一种广为应用、行之 有效的方法
用于分析各类表达式 ALGOL 60
12
优先函数
每个终结符与两个自然数f()与g()相对应,使得
16
讨论:优先函数
优先函数如果存在,唯一吗?
A. 是 B. 不是
如果优先函数存在,则不唯一(无穷多)!
17
如果优先函数存在,则可以通过以下三个 步骤从优先表构造优先函数
1. 画图:对于每个终结符a,令其对应两个符号fa 和ga,画一以所有符号和为结点的方向图。如 果a b,则从fa画一条弧至gb,如果a b, 则画一条弧从gb至fa 。
编译原理实验报告5_语法分析程序的设计(2)
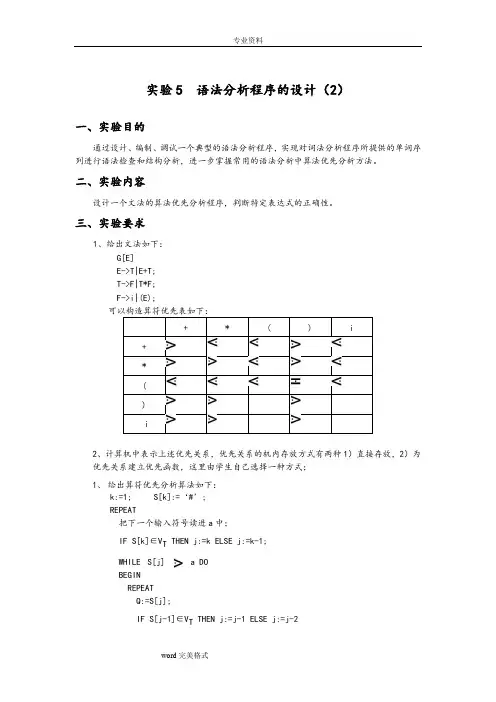
实验5 语法分析程序的设计(2)一、实验目的通过设计、编制、调试一个典型的语法分析程序,实现对词法分析程序所提供的单词序列进行语法检查和结构分析,进一步掌握常用的语法分析中算法优先分析方法。
二、实验内容设计一个文法的算法优先分析程序,判断特定表达式的正确性。
三、实验要求1、给出文法如下:G[E]E->T|E+T;T->F|T*F;F->i|(E);2、计算机中表示上述优先关系,优先关系的机内存放方式有两种1)直接存放,2)为优先关系建立优先函数,这里由学生自己选择一种方式;1、给出算符优先分析算法如下:k:=1; S[k]:=‘#’;REPEAT把下一个输入符号读进a中;IF S[k]∈V T THEN j:=k ELSE j:=k-1;WHILE S[j] a DOBEGINREPEATQ:=S[j];IF S[j-1]∈V T THEN j:=j-1 ELSE j:=j-2UNTIL S[j] Q把S[j+1]…S[k]归约为某个N;k:=j+1;S[k]:=N;END OF WHILE;IF S[j] a OR S[j] a THENBEGINk:=k+1;S[k]:=aENDELSE ERRORUNTIL a=‘#’1、根据给出算法,利用适当的数据结构实现算符优先分析程序;2、利用算符优先分析程序完成下列功能:1)手工将测试的表达式写入文本文件,每个表达式写一行,用“;”表示结束;2)读入文本文件中的表达式;3)调用实验2中的词法分析程序搜索单词;4)把单词送入算法优先分析程序,判断表达式是否正确(是否是给出文法的语言),若错误,应给出错误信息;5)完成上述功能,有余力的同学可以对正确的表达式计算出结果。
四、实验环境PC微机DOS操作系统或 Windows 操作系统Turbo C 程序集成环境或 Visual C++ 程序集成环境五、实验步骤1、分析文法中终结符号的优先关系;2、存放优先关系或构造优先函数;3、利用算符优先分析的算法编写分析程序;4、写测试程序,包括表达式的读入和结果的输出;5、程序运行效果,测试数据可以参考下列给出的数据。
算符优先文法分析
算符优先文法分析1.问题描述基于算符优先分析法的语法分析程序要求:(1)输入已知文法,生成文法矩阵,判断该文法是否是算符优先文法。
(2)用程序自动生成该文法的算符优先关系矩阵。
(3)对人工输入的句型或句子,分析该句型或句子是否合法,能否用已知文法推出。
(4)具有通用性。
所开发的程序可适用于不同的文法和任意输入串,且能判断该文法是否为算符优先文法。
(5)有运行实例。
对于输入的文法和符号串,所编制的语法分析程序应能正确判断此串是否为文法的句子,并要求输出分析过程。
2.算符优先分析法2.1算符优先文法定义:设有不含空串的一文法G,如果G中没有形如G>……BC……的产生式,其中B和C为非终结符,且对任意两个终结符a,b之间之多只有<,>,=,三种关系的一种成立,则称G是一个算符优先文法。
非终结符的FIRSTVT集合和LASTVT集合FIRSTVT(B)={b|B→b…或B→Cb…}LASTVT(B)={b|B→…a或B→…aC}2.2算符优先矩阵算符优先关系矩阵,判断输入是否满足已知文法的依据。
根据非终结符的FIRSTVT集合和LASTVT集合产生。
1.“=”关系若A→…ab…或A→…aBb…,则a=b;2.“〈⋅”关系若A→…aB…,对每一个b属于FIRSTVT(B),有a〈⋅b;3.“⋅〉”关系若A→…Bb…,对每一个a属于LASTVT(B),有a⋅〉 b。
2.3如何规约在分析过程中,利用分析栈存放已识别的那部分句型,而句型的其余部分由剩余输入串组成,通过比较栈顶符号和下一个输入符号之间的关系,可以判别栈顶符号是否为句柄尾符号。
如果是句柄尾,则沿栈顶向下,在栈内寻找句柄头(利用关系)。
由关系和关系之间包括的符号串就是句柄,然后把它们弹出栈,并代之以归约后的非终结符。
这样就完成了一次归约过程。
2.4算符优先分析方法的局限性由于算符优先分析法去掉了单非终结符之间的归约,尽管在分析过程中,当决定是否为句柄时采取一些检查措施,但仍难完全避免把错误的句子得到正确的归约。
算符优先分析算法(c语言)
编译原理实验一实验目的设计、编制并调试一个算符优先分析算法,加深对此分析法的理解二实验过程先在算符栈置“$”,然后开始顺序扫描表达式,若读来的单词符号是操作数,这直接进操作数栈,然后继续读下一个单词符号。
分析过程从头开始,并重复进行;若读来的是运算符θ2则将当前处于运算符栈顶的运算符θ1的入栈优先数f与θ2的比较优先函数g进行比较。
2.2 各种单词符号对应的种别码2.3 算符优先程序的功能完成一个交互式面向对象的算符优先分析程序,而一个交互式面向对象的算符优先分析程序基本功能是:(1)输入文法规则(2)对文法进行转换(3)生成每个非终结符的FirstVT和LastVT(4)生成算符优先分析表(5)再输入文法符号(6)生成移进规约步骤三设计源码算符优先分析器#include "stdio.h"#include "stdlib.h"#include "iostream.h"char data[20][20]; //算符优先关系char s[100]; //模拟符号栈schar lable[20]; //文法终极符集char input[100]; //文法输入符号串char string[20][10]; //用于输入串的分析int k;char a;int j;char q;int r; //文法规则个数int r1;int m,n,N; //转化后文法规则个数char st[10][30]; //用来存储文法规则char first[10][10]; //文法非终结符FIRSTVT集char last[10][10]; //文法非终结符LASTVT集int fflag[10]={0}; //标志第i个非终结符的FIRSTVT集是否已求出int lflag[10]={0}; //标志第i个非终结符的LASTVT集是否已求出int deal(); //对输入串的分析int zhongjie(char c); //判断字符c是否是终极符int xiabiao(char c); //求字符c在算符优先关系表中的下标void out(int j,int k,char *s); //打印s栈void firstvt(char c); //求非终结符c的FIRSTVT集void lastvt(char c); //求非终结符c的LASTVT集void table(); //创建文法优先关系表void main(){int i,j,k=0;printf("请输入文法规则数:");scanf("%d",&r);printf("请输入文法规则:\n");for(i=0;i<r;i++){scanf("%s",st[i]); //存储文法规则,初始化FIRSTVT集和LASTVT集*/first[i][0]=0; /*first[i][0]和last[i][0]分别表示st[i][0]非终极符的FIRSTVT集和LASTVT集中元素的个数*/ last[i][0]=0;}for(i=0;i<r;i++) //判断文法是否合法{for(j=0;st[i][j]!='\0';j++){if(st[i][0]<'A'||st[i][0]>'Z'){printf("不是算符文法!\n");exit(-1);}if(st[i][j]>='A'&&st[i][j]<='Z'){if(st[i][j+1]>='A'&&st[i][j+1]<='Z'){printf("不是算符文法!\n");exit(-1);}}}}for(i=0;i<r;i++){for(j=0;st[i][j]!='\0';j++){if((st[i][j]<'A'||st[i][j]>'Z')&&st[i][j]!='-'&&st[i][j]!='>'&&st[i][j]!='| ')lable[k++]=st[i][j];}}lable[k]='#';lable[k+1]='\0';table();printf("每个非终结符的FIRSTVT集为:\n"); //输出每个非终结符的FIRSTVT集for(i=0;i<r;i++){printf("%c: ",st[i][0]);for(j=0;j<first[i][0];j++){printf("%c ",first[i][j+1]);}printf("\n");}printf("每个非终结符的LASTVT集为:\n"); //输出每个非终结符的LASTVT集for(i=0;i<r;i++){printf("%c: ",st[i][0]);for(j=0;j<last[i][0];j++){printf("%c ",last[i][j+1]);}printf("\n");}printf("算符优先分析表如下:\n");for(i=0;lable[i]!='\0';i++)printf("\t%c",lable[i]);printf("\n");for(i=0;i<k+1;i++){printf("%c\t",lable[i]);for(j=0;j<k+1;j++){printf("%c\t",data[i][j]);}printf("\n");}printf("请输入文法输入符号串以#结束:");scanf("%s",input);deal();}void table(){char text[20][10];int i,j,k,t,l,x=0,y=0;int m,n;x=0;for(i=0;i<r;i++){firstvt(st[i][0]);lastvt(st[i][0]);}for(i=0;i<r;i++){text[x][y]=st[i][0];y++;for(j=1;st[i][j]!='\0';j++){if(st[i][j]=='|'){text[x][y]='\0';x++;y=0;text[x][y]=st[i][0];y++;text[x][y++]='-';text[x][y++]='>';}else{text[x][y]=st[i][j];y++;}}text[x][y]='\0';x++;y=0;}r1=x;printf("转化后的文法为:\n");for(i=0;i<x;i++) //输出转化后的文法规则串{printf("%s\n",text[i]);}for(i=0;i<x;i++) /*求每个终结符的推导结果(去掉"->"后的转化文法,用于最后的规约)*/ {string[i][0]=text[i][0];for(j=3,l=1;text[i][j]!='\0';j++,l++)string[i][l]=text[i][j];string[i][l]='\0';}for(i=0;i<x;i++){for(j=1;text[i][j+1]!='\0';j++){if(zhongjie(text[i][j])&&zhongjie(text[i][j+1])){m=xiabiao(text[i][j]);n=xiabiao(text[i][j+1]);data[m][n]='=';}if(text[i][j+2]!='\0'&&zhongjie(text[i][j])&&zhongjie(text[i][j+2])&&!zhongjie(text[i][j+1])){m=xiabiao(text[i][j]);n=xiabiao(text[i][j+2]);data[m][n]='=';}if(zhongjie(text[i][j])&&!zhongjie(text[i][j+1])){for(k=0;k<r;k++){if(st[k][0]==text[i][j+1])break;}m=xiabiao(text[i][j]);for(t=0;t<first[k][0];t++){n=xiabiao(first[k][t+1]);data[m][n]='<';}}if(!zhongjie(text[i][j])&&zhongjie(text[i][j+1])){for(k=0;k<r;k++){if(st[k][0]==text[i][j])break;}n=xiabiao(text[i][j+1]);for(t=0;t<last[k][0];t++){m=xiabiao(last[k][t+1]);data[m][n]='>';}}}}m=xiabiao('#');for(t=0;t<first[0][0];t++){n=xiabiao(first[0][t+1]);data[m][n]='<';}n=xiabiao('#');for(t=0;t<last[0][0];t++){m=xiabiao(last[0][t+1]);data[m][n]='>';}data[n][n]='=';}void firstvt(char c) //求FIRSTVT集{int i,j,k,m,n;for(i=0;i<r;i++){if(st[i][0]==c)break;}if(fflag[i]==0){n=first[i][0]+1;m=0;do{if(m==2||st[i][m]=='|'){if(zhongjie(st[i][m+1])){first[i][n]=st[i][m+1];n++;}else{if(zhongjie(st[i][m+2])){first[i][n]=st[i][m+2];n++;}if(st[i][m+1]!=c){firstvt(st[i][m+1]);for(j=0;j<r;j++){if(st[j][0]==st[i][m+1])break;}for(k=0;k<first[j][0];k++)int t;for(t=0;t<n;t++){if(first[i][t]==first[j][k+1])break;}if(t==n){first[i][n]=first[j][k+1];n++;}}}}}m++;}while(st[i][m]!='\0');first[i][n]='\0';first[i][0]=--n;fflag[i]=1;}}void lastvt(char c) //求LASTVT集{int i,j,k,m,n;for(i=0;i<r;i++){if(st[i][0]==c)break;}if(lflag[i]==0){n=last[i][0]+1;m=0;do{if(st[i][m+1]=='\0'||st[i][m+1]=='|'){if(zhongjie(st[i][m])){last[i][n]=st[i][m];}else{if(zhongjie(st[i][m-1])){last[i][n]=st[i][m-1];n++;}if(st[i][m]!=c){lastvt(st[i][m]);for(j=0;j<r;j++){if(st[j][0]==st[i][m])break;}for(k=0;k<last[j][0];k++){int t;for(t=0;t<n;t++){if(last[i][t]==last[j][k+1])break;}if(t==n){last[i][n]=last[j][k+1];n++;}}}}}m++;}while(st[i][m]!='\0');last[i][n]='\0';last[i][0]=--n;lflag[i]=1;}}int deal(){int i,j;int x,y;int z; //输入串的长度k=1;s[k]='#'; //栈置初值for(i=0;input[i]!='\0';i++); //计算输入串的长度z=i--;i=0;while((a=input[i])!='\0'){if(zhongjie(s[k]))j=k;elsej=k-1;x=xiabiao(s[j]);y=xiabiao(a);if(data[x][y]=='>'){out(1,k,s);printf("%c",a);out(i+1,z,input);printf("规约\n");do{q=s[j];if(zhongjie(s[j-1]))j=j-1;else j=j-2;x=xiabiao(s[j]);y=xiabiao(q);}while(data[x][y]!='<');int m,n,N;for(m=j+1;m<=k;m++){for(N=0;N<r1;N++)for(n=1;string[N][n]!='\0';n++){if(!zhongjie(s[m])&&!zhongjie(string[N][n])){if(zhongjie(s[m+1])&&zhongjie(string[N][n+1])&&s[m+1]==string[N][n+1]){s[j+1]=string[N][0];break;}}elseif(zhongjie(s[m]))if(s[m]==string[N][n]){s[j+1]=string[N][0];break;}}}k=j+1;if(k==2&&a=='#'){out(1,k,s);printf("%c",a);out(i+1,z,input);printf("结束\n");printf("输入串符合文法的定义!\n");return 1; //输入串符合文法的定义}}elseif(data[x][y]=='<'||data[x][y]=='='){ //移进out(1,k,s);printf("%c",a);out(i+1,z,input);printf("移进\n");k++;s[k]=a;i++;}else{printf("\nflase");return 0;}}printf("\nflase");return 0;}void out(int j,int k,char *s){int n=0;int i;for(i=j;i<=k;i++){printf("%c",s[i]);n++;}for(;n<15;n++){printf(" ");}}int xiabiao(char c) //求字符c在算符优先关系表中的下标{int i;for(i=0;lable[i]!='\0';i++){if(c==lable[i])return i;}return -1;}int zhongjie(char c) //判断字符c是否是终极符{int i;for(i=0;lable[i]!='\0';i++){if(c==lable[i])return 1;}return 0;}四实验结果。
第六章 语法分析-自下而上分析法
一、自下而上语法分析的基本问题 1.归约: 如何判断栈顶符号的可归约性以及如何归约,是 自下而上分析的中心问题。 2.短语和句柄
如果S ⇒ αAβ and A ⇒γ,则称γ是句型 αγβ的相对于变量A的短语 * 如果S ⇒αAβ and A⇒γ,则称γ是句型 αγβ的相对于变量A的直接(简单)短语 最左直接短语叫做句柄
e
abbcde
一、自下而上语法分析的基本问题 (3)自下而上分析的关键问题
似乎移进-归约过程很简单,其实不然,在上面第5步,如果用 规则2(P → b)进行归约而不是用规则3(P → Pb)进行归约,结果 会怎么样呢? 上面的归约过程是从文法的句子abbcde开始,每一步都是把最 左直接短语(句柄)替换为相应产生式的左部符号(在步骤5时 栈顶为#aPb,此时是将b归约为P还是将Pb归约为P?由于此时对 于句型aPbcde(即栈内容+输入缓冲区内容)来说Pb是句柄,故 将Pb归约为P)。也就是说,自底向上分析的关键问题是在分析 中如何确定句柄(准确地说为可归约串),即如果知道何时在 栈顶符号串中已形成了某句型的句柄,那么就可以确定何时进 行归约。对此,不同的分析方法有不同的解决办法。这里主要 介绍算符优先及LR分析方法。
例: 移进—归约分析(Shift-reduce parsing)
要点:建立符号栈,用来纪录分析的历史和现状, 并根据所面临的状态,确定下一步动作是移 进还是归约。
输入串 # 符号栈 #
S.R.P
输入串 # 符号栈 #
S.R.P
分析过程:把输入符号串按自左向右顺序一一地 移进符号栈(一次移一个),检查栈中符号,当在栈 顶的若干符号形成当前句型的句柄时,就根据规则进 行归约,将句柄从符号栈中弹出,并将相应的非终结 符号压入栈内(即规则的左部符号),然后再检查栈 内符号串是否形成新的句柄,若有就再进行归约,否 则移进符号。分析一直进行到读到输入串的右界符为 止。最后,若栈中仅含有左界符号和识别符号,则表 示分析成功,否则失败
算符优先分析法

G[E]: E→E+E|E-E|E*E|E/E|EE|(E)|-E|id
由于该文法是一个二义文法,它的句子往往有不同的规范推导和 归约,实际运算会得到不同结果,但按传统的习惯规定优先级和 结合律进行归约,优先级从高到低为:乘幂运算符,乘、除运算符, 加、减运算符;同级运算符服从左结合原则;有括号时,先括号 内后括号外。 则文法的句子id+id-id*(id+id)的归约过程为:
N1…Ni-1<· Ni …… Nj · >Nj+1…Nn
2.
句型中Ni„„Nj是句柄,语法分析程序可以通过寻找 Ni-1<· Ni和Nj· >Nj+1这两个关系来确定句柄的头尾,从 而确定句柄进行归约。
帮助理解 abce # 控制程序 # ce # b a #
G[S]: S→aBe B→bc bce # 控制程序 e #
知识点
算符优先分析法的算法简单、直观、易于理解,所以通常作为学 习其它自下而上语法分析的基础。 需复习有关语法分析的知识有:什么是语言、文法、句子、句型、 短语、简单短语、句柄、最右推导、规范归约基本概念。 本章重难点 算符文法的形式。 对一个给定的算符文法能构造算符优先关系分析表,并能判别所 给文法是否为 算符优先文法。 分清规范句型的句柄和最左素短语的区别,进而分清算符优先归 约和规范归约的区别。(在分析过程中如何寻找可归约串) 对一个给定的输入串能应用算符优先关系分析表给出分析(归约) 步骤,并最终判断所给输入串是否为该文法的句子。
输出带
2
2,3
2,3,4
2,3,4,1
S
a
A A b b
c
B e d
算符优先算法

算符优先算法1. 算符优先算法简介算符优先算法(Operator Precedence Parsing)是一种用于解析和计算表达式的方法。
它通过定义运算符之间的优先级和结合性来确定表达式的计算顺序,从而实现对表达式的准确解析和计算。
在算符优先算法中,每个运算符都被赋予一个优先级,表示其与其他运算符之间的优先关系。
根据这些优先级规则,可以将一个表达式转化为一个操作符和操作数构成的序列,并按照一定的顺序进行计算。
2. 算符优先文法在使用算符优先算法进行解析时,需要定义一个文法来描述运算符之间的关系。
这个文法称为算符优先文法。
一个典型的算符优先文法由以下三部分组成:1.终结符:表示可以出现在表达式中的基本元素,例如数字、变量名等。
2.非终结符:表示可以出现在表达式中但不能作为最终结果输出的元素,例如运算符。
3.产生式:描述了如何将非终结符转化为终结符或其他非终结符。
通过定义合适的产生式规则,可以建立起非终结符之间的优先关系。
这些优先关系决定了表达式中运算符的计算顺序。
3. 算符优先表算符优先表(Operator Precedence Table)是算符优先算法的核心数据结构之一。
它用于存储运算符之间的优先级和结合性信息。
一个典型的算符优先表由以下几部分组成:1.终结符集合:包含所有可能出现在表达式中的终结符。
2.非终结符集合:包含所有可能出现在表达式中的非终结符。
3.优先关系矩阵:用于存储运算符之间的优先关系。
矩阵中每个元素表示两个运算符之间的关系,例如“<”表示左运算符优先级低于右运算符,“>”表示左运算符优先级高于右运算符。
“=”表示两个运算符具有相同的优先级。
通过使用算符优先表,可以根据当前输入字符和栈顶字符来确定下一步应该进行的操作,例如移进、规约等。
4. 算法流程下面是一个简化版的算法流程:1.初始化输入串、操作数栈和操作符栈。
2.从输入串中读取一个字符作为当前输入字符。
3.如果当前输入字符为终结符,则进行移进操作,将其压入操作数栈,并读取下一个输入字符。
07级_实验二_用算符优先分析法进行表达式分析
return ('*');
}
/**********************************/
int Operate(int a,int b,SYMBOL o)
{
switch (o)
{
case PLUS: return a+b;
case MINUS: return a-b;
case TIMES: return a*b;
若θ1和θ2之间无优先关系,则报错。
2、源程序提示
利用以前实验进行单词识别,并自组织工程文件,关于算符优先算法要用到的部份函数提示如下。
[1]一些自定义的变量和函数的声明
#define MAX 255
SYMBOLtitle[7]= {PLUS,MINUS,TIMES,SLASH,LPAREN,RPAREN,SHAP};//用来将相应的种别码与数组下标进行映射
θ2
θ1
+
-
*
/
(
)
#
+
>
>
<
<
<
>
>
-
>
>
<
<
<
>
>
*
>
>
>
>
<
>
>
/
>
>
>>
(
<
<
<
<
<
=
)
>
>
>
>
《编译原理》课程研讨题(2016)
第一次研讨、第一批(第3周)1.讨论:(1)编译方法与解释方法的主要区别(2)编译程序组合中分端(前端/后端)和分遍(单遍/多遍)的作用(3)编译程序生成方法中自编译与自展的含义2.编写PL/0程序,功能:输入正整数n,求sum = 1! + 2 ! + ... + n!3.扩充PL/0语言文法的定义,增加实数类型和数组类型。
例:Var i:integer;r:real;A:array[1..10]of real;……A[i]:=r;4.设有下列文法G1[S]和G2[S]:1)指出文法的类型2)证明两者等价G1[S]:S→aAb | bBaA→aA | aB→Bb | bG2[S]:S→aA | bBA→aA | aCB→bB | bDC→bD→a5. 构造一个文法,使其语言是奇数集,且每个奇数不以0开头。
6.文法G[S] 的一个句子abbba 的语法树如下图:SA B aA b b Ba b1) G[S]可能包含哪些产生式?2) 给出句子abbba的规范推导。
3) 求出句子abbba 的句柄。
7.设有上下文无关文法G[S]:S→aAb A→aB A→a B→bA B→b 试构造与G[S]等价的正规文法。
8 实验一识别标识符(A)第一次研讨、第二批(第4周)1.编写PL/0程序,输入正整数n、x1、x2、…、x n,计算:S= ∑ x i/i! i=1~n。
2.构造下列语言的文法,并分析比较(1)L1(G)={a n b n|n≥1}(2)L2(G)={(ab) n|n≥1}(3)L3(G)={a n b m|n,m≥0}(4)L4(G)={a n b m|n,m≥1}3.定义一个文法,产生表达式E:1)含有双目运算符+,*2)+ 的优先级高于*3)+ 右结合,* 左结合4)运算对象为标识符i5)可用括号改变算符的优先级4.扩充PL/0语言文法的定义, 增加for语句的功能。
for语句的示例如下:for i:= 1 to 100 do s:=s+i;5.定义一个文法,产生下列语言:该语言由a、b符号串组成,串中a和b的个数相同6.证明下列文法为二义文法(能否转换为等价的非二义文法?)⑴G1[S]:S→A A→AA A→aAb A→ab⑵G2[S]:S→aSb S→Sb S→b7.试写出V T={0,1},分别满足下述要求的正则表达式:⑴所有以1开始和0结束的符号串。
第6章自底向上优先分析法
第6章⾃底向上优先分析法⾃底向上分析⽅法,也称移进-归约分析法,粗略地说它的实现思想是对输⼊符号串⾃左向右进⾏扫描,并将输⼊符逐个移⼊⼀个后进先出栈中,边移⼊边分析,⼀旦栈顶符号串形成某个句型的句柄时,(该句柄对应某产⽣式的右部),就⽤该产⽣式的左部⾮终结符代替相应右部的⽂法符号串,这称为归约。
重复这⼀过程直到归约到栈顶中只剩⽂法的开始符号时则为分析成功,也就确认输⼊串是⽂法的句⼦。
本章将在介绍⾃底向上分析思想基础上,着重介绍算符优先分析法。
例6.1,设⽂法G[S]为:(1)S→aAcBe(2)A→b(3)A→Ab(4)B→d对输⼊串abbcde#进⾏分析,检查该符号串是否是G[S]的句⼦。
由于⾃底向上分析的移进-归约过程是⾃顶向下最右推导的逆过程,⽽最右推导为规范推导,⾃左向右的归约过程也称为规范归约。
容易看出对输⼊串abbcde的最右推导为:S aAcBe aAcde aAbcde abbcde由此我们可以构造它的逆过程即归约过程。
先设⼀个后进先出的符号栈,并把句⼦左括号”#”号放⼊栈底。
对上述分析过程也可看成⾃底向上构造语法树的过程,每步归约都是构造⼀棵⼦树,最后当输⼊串结束时刚好构造出整个语法树。
在上述移进-归约或⾃底向上构造语法树的过程中,考虑⼏个问题:u 何时移进?u 何时归约?u 将哪个字符串归约?当⼀个⽂法⽆⼆义性时,那么它对⼀个句⼦的规范推导是唯⼀的,规范规约也必然是唯⼀的。
因⽽每次归约时要找当前句型的句柄,也就是说,任何时候栈中的符号串和剩余的输⼊串组成⼀个句型,当句柄出现在栈顶符号串中时,则可⽤句柄归约,这样⼀直归约到输⼊串只剩结束符,⽂法符号栈中只剩开始符号。
由此可见,⾃底向上分析的关键问题是在分析过程中如何确定句柄,即如何知道何时在栈顶符号串中已形成某句型的句柄。
然⽽⾃底向上的分析算法很多,我们仅在本章和第7章介绍⽬前常⽤的算符优先分析和LR类分析法。
6.1 ⾃底向上优先分析法概述优先分析法⼜可分简单优先法和算符优先分析法。
简单优先和算符优先分析方法
简单优先和算符优先分析方法简单优先分析(Simple Precedence Parsing)和算符优先分析(Operator Precedence Parsing)是两种常用的自底向上的语法分析方法。
它们是基于符号优先级的理念,通过比较符号之间的优先级关系,来进行语法分析。
1.简单优先分析简单优先分析是一种自底向上的语法分析方法,它利用一个优先级表来确定符号之间的优先关系。
简单优先分析的算法如下:(1)将输入串和符号栈初始化为空。
(2)从输入串中读入第一个输入符号a。
(3)将a与栈顶的符号进行比较:a.如果a的优先级大于栈顶符号的优先级,将a推入符号栈,并读入下一个输入符号。
b.如果a的优先级小于栈顶符号的优先级,将栈中的符号做规约操作,直到栈顶的符号优先级不小于a。
然后,将a推入符号栈。
c.如果a和栈顶符号优先级相等,栈顶的符号出栈,并将a推入符号栈。
(4)重复步骤(3)直到输入串为空。
(5)如果符号栈中只有一个符号且为文法的开始符号,则分析成功。
简单优先分析的优先级表一般由语法规则和符号之间的优先关系组成。
我们可以通过构造优先级关系表来实现简单优先分析。
2.算符优先分析算符优先分析是一种自底向上的语法分析方法,它也是基于符号优先级的理念,但是相对于简单优先分析,算符优先分析更加灵活,并且允许处理左递归的文法。
算符优先分析的算法如下:(1)将输入串和符号栈初始化为空。
(2)从输入串中读入第一个输入符号a。
(3)将a与栈顶的符号进行比较:a.如果a的优先级大于栈顶符号的优先级,将a推入符号栈,并读入下一个输入符号。
b.如果a的优先级小于栈顶符号的优先级,将栈中的符号做规约操作,直到栈顶的符号优先级不小于a。
然后,将a推入符号栈。
c.如果a和栈顶符号优先级相等,根据符号栈中符号的类型执行相应的操作(如归约、移进等)。
(4)重复步骤(3)直到输入串为空。
(5)如果符号栈中只有一个符号且为文法的开始符号,则分析成功。