
距离判别法贝叶斯判别法和费歇尔判别法的异同
距离判别法贝叶斯判别法和费歇尔判别法的异同
距离判别法、贝叶斯判别法和费歇尔判别法是三种常见的分类方法。
它们都是基于已知类别的数据集,通过学习得到一个分类模型,然后用该模型对未知数据进行分类。
虽然它们都属于分类方法,但是它们之间还是存在一些异同点的。
一、距离判别法
距离判别法是根据样本之间的距离来进行分类的方法。
具体地说,对于一个未知样本,计算它与每个已知类别中心之间的距离,然后将其归为距离最近的那个类别。
其中“中心”可以是类别内所有样本的平均值或者其他统计量。
优点:
1. 简单易懂:距离判别法直观易懂,容易理解。
2. 计算简单:计算样本与中心之间的距离只需要进行简单的数学运算即可。
缺点:
1. 对异常值敏感:由于距离判别法是基于样本之间的距离来进行分类,因此如果存在异常值,则可能会影响分类结果。
2. 需要提前确定中心:在使用距离判别法时需要提前确定每个类别的
中心,而这个过程可能会比较困难。
二、贝叶斯判别法
贝叶斯判别法是一种基于概率的分类方法。
它假设每个类别都服从某
种概率分布,然后根据贝叶斯公式计算出每个类别对于给定样本的后
验概率,最终将样本归为后验概率最大的那个类别。
优点:
1. 可以处理多维特征:与距离判别法不同,贝叶斯判别法可以处理多
维特征。
2. 对异常值不敏感:由于贝叶斯判别法是基于概率分布来进行分类的,因此对于一些异常值,它可以通过概率分布来进行修正。
缺点:
1. 需要大量数据:由于贝叶斯判别法需要估计每个类别的概率分布,因此需要大量的数据才能得到准确的结果。
2. 对先验概率敏感:在使用贝叶斯判别法时需要提前确定每个类别的先验概率,而这个过程可能会比较困难。
三、费歇尔判别法
费歇尔判别法是一种基于方差分析理论的分类方法。
它假设每个类别服从某种概率分布,然后根据方差分析的原理来计算每个类别对于给定样本的“可信度”,最终将样本归为“可信度”最高的那个类别。
优点:
1. 可以处理多维特征:与距离判别法不同,费歇尔判别法可以处理多维特征。
2. 对异常值不敏感:由于费歇尔判别法是基于方差分析理论来进行分类的,因此对于一些异常值,它可以通过方差分析来进行修正。
缺点:
1. 需要大量数据:由于费歇尔判别法需要估计每个类别的概率分布,
因此需要大量的数据才能得到准确的结果。
2. 对先验概率敏感:在使用费歇尔判别法时需要提前确定每个类别的先验概率,而这个过程可能会比较困难。
总结:
距离判别法、贝叶斯判别法和费歇尔判别法都是常见的分类方法,它们都有自己的优缺点。
在实际应用中,我们需要根据具体问题选择合适的分类方法,并结合具体情况进行调整和改进。
应用多元统计分析课后答案-朱建平版(前9章)
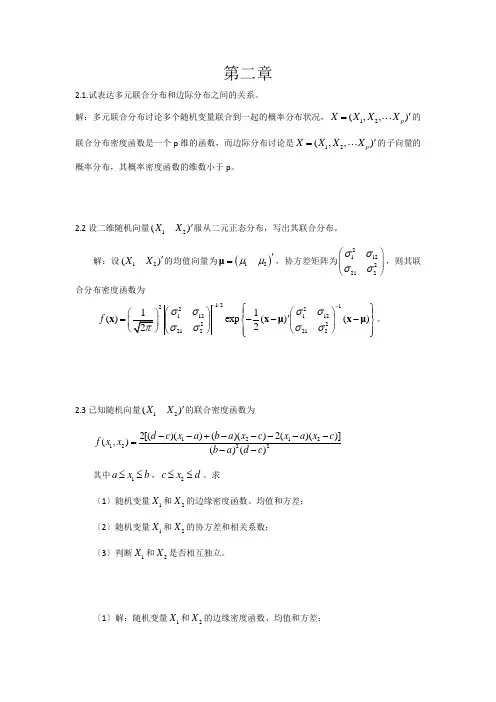
第二章2.1.试表达多元联合分布和边际分布之间的关系。
解:多元联合分布讨论多个随机变量联合到一起的概率分布状况,12(,,)p X X X X '=的联合分布密度函数是一个p 维的函数,而边际分布讨论是12(,,)p X X X X '=的子向量的概率分布,其概率密度函数的维数小于p 。
2.2设二维随机向量12()X X '服从二元正态分布,写出其联合分布。
解:设12()X X '的均值向量为()12μμ'=μ,协方差矩阵为21122212σσσσ⎛⎫ ⎪⎝⎭,则其联合分布密度函数为1/21222112112222122121()exp ()()2f σσσσσσσσ--⎧⎫⎛⎫⎛⎫⎪⎪'=---⎨⎬ ⎪⎪⎝⎭⎝⎭⎪⎪⎩⎭x x μx μ。
2.3已知随机向量12()X X '的联合密度函数为121212222[()()()()2()()](,)()()d c x a b a x c x a x c f x x b a d c --+-----=-- 其中1a x b ≤≤,2c x d ≤≤。
求〔1〕随机变量1X 和2X 的边缘密度函数、均值和方差; 〔2〕随机变量1X 和2X 的协方差和相关系数; 〔3〕判断1X 和2X 是否相互独立。
〔1〕解:随机变量1X 和2X 的边缘密度函数、均值和方差;112121222[()()()()2()()]()()()dx cd c x a b a x c x a x c f x dx b a d c --+-----=--⎰12212222222()()2[()()2()()]()()()()ddcc d c x a x b a x c x a x c dx b a d c b a d c -------=+----⎰12122222()()2[()2()]()()()()dd cc d c x a x b a t x a t dt b a d c b a d c ------=+----⎰2212122222()()[()2()]1()()()()d cdcd c x a x b a t x a t b a d c b a d c b a------=+=----- 所以由于1X 服从均匀分布,则均值为2b a +,方差为()212b a -。
判别分析

(1) 1 n1 (1) X i X (1) n1 i 1
( 2)
X ( 2)
(1) ( 2) 1 X X ( (1) ( 2 ) ) , 2 2 1 ( S1 S2 ), n1 n2 2
其中Si ( X
数学建模培训课件
判别分析
邱国新
qiugx02@
Def :判别分析是在已知研究对象分成若干类型(或 组别)并已取得各种类型的一批已知样品观测 数据,在此基础上根据某些准则建立判别式, 然后对未知类型的样品进行分类.
判别分析和聚类分析往往联合起来使用,当 总体分类不清楚时,可先用聚类分析对原来的一批 样品进行分类,然后再用判别分析建立判别式以对 新样品进行判别. 按照判别准则的不同,判别方法又分为距离判别 法,Fisher判别法,Bayes判别法和逐步判别法.
(1)当 (1) ( 2 ) 时, D 2 ( X , G2 ) D 2 ( X , G1 ) 2[ X
1 (1) 令 ( ( 2 ) ), 2
(1) ( 2 )
2
] 1 ( (1) ( 2 ) )
W ( X ) ( X ) 1 ( (1) ( 2 ) )
G2总体
X 1( 2 ) (2) X2 (2) Xn 2
( 2) X 11 ( 2) X 21 ( 2) Xn 21 ( 2) X 12 ( 2) X 22 ( 2) Xn 22 ) X 1( 2 p ( 2) X2p ( 2) Xn 2p
1
15
where
n1
( 1) ( 2) d k xk xk ,
贝叶斯,fisher判别法

距离判别法和Bayes判别法[color=black][size=3]距离判别法和Bayes判别法是判别分析中常用的两类判别法。
多元统计书上一般都有介绍。
简单说就是[font=MS Shell Dlg]判别给定的样本属于哪一类的。
比方说一堆样本,分好几类,样本有n个属性。
把这堆样本输入程序训练好后,程序就可以判别新的样本属于哪一类了。
[/font]我把它们做成了一个简单的界面,大家可以按界面提示操作下。
为了方便我准备了一些数据,见附件。
[font=MS Shell Dlg]train是训练样本(判别准备前用的),test是测试样本,即新数据,用来判别新样本中每一个属于哪一类的。
这里属性个数n=3。
实际使用时,n可以不局限于3。
训练样本只要按照附件中的格式(即第一列为类名,其余列为属性)存为xls文件即可。
测试样本直接就是由属性列组成的,每一行表示一个样本。
[/font][/size][/color][font=MS Shell Dlg][size=3]下面是代码(注释比较详细,用nested function写回调函数可以供GUI 初学者借鉴):[/size][/font][font=MS Shell Dlg][size=3][code]function DiscriminantMethodsfig=figure('defaultuicontrolunits','normalized','name','各类判别方法比较','numbertitle','off','menubar','none');%主界面,返回主界面句柄figUiButtonGroupH = uibuttongroup('Position',[0.55 0.08 0.40 0.85],'title','各判别方法','fontsize',12,'bordertype','etchedout');%群组对象,并返回句柄DistanceH = uicontrol('Style','Radio','String','距离判别法','fontsize',12,'pos',[0.05 0.73 0.9 0.15],'parent',UiButtonGroupH);%距离判别法的选项BayesH = uicontrol('Style','Radio','String','Bayes判别法','fontsize',12,'pos',[0.05 0.52 0.9 0.15],'parent',UiButtonGroupH);%Bayes判别法的选项FisherH = uicontrol('Style','Radio','String','Fisher判别法','fontsize',12,'pos',[0.05 0.31 0.9 0.15],'parent',UiButtonGroupH);%Fisher判别法的选项%下面几行建立相关按钮控件。
4-3_Fisher判别

整性。
在解决实际问题时,当总体参数未知,需要通过样本来估计,
我们仅对 k2 的情形加以说明。设样本分别为
X(1) 1
,
X(1) 2
,
X(1) n1
和
X(2) 1
,
X(2) 2
,
X(2) n2
,则
X n1X(1) n2X(2) n1 n2
X(1) X n2 (X(1) X(2) ) n1 n2
方法回顾
距离判别法 优点:简单,便于使用。 不足之处:
第一,判别方法与总体各自出现的概率的大小无关; 第二,判别方法与错判之后所造成的损失无关。 Bayes判别法 优点:错判率较小。 不足之处: 需要获取总体的分布及参数值,实现困难。 实际问题中有时也没必要知道其分布。
第四节 费歇(Fisher)判别法
E(uX) E(uX | Gi ) uE(X | Gi ) uμi i , i 1,2
D(uX) D(uX | Gi ) uD(X | Gi )u uΣiu
2 i
,
i 1,2
在求线性判别函数 时,尽量使得总体之间差异大,也就是要求
uμ1 uμ2 尽可能的大,即 1 2 变大;同时要求每一个总体内
的离差平方和最小,即
2 1
2 2
,则我们可以建立一个目标函数
(u) (1 2 )
2 1
2 2
(4.20)
这样,我们就将问题转化为,寻找 u 使得目标函数 (u) 达到
最大。从而可以构造出所要求的线性判别函数。
2、针对多个总体的情形
假设有 k 个总体 G1, G2 ,, Gk ,其均值和协方差矩阵分别为 μ i
判别分析
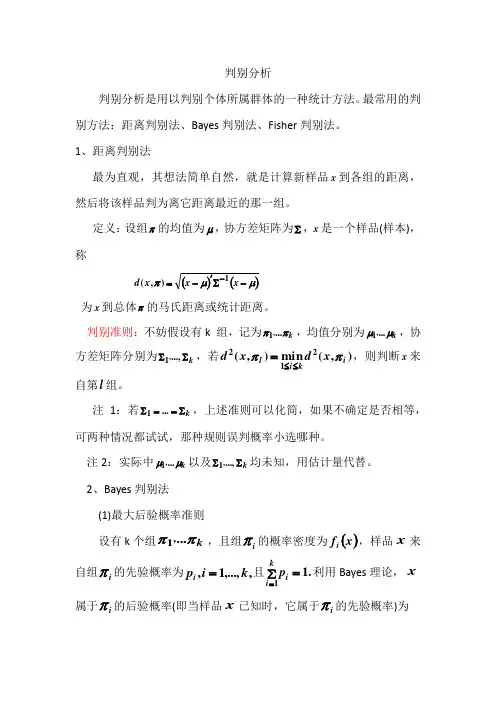
判别分析判别分析是用以判别个体所属群体的一种统计方法。
最常用的判别方法:距离判别法、Bayes 判别法、Fisher 判别法。
1、距离判别法最为直观,其想法简单自然,就是计算新样品x 到各组的距离,然后将该样品判为离它距离最近的那一组。
定义:设组π的均值为μ,协方差矩阵为∑,x 是一个样品(样本),称()()μμπ-∑'-=-x x x d 1),(为x 到总体π的马氏距离或统计距离。
判别准则:不妨假设有k 组,记为k ππ...1,,均值分别为k μμ...1,,协方差矩阵分别为k ∑∑...,1,,若),(min ),(212i ki l x d x d ππ≤≤=,则判断x 来自第l 组。
注1:若k ∑==∑...1,上述准则可以化简,如果不确定是否相等,可两种情况都试试,那种规则误判概率小选哪种。
注2:实际中k μμ...1,以及k ∑∑...,1,均未知,用估计量代替。
2、Bayes 判别法(1)最大后验概率准则设有k 个组k ππ...1,,且组i π的概率密度为()x f i ,样品x 来自组i π的先验概率为,,...,1,k i p i =且.11=∑=ki i p 利用Bayes 理论,x 属于i π的后验概率(即当样品x 已知时,它属于i π的先验概率)为()().,...,2,1,)(1k i x f p x f p x P k j j j i i i ==∑=π最大后验概率法是采用如下的判别规则:()x P x P x l ji l l πππ≤≤=∈1max )(,若. (2)最小平均误判代价准则()()()()∑∑≠=≤≤≠==∈ki j j j j k i j k l j j j l j i c x f p j l c x f p x 111m i n ,若π,其中)(j i c 表示将来自j π的x 判为i π的代价。
例:设有321,,πππ三个组,欲判别某样品0x 属于何组,已知()()().4.2,63.0,10.0,30.0,65.0,05.0030201321======x f x f x f p p p 计算:()()004.04.230.063.065.010.005.010.005.0)(1111=⨯+⨯+⨯⨯==∑=k j j j x f p x f p x P π ()361.02=x P π()635.03=x P π假定误判代价矩阵为95.4110063.065.020010.005.0:305.36504.230.01010.005.0:239.51604.230.02063.065.0:1=⨯⨯+⨯⨯==⨯⨯+⨯⨯==⨯⨯+⨯⨯=l l l 3、Fisher 判别基本思想:先对原始数据进行降维,然后对新数据使用距离判别法进行判别。
多元统计分析第4章作业题选讲

多元统计分析
解:由已知可得,
1 (1) 1 6 2 4 (2) x x 2 2 2 1 0.5
^
4 3 1 9 3 1 =S p 27 3 4 3 9 ^ ^ ^ ^ 1 9 3 4 1 1 a 1 2 27 3 4 3 0 x1 4 ^ ^ x 1 1 x 4 记x , 则W ( x) a x 1 1 x 0 x 2 2 2 6 6 当x , 则W ( x) 6 4=2 0 ,所以,x 属于总体G1. 0 0
i
1 令 W x a x μ ,其中 μ 2 μ1 μ2
i
i
a Σ 1 μ1 μ2 ,则上述判别规则可简化为:
x G1 , 若W x 0 x G2 , 若W x 0 待判, 若W x =0
由s≤min(k−1,p)知,组数k=2时只有一个判别式,k=3时最
多只有两个判别式,判别式的个数不可能超过原始变量的个 数p。
多元统计分析
第三步 写出判别式 第一判别式:y1=t1′x; 第二判别式:y2=t2′x;
一般地,第i判别式:yi=ti′x,i=1,2,⋯,s。
多元统计分析
(2)判别规则 选取前r(≤s)个判别式y1,y2,⋯,yr,使累计贡献率:
k
k
使ECM达到最小的判别规则:
k
l 1 l i
x l , 若 q j f j x C l | j min q j f j x C i | j
Fisher判别法距离判别法Bayes判别法逐步判别法
又D1,D2,┅,Dk是R(p)的一个分划,判别法则为: 当样品X落入Di时,则判
i 1,2,3,, k X Di 关键的问题是寻找D1,D2,┅,Dk分划,这个分划 应该使平均错判率最小。
【定义】(平均错判损失函数)
用P(j/i)表示将来自总体Gi的样品错判到总体Gj的条件 概率。 p( j / i) P( X D j / Gi ) fi ( x)dx i j
P好人 P做好事 / 好人 P好人 P (做好事 / 好人) P (坏人) P (做好事 / 坏人)
P (好人 / 做好事)
0.5 0.9 0.82 0.5 0.9 0.5 0.2
P坏人P做好事 / 坏人 P好人P (做好事 / 好人) P (坏人) P (做好事 / 坏人)
办公室新来了一个雇员小王,小王是好人还是坏人大家 都在猜测。按人们主观意识,一个人是好人或坏人的概率均为 0.5。坏人总是要做坏事,好人总是做好事,偶尔也会做一件坏 事,一般好人做好事的概率为0.9,坏人做好事的概率为0.2, 一天,小王做了一件好事,小王是好人的概率有多大,你现在 把小王判为何种人。。
目录 上页 下页 返回 结束
7
§4.2
距离判别
2018/10/4
目录 上页 下页 返回 结束
8
§4.2
距离判别
2018/10/4
目录 上页 下页 返回 结束
9
§4.2
距离判别
2018/10/4
目录 上页 下页 返回 结束
10
4.2.2 多总体情况
§4.2
距离判别
1. 协差阵相同。
2018/10/4
目录 上页 下页 返回 结束
判别分析--费希尔判别、贝叶斯判别、距离判别
判别分析--费希尔判别、贝叶斯判别、距离判别判别分析⽐较理论⼀些来说,判别分析就是根据已掌握的每个类别若⼲样本的数据信息,总结出客观事物分类的规律性,建⽴判别公式和判别准则;在遇到新的样本点时,再根据已总结出来的判别公式和判别准则,来判断出该样本点所属的类别。
1 概述三⼤类主流的判别分析算法,分别为费希尔(Fisher)判别、贝叶斯(Bayes)判别和距离判别。
具体的,在费希尔判别中我们将主要讨论线性判别分析(Linear Discriminant Analysis,简称LDA)及其原理⼀般化后的衍⽣算法,即⼆次判别分析(Quadratic Discriminant Analysis,简称QDA);⽽在贝叶斯判别中将介绍朴素贝叶斯分类(Naive Bayesian Classification)算法;距离判别我们将介绍使⽤最为⼴泛的K最近邻(k-Nearest Neighbor,简称kNN)及有权重的K最近邻( Weighted k-Nearest Neighbor)算法。
1.1 费希尔判别费希尔判别的基本思想就是“投影”,即将⾼维空间的点向低维空间投影,从⽽简化问题进⾏处理。
投影⽅法之所以有效,是因为在原坐标系下,空间中的点可能很难被划分开,如下图中,当类别Ⅰ和类别Ⅱ中的样本点都投影⾄图中的“原坐标轴”后,出现了部分样本点的“影⼦”重合的情况,这样就⽆法将分属于这两个类别的样本点区别开来;⽽如果使⽤如图8-2中的“投影轴”进⾏投影,所得到的“影⼦”就可以被“类别划分线”明显地区分开来,也就是得到了我们想要的判别结果。
原坐标轴下判别投影轴下判别我们可以发现,费希尔判别最重要的就是选择出适当的投影轴,对该投影轴⽅向上的要求是:保证投影后,使每⼀类之内的投影值所形成的类内离差尽可能⼩,⽽不同类之间的投影值所形成的类间离差尽可能⼤,即在该空间中有最佳的可分离性,以此获得较⾼的判别效果。
对于线性判别,⼀般来说,可以先将样本点投影到⼀维空间,即直线上,若效果不明显,则可以考虑增加⼀个维度,即投影⾄⼆维空间中,依次类推。
多元统计复习题 附答案
复习题原文: 答案:4.2 试述判别分析的实质。
4.3 简述距离判别法的基本思想和方法。
4.4 简述贝叶斯判别法的基本思想和方法。
4.5 简述费希尔判别法的基本思想和方法。
4.6 试析距离判别法、贝叶斯判别法和费希尔判别法的异同。
4.2 试述判别分析的实质。
答:判别分析就是希望利用已经测得的变量数据,找出一种判别函数,使得这一函数具有某种最优性质,能把属于不同类别的样本点尽可能地区别开来。
设R1,R2,…,Rk 是p 维空间R p 的k 个子集,如果它们互不相交,且它们的和集为 ,则称 , 为 的一个划分。
判别分析问题实质上就是在某种意义上,以最优的性质对p 维空间 构造一个“划分”,这个“划分”就构成了一个判别规则。
4.3 简述距离判别法的基本思想和方法。
答:距离判别问题分为①两个总体的距离判别问题和②多个总体的判别问题。
其基本思想都是分别计算样本与各个总体的距离(马氏距离),将距离近的判别为一类。
①两个总体的距离判别问题设有协方差矩阵∑相等的两个总体G 1和G 2,其均值分别是?1和? 2,对于一个新的样品X ,要判断它来自哪个总体。
计算新样品X 到两个总体的马氏距离D 2(X ,G 1)和D 2(X ,G 2),则X ,D 2(X ,G 1) D 2(X ,G 2)X ,D 2(X ,G 1)> D 2(X ,G 2, 具体分析,记()()W '=-X αX μ 则判别规则为 X ,W(X) X ,W(X)<0②多个总体的判别问题。
设有k 个总体k G G G ,,,21 ,其均值和协方差矩阵分别是和k ΣΣΣ,,,21 ,且ΣΣΣΣ====k 21。
计算样本到每个总体的马氏距离,到哪个总体的距离最小就属于哪个总体。
具体分析,21(,)()()D G ααα-'=--X X μΣX μ取ααμΣI 1-=,αααμΣμ121-'-=C ,k ,,2,1 =α。
Fisher判别法距离判别法Bayes判别法逐步判别法
总体G1 (i=1, …, p)
1 X1(1) …
i Xi(1) …
总体G2 (i=1, …, q)
p Xp(1) 1 X1(2)
…
i Xi(2) …
q Xq(2)
1
x11(1) … xi1(1) …
xp1(1) x11(2)
P(好人 / 做好事)
P好人P做好事 / 好人 P好人P(做好事 / 好人) P(坏人)P(做好事
/
坏人)
0.5 0.9
0.82
0.5 0.9 0.5 0.2
P(坏人/ 做好事)
P坏人P做好事/ 坏人 P好人P(做好事/ 好人) P(坏人)P(做好事
/
坏人)
0.5 0.2
0.18
0.5 0.9 0.5 0.2
7
目录 上页 下页 返回 结束
§4.2 距离判别
2020/6/22
8
目录 上页 下页 返回 结束
§4.2 距离判别
2020/6/22
9
目录 上页 下页 返回 结束
§4.2 距离判别
2020/6/22
10
目录 上页 下页 返回 结束
§4.2
4.2.2 多总体情况 1. 协差阵相同。
距离判别
2020/6/22
2020/6/22
3
目录 上页 下页 返回 结束
§4.1判别分析的基本理论
判别分析的假设之一,是每一个判别变量(解释变量)不 能是其他判别变量的线性组合。即不存在多重共线性问题。 判别分析的假设之二,是各组变量的协方差矩阵相等。判 别分析最简单和最常用的形式是采用线性判别函数,它们 是判别变量的简单线性组合。在各组协方差矩阵相等的假 设条件下,可以使用很简单的公式来计算判别函数和进行 显著性检验。 判别分析的假设之三,是各判别变量之间具有多元正态分 布,即每个变量对于所有其他变量的固定值有正态分布。 在这种条件下可以精确计算显著性检验值和分组归属的概 率。当违背该假设时,计算的概率将非常不准确。