
第四章联立方程模型
Chapter4 联立方程模型本章关注的目标Y 不止一个,而是多个。
或者其中关注的某一目标与其它目标有内在联系,如果我们不知道其它的目标,就不可能知道要关注的目标。
例如,我们要知道某一商品的市场价格,我们必须要同时知道该商品的供给曲线和需求曲线。
自然也就存在多因多果的关系问题。
从内生性问题角度看,某一解释变量i X 从另一方面考察可能成为Y 的结果,那么Y 就是原因,因为i X 中有Y 的成分,从而()0i E U X =不成立,产生内生性问题的第3种情形,联立性问题。
在第二章现代观点理念的陈述中,把Y 看成是一个随机向量(多个结果),所有的语言经过适当的修正,完全可以类似重复。
但由于因变量Y 的个数的增加,也就带来了许多“单方程线性回归模型”不曾有的问题。
本章主要讨论联立的线性系统。
内容主要在理论层面有:联立方程模型的表述,各种估计和检验的假设条件,系统的可识别,以及一些专题。
其中GMM 方法是本章的特色。
它把2SLS 的方法又提高了一步。
一、基本概念和模型系统:多个变量间的相互联系,一般用方程表述。
线性系统则认为它们的联系是线性的。
变量:描述系统状态的基本要素。
变量分成两类。
一类是内生变量,含义是,一旦系统变量间的相互联系确定,这些变量的值就是完全确立的。
内生变量一般是系统要关注的对象。
另一类是先决变量,含义是,它们的值不是由系统直接确定。
它又分成:(1)外生变量,它的值由系统的外部给定;(2)滞后的内生变量,它的值由内生变量的前期确定。
有时(1)(2)不加区分,统称为外生变量。
不过这两种内生变量有实质性区别,后一种滞后变量会带来内生性问题。
线性模型:系统中的变量通过线性方程或加上随机误差项联系,称为联立系统的线性模型。
联立模型分成简约式(reduced formed )和结构式(structure form )两种:1、简约式:每个内生变量由系统的先决变量的线性式加随机项构成,先决变量前的系数称为简约系数。
2、结构式:每个方程由内生变量和先决变量的混合线性式或加随机项构成。
结构式变量前的系数有确定的经济内涵,它们一般从理论模型简化而成。
一般把结构式分成四类:(1) 行为方程 (2) 技术方程 (3) 平衡方程(4) 定义方程每个结构方程中,变量前的系数称为结构参数。
系统的描述:Y 表示内生变量,设共有G 个内生变量:1Y ……G YX 表示先决变量,设有M 个先决变量:1X ……M XU 表示随机误差,误差项的个数随行为和技术方程的个数来定。
例:简单的宏观消费-投资模型: 消费方程:t t t U Y C ++=21αα可加随机项 不可加随机项投资方程:t t t t Y Y I εββ+-+=--)(2121 平衡方程:t t t t G C I Y ++=则:内生变量:t C ,t I ,t Y ;先决变量: 21,--t t Y Y t G ;随机误差:t t U ,ε。
联立方程模型主要分成三类:(1) 似无关模型(Seemingly Unrelated Regression )(SUR 模型)1111U X Y +=β 2222U X Y +=β……G U X Y G G G +=β模型中每个方程都是简约式(reduced form )有不同的先决解释变量和因变量,并有各自的参数值1,=g g β…G 。
相关联的仅是不可观测的误差项。
可以理解为系统有一个共同的环境,且系统间的因果关系由随机项构成。
由此设定:()1G |X 0g E U X =,g =1…G 。
这是一个很强的假定,意味着任意i U 与j X 不相关,弱一些的假定是:()0X |g =g U E ,g =1…G,仅要求g U 与g X 不相关,单方程的正确设定要求。
总体上,g U 可能与其他外生变量j X (g 不等于j )相关,似无关的含义是指后一种含义。
(2)面板数据模型(Panel Data )( PD 模型)t t t Y X U β=+,()|0,t t E U X = t =1,2…T。
这里,先决解释变量和参数值都相同。
区别的仅在于t ,一般理解为不同时段,也可以是其它指标如不同组、地区、城市等,t 表示为不同的因变量,因此T 是有限的。
t U 可理解为不同的因变量t 导致不同的随机误差。
因为t 是一个序列关系,故t U 和s U 可以不独立,也可以不同分布等,视各种实际情况而定。
注:1、这种简单形式的面板数据模型可以看成是一类特殊的联立方程。
其他各种特征的面板数据模型将在第五章中介绍。
SUR 和PD 是联立方程的特殊形式,其特点为每个内生变量i Y 都可以写成单方程的多元线性回归的形式,且都是正确设定的。
区别是,SUR 模型每个i Y 有自己的外生变量,而PD 则是所有t Y 都有相同的外生变量。
2、另一种介于SUR 和PD 模型的联立式称为跨方程的联立式,含义是:如果某i Y 与jY中有相同的先决变量,且参数值相同,那么可将i Y 与j Y 合并成跨方程的联立式,如:1121112111212122 00 k k k X X X Y Y X X X ββ⎛⎫⎛⎫⎛⎫= ⎪ ⎪ ⎪ ⎪⎝⎭⎝⎭⎝⎭+⎪⎪⎭⎫⎝⎛21U U ,并将其看成是一个整体。
(3)同时性模型(Simultanious Equation )(SEM)()()()()111111Y Y X U χδ=++ ……()()()()G G G G G G Y Y X U γδ=++这里,()h Y 是指不包括h 在内的其它内生变量的部分(()Y Y h ⊂);()h X 是指先决变量的部分(()X X h ⊂);()h γ和()h δ是变量()h Y 和()h X 的参数;h U 是随机误差。
即同时性模型是把每个内生变量写成其它部分内生变量和先决变量的线性式。
因为SEM 模型中右边方程中含有其它内生变量,所以内生变量1G Y Y 是同时确定的。
它不能象模型(1)和(2)那样,单独就可以确定。
如果我们能够通过线性变换把SEM 中右边的内生变量部分消去,得到它的简约式,那么SEM 也可以象SUR 和PD 那样处理。
我们把SEM 左边的每个h Y 都移到方程的右边,使其得到按行排列的统一的紧凑形式:0Y X U Γ+∆+=。
这里,1()G Y Y Y =是1×G矩阵,1()M X X X =是1×M 矩阵,且可以观测抽样;()ij γΓ=是G ×G 矩阵,()ij δ∆=是M ×G 矩阵,是未知参数;1()G U U U =是1×G矩阵,是随机误差。
注:紧凑式也可按列排成按行的转置形式:0Y X U Γ+∆+=。
这里,1()G Y Y Y '=是G×1矩阵,1()M X X X '=是M ×1矩阵,1()G U U U '=是G ×1矩阵,采取那种方式视方便而定。
假定Γ可逆,否则内生变量Y 中的选择至少有一个是多余的,且()E U U '∑=是随机误差的协方差阵,为G ×G 的非奇异矩阵。
那么模型可以方便地转化成简约式: ()()11Y X U X V --=-∆Γ+-Γ=∏+。
但是,将SEM 写成简约式面临一个问题:当我们从简约式通过取样,得到∏的估计∏ˆ,在什么条件下,我们可以从∏ˆ得到Γ和∆的估计ˆΓ和∆ˆ,称为系统的可识别问题。
这个问题不是显然的,甚至有点微妙。
因为Γ与∆是原模型的未知参数,有其经济含义,如果从∏ˆ得不到Γ和∆的估计ˆΓ和∆ˆ,∏ˆ的估计就没有意义。
这个问题我们放到后面讨论,先讨论联立方程模型的估计和检验。
二、联立方程的估计和检验为要利用单方程的多元回归方法,我们先把联立方程中的三种形式统一处理成Y X U β=+的矩阵形式。
(1)SUR 模型1111222000000G G G G X U Y X U Y X U Y X U ββββ⎛⎫⎛⎫⎛⎫⎛⎫ ⎪⎪ ⎪ ⎪ ⎪⎪ ⎪==+=+ ⎪⎪⎪ ⎪ ⎪ ⎪⎪ ⎪⎝⎭ ⎭⎝⎭⎝⎭⎝。
(2)PD 模型11T T Y X Y U X U Y X ββ⎛⎫⎛⎫ ⎪ ⎪==+=+ ⎪ ⎪ ⎪ ⎪⎝⎭⎝⎭。
(3)SEM 模型(1)(1)111(2)(2)22()()()0000()0000()G G G G G Y X U Y Y X U Y X U Y Y X U ββββ⎛⎫⎛⎫⎛⎫⎛⎫ ⎪ ⎪ ⎪⎪ ⎪ ⎪ ⎪==+=+ ⎪ ⎪ ⎪ ⎪⎪ ⎪ ⎪ ⎪⎝⎭⎪ ⎝⎭⎝⎭⎭⎝。
这里X 是G ×K 矩阵,G 、K 视不同联立形式而定。
加上下标i 表示第i 次随机抽样。
类似于单方程模型,对总体联立式Y X U β=+的OLS 估计与检验有如下假定: 假定:Sols1: ()0i i E X U '= i ∀成立;Sols2:()i i E X X A '=非奇异 i ∀成立。
那么,()()1i i i i E X X E X Y β-''=⎡⎤⎣⎦i ∀。
从总体中随机N 次抽样,由得到:11111ˆN N Pi i i i i i SOLS X X X Y N N ββ-==⎛⎫⎛⎫''=−−→ ⎪ ⎪⎝⎭⎝⎭∑∑写成矩阵表达,()1ˆSOLS X X X Y β-''=,此与单方程形式上一致,但矩阵Y 、X 的内涵是不一样的。
这里将i 排成列,同样用Y 和X 表示为1(,,)N Y Y Y '=,Y 是NG ×1的矩阵,1()i G Y Y Y '=,1(,,)N X X X '=,1i N =。
对SUR ,X 是NG ×K 的矩阵;对PD ,X 是NT×K的矩阵。
)()11ˆ0,d Nββ---−−→A BA,()i i i iE X U U X''B=i∀。
又记,残差ˆˆi i iU Y Xβ=-,将i排成列得,ˆˆU Y Xβ=-。
那么,ˆˆˆpX UU X B''B=−−→。
于是,βˆ的渐近协方差估计()()()11ˆˆˆ--''''=XXXUUXXXV,Vˆ称为βˆ稳健的协方差估计。
且t值ˆˆ()j j NG Kse tββ-。
当N很大,近似于标准正态分布。
注:1)在联立方程模型中,对误差项协差矩阵Ω=()i iE U U'是没有任何限制的。
故ΩI2σ≠,仅是一个正定阵,所以SOLS方法仅能保证βˆ是一致的,不一定是有效的。
由于Ω的复杂性,如果未知,一般SOLS方法估计的效果是很差的,只是作为其他估计方法的过渡。
联立方程模型(计量经济学课件南京农业大学-周曙东)
能够处理内生性问题,提高估计的准确性。
缺点
需要满足一定的假设条件,如误差项与解释变量无关 等。
三阶段最小二乘法
原理
在两阶段最小二乘法的基础上,引入第三个 方程来修正第二阶段的估计偏误。
优点
进一步提高了估计的准确性。
缺点
计算复杂度增加,需要满足更多的假设条件。
PART 04
联立方程模型的检验
REPORTING
研究劳动力市场供需关系,解释工资水平、就业率等
经济现象。
02 考虑劳动力市场的竞争性和供需双方的相互作用。
03
通过联立方程模型,可以分析劳动力市场的动态变化
,为政策制定提供依据。
货币市场模型
01
02
03
研究货币供应和需求之 间的关系,解释利率水 平、货币价值等经济现
象。
考虑货币市场的供求因 素和中央银行的货币政
01
联立方程模型能够综合考虑多个经济变量之间的关系,提供 更全面的经济分析。
02
通过联立方程模型,可以更好地理解经济系统的内在机制和 动态变化。
03
联立方程模型还可以用于预测和政策分析,帮助决策者制定 更加科学和有效的经济政策。
联立方程模型的应用场景
宏观经济分析
联立方程模型可以用于分析宏观 经济变量之间的关系,例如国内 生产总值、通货膨胀率、利率等。
联立方程模型的优势与局限性
• 可以更好地处理经济系统的动态性和非线 性关系。
联立方程模型的优势与局限性
01
模型设定和识别问 题
联立方程模型的设定和识别具有 一定的主观性和难度,容易产生 模型误设和识别错误。
计算复杂性
02
03
数据要求高
计量经济学第四章
Ⅰ、联立方程模型的提出
联立方程计量经济学模型是相对于单方程 计量经济学模型而言的,它以经济系统为 研究对象;以揭示经济系统中各部分、各 因素间的数量关系和系统的数量特征为目 标;用于经济系统的预测、分析和评价。 使计量经济学模型的重要组成部分。
3
计量经济学
一、联立方程计量经济学模型问题
单方程计量经济学模型,只能描述经济变 量间的单向因果关系。但经济现象是错综 复杂的,许多经济变量间存在着交错的双 向或多项因果关系,因此需要建立多个单 方程组成的多方程模型,即联立方程模型。 其中每个方程都描述变量间的一个因果关 系。
0 Ct - b1Yt It - b0 - b2Yt-1 - 0 Gt u2t
- Ct Yt - It - 0- 0 Yt-1 - Gt 0
16
计量经济学
C t - a 1 Y t 0 I t - a 0 - 0 Y t -1 - 0 G t u 1t 0 C t - b 1 Y t I t - b 0 - b 2 Y t -1 - 0 G t u 2t - C t Y t - I t - 0 - 0 Y t-1 - G t 0 矩阵形式: BY X N
Ⅲ、联立方程计量经济学模型的识别
联立方程模型的识别性,主要指联立方程模型 中包含的各种影响和关系,是否可以明确辨别 或惟一确定。联立方程模型的识别性,实际上 与结构参数和简化参数之间存在明确的一一对 应关系有关,因此对联立方程模型的分析有重 要影响。
27
计量经济学
同上
联立方程模型的识别问题的本质:由于联立 方程模型中有许多个方程,内生变量的水平 是由多个方程的共同作用所决定的,因此能 否根据观测到的变量数据推测出生成它们的 各方面经济关系,很值得疑问。
计量经济学之联立方程模型
计量经济学之联立方程模型引言联立方程模型(Simultaneous Equation Model,简称SEM)是计量经济学中的一个重要分析工具,用于研究多个经济变量之间的相互关系。
通过建立一组方程,可以理解变量之间的联动效应,并进行预测和政策分析。
本文将介绍联立方程模型的基本概念、建模步骤和常见的估计方法等内容。
基本概念联立方程模型的定义联立方程模型是指由多个方程组成的一种数学模型,用于描述多个经济变量之间的关系。
每个方程都包含一个因变量和若干个解释变量,以及一个误差项。
联立方程模型的核心思想是通过解方程组,得到各个变量的估计值,进而分析它们之间的关系。
基本假设在建立联立方程模型时,需要对变量之间的关系进行假设。
常见的基本假设有:1.线性关系假设:方程中的变量之间的关系是线性的。
2.独立性假设:各个方程中的误差项是独立的,即它们之间不存在相关性。
3.零条件均值假设:解释变量的条件均值为零,即解释变量的期望与误差项无关。
4.同方差假设:各个方程中的误差项方差相等。
建模步骤建立联立方程模型的步骤如下:步骤一:确定变量根据研究主题和数据可获得的变量,确定需要建立模型的变量集合。
步骤二:构建方程根据经济理论和实际问题,构建联立方程模型的方程形式。
每个方程包含一个因变量和若干个解释变量。
步骤三:参数估计通过收集数据,对联立方程模型进行参数估计。
常用的估计方法有最小二乘估计(Ordinary Least Squares,简称OLS)和广义矩估计(Generalized Method of Moments,简称GMM)等。
步骤四:模型诊断对估计得到的模型进行诊断,检验模型的拟合优度、参数显著性和误差项的假设等。
常见的诊断方法有虚拟变量检验、异方差性检验和序列相关性检验等。
步骤五:模型解释与政策分析根据估计得到的模型结果,解释各个变量之间的关系,并进行政策分析。
可以利用模型进行预测和模拟,评估不同政策对经济变量的影响。
联立方程模型(蓝色)
• 联立方程模型概述 • 联立方程模型的建立 • 联立方程模型的求解方法 • 联立方程模型的应用案例 • 联立方程模型的优缺点 • 联立方程模型的发展趋势与展望
01
联立方程模型概述
定义与特点
01
02
定义:联立方程模型是 特点 一种数学模型,用于描 述一组变量之间的相互 关系。它由多个方程组 成,每个方程描述一个 变量与其他变量的关系。
模型的可解释性和透明度
随着对模型复杂度增加的关注,未来联立方程模 型将更加注重可解释性和透明度。这有助于提高 模型的可靠性和可信度,促进模型在实际决策中 的应用。
人工智能技术的应用
人工智能技术,如深度学习、神经网络等,将在 联立方程模型中发挥越来越重要的作用。这些技 术可以帮助模型更好地处理非线性关系、高维数 据和复杂动态系统。
环境影响评估
联立方程模型可以用于评估各种人类活动对生态环境的影响,为环境决策提供科学依据。
05
联立方程模型的优缺点
优点
01
全面性
联立方程模型能够同时考虑多个经济变量之间的相互影响,从而更全面
地描述经济系统的内在机制。
02
准确性
联立方程模型通过建立多个方程来描述经济现象,可以更准确地估计参
数,提高预测的准确性。
政策效果评估
通过联立方程模型,可 以评估政策变动对经济 的影响,分析政策效果, 为政策制定提供参考。
交通规划
交通流量预测
联立方程模型可以用于预测交通流量,帮助交通管理部门 制定合理的交通规划,优化交通网络布局。
交通需求管理
通过联立方程模型分析交通需求与各种因素之间的关系, 制定有效的交通需求管理策略,缓解城市交通拥堵。
联立方程模型 make system
联立方程模型是一种数学方法,通过联立多个方程来描述和解决复杂的问题。
这种模型在经济学、物理学、工程学等领域中得到了广泛的应用,能够帮助研究人员理解和预测各种变量之间的关系。
本文将介绍联立方程模型的基本概念和应用,以及如何构建和求解联立方程模型。
一、联立方程模型的基本概念联立方程模型是一种描述多个变量之间关系的数学模型。
我们可以用一组方程组来表示这些变量之间的相互影响。
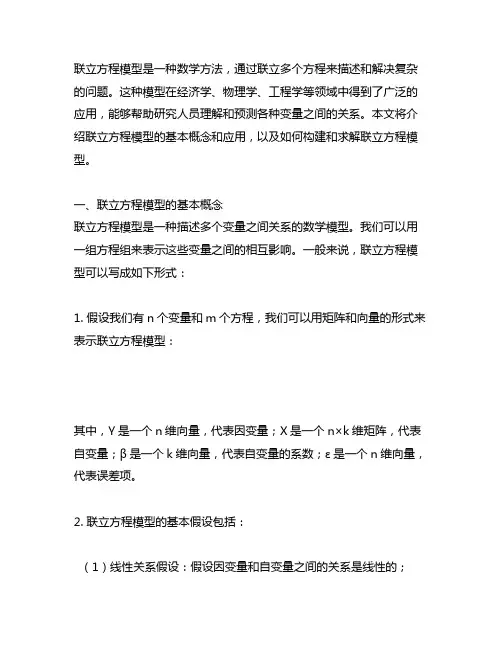
一般来说,联立方程模型可以写成如下形式:1. 假设我们有n个变量和m个方程,我们可以用矩阵和向量的形式来表示联立方程模型:其中,Y是一个n维向量,代表因变量;X是一个n×k维矩阵,代表自变量;β是一个k维向量,代表自变量的系数;ε是一个n维向量,代表误差项。
2. 联立方程模型的基本假设包括:(1)线性关系假设:假设因变量和自变量之间的关系是线性的;(2)随机抽样:样本必须是随机抽样的,以保证估计结果的一致性;(3)独立同分布假设:误差项之间是相互独立的,并且服从相同的分布;(4)方差齐性假设:误差项的方差是相同的。
二、构建联立方程模型构建联立方程模型的基本步骤包括:1. 确定研究的目标和问题:首先需要明确研究的目的,确定需要研究的变量和它们之间的关系。
2. 收集数据:根据研究目标,需要收集相关的数据样本。
3. 设定模型:选择合适的自变量和因变量,并设计出联立方程模型的形式。
4. 估计参数:通过最小二乘法或其他方法,估计模型的参数。
5. 检验模型:对模型的拟合度和估计结果进行检验,检验模型是否符合现实情况。
6. 修正模型:根据检验结果对模型进行修正,直至得到较为合理的模型。
三、求解联立方程模型求解联立方程模型的常用方法有:1. 最小二乘法:通过最小化因变量的观测值和模型估计值之间的差异来估计参数。
2. 极大似然估计:通过最大化样本数据出现的概率来估计参数。
3. 广义最小二乘法:当误差项不满足方差齐性和独立同分布假设时,可以使用广义最小二乘法进行参数估计。
9.4联立方程模型的识别条件

三、模型识别的一般程序 第一步,首先考虑阶条件。阶条件不成立,则方 程不可识别。 第二步,如果阶条件成立,再考虑秩条件是否成 立。如果秩条件不成立,则该方程仍不可识别。 第三步,秩条件成立时,再根据阶条件来判断是 过度识别,还是恰好识别。
8Leabharlann 例6:设宏观经济模型为:消费方程
Ct a0 a1Yt a2Tt u1t
K Mi G 1
3
阶条件可完整地表示成:
当K Mi G 1时,若第i个方程可识别,则为恰好识别; 当K Mi G 1时,若第i个方程可识别,则为过度识别; 当K Mi G 1时,阶条件不成立,则第i个方程不可识别。
需要指出的是,阶条件仅是一个必要条件,即该方 程不满足阶条件一定不能被识别,但满足阶条件不 一定就能被识别。只有根据别的方法判断某个结构 方程是可识别之后,才能根据阶条件来进一步确认 该方程是恰好识别还是过度识别。
虽然满足阶条件,但由于阶条件只是可识别的 必要条件,所以根据阶条件无法判断投资方程 是否可识别。
二、识别的秩条件 (充要条件)
秩条件的具体内容是:在具有G个方程的结构式 模型中,任何一个方程能够被识别的充分必要条 件是:该方程被斥变量结构参数矩阵的秩为G-1。 或者说,该方程被斥变量结构参数矩阵中,至少 有一个G-1阶的非零行列式。
投资方程 税收方程
It b0 b1Yt b2Yt1 u2t Tt c0 c1Yt u3t
收入方程
Yt Ct It Gt
其中为Ct消费额,It为投资额,Tt为税收,Yt为国 民收入,Gt为政府支出。判断模型中各结构方程 以及模型的识别性。
9
此联立方程模型中K=6,G=4。因消费方程、投 资方程中都只有3个变量,税收方程中有2个变量, 所以这三个方程都满足阶条件:
计量经济学联立方程模型evlr
需求函数 Pt 1 2Qt 2t
模型的简化式:
Qt
1 21 1t 2 2t 122 122
11 u1t
Pt
1 12 122
21t 2t 122
21 u2t
1 21 122
11
1 12 122
21
供求模型都不可识别。
在需求函数中引入收入变量 Yt来说明
变其量中。,Y如1,果,模Y型m 中为有m个常内数生项变,量X1;可X1视,为,始X k终为取k个值前为定1
的外生变量。
引入向量和矩阵记法
11 12 1m
R 21
22
2m
,
m1
m2
mm
Y1t
Y
Y2t
,
Ymt
11 12 1K
β
21
22
2K
,
m1
Yt Ct It Gt
变形为: Ct 0 1Yt 2Tt 1t , It 0 1Yt1 2rt 2t , Tt 0 1Yt 3t ,
Yt Ct It Gt 0
恒等方程无识别问题,因为无未知参数。
讨论第一个方程的识别性。根据阶条件的两个等价条 件,可知第一个方程是过度识别的。
(二)简单的例子
简单的两方程宏观经济模型
Ct Yt t
Yt Ct It
其简化式模型:
Ct
1
It
1
1
t
Π1It
ut
Yt11It11t
Π2It
ut
第一个方程的最小二乘估计为
Ct It
Πˆ 1 t
I
2 t
t
根据:
ˆ 1 ˆ
Πˆ 1
t
Ct It
联立方程模型的估计课件
详细描述
该模型假设货币供应和需求之间存在某种关 系,例如货币供应和需求都受到其他因素的 影响。通过联立方程模型,我们可以估计这 些关系,并进一步了解通货膨胀和货币价值 的变化对经济的影响。
案例四:经济增长模型
总结词
该模型通过经济增长的驱动因素,探讨了如何促进经济的长期稳定增长。
详细描述
该模型假设经济增长受到多种因素的影响,例如技术进步、投资、劳动力等。通过联立方程模型,我 们可以估计这些因素对经济增长的影响,并进一步了解如何促进经济的长期稳定增长。
的差异,评估模型的预测能力和解释能力。 根据评估结果,可以对模型进行修正和改进,
以提高模型的精度和可靠性。
联立方程模型估计的注意事项与挑战
内生性问题
总结词
内生性问题是指模型中的一个或多个解释变量与误差项相关,导致估计结果偏误。
详细描述
内生性问题的出现通常是由于解释变量与误差项相关,这会导致OLS估计量不一致。为 了解决内生性问题,可以采用工具变量法(IV)进行估计。
04
随着人工智能和机器学习技术的发展,未来联立方程模型的估计方法 将更加智能化和自动化。
THANKS
感谢观看
联立方程模型估计的步骤与流程
数据收集与整理
数据准备
在进行联立方程模型估计之前,需要收集相关的数据并进行整理。数据来源可以是调查、统计或其他 途径,需要确保数据的准确性和完整性。数据整理包括数据清洗、缺失值处理、异常值检测等步骤, 以确保数据质量。
模型设定与识别
模型构建
根据研究目的和问题背景,选择合适的联立方程模型进行设定。模型设定需要考虑变量之间的关系、因果关系等因素,并确 定模型的形式和结构。在模型设定后,需要进行识别,确定模型中变量的内生性和外生性,为后续的参数估计提供基础。
《计量经济学》-联立方程模型
γ 2k
X
kt
u2t
L L L L L L
bg1Y1t b Y g2 2t L b Y gg gt γ X g1 1t γ X g2 2t L γ X gk kt ugt
结构方程的个数等于内生变量的个数,称为完备模型
10
结构型的矩阵表示(一)
b11 b12 L
b21
b22
L
L L L
c5
a2b1 a b
,
c6
a3b1 a b
17
1.结构方程的识别
恰好识别:通过简化模型的参数估计值和参数关系式可以得到 结构方程的参数估计值的惟一解,该结构方程恰好识别
过度识别:通过简化模型的参数估计值和参数关系式可以得到 结构方程的参数估计值的多个解,该结构方程过度识别
不可识别:通过简化模型的参数估计值和参数关系式可以得不 到结构方程的参数估计值,该结构方程不可识别
u1t
u2
t
Ut
u
BYt ΓXt Ut
或
B
Γ
Yt Xt
Ut
12
2. 简化型
Ct
a1b2 1 a1
b1
Yt 1
a1 1 a1
b1
Gt
u1t
a1u2t b1u1t 1 a1 b1
It
b2 ( 1
1 a1 ) a1 b1
Yt
1
b1 1 a1 b1
Gt
u2 t
第九章
联立方程模型
主要内容
联立方程模型的概念 联立方程模型的形式 模型的识别 联立方程模型的参数估计
2
一. 联立方程模型的概念
由若干个单一线性经济计量方程构成联立方程组,描述整个经 济系统的模型称为联立方程经济计量模型,简称联立方程模型
第四章__联立方程模型
Chapter4 联立方程模型本章关注的目标Y 不止一个,而是多个。
或者其中关注的某一目标与其它目标有内在联系,如果我们不知道其它的目标,就不可能知道要关注的目标。
例如,我们要知道某一商品的市场价格,我们必须要同时知道该商品的供给曲线和需求曲线。
自然也就存在多因多果的关系问题。
从内生性问题角度看,某一解释变量i X 从另一方面考察可能成为Y 的结果,那么Y 就是原因,因为i X 中有Y 的成分,从而()0i E U X 不成立,产生内生性问题的第3种情形,联立性问题。
在第二章现代观点理念的陈述中,把Y 看成是一个随机向量,所有的语言经过适当的修正,完全可以类似重复。
但由于因变量Y 的个数的增加,也就带来了许多“单方程线性回归模型”不曾有的问题。
本章主要讨论联立的线性系统。
内容有,联立方程模型的表述,各种估计和检验的假设条件,系统的可识别,以及一些专题。
其中GMM 方法是本章的特色。
它把2SLS 的方法又提高了一步。
一、基本概念和模型系统:多个变量间的相互联系,一般用方程表述。
线性系统则认为它们的联系是线性的。
变量:描述系统状态的基本要素。
变量分成两类。
一类是内生变量,含义是,一旦系统变量间的相互联系确定,这些变量的值就是完全确立的。
内生变量一般是系统要关注的对象。
另一类是先决变量,含义是,它们的值不是由系统直接确定。
它又分成:(1)外生变量,它的值由系统的外部给定;(2)滞后的内生变量,它的值由内生变量的前期确定。
有时,(1)(2)不加区分统称为外生变量。
不过这两种内生变量有实质性区别,后一种滞后变量会带来内生性问题。
线性模型:系统中的变量通过线性方程或加上随机误差项联系,称为联立系统的线性模型。
模型分成简约式(reduced formed )和结构式(structure form )两种:1、简约式:每个内生变量由系统的先决变量的线性式加随机项构成,先决变量前的系数称为简约系数。
2、结构式:每个方程由内生变量和先决变量的混合线性式或加随机项构成。