
语音端点检测方法研究
语音端点检测方法研究
文章在研究语音识别系统中端点检测基本算法的基础上,分别对利用双门限的端点检测方法、利用小波变换的端点检测方法、利用倒谱相关理论的端点检测方法原理进行了阐述和说明,并对几种端点检测方法的特点进行了分析。
标签:端点检测;双门限;小波变换;倒谱
1 概述
就一般情况下来讲,在语音通信过程当中,大多采用有线电话网的方式来进行,但是由于某些地区环境及场合需要等因素,则需要通过无线电台来作为通信方式。
与此同时,在其实际应用过程中,整个通话过程由语音控制来实现。
具体来讲,有线方说话时本地无线电台则处于发射状态,相对应来讲远端无线电台为接收状态,相反来讲,当有线方沉默的时候,无线电台工作状态发转。
其中,语音端点检测方法和技术是关键,基于从某段语音信号当中来准确判断语音位置(起始点与终止点),从而有效地区分是否为语音信号这样的目的。
该技术对于减少数据的采集量、降低或者排除噪声段的干扰以及提高系统识别性能等方面具有关键作用。
2 利用双门限进行语音端点检测
首先确定短时能量和短时过零率符合端点起点判定条件的帧,接着再根据短时过零率和短时能量符合端点终点判定条件的帧。
除此之外,对于一些突发性噪声检测,比如由于门窗开关所引起的噪声,相对应来讲我们可以通过设置最短时间门限来进行判断。
具体来讲,当处于静音这一语音信号端点检测段时,如数值比低门限还低,与此同时最短时间门限大于计时长度,那么我们基本上可以确定这是一段噪音。
双门限的检测算法结合了短时能量和短时过零率的优点,在得到的端点检测结果中,其精确度和浊音检测都能得到很好的保证。
现在有很多的端点检测算法都是根据双门限的算法进行不同的改进,能使其各有优劣,从而适应于不同的情况和环境。
3 利用小波变换进行语音端点检测
小波变换属于时频分析的一种,具体来说是空间(时间)和频率的局部变换,因而能有效的从信号中提取信息。
小波变换能将信号在时域中表现不了的特征在频域中表现出来。
因此,利用小波变换的这一个特性,根据有效的说话人的声音数据和背景噪声数据的频谱存在明显差异的特征来进行端点检测。
一般有效的说话人的声音数据的频谱分布范围很大,而且频率的值也很大。
而背景噪声的频谱变化不大,而且值也较小。
因此先将语音数据分帧,将分帧后的数据进行一次小波变换,再对小波变换后的数据计算方差,如果计算的结果大于一定的阈值,那
么这帧即被记为起始帧,若在起始帧存在的情况下计算的结果小于阈值,则被记为结束帧。
4 利用倒谱系数和倒谱距离进行语音端点检测
(1)预处理:对8kHz采样信号进行预加重处理,然后分帧加窗,帧长取16ms(128个采样点),帧移4ms,对每一帧信号加128点的矩形窗。
(2)估计噪声倒谱系数和倒谱距离:阶数p取12,首先假定抽样信号起始10帧是背景噪声,利用这10帧的前5帧倒谱系数的统计平均值作为背景噪声倒谱系数的估计值,用向量表示。
同时计算这10帧的后5帧倒谱距离平均值作为背景噪声倒谱距离的估计值,其中表示当前帧的倒谱系数,为对应的倒谱系数。
(3)逐帧计算值:逐帧计算倒谱系数,然后由每帧信号的倒谱系数和噪声倒谱系数的估计值计算倒谱距离。
(4)确定判决门限:采用类似于短时能量检测法所使用的动态门限判决准则。
5 端点检测方法的对比分析结论
在对三种算法的算法特性、适用情况、检测精度和检测速度做一个总体的统计分析比较,三种端点检测方法的总体比较算法特征适用情况检测精度检测速度。
(1)双门限时域范围内对声音数据的能量和过零率分析高信噪比的环境低最快。
(2)小波检测频域范围内对声音数据进行小波变换后,方差分析高或低信噪比的环境高慢。
(3)倒谱检测频域范围内对声音数据进行倒谱变换后,计算倒谱距离高或低信噪比的环境高快。
通过对三种算法的比较,可以发现倒谱变换的端点检测方法是最具有实用价值的。
小波方法检测的声音数据虽然检测的精度很高,但是检测的速度很慢,相对适用于在实验室的情况下进行端点检测。
参考文献
[1]张雄伟,等.现代语音处理技术及应用[M].北京:机械工业出版社,2003.
[2]胡光锐.语音处理与识别[M].上海:上海科学技术文献出版社,1994.
[3]蔡莲红,等.现代语音技术基础及应用[M].北京:清华大学出版社,2003.
[4]韩纪庆,等.语音信号处理[M].北京:清华大学出版社,2004.
[5]何湘智.语音识别的研究与发展[J].计算机与现代化,2002,79(3).
[6]赵高峰,张雪英,侯雪梅.一种基于小波系数方差的语音端点检测方法[J].太原理工大学学报,2006,37(5).
[7]董力,陈宏钦,马争鸣.基于小波变换的语音段起止端点检测算法[J].中山大学学报(自然科学版),2005,44(3).
[8]胡光锐,韦晓东.基于倒谱特征的带噪语音端点检测[J].電子学报,2000,10(9).
[9]NASSAR AM,KADER N S,Refat AM. End point s detection for noisy speech using a wavelet based algorit hm[M].Buda2 pest Kluwer Academic Publishers,1999:9032906.
[10]Haigh J A,Mason J S. Robust V oice Activity Detection Using Cep stral Features[J].Computer,Communication,Control and Power Engineering. Proceedings of the IEEE Region 10 Conference TENCON,1993,3(3).。
基于语音端点检测的说话人识别技术研究
基于语音端点检测的说话人识别技术研究使用语音技术进行说话人识别已经成为了许多领域中重要的应用,如指挥控制系统,安全验证系统等。
而其中一个重要的技术就是语音端点检测。
本文将会对基于语音端点检测的说话人识别技术进行深入研究。
一、语音端点检测的意义语音信号的端点检测是指确定语音信号开始和结束的时刻点,是语音信号分帧的重要前提。
准确的语音端点检测可以有效地提高语音分析和识别的准确度,同时也对于多媒体信息的处理和储存有重要的意义。
因此,在语音领域中,语音端点检测一直是一个备受关注的领域。
二、常用的语音端点检测算法目前,常见的语音端点检测算法主要分为基于阈值的算法和基于能量的算法。
基于阈值的算法主要是通过设置一个阈值,对于低于这个阈值的部分进行滤除,从而确定语音信号的端点。
这种算法可以适用于噪声较小的环境,但是面对噪声干扰较大的环境时,就很难得到一个较准确的结果。
基于能量的算法主要是对语音信号的能量进行测量,通过设定预定的能量阈值,判断信号的端点位置。
这种算法不仅快速而且准确,还依靠于信号能量,而这对于多噪声环境中的语音信号进行处理来说尤为重要。
三、语音端点检测在说话人识别中的应用说话人识别主要是指通过语音信号,通过一定的分析和算法,来识别说话人的身份信息。
常见的应用场景包括指挥控制系统中的安全验证、电话银行等领域。
语音端点检测可以帮助确定语音信号的开始和结束点,从而有效地提高说话人识别的准确度。
在进行说话人识别之前,首先需要对语音信号进行分帧,并确定语音信号的端点。
通过使用基于能量的语音端点检测算法,可以得到更加准确的结果,从而提高说话人识别的准确度。
同时,在处理多噪声环境中的语音信号时,基于能量的算法也要比基于阈值的算法更加准确。
四、未来的发展趋势随着科技的不断发展,语音端点检测和说话人识别技术也将进一步发展。
未来的发展趋势主要集中在以下几个方面:1. 基于深度学习的语音端点检测算法的应用:近年来,深度学习在语音处理中得到了广泛应用。
基于深度学习的语音端点检测技术研究

基于深度学习的语音端点检测技术研究随着科技发展的不断进步,我们的生活日益方便。
从智能手机到智能音箱,语音交互已经成为了越来越普遍的方式。
作为语音信号处理的核心环节之一的语音端点检测技术,在当前的社会中也扮演着极其重要的角色。
然而,在实际应用中,由于环境的复杂性以及语音信号的多样性,语音端点检测技术还面临着许多的挑战。
而基于深度学习的语音端点检测技术,相较于传统的基于特征工程的方法,具备更好的鲁棒性、准确性和普适性。
本文将从深度学习的原理、语音端点检测中的应用以及未来的发展三方面,探讨基于深度学习的语音端点检测技术。
一、深度学习原理深度学习是机器学习的一种,其核心是对人工神经网络的深度分析和应用。
神经网络中有各种各样的层(Layer),每一层派生出的特征都是在前一层的基础上进行的。
由于每一层都有一定的非线性变换,因此在深层次上,神经网络可以对数据进行更复杂的抽象表示。
此外,深度学习还适用于处理大规模数据和高复杂度任务。
基于深度学习的语音端点检测技术也采用了人工神经网络作为处理的基本模型。
为了实现自动化特征提取和分类,采用了多层原子去混淆(Multiple layer atom separation method,MLASM)特征表示方法。
MLASM采用了层次化的思路,通过对各层原始语音特征进行滤波和下采样,最终生成具有高可区分度和抗干扰性的特征。
二、语音端点检测中的应用语音端点检测是指从音频信号中判断出语音的起始和终止时刻。
它是语音信号处理中的一个非常重要的问题,对于语音识别等领域的应用拥有着广泛的影响。
与此同时,语音端点检测技术的研究也得到了广泛的关注。
基于深度学习的语音端点检测技术在各方面的性能上都优于传统的方法。
首先,基于深度学习的方法具有更好的鲁棒性,例如对于语音信号的噪声环境进行检测时,传统的方法可能会出现误检情况,而基于深度学习的方法则不会受到这种干扰。
其次,基于深度学习的方法具有更好的准确性,可以更自然地判断音频信号的边界。
语音信号端点检测方法研究

是变时的 ,所以.实际计算的是短时频带方差 ,它
的实质 就是 计算 某一 帧信 号 的各 频带 能量 之 间 的方
测翻 。由于采集声音信号的最初的短时段为无语音 段 ,仅有均匀分布的噪声信号 ,因此可 以用 已知为 “ 静态”的最初几帧 ( 一般为 1 O帧)信号计算过零
i( ) 1, ) , o , )L,( } (
Z = i I , c2 f 】 T mn【 z+  ̄z , F c 其 中, 为经验值 ,一般取 2 ; c 尼 分别为根 5 z和 c 据所取最初 l 0帧样值算得的过零率的 “ 均值”和
其中的分量 ( ) 定义为 中心频率为 的滤波器的 输出能量 。它可以根据一帧信号通过一带通滤波器
摘
要: 介绍 了语音信 号的 3种端点检测方法 ,即能量过零率检 测方法、基 于频 带方差 的检测方法和
语 音 短 时信 息 熵检 测 方 法 ,并 对 3种 方 法 的优 缺 点 进 行 分析 。
关键 词 : 音 识 别 ; 点检 测 ; 音 信 号 处 理 语 端 语 中图 分 类 号 : N923 T 1. 4 文献 标 志 码 : A
来计算 ,也可以计算一帧信号的 F ,然后把某几 兀’
个频率分组组合而得。对于数字信号 ,最低频是 0 ,
最 高 频是 1 7 , 余 各 中心频 率 按 一 定 规 则 从 0到 n 。其
递增 。
收稿 日期 :0 8 0 — 5 修 回 日期 :0 8 0 — 6 20 — 8 1 ; 2 0 — 9 1
作 者简 介 : 志 霞 ( 9 9 , , 张 1 7 一)女 山西 原 平 人 。 20 年 9月就 06
噪声背景下语音端点检测方法的研究
噪声背景下语音端点检测方法的研究摘要:在实际环境中,并没有完全纯净的语音信号,一段语音信号往往都伴有噪声信号,所以研究在背景噪声环境中的语音端点检测更为重要。
常用的短时过零率法、短时能量法以及双门限法都存在着一个共同的问题,即对信噪比要求较高。
为了解决这一问题我们提出了一改进算法,即基于谱减法思想的语音端点检测的方法,有效的提高检测的正确率。
关键词:端点检测噪声短时能量短时过零率谱减法1、引言语音端点检测是指用计算机数字处理技术来找出语音信号中的字或词等的起点和终点这俩个端点。
作为语音识别的前端,准确的端点检测可以提高识别的准确率。
语音端点检测的困难在于一段信号中的无声段或者录制一段语音段的前后人为呼吸等产生的杂音、语音开始处的弱摩擦音或弱爆破音以及终点处的鼻音,这些使得语音的端点需要综合利用语音的各种信号特征,从而确保定位的精确性,避免包含噪音信号和丢失语音信号。
常用语音端点检测法有短时过零率法、短时能量法以及双门限法。
但是对于信噪比要求较高,所以本文提出了一种基于谱减法思想的语音端点检测算法,提高语音端点检测的正确率。
2、语音端点检测方法常用方法中的短时能量法,语音和噪声的区别可以体现在它们的能量上,语音段的能量与噪声段能量相比,要大于噪声段的能量,因此可以以此为依据进行检测;短时过零率法,短时过零率可以区别语音是清音还是浊音[1,2],因此它可以从背景噪声中找出语音信号;传统双门限比较法,首先为短时能量和过零率分别确定两个门限,较低的门限对信号的变化比较敏感,较高的门限是用来确定进入语音段。
当低门限被超过时,未必是语音的开始而很有可能是由很小的噪声所引起的波动,但当高门限被超过并且在接下来的时间段内一直超过低门限时,则意味着语音信号的开始[3]。
但是上述三种方法在低信噪比时检测效果就不是很理想了。
因此我们提出了一种改进算法。
3、基于谱减法思想的语音端点检测算法的研究3.1 谱减法概述由于语音生成模型是低速率语音编码的基础,当语音受到噪声干扰时,提取的模型参数将很不准确,重建的语音质量急剧恶化。
语音端点检测方法研究

语音端点检测方法研究1沈红丽,曾毓敏,李平,王鹏南京师范大学物理科学与技术学院,南京(210097)E-mail:orange.2009@摘要: 端点检测是语音识别中的一个重要环节。
有效的端点检测技术不仅能减少系统的处理时间,增强系统处理的实时性,而且能排除无声段的噪声干扰,增强后续过程的识别性。
可以说,语音信号的端点检测至今天为止仍是有待进一步深入的研究课题.鉴于此,本文介绍了语音端点算法的基本研究现状,接着讨论并比较了语音信号端点检测的方法,分析了各种方法的原理及优缺点,如经典的基于短时能量和过零率的检测方法,基于频带方差的检测方法,基于熵的检测方法,基于倒谱距离的检测方法等.并基于这些方法的分析,对端点检测方法做了进行了总结和展望,对语音信号的端点检测的进一步研究具有深远的意义。
关键词:语音信号;端点检测;噪声中图分类号:TP206. 11. 引言语音信号处理中的端点检测技术,是指从包含语音的一段信号中确定出语音信号的起始点及结束点。
语音信号的端点检测是进行其它语音信号处理(如语音识别、讲话人识别等)重要且关键的第一步. 研究表明[1],即使在安静的环境中,语音识别系统一半以上的识别错误来自端点检测器。
因此,作为语音识别系统的第一步,端点检测的关键性不容忽视,尤其是噪声环境下语音的端点检测,它的准确性很大程度上直接影响着后续的工作能否有效进行。
确定语音信号的起止点, 从而减小语音信号处理过程中的计算量, 是众多语音信号处理领域中一个基本而且重要的问题。
有效的端点检测技术不仅能减少系统的处理时间,增强系统处理的实时性,而且能排除无声段的噪声干扰,增强后续过程的识别性。
可以说,语音信号的端点检测至今天为止仍是有待进一步深入的研究课题。
2. 语音端点检测主要方法和分析在很长一段时间里,语音端点检测算法主要是依据语音信号的时域特性[2].其采用的主要参数有短时能量、短时平均过零率等,即通常说的基于能量的端点检测方法。
语音端点检测方法探析
【 关键词 】复 杂噪声环境 语音端点检测 方法
1端点检测系统结构框架
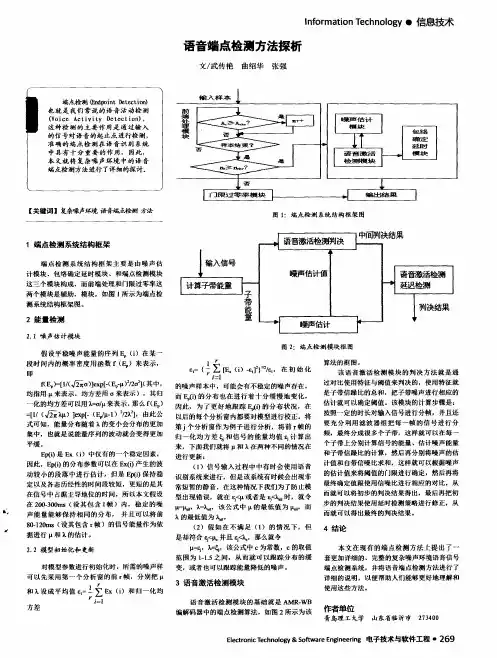
端 点检 测系 统结 构框 架主 要是 由 噪声估
—
- 一 语 音 激 活 喇 决
J L
哭 箔 果
吾音激活检测
计模块 、包 络确 定延时模块、和端点检测模块 这三个模块 构成 ,而前端处理和 门限过零率这 两个模块是辅助 ,模块 。如图 l 所示为端点检
均指用 来表示 ,均方差用 。来表 示 ),其 归 化 的均 方差可 以用 p来表示 , 那么 f ( )
估计就可 以确定阈值 。该模块的计算步骤是 : 要充 分利 用滤波 器 组把每 一帧 的信 号进 行分 频,最终分成很多个子带 ,这样就可 以在每一
个子带上分别计算信号的能量、估计噪声能量 和子带信躁 比的计算 ,然后再分别将噪声 的估 计值和 自带信噪 比求和,这样就可 以根据噪声
=
【 l , ( √
) ] e x p [ 一 ( E / | l ・ 1 ) 2 / 2 ,由 此公 以后的每个分析 窗内都要对 模型进行校正 。将 按照一定的时长对输入信号进行分帧 ,并且还
式可 知,能量分布随着 的变小会分布 的更加 集 中,也就是说能量序列的波动就会变得 更加 平缓 。 E p ( i ) 是E x( i )中仅有 的一个 稳定因素,
即
图2 :端点检测模 块框图
s 。 = ( 1 善 r i ) - £ I 】 2 } , 在 初 始 化
而E 订的分 布也 在进 行着十 分缓慢 地变 化,
因此 ,为 了更好 地跟踪 E n ( i ) 的分布 状况 ,在 第i 个分 析窗作 为例子进 行分析 ,将 前 r 帧的 归一 化均 方差 和信 号 的能量 均值 £ i 计算 出 来 ,下面我们就将 } l 和 在两种不同的情况在
端点检测方法的研究
黑龙江 李野 姬红旭 张磊 张晓雪
引 言
线性预测倒谱 系数( L P C C ) 、 梅尔频率倒谱系数( M F C C ) E 。
3 . 1线性预测 系数 线性 预测分 析是从 发生机理人手 , 全极点数字滤 波器是 线性预测分 析
在 采用 某些设 备对 语音 信号进 行采 集 时有可 能 出现语 音段 已经 结
束, 仍 然会 出现不希 望被采集到 的语 音片段 , 或者在 两段声音信号 之间出 现一段 空 白时 间, 此时 , 人们就希 望可 以通过某些 方法判断 出语音 信号的 起始点 , 即必须对语音信号进行端点检测 。
I s g n [ x ( Ⅲ ) 卜s g n [ x ( 一 1 ) 】 l
‘ …
¨, 、
,
误差为公式f 1 — 5 ) 所示 。
( ) ( ) 一 ( 月 ) ( " ) 一 a  ̄ s ( n — f ) ( 1 — 5 )
短 时过零率可 以粗略估计语音 的频谱特性 。通 过对语音产生 模型 的 分析 可知 , 低频率与低过零率相 对应 , 高频率与高过零率相对应 。
垦垦 垦塾 一 ! ! . ! 。 ! ! . ! ! . ! ! 一 . ! 一 . 。 … 。
端点检测方法的研究
摘 要: 在语音信号前端 处理技 术 中, 端点检测是一项十 分重要 的技术 。端 点检 测的 目的是在 有噪声的情 况
下找到语音信号 的起始 点和终止点 , 为后 续的语音信号研 究奠 定良好 的基础 。但是 由于噪声的存在 , 仅仅从 波形
一种语音信号端点检测方法的研究
一种语音信号端点检测方法的研究吴亮春潘世永(西华大学数学与计算机学院,四川成都 610039)摘要在语音识别系统中,端点检测的误差会降低系统的识别率,进行有效准确的端点检测是语音识别的重要步骤。
因此端点检测逐渐成为语音信号处理中的一个热点。
本文提出了一种基于模型的Teager 能量端点检测方法。
实验证明,该算法比传统的能量过零率端点检测算法具有更高的识别率,能够更准确的检测出语音信号的端点。
关键词端点检测;模型;过零率1 引言语音是人类相互交流和通信最方便快捷的手段。
如何高效地实现语音传输、存储或通过语音实现人机交互,是语音信号处理领域中的重要研究课题。
而语音端点检测是语音分析、语音合成、语音编码、说话人识别中的一个重要环节,直接影响到后续工作的准确性。
在实际应用中,首先通常要求对系统的输入信号进行判断,准确地找出语音信号的起始点和终止点,这样才能采集真正的语音数据,减少数据量和运算量,并减少处理时间。
在语音识别中,通常是先根据一定的端点检测算法,对语音信号中的有声片段和无声片段进行分割,而后再针对有声片段,依据语音的某些特征进行识别。
研究表明,即使在安静的环境中,语音识别系统一半以上的识别错误来自端点检测器。
因此,作为语音识别系统的第一步,端点检测的关键不容忽视,尤其是噪声环境下语音的端点检测,它的准确性很大程度上直接影响着后续的工作能否有效进行。
可以说,语音信号的端点检测至今仍是有待进一步深入研究的课题。
2 语音信号的时域特征2.1 短时能量分析语音信号的能量随着时间变化比较明显,一般清音部分的能量比浊音的能量小的多,所以在区分清音和浊音,有声段和无声段的应用中效果比较明显。
对于信号{x(n)},短时能量的定义如下:式中,, E n表示在信号的第n个点开始加窗函数时的短时能量。
通过上式可以看出,短时能量式语音信号的平方经过一个线性低通滤波器的输出,该线性低通滤波器的单位冲激响应为h(n)。
由于短时能量是对信号进行平方运算,因而增加了高低信号之间的差距,在一些应用场合并不合适。
本科毕业论文-—语音端点检测算法的研究及matla程序仿真与实现
摘要摘要语音端点检测是指从一段语音信号中准确的找出语音信号的起始点和结束点,它的目的是为了使有效的语音信号和无用的噪声信号得以分离,因此在语音识别、语音增强、语音编码、回声抵消等系统中得到广泛应用。
目前端点检测方法大体上可以分成两类,一类是基于阈值的方法,该方法根据语音信号和噪声信号的不同特征,提取每一段语音信号的特征,然后把这些特征值与设定的阈值进行比较,从而达到语音端点检测的目的,该方法原理简单,运算方便,所以被人们广泛使用,本文主要对基于阀值的方法进行研究。
另一类方法是基于模式识别的方法,需要估计语音信号和噪声信号的模型参数来进行检测。
由于基于模式识别的方法自身复杂度高,运算量大,因此很难被人们应用到实时语音信号系统中去。
端点检测在语音信号处理中占有十分重要的地位,直接影响着系统的性能。
本文首先对语音信号进行简单的时域分析,其次利用短时能量和过零率算法、倒谱算法、谱熵算法进行语音端点检测,并对这几种算法进行端点检测,并进行实验分析。
本文首先分别用各算法对原始语音信号进行端点检测,并对各算法检测结果进行分析和比较。
其次再对语音信号加噪,对不同信噪比值进行端点检测,分析比较各算法在不同信噪比下的端点检测结果,实验结果表明谱熵算法语音端点检测结果比其他两种方法好。
关键词语音端点检测;语音信号处理;短时能量和过零率;倒谱;谱熵IAbstractEndpoint detection is a voice signal from the accurate speech signal to the identify start and the end points, the purpose is to enable to separated the effective voice signals and un-useful noise. So, in the speech recognition system, speech enhancement, speech coding, echo cancellation and other systems are widely used.In Current the endpoint detection can be roughly divided into two categories, one is based on the threshold method based on the different characteristics of speech signal and the noise signals, a voice signal for each extracted feature, and then set the values of these thresholds compare with the values to achieve the endpoint detection purposes, This method is simple, it convenient operation, it is widely used, the main in this paper is based on the method of threshold method. Another method is based on the method of pattern recognition , it needs to estimate the speech signal and the noise signal model parameters were detected. Because is based on the method of pattern recognition and high self-complexity, a large amount of computation, so it is difficult to be use in real-time voice signal system for people.The Endpoint detection is take a very important position in the speech recognition, it directly affects the performance of the system. In this article first domain analysis in simple speech signal time, than dual threshold algorithm, cepstrum algorithm, spectral entropy algorithm for endpoint detection, and these types of endpoint detection algorithms, and experimental analysis points. Firstly, the algorithm were used to the original speech signal detection, and the algorithm to analyze and compare results. Secondly, the speech signal and then adding noise, SNR values for different endpoint detection, analysis and comparison of various algorithms under different SNR endpoint detection results, experimental results show that the spectral entropy of speech endpoint detectionIIalgorithm results better than the other two methods.Keywords voice activity detection;Signal processing; Average energy use of short-term and short-time average zero-crossing rat; cepstrum; spectral entropyIII毕业设计(论文)原创性声明和使用授权说明原创性声明本人郑重承诺:所呈交的毕业设计(论文),是我个人在指导教师的指导下进行的研究工作及取得的成果。
一种改进的语音信号端点检测方法研究
一种改进的语音信号端点检测方法研究摘要:在语音识别系统中端点检测有误差会降低系统的识别率,进行有效准确的端点检测是语音识别的重要步骤。
当信噪比较低时,传统的端点检测方法不能有效的工作。
为了提高系统的识别率,本文提出了一种更有效的端点检测算法,基于LPC美尔倒谱特征的端点检测方法。
它是基于倒谱特征方法的一种改进。
实验证明,该算法在低信噪比的情况下,能够准确的检测出语音信号的端点。
通过对三种不同的端点检测算法的比较,证明了基于LPC美尔倒谱特征算法在低信噪比的情况下有较高的检测正确率。
关键词:端点检测;语音识别;Mel倒谱距离;LPC美尔倒谱系数引言语音端点检测是语音识别中一个重要的步骤,进行有效的端点检测能够对语音信号更好的进行分析和训练,这样语音识别才能有好的识别率。
所以进行有效的端点检测是语音信号处理中首先要解决的问题。
传统的端点检测算法口如利用过零率、短时能量和自相关参数,在高信噪比环境下可以获得较好的检测效果,但在低信噪比环境下其检测性能却急剧下降。
当语音信号包含有背景噪音时,从中检测出语音信号的起始点和终止点,可以减少数据的采集量,删除不含语音信号的背景噪声和无声段,从而降低特征提取的计算量和处理时间,提高语音识别的准确性。
因此噪声环境中准确的检测语音起止位置有利于提高语音系统性能。
当语音中含有噪音时,传统的端点检测方法显得有些无能为力。
针对这种情况,提出了基于LPC美尔倒谱特征的端点检测算法。
它是对倒谱特征算法的一种改进。
1 基于倒谱特征的端点检测方法在大多数的语音识别系统中,选用倒谱特征参数作为语音信号的特征参数能够提高语音识别系统的性能。
因此用倒谱系数作为端点检测的参数。
信号倒谱可以看成是信号能量谱密度函数s( )的对数的傅立叶级数展开。
定义如下:(3)式中:Cn 和Cn′分别为对应于谱密度函数S(w)和S′(w)的倒谱系数。
对数谱的均方距离可以表示两个信号谱的区别,故它可以作为一个判决参数。