
总结:线性回归分析的基本步骤
如何进行回归分析:步骤详解(四)
回归分析是统计学中一种重要的分析方法,用于研究两个或更多变量之间的关系。
它可以帮助我们了解变量之间的因果关系,预测未来的趋势,以及检验假设。
在实际应用中,回归分析被广泛用于经济学、社会学、医学等领域。
下面将详细介绍如何进行回归分析的步骤。
第一步:确定研究的目的和问题在进行回归分析之前,首先需要明确研究的目的和问题。
例如,我们想要了解某个因变量与几个自变量之间的关系,或者我们想要预测未来的趋势。
明确研究目的和问题可以帮助我们选择合适的回归模型和变量。
第二步:收集数据接下来,我们需要收集相关的数据。
数据可以是实验数据、调查数据或者是已有的数据集。
在收集数据的过程中,需要保证数据的质量和完整性,以及避免数据的缺失和错误。
同时,还需要考虑数据的样本量和代表性,以确保结果的可靠性和有效性。
第三步:选择合适的回归模型在确定了研究目的、问题和收集了相关数据之后,接下来需要选择合适的回归模型。
常见的回归模型包括线性回归模型、多元线性回归模型、逻辑回归模型等。
选择合适的回归模型需要考虑多个因素,包括变量之间的关系、数据类型、模型的假设和可解释性等。
第四步:建立回归模型在选择了合适的回归模型之后,接下来需要建立回归模型。
建立回归模型的过程包括确定因变量和自变量之间的关系、估计模型的参数、检验模型的拟合度等。
在建立回归模型的过程中,需要考虑模型的解释能力和预测能力,以及模型的稳健性和可靠性。
第五步:评估回归模型建立回归模型之后,需要对模型的拟合度进行评估。
常用的评估方法包括确定系数(R-squared)、残差分析、假设检验等。
评估回归模型的过程可以帮助我们了解模型的解释能力和预测能力,以及检验模型的假设和稳健性。
第六步:解释结果和做出推断最后,根据回归模型的结果,我们可以对变量之间的关系进行解释和推断。
通过对回归系数的解释和显著性检验,我们可以了解自变量与因变量之间的关系,以及变量对因变量的影响程度。
同时,还可以利用回归模型进行预测和假设检验,以支持决策和推断。
总结:线性回归分析的基本步骤

线性回归分析的基本步骤步骤一、建立模型知识点:1、总体回归模型、总体回归方程、样本回归模型、样本回归方程 ①总体回归模型:研究总体之中自变量和因变量之间某种非确定依赖关系的计量模型。
Y X U β=+特点:由于随机误差项U 的存在,使得Y 和X 不在一条直线/平面上。
例1:某镇共有60个家庭,经普查,60个家庭的每周收入(X )与每周消费(Y )数据如下:作出其散点图如下:②总体回归方程(线):由于假定0EU =,因此因变量的均值与自变量总处于一条直线上,这条直线()|E Y X X β=就称为总体回归线(方程)。
总体回归方程的求法:以例1的数据为例,求出E (Y |X 由于01|i i i E Y X X ββ=+,因此任意带入两个X i 和其对应的E (Y |X i )值,即可求出01ββ和,并进而得到总体回归方程。
如将()()222777100,|77200,|137X E Y X X E Y X ====和代入()01|i i i E Y X X ββ=+可得:01001177100171372000.6ββββββ=+=⎧⎧⇒⎨⎨=+=⎩⎩以上求出01ββ和反映了E (Y |X i )和X i 之间的真实关系,即所求的总体回归方程为:()|170.6i i i E Y X X =+,其图形为:③样本回归模型:总体通常难以得到,因此只能通过抽样得到样本数据。
如在例1中,通过抽样考察,我们得到了20个家庭的样本数据:那么描述样本数据中因变量Y 和自变量X 之间非确定依赖关系的模型ˆY X e β=+就称为样本回归模型。
④样本回归方程(线):通过样本数据估计出ˆβ,得到样本观测值的拟合值与解释变量之间的关系方程ˆˆY X β=称为样本回归方程。
如下图所示:⑤四者之间的关系:ⅰ:总体回归模型建立在总体数据之上,它描述的是因变量Y 和自变量X 之间的真实的非确定型依赖关系;样本回归模型建立在抽样数据基础之上,它描述的是因变量Y 和自变量X 之间的近似于真实的非确定型依赖关系。
线性回归分析的基本步骤
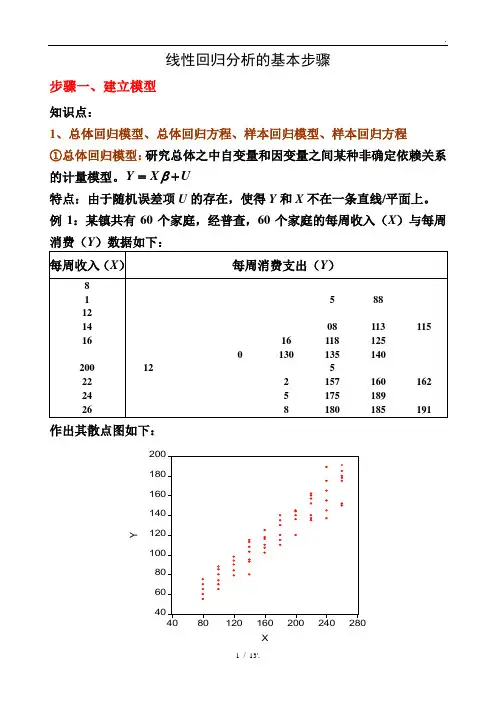
线性回归分析的基本步骤步骤一、建立模型知识点:1、总体回归模型、总体回归方程、样本回归模型、样本回归方程 ①总体回归模型:研究总体之中自变量和因变量之间某种非确定依赖关系的计量模型。
Y X U β=+特点:由于随机误差项U 的存在,使得Y 和X 不在一条直线/平面上。
例1:某镇共有60个家庭,经普查,60个家庭的每周收入(X )与每周消费(Y )数据如下:作出其散点图如下:②总体回归方程(线):由于假定0EU =,因此因变量的均值与自变量总处于一条直线上,这条直线()|E Y X X β=就称为总体回归线(方程)。
总体回归方程的求法:以例1的数据为例 由于01|i i i E Y X X ββ=+,因此任意带入两个X i 和其对应的E (Y |X i )值,即可求出01ββ和,并进而得到总体回归方程。
如将()()222777100,|77200,|137X E Y X X E Y X ====和代入()01|i i i E Y X X ββ=+可得:01001177100171372000.6ββββββ=+=⎧⎧⇒⎨⎨=+=⎩⎩以上求出01ββ和反映了E (Y |X i )和X i 之间的真实关系,即所求的总体回归方程为:()|170.6i i i E Y X X =+,其图形为:③样本回归模型:总体通常难以得到,因此只能通过抽样得到样本数据。
如在例1中,通过抽样考察,我们得到了20个家庭的样本数据:那么描述样本数据中因变量Y 和自变量X 之间非确定依赖关系的模型ˆY X e β=+就称为样本回归模型。
④样本回归方程(线):通过样本数据估计出ˆβ,得到样本观测值的拟合值与解释变量之间的关系方程ˆˆY X β=称为样本回归方程。
如下图所示:⑤四者之间的关系:ⅰ:总体回归模型建立在总体数据之上,它描述的是因变量Y 和自变量X 之间的真实的非确定型依赖关系;样本回归模型建立在抽样数据基础之上,它描述的是因变量Y 和自变量X 之间的近似于真实的非确定型依赖关系。
线性回归分析的基本步骤

线性回归分析的基本步骤一、什么是线性回归分析呢?线性回归分析啊,就像是我们在找一群散点之间的一种规律。
打个比方,就好像一群小蚂蚁在地上乱爬,我们要给它们找出一条路线来。
它主要就是用来研究两个变量之间的线性关系的。
比如说,我们想知道身高和体重之间有没有一种大概的关系,这时候线性回归分析就可能派上用场啦。
二、线性回归分析的基本步骤1. 数据收集这可是很关键的一步呢。
我们得先去找到我们要研究的那两个变量的数据。
比如说,如果我们要研究学习时间和考试成绩之间的关系,那我们就得去收集好多学生的学习时间和他们对应的考试成绩。
这些数据就像是我们做菜的食材,没有好的食材,后面的菜可就做不好啦。
而且这些数据得尽量准确,要是数据错了,那就像在沙子上盖房子,基础就不稳。
2. 数据可视化有了数据之后呢,我们就把这些数据画成图。
就像我们把一堆珠子按照一定的规律串起来,让我们能直观地看到这些数据大概是个什么样子。
通常我们会用散点图,把两个变量分别放在横纵坐标上,这样我们就能看到这些点大概是怎么分布的了。
如果这些点看起来像是在一条直线附近,那可能就比较适合做线性回归分析啦。
这一步就像是我们在出门之前先看看地图,大概了解一下方向。
3. 建立模型这一步呢,我们要假设两个变量之间存在一种线性关系,然后用一个方程来表示这种关系。
一般就是y = a+bx这样的形式,这里的y就是我们要预测的变量,x就是我们用来预测的变量,a和b呢,就是我们要找的参数。
这就好比我们要给一群小虫子建一个小房子,这个方程就是房子的框架。
我们要通过后面的步骤来确定这个框架的具体样子。
4. 估计参数现在我们要确定a和b的值啦。
这就需要用到一些数学方法,比如最小二乘法。
简单说呢,就是要让我们画出来的直线到那些散点的距离的平方和最小。
这就像是我们在调整小房子的柱子和横梁,让它能更好地适应这些散点的分布。
这一步算起来可能有点复杂,但是只要我们按照方法来,就能够得到比较合适的a和b的值。
线性回归分析
一元线性回归分析1.理论回归分析是通过试验和观测来寻找变量之间关系的一种统计分析方法。
主要目的在于了解自变量与因变量之间的数量关系。
采用普通最小二乘法进行回归系数的探索,对于一元线性回归模型,设(X1,Y1),(X2,Y2),…,(X n,Y n)是取至总体(X,Y)的一组样本。
对于平面中的这n个点,可以使用无数条曲线来拟合。
要求样本回归函数尽可能好地拟合这组值。
综合起来看,这条直线处于样本数据的中心位置最合理。
由此得回归方程:y=β0+β1x+ε其中Y为因变量,X为解释变量(即自变量),ε为随机扰动项,β0,β1为标准化的偏斜率系数,也叫做回归系数。
ε需要满足以下4个条件:1.数据满足近似正态性:服从正态分布的随机变量。
2.无偏态性:∑(εi)=03.同方差齐性:所有的εi 的方差相同,同时也说明εi与自变量、因变量之间都是相互独立的。
4.独立性:εi 之间相互独立,且满足COV(εi,εj)=0(i≠j)。
最小二乘法的原则是以“残差平方和最小”确定直线位置。
用最小二乘法除了计算比较方便外,得到的估计量还具有优良特性。
最常用的是普通最小二乘法(OLS):所选择的回归模型应该使所有观察值的残差平方和达到最小。
线性回归分析根据已有样本的观测值,寻求β0,β1的合理估计值^β0,^β1,对样本中的每个x i,由一元线性回归方程可以确定一个关于y i的估计值^y i=^β0+^β1x i,称为Y关于x的线性回归方程或者经验回归公式。
^β0=y-x^β1,^β1=L xy/L xx,其中L xx=J12−x2,L xy=J1−xy,x=1J1 ,y=1J1 。
再通过回归方程的检验:首先计算SST=SSR+SSE=J1^y−y 2+J1−^y2。
其中SST为总体平方和,代表原始数据所反映的总偏差大小;SSR为回归平方和(可解释误差),由自变量引起的偏差,放映X的重要程度;SSE为剩余平方和(不可解释误差),由试验误差以及其他未加控制因子引起的偏差,放映了试验误差及其他随机因素对试验结果的影响。
一元线性回归分析
一元线性回归分析摘要:一元线性回归分析是一种常用的预测和建模技术,广泛应用于各个领域,如经济学、统计学、金融学等。
本文将详细介绍一元线性回归分析的基本概念、模型建立、参数估计和模型检验等方面内容,并通过一个具体的案例来说明如何应用一元线性回归分析进行数据分析和预测。
1. 引言1.1 背景一元线性回归分析是通过建立一个线性模型,来描述自变量和因变量之间的关系。
通过分析模型的拟合程度和参数估计值,我们可以了解自变量对因变量的影响,并进行预测和决策。
1.2 目的本文的目的是介绍一元线性回归分析的基本原理、建模过程和应用方法,帮助读者了解和应用这一常用的数据分析技术。
2. 一元线性回归模型2.1 模型表达式一元线性回归模型的基本形式为:Y = β0 + β1X + ε其中,Y是因变量,X是自变量,β0和β1是回归系数,ε是误差项。
2.2 模型假设一元线性回归模型的基本假设包括:- 线性关系假设:自变量X与因变量Y之间存在线性关系。
- 独立性假设:每个观测值之间相互独立。
- 正态性假设:误差项ε服从正态分布。
- 同方差性假设:每个自变量取值下的误差项具有相同的方差。
3. 一元线性回归分析步骤3.1 数据收集和整理在进行一元线性回归分析之前,需要收集相关的自变量和因变量数据,并对数据进行整理和清洗,以保证数据的准确性和可用性。
3.2 模型建立通过将数据代入一元线性回归模型的表达式,可以得到回归方程的具体形式。
根据实际需求和数据特点,选择适当的变量和函数形式,建立最优的回归模型。
3.3 参数估计利用最小二乘法或最大似然法等统计方法,估计回归模型中的参数。
通过最小化观测值与回归模型预测值之间的差异,找到最优的参数估计值。
3.4 模型检验通过对回归模型的拟合程度进行检验,评估模型的准确性和可靠性。
常用的检验方法包括:残差分析、显著性检验、回归系数的显著性检验等。
4. 一元线性回归分析实例为了更好地理解一元线性回归分析的应用,我们以房价和房屋面积之间的关系为例进行分析。
线性回归分析步骤
线性回归分析步骤线性回归分析是一种统计学方法,用于确定两个变量之间的线性关系。
它可以用于预测特定的变量,并估计它们之间的关系。
它也可以用于识别影响变量的其他因素,以验证假设。
线性回归是定量分析的一个重要方面,可以帮助研究人员更好地理解数据,并从中得出有意义的结论。
本文将介绍线性回归分析的基本步骤,包括数据收集、数据分析、回归分析和结果解释。
首先,在进行线性回归分析之前,需要收集数据。
这可通过实验、观察、实地考察或从其他人获得这些资料。
通常,数据收集者需要有清晰的研究目的,确定有关数据的变量类型和范围,以及所涉及的样本大小。
收集的数据需要记录,以便进行数据分析的第二步。
接下来,需要对收集的数据进行分析。
其核心方法是计算两个变量之间的相关系数,以确定它们之间的线性关系。
如果两个变量之间呈线性关系,那么可以使用线性回归分析,以估计它们之间的相关性。
同时,在样本内可以应用其他技术,比如回归的分类、因变量的探索和多变量的线性回归分析,以帮助调查人员更好地理解数据。
第三步是实施回归分析,以估计变量之间的关系。
回归分析的过程包括选择回归模型、计算参数、检验模型好坏和比较模型之间的区别。
需要注意的是,计算参数时,应该考虑到所采用的统计方法,以确保结果的准确性。
最后,还需要解释结果,以获得有意义的结论。
结果解释可以采用模型诊断和参数检验的结果,以识别模型的弱点,并根据结果对结论进行调整。
另外,也可以检查预期的变量之间的联系,以及其他变量对模型结果的影响。
最后,可以利用结果改善和解释过程中的假设,以验证研究的可行性。
综上所述,线性回归分析是一种重要的定量分析技术,可以帮助研究人员更好地理解数据,以及从中得出有意义的结论。
它的基本步骤包括数据收集、数据分析、回归分析和结果解释。
在收集数据时,应记录所涉及的变量类型、范围和样本大小的信息;在进行数据分析时,要计算变量之间的相关系数;在运行回归分析时,应考虑回归模型、计算参数和检验模型的好坏;在解释结果时,应诊断模型弱点、检查预期变量及其他变量对模型结果的影响,以及利用结果改善和验证假设。
(整理)总结:线性回归分析的基本步骤
线性回归分析的基本步骤步骤一、建立模型知识点:1、总体回归模型、总体回归方程、样本回归模型、样本回归方程 ①总体回归模型:研究总体之中自变量和因变量之间某种非确定依赖关系的计量模型。
Y X U β=+特点:由于随机误差项U 的存在,使得Y 和X 不在一条直线/平面上。
例1:某镇共有60个家庭,经普查,60个家庭的每周收入(X )与每周消费(Y )数据如下:作出其散点图如下:②总体回归方程(线):由于假定0EU =,因此因变量的均值与自变量总处于一条直线上,这条直线()|E Y X X β=就称为总体回归线(方程)。
总体回归方程的求法:以例1的数据为例,求出E (Y |X 由于01|i i i E Y X X ββ=+,因此任意带入两个X i 和其对应的E (Y |X i )值,即可求出01ββ和,并进而得到总体回归方程。
如将()()222777100,|77200,|137X E Y X X E Y X ====和代入()01|i i i E Y X X ββ=+可得:01001177100171372000.6ββββββ=+=⎧⎧⇒⎨⎨=+=⎩⎩以上求出01ββ和反映了E (Y |X i )和X i 之间的真实关系,即所求的总体回归方程为:()|170.6i i i E Y X X =+,其图形为:③样本回归模型:总体通常难以得到,因此只能通过抽样得到样本数据。
如在例1中,通过抽样考察,我们得到了20个家庭的样本数据: 那么描述样本数据中因变量Y 和自变量X 之间非确定依赖关系的模型ˆY X e β=+就称为样本回归模型。
④样本回归方程(线):通过样本数据估计出ˆβ,得到样本观测值的拟合值与解释变量之间的关系方程ˆˆY X β=称为样本回归方程。
如下图所示:⑤四者之间的关系:ⅰ:总体回归模型建立在总体数据之上,它描述的是因变量Y和自变量X 之间的真实的非确定型依赖关系;样本回归模型建立在抽样数据基础之上,它描述的是因变量Y和自变量X之间的近似于真实的非确定型依赖关系。
总结线性回归分析的基本步骤
总结线性回归分析的基本步骤线性回归分析是一种统计方法,用于研究两个或更多变量之间的关系。
它的基本思想是通过构建一个线性函数来描述因变量与自变量之间的关系,并使用最小二乘法估计未知参数。
下面是线性回归分析的基本步骤:1.收集数据:首先,我们需要收集有关自变量和因变量的数据。
这些数据可以通过实验、观察或调查获得。
数据应该涵盖自变量和因变量的所有可能值,并且应该尽可能全面和准确。
2.绘制散点图:一旦我们收集到数据,我们可以使用散点图来可视化自变量和因变量之间的关系。
散点图展示了每个观测值的自变量与相应因变量的值之间的关系图形。
通过观察散点图,我们可以初步判断变量之间的关系类型,如直线、曲线或没有明显关系。
3.选择模型:在进行线性回归分析之前,我们需要选择适当的模型。
线性回归模型的形式为Y=β0+β1X1+β2X2+...+βnXn+ε,其中Y是因变量,X1,X2,...Xn是自变量,β0,β1,β2,...βn是未知参数,ε是误差项。
我们假设因变量与自变量之间的关系是线性的。
4.估计参数:在线性回归模型中,我们的目标是估计未知参数β0,β1,β2,...βn。
我们使用最小二乘法来估计这些参数,最小二乘法的目标是通过最小化残差平方和来选择最佳拟合直线,使预测值与观测值之间的差异最小化。
5.评估模型:一旦我们估计出参数,我们需要评估模型的拟合程度。
常见的评估指标包括残差分析、方差分析、回归系数的显著性检验、确定系数和调整确定系数。
这些指标可以帮助我们判断模型的有效性和可靠性。
6.解释结果:在得到合理的回归模型之后,我们可以使用回归方程来进行预测和解释结果。
通过回归系数可以了解自变量对因变量的影响程度和方向。
同时,我们可以进行假设检验,确定哪些自变量对因变量是显著的。
7.模型修正和改进:一旦我们获得了回归模型,我们可以进一步修正和改进模型。
这可以通过添加更多的自变量或删除不显著的自变量来完成。
同时,我们还可以使用交互项、多项式项或转换变量来探索更复杂的关系。
线性回归分析
线性回归分析线性回归分析是一种统计学方法,用于建立一个自变量和一个或多个因变量之间的线性关系模型。
它是一种常用的预测和解释性方法,在实际问题的应用广泛。
首先,线性回归分析的基本原理是通过找到最佳拟合直线来描述自变量和因变量之间的关系。
这条直线可以用一元线性回归方程 y =β0 + β1*x 表示,其中y是因变量,x是自变量,β0和β1是回归系数。
通过确定最佳拟合直线,我们可以预测因变量的值,并了解自变量对因变量的影响程度。
其次,线性回归分析需要满足一些假设前提。
首先,自变量和因变量之间呈线性关系。
其次,误差项满足正态分布。
最后,自变量之间不具有多重共线性。
如果这些假设得到满足,线性回归模型的结果将更加可靠和准确。
线性回归分析的步骤通常包括数据收集、模型设定、模型估计和模型检验。
在数据收集阶段,我们要搜集并整理相关的自变量和因变量数据。
在模型设定阶段,我们根据问题的需求选择适当的自变量,并建立线性回归模型。
在模型估计阶段,我们使用最小二乘法来估计回归系数,并得到最佳拟合直线。
在模型检验阶段,我们通过检验回归方程的显著性和模型的拟合程度来评估模型的质量。
通过线性回归分析,我们可以进行预测和解释。
在预测方面,我们可以利用回归模型对新的自变量数据进行预测,从而得到相应的因变量值。
这对于市场预测、销售预测等具有重要意义。
在解释方面,线性回归分析可以帮助我们了解自变量对因变量的影响程度。
通过回归系数的大小和正负,我们可以判断自变量对因变量的正向或负向影响,并量化这种影响的大小。
线性回归分析在许多领域都有广泛的应用。
在经济学中,线性回归模型被用于解释经济变量之间的关系,如GDP与失业率的关系。
在医学领域,线性回归模型可以用于预测患者的疾病风险,如心脏病与吸烟的关系。
在工程领域,线性回归模型可以用于预测材料的强度与温度的关系。
总之,线性回归分析在实践中具有广泛的应用价值。
然而,线性回归分析也存在一些局限性。
首先,线性回归模型只能处理线性关系,对于非线性关系的建模效果不佳。