
关于图分割的关键节点挖掘算法
9
算法流程图
选择feature最小 的节点加入网络
开始
读入网络
初始化空网络
是
否 结束
是否有未 加入网络 的节点
更新相关节点 feature
10
节点选择与特征更新
11
化简网络
12
算法介绍及分析
递归
贪心
递归
高复杂度,可以获得更好的结果。 如果递归深度够深,可以得到最优 结果
贪心
采用简单的贪心策略,能够处理 更大的网络
13
03
结果展示及展望
网络基本信息
15
网络基本信息
16
渗流结果
每次选择节点的度
real2 model3
17
改进
1. 可以在算法中加入递归。 2. 考虑网络的结构
18
谢谢
胡清华 电子科技大学
19
5
02
算法介绍
算法介绍
网络分割问题
不断删除网络中的节点
网络分割问题
关键节点挖掘
看问题的不同方式
每次选取一个节பைடு நூலகம்,将问题看做关键节点 挖掘问题
7
算法介绍
如何进行关键节点挖掘?
连通分支大小
8
两种处理方式
全网络 不断 删除节点
空网络 不断 加入节点
时间复杂度O(n), n为连通分支大小
时间复杂度为O(d), d为加入节点的度
关于图分割的 关键节点挖掘算法
胡清华 电子科技大学
1
01
问题简述 算法介绍
目录
CONTENTS
02
03
结果展示及改进
2
01
问题简述
问题简述
一个连通的网络。不断删除网络中的顶点和与删除顶点相关的边,网络会被
分割成多个连通分支。使删除之后的图中,最大连通分支最小。
4
问题简述
鲁棒性(Robustness):
结合闭合解抠图及最小生成树的图论分割算法
结合闭合解抠图及最小生成树的图论分割算法王卫星1,2,石红玉1【摘要】针对图像目标物体与背景边界交错在一起或两者之间边界不明晰以及背景与目标纹理相似的情况,进行图像分割非常困难.为此,提出了一种基于图论(graph theory)及闭合解抠图思想的图像分割算法.首先,利用闭合解抠图算法对图像进行预分割,粗糙地将图像分为前景和背景两部分;其次,提取目标及背景的细节,再分别用改进的图论分割算法细分割目标物体及背景,从而得到最终图像分割结果.实验结果表明,抠图算法避免了前景和背景的混叠,改进的图论算法可有效提高6%~12%的分割精度.与传统的区域合并、通常的图论及阈值算法相比,该算法精度高、效果好,具有显著优越性.【期刊名称】哈尔滨工业大学学报【年(卷),期】2014(000)009【总页数】6【关键词】闭合解抠图;图论;最小生成树;图像分割自1971年Zahn[1]最早将图论应用于图像分割和数据聚类以来,由于图论方法良好的数学基础及应用的扩展,基于图论的图像分割成为国内外研究的热点,并产生了多种基于图论的图像分割算法.主要包括:图切割相关算法[2-7],活动线(live wire)方法[8],随机游走与等周算法[9-11],最小生成树算法[12].值得一提的是2006年Sharon等[4]在《Nature》上提出的一种基于图方法的至上而下的分层分割方法,分割结果精准且效率高.另外,Felzenszwalb等[12]提出了“小而并之”的最小生成树分割算法,即当区域的内部差异大于区域之间的像素差异时,就认定两区域属于同质区域而将它们合并.该分割方法能够部分地根据不同的图像特性进行不同分割且效率较快,本文就以此方法为基础进行改进.上述最小生成树方法不足之处在于随着设置参数的增大,丢失了图像的很多细节,而参数设置过小容易产生过分割,无法正确把握分割尺度.为了解决这一问题,可以考虑结合预(粗)分割算法来进行补充,可能的预分割算法之一是抠图算法[13].抠图算法虽然不能检测出图像中目标物体的详细细节,但可以将整体目标物体从复杂背景图像中分割出来,弥补了图论方法在此方面的不足.Levin等[14]所提出来的closed-form solution算法通过用户的交互输入计算全局最优值,得到高质量的抠图结果.因此,本文方法结合图论和此算法,各取其长,在闭合解抠图算法粗分割的基础上用改进的图论方法对图像进行细分割,得到较为理想分割效果.1 基于闭合解抠图算法的预分割抠图是从图像背景中提取出前景目标的技术.对于输入图像I,存在以下颜色组合方程式中:F、B分别为前景色和背景色;α为不透明度,表征前景色所占的比重,0≤α≤1.关于α,本文进行四舍五入,即其取值非0即1,因为对于图论方法,为了进一步将对前景分割与背景分割得到的结果相加,本文设定对图像黑色像素点不进行处理.若α在0~1之间,则无论是前景还是背景都会对此部分像素进行基于图论的分割,最后相加时会产生前景和背景的重复叠加.根据闭合解抠图理论对本文研究图像进行处理,选取了两幅各具特色的自然景象(非人造目标)图像,图像中目标物体及背景的组合及纹理均复杂.如图1所示为闭合解抠图的结果与高效随机游走算法[15]分割结果的比较.由图1可以明显看出本文方法可以准确地将前景目标从背景图像中分割出来,包括前景和背景交错的部分,比如小鹿的身体与草丛、帆船的倒影等;而随机游走算法虽然能大致将前景与背景之间的边界描绘出来,但是对于边界点较为模糊或者前景与背景之间灰度值较为接近的情况,找到的边界并不准确.2 基于改进分割准则的图论算法的细分割在以上闭合解抠图结果的基础上,对图像前景进行基于图论的细分割.即将图像映射成一个加权图G(V,E),采用基于合并策略的Krusal算法进行分割,主要涉及3个参数:1)高斯滤波参σ;2)阈值函数参k,用来控制分割程度;3)再合并参数min-size.若两邻域其中一个的区域大小小于min-size,则将两区域合并.此方法分割效果好、算法结构简单且计算效率高,但它仍然有许多缺点,本文针对以上3个参数分别加以改进.2.1 图论算法的具体改进2.1.1 最小生成树中区域内部和区域间差异函数的改进如果仅仅用区域内的最大边权代表区域的差异程度,对某些图像而言,容易受噪声和孤立点的影响,分割效果也会变差,因此可以重新定义区域内部差异和区域间差异为式中N为最小生成树的边数,即N=|C|-1.此举虽然在一定程度上降低了敏感度,原方法中可以合并的两区域可能因此将不能合并,但可以通过调节参数k控制分割尺度.2.1.2 边权函数设计的改进原方法的权重函数仅仅是灰度值的绝对差异,而没有考虑到各像素的空间位置.若两像素空间位置较远,其相关性一般也会变弱,理应加大边权惩罚.因此可定义权重函数为其中:I(vi)、I(vj)分别为像素vi和vj的灰度级;d(vi,vj)定义为vi和vj 之间的空间欧式距离为为一个自适应的二维高斯因子式中:μi、μj分别为方向像素灰度级的期望;σi、σj分别为其标准差;r为其协方差.2.1.3 图映射分割后再合并机制的改进算法1)从分割S开始,对每一条边(vi,vj)∈E,vi∈C1,vj∈C2,如果C1≠C2并且|C1|<q且|C2|<q,那么就将C1和C2合并,得到新的分割Snew.2)对Snew中的每一条边,(vi,vj)∈E,vi∈C1,vj∈C2,如果C1≠C2并且|C1|<q或者|C2|<q,那么就将C1和C2合并.假设待分割图像的分辨率为3×3,分割S中每一顶点为一区域,p=4.由图2(a)可以看出,Step 1更容易得到大的区域,但一些小区域仍然存在.经过Step 2可以保证所有区域大小大于p.而原方法直接跳到第2步,使图像只得到一个分割区域,产生过合并现象.2.2 改进的图论分割算法与其他类似分割算法的比较分析对图1中图像的抠图结果图(目标物体图和背景图),分别进行基于改进Graph-Based算法、基于mean-shift模型的区域合并算法[16]以及Canny 边缘检测算法的图像分割,试验结果如图3所示.由于噪声太多,基于边界扫描(如Canny)的方法无法精确地勾画出各目标物体的轮廓及纹理等.区域合并算法有些地方过合并有些地方过分割,以下图像都不同程度地出现了这一问题.相较而言,基于改进图论的分割方法效果较好,小鹿身体中属于草丛部分完全被分离出去,第2排属于近处与远处的树木分割开来.该方法可以有效去除孤立点和其他噪声,并且将渐变区域合为同一区域.以上3种方法的处理速度如表1所示,其中区域合并方法未将mean shift预处理的时间计算在内,可见基于图论的分割方法效率较高.3 结果与分析经过以上分析,本文的算法(包括粗分割和细分割)的总流程图如图4所示.其中:①为闭合解抠图部分;②为基于改进图论算法的图像分割部分.当①中交互选取种子点时,根据本文图像纹理特点,为得到好的抠图效果与效率,选取的种子点像素数目占整幅图像的比率大致为3%~8%.按照图4对图像进行分割,图5演示了每一步的过程,此处种子点概率为4.53%.与原图论方法[12]以及文献[17]的改进图论方法进行比较(均在抠图基础上进行处理),调整各参数尤其是k以得到最优的分割效果.从图5可以看出,若没有预分割(闭合解抠图)步骤及图论算法的改进,原图论的分割算法很难分割这些边界模糊复杂的自然景象图像.基于图1中的图像,图6(a)是用本文算法处理的结果,图6(b)、6(c)分别是在抠图基础上用原算法和文献[17]算法处理的结果.两幅图像的种子点比率分别为5.67%、3.26%.从图1可以看出:第1幅图像中小鹿站在草丛中,身体与草丛混杂在一起,纵向看,小鹿身体上的花纹和身处的草丛均是垂直方向的纹理,只存在颜色的差异,是分割的难点所在,本文方法将小鹿和草丛准确分离,而原图论方法与文献[17]方法头部分割结果均不理想;第2幅图像中帆的颜色与水色灰度差异小,难以分辨,且近处树叶与远处树叶边界模糊,以及树叶缝隙与天空的交接等都给分割带来困难,本文方法较好的解决了以上难点,而原图论方法未将远处和近处树木合理分割,天空云彩欠分割,文献[17]方法除以上问题外,水中的帆船同样欠分割.针对以上两幅图像,根据人工绘制边界图7,分别比较,计算各方法的分割精度如表2所示.精度计算为式中:Epixel、Upixel分别为3种方法分割结果中边界点的正确率与错误率;λ为惩罚系数,其值越大对多余边界像素点的惩罚越大,精度也越低.考虑到图像的复杂性,本文未能将所有边界点都准确描绘出,且主要考量方面为正确率,因此本文取λ= 0.3;WEpixel为期望分割结果的总边界像素点.根据上述粗分割和细分割的结合方法,本文选取了40多幅具有不同代表性的边界模糊图像进行了试验,参照图6和表2的分析,本文提出方法可有效提高6%~12%的分割精度.4 结论1)本文针对目标边界不清楚的图像难以用常规图像分割算法进行分割的问题,提出了一种结合闭合解抠图和改进图论的分割方法.对闭合解抠图得到的背景和前景图像分别用改进的图论方法进行处理,再将两个结果合并得到最终分割结果.2)此方法不会产生前景与背景的错分割,亦可保留图像细节.3)将前景和背景分开处理,在用基于改进的图论方法进行分割时,具有可以分别根据前景和背景纹理特点设置不同分割尺度的优点,这在一定程度上避免了欠分割和过分割.4)从区域内部和区域间差异函数、边权函数和图映射分割后再合并机制3方面对图论方法进行改进,降低噪声对分割结果的影响,提高分割准确性.与原图论和区域合并方法相比,本文方法错分率小,具有良好的分割效果.参考文献[1]ZAHNC.Graph-theoreticalmethods for detecting and describing gestalt clusters[J].IEEE Transactions on Computers,1971,C-20(1):68-86.[2]SHI J,MALIK J.Normalized cuts and image segmentation[J].IEEE Transactions on Pattern Analysis and Machine Intelligence,2000,22(8):888-905.[3]BOYKOV Y,FUNKA-LEA G.Graph cuts and efficient ND image segmentation[J].International Journal of Computer Vision,2006,70(2):109-131.[4]SHARON E,GALUN M,SHARON D,et al.Hierarchy and adaptivity in segmenting visual scenes[J].Nature,2006,442(7104):810-813.[5]CHEN Yuke,WU Xiaoming,CAIKen,et al.CT image segmentation based in clustering and graph-cuts[J]. Procedia Engineering,2011,15:5179-5184.[6]侯叶.基于图论的图像分割技术研究[D].西安:西安电子科技大学,2011.[7]EGGER J,FREISLEBEN B,NIMSKY C,etal.Templatecut:a pattern-based segmentation paradigm[J].Nature Scientific Reports,2012,2:1-8.[8]WIECLAWEKW,PIETKA E.Fuzzy clustering in Intelligent scissors [J].Computerized Medical Imaging and Graphics,2012,36(5):396-409.[9]GOPALAKRISHNAN V,HU Y,RAJAN D.Random walks on graphs for salient object detection in images[J].IEEE Transactions on Image Processing,2010,19(12):3232-3242.[10]依玉峰,高立群,郭丽.基于Mean shift随机游走图像分割算法[J].计算机辅助设计与图形学学报,2011,23(11):1875-1881.[11]汪云飞,毕笃彦,黄飞.一种用于图像分割的等周算法改进[J].西安电子科技大学学报,2012,39(2): 87-94.[12]FELZENSZWALB P F,HUTTENLOCHER D P.Efficient graph-based image segmentation[J].International Journalof Computer Vision,2004,59(2):167-181.[13]WEXLER Y,FITZGIBBON A,ZISSERMAN A.Bayesian estimation of layers from multiple images[J].Computer Vision,2002,2352:487-501.[14]LEVIN A,LISCHINSKI D,WEISS Y.A Closed-form solution to natural image matting[J].IEEE Transactions on Pattern Analysis and Machine Intelligence,2008,30(2):228-242.[15]ANDREWSS,HAMAMEN G,SAAD A.Fast random walker with priors using precomputation for interactive medical imagesegmentation[J].Medical Image Computing and Computer-Assisted Intervention,2010,6363:9-16.[16]PENG Bo,ZHANG Lei,ZHANG D.Automatic image segmentation by dynamic region merging[J].IEEE Transactions on Image Processing,2011,20(12):3592-3605.[17]ZHANG M,ALHAJJ R.Improving the graph-based image segmentation method[C]//Proceeding of the 18thIEEE International Conference on Tools with Artificial Intelligence.Arlington:IEEE,2006:617-624.(编辑张红)基金项目:国家自然科学基金资助项目(61170147).。
图像处理领域的SIFT算法研究

图像处理领域的SIFT算法研究一、引言随着数字图像处理技术的不断发展,图像处理已经成为计算机科学和数学领域中的热门研究领域。
其中,视觉特征提取技术是图像处理中的重要一环。
在图像处理领域中,SIFT算法是一种非常重要的特征提取算法,它能够有效地进行图像匹配和目标识别等工作,并且在计算机视觉和机器学习等领域有着广泛的应用。
二、SIFT算法概述SIFT算法是由David Lowe在1999年提出的,是一种用来检测局部不变特征的算法。
它能够在不受旋转、尺度和亮度变化的影响下,从原始图像中提取出具有局部性、尺度性和方向性等特征的关键点,从而表示图像特征。
SIFT算法在图像匹配、目标识别、三维重建等领域中有着广泛的应用。
SIFT算法主要由两个步骤组成:关键点检测和特征描述。
1. 关键点检测:关键点检测是指从图像中提取具有局部不变性、尺度不变性和方向性的关键点。
SIFT算法使用高斯差分金字塔来检测尺度不变的关键点。
首先,图像被缩放到不同的尺度,然后在每个尺度上使用高斯差分滤波器来检测关键点,最后使用非极大值抑制来排除冗余点。
这样,SIFT算法就可以检测到不同尺度下的关键点。
2. 特征描述:特征描述是指对关键点进行描述,生成具有方向性的特征向量。
SIFT算法使用方向直方图来描述关键点的方向特征。
首先,计算每个关键点周围的梯度方向和梯度幅值,然后根据梯度方向将关键点周围的像素划分到8个方向的区间中,最后生成128维的特征向量。
这样,SIFT算法就可以对图像提取出具有局部性、尺度性和方向性等特征的关键点进行描述。
三、SIFT算法的实现SIFT算法的实现主要包括图像金字塔的构建、高斯差分算法的实现、关键点检测、方向直方图的计算和特征向量的描述等步骤。
1. 图像金字塔的构建SIFT算法使用图像金字塔对图像进行多尺度处理。
图像金字塔是一种常用的图像分析方法,它通过对图像进行不同程度的缩放来实现多尺度分析。
SIFT算法使用高斯滤波器来对原始图像进行多次下采样,构建成一系列由不同尺度空间幅度调整的高斯模糊图像,从而建立起尺度空间范围内的金字塔结构,用于检测尺度不变的关键点。
sift算法原理

sift算法原理SIFT算法原理。
SIFT(Scale-invariant feature transform)算法是一种用于图像处理和计算机视觉领域的特征提取算法。
它能够在不同尺度和旋转角度下提取出稳定的特征点,并且对光照、噪声等干扰具有较强的鲁棒性。
SIFT算法由David Lowe于1999年提出,至今仍被广泛应用于图像拼接、目标识别、三维重建等领域。
本文将介绍SIFT算法的原理及其关键步骤。
1. 尺度空间极值检测。
SIFT算法首先通过高斯滤波构建图像的尺度空间金字塔,然后在不同尺度空间上寻找局部极值点作为关键点。
这些关键点在不同尺度下具有不变性,能够在不同大小的目标上被检测到。
2. 关键点定位。
在尺度空间极值点的基础上,SIFT算法通过对尺度空间进行插值,精确定位关键点的位置和尺度。
同时,为了提高关键点的稳定性,还会对梯度方向进行进一步的精确计算。
3. 方向分配。
为了使关键点对旋转具有不变性,SIFT算法会计算关键点周围像素点的梯度方向直方图,并选择主方向作为关键点的方向。
这样可以使得关键点对于图像的旋转具有不变性。
4. 特征描述。
在确定了关键点的位置、尺度和方向后,SIFT算法会以关键点为中心,提取周围区域的梯度信息,并将其转换为具有较强区分度的特征向量。
这些特征向量可以很好地描述关键点周围的图像信息,从而实现对图像的匹配和识别。
5. 特征匹配。
最后,SIFT算法使用特征向量进行特征匹配,通常采用欧氏距离或者余弦相似度进行特征匹配。
通过匹配不同图像的特征点,可以实现图像的配准、目标的识别等应用。
总结。
SIFT算法作为一种经典的特征提取算法,在图像处理和计算机视觉领域具有重要的应用价值。
其关键在于通过尺度空间极值点的检测和特征描述子的构建,实现了对图像的稳健特征提取。
同时,SIFT算法对于光照、噪声等干扰具有较强的鲁棒性,能够应对复杂环境下的图像处理任务。
因此,SIFT算法在目标识别、图像拼接、三维重建等领域有着广泛的应用前景。
大数据挖掘主要算法

大数据挖掘主要算法1. 关联规则挖掘算法:关联规则挖掘是指从大规模数据集中发现项集之间的相关关系。
其中最著名的算法是Apriori算法和FP-Growth算法。
Apriori算法通过迭代地扫描数据集,找出频繁项集之间的关联规则。
FP-Growth算法通过构建FP树,有效地发现频繁项集。
2.分类算法:分类算法是指从已知的训练数据中学习一个分类模型,然后使用该模型对新的数据进行分类。
常用的分类算法有决策树算法、K近邻算法、朴素贝叶斯算法和支持向量机算法。
3.聚类算法:聚类算法是指将相似的数据点分组到同一个簇中。
常用的聚类算法有K均值算法、层次聚类算法和DBSCAN算法。
4.随机森林算法:随机森林是一种集成学习算法,它由多个决策树组成。
每个决策树由随机选择的数据集和特征组成。
随机森林的输出是由其所有决策树的输出合并而成的。
5.神经网络算法:神经网络是一种模仿人脑神经系统的计算模型。
在大数据挖掘中,神经网络算法被广泛应用于模式识别和分类问题。
6.支持向量机算法:支持向量机是一种监督学习算法,用于分类和回归分析。
它通过在数据空间中找到最大间隔超平面来进行分类。
7. 关键词提取算法:关键词提取是指从文本中识别出最重要的关键词。
常用的关键词提取算法有TF-IDF算法和TextRank算法。
8.用户画像算法:用户画像是指用于描述用户特征和行为的模型。
在大数据挖掘中,用户画像算法通过分析用户行为和兴趣,从而为用户提供个性化的推荐和服务。
9.时间序列分析算法:时间序列分析是指对一系列按时间顺序排列的数据进行分析和预测的方法。
常用的时间序列分析算法有ARIMA模型和LSTM神经网络。
10. 图挖掘算法:图挖掘是指从图数据中发现模式和知识的过程。
常用的图挖掘算法有PageRank算法和社区发现算法。
这些算法在大数据挖掘中起着重要的作用,能够处理海量的数据并从中提取有用的信息和知识。
随着技术的不断发展,也会有更多新的算法被提出来应对不断增长的大数据挑战。
找特征点的算法SIFT和SURF算法

找特征点的算法SIFT和SURF算法SIFT算法和SURF算法是用于图像特征点的检测与描述的两种经典算法。
它们在图像处理、计算机视觉和模式识别等领域得到广泛应用。
下面将分别介绍SIFT算法和SURF算法,并对其原理和应用进行详细阐述。
一、SIFT算法(Scale-Invariant Feature Transform)SIFT算法是由Lowe于1999年提出的一种用于图像特征点检测与描述的算法。
它通过分析图像的局部特征来提取与尺度无关的特征点,具有尺度不变性、旋转不变性和仿射不变性等优点。
1.特征点检测SIFT算法首先通过高斯差分金字塔来检测图像中的特征点。
高斯差分金字塔是由一系列模糊后再进行差分操作得到的,通过不同尺度的高斯核函数对图像进行卷积,然后对结果进行差分运算,得到图像的拉普拉斯金字塔。
在拉普拉斯金字塔上,通过寻找局部最大值和最小值来确定特征点的位置。
2.特征点描述在确定特征点的位置后,SIFT算法使用梯度直方图表示特征点的局部特征。
首先,计算特征点周围邻域内每个像素点的梯度幅值和方向,然后将邻域分为若干个子区域,并统计每个子区域内的梯度幅值和方向的分布,最后将这些统计结果组合成一个向量作为特征点的描述子。
3.特征点匹配SIFT算法通过计算特征点描述子之间的欧式距离来进行特征点的匹配。
欧式距离越小表示两个特征点越相似,因此选择距离最近的两个特征点作为匹配对。
二、SURF算法(Speeded Up Robust Features)SURF算法是由Bay等人于2024年提出的一种在SIFT算法的基础上进行改进的图像特征点检测与描述算法。
它通过加速特征点的计算速度和增强特征点的稳定性来提高算法的实时性和鲁棒性。
1.特征点检测SURF算法使用Hessian矩阵来检测图像中的特征点。
Hessian矩阵是图像的二阶导数矩阵,通过计算Hessian矩阵的行列式和迹来确定图像的局部最大值和最小值,从而找到特征点的位置。
图算法——狄克斯特拉算法
图算法——狄克斯特拉算法这⾥有⼀些定义及代码取⾃的简书,链接:,和的CSDN,链接:,感谢两位⼤佬。
狄克斯特拉算法(Dijkstra )⽤于计算出不存在⾮负权重的情况下,起点到各个节点的最短距离(单源最短路问题),如果要得到整个图各个顶点之间的最短距离,则需要对整个图的每个顶点都遍历⼀遍狄克斯特拉算法,显然不合适,所以这⾥要注意使⽤场合。
其思路为:(1) 找出节点集合U⾥⾯“最便宜”的节点,即可在最短时间内到达的节点,并将它加⼊集合S⾥⾯(问题⼆:为什么该节点可以加⼊S集合,也就是认为此时他与源节点距离最⼩),并把该节点从集合U⾥⾯取出。
(2) 更新该节点对应的邻居节点的开销(问题⼀:其含义将稍后介绍)。
(3) 重复这个过程,直到对图中的每个节点都这样做了。
(4) 计算最终路径。
为了防⽌重复遍历节点,引进两个集合S和U。
S的作⽤是记录已求出最短路径的节点(以及相应的最短路径长度),⽽U则是记录还未求出最短路径的节点(以及该节点到起点s的距离)。
由上可知,代码实现的时候要注意第⼀点即遍历U集合⾥⾯的最短路径和第⼆点更新开销。
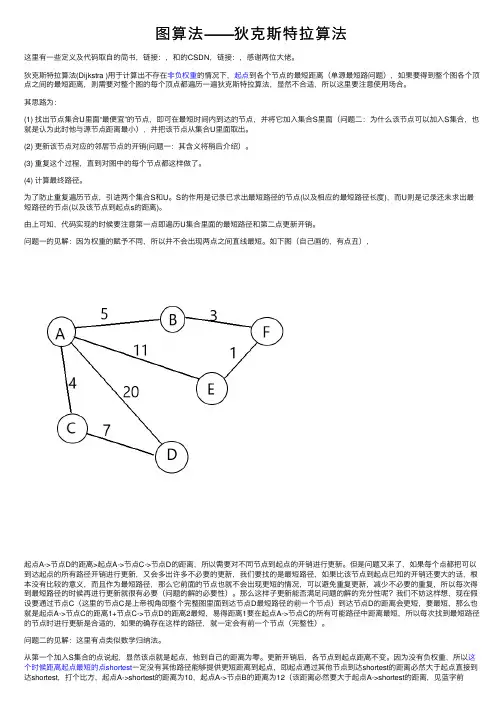
问题⼀的见解:因为权重的赋予不同,所以并不会出现两点之间直线最短。
如下图(⾃⼰画的,有点丑),起点A->节点D的距离>起点A->节点C->节点D的距离,所以需要对不同节点到起点的开销进⾏更新。
但是问题⼜来了,如果每个点都把可以到达起点的所有路径开销进⾏更新,⼜会多出许多不必要的更新,我们要找的是最短路径,如果⽐该节点到起点已知的开销还要⼤的话,根本没有⽐较的意义,⽽且作为最短路径,那么它前⾯的节点也就不会出现更短的情况,可以避免重复更新,减少不必要的重复,所以每次得到最短路径的时候再进⾏更新就很有必要(问题的解的必要性)。
那么这样⼦更新能否满⾜问题的解的充分性呢?我们不妨这样想,现在假设要通过节点C(这⾥的节点C是上帝视⾓即整个完整图⾥⾯到达节点D最短路径的前⼀个节点)到达节点D的距离会更短,要最短,那么也就是起点A->节点C的距离1+节点C->节点D的距离2最短,易得距离1要在起点A->节点C的所有可能路径中距离最短,所以每次找到最短路径的节点时进⾏更新是合适的,如果的确存在这样的路径,就⼀定会有前⼀个节点(完整性)。
大数据常见的9种数据分析手段
大数据常见的9种数据分析手段一、数据清洗与预处理数据清洗与预处理是大数据分析的第一步,它涉及到对原始数据进行筛选、去除噪声、填充缺失值等操作,以保证数据的质量和准确性。
常见的数据清洗与预处理手段包括:1. 数据去重:通过识别和删除重复的数据记录,避免重复计算和分析。
2. 缺失值处理:对于存在缺失值的数据,可以使用插补法(如均值、中位数、众数插补)或者删除缺失值的方法进行处理。
3. 异常值检测与处理:通过统计分析和可视化方法,识别和处理数据中的异常值,避免对分析结果的影响。
4. 数据转换与归一化:对数据进行统一的转换和归一化处理,使得数据在同一尺度上进行分析。
5. 数据集成与重构:将多个数据源的数据进行整合和重构,以便后续的分析和挖掘。
二、数据探索与可视化数据探索与可视化是通过统计分析和可视化手段,对数据进行探索和发现潜在的规律和关联。
常见的数据探索与可视化手段包括:1. 描述性统计分析:对数据进行基本的统计描述,包括均值、中位数、标准差等指标,以了解数据的分布和特征。
2. 相关性分析:通过计算相关系数或者绘制散点图等方式,分析变量之间的相关性和相关程度。
3. 数据可视化:利用图表、图形和地图等方式,将数据以可视化的形式展现,匡助用户更直观地理解数据。
4. 聚类分析:通过将数据分成若干个类别,发现数据中的内在结构和相似性。
5. 关联规则挖掘:通过挖掘数据中的关联规则,发现数据中的频繁项集和关联规则,用于市场篮子分析等领域。
三、数据挖掘与机器学习数据挖掘与机器学习是利用算法和模型,从大数据中发现隐藏的模式和知识。
常见的数据挖掘与机器学习手段包括:1. 分类与回归:通过训练模型,将数据分为不同的类别或者预测数值型变量。
2. 聚类与关联:通过挖掘数据中的相似性和关联规则,发现数据中的潜在结构和关联关系。
3. 预测与时间序列分析:通过建立时间序列模型,预测未来的趋势和变化。
4. 强化学习:通过与环境的交互,通过试错学习的方式,优化决策和策略。
如何使用图推荐算法优化网络推荐系统(二)
网络推荐系统是现代互联网服务中的重要组成部分,通过分析用户的行为和兴趣,向用户推荐合适的内容或商品。
而图推荐算法作为一种有效的推荐方法,可以帮助优化网络推荐系统,提升用户体验。
本文将介绍图推荐算法的原理和应用,并探讨如何使用该算法来优化网络推荐系统。
一、图推荐算法的原理图推荐算法基于图论和机器学习的理论,通过构建用户-内容或用户-用户的图模型,利用节点之间的关系来进行推荐。
具体来说,图推荐算法将用户和内容或用户之间的关系表示为图的节点,并使用边来表示节点之间的连接关系。
通过分析图的拓扑结构和节点属性,算法可以挖掘出潜在的用户兴趣和相关的内容。
二、图推荐算法的应用1. 社交网络推荐社交网络已成为人们获取信息和社交的重要平台。
图推荐算法可以分析用户在社交网络中的好友关系、互动行为等信息,向用户推荐与他们的兴趣相关的用户或内容。
例如,当用户关注一位摄影师时,算法可以推荐其他摄影师或与摄影相关的内容。
2. 电商推荐在电商平台上,图推荐算法可以分析用户的购买历史、评价等信息,构建用户-商品的图模型。
通过分析用户与商品之间的关系,算法可以向用户推荐符合他们兴趣和购买需求的商品。
例如,当用户购买一部手机时,算法可以推荐相应配件或其他用户购买过的相关商品。
3. 新闻资讯推荐新闻资讯是网络推荐系统的重要应用领域之一。
图推荐算法可以通过分析用户的阅读行为、新闻分类等信息,构建用户-新闻的图模型。
通过挖掘用户与新闻之间的关系,算法可以向用户推荐感兴趣的新闻内容。
例如,当用户频繁阅读与科技相关的新闻时,算法可以推荐其他与科技相关的新闻。
三、优化网络推荐系统的方法使用图推荐算法优化网络推荐系统可以采取以下几种方法:1. 丰富数据源为了构建准确的图模型,需要收集尽可能多的用户行为数据和内容特征。
可以考虑引入用户评价、收藏、点击等多种行为数据,以及文本内容的标签、关键词等特征,从而提升推荐的准确性。
2. 引入图嵌入技术图推荐算法的关键在于挖掘节点的相似性和关联性。
SIFT特征点提取与匹配
SIFT特征点提取与匹配SIFT(Scale-Invariant Feature Transform)特征点提取与匹配是一种在计算机视觉领域广泛使用的图像特征提取和匹配算法。
它由David G. Lowe于1999年提出,并在后续的研究中得到了改进和优化。
关键点检测的目标是找到一些具有局部极值的图像点。
这里的局部极值是指该点所在位置的像素值在周围邻域中达到最大或最小值。
为了实现尺度不变性,SIFT算法使用了高斯金字塔来检测不同尺度下的关键点。
高斯金字塔是通过对原始图像进行多次平滑操作得到的一系列图像,每一层图像的尺度比上一层的尺度大约减少一半。
在每一层中,使用DoG (Difference of Gaussians)来寻找关键点。
DoG是通过对两个邻近的高斯平滑图像进行差分操作得到的,它可以提供图像中的边缘和角点等信息。
通过在每一层的DoG图像中找到局部极值点,即可得到关键点的粗略位置。
为了进一步提高关键点的准确性,还需要对这些粗略位置进行精细的插值。
最终得到的关键点具有尺度和旋转不变性,并且能够抵抗光照变化的影响。
描述子的计算是对关键点周围区域的图像内容进行编码,生成一个具有较高区分度的特征向量。
首先,将关键点周围的邻域划分为若干个子区域,每个子区域内的像素值作为一个特征向量的元素。
然后,对每个子区域内的像素值进行高斯加权,以减小光照变化对特征描述子的影响。
最后,对加权后的像素值进行方向直方图统计,得到一个具有旋转不变性的特征描述子。
对于每个关键点,都会得到一个128维的特征向量。
这些特征向量可以通过比较欧式距离来进行匹配。
SIFT特征点匹配是通过在两个图像中的特征描述子之间进行比较,找到最佳匹配的特征点对。
常用的匹配方法是计算两个特征向量之间的欧式距离,并将距离最小的两个特征点视为匹配点。
为了提高匹配的准确性和鲁棒性,还可以采用诸如RANSAC(RANdom SAmple Consensus)的算法来剔除错误匹配。
数据结构中的最小割算法解析
数据结构中的最小割算法解析最小割算法是一种用于在图中找到最小割(最小割是指将图分成两个部分,使得两部分之间的边集权重之和最小)的有效方法。
在数据结构领域,最小割算法是一种重要的算法,被广泛应用于网络流问题、图像分割和社交网络分析等领域。
本文将详细解析最小割算法的原理、应用场景和具体实现。
一、最小割算法原理最小割算法的核心原理基于网络流的概念和图的割。
在图论中,网络流是指在一个带有容量限制的图中,从源节点到汇节点的流量传输问题。
而割是将图中的顶点分为两个不相交的集合,并将这两个集合分别称为源集合和汇集合,边的权重被称为割的容量。
最小割算法通过寻找图中的割,使得割的容量最小来达到最小割的目标。
最小割算法有多种具体实现方法,其中最著名的算法是Ford-Fulkerson算法和Edmonds-Karp算法。
Ford-Fulkerson算法通过不断寻找增广路径,即从源节点到汇节点的一条路径,使得路径上的边容量可以增加,从而提高流量。
而Edmonds-Karp算法则通过BFS(广度优先搜索)寻找增广路径,具有更高的效率。
二、最小割算法的应用场景最小割算法在实际应用中有广泛的应用场景,主要包括以下几个方面:1. 网络流问题:最小割算法被广泛应用于网络流问题中,如最大流问题、最小费用最大流问题和最大权闭合子图问题等。
通过寻找最小割,可以在网络中找到最大的流量或最小的流量。
2. 图像分割:最小割算法可以将图像分割为多个区域,从而实现图像语义分割、边缘检测和目标识别等应用。
3. 社交网络分析:最小割算法可以应用于社交网络中的群体发现、社区发现和信息传播等领域。
通过寻找最小割,可以将社交网络分割为不同的社区,从而更好地理解和分析社交网络的结构和特征。
三、最小割算法的具体实现最小割算法的具体实现与选择的算法密切相关。
在这里,我们以Ford-Fulkerson算法为例进行介绍。
1. Ford-Fulkerson算法:a. 初始化流量网络,设置初始流量为0。