
hive语法和常用函数
Hive是一个基于Hadoop分布式系统上的数据仓库,最早是由Facebook公司开发的,Hive极大的推进了Hadoop ecosystem在数据仓库方面上的发展。
Facebook的分析人员中很多工程师比较擅长而SQL而不善于开发MapReduce程序,为此开发出Hive,并对比较熟悉SQL的工程师提供了一套新的SQL-like方言——Hive QL。
Hive SQL方言特别和MySQL方言很像,并提供了Hive QL的编程接口。
Hive QL语句最终被Hive解析器引擎解析为MarReduce程序,作为job提交给Job Tracker运行。
这对MapReduce框架是一个很有力的支持。
Hive是一个数据仓库,它提供了数据仓库的部分功能:数据ETL(抽取、转换、加载)工具,数据存储管理,大数据集的查询和分析能力。
由于Hive是Hadoop上的数据仓库,因此Hive也具有高延迟、批处理的的特性,即使处理很小的数据也会有比较高的延迟。
故此,Hive的性能就和居于传统数据库的数据仓库的性能不能比较了。
Hive不提供数据排序和查询的cache功能,不提供索引功能,不提供在线事物,也不提供实时的查询功能,更不提供实时的记录更性的功能,但是,Hive能很好地处理在不变的超大数据集上的批量的分析处理功能。
Hive是基于hadoop平台的,故有很好的扩展性(可以自适应机器和数据量的动态变化),高延展性(自定义函数),良好的容错性,低约束的数据输入格式。
下面我们来看一下Hive的架构和执行流程以及编译流程:用户提交的Hive QL语句最终被编译为MapReduce程序作为Job提交给Hadoop执行。
Hive的数据类型Hive的基本数据类型有:TINYINT,SAMLLINT,INT,BIGINT,BOOLEAN,FLOAT,DOUBLE,STRING,TIMESTAMP(V0.8.0+)和BINARY(V0.8.0+)。
Hive的集合类型有:STRUCT,MAP和ARRAY。
Hive主要有四种数据模型(即表):(内部)表、外部表、分区表和桶表。
表的元数据保存传统的数据库的表中,当前hive只支持Derby和MySQL数据库。
内部表:Hive中的表和传统数据库中的表在概念上是类似的,Hive的每个表都有自己的存储目录,除了外部表外,所有的表数据都存放在配置在hive-site.xml文件的${hive.metastore.warehouse.dir}/table_name目录下。
Java代码1.CREATE TABLE IF NOT EXISTS students(user_no INT,name STRING,sex STRING,2. grade STRING COMMOT '班级')COMMONT '学生表'3.ROW FORMAT DELIMITED4.FIELDS TERMINATED BY ','5.STORE AS TEXTFILE;外部表:外部表指向已经存在在Hadoop HDFS上的数据,除了在删除外部表时只删除元数据而不会删除表数据外,其他和内部表很像。
Java代码1.CREATE EXTERNAL TABLE IF NOT EXISTS students(user_no INT,name STRING,sex STRING,2.class STRING COMMOT '班级')COMMONT '学生表'3.ROW FORMAT DELIMITED4.FIELDS TERMINATED BY ','5.STORE AS SEQUENCEFILE6.LOCATION '/usr/test/data/students.txt';分区表:分区表的每一个分区都对应数据库中相应分区列的一个索引,但是其组织方式和传统的关系型数据库不同。
在Hive中,分区表的每一个分区都对应表下的一个目录,所有的分区的数据都存储在对应的目录中。
比如说,分区表partitinTable有包含nation(国家)、ds(日期)和city(城市)3个分区,其中nation = china,ds = 20130506,city = Shanghai则对应HDFS上的目录为:/datawarehouse/partitinTable/nation=china/city=Shanghai/ds=20130506/。
Java代码1.CREATE TABLE IF NOT EXISTS students(user_no INT,name STRING,sex STRING,2.class STRING COMMOT '班级')COMMONT '学生表'3.PARTITIONED BY (ds STRING,country STRING)4.ROW FORMAT DELIMITED5.FIELDS TERMINATED BY ','6.STORE AS SEQUENCEFILE;分区中定义的变量名不能和表中的列相同。
桶区表:桶表就是对指定列进行哈希(hash)计算,然后会根据hash值进行切分数据,将具有不同hash 值的数据写到每个桶对应的文件中。
Java代码1.CREATE TABLE IF NOT EXISTS students(user_no INT,name STRING,sex STRING,2.class STRING COMMOT '班级',score SMALLINT COMMOT '总分')COMMONT '学生表'3.PARTITIONED BY (ds STRING,country STRING)4.CLUSTERED BY(user_no) SORTED BY(score) INTO 32 BUCKETS5.ROW FORMAT DELIMITED6.FIELDS TERMINATED BY ','7.STORE AS SEQUENCEFILE;内部表和外部表的主要区别:1)、内部表创建要2步:表创建和数据加载,这两个过程可以同步执行。
在数据加载的过程中,数据数据会移动到数据仓库的目录中;外部表的创建只需要一个步骤,表创建数据加载同时完成,表数据不会移动。
2)、删除内部表时,会将表数据和表的元数据一同删除;而删除外部表时,紧删除表的元数据而不会删除表数据。
在上一节《深入学习《Programing Hive》:Hive的数据模型(表)》中,已经学习过表的定义,接下来接着学习Hive的DDL操作。
复制表结构:Java代码1.CREATE TABLE IF NOT EXISTS students2 LIKE students;查看表结构:Java代码1.DESCRIBE TABLE students;删除表:Java代码1.DROP TABLE students;创建视图:Hive中的视图(view)的概念和传统数据库中的表是相同的,是只读的,目前还不支持不支持物化视图。
如果在创建试图后,再将基本表中被视图引用的列修改,那么修改后的数据列将不会体现在视图中;如果基本表被删除或以不兼容的方式被修改,则查询该视图时会失败。
Java代码1.CREATE VIEW IF NOT EXISTS view_students (user_no,name,score)2.AS3.SELECT user_no,name,score FROM students;删除视图:Java代码1.DROP VIEW view_students;定制表存储方式:Java代码1.CREATE TABLE IF NOT EXISTS employees(2. no STRING,3. name STRING,4. salary FLOAT,5. subordinates ARRAY<STRING>,6. deductions MAP<STRING,FLOAT>,7. address STRUCT<street:STRING,district:STRING,city:STRING,province:STRING,ZIP:STRING>8.)9.ROW FORMAT DELIMITED10.FIELDS TERMINATED BY '\001'11.COLLECTIN ITEMS TERMINATED BY '\002'12.MAP KEYS TERMINATED '\003'13.LINES TERMINATED BY '\n'14.STORED AS15.INPUTFORMAT 'org.linkedin.haivvreo.AvroContainerInputFormat'16.OUTPUTFORMAT 'org.linkedin.haivvreo.AvroContainerOutputFormat';修改表结构:1)、重命名表Java代码1.ALTER TABLE table_name RENAME TO new_table_name;只修改了表名,不会改变表结构和数据存放的位置。
2)、修改列名、类型、位置及注释Java代码1.CREATE TABLE IF NOT EXISTS test(a INT,b STRING,c FLOAT);//创建测试表2.//修改列名3.4. TABLE test CHANGE a a2 INT;5./*将a列的名字改为a2,并将其数据类型改为STRING,然后将之放在b列之后;修改6. * 后的表结构为:b INT,a2 STRING,c FLOAT7. */8.ALTER TABLE test CHANGE a a2 STRING AFTER b;9./*10. * 将b列的名字改为b2,并将其数据类型由FLOAT改为DOUBLE,然后将之11. * 放在第一列;修改后的表结构为:12. * b2 DOUBLE,a STRING,c FLOAT13. */14.ALTER TABLE test CHANGE b b2 DOUBLE FIRST;列的改变只会修改Hive的元数据,而不改变实际的数据。
用户应该确保元数据的定义和实际的数据结构保持一致。
3)、增加新列Java代码1.ALTER TABLE test ADD COLOMNS(d INT,e STRING);4)、改变表的数据存储格式Java代码1.ALTER TABLE test SET FILEFORMAT SEQUENCEFILE;5)、添加分区PartitionJava代码1.ALTER TABLE students ADD PARTITION(ds = '2013-05-07',country = 'china')2. LOCATION '/usr/test/data/test.txt';6)、删除分区PartitionJava代码1.ALTER TABLE students DROP PARTITION(ds = '2013-05-07',country = 'china');7)、创建函数Java代码1.CREATE TEMPORARY FIUNCTION aFunc as class_name;8)、删除函数Java代码1.DROP TEMPORARY FIUNCTION aFunc;9)、显示表Java代码1.SHOW TABLES students;9)、显示分区Java代码1.SHOW PARTITIONS students;本节继续讨论HiveQL,Hive查询语言,如何向Hive表中添加数据,操纵数据和从表中将数据提取到文件系统。
Hive常见内置函数及其使用
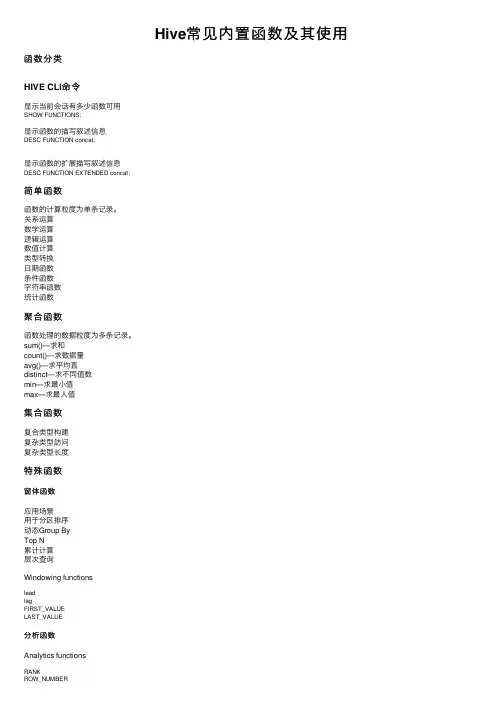
Hive常见内置函数及其使⽤函数分类HIVE CLI命令显⽰当前会话有多少函数可⽤SHOW FUNCTIONS;显⽰函数的描写叙述信息DESC FUNCTION concat;显⽰函数的扩展描写叙述信息DESC FUNCTION EXTENDED concat;简单函数函数的计算粒度为单条记录。
关系运算数学运算逻辑运算数值计算类型转换⽇期函数条件函数字符串函数统计函数聚合函数函数处理的数据粒度为多条记录。
sum()—求和count()—求数据量avg()—求平均直distinct—求不同值数min—求最⼩值max—求最⼈值集合函数复合类型构建复杂类型訪问复杂类型长度特殊函数窗体函数应⽤场景⽤于分区排序动态Group ByTop N累计计算层次查询Windowing functionsleadlagFIRST_VALUELAST_VALUE分析函数Analytics functionsRANKROW_NUMBERDENSE_RANKCUME_DISTPERCENT_RANKNTILE混合函数java_method(class,method [,arg1 [,arg2])reflect(class,method [,arg1 [,arg2..]])hash(a1 [,a2...])UDTFlateralView: LATERAL VIEW udtf(expression) tableAlias AS columnAlias (',' columnAlias)*fromClause: FROM baseTable (lateralView)*ateral view⽤于和split, explode等UDTF⼀起使⽤,它可以将⼀⾏数据拆成多⾏数据,在此基础上可以对拆分后的数据进⾏聚合。
lateral view⾸先为原始表的每⾏调⽤UDTF,UTDF会把⼀⾏拆分成⼀或者多⾏。
lateral view再把结果组合。
HIVE常用正则函数(like、rlike、regexp、regexp_replace、r。。。

HIVE常⽤正则函数(like、rlike、regexp、regexp_replace、r。
Oralce中regex_like和hive的regexp对应LIKE语法1: A LIKE B语法2: LIKE(A, B)操作类型: strings返回类型: boolean或null描述: 如果字符串A或者字符串B为NULL,则返回NULL;如果字符串A符合表达式B的正则语法,则为TRUE;否则为FALSE。
B中字符"_"表⽰任意单个字符,⽽字符"%"表⽰任意数量的字符。
hive> select 'football' like '%ba';OKfalsehive> select 'football' like '%ba%';OKtruehive> select 'football' like '__otba%';OKtruehive> select like('football', '__otba%');OKtrueRLIKE语法1: A RLIKE B语法2: RLIKE(A, B)操作类型: strings返回类型: boolean或null描述: 如果字符串A或者字符串B为NULL,则返回NULL;如果字符串A符合JAVA正则表达式B的正则语法,则为TRUE;否则为FALSE。
hive> select 'football' rlike 'ba';OKtruehive> select 'football' rlike '^footba';OKtruehive> select rlike('football', 'ba');OKtrueJava正则:"." 任意单个字符"*" 匹配前⾯的字符0次或多次"+" 匹配前⾯的字符1次或多次"?" 匹配前⾯的字符0次或1次"\d" 等于 [0-9],使⽤的时候写成'\d'"\D" 等于 [^0-9],使⽤的时候写成'\D'hive> select 'does' rlike 'do(es)?';OKtruehive> select '\\';OK\hive> select '2314' rlike '\\d+';OKtrueREGEXP语法1: A REGEXP B语法2: REGEXP(A, B)操作类型: strings返回类型: boolean或null描述: 功能与RLIKE相同hive> select 'football' regexp 'ba';OKtruehive> select 'football' regexp '^footba';OKtruehive> select regexp('football', 'ba');OKtrue语法: regexp_replace(string A, string B, string C)操作类型: strings返回值: string说明: 将字符串A中的符合java正则表达式B的部分替换为C。
hive常用运算和函数
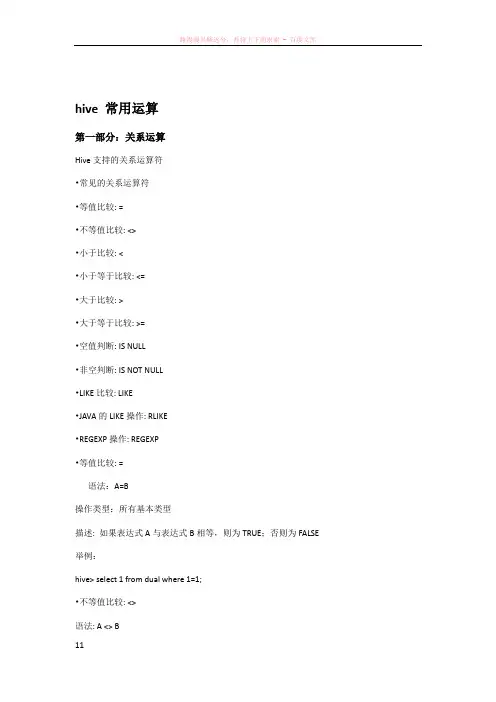
hive 常用运算第一部分:关系运算Hive支持的关系运算符•常见的关系运算符•等值比较: =•不等值比较: <>•小于比较: <•小于等于比较: <=•大于比较: >•大于等于比较: >=•空值判断: IS NULL•非空判断: IS NOT NULL•LIKE比较: LIKE•JAVA的LIKE操作: RLIKE•REGEXP操作: REGEXP•等值比较: =语法:A=B操作类型:所有基本类型描述: 如果表达式A与表达式B相等,则为TRUE;否则为FALSE 举例:hive> select 1 from dual where 1=1;•不等值比较: <>语法: A <> B操作类型: 所有基本类型描述: 如果表达式A为NULL,或者表达式B为NULL,返回NULL;如果表达式A与表达式B 不相等,则为TRUE;否则为FALSE举例:hive> select 1 from dual where 1 <> 2;•小于比较: <语法: A < B操作类型: 所有基本类型描述: 如果表达式A为NULL,或者表达式B为NULL,返回NULL;如果表达式A小于表达式B,则为TRUE;否则为FALSE举例:hive> select 1 from dual where 1 < 2;•小于等于比较: <=语法: A <= B操作类型: 所有基本类型描述: 如果表达式A为NULL,或者表达式B为NULL,返回NULL;如果表达式A小于或者等于表达式B,则为TRUE;否则为FALSE举例:hive> select 1 from dual where 1 <= 1;•大于等于比较: >=语法: A >= B操作类型: 所有基本类型描述: 如果表达式A为NULL,或者表达式B为NULL,返回NULL;如果表达式A大于或者等于表达式B,则为TRUE;否则为FALSE举例:hive> select 1 from dual where 1 >= 1;•空值判断: IS NULL语法: A IS NULL操作类型: 所有类型描述: 如果表达式A的值为NULL,则为TRUE;否则为FALSE举例:hive> select 1 from dual where null is null;•非空判断: IS NOT NULL语法: A IS NOT NULL操作类型: 所有类型描述: 如果表达式A的值为NULL,则为FALSE;否则为TRUE举例:hive> select 1 from dual where 1 is not null;•LIKE比较: LIKE语法: A LIKE B操作类型: strings描述: 如果字符串A或者字符串B为NULL,则返回NULL;如果字符串A符合表达式B 的正则语法,则为TRUE;否则为FALSE。
hive 常用的函数
hive 常用的函数Hive是一个建立在Hadoop上的数据仓库工具,常用于大数据处理和分析。
在Hive中,有许多内置的函数可以帮助用户进行数据处理和转换。
以下是一些Hive 常用的函数:1. 字符串函数:- CONCAT:用于连接两个或多个字符串。
- SUBSTR:用于获取字符串的子串。
- LENGTH:用于获取字符串的长度。
- UPPER和LOWER:用于将字符串转换为大写或小写。
- TRIM:用于去除字符串两端的空格。
2. 数学函数:- ROUND:用于对数字进行四舍五入。
- ABS:用于获取数字的绝对值。
- CEIL和FLOOR:分别用于向上取整和向下取整。
- POWER:用于计算一个数字的指数幂。
- SQRT:用于计算一个数字的平方根。
3. 日期函数:- TO_DATE:用于将字符串转换为日期类型。
- YEAR、MONTH、DAY:分别用于获取日期的年、月、日部分。
- DATEDIFF:用于计算两个日期之间的天数差。
- DATE_ADD和DATE_SUB:用于对日期进行加减操作。
4. 数组函数:- SIZE:用于获取数组的长度。
- ARRAY_CONTAINS:用于判断数组中是否包含某个元素。
- ARRAY_MAX和ARRAY_MIN:分别用于获取数组中的最大值和最小值。
- ARRAY_JOIN:用于将数组转换为字符串。
5. 条件函数:- CASE WHEN:用于在查询中实现条件判断。
- COALESCE:用于获取第一个非空的值。
- NVL:用于将空值替换为指定的默认值。
- IF和IFNULL:用于实现简单的条件判断。
以上是一些Hive中常用的函数,通过合理使用这些函数,可以更高效地进行数据处理和转换。
在实际应用中,根据具体的需求和数据类型选择合适的函数是非常重要的。
希望以上内容对您有所帮助。
hive函数大全

目录一、关系运算: (4)1. 等值比较: = (4)2. 不等值比较: <> (4)3. 小于比较: < (4)4. 小于等于比较: <= (4)5. 大于比较: > (5)6. 大于等于比较: >= (5)7. 空值判断: IS NULL (5)8. 非空判断: IS NOT NULL (6)9. LIKE比较: LIKE (6)10. JAVA的LIKE操作: RLIKE (6)11. REGEXP操作: REGEXP (7)二、数学运算: (7)1. 加法操作: + (7)2. 减法操作: - (7)3. 乘法操作: * (8)4. 除法操作: / (8)5. 取余操作: % (8)6. 位与操作: & (9)7. 位或操作: | (9)8. 位异或操作: ^ (9)9.位取反操作: ~ (10)三、逻辑运算: (10)1. 逻辑与操作: AND (10)2. 逻辑或操作: OR (10)3. 逻辑非操作: NOT (10)四、数值计算 (11)1. 取整函数: round (11)2. 指定精度取整函数: round (11)3. 向下取整函数: floor (11)4. 向上取整函数: ceil (12)5. 向上取整函数: ceiling (12)6. 取随机数函数: rand (12)7. 自然指数函数: exp (13)8. 以10为底对数函数: log10 (13)9. 以2为底对数函数: log2 (13)10. 对数函数: log (13)11. 幂运算函数: pow (14)12. 幂运算函数: power (14)13. 开平方函数: sqrt (14)14. 二进制函数: bin (14)15. 十六进制函数: hex (15)16. 反转十六进制函数: unhex (15)17. 进制转换函数: conv (15)18. 绝对值函数: abs (16)19. 正取余函数: pmod (16)20. 正弦函数: sin (16)21. 反正弦函数: asin (16)22. 余弦函数: cos (17)23. 反余弦函数: acos (17)24. positive函数: positive (17)25. negative函数: negative (17)五、日期函数 (18)1. UNIX时间戳转日期函数: from_unixtime (18)2. 获取当前UNIX时间戳函数: unix_timestamp (18)3. 日期转UNIX时间戳函数: unix_timestamp (18)4. 指定格式日期转UNIX时间戳函数: unix_timestamp (18)5. 日期时间转日期函数: to_date (19)6. 日期转年函数: year (19)7. 日期转月函数: month (19)8. 日期转天函数: day (19)9. 日期转小时函数: hour (20)10. 日期转分钟函数: minute (20)11. 日期转秒函数: second (20)12. 日期转周函数: weekofyear (20)13. 日期比较函数: datediff (21)14. 日期增加函数: date_add (21)15. 日期减少函数: date_sub (21)六、条件函数 (21)1. If函数: if (21)2. 非空查找函数: COALESCE (22)3. 条件判断函数:CASE (22)4. 条件判断函数:CASE (22)七、字符串函数 (23)1. 字符串长度函数:length (23)2. 字符串反转函数:reverse (23)3. 字符串连接函数:concat (23)4. 带分隔符字符串连接函数:concat_ws (23)5. 字符串截取函数:substr,substring (24)6. 字符串截取函数:substr,substring (24)7. 字符串转大写函数:upper,ucase (24)8. 字符串转小写函数:lower,lcase (25)9. 去空格函数:trim (25)10. 左边去空格函数:ltrim (25)11. 右边去空格函数:rtrim (25)12. 正则表达式替换函数:regexp_replace (26)13. 正则表达式解析函数:regexp_extract (26)14. URL解析函数:parse_url (26)15. json解析函数:get_json_object (27)16. 空格字符串函数:space (27)17. 重复字符串函数:repeat (27)18. 首字符ascii函数:ascii (28)19. 左补足函数:lpad (28)20. 右补足函数:rpad (28)21. 分割字符串函数: split (28)22. 集合查找函数: find_in_set (29)八、集合统计函数 (29)1. 个数统计函数: count (29)2. 总和统计函数: sum (29)3. 平均值统计函数: avg (30)4. 最小值统计函数: min (30)5. 最大值统计函数: max (30)6. 非空集合总体变量函数: var_pop (30)7. 非空集合样本变量函数: var_samp (31)8. 总体标准偏离函数: stddev_pop (31)9. 样本标准偏离函数: stddev_samp (31)10.中位数函数: percentile (31)11. 中位数函数: percentile (31)12. 近似中位数函数: percentile_approx (32)13. 近似中位数函数: percentile_approx (32)14. 直方图: histogram_numeric (32)九、复合类型构建操作 (32)1. Map类型构建: map (32)2. Struct类型构建: struct (33)3. array类型构建: array (33)十、复杂类型访问操作 (33)1. array类型访问: A[n] (33)2. map类型访问: M[key] (34)3. struct类型访问: S.x (34)十一、复杂类型长度统计函数 (34)1. Map类型长度函数: size(Map<K.V>) (34)2. array类型长度函数: size(Array<T>) (34)3. 类型转换函数 (35)一、关系运算:1. 等值比较: =语法:A=B操作类型:所有基本类型描述: 如果表达式A与表达式B相等,则为TRUE;否则为FALSE举例:hive> select 1 from lxw_dual where 1=1;12. 不等值比较: <>语法: A <> B操作类型: 所有基本类型描述: 如果表达式A为NULL,或者表达式B为NULL,返回NULL;如果表达式A与表达式B不相等,则为TRUE;否则为FALSE举例:hive> select 1 from lxw_dual where 1 <> 2;13. 小于比较: <语法: A < B操作类型: 所有基本类型描述: 如果表达式A为NULL,或者表达式B为NULL,返回NULL;如果表达式A小于表达式B,则为TRUE;否则为FALSE举例:hive> select 1 from lxw_dual where 1 < 2;14. 小于等于比较: <=语法: A <= B操作类型: 所有基本类型描述: 如果表达式A为NULL,或者表达式B为NULL,返回NULL;如果表达式A小于或者等于表达式B,则为TRUE;否则为FALSE举例:hive> select 1 from lxw_dual where 1 <= 1;15. 大于比较: >语法: A > B操作类型: 所有基本类型描述: 如果表达式A为NULL,或者表达式B为NULL,返回NULL;如果表达式A大于表达式B,则为TRUE;否则为FALSE举例:hive> select 1 from lxw_dual where 2 > 1;16. 大于等于比较: >=语法: A >= B操作类型: 所有基本类型描述: 如果表达式A为NULL,或者表达式B为NULL,返回NULL;如果表达式A大于或者等于表达式B,则为TRUE;否则为FALSE举例:hive> select 1 from lxw_dual where 1 >= 1;1注意:String的比较要注意(常用的时间比较可以先to_date之后再比较)hive> select * from lxw_dual;OK2011111209 00:00:00 2011111209hive> select a,b,a<b,a>b,a=b from lxw_dual;2011111209 00:00:00 2011111209 false true false7. 空值判断: IS NULL语法: A IS NULL操作类型: 所有类型描述: 如果表达式A的值为NULL,则为TRUE;否则为FALSE举例:hive> select 1 from lxw_dual where null is null;18. 非空判断: IS NOT NULL语法: A IS NOT NULL操作类型: 所有类型描述: 如果表达式A的值为NULL,则为FALSE;否则为TRUE举例:hive> select 1 from lxw_dual where 1 is not null;19. LIKE比较: LIKE语法: A LIKE B操作类型: strings描述: 如果字符串A或者字符串B为NULL,则返回NULL;如果字符串A符合表达式B 的正则语法,则为TRUE;否则为FALSE。
hive中的常用函数

Hive是一种基于Hadoop的数据仓库工具,用于处理大规模数据集。
以下是Hive中常用的一些函数:
聚合函数:
COUNT:计算行数或非NULL值的数量。
SUM:计算数值列的总和。
AVG:计算数值列的平均值。
MIN:找出数值列的最小值。
MAX:找出数值列的最大值。
字符串函数:
CONCAT:连接两个或多个字符串。
LENGTH:返回字符串的长度。
SUBSTR:截取字符串的子串。
TRIM:去除字符串首尾的空格。
LOWER/UPPER:将字符串转换为小写/大写。
时间日期函数:
YEAR/MONTH/DAY:提取日期字段中的年份/月份/日份。
HOUR/MINUTE/SECOND:提取时间字段中的小时/分钟/秒数。
TO_DATE:将字符串转换为日期格式。
条件函数:
IF/ELSE:根据条件返回不同的值。
CASE WHEN/THEN/ELSE/END:根据多个条件返回不同的值。
数学函数:
ABS:返回数值的绝对值。
ROUND:对数值进行四舍五入。
RAND:生成一个随机数。
EXP:返回指定数值的指数值。
LOG:计算数值的自然对数。
这只是Hive中一些常用的函数示例,实际上Hive提供了更多的函数用于处理数据。
你可以根据具体的需求在Hive官方文档中查找更多详细的函数说明和用法。
hive常用的的函数 -回复
hive常用的的函数-回复"Hive常用的函数"Hive是一个基于Hadoop的数据仓库工具,用于对大规模数据进行处理和分析。
在Hive中,函数是使用HiveQL查询语言进行数据操作和转换的重要工具。
本文将深入探讨Hive中常用的函数,并逐步介绍它们的用法和示例。
一、Hive内置函数Hive提供了多种内置函数,用于在查询中执行各种操作,如数学计算、条件判断、字符串处理等。
下面是Hive中一些常用的内置函数:1.数学函数- ABS(x): 返回x的绝对值。
- ROUND(x [, d]): 返回离x最近的整数,如果d给出,返回到小数点后d位的近似值。
示例:SELECT ABS(-10), ROUND(3.14159, 2);2.字符串函数- CONCAT(str1, str2, ...): 返回连接多个字符串得到的结果。
- LENGTH(str): 返回字符串的字符个数。
示例:SELECT CONCAT('Hello', 'World'), LENGTH('Hive');3.日期和时间函数- CURRENT_TIMESTAMP(): 返回当前的日期和时间。
- YEAR(date), MONTH(date), DAY(date): 返回给定日期的年、月、日。
示例:SELECT CURRENT_TIMESTAMP(), YEAR('2022-09-01'),MONTH('2022-09-01'), DAY('2022-09-01');4.条件函数- CASE WHEN condition THEN result [WHEN condition THEN result ...] [ELSE result] END: 对条件进行判断并返回不同的结果。
示例:SELECT CASE WHEN age < 18 THEN 'Child' ELSE 'Adult' END;二、自定义函数除了内置函数,Hive还支持用户自定义函数,这使得我们可以根据特定需求自定义函数来处理数据。
hive常用的的函数
hive常用的的函数Hive提供了一种简单的SQL查询语言称为HiveQL,它允许数据工程师、数据分析师和应用程序开发人员查询和管理大规模数据。
以下是Hive中常用的一些函数:1. 字符串函数:`length(string)`: 返回字符串的长度。
`concat(string1, string2, ...)`: 连接两个或多个字符串。
`substr(string, start, length)`: 返回字符串的子串。
`trim(string)`: 去除字符串两端的空格。
`ltrim(string)`: 去除字符串左端的空格。
`rtrim(string)`: 去除字符串右端的空格。
2. 数值函数:`abs(bigint)`: 返回整数的绝对值。
`ceil(double)`: 返回大于或等于给定数字的最小整数。
`floor(double)`: 返回小于或等于给定数字的最大整数。
`round(double, ndigits)`: 返回四舍五入的值,其中ndigits是精度。
`mod(int, int)`: 返回第一个参数除以第二个参数的余数。
3. 日期函数:`current_date()`: 返回当前日期。
`from_unixtime(unix_timestamp[, format])`: 将UNIX时间戳转换为指定格式的日期时间。
`unix_timestamp()`: 将当前日期和时间转换为UNIX时间戳(以秒为单位)。
`date_format(date, format)` or `date_format(timestamp, format)`: 将日期/时间值格式化为指定的字符串格式。
4. 聚合函数:`count(), count(column)`: 计算行数或非NULL值的数量。
`sum(column)`: 计算列的总和。
`avg(column)`: 计算列的平均值。
`min(column)`: 返回列中的最小值。
hive 常用的函数
Apache Hive 是一个基于Hadoop 的数据仓库工具,它提供了类似SQL 的查询语言HiveQL 来处理大规模的数据集。
以下是一些Hive 中常用的函数类别及示例:1. 数学与舍入函数•ABS(x): 返回x 的绝对值。
•FLOOR(x): 对浮点数x 进行向下取整。
•CEIL(x): 对浮点数x 进行向上取整。
•ROUND(x[, d]): 对数字x 进行四舍五入,d(可选)表示要保留的小数位数。
2. 字符串函数•LENGTH(str): 返回字符串str 的长度。
•LOWER(str)或lcase(str): 将字符串转换为小写。
•UPPER(str)或ucase(str): 将字符串转换为大写。
•CONCAT(string1, string2,...): 连接多个字符串。
•TRIM([BOTH|LEADING|TRAILING] 'chars' FROM str): 删除字符串两侧或指定一侧的字符。
3. 日期和时间函数•FROM_UNIXTIME(epoch, format): 将Unix 时间戳转换为日期格式。
•UNIX_TIMESTAMP(): 获取当前Unix 时间戳。
•DATE_FORMAT(date_expression, format_string): 格式化日期表达式。
•YEAR(date), MONTH(date), DAY(date): 提取日期中的年、月、日部分。
4. 聚合函数•COUNT(*): 统计行数。
•SUM(column): 计算某一列的总和。
•AVG(column): 计算平均值。
•MAX(column): 找出一列的最大值。
•MIN(column): 找出一列的最小值。
•GROUP_CONCAT(column): 合并一组值为单个字符串(在某些版本的Hive 中可用)。
5. 集合函数•COLLECT_SET(column): 返回一组唯一的值组成的集合,无序且会去除重复值。
hive中的常用函数
hive中的常用函数Hive中的常用函数包括数学函数、字符串函数、日期函数等多种类型,这些函数可以帮助用户对数据进行处理和分析,提高数据处理的效率和准确性。
首先是数学函数,Hive中提供了一系列常用的数学函数,如ABS、CEIL、FLOOR、ROUND、EXP、LOG、POWER、RAND等。
这些函数可以用于对数据进行绝对值计算、向上取整、向下取整、四舍五入、指数计算、对数计算、幂计算、生成随机数等操作。
这些数学函数在数据分析和计算中经常被使用,能够满足不同场景下的数学计算需求。
其次是字符串函数,Hive中也提供了丰富的字符串函数,如CONCAT、SUBSTRING、UPPER、LOWER、LENGTH、TRIM、SPLIT、REGEXP、REPLACE等。
这些函数可以用于对字符串进行连接、截取、转换大小写、计算长度、去除空格、分割、正则表达式匹配、替换等操作。
字符串函数在数据清洗、处理、分析中起着至关重要的作用,能够帮助用户处理各种文本数据。
此外,Hive还提供了日期函数,如YEAR、MONTH、DAY、HOUR、MINUTE、SECOND、DATEDIFF、DATE_FORMAT、UNIX_TIMESTAMP等。
这些函数可以用于对日期时间数据进行提取、计算、格式化、转换等操作。
日期函数在时间序列数据分析、时间窗口函数、日期比较等场景中发挥着关键作用,帮助用户对时间数据进行更精确的处理和分析。
除了数学、字符串、日期函数外,Hive还提供了其他类型的函数,如类型转换函数、聚合函数、条件函数、窗口函数等。
这些函数可以满足不同数据处理、分析、计算、展示的需求,帮助用户更高效、准确地进行数据处理和分析。
总的来说,Hive中的常用函数涵盖了多种类型,可以满足用户在数据处理、分析、计算、展示等方面的各种需求。
熟练掌握这些函数的用法,能够提高数据处理的效率、准确性,让数据分析工作更加顺利、高效。
通过不断学习、实践,可以更好地运用Hive中的常用函数,为数据处理、分析、挖掘、应用带来更多的价值和意义。