
模式识别总复习题
总 复 习 题
1 简答题
1、什么是模式与模式识别?
2、一个典型的模式识别系统主要由哪几个部分组成?
3、什么是后验概率?
4、确定线性分类器的主要步骤?
5、样本集推断总体概率分布的方法?
6、近邻法的基本思想是什么?
7、什么是K近邻法?
1 简答题
8、监督学习与非监督学习的区别?
9、什么是误差平方和准则?
10、分级聚类算法的2种基本途径是什么?
11、特征抽取与特征选择的区别?
12、什么是最优搜索算法?
13、统计学习理论的核心问题?
14、什么是支持向量机?
2 问答题
1、描述贝叶斯公式及其主要作用。
2、利用最大似然估计方法对单变量正态分布函数来估计其均值μ 和方差σ2。
3 、请详细写出感知器训练算法步骤。
4 、请详细写出Fisher 算法实现步骤。
5 、什么是两分剪辑近邻法与压缩近邻法。
2 问答题
6、请详细介绍初始聚类中心的选择方法。
7、请描述K均值聚类算法。
8、什么是离散K-L变换以及离散有限K-L展开。
9、必考:针对某个识别对象设计自己的模式识别系统,并叙述各步骤主要工作。
3 计算题
1、在图像识别中,假定有灌木和坦克2种类型,它们的先验概率分别是0.7和0.3,损失函数
如下表所示。其中,类型w1和w2分别表示灌木和坦克,判决a1=w1,a2=w2。现在做了2次实
验,获得2个样本的类概率密度如下:
3 计算题
2、已知两类的训练样本:w1(0,0)T,(0,2)T;w2(2,0)T,(2,2)T, 试用H-K 算法进行分类器训练,求
解向量w*。
3、 已知欧氏二维空间中两类9 个训练样本w1:(-1,0)T,(-2,0)T,(-2,1)T,(-2,-1)T
w2:(1,1)T,(2,0)T,(1,-1)T,(2,1)T,(2,2)
T
试分别用最近邻法和K 近邻法求测试样本(0,0)T 的分类,取K=5,7。
3 计算题
4、已知两类的数据:
w1:(1,0),(2,0),(1,1)
W2:(-1,0),(0,1),(-1,1)
试求该组数据的类内与类间散布矩阵。
5 、给出二维样本数据(-1,1),(2,2),(1,-1),(-2,-2) ,试用K-L 变换作一维数据压缩。
模式识别期末试题
模式识别期末试题⼀、填空与选择填空(本题答案写在此试卷上,30分)1、模式识别系统的基本构成单元包括:模式采集、特征提取与选择和模式分类。
2、统计模式识别中描述模式的⽅法⼀般使⽤特真⽮量;句法模式识别中模式描述⽅法⼀般有串、树、⽹。
3、聚类分析算法属于(1);判别域代数界⾯⽅程法属于(3)。
(1)⽆监督分类 (2)有监督分类(3)统计模式识别⽅法(4)句法模式识别⽅法4、若描述模式的特征量为0-1⼆值特征量,则⼀般采⽤(4)进⾏相似性度量。
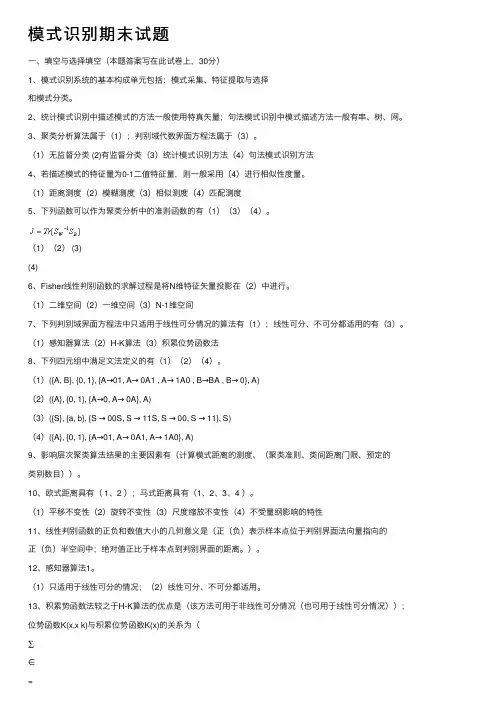
(1)距离测度(2)模糊测度(3)相似测度(4)匹配测度5、下列函数可以作为聚类分析中的准则函数的有(1)(3)(4)。
(1)(2) (3)(4)6、Fisher线性判别函数的求解过程是将N维特征⽮量投影在(2)中进⾏。
(1)⼆维空间(2)⼀维空间(3)N-1维空间7、下列判别域界⾯⽅程法中只适⽤于线性可分情况的算法有(1);线性可分、不可分都适⽤的有(3)。
(1)感知器算法(2)H-K算法(3)积累位势函数法8、下列四元组中满⾜⽂法定义的有(1)(2)(4)。
(1)({A, B}, {0, 1}, {A→01, A→ 0A1 , A→ 1A0 , B→BA , B→ 0}, A)(2)({A}, {0, 1}, {A→0, A→ 0A}, A)(3)({S}, {a, b}, {S → 00S, S → 11S, S → 00, S → 11}, S)(4)({A}, {0, 1}, {A→01, A→ 0A1, A→ 1A0}, A)9、影响层次聚类算法结果的主要因素有(计算模式距离的测度、(聚类准则、类间距离门限、预定的类别数⽬))。
10、欧式距离具有( 1、2 );马式距离具有(1、2、3、4 )。
(1)平移不变性(2)旋转不变性(3)尺度缩放不变性(4)不受量纲影响的特性11、线性判别函数的正负和数值⼤⼩的⼏何意义是(正(负)表⽰样本点位于判别界⾯法向量指向的正(负)半空间中;绝对值正⽐于样本点到判别界⾯的距离。
模式识别试题及总结

一、填空与选择填空(本题答案写在此试卷上,30分)1、模式识别系统的基本构成单元包括:模式采集、特征提取与选择和模式分类。
2、统计模式识别中描述模式的方法一般使用特真矢量;句法模式识别中模式描述方法一般有串、树、网。
3、聚类分析算法属于(1);判别域代数界面方程法属于(3)。
(1)无监督分类 (2)有监督分类(3)统计模式识别方法(4)句法模式识别方法4、若描述模式的特征量为0-1二值特征量,则一般采用(4)进行相似性度量。
(1)距离测度(2)模糊测度(3)相似测度(4)匹配测度5、下列函数可以作为聚类分析中的准则函数的有(1)(3)(4)。
(1)(2) (3)(4)6、Fisher线性判别函数的求解过程是将N维特征矢量投影在(2)中进行。
(1)二维空间(2)一维空间(3)N-1维空间7、下列判别域界面方程法中只适用于线性可分情况的算法有(1);线性可分、不可分都适用的有(3)。
(1)感知器算法(2)H-K算法(3)积累位势函数法8、下列四元组中满足文法定义的有(1)(2)(4)。
(1)({A, B}, {0, 1}, {A→01, A→ 0A1 , A→ 1A0 , B→BA , B→ 0}, A) (2)({A}, {0, 1}, {A→0, A→ 0A}, A)(3)({S}, {a, b}, {S → 00S, S → 11S, S → 00, S → 11}, S)(4)({A}, {0, 1}, {A→01, A→ 0A1, A→ 1A0}, A)9、影响层次聚类算法结果的主要因素有(计算模式距离的测度、(聚类准则、类间距离门限、预定的类别数目))。
10、欧式距离具有( 1、2 );马式距离具有(1、2、3、4 )。
(1)平移不变性(2)旋转不变性(3)尺度缩放不变性(4)不受量纲影响的特性11、线性判别函数的正负和数值大小的几何意义是(正(负)表示样本点位于判别界面法向量指向的正(负)半空间中;绝对值正比于样本点到判别界面的距离。
模式识别试题及总结

一、填空与选择填空(本题答案写在此试卷上,30分)1、模式识别系统的基本构成单元包括:模式采集、特征提取与选择和模式分类。
2、统计模式识别中描述模式的方法一般使用特真矢量;句法模式识别中模式描述方法一般有串、树、网。
3、聚类分析算法属于(1);判别域代数界面方程法属于(3)。
(1)无监督分类(2)有监督分类(3)统计模式识别方法(4)句法模式识别方法4、若描述模式的特征量为0-1二值特征量,则一般采用(4)进行相似性度量。
(1)距离测度(2)模糊测度(3)相似测度(4)匹配测度5、下列函数可以作为聚类分析中的准则函数的有(1)(3)(4)。
(1)(2)(3)(4)6、Fisher线性判别函数的求解过程是将N维特征矢量投影在(2)中进行。
(1)二维空间(2)一维空间(3)N-1维空间7、下列判别域界面方程法中只适用于线性可分情况的算法有(1);线性可分、不可分都适用的有(3)。
(1)感知器算法(2)H-K算法(3)积累位势函数法8、下列四元组中满足文法定义的有(1)(2)(4)。
(1)({A,B},{0,1},{A®01,A®0A1,A®1A0,B®BA,B®0},A)(2)({A},{0,1},{A®0,A®0A},A)(3)({S},{a,b},{S®00S,S®11S,S®00,S®11},S)(4)({A},{0,1},{A®01,A®0A1,A®1A0},A)9、影响层次聚类算法结果的主要因素有(计算模式距离的测度、(聚类准则、类间距离门限、预定的类别数目))。
10、欧式距离具有(1、2);马式距离具有(1、2、3、4)。
(1)平移不变性(2)旋转不变性(3)尺度缩放不变性(4)不受量纲影响的特性11、线性判别函数的正负和数值大小的几何意义是(正(负)表示样本点位于判别界面法向量指向的正(负)半空间中;绝对值正比于样本点到判别界面的距离。
模式识别试题及总结

二、(15分)简答及证明题(1)影响聚类结果的主要因素有那些?(2)证明马氏距离是平移不变的、非奇异线性变换不变的。
答:(1)分类准则,模式相似性测度,特征量的选择,量纲。
(2)证明:(2分)(2分)(1分)设,有非奇异线性变换:(1分)(4分)三、(8分)说明线性判别函数的正负和数值大小在分类中的意义并证明之。
答:(1)(4分)的绝对值正比于到超平面的距离平面的方程可以写成式中。
于是是平面的单位法矢量,上式可写成设是平面中的任一点,是特征空间中任一点,点到平面的距离为差矢量在上的投影的绝对值,即(1-1)上式中利用了在平面中,故满足方程式(1-1)的分子为判别函数绝对值,上式表明,的值正比于到超平面的距离,一个特征矢量代入判别函数后所得值的绝对值越大表明该特征点距判别界面越远。
(2)(4分)的正(负)反映在超平面的正(负)侧两矢量和的数积为(2分)显然,当和夹角小于时,即在指向的那个半空间中,>0;反之,当和夹角大于时,即在背向的那个半空间中,<0。
由于,故和同号。
所以,当在指向的半空间中时,;当在背向的半空间中,。
判别函数值的正负表示出特征点位于哪个半空间中,或者换句话说,表示特征点位于界面的哪一侧。
五、(12分,每问4分)在目标识别中,假定有农田和装甲车两种类型,类型ω1和类型ω2分别代表农田和装甲车,它们的先验概率分别为0.8和0.2,损失函数如表1所示。
现在做了三次试验,获得三个样本的类概率密度如下::0.3,0.1,0.6:0.7,0.8,0.3(1)试用贝叶斯最小误判概率准则判决三个样本各属于哪一个类型;(2)假定只考虑前两种判决,试用贝叶斯最小风险准则判决三个样本各属于哪一类;(3)把拒绝判决考虑在内,重新考核三次试验的结果。
表1类型损失判决1ω1α 1 45 11 1解:由题可知:,,,,(1)(4分)根据贝叶斯最小误判概率准则知:,则可以任判;,则判为;,则判为;(2)(4分)由题可知:则,判为;,判为;,判为;(3)(4分)对于两类问题,对于样本,假设已知,有则对于第一个样本,,则拒判;,则拒判;,拒判。
《模式识别》试题库

《模式识别》试题库一、基本概念题1.1 模式识别的三大核心问题是: 、。
1.2、模式分布为团状时,选用 聚类算法较好。
1.3 欧式距离具有 。
马式距离具有 。
(1)平移不变性 (2)旋转不变性 (3)尺度缩放不变性 (4)不受量纲影响的特性 1.4 描述模式相似的测度有: 。
(1)距离测度 (2)模糊测度 (3)相似测度 (4)匹配测度1.5 利用两类方法处理多类问题的技术途径有:(1) ;(2) ;(3) 。
其中最常用的是第 个技术途径。
1.6 判别函数的正负和数值大小在分类中的意义是: , 。
1.7 感知器算法 。
(1)只适用于线性可分的情况;(2)线性可分、不可分都适用。
1.8 积累位势函数法的判别界面一般为 。
(1)线性界面;(2)非线性界面。
1.9 基于距离的类别可分性判据有: 。
(1)1[]wB Tr S S - (2)B W S S (3)BW BS S S + 1.10 作为统计判别问题的模式分类,在( )情况下,可使用聂曼-皮尔逊判决准则。
1.11 确定性模式非线形分类的势函数法中,位势函数K(x,x k )与积累位势函数K(x)的关系为( )。
1.12 用作确定性模式非线形分类的势函数法,通常,两个n 维向量x 和x k 的函数K(x,x k )若同时满足下列三个条件,都可作为势函数。
①( ); ②( ); ③ K(x,x k )是光滑函数,且是x 和x k 之间距离的单调下降函数。
1.13 散度J ij 越大,说明ωi 类模式与ωj 类模式的分布( )。
当ωi 类模式与ωj 类模式的分布相同时,J ij =( )。
1.14 若用Parzen 窗法估计模式的类概率密度函数,窗口尺寸h1过小可能产生的问题是( ),h1过大可能产生的问题是( )。
1.15 信息熵可以作为一种可分性判据的原因是: 。
1.16作为统计判别问题的模式分类,在( )条件下,最小损失判决规则与最小错误判决规则是等价的。
(完整word版)模式识别试题及总结

一、填空与选择填空(本题答案写在此试卷上,30分)1、模式识别系统的基本构成单元包括:模式采集、特征提取与选择和模式分类。
2、统计模式识别中描述模式的方法一般使用特真矢量;句法模式识别中模式描述方法一般有串、树、网。
3、聚类分析算法属于(1);判别域代数界面方程法属于(3)。
(1)无监督分类 (2)有监督分类(3)统计模式识别方法(4)句法模式识别方法4、若描述模式的特征量为0-1二值特征量,则一般采用(4)进行相似性度量。
(1)距离测度(2)模糊测度(3)相似测度(4)匹配测度5、下列函数可以作为聚类分析中的准则函数的有(1)(3)(4)。
(1)(2) (3)(4)6、Fisher线性判别函数的求解过程是将N维特征矢量投影在(2)中进行。
(1)二维空间(2)一维空间(3)N-1维空间7、下列判别域界面方程法中只适用于线性可分情况的算法有(1);线性可分、不可分都适用的有(3)。
(1)感知器算法(2)H-K算法(3)积累位势函数法8、下列四元组中满足文法定义的有(1)(2)(4)。
(1)({A, B}, {0, 1}, {A→01, A→ 0A1 , A→ 1A0 , B→BA , B→ 0}, A)(2)({A}, {0, 1}, {A→0, A→ 0A}, A)(3)({S}, {a, b}, {S → 00S, S → 11S, S → 00, S → 11}, S)(4)({A}, {0, 1}, {A→01, A→ 0A1, A→ 1A0}, A)9、影响层次聚类算法结果的主要因素有(计算模式距离的测度、(聚类准则、类间距离门限、预定的类别数目))。
10、欧式距离具有( 1、2 );马式距离具有(1、2、3、4 )。
(1)平移不变性(2)旋转不变性(3)尺度缩放不变性(4)不受量纲影响的特性11、线性判别函数的正负和数值大小的几何意义是(正(负)表示样本点位于判别界面法向量指向的正(负)半空间中;绝对值正比于样本点到判别界面的距离。
模式识别习题及答案-精品资料
第一章绪论1 •什么是模式?具体事物所具有的信息。
模式所指的不是事物本身,而是我们从事物中获得的—信息__。
2. 模式识别的定义? 让计算机来判断事物。
3. 模式识别系统主要由哪些部分组成? 数据获取一预处理一特征提取与选择一分类器设计/分类决策。
第二章贝叶斯决策理论P ( W 2 ) / p ( w 1 ) _,贝V X1. 最小错误率贝叶斯决策过程?答:已知先验概率,类条件概率。
利用贝叶斯公式 得到后验概率。
根据后验概率大小进行决策分析。
2 .最小错误率贝叶斯分类器设计过程?答:根据训练数据求出先验概率P ( W i ), i类条件概率分布p ( x | W i ), i 1 , 2 利用贝叶斯公式得到后验概率P (W i | x)P(X | W j )P(W j )j 1如果输入待测样本 X ,计算X 的后验概率根据后验概率大小进行分类决策分析。
3. 最小错误率贝叶斯决策规则有哪几种常用的表示形式?决策规则的不同形式(董点)C1^ 如vr, | JV ) = max 戶(vr ] WJ A * U vtvEQ 如杲尹a H ; )2^(ir, ) = max |沪0輕』),则x e HpCx |=尸4 "J"匕< 4) 如!4i= — 1IL | /( JV )] = — 111 戸(兀 | w”. ) -+- 11111r a4. 贝叶斯决策为什么称为最小错误率贝叶斯决策?答:最小错误率Bayes 决策使得每个观测值下的条件错误率最小因而保证了 (平均)错误率最小。
Bayes 决策是最优决策:即,能使决策错误率最小。
5 .贝叶斯决策是 由先验概率和(类条件概率)概率,推导(后验概率)概率,然后利用这 个概率进行决策。
6.利用乘法法则和全概率公式证明贝叶斯公式p(AB) p(A|B)p(B) p(B|A)p(A)P (A」B )答:m所以推出贝叶斯公式p(B) p(B|Aj)p(Aj)j 17. 朴素贝叶斯方法的条件独立D (1P (x | W i ) P(W i )i i入)2P(x | W j ) P (w j )j 11 ,2P (x | W i )P(W i )如果 I (x)P(B |A i )P(AJ P ( B ) P ( B | A i ) P ( A i ) 7MP ( B | A j ) P ( A j )2假设是( P(x| 3 i) =P(x1, x2, …,xn | co i)19.=P(x1|3 i) P(x2| 3 i)…P(xn| 3 i))8•怎样利用朴素贝叶斯方法获得各个属性的类条件概率分布?答:假设各属性独立,P(x| 3 i) =P(x1, x2, …,xn |3 i) = P(x1| 3 i) P(x2| 3 i)P(xn| 3 i)后验概率:P( 3 i|x) = P( 3 i) P(x1|3 i) P(x2| 3 i)…P(xn| 3 i)类别清晰的直接分类算,如果是数据连续的,假设属性服从正态分布,算出每个类的均值方 差,最后得到类条件概率分布。
模式识别试题库
《模式识别》试题库一、基本概念题1.1 模式识别的三大核心问题是:、、。
1.2、模式分布为团状时,选用聚类算法较好。
1.3 欧式距离具有。
马式距离具有。
(1)平移不变性(2)旋转不变性(3)尺度缩放不变性(4)不受量纲影响的特性1.4 描述模式相似的测度有:。
(1)距离测度(2)模糊测度(3)相似测度(4)匹配测度1.5 利用两类方法处理多类问题的技术途径有:(1);(2);(3)。
其中最常用的是第个技术途径。
1.6 判别函数的正负和数值大小在分类中的意义是:,。
1.7 感知器算法。
(1)只适用于线性可分的情况;(2)线性可分、不可分都适用。
1.8 积累位势函数法的判别界面一般为。
(1)线性界面;(2)非线性界面。
1.9 基于距离的类别可分性判据有:。
(1)1[]w BTr S S-(2)BWSS(3)BW BSS S+1.10 作为统计判别问题的模式分类,在()情况下,可使用聂曼-皮尔逊判决准则。
1.11 确定性模式非线形分类的势函数法中,位势函数K(x,x k)与积累位势函数K(x)的关系为()。
1.12 用作确定性模式非线形分类的势函数法,通常,两个n维向量x和x k的函数K(x,x k)若同时满足下列三个条件,都可作为势函数。
①();②( ); ③ K(x,x k )是光滑函数,且是x 和x k 之间距离的单调下降函数。
1.13 散度J ij 越大,说明ωi 类模式与ωj 类模式的分布( )。
当ωi 类模式与ωj 类模式的分布相同时,J ij =( )。
1.14 若用Parzen 窗法估计模式的类概率密度函数,窗口尺寸h1过小可能产生的问题是( ),h1过大可能产生的问题是( )。
1.15 信息熵可以作为一种可分性判据的原因是: 。
1.16作为统计判别问题的模式分类,在( )条件下,最小损失判决规则与最小错误判决规则是等价的。
1.17 随机变量l(x )=p( x |ω1)/p( x |ω2),l( x )又称似然比,则E {l( x )|ω2}=( )。
模式识别习题集
模式识别习题Part 2CH41.线性分类器的分界面是超平面,线性分类器设计步骤是什么?2.Fisher线性判别函数是研究这类判别函数中最有影响的方法之一,请简述它的准则.3.感知器的准则函数是什么?它通过什么方法得到最优解?4.(1)指出从x到超平面g(x)=(w T x+w0=0)的距离r=|g(x)|是在||w|| g(x q)=0的约束条件下,使||x−x q||2达到极小解;w(2)指出在超平面上的投影是x p=x−g(x)||w||2(《模式识别》第二版,边肇祺,pp.117 4.1) 5.设有一维空间二次判别函数g(x)=5+7x+9x2(1)试映射成广义齐次线性判别函数;(2)总结把高次函数映射成齐次线性函数的方法。
(《模式识别》第二版,边肇祺,pp.117 4.2) 6.(1)通过映射把一维二次判别函数g(x)=a1+a2x+a3x2映射成三维广义线性判别函数;(2)若x在一维空间具有分布密度p(x),说明三维空间中的分布退化成只在一条曲线上有值,且曲线上值无穷大。
(《模式识别》第二版,边肇祺,pp.117 4.3)7.对于二维线性判别函数g(x)=x1+2x2−2(1)将判别函数写成g(x)=w T x+w0的形式,并画出g(x)=0的几何图形;(2)映射成广义齐次线性函数g(x)=a T y;(3)指出上述X空间实际是Y空间的一个子空间,且a T y=0对于X子空间的划分和原空间中w T+w0=0对原X空间的划分相同,并在图上表示出来。
8.指出在Fisher线性判别中,w的比例因子对Fisher判别结果无影响。
9.证明在正态等方差条件下,Fisher线性判别等价于贝叶斯判别。
10.考虑准则函数J(a)=∑(a T y−b)2y∈Y(a)其中Y(a)是使a T y≤b的样本集合。
设y1是Y(a)中的唯一样本,则J(a)的梯度为∇J(a)=2(a k T y1−b)y1,二阶偏导数矩阵D=2y1y1T。
模式识别复习资料(1)
模式识别复习资料(1)⼀.绪论:1.机器学习中数据样本、任务、泛化的含义基本术语(填空、名词解释)数据样本、任务、泛化能⼒答:2.假设数、假设空间、版本空间假设空间(填空、名词解释)假设空间、版本空间答:3.归纳偏好:为什么要有偏好、偏好原则、偏好的决定因素归纳偏好(填空、名词解释、判断)为什么要有偏好、偏好原则、偏好的决定因素答:4.机器学习的应⽤与前景(开放)答:第⼀章练习:1、单选题(必做)请选出下列任务中属于回归的任务()A.分辨冬⽠、西⽠还是南⽠B.估计南⽠的成熟度C.将同类的⽠分成⼀堆D.以上都不是2、请写出以下训练集中的假设空间的假设总数,以及版本空间中所有的假设分别是什么(写出具体假设内容)。
认为训练集中的各属性值已经完备,不存在遗漏。
(必做)训练集1、青绿,蜷缩,浊响,是好⽠2、乌⿊,稍蜷,沉闷,不是好⽠3、⼆、模型评估与选择1.经验误差与过拟合错误率、误差、过拟合经验误差与过拟合(填空、名词解释)错误率、误差、过拟合答:2.评估⽅法留出法、交叉验证法、⾃助法评估⽅法(填空、计算、判断)留出法、交叉验证法、⾃助法答:3.性能度量错误率、P-R曲线、平衡点、ROC图性能度量(填空、问答)错误率、P-R曲线、平衡点、ROC图答:4.⽐较检验Friedman检验与Nemenyi后续检验、检验图⽐较检验(填空、计算、绘图)Friedman检验与Nemenyi后续检验、检验图答:第⼆章练习:1、数据集包含100个样本,其中正反例各⼀半,假定学习算法所产⽣的模型是将新样本预测为训练样本数较多的类别(训练样本数相同时进⾏随机猜测),试给出⽤10折交叉验证法和留⼀法分别对错误率进⾏评估所得的结果。
2、对于下列混淆矩阵,请计算查准率P和查全率R,可⽤分数表⽰,并计算出总样本数。
1、推导Fβ从调和平均到最终结果的过程2、针对下列混淆矩阵,计算TPR和FPR3、试举例说明为何TPR和FPR会同时增加或减少1、说明分类任务与回归任务的区别2、请计算下列样本集合对应的假设空间内假设数3、请简述奥卡姆剃⼑原理4、判断题:过拟合将训练样本本⾝的特点当做所有样本的⼀般性质,导致泛化性能下降,但可以通过设计彻底克服5、请写出学过的所有评估⽅法,并指出哪⼀个⽅法会因改变了数据分布⽽引⼊估计偏差在·6、请写出混淆矩阵的组成,并给出查准率P、查全率R、真正例率TPR、假正例率FPR的表达式和含义7、请写出Friedman检验和Nemenyi后续检验的步骤,并将下列参数画成Friedman检验图,其中,假设CD为1.28、请说出泛化误差由哪⼏部分组成,哪些可以通过设计进⾏优化三、线性模型1.基本形式线性模型基本形式(辨析)线性模型答:2.线性回归⽬的、算法线性回归(填空、计算)⽬的、算法答:3.对数⼏率回归对数⼏率函数、优点、极⼤似然对数⼏率回归(问答)对数⼏率函数、优点、极⼤似然答:4.线性判别分析(填空)答:5.多分类学习:概念、流程多分类学习(填空、问答、判断)OvO、OvR、MvM、ECOC 答:。