
2015-05-06-统计学方法的选择讲解
统计学 n和r-概述说明以及解释

统计学 n和r-概述说明以及解释
1.引言
1.1 概述
统计学是一门应用广泛的学科,它涉及到数据的收集、整理、分析和解释。通过统计学的方法,我们可以更好地理解和描述数据的特征,并将其应用于各个领域,如社会科学、经济学、医学等。统计学中的两个重要概念分别是n和r。在本文中,我们将重点探讨这两个概念以及它们在统计学中的作用和应用。
首先,我们来了解n的含义和作用。n代表样本容量,也就是用于研究或调查的样本的数量。样本是从总体中随机选取的一部分,通过对样本进行统计分析,我们可以推断出有关总体的特征和规律。n的大小对于研究结果的可靠性和准确性非常重要。较大的样本容量可以减少随机误差的影响,提高结果的可靠性。但同时,较大的样本容量也需要更多的时间和资源,因此在实际应用中需要进行权衡和选择。
接下来,我们来了解r的定义和意义。r代表相关系数,是衡量两个变量之间关联程度的一种统计量。相关系数的取值范围为-1到1之间,其中-1表示完全的负相关,1表示完全的正相关,0表示无相关。相关系数的计算和解读可以帮助我们了解变量之间的关系及其强度。在实际应用中,相关系数可以用于研究变量之间的线性关系、预测模型的效果以及探索特定变量对结果的影响程度。
在本文的后续部分,我们将详细介绍统计学的基本原理、n的选择方法和影响因素,以及r在相关性分析中的应用和解读方法。通过深入研究和理解这些概念,我们可以更好地应用统计学的方法来解决实际问题,并为不同领域的研究和决策提供有力的支持。
通过对统计学中的n和r这两个重要概念的探讨,本文旨在增强读者对统计学的认识和理解,并展示它们在各个领域的重要性和应用前景。在结论部分,我们将对统计学的重要性进行总结,并对n和r的进一步研究和应用提出一些思考和展望。
文章结构部分的内容应该是对整篇文章的组织和内容安排进行介绍。以下是对文章结构部分的具体内容的建议:
1.2 文章结构
本文的结构如下:
第一部分是引言部分,旨在为读者提供对统计学中n和r的背景和概述。在1.1小节中,将简要介绍统计学的概念和其在现实生活中的应用。在1.2小节中,将说明文章的整体结构和各部分的内容概要。最后,在1.3小节中,将明确文章的目的,即通过对n和r的介绍和讨论,强调它们在统计学中的重要性和应用价值。
统计学课后习题答案_(第四版)_贾俊平

《统计学》第四版
第四章练习题答案
4.1 (1)众数:M0=10; 中位数:中位数位置=n+1/2=5.5,Me=10;平均数:6.91096nxxi
(2)QL位置=n/4=2.5, QL=4+7/2=5.5;QU位置=3n/4=7.5,QU=12
(3)2.494.1561)(2nisxx
(4)由于平均数小于中位数和众数,所以汽车销售量为左偏分布。
4.2 (1)从表中数据可以看出,年龄出现频数最多的是19和23,故有个众数,即M0=19和M0=23。
将原始数据排序后,计算中位数的位置为:中位数位置= n+1/2=13,第13个位置上的数值为23,所以中位数为Me=23
(2)QL位置=n/4=6.25, QL==19;QU位置=3n/4=18.75,QU=26.5
(3)平均数nxxi600/25=24,标准差65.612510621)(2nisxx
(4)偏态系数SK=1.08,峰态系数K=0.77
(5)分析:从众数、中位数和平均数来看,网民年龄在23-24岁的人数占多数。由于标准差较大,说明网民年龄之间有较大差异。从偏态系数来看,年龄分布为右偏,由于偏态系数大于1,所以,偏斜程度很大。由于峰态系数为正值,所以为尖峰分布。
4.3 (1)茎叶图如下:
茎
叶 频数
5
6
7
5
6 7 8
1 3 4 8 8 1
3
5
(2)nxxi63/9=7,714.0808.41)(2nisxx
(3)由于两种排队方式的平均数不同,所以用离散系数进行比较。
第一种排队方式:v1=1.97/7.2=0.274;v2=0.714/7=0.102.由于v1>v2,表明第一种排队方式的离散程度大于第二种排队方式。
(4)选方法二,因为第二种排队方式的平均等待时间较短,且离散程度小于第一种排队方式。
4.4 (1)nxxi8223/30=274.1
统计学教案格式模板(3篇)

第1篇
一、教案基本信息
1. 课程名称:统计学
2. 教学年级:[年级]
3. 教学科目:[科目]
4. 教学周次:[周次]
5. 教学课时:[课时]
6. 教师姓名:[教师姓名]
7. 教学日期:[教学日期]
二、教学目标
1. 知识目标:
- 学生能够掌握统计学的基本概念和基本原理。
- 学生能够理解统计数据的收集、整理和分析方法。
- 学生能够运用统计学方法解决实际问题。
2. 能力目标:
- 学生能够运用统计学知识进行数据分析和决策。
- 学生能够运用统计学方法进行数据呈现和表达。
- 学生能够培养良好的统计学思维和逻辑推理能力。
3. 情感目标:
- 培养学生对统计学知识的兴趣和热情。
- 增强学生的团队合作精神和创新意识。
- 培养学生的社会责任感和职业道德。
三、教学内容 1. 教学内容概述:
- 统计学基本概念:总体、样本、样本容量、概率等。
- 统计数据收集方法:问卷调查、实验调查、观察调查等。
- 统计数据整理方法:数据清洗、数据分类、数据排序等。
- 统计数据分析方法:描述性统计、推断性统计、回归分析等。
2. 教学内容详细安排:
- 第一节课:统计学基本概念、概率论基础。
- 第二节课:数据收集方法、数据整理方法。
- 第三节课:描述性统计方法、集中趋势和离散程度。
- 第四节课:推断性统计方法、假设检验。
- 第五节课:回归分析、相关性分析。
- 第六节课:统计软件应用、案例分析。
四、教学过程
1. 导入新课:通过实例或问题引入新课内容,激发学生的学习兴趣。
2. 讲授新课:按照教学内容详细安排,讲解统计学基本概念、方法和原理。
3. 案例分析:结合实际案例,引导学生运用统计学方法进行分析和决策。
4. 课堂讨论:组织学生进行课堂讨论,提高学生的思维能力和表达能力。
统计学-抽样调查的基本方法习题及答案

统计学-抽样调查的基本方法习题及答案
一、选择题
1. 抽样调查是指从人口中随机抽取个体作为调查对象,并通过对这些个体的调查研究来推断总体特征。下面哪种抽样方法是最常用的?
- A. 简单随机抽样
- B. 系统抽样
- C. 分层抽样
- D. 整群抽样
选择答案:A
2. 如果我们希望对某个地区的顾客群体进行调查,首先将地区划分为多个不同的区域,然后从每个区域中随机选取一些顾客进行调查,这种抽样方法称为:
- A. 简单随机抽样
- B. 系统抽样
- C. 分层抽样 - D. 整群抽样
选择答案:C
3. 在统计调查中,"样本容量"是指:
- A. 做出判断的人数
- B. 地区划分数
- C. 调查问卷的页数
- D. 参与调查的个体数量
选择答案:D
二、填空题
1. 抽样误差是指抽出的样本与总体之间的差异。为了减小抽样误差,可以增加样本的
2. "抽样分布"是指在相同的总体中,根据不同的抽样数据得出的统计量的
3. "简单随机抽样"是一种可能的抽样方法,其中每个个体都有相同的
三、问答题
1. 请简要说明简单随机抽样的基本步骤。
答案:
简单随机抽样的基本步骤包括:
- 确定总体和样本的定义;
- 根据总体的特征确定抽样目标;
- 设定样本容量;
- 使用随机数生成器或其他随机选择方法,从总体中随机选取样本;
- 进行调查或实验,收集样本数据;
- 对样本数据进行统计分析,得出结论,并推断总体特征。
2. 请详细描述分层抽样的原理和适用场景。
答案: 分层抽样是根据总体的特征将总体划分为多个层级,然后从每个层级中随机选取样本。它的原理是通过在每个层级中进行抽样,保证每个层级都得到足够的样本量,从而增加总体的代表性和减小抽样误差。
分层抽样适用于总体分布不均匀、具有明显的区域特征或特定特征的调查对象。通过将总体划分为不同的层级,可以更好地捕捉每个层级的特征,并对其进行适当权重的分析。这种抽样方法能够减小总体的多样性,并提高研究的有效性和可靠性。
统计学重点
统计学重点整理
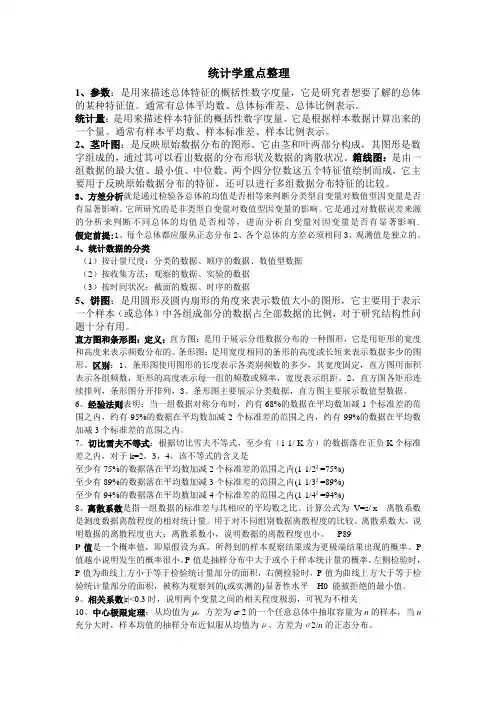
1、参数:是用来描述总体特征的概括性数字度量,它是研究者想要了解的总体的某种特征值。通常有总体平均数、总体标准差、总体比例表示。
统计量:是用来描述样本特征的概括性数字度量。它是根据样本数据计算出来的一个量。通常有样本平均数、样本标准差、样本比例表示。
2、茎叶图:是反映原始数据分布的图形。它由茎和叶两部分构成,其图形是数字组成的,通过其可以看出数据的分布形状及数据的离散状况。箱线图:是由一组数据的最大值、最小值、中位数、两个四分位数这五个特征值绘制而成,它主要用于反映原始数据分布的特征,还可以进行多组数据分布特征的比较。
3、方差分析就是通过检验各总体的均值是否相等来判断分类型自变量对数值型因变量是否有显著影响。它所研究的是非类型自变量对数值型因变量的影响。它是通过对数据误差来源的分析来判断不同总体的均值是否相等,进而分析自变量对因变量是否有显著影响.
假定前提:1、每个总体都应服从正态分布2、各个总体的方差必须相同3、观测值是独立的。
4、统计数据的分类
(1)按计量尺度:分类的数据、顺序的数据、数值型数据
(2)按收集方法:观察的数据、实验的数据
(3)按时间状况:截面的数据、时序的数据
5、饼图:是用圆形及圆内扇形的角度来表示数值大小的图形,它主要用于表示一个样本(或总体)中各组成部分的数据占全部数据的比例,对于研究结构性问题十分有用。
直方图和条形图:定义:直方图:是用于展示分组数据分布的一种图形,它是用矩形的宽度和高度来表示频数分布的。条形图:是用宽度相同的条形的高度或长短来表示数据多少的图形。区别:1、条形图使用图形的长度表示各类别频数的多少,其宽度固定,直方图用面积表示各组频数,矩形的高度表示每一组的频数或频率,宽度表示组距。2、直方图各矩形连续排列,条形图分开排列,3、条形图主要展示分类数据,直方图主要展示数值型数据。
分类资料组间比较的统计方法选择与应用

分类资料组间比较的统计方法选择与应用
在统计学中,分类资料组间比较是指对不同分类资料组之间的差异进行统计分析。分类资料是指将个体按其中一种特征分组,而分类资料组是指这些不同特征组成的组。此时,为了确定不同组之间的差异,我们需要选择适当的统计方法进行比较。
下面介绍几种常用的分类资料组间比较的统计方法选择与应用。
1.基本原则:
在选择分类资料组间比较的统计方法时,需要根据变量的测定水平来确定,通常可以根据资料的测定水平来进行分类资料分析的方法选择。对于分类资料,我们可以采用卡方检验分析,对于有序分类资料,我们可以采用秩和检验分析。
2.卡方检验:
卡方检验适用于分类资料的比较,其基本思想是比较实际观测频数与理论频数之间的差异。卡方检验有两种形式:独立性检验和拟合优度检验。独立性检验用于检验两个或多个分类变量之间是否存在关联;拟合优度检验用于检验观测频数与理论频数之间的差异是否显著。
3.秩和检验:
对于有序分类资料,我们可以采用秩和检验进行比较。秩和检验的基本思想是将不同组之间的观测值按顺序排列,并将其转化为秩次,然后将秩次相加得到秩和,通过比较秩和的大小来判断不同组之间的差异是否显著。
4.t检验: 当分类资料分为两个组进行比较时,可以采用t检验。t检验的基本思想是通过比较两个组的均值差异来判断两个组之间的差异是否显著。但是需要注意的是,t检验要求数据满足正态分布的假设,所以在进行t检验之前需要进行正态分布检验。
5.方差分析:
当分类资料包含多个组时,可以使用方差分析进行比较。方差分析的基本思想是比较组间方差与组内方差之间的差异,通过计算F值来判断不同组之间的差异是否显著。方差分析也需要满足正态分布的假设。
6.非参数检验:
如果数据不满足正态分布假设,或者样本量较小,可以使用非参数检验。非参数检验不依赖于总体分布形式的假设,比如Mann-Whitney U检验适用于两个独立样本的比较,Kruskal-Wallis H检验适用于多个独立样本的比较。
医学研究中统计方法的选择和应用
1 医学研究中统计分析方法的选择与应用
一般人认为统计学在医学研究中的应用就是资料的统计分析,这是因为这部分工作容易被人觉察到,并且也是统计学中非常重要的一部分,然而这是一种不太全面的看法。因为统计学在医学科研中的作用不仅仅是资料的统计分析,它的应用贯穿于整个研究过程之中,包括计划、设计、实施、资料处理与分析,到结果的展示和解释,直至到最后论文发表,都需要统计学知识的支持。因此,学好统计学基本理论,掌握每一种统计方法的适用条件及其使用技巧,对每一位医学研究人员来讲是必须具备的基本功之一。
第1节 临床科研中研究变量的类型
在进行资料统计分析之前,必须辨别清楚将要统计分析的研究变量的性质和在研究中所起的作用。因为不同类型的资料所选用的统计量和统计方法不同,在病因学科研中研究变量所起的作用以及研究其目的不同,对它们的处理也不一样。以下按测量单位和病因学研究的目的对研究变量的类型加以介绍。
一、按测量尺度分类
1. 计量资料
对每个观察单位用定量的方法测定某项指标的大小,所得的资料称为计量资料(measurement data),一般有度量衡等单位。例如在研究血压与身高、体重等身体型态指标的关系时,以人为观察单位,测得的身高(cm)、体重(kg)和血压(mmHg)属于计量资料。又如在环境污染与人体健康关系的研究时,以每个采样点为观察单位,测量不同采样点空气中二氧化碳、氮氧化物、悬浮颗粒等的浓度(mg/L)。再如临床实验室检验中,血脂的浓度、血糖的含量、血清中肌酸磷酸激酶浓度 2 (IU)等也属于计量资料。
计量资料又可分为离散型和连续型资料两种。离散型资料往往是一种计数,如每名儿童口腔中的龋齿个数、单位面积内细菌菌落的个数、显微镜下每个方格中的红细胞数。这种计数只能是0和正整数,不可能是负数,也不会有小数点。连续型资料,理论上在任何两个数值之间都会有无穷多个数据,如身高,在175厘米与176厘米之间理论上存在无穷多个数据。
常用的统计学方法
常用的统计学方法
常用的统计学方法包括:
1. 描述统计方法:包括测量中心趋势(如均值、中位数、众数)、测量离散程度(如方差、标准差、范围)和测量偏斜程度(如偏态系数、峰态系数)等。
2. 探索性数据分析(EDA):通过绘图和可视化方法来探索数据的特征和结构,以发现数据中的模式、异常值和趋势等。
3. 参数统计方法:基于总体参数对样本数据进行推断,并进行相关的假设检验。常用的参数统计方法包括t检验、方差分析、回归分析等。
4. 非参数统计方法:不依赖于总体参数的分布假设,通常用于数据不满足正态分布等前提条件的情况下。常用的非参数统计方法包括Wilcoxon秩和检验、Mann-Whitney U检验、Kruskal-Wallis检验等。
5. 相关分析:用于评估两个或多个变量之间的关系或相关性,并衡量其强度和方向。常用的相关分析方法包括皮尔逊相关系数、斯皮尔曼相关系数等。
6. 因子分析:通过降维技术将多个相关变量解释为少数几个未观测到的潜在因子,以揭示数据中的潜在结构。
7. 聚类分析:将样本或观测单元根据相似性聚集成不同的组别或类别,以发现数据中的群体和模式。
8. 时间序列分析:用于分析时间上的依赖关系和趋势,以预测未来的发展方向。常用的时间序列分析方法包括ARIMA模型、指数平滑法等。
9. 整体分析方法:通过数据挖掘和机器学习技术,识别和分析大规模数据集中的模式和趋势,以提取有价值的信息。
注:以上仅列举了部分常用的统计学方法,实际应用中根据问题的不同可能还会采用其他方法。同时,统计学方法的选择也要考虑数据类型、样本大小、样本分布等因素。