
机器学习答案
1.1. Give three computer applications for which machine learning approaches seem appropriate and three for which they seem inappropriate. Pick applications that are not already mentioned in this chapter, and include a one-sentence justification for each.Ans.Machine learning: Face recognition, handwritten recognition, credit card approval.Not machine learning: calculate payroll, execute a query to database, use WORD.2.1. Explain why the size of the hypothesis space in the EnjoySport learning task is 973. How would the number of possible instances and possible hypotheses increase with the addition of the attribute WaterCurrent, which can take on the values Light, Moderate, or Strong? More generally, how does the number of possible instances and hypotheses grow with the addition of a new attribute A that takes on k possible values?Ans.Since all occurrence of “φ” for an attribute of the hypothesis results in a hypothesis which does not accept any instance, all these hypotheses are equal to that one where attribute is “φ”. So the number of hypothesis is 4*3*3*3*3*3 +1 = 973.With the addition attribute Watercurrent, the number of instances = 3*2*2*2*2*2*3 = 288, the number of hypothesis = 4*3*3*3*3*3*4 +1 = 3889.Generally, the number of hypothesis = 4*3*3*3*3*3*(k+1)+1.2.3. Consider again the EnjoySport learning task and the hypothesis space H described in Section 2.2. Let us define a new hypothesis space H' that consists of all pairwise disjunctions of the hypotheses in H. For example, a typical hypothesis in H' is (?, Cold, High, ?, ?, ?) v (Sunny, ?, High, ?, ?, Same) Trace the CANDIDATE-ELIMINATATION algorithm for the hypothesis space H' given the sequence of training examples from Table 2.1 (i.e., show the sequence of S and G boundary sets.)Ans.S0= (φ,φ,φ,φ,φ,φ) v (φ,φ,φ,φ,φ,φ)G0 = (?, ?, ?, ?, ?, ?) v (?, ?, ?, ?, ?, ?)Example 1: <Sunny, Warm, Normal, Strong, Warm, Same, Yes>S1=(Sunny, Warm, Normal, Strong, Warm, Same)v (φ,φ,φ,φ,φ,φ)G1 = (?, ?, ?, ?, ?, ?) v (?, ?, ?, ?, ?, ?)Example 2: <Sunny, Warm, High, Strong, Warm, Same, Yes>S2= {(Sunny, Warm, Normal, Strong, Warm, Same)v (Sunny, Warm, High, Strong, Warm, Same),(Sunny, Warm, ?, Strong, Warm, Same) v (φ,φ,φ,φ,φ,φ)}G2 = (?, ?, ?, ?, ?, ?) v (?, ?, ?, ?, ?, ?)Example 3: <Rainy, Cold, High, Strong, Warm, Change, No>S3={(Sunny, Warm, Normal, Strong, Warm, Same)v (Sunny, Warm, High, Strong, Warm, Same),(Sunny, Warm, ?, Strong, Warm, Same) v (φ,φ,φ,φ,φ,φ)}G3 = {(Sunny, ?, ?, ?, ?, ?) v (?, Warm, ?, ?, ?, ?),(Sunny, ?, ?, ?, ?, ?) v (?, ?, ?, ?, ?, Same),(?, Warm, ?, ?, ?, ?) v (?, ?, ?, ?, ?, Same)}Example 4: <Sunny, Warm, High, Strong, Cool, Change, Yes>S4= {(Sunny, Warm, ?, Strong, ?, ?) v (Sunny, Warm, High, Strong, Warm, Same),(Sunny, Warm, Normal, Strong, Warm, Same) v (Sunny, Warm, High, Strong, ?, ?),(Sunny, Warm, ?, Strong, ?, ?)v (φ,φ,φ,φ,φ,φ),(Sunny, Warm, ?, Strong, Warm, Same)v (Sunny, Warm, High, Strong, Cool, Change)}G4 = {(Sunny, ?, ?, ?, ?, ?) v (?, Warm, ?, ?, ?, ?),(Sunny, ?, ?, ?, ?, ?) v (?, ?, ?, ?, ?, Same),(?, Warm, ?, ?, ?, ?) v (?, ?, ?, ?, ?, Same)}2.4. Consider the instance space consisting of integer points in the x, y plane and the set of hypotheses H consisting of rectangles. More precisely, hypotheses are of the form a ≤x ≤ b, c ≤ y≤d, where a, b, c, and d can be any integers.(a) Consider the version space with respect to the set of positive (+) and negative (-) training examples shown below. What is the S boundary of the version space in this case? Write out the hypotheses and draw them in on the diagram.(b) What is the G boundary of this version space? Write out the hypotheses and draw them in.(c) Suppose the learner may now suggest a new x, y instance and ask the trainer for its classification. Suggest a query guaranteed to reduce the size of the version space, regardless of how the trainer classifies it. Suggest one that will not.(d) Now assume you are a teacher, attempting to teach a particular target concept (e.g., 3 ≤ x ≤ 5,2 ≤ y ≤ 9). What is the smallest number of training examples you can provide so that the CANDIDATE-ELIMINATION algorithm will perfectly learn the target concept?Ans. (a) S= (4,6,3,5) (b) G=(3,8,2,7) (c) e.g., (7,6), (5,4) (d) 4 points: (3,2,+), (5,9,+),(2,1,-),(6,10,-)2.6. Complete the proof of the version space representation theorem (Theorem 2.1).Proof: Every member of VS H,D satisfies the right-hand side of expression.Let h be an arbitrary member of VS H,D, then h is consistent with all training examples in D. Assuming h does not satisfy the right-hand side of the expression, it means ¬(∃s∈S)∃(g∈G)(g ≥ h ≥ s) = ¬(∃s∈S)∃(g∈G) (g ≥ h) ∧ (h ≥ s). Hence, there does not exist g from G so that g is more general or equal to h or there does not exist s from S so that h is more general or equal to s.If the former holds, it leads to an inconsistence according to the definition of G. If the later holds, itleads to an inconsistence according to the definition of S. Therefore, h satisfies the right-hand side of the expression. (Notes: since we assume the expression is not fulfilled, this can be only be if S or G is empty, which can only be in the case of any inconsistent training examples, such as noise or the concept target is not member of H.)。
机器学习 模拟题与参考答案
机器学习模拟题与参考答案一、单选题(共114题,每题1分,共114分)1.机器学习这个术语是由( )定义的?A、Arthur SamuelB、Guido van RossumC、James GoslingD、以上都不是正确答案:A2.在一个线性回归问题中,我们使用 R 平方(R-Squared)来判断拟合度。
此时,如果增加一个特征,模型不变,则下面说法正确的是?A、如果 R-Squared 增加,则这个特征有意义B、如果R-Squared 减小,则这个特征没有意义C、仅看 R-Squared 单一变量,无法确定这个特征是否有意义。
D、以上说法都不对正确答案:C3.在SVM中, margin的含义是()A、损失误差B、间隔C、幅度D、差额正确答案:B4.下列哪种方法可以用来缓解过拟合的产生:( )。
A、正则化B、增加更多的特征C、以上都是D、增加模型的复杂度正确答案:A5.当数据分布不平衡时,我们可采取的措施不包括( )。
A、对数据分布较少的类别过采样B、对数据分布较多的类别欠采样C、对数据分布较少的类别赋予更大的权重D、对数据分布较多的类别赋予更大的权重正确答案:D6.同质集成中的个体学习器亦称()A、异质学习器B、同质学习器C、基学习器D、组件学习器正确答案:C7.以下哪些是无序属性()A、{小,中,大}B、闵可夫斯基距离C、{飞机,火车、轮船}D、{1,2,3}正确答案:C8.下列关于过拟合的说法错误的是A、过拟合是指模型在训练集上表现很好,但是在交叉验证集和测试集上表现一般B、解决过拟合可以采用Dropout方法C、解决过拟合可以采用参数正则化方法D、数据集扩增不能用来解决过拟合问题正确答案:D9.神经网络算法有时会出现过拟合的情况,那么采取以下哪些方法解决过拟合更为可行()。
A、减少训练数据集中数据的数量B、增大学习的步长C、为参数选取多组初始值,分别训练,再选取一组作为最优值D、设置一个正则项减小模型的复杂度正确答案:D10.下列是机器学习中降维任务的准确描述的为A、依据某个准则对项目进行排序B、将其映射到低维空间来简化输入C、预测每个项目的实际值D、对数据对象进行分组正确答案:B11.对于在原空间中线性不可分问题,支持向量机()。
机器学习课后习题答案
机器学习(周志华)参考答案第一章 绪论(略)第二章模型评估与选择1.数据集包含1000个样本,其中500个正例,500个反例,将其划分为包含70%样本的训练集和30%样本的测试集用于留出法评估,试估算共有多少种划分方式。
一个组合问题,从500500正反例中分别选出150150正反例用于留出法评估,所以可能取150)2。
法应该是(C5002.数据集包含100个样本,其中正反例各一半,假定学习算法所产生的模型是将新样本预测为训练样本数较多的类别(训练样本数相同时进行随机猜测),试给出用10折交叉验证法和留一法分别对错误率进行评估所得的结果。
10折交叉检验:由于每次训练样本中正反例数目一样,所以讲结果判断为正反例的概率也是一样的,所以错误率的期望是5050%。
留一法:如果留下的是正例,训练样本中反例的数目比正例多一个,所以留出的样本会被判断是反例;同理,留出的是反例,则会被判断成正例,所以错误率是100%。
3.若学习器A的F1值比学习器B高,试析A的BEP值是否也比B高。
Array4.试述真正例率(TPR)、假正例率(FPR)与查准率(P)、查全率(R)之间的联系。
查全率: 真实正例被预测为正例的比例真正例率: 真实正例被预测为正例的比例显然查全率与真正例率是相等的。
查准率:预测为正例的实例中真实正例的比例假正例率: 真实反例被预测为正例的比例两者并没有直接的数值关系。
9.试述卡方检验过程。
第三章线性模型2.试证明,对于参数w,对率回归(logistics回归)的目标函数(式1)是非凸的,但其对数似然函数(式2)是凸的。
如果一个多元函数是凸的,那么它的Hessian矩阵是半正定的。
3.编程实现对率回归,并给出西瓜数据集3.0α上的结果/icefire_tyh/article/details/520688444.选择两个UCI数据集,比较10折交叉验证法和留一法所估计出的对率回归的错误率。
/icefire_tyh/article/details/520689005.编程实现线性判别分析,并给出西瓜数据集3.0α上的结果。
第二版机器学习答案

一、判断题(共30分,每题2分,打诚X)1、如果问题本身就是非线性问题,使用支持向量机(SVM )是难以取得好的预测效果的。
(X)2、只要使用的半监督学习方法合适,利用100个标记样本和1000个无标记样本的预测效果,同样可以达到利用1100个标记样本使用监督学习方法的预测效果。
(X)3、深度学习中应该尽量避免过拟合。
(X)4、在随机森林Bagging过程中,每次选取的特征个数为m, m的值过大会降低树之间的关联性和单棵树的分类能力。
(X)5、决策树学习的结果,是得到一组规则集,且其中的规则是可以解释的。
(V)6、在FCM聚类算法中交替迭代优化目标函数的方法不一定得到最优解。
(V)7、在流形学习ISOMAP中,测地距离即是欧氏距离。
(X)8、贝叶斯决策实质上是按后验概率进行决策的。
(V)9、非参数估计需要较大数量的样本才能取得较好的估计结果。
(V)10、不需要显示定义特征是深度学习的优势之一。
(V)判断题为反扣分题目;答对得2分,不答得0分,答错得-2分;尹老师没有给出问答题的参考答案是怕限制大家的思路,我简要给出答题思路,仅供大家参考。
我发现好几个问题直接百度就可以找到答案,大家不妨自己搜一下。
也可以看一下机器学习十大算法那个PDF文件。
Co-training和ensemble learning两个文件大家有时间可以看一下了解了解。
二、问答题(共60分)1、从样本集推断总体概率分布的方法可以归结为哪几种类型?请分别简要解释之。
3种方法:监督参数估计、非监督参数估计、非参数估计这个可以参照第三章概率密度函数估计-1.ppt,写的不能再详细了。
监督参数估计:样本所属类别及类条件总体概率密度的形式已知,而表征概率密度函数的某些参数未知,需要根据样本集对总体分布中的某些参数进行估计。
非监督参数估计:已知总体概率密度函数形式,但未知样本所属类别,需要根据样本集对总体分布中的某些参数进行估计。
非参数估计:已知样本所属类别,未知总体概率密度的形式,需要依据样本集直接推断概率密度函数2、什么是k-近邻算法?K近邻算法,即给定一个训练数据集,对新的输入实例,在训练数据集中找到与该实例最邻近的K 个实例(也就是K个邻居),这K个实例的多数属于某个类,就把该输入实例分类到这个类中。
机器学习考试题目及答案
机器学习考试题目答案1.简描述机器学习概念?TomMitCheI1:"对于某类任务T和性能度量P,如果一个计算机程序在T上以P衡量的性能随着经验E而自我完善,那么我们称这个计算机程序在从经验E学习J 我们遇到的大部分事情一般包括分类问题与回归问题。
如房价的预测,股价的预测等属于分类问题。
一般的处理过程是:首先,1)获取数据;2)提取最能体现数据的特征;3)利用算法建模;4)将建立的模型用于预测。
如人脸识别系统,首先我们获取到一堆人脸照片,首先,对数据进行预处理,然后提取人脸特征,最后用算法如SVM或者NN等。
这样,我们就建立了一个人脸识别系统,当输入一张人脸,我们就知道这张面孔是否在系统中。
这就是机器学习的整个流程,其次还包括寻找最优参数等。
机器学习主要分为:监督学习:数据集是有标签的,大部分机器学习模型都属于这一类别,包括线性分类器、支持向量机等等;无监督学习:跟监督学习相反,数据集是完全没有标签的,主要的依据是相似的样本在数据空间中一般距离是相近的,这样就能通过距离的计算把样本分类,这样就完全不需要IabeI,比如著名的kmeans算法就是无监督学习应用最广泛的算法;半监督学习:半监督学习一般针对的问题是数据量超级大但是有标签数据很少或者说标签数据的获取很难很贵的情况,训练的时候有一部分是有标签的而有一部分是没有的;强化学习:一直激励学习的方式,通过激励函数来让模型不断根据遇到的情况做出调整;2.循环神经网络的基本原理?RNNS的目的是用来处理序列数据。
在传统的神经网络模型中,是从输入层到隐含层再到输出层,层与层之间是全连接的,每层之间的节点是无连接的。
但是这种普通的神经网络对于很多问题却无能无力。
例如,你要预测句子的下一个单词是什么,一般需要用到前面的单词,因为一个句子中前后单词并不是独立的。
RNNS之所以称为循环神经网路,即一个序列当前的输出与前面的输出也有关。
具体的表现形式为网络会对前面的信息进行记忆并应用于当前输出的计算中,即隐藏层之间的节点不再无连接而是有连接的,并且隐藏层的输入不仅包括输入层的输出还包括上一时刻隐藏层的输出。
2022机器学习专项测试试题及答案
2022机器学习专项测试试题及答案1.机器学习的流程包括:分析案例、数据获取、________和模型验证这四个过程。
()A.数据清洗A、数据清洗B.数据分析C.模型训练(正确答案)D.模型搭建2.机器翻译属于下列哪个领域的应用?() *A.自然语言系统(正确答案)A. 自然语言系统(正确答案)B.机器学习C.专家系统D.人类感官模拟3.为了解决如何模拟人类的感性思维, 例如视觉理解、直觉思维、悟性等, 研究者找到一个重要的信息处理的机制是()。
*A.专家系统B.人工神经网络(正确答案)C.模式识别D.智能代理4.要想让机器具有智能, 必须让机器具有知识。
因此, 在人工智能中有一个研究领域, 主要研究计算机如何自动获取知识和技能, 实现自我完善, 这门研究分支学科叫()。
*A. 专家系统A.专家系统B. 机器学习(正确答案)C. 神经网络D. 模式识别5.如下属于机器学习应用的包括()。
*A.自动计算, 通过编程计算 456*457*458*459 的值(正确答案)A. 自动计算,通过编程计算 456*457*458*459 的值(正确答案)A.自动计算,通过编程计算 456*457*458*459 的值(正确答案)B.文字识别, 如通过 OCR 快速获得的图像中出汉字, 保存为文本C.语音输入, 通过话筒将讲话内容转成文本D.麦克风阵列, 如利用灵云该技术实现远场语音交互的电视6.对于神经网络模型, 当样本足够多时, 少量输入样本中带有较大的误差甚至个别错误对模型的输入-输出映射关系影响很小, 这属于()。
*A. 泛化能力A.泛化能力B. 容错能力(正确答案)C. 搜索能力D. 非线性映射能力7.下列选项不属于机器学习研究内容的是() *A. 学习机理A.学习机理B. 自动控制(正确答案)C. 学习方法D. 计算机存储系统8.机器学习的经典定义是: () *A.利用技术进步改善系统自身性能A. 利用技术进步改善系统自身性能B.利用技术进步改善人的能力C.利用经验改善系统自身的性能(正确答案)D.利用经验改善人的能力9.研究某超市销售记录数据后发现, 买啤酒的人很大概率也会购买尿布, 这种属于数据挖掘的那类问题()。
机器学习原理及应用习题答案
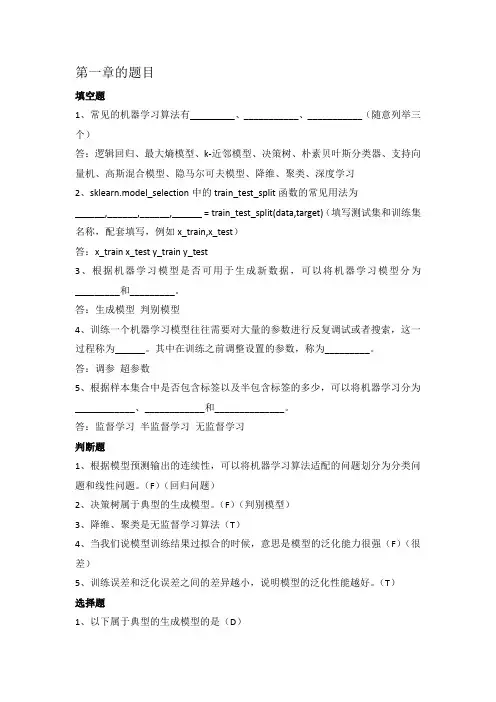
第一章的题目填空题1、常见的机器学习算法有_________、___________、___________(随意列举三个)答:逻辑回归、最大熵模型、k-近邻模型、决策树、朴素贝叶斯分类器、支持向量机、高斯混合模型、隐马尔可夫模型、降维、聚类、深度学习2、sklearn.model_selection中的train_test_split函数的常见用法为______,______,______,______ = train_test_split(data,target)(填写测试集和训练集名称,配套填写,例如x_train,x_test)答:x_train x_test y_train y_test3、根据机器学习模型是否可用于生成新数据,可以将机器学习模型分为_________和_________。
答:生成模型判别模型4、训练一个机器学习模型往往需要对大量的参数进行反复调试或者搜索,这一过程称为______。
其中在训练之前调整设置的参数,称为_________。
答:调参超参数5、根据样本集合中是否包含标签以及半包含标签的多少,可以将机器学习分为____________、____________和______________。
答:监督学习半监督学习无监督学习判断题1、根据模型预测输出的连续性,可以将机器学习算法适配的问题划分为分类问题和线性问题。
(F)(回归问题)2、决策树属于典型的生成模型。
(F)(判别模型)3、降维、聚类是无监督学习算法(T)4、当我们说模型训练结果过拟合的时候,意思是模型的泛化能力很强(F)(很差)5、训练误差和泛化误差之间的差异越小,说明模型的泛化性能越好。
(T)选择题1、以下属于典型的生成模型的是(D)A、逻辑回归B、支持向量机C、k-近邻算法D、朴素贝叶斯分类器2、以下属于解决模型欠拟合的方法的是(C)A、增加训练数据量B、对模型进行裁剪C、增加训练过程的迭代次数D、正则化3、构建一个完整的机器学习算法需要三个方面的要素,分别是数据、模型、(A)。
机器学习期末试题及答案
机器学习期末试题及答案一、选择题1. 机器学习是一种:A. 人工智能子领域B. 数据分析工具C. 算法库D. 编程语言答案:A. 人工智能子领域2. 以下哪种算法是无监督学习算法?A. 决策树B. 支持向量机C. K均值聚类D. 朴素贝叶斯答案:C. K均值聚类3. 在机器学习中,过拟合是指:A. 模型无法适应新数据B. 模型过于简单C. 模型过于复杂D. 模型的精度较低答案:C. 模型过于复杂4. 机器学习任务中的训练集通常包括:A. 特征和标签B. 标签和模型参数C. 特征和模型参数D. 特征、标签和模型参数答案:A. 特征和标签5. 在机器学习中,用于评估模型性能的常见指标是:A. 准确率B. 回归系数C. 损失函数D. 梯度下降答案:A. 准确率二、填空题1. 监督学习中,分类问题的输出是离散值,而回归问题的输出是________________。
答案:连续值/实数值2. 机器学习中的特征工程是指对原始数据进行________________。
答案:预处理3. ________________是一种常见的集成学习算法,通过构建多个弱分类器来提高整体模型的性能。
答案:随机森林4. K折交叉验证是一种常用的评估模型性能和调参的方法,其中K 代表______________。
答案:折数/交叉验证的次数5. 在机器学习中,优化算法的目标是最小化或最大化一个称为______________的函数。
答案:目标函数/损失函数三、简答题1. 请简要解释什么是过拟合,并提出至少三种防止过拟合的方法。
答:过拟合是指在训练数据上表现很好,但在新数据上表现较差的现象。
防止过拟合的方法包括:- 数据集扩充:增加更多的训练样本,从而减少模型对特定数据的过度拟合。
- 正则化:通过在损失函数中引入正则化项,约束模型的复杂度,防止模型过分拟合训练数据。
- 交叉验证:使用交叉验证方法对模型进行评估,通过评估模型在不同数据集上的性能,选择性能较好的模型。
机器学习(慕课版)习题答案全集
机器学习(慕课版)习题答案全集机器学习(慕课版)习题答案目录第一章机器学习概述 (2)第二章机器学习基本方法 (5)第三章决策树与分类算法 (9)第四章聚类分析 (13)第五章文本分析 (17)第六章神经网络 (22)第七章贝叶斯网络 (26)第八章支持向量机 (31)第九章进化计算 (32)第十章分布式机器学习 (34)第十一章深度学习 (35)第十二章高级深度学习 (37)第十三章推荐系统 (39)第一章机器学习概述1.机器学习的发展历史上有哪些主要事件?机器学习发展分为知识推理期、知识工程期、浅层知识期和深度学习几个阶段,可从几个阶段选择主要历史事件作答。
2.机器学习有哪些主要的流派?它们分别有什么贡献?符号主义:专家系统、知识工程贝叶斯派:情感分类、自动驾驶、垃圾邮件过滤联结主义:神经网络进化主义:遗传算法行为类推主义3.讨论机器学习与人工智能的关系机器学习是人工智能的一个分支,作为人工智能核心技术和实现手段,通过机器学习的方法解决人工智能面对的问题4.讨论机器学习与数据挖掘的关系数据挖掘是从大量的业务数据中挖掘隐藏、有用的、正确的知识促进决策的执行。
数据挖掘的很多算法都来自于机器学习,并在实际应用中进行优化。
机器学习最近几年也逐渐跳出实验室,解决从实际的数据中学习模式,解决实际问题。
数据挖掘和机器学习的交集越来越大,机器学习成为数据挖掘的重要支撑技术5.讨论机器学习与数据科学、大数据分析等概念的关系数据科学主要包括两个方面:用数据的方法研究科学和用科学的方法研究数据。
前者包括生物信息学、天体信息学、数字地球等领域;后者包括统计学、机器学习、数据挖掘、数据库等领域。
大数据分析即是后者的一个部分。
一般使用机器学习这个工具做大数据的分析工作,也就是说机器学习是我们做大数据分析的一个比较好用的工具,但是大数据分析的工具并不止机器学习,机器学习也并不只能做大数据分析。
人工智能初级认证(机器学习)试题及答案
人工智能初级认证(机器学习)试题及答案
1. 介绍
本文档为人工智能初级认证(机器研究)试题及答案,旨在帮助考生准备和复相关内容。
以下是试题及答案的详细内容。
2. 试题及答案
2.1 选择题
1. 什么是机器研究?
- (A) 一种人工智能的分支领域
- (B) 一种计算机编程语言
- (C) 一种图像处理技术
- (D) 一种机械设计原理
正确答案:(A)
2. 在机器研究中,监督研究是指什么?
- (A) 通过观察输入和输出样本对模型进行训练- (B) 通过自主发现模式对模型进行训练
- (C) 通过基于规则的推理对模型进行训练
- (D) 通过随机试错对模型进行训练
正确答案:(A)
3. 机器研究的主要任务之一是什么?
- (A) 数据处理和可视化
- (B) 模型选择和优化
- (C) 特征提取和选择
- (D) 性能评估和验证
正确答案:(B)
2.2 简答题
1. 请简要解释什么是过拟合?
过拟合指的是模型在训练集上表现良好,但在未知数据集上表现不佳的情况。
过拟合通常是因为模型过于复杂,过度适应了训练集中的噪声和异常值,导致泛化能力下降。
2. 请列举至少两种常见的机器研究算法。
- (1) 线性回归:用于建立线性关系模型,预测一个连续变量。
- (2) 决策树:通过不断划分特征空间,构建一个树形模型。
3. 总结
本文档提供了人工智能初级认证(机器学习)试题及答案,包括选择题和简答题。
考生可以通过复习这些内容来更好地准备考试。
祝您成功!。
2023年6月机器学习考试题及答案
2023年6月机器学习考试题及答案考试题目1. 什么是机器研究?2. 请简要说明监督研究和无监督研究的区别。
3. 什么是过拟合?如何避免过拟合?4. 请解释什么是决策树,并列举一些常用的决策树算法。
5. 什么是集成研究?列举两种常见的集成研究方法。
6. 请解释支持向量机(SVM)的工作原理。
7. 什么是深度研究?列举两个常用的深度研究模型。
8. 请简要介绍一下主成分分析(PCA)的原理和应用领域。
9. 什么是聚类分析?请列举一个常用的聚类算法。
10. 请说明机器研究中的特征选择方法。
答案1. 机器研究是一种人工智能的分支,旨在通过使用算法和统计模型,使计算机能够从数据中研究和改进,而无需明确编程。
它涉及让计算机从经验中自动研究,并利用研究到的知识来进行决策和预测。
3. 过拟合指模型在训练集上表现很好,但在新数据上表现较差的现象。
为了避免过拟合,可以采用以下方法:- 使用正则化技术,如L1正则化和L2正则化,限制模型的复杂度。
- 进行特征选择,排除一些对模型泛化能力影响较大的特征。
4. 决策树是一种基于树结构的分类和回归模型,它代表了对数据进行决策的过程。
常见的决策树算法包括ID3、C4.5和CART。
5. 集成研究是一种使用多个研究器进行组合预测的方法。
常见的集成研究方法包括随机森林和梯度提升树。
6. 支持向量机(SVM)是一种二分类模型,其工作原理是将数据映射到高维空间,在高维空间中找到一个最优超平面来分割不同类别的数据点。
7. 深度研究是一种基于神经网络的机器研究方法,它通过多层次的非线性变换来研究和表示数据。
常见的深度研究模型包括卷积神经网络(CNN)和循环神经网络(RNN)。
8. 主成分分析(PCA)是一种常用的降维技术,它通过线性变换将原始数据映射到低维空间,保留数据集中的主要特征。
主成分分析在数据预处理、图像处理和模式识别等领域有广泛的应用。
9. 聚类分析是一种将数据点划分为不同组别或类别的无监督研究方法。