
整理的用Python编写的爬虫文档
Python爬虫入门教程[Python]网络爬虫(一):网络爬虫的定义网络爬虫,即Web Spider,是一个很形象的名字。
把互联网比喻成一个蜘蛛网,那么Spider就是在网上爬来爬去的蜘蛛。
网络蜘蛛是通过网页的链接地址来寻找网页的。
从网站某一个页面(通常是首页)开始,读取网页的内容,找到在网页中的其它链接地址,然后通过这些链接地址寻找下一个网页,这样一直循环下去,直到把这个网站所有的网页都抓取完为止。
如果把整个互联网当成一个网站,那么网络蜘蛛就可以用这个原理把互联网上所有的网页都抓取下来。
这样看来,网络爬虫就是一个爬行程序,一个抓取网页的程序。
网络爬虫的基本操作是抓取网页。
那么如何才能随心所欲地获得自己想要的页面?我们先从URL开始。
二、浏览网页的过程抓取网页的过程其实和读者平时使用IE浏览器浏览网页的道理是一样的。
比如说你在浏览器的地址栏中输入 这个地址。
打开网页的过程其实就是浏览器作为一个浏览的“客户端”,向服务器端发送了一次请求,把服务器端的文件“抓”到本地,再进行解释、展现。
HTML是一种标记语言,用标签标记内容并加以解析和区分。
浏览器的功能是将获取到的HTML代码进行解析,然后将原始的代码转变成我们直接看到的网站页面。
三、URI和URL的概念和举例简单的来讲,URL就是在浏览器端输入的 这个字符串。
在理解URL之前,首先要理解URI的概念。
什么是URI?Web上每种可用的资源,如HTML文档、图像、视频片段、程序等都由一个通用资源标志符(Universal Resource Identifier,URI)进行定位。
URI通常由三部分组成:①访问资源的命名机制;②存放资源的主机名;③资源自身的名称,由路径表示。
如下面的URI:/myhtml/html1223/我们可以这样解释它:①这是一个可以通过HTTP协议访问的资源,②位于主机上,③通过路径“/html/html40”访问。
四、URL的理解和举例URL是URI的一个子集。
它是Uniform Resource Locator的缩写,译为“统一资源定位符”。
通俗地说,URL是Internet上描述信息资源的字符串,主要用在各种WWW客户程序和服务器程序上。
采用URL可以用一种统一的格式来描述各种信息资源,包括文件、服务器的地址和目录等。
URL的一般格式为(带方括号[]的为可选项):protocol :// hostname[:port] / path / [;parameters][?query]#fragmentURL的格式由三部分组成:①第一部分是协议(或称为服务方式)。
②第二部分是存有该资源的主机IP地址(有时也包括端口号)。
③第三部分是主机资源的具体地址,如目录和文件名等。
第一部分和第二部分用“://”符号隔开,第二部分和第三部分用“/”符号隔开。
第一部分和第二部分是不可缺少的,第三部分有时可以省略。
五、URL和URI简单比较URI属于URL更低层次的抽象,一种字符串文本标准。
换句话说,URI属于父类,而URL属于URI的子类。
URL是URI的一个子集。
URI的定义是:统一资源标识符;URL的定义是:统一资源定位符。
二者的区别在于,URI表示请求服务器的路径,定义这么一个资源。
而URL同时说明要如何访问这个资源(http://)。
下面来看看两个URL的小例子。
1.HTTP协议的URL示例:使用超级文本传输协议HTTP,提供超级文本信息服务的资源。
例:/channel/welcome.htm其计算机域名为。
超级文本文件(文件类型为.html)是在目录/channel下的welcome.htm。
这是中国人民日报的一台计算机。
例:/talk/talk1.htm其计算机域名为。
超级文本文件(文件类型为.html)是在目录/talk下的talk1.htm。
这是瑞得聊天室的地址,可由此进入瑞得聊天室的第1室。
2.文件的URL用URL表示文件时,服务器方式用file表示,后面要有主机IP地址、文件的存取路径(即目录)和文件名等信息。
有时可以省略目录和文件名,但“/”符号不能省略。
例:file:///pub/files/foobar.txt上面这个URL代表存放在主机上的pub/files/目录下的一个文件,文件名是foobar.txt。
例:file:///pub代表主机上的目录/pub。
例:file:///代表主机的根目录。
爬虫最主要的处理对象就是URL,它根据URL地址取得所需要的文件内容,然后对它进行进一步的处理。
因此,准确地理解URL对理解网络爬虫至关重要。
[Python]网络爬虫(二):利用urllib2通过指定的URL抓取网页内容版本号:Python2.7.5,Python3改动较大,各位另寻教程。
所谓网页抓取,就是把URL地址中指定的网络资源从网络流中读取出来,保存到本地。
类似于使用程序模拟IE浏览器的功能,把URL作为HTTP请求的内容发送到服务器端,然后读取服务器端的响应资源。
在Python中,我们使用urllib2这个组件来抓取网页。
urllib2是Python的一个获取URLs(Uniform Resource Locators)的组件。
它以urlopen函数的形式提供了一个非常简单的接口。
最简单的urllib2的应用代码只需要四行。
我们新建一个文件urllib2_test01.py来感受一下urllib2的作用:[python]view plaincopy1.import urllib22.response = urllib2.urlopen('/')3.html = response.read()4.print html按下F5可以看到运行的结果:我们可以打开百度主页,右击,选择查看源代码(火狐OR谷歌浏览器均可),会发现也是完全一样的内容。
也就是说,上面这四行代码将我们访问百度时浏览器收到的代码们全部打印了出来。
这就是一个最简单的urllib2的例子。
除了"http:",URL同样可以使用"ftp:","file:"等等来替代。
HTTP是基于请求和应答机制的:客户端提出请求,服务端提供应答。
urllib2用一个Request对象来映射你提出的HTTP请求。
在它最简单的使用形式中你将用你要请求的地址创建一个Request对象,通过调用urlopen并传入Request对象,将返回一个相关请求response对象,这个应答对象如同一个文件对象,所以你可以在Response中调用.read()。
我们新建一个文件urllib2_test02.py来感受一下:[python]view plaincopy1.import urllib22.req = urllib2.Request('')3.response = urllib2.urlopen(req)4.the_page = response.read()5.print the_page可以看到输出的内容和test01是一样的。
urllib2使用相同的接口处理所有的URL头。
例如你可以像下面那样创建一个ftp请求。
[python]view plaincopy1.req = urllib2.Request('ftp:///')在HTTP请求时,允许你做额外的两件事。
1.发送data表单数据这个内容相信做过Web端的都不会陌生,有时候你希望发送一些数据到URL(通常URL与CGI[通用网关接口]脚本,或其他WEB应用程序挂接)。
在HTTP中,这个经常使用熟知的POST请求发送。
这个通常在你提交一个HTML表单时由你的浏览器来做。
并不是所有的POSTs都来源于表单,你能够使用POST提交任意的数据到你自己的程序。
一般的HTML表单,data需要编码成标准形式。
然后做为data参数传到Request对象。
编码工作使用urllib的函数而非urllib2。
我们新建一个文件urllib2_test03.py来感受一下:[python]view plaincopy1.import urllib2.import urllib23.4.url = '/register.cgi'5.6.values = {'name' : 'WHY',7.'location' : 'SDU',8.'language' : 'Python' }9.10.data = urllib.urlencode(values) # 编码工作11.req = urllib2.Request(url, data) # 发送请求同时传data表单12.response = urllib2.urlopen(req) #接受反馈的信息13.the_page = response.read() #读取反馈的内容如果没有传送data参数,urllib2使用GET方式的请求。
GET和POST请求的不同之处是POST请求通常有"副作用",它们会由于某种途径改变系统状态(例如提交成堆垃圾到你的门口)。
Data同样可以通过在Get请求的URL本身上面编码来传送。
[python]view plaincopy1.import urllib22.import urllib3.4.data = {}5.6.data['name'] = 'WHY'7.data['location'] = 'SDU'8.data['language'] = 'Python'9.10.url_values = urllib.urlencode(data)11.print url_values12.=Somebody+Here&language=Python&location=Northampton14.url = '/example.cgi'15.full_url = url + '?' + url_values16.17.data = urllib2.open(full_url)这样就实现了Data数据的Get传送。
2.设置Headers到http请求有一些站点不喜欢被程序(非人为访问)访问,或者发送不同版本的内容到不同的浏览器。
默认的urllib2把自己作为“Python-urllib/x.y”(x和y是Python主版本和次版本号,例如Python-urllib/2.7),这个身份可能会让站点迷惑,或者干脆不工作。
python爬虫的实验报告
python爬虫的实验报告Python 爬虫的实验报告一、实验目的本次实验的主要目的是深入了解和掌握 Python 爬虫的基本原理和技术,通过实际操作,能够从互联网上获取所需的数据,并对获取的数据进行初步的处理和分析。
二、实验环境1、操作系统:Windows 102、开发工具:PyCharm3、 Python 版本:38三、实验原理Python 爬虫的基本原理是通过模拟浏览器的行为,向目标网站发送请求,获取网页的 HTML 代码,然后通过解析 HTML 代码,提取出我们需要的数据。
在这个过程中,我们需要使用一些库,如`requests` 用于发送请求,`BeautifulSoup` 或`lxml` 用于解析 HTML 代码。
四、实验步骤1、需求分析确定要爬取的目标网站和数据类型,例如,我们选择爬取某电商网站的商品信息,包括商品名称、价格、销量等。
2、发送请求使用`requests` 库发送`GET` 请求获取网页的 HTML 代码。
```pythonimport requestsurl =""response = requestsget(url)html_content = responsetext```3、解析 HTML使用`BeautifulSoup` 库对获取的 HTML 代码进行解析。
```pythonfrom bs4 import BeautifulSoupsoup = BeautifulSoup(html_content, 'htmlparser')```4、提取数据通过分析网页的结构,使用合适的方法提取所需的数据。
```pythonproduct_names = ptext for p in soupfind_all('div', class_='productname')prices = ptext for p in soupfind_all('div', class_='productprice')sales = ptext for p in soupfind_all('div', class_='productsales')```5、数据存储将提取到的数据存储到本地文件或数据库中,以便后续分析和使用。
Python爬虫实战项目源码+说明文档

Python爬虫实战项目源码+说明文档Python爬虫实战项目源码+说明文档首先,为了确保文章整洁美观,本文将采用以下结构:1. 简介2. 实战项目一:网站信息爬取3. 实战项目二:数据采集与存储4. 实战项目三:数据清洗与分析5. 总结1. 简介Python爬虫是一种强大的工具,它可以帮助我们从互联网上快速获取数据并进行分析。
本文将介绍三个Python爬虫实战项目,并附上详细的源码和说明文档,帮助读者更好地理解和应用爬虫技术。
2. 实战项目一:网站信息爬取在这个项目中,我们将使用Python编写一个爬虫程序,从指定的网站上获取各类信息,并将其保存到本地文件中。
我们将使用Requests 库发送HTTP请求,并使用BeautifulSoup库解析HTML文档。
通过这个项目,读者将学会如何定位并提取所需信息,并保存到CSV或Excel等格式的文件中。
3. 实战项目二:数据采集与存储在这个项目中,我们将编写一个爬虫程序,用于采集并存储大量的数据。
我们将使用Selenium库模拟浏览器操作,并结合使用XPath或正则表达式来定位和提取数据。
通过这个项目,读者将学会如何处理动态页面,并将采集到的数据存储到数据库中,如MySQL或MongoDB。
4. 实战项目三:数据清洗与分析在这个项目中,我们将使用Python进行数据清洗和分析。
我们将使用Pandas库加载和处理数据,并使用Matplotlib或Seaborn库进行可视化分析。
通过这个项目,读者将学会如何处理和清洗爬取到的数据,并进行基本的数据分析和可视化操作。
5. 总结本文介绍了三个Python爬虫实战项目,并附上了详细的源码和说明文档。
通过这些实战项目,读者能够掌握Python爬虫的基本技巧和应用方法,进一步提高数据采集、处理和分析的能力。
希望本文能够对读者在Python爬虫方面的学习和实践提供帮助。
以上就是Python爬虫实战项目源码+说明文档的全部内容。
python 爬虫常规代码

python 爬虫常规代码Python爬虫常规代码是指用Python编写的用于网页数据抓取和提取的代码。
爬虫是一种自动化程序,可以模拟人类在网页浏览器中的行为,从而获取所需的信息。
在这篇文章中,我们将一步一步地回答关于Python 爬虫常规代码的问题,帮助读者了解如何编写自己的爬虫程序。
第一步:安装Python和必要的库首先,我们需要安装Python和一些必要的库来编写爬虫代码。
Python 是一种流行的编程语言,可以用于开发各种应用程序,包括爬虫。
对于Python的版本,我们建议使用Python 3.x。
然后,我们需要安装一些常用的爬虫库,例如requests和beautifulsoup4。
可以使用pip命令来安装它们:pip install requestspip install beautifulsoup4第二步:发送HTTP请求在编写爬虫代码之前,我们首先需要发送HTTP请求以获取网页的内容。
这可以使用requests库来实现。
以下是一个简单的例子:pythonimport requestsurl = "response = requests.get(url)if response.status_code == 200:content = response.textprint(content)在这个例子中,我们首先指定了要访问的URL,然后使用requests库的get方法发送一个GET请求。
如果响应的状态码是200,表示请求成功,我们就可以从response对象中获取网页内容,并打印出来。
第三步:解析网页内容获取网页的原始内容后,我们通常需要解析网页,提取所需的信息。
这可以使用beautifulsoup4库来实现。
下面是一个示例:pythonfrom bs4 import BeautifulSoup# 假设content是之前获取的网页内容soup = BeautifulSoup(content, "html.parser")# 使用soup对象进行解析在这个例子中,我们首先导入了BeautifulSoup类并创建了一个soup对象,该对象将用于解析网页内容。
用Python实现网络爬虫、蜘蛛
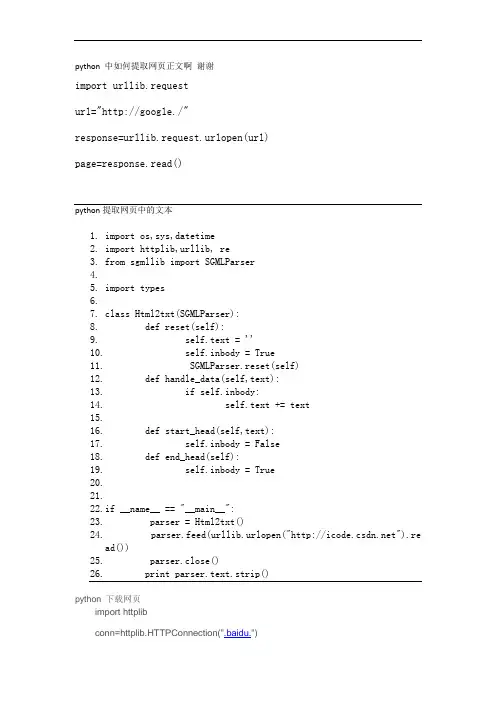
python 中如何提取网页正文啊谢谢import urllib.requesturl="http://google./"response=urllib.request.urlopen(url)page=response.read()python提取网页中的文本1.import os,sys,datetime2.import httplib,urllib, re3.from sgmllib import SGMLParser4.5.import types6.7.class Html2txt(SGMLParser):8.def reset(self):9.self.text = ''10. self.inbody = True11. SGMLParser.reset(self)12. def handle_data(self,text):13. if self.inbody:14. self.text += text15.16. def start_head(self,text):17. self.inbody = False18. def end_head(self):19. self.inbody = True20.21.22.if __name__ == "__main__":23. parser = Html2txt()24. parser.feed(urllib.urlopen("").read())25. parser.close()26. print parser.text.strip()python 下载网页import httplibconn=httplib.HTTPConnection(".baidu.")conn.request("GET","/index.html")r1=conn.getresponse()print r1.status,r1.reasondata=r1.read()print dataconn.close用python下载网页,超级简单!from urllib import urlopenwebdata = urlopen("").read()print webdata深入python里面有python 下载网页内容,用python的pycurl模块实现1.用python 下载网页内容还是很不错的,之前是使用urllib模块实验的,但听说有pycurl这个模块,而且比urllib好,所以尝试下,废话不说,以下是代码2.3.4.#!/usr/bin/env python5.# -*- coding: utf-8 -*-6.import StringIO7.import pycurl8.9.def writefile(fstr,xfilename):f=open(xfilename,'w')f.write(fstr)f.close10.1.html = StringIO.StringIO()2.c = pycurl.Curl()3.myurl='http://.ppgchenshan.'4.5.c.setopt(pycurl.URL, myurl)6.7.#写的回调8.c.setopt(pycurl.WRITEFUNCTION, html.write) 9.10. c.setopt(pycurl.FOLLOWLOCATION, 1)11.12.#最大重定向次数,可以预防重定向陷阱13. c.setopt(pycurl.MAXREDIRS, 5)14.15.#连接超时设置16. c.setopt(pycurl.CONNECTTIMEOUT, 60)17. c.setopt(pycurl.TIMEOUT, 300)18.19.#模拟浏览器20. c.setopt(ERAGENT, "Mozilla/4.0 (patible;MSIE 6.0; Windows NT 5.1; SV1; .NET CLR 1.1.4322)")21.22.23.24.#访问,阻塞到访问结束25. c.perform()26.27.#打印出 200(HTTP状态码,可以不需要)28.print c.getinfo(pycurl.HTTP_CODE)29.30.#输出网页的内容31.print html.getvalue()32.#保存成down.txt文件33.writefile(html.getvalue(),"down.txt")python的pycurl模块的安装可以到/download/这里去找.不同系统使用不同版本,自己看看总结下,Python 下载网页的几种方法1fd = urllib2.urlopen(url_link)data = fd.read()这是最简洁的一种,当然也是Get的方法2通过GET的方法def GetHtmlSource(url):try:htmSource = ''req = urllib2.Request(url)fd = urllib2.urlopen(req,"")while 1:data = fd.read(1024)if not len(data):breakhtmSource += datafd.close()del fddel reqhtmSource = htmSource.decode('cp936')htmSource = formatStr(htmSource)return htmSourceexcept socket.error, err:str_err = "%s" % errreturn ""3通过GET的方法def GetHtmlSource_Get(htmurl):htmSource = ""try:urlx = httplib.urlsplit(htmurl)conn = httplib.HTTPConnection(loc)conn.connect()conn.putrequest("GET", htmurl, None)conn.putheader("Content-Length", 0)conn.putheader("Connection", "close")conn.endheaders()res = conn.getresponse()htmSource = res.read()except Exception(), err:trackback.print_exec()conn.close()return htmSource通过POST的方法def GetHtmlSource_Post(getString):htmSource = ""try:url = httplib.urlsplit(".:8080")conn = httplib.HTTPConnection(loc)conn.connect()conn.putrequest("POST", "/sipo/zljs/hyjs-jieguo.jsp")conn.putheader("Content-Length", len(getString))conn.putheader("Content-Type", "application/x--form-urlencoded")conn.putheader("Connection", " Keep-Alive")conn.endheaders()conn.send(getString)f = conn.getresponse()if not f:raise socket.error, "timed out"htmSource = f.read()f.close()conn.close()return htmSourceexcept Exception(), err:trackback.print_exec()conn.close()return htmSource本文来自CSDN博客,转载请标明出处:/sding/archive/2010/04/29/5538065.aspxDjango+python+BeautifulSoup组合的垂直搜索爬虫使用python+BeautifulSoup完成爬虫抓取特定数据的工作,并使用Django搭建一个管理平台,用来协调抓取工作。
python爬虫实验报告

python爬虫实验报告Python爬虫实验报告引言:近年来,随着互联网的迅速发展,网络上的数据量呈现爆炸式增长。
为了有效地获取和利用这些海量数据,人们开始使用爬虫技术,其中Python爬虫技术因其简洁高效的特点而备受青睐。
本文将介绍一次Python爬虫实验的过程和结果,以及对爬虫技术的一些思考。
一、实验目的本次实验的目的是使用Python编写一个爬虫程序,从指定的网站上获取数据,并进行相应的数据处理和分析。
通过实验,我们旨在掌握Python爬虫的基本原理和操作方法,了解爬虫技术在数据获取和处理方面的应用。
二、实验过程1. 确定目标网站和数据在实验开始前,我们首先选择了一个目标网站,该网站提供了一些关于电影的基本信息和用户评分数据。
我们希望通过爬虫程序获取这些数据,并进行进一步的分析。
2. 分析网页结构为了编写有效的爬虫程序,我们需要先了解目标网站的网页结构。
通过查看网页源代码和使用开发者工具,我们可以获取到网页的HTML结构。
在分析过程中,我们发现电影的基本信息和评分数据都包含在特定的HTML标签中,这为后续的数据提取提供了方便。
3. 编写爬虫程序基于分析的结果,我们使用Python编写了一个简单的爬虫程序。
程序首先发送HTTP请求获取目标网页的HTML源代码,然后使用正则表达式或者BeautifulSoup库等工具进行数据提取和解析。
最后,将提取到的数据保存到本地文件或者数据库中。
4. 数据处理和分析获取到数据后,我们进行了一些简单的数据处理和分析。
例如,我们统计了电影的平均评分和评分分布情况,通过绘制柱状图和饼图等可视化工具,展示了这些数据的直观结果。
三、实验结果通过爬虫程序的运行,我们成功地获取了目标网站上的电影数据,并进行了相应的处理和分析。
以下是一些实验结果的摘要:1. 数据获取:我们获取了1000部电影的基本信息和用户评分数据,并将其保存到了本地文件中。
2. 数据处理:我们计算了这1000部电影的平均评分,并绘制了评分分布的柱状图和饼图。
如何使用Python进行网络爬虫开发
如何使用Python进行网络爬虫开发在当今的数字化时代,数据成为了一种宝贵的资源。
网络爬虫作为获取大量数据的有效工具,受到了广泛的关注和应用。
Python 语言因其简洁易懂、功能强大,成为了开发网络爬虫的首选语言之一。
接下来,让我们一起深入了解如何使用 Python 进行网络爬虫开发。
首先,我们需要明确网络爬虫的基本概念和工作原理。
简单来说,网络爬虫就是一个能够自动访问网页并提取所需信息的程序。
它模拟人类在浏览器中的行为,通过发送 HTTP 请求获取网页内容,然后对网页内容进行解析和处理,提取出有价值的数据。
在 Python 中,我们有许多优秀的库可以帮助我们实现网络爬虫的功能。
其中,`requests`库是用于发送 HTTP 请求的常用库,而`BeautifulSoup`库则用于解析网页内容。
让我们从一个简单的例子开始。
假设我们想要获取某个网页的标题,以下是一个基本的代码框架:```pythonimport requestsfrom bs4 import BeautifulSoupdef get_page_title(url):response = requestsget(url)if responsestatus_code == 200:soup = BeautifulSoup(responsetext, 'htmlparser')title = souptitlestringreturn titleelse:return "无法获取页面标题"url ="https://"print(get_page_title(url))```在上述代码中,我们首先使用`requestsget()`方法发送 GET 请求获取网页内容。
然后,通过检查响应的状态码来确定请求是否成功。
如果成功,我们使用`BeautifulSoup`将网页内容解析为 HTML 结构,并通过`souptitlestring`获取网页的标题。
7个经典python爬虫案例代码分享
Python作为一种简单易学的编程语言,广受程序员和数据科学家的喜爱。
其中,用Python进行网络爬虫的应用也越来越广泛。
本文将共享7个经典的Python爬虫案例代码,希望能够给大家带来启发和帮助。
1. 爬取豆瓣电影排行榜数据在本例中,我们将使用Python的requests库和BeautifulSoup库来爬取豆瓣电影排行榜的数据。
我们需要发送HTTP请求获取网页内容,然后使用BeautifulSoup库解析HTML文档,提取出我们需要的电影名称、评分等信息。
我们可以将这些数据保存到本地或者进行进一步的分析。
```pythonimport requestsfrom bs4 import BeautifulSoupurl = 'response = requests.get(url)soup = BeautifulSoup(response.text, 'html.parser')for movie in soup.find_all('div', class_='item'):title = movie.find('span', class_='title').textrating = movie.find('span', class_='rating_num').textprint(title, rating)```2. 爬取博博用户信息在这个案例中,我们将利用Python的requests库和正则表达式来爬取博博用户的基本信息。
我们需要登录博博并获取用户主页的URL,然后发送HTTP请求获取用户主页的HTML文档。
我们可以使用正则表达式来提取用户的昵称、性别、位置区域等信息。
我们可以将这些信息保存到数据库或者进行其他处理。
```pythonimport requestsimport reurl = 'response = requests.get(url)pattern = repile(r'<title>(.*?)</title>.*?昵称:(.*?)<.*?性别:(.*?)<.*?地区:(.*?)<', re.S)result = re.search(pattern, response.text)if result:username = result.group(2)gender = result.group(3)location = result.group(4)print(username, gender, location)```3. 爬取新浪新闻在这个案例中,我们将使用Python的requests库和XPath来爬取新浪新闻的标题和信息。
python爬虫通用模板代码
python爬虫通用模板代码
以下是一个简单的 Python 爬虫通用模板代码,用于从网页中抓取数据:
python
import requests
from bs4 import BeautifulSoup
# 目标网页的 URL
url = "http://网址"
# 发送 HTTP 请求并获取响应
response = requests.get(url)
# 解析 HTML 内容
soup = BeautifulSoup(response.text, "html.parser") # 查找目标数据
data = soup.find_all("div", class_="data") # 根据实际情况修改查找条件
# 处理数据
for item in data:
# 根据实际情况修改处理逻辑,比如提取文本、链接等
print(item.text)
这个模板代码使用了 requests 和 BeautifulSoup 这两个Python 库,用于发送 HTTP 请求和解析 HTML 内容。
在实际使用中,需要根据目标网页的结构和数据特点,修改查找条件和处理逻
辑。
同时,还需要考虑一些特殊情况,比如反爬虫机制、网页结构变化等。
python 简单的爬虫 源码
Python简单的爬虫源码1. 什么是爬虫?在互联网上,有大量的数据和信息,而爬虫就是一种自动化程序,用于从网页中提取数据并进行处理。
它可以模拟人类的浏览行为,自动访问网页并抓取所需的数据。
2. 爬虫的原理及工作流程爬虫的工作原理是通过发送HTTP请求获取网页内容,然后解析网页并提取所需的数据。
其主要工作流程如下:•发送HTTP请求:使用Python中的requests库发送HTTP请求到目标网页。
•获取网页内容:获取服务器响应,并将返回的HTML文档保存下来。
•解析HTML文档:使用HTML解析库(如BeautifulSoup)对HTML文档进行解析,并提取所需的数据。
•存储数据:将提取到的数据保存到本地文件或数据库中。
3. 编写一个简单的爬虫源码下面是一个简单的Python爬虫源码示例,用于爬取某个网站上的新闻标题和链接:import requestsfrom bs4 import BeautifulSoupdef get_news():url = ' # 替换为目标网站地址response = requests.get(url)soup = BeautifulSoup(response.text, 'html.parser')news_list = []news_elements = soup.find_all('a', class_='news-link')for element in news_elements:news_title = element.textnews_link = element['href']news_list.append({'title': news_title, 'link': news_link}) return news_listif __name__ == '__main__':news = get_news()for item in news:print(item['title'])print(item['link'])以上代码通过requests库发送HTTP请求获取网页内容,然后使用BeautifulSoup库解析HTML文档,并提取出新闻标题和链接。
使用Python实现一个网络爬虫
使用Python实现一个网络爬虫
Python是一种功能强大的编程语言,可用于实现多种应用的
开发。
其中之一就是实现网络爬虫。
网络爬虫是搜索引擎的重要组成部分,可以自动收集有价值的信息,并把它们存储在后台数据库中。
要使用Python实现网络爬虫,首先需要准备所需的工具和库,例如urllib、Beautiful Soup和Selenium等。
urllib模块用来实
现跨平台HTTP访问,Beautiful Soup模块用于解析HTML文档,而Selenium模块可以实现浏览器自动化,从而实现更精
细的爬取控制。
此外,还可以使用Python中的线程模块实现多线程爬取,可
以实现更快的爬取速度。
Python中的多线程模块不仅可以创
建新的线程,还可以实现线程的暂停、恢复和停止等操作。
最后,使用Python编写的爬虫程序一般会将抓取到的数据存
储到MySQL、MongoDB或者Hadoop等后端数据库中。
这样,就可以方便地根据用户要求从数据库中检索出想要的数据。
总而言之,Python可以很好地支持网络爬虫的实现,可以利
用大量功能强大的模块和库快速开发出功能完善的爬虫程序,从而实现网络数据的抓取和存储。