
编译原理及实现课后习题答案绝杀版
2.1 设字母表A={a},符号串x=aaa,写出下列符号串及其长度:x0,xx,x5以及A+和A*.x0=(aaa)0=ε | x0|=0xx=aaaaaa |xx|=6x5=aaaaaaaaaaaaaaa | x5|=15A+ =A1∪A2∪…. ∪A n∪…={a,aa,aaa,aaaa,aaaaa…}A* = A0 ∪A1 ∪ A2∪…. ∪ A n∪…={ε,a,aa,aaa,aaaa,aaaaa…}2.2 令∑={a,b,c},又令x=abc,y=b,z=aab,写出如下符号串及它们的长度:xy,xyz,(xy)3xy=abcb |xy|=4xyz=abcbaab |xyz|=7(xy)3=(abcb)3 =abcbabcbabcb | (xy)3 |=122.3设有文法G[S]:S∷=SS*|SS+|a,写出符号串aa+a*规范推导,并构造语法树。
S => SS* => Sa* => SS+a* => Sa+a* => aa+a*2.4 已知文法G[Z]:Z∷=U0∣V1 、 U∷=Z1∣1 、 V∷=Z0∣0 ,请写出全部由此文法描述的只含有四个符号的句子。
Z=>U0=>Z10=>U010=>1010Z=>U0=>Z10=>V110=>0110Z=>V1=>Z01=>U001=>1001Z=>V1=>Z01=>V101=>01012.5 已知文法G[S]: S∷=AB A∷=aA︱ε B∷=bBc︱bc , 写出该文法描述的语言。
A∷=aA︱ε描述的语言: {a n|n>=0}B∷=bBc︱bc描述的语言:{b n c n|n>=1}L(G[S])={a n b m c m|n>=0,m>=1}2.6 已知文法E∷=T∣E+T∣E-T 、 T∷=F∣T*F∣T/F 、 F∷=(E)∣i,写出该文法的开始符号、终结符号集合V T、非终结符号集合V N。
开始符号:EV t ={+, - , * , / ,( , ), i} V n ={E , F , T}2.7 对2.6题的文法,写出句型T+T*F+i 的短语、简单短语以及句柄。
短语:T+T*F+i T+T*F i i T T*F 简单短语:i T*F T 句柄:T2.8 设有文法G[S]:S ∷=S*S|S+S|(S)|a ,该文法是二义性文法吗?根据所给文法推导出句子a+a*a ,画出了两棵不同的语法树,所以该文法是二义性文法。
2.9 写一文法,使其语言是奇正整数集合。
A::=1|3|5|7|9|NA N::=0|1|2|3|4|5|6|7|8|92.10给出语言{a n b m |n,m ≥1}的文法。
G[S]: S::=AB A::=aA|a B::=bB|b3.1 有正则文法G[Z]:Z::=Ua|Vb ,U::=Zb|b ,V::=Za|a ,画出该文法的状态图,并检查句子abba 是否合法。
解:该文法的状态图如下:句子abba 合法。
3.2 状态图如图3.35所示,S为开始状态,Z为终止状态。
写出相应的正则文法以及V,V n和V t。
解:左线性文法G[Z]: 右线性文法G’[S]:Z::=Ab|bS::=aA|bA::=Aa|aA::=aA|bV={Z,A,a,b}V={S,A,a,b}V n={Z,A} V n={S,A}V t={a,b} V t={a,b} 3.3 构造下列正则表达式相应的NFA:1(1|0)*|01(1010*|1(010)*1)*0解:正则表达式:1(1|0)*|0正则表达式:1(1010*|1(010)*1)*03.4将右图的NFA M确定化解:3.5 将图3.37的DFA化简。
化简后的DFA:4.1 对下面文法,设计递归下降分析程序。
S→aAS|(A) , A→Ab|c解:首先将左递归去掉,将规则A→Ab|c 改成 A→c{b} 非终结符号S的分析程序如下:非终结符号A的分析程序如下:4.2 设有文法G[Z]:Z∷=(A) , A∷=a|Bb , B∷=Aab若采用递归下降分析方法,对此文法来说,在分析过程中,能否避免回溯?为什么?解:若采用递归下降分析方法,对此文法来说,在分析过程中不能避免回朔。
因为规则A∷=a|Bb和规则B∷=Aab 构成了间接左递归,不满足实现没有回溯的递归下降分析方法的条件(1)(书P67),且规则 A: := a|Bb,FIRST(a)={a},FIRST(Bb)={a},即此规则候选式的首符号集有相交,不满足实现没有回溯的递归下降分析方法的条件(2)(书P67),在分析过程中,将造成回溯。
改写文法可避免回溯:将规则B∷=Aab代入规则A∷=a|Bb得:A∷=a|Aabb,再转换成:A∷=a{abb},可避免回溯。
4.3 若有文法如下,设计递归下降分析程序。
<语句>→<语句><赋值语句>|ε<赋值语句>→ID=<表达式><表达式>→<项>|<表达式>+<项>|<表达式>-<项><项>→<因子>|<项>*<因子>|<项>/<因子><因子>→ID|NUM|(<表达式>)解:首先,去掉左递归<语句>→<语句><赋值语句>|ε改为: <语句>→{<赋值语句>}<表达式>→<项> | <表达式> + <项> | <表达式> - <项>改为:<表达式>→<项>{(+ | -)<项>}<项>→<因子> | <项> * <因子> | <项> / <因子>改为:<项>→<因子>{(* | /)<因子>}则文法变为:<语句>→{<赋值语句>}<赋值语句>→ID=<表达式><表达式>→<项>{(+ | -)<项>} <项>→<因子>{(* | /)<因子>} <因子>→ID|NUM|(<表达式>)非终结符号 <语句> 的分析程序如下:非终结符号 <赋值语句> 的分析程序如下:非终结符号 <表达式> 的分析程序如下:非终结符号 <项> 的分析程序如下:非终结符号 <因子> 的分析程序如下:4.4 有文法G[A]:A::=aABe|ε,B::=Bb|b (1)求每个非终结符号的FOLLOW 集。
(2)该文法是LL(1)文法吗? (3)构造LL(1)分析表。
解:(1) FOLLOW(A)=First(B)∪{#}={b,#}FOLLOW(B)={e,b}(2) 该文法中的规则B::=Bb|b 为左递归,因此该文法不是LL(1)文法’,B ’=bB ’|ε,该文法的LL(1)4.5 若有文法A→(A)A|ε(1)为非终结符A构造FIRST集合和FOLLOW集合。
(2)说明该文法是LL(1)的文法。
解:(1)FIRST(A)={(,ε}FOLLOW(A)={),#}(2)该文法不含左递归;FIRST((A)A)={(},FIRST(ε)={ε},FIRST((A)A)∩FIRST(ε)=Φ,且FOLLOW(A)={),#},FIRST((A)A)∩ FOLLOW(A) =Φ,因此,该文法满足LL(1)文法的条件,是LL(1)文法。
4.6 利用分析表4-1,识别以下算术表达式,请写出分析过程。
(1)i+i*i+i(2)i*(i+i+i)解:(2)i*(i+i+i)<声明语句>→<类型><变量表>;<类型>→int|float|char<变量表>→ID,<变量表>|ID(1)在该文法中提取左因子。
(2)为所得的文法的非终结符构造FIRST集合和FOLLOW集合。
(3)说明所得的文法是LL(1)文法。
(4)为所得的文法构造LL(1)分析表。
(5)假设有输入串为“char x,y,z;”,写出相对应的LL(1)分析过程。
解:(1)规则<变量表>→ID,<变量表>|ID提取公因子如下:<变量表>→ID(,<变量表>|ε)增加新的非终结符<变量表1>,规则变为:<变量表>→ID<变量表1><变量表1>→,<变量表>|εC声明文法改变为:<声明语句>→<类型><变量表>;<类型>→int|float|char<变量表>→ID<变量表1><变量表1>→,<变量表>|ε(2)FIRST(<声明语句>)=FIRST(<类型>)={int,float,char}FIRST(<变量表>)={ID}FIRST(<变量表1>)={,,ε}FOLLOW(<声明语句>)={#}FOLLOW(<类型>)=FIRST(<变量表>)={ID}FOLLOW(<变量表>)=FOLLOW(<变量表1>)={;}(3)所得文法无左递归,且FIRST(int)∩FIRST(float)∩FIRST(char)=ΦFIRST(,<变量表>)∩FIRST(ε)=ΦFIRST(,<变量表>)∩FOLLOW(<变量表1>)=Φ因此,所得文法为LL(1)文法。
更常用且简单的LL(1)分析表:5.1 考虑以下的文法:S→S;T|TT→a(1)为这个文法构造LR(0)的项目集规范族。
(2)这个文法是不是LR(0)文法?如果是,则构造LR(0)分析表。
(3)对输入串“a;a”进行分析。
解:(1)拓广文法G[S’]:0:S’→S1:S→S;T2:S→T3:T→a构造LR(0)项目集规范族LR(0)文法。
LR(0)分析表如下:5.2 证明下面文法是SLR(1)文法,但不是LR(0)文法。
【编译原理】1-5章课后习题答案精心整理版,可直接缩印

第一章1.2 计算机执行用高级语言编写的程序有哪些途径?它们之间的主要区别是什么? 【解答】计算机执行用高级语言编写的程序主要有两种途径:解释和编译。
这两种途径的主要区别在于:解释方式下不生成目标代码程序,而编译方式下生成目标代码程序。
从执行速度上看,编译型的高级语言比解释型的高级语言要快,但解释方式下的人机界面比编译型好,便于程序调试。
(在解释方式下,翻译程序事先并不采用将高级语言程序全部翻译成机器代码程序,然后执行这个机器代码程序的方法,而是每读入一条源程序的语句,就将其解释(翻译)成对应其功能的机器代码语句串并执行,而所翻译的机器代码语句串在该语句执行后并不保留,最后再读入下一条源程序语句,并解释执行。
这种方法是按源程序中语句的动态执行顺序逐句解释(翻译)执行的,如果一语句处于一循环体中,则每次循环执行到该语句时,都要将其翻译成机器代码后再执行。
在编译方式下,高级语言程序的执行是分两步进行的:第一步首先将高级语言程序全部翻译成机器代码程序,第二步才是执行这个机器代码程序。
因此,编译对源程序的处理是先翻译,后执行。
)1.3 请画出编译程序的总框图。
如果你是一个编译程序的总设计师,设计编译程序时应当考虑哪些问题? 【解答】编译程序总框图如图1-1所示。
作为一个编译程序的总设计师,首先要深刻理解被编译的源语言其语法及语义;其次,要充分掌握目标指令的功能及特点,如果目标语言是机器指令,还要搞清楚机器的硬件结构以及操作系统的功能;第三,对编译的方法及使用的软件工具也必须准确化。
总之,总设计师在设计编译程序时必须估量系统功能要求、硬件设备及软件工具等诸因素对编译程序构造的影响等。
第二章2.1 正规式M1和M2等价是指:M1和M2所识别的语言集相等。
2.2 什么是扫描器?扫描器的功能是什么?【解答】扫描器就是词法分析器,它接受输入的源程序,对源程序进行词法分析并识别出一个个单词符号,其输出结果是单词符号,供语法分析器使用。
编译原理及实现课后答案
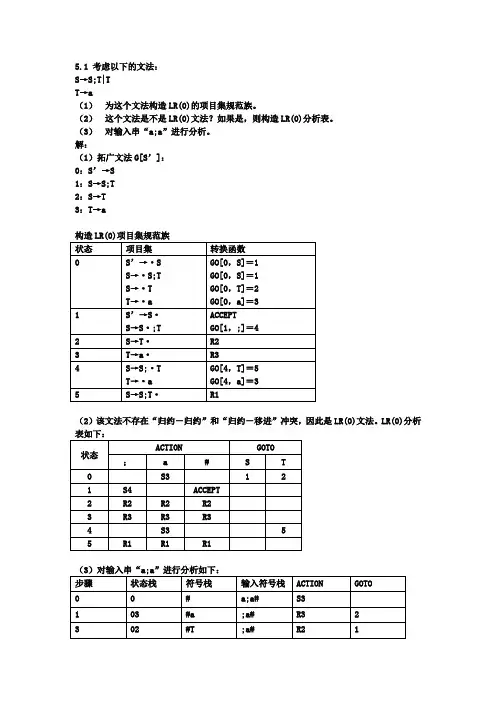
5.1 考虑以下的文法:S→S;T|TT→a(1)为这个文法构造LR(0)的项目集规范族。
(2)这个文法是不是LR(0)文法?如果是,则构造LR(0)分析表。
(3)对输入串“a;a”进行分析。
解:(1)拓广文法G[S’]:0:S’→S1:S→S;T2:S→T3:T→a构造LR(0)项目集规范族(2)该文法不存在“归约-归约”和“归约-移进”冲突,因此是LR(0)文法。
LR(0)分析表如下:(3)对输入串“a;a”进行分析如下:5.2 证明下面文法是SLR(1)文法,但不是LR(0)文法。
S→AA→Ab|bBaB→aAc|a|aAb解:文法G[S]:0:S→A1:A→Ab2:A→bBa3:B→aAc4:B→a5:B→aAb状态5存在“归约-移进”冲突,状态9存在“归约-归约”冲突,因此该文法不是LR(0)文法。
状态5:FOLLOW(B)={a},因此,FOLLOW(B)∩{b}=Φ状态9:FOLLOW(B)={a},FOLLOW(A)={#,b,c},因此FOLLOW(B)∩FOLLOW(A)=Φ该SLR(1)分析表无重定义,因此该文法是SLR(1)文法,不是LR(0)文法。
5.3 证明下面文法是LR(1)文法,但不是SLR(1)文法。
S→AaAb|BbBaA→εB→ε解:拓广文法G[S’]:0:S’→S1:S→AaAb2:S→BbBa3:A→ε4:B→ε={a,b},即FOLLOW(A)∩FOLLOW(B)={a,b}≠Φ,所以该文法不是SLR(1)文法。
构造LR(1)项目集规范族:分析表无重定义,说明该文法是LR(1)文法,不是SLR(1)文法。
5.4 考虑以下的文法:E→EE+E→EE*E→a(1)为这个文法构造LR(1)项目集规范族。
(2)构造LR(1)分析表。
(3)为这个文法构造LALR(1)项目集规范族。
(4)构造LALR(1)分析表。
(5)对输入符号串“aa*a+”进行LR(1)和LALR(1)分析。
编译原理及实践教程(黄贤英 王柯柯 编著) 习题答案

第2章参考答案:1,2,3:解答:略!4. 解答:A:① B:③ C:① D:②5. 解答:用E表示<表达式>,T表示<项>,F表示<因子>,上述文法可以写为:E → T | E+TT → F | T*FF → (E) | i最左推导:E=>E+T=>E+T+T=>T+T+T=>F+T+T=>i+T+T=>i+F+T=>i+i+T=>i+i+F=>i+i+iE=>E+T=>T+T=>F+T=>i+T=>i+T*F=>i+F*F=>i+i*F=>i+i*i 最右推导:E=>E+T=>E+F=>E+i=>E+T+i=>E+F+i=>E+i+i=>T+i+i=>F+i+i=>i+i+iE=>E+T=>E+T*F=>E+T*i=>E+F*i=>E+i*i=>T+i*i=>F+i*i =>i+i*ii+i+i和i+i*i的语法树如下图所示。
i+i+i、i+i*i的语法树6. 解答:(1) 终结符号为:{or,and,not,(,),true,false}非终结符号为:{bexpr,bterm,bfactor}开始符号为:bexpr(2) 句子not(true or false)的语法树为:7. 解答:(1) 把a n b n c i分成a n b n和c i两部分,分别由两个非终结符号生成,因此,生成此文法的产生式为:S → ABA → aAb|abB → cB|ε(2) 令S为开始符号,产生的w中a的个数恰好比b多一个,令E为一个非终结符号,产生含相同个数的a和b的所有串,则产生式如下:S → aE|Ea|bSS|SbS|SSbE → aEbE|bEaE|ε(3) 设文法开始符号为S,产生的w中满足|a|≤|b|≤2|a|。
(完整版)编译原理及实现课后习题答案
编译原理及实现课后习题解答2.1设字母表A={a},符号串x=aaa,写出下列符号串及其长度:x0,xx,x5 以及A+和A*.x0=(aaa)0=ε| x0|=0xx=aaaaaa |xx|=6x5=aaaaaaaaaaaaaaa | x5|=15A+ =A1∪A2∪ …. ∪A n∪…={a,aa,aaa,aaaa,aaaaa…}A* = A0 ∪A1 ∪A2 ∪…. ∪A n ∪…={ε,a,aa,aaa,aaaa,aaaaa…}2.2令∑={a,b,c},又令x=abc,y=b,z=aab,写出如下符号串及它们的长度:xy,xyz,(xy)3xy=abcb |xy|=4xyz=abcbaab |xyz|=7(xy)3=(abcb)3 =abcbabcbabcb | (xy)3 |=122.3设有文法G[S]:S∷=SS*|SS+|a,写出符号串aa+a*规范推导,并构造语法树。
S => SS* => Sa* => SS+a* => Sa+a* => aa+a*SS S *S S + aa a2.4 已知文法G[Z]:Z∷=U0∣V1 、U∷=Z1∣1 、V∷=Z0∣0 ,请写出全部由此文法描述的只含有四个符号的句子。
Z=>U0=>Z10=>U010=>1010Z=>U0=>Z10=>V110=>0110Z=>V1=>Z01=>U001=>1001Z=>V1=>Z01=>V101=>01012.5已知文法G[S]:S∷=AB A∷=aA︱εB∷=bBc︱bc , 写出该文法描述的语言。
A∷=aA︱ε描述的语言: {a n|n>=0}B∷=bBc︱bc 描述的语言:{b n c n|n>=1}L(G[S])={a n b m c m|n>=0,m>=1}2.6已知文法E∷=T∣E+T∣E-T 、T∷=F∣T*F∣T/F 、F∷=(E)∣i,写出该文法的开始符号、终结符号集合V T、非终结符号集合V N。
(完整版)哈工大编译原理习题及答案
何谓源程序、目标程序、翻译程序、编译程序和解释程序它们之间可能有何种关系一个典型的编译系统通常由哪些部分组成各部分的主要功能是什么选择一种你所熟悉的程序设计语言,试列出此语言中的全部关键字,并通过上机使用该语言以判明这些关键字是否为保留字。
选取一种你所熟悉的语言,试对它进行分析,以找出此语言中的括号、关键字END以及逗号有多少种不同的用途。
试用你常用的一种高级语言编写一短小的程序,上机进行编译和运行,记录下操作步骤和输出信息,如果可能,请卸出中间代码和目标代码。
第一章习题解答1.解:源程序是指以某种程序设计语言所编写的程序。
目标程序是指编译程序(或解释程序)将源程序处理加工而得的另一种语言(目标语言)的程序。
翻译程序是将某种语言翻译成另一种语言的程序的统称。
编译程序与解释程序均为翻译程序,但二者工作方法不同。
解释程序的特点是并不先将高级语言程序全部翻译成机器代码,而是每读入一条高级语言程序语句,就用解释程序将其翻译成一段机器指令并执行之,然后再读入下一条语句继续进行解释、执行,如此反复。
即边解释边执行,翻译所得的指令序列并不保存。
编译程序的特点是先将高级语言程序翻译成机器语言程序,将其保存到指定的空间中,在用户需要时再执行之。
即先翻译、后执行。
2.解:一般说来,编译程序主要由词法分析程序、语法分析程序、语义分析程序、中间代码生成程序、代码优化程序、目标代码生成程序、信息表管理程序、错误检查处理程序组成。
3.解:C语言的关键字有:auto break case char const continue default do double else enum externfloat for goto if int long register return short signed sizeof static struct switch typedef union unsigned void volatile while。
《编译原理》习题解答

《编译原理》习题解答:第一次作业:P14 2、何谓源程序、目标程序、翻译程序、汇编程序、编译程序和解释程序?它们之间可能有何种关系?答:被翻译的程序称为源程序;翻译出来的程序称为目标程序或目标代码;将汇编语言和高级语言编写的程序翻译成等价的机器语言,实现此功能的程序称为翻译程序;把汇编语言写的源程序翻译成机器语言的目标程序称为汇编程序;解释程序不是直接将高级语言的源程序翻译成目标程序后再执行,而是一个个语句读入源程序,即边解释边执行;编译程序是将高级语言写的源程序翻译成目标语言的程序。
关系:汇编程序、解释程序和编译程序都是翻译程序,具体见P4 图 1.3。
P14 3、编译程序是由哪些部分组成?试述各部分的功能?答:编译程序主要由8个部分组成:(1)词法分析程序;(2)语法分析程序;(3)语义分析程序;(4)中间代码生成;(5)代码优化程序;(6)目标代码生成程序;(7)错误检查和处理程序;(8)信息表管理程序。
具体功能见P7-9。
P14 4、语法分析和语义分析有什么不同?试举例说明。
答:语法分析是将单词流分析如何组成句子而句子又如何组成程序,看句子乃至程序是否符合语法规则,例如:对变量x:= y 符合语法规则就通过。
语义分析是对语句意义进行检查,如赋值语句中x与y类型要一致,否则语法分析正确,语义分析则错误。
P15 5、编译程序分遍由哪些因素决定?答:计算机存储容量大小;编译程序功能强弱;源语言繁简;目标程序优化程度;设计和实现编译程序时使用工具的先进程度以及参加人员多少和素质等等。
补充:1、为什么要对单词进行内部编码?其原则是什么?对标识符是如何进行内部编码的?答:内部编码从“源字符串”中识别单词并确定单词的类型和值;原则:长度统一,即刻画了单词本身,也刻画了它所具有的属性,以供其它部分分析使用。
对于标识符编码,先判断出该单词是标识符,然后在类别编码中写入相关信息,以表示为标识符,再根据具体标识符的含义编码该单词的值。
编译原理及实践教程第1章参考答案
1.翻译程序:能够将某种语言写的程序转换成另一种语言的程序,而且后者与前者在逻辑上是等价的。
编译程序:是一种将高级语言程序(源程序)翻译成低级语言(目标程序)的程序解释程序:接受某高级语言的一个语句输入,进行解释并控制计算机执行,马上得到这句的执行结果,然后再接受下一句。
源程序:被翻译的程序。
目标程序:翻译后的程序。
遍:对源程序或源程序的中间结果从头到尾扫描一次,并作有关的加工处理,生成新的中间结果或目标程序。
编译前端:主要指与源语言有关,与目标语言无关的部分,通常包括词法分析、语法分析、语义分析和中间代码生成,与机器无关部分的代码优化编译后端:指与目标机器有关的部分。
如与机器有关的优化、目标代码生成2.高级语言程序有哪两种执行方式?其特点是什么?阐述其主要异同点。
答:高级语言程序有编译程序和解释程序两种执行方式;编译程序(Compiler)——将高级程序设计语言程序翻译成逻辑上等价的低级语言(汇编语言,机器语言)程序的翻译程序。
解释程序(Interpreter)——将高级程序设计语言写的源程序作为输入,边解释边执行源程序本身,而不产生目标程序的翻译程序。
3.编译过程可分为哪些阶段?各个阶段的主要任务是什么?答:编译过程逻辑上可分为五个阶段:词法分析、语法分析、语义分析与中间代码生成、代码优化、目标代码生成。
第一阶段:词法分析任务: 从左到右扫描源程序,识别出每个单词第二阶段:语法分析任务: 在词法分析的基础上,根据语言的语法规则,将单词符号串分解成各类语法短语(例:程序、语句、表达式)。
第三阶段:语义分析和中间代码生成任务:对语法分析所识别出的各类语法范畴分析其含义,进行初步的翻译(翻译成中间代码)。
第四阶段:代码优化任务:对已产生的中间代码进行加工变换,使生成的目标代码更为高效(时间和空间)。
第五阶段:目标代码的生成任务:把中间代码(或经优化的中间代码)变换成特定机器上的低级语言代码。
4. 编译程序有哪些主要构成成分?各自的主要功能是什么?答:(1) 记号(token)当扫描程序将字符收集到一个记号中时,它通常是以符号表示这个记号;这也就是说,作为一个枚举数据类型的值来表示源程序的记号集。
编译原理
《编译原理》课后习题答案第 1 章引论第 1 题解释下列术语:(1)编译程序(2)源程序(3)目标程序(4)编译程序的前端(5)后端(6)遍(1)编译程序:如果源语言为高级语言,目标语言为某台计算机上的汇编语言或机器语言,则此翻译程序称为编译程序。
(2)源程序:源语言编写的程序称为源程序。
(3)目标程序:目标语言书写的程序称为目标程序。
(4)编译程序的前端:它由这样一些阶段组成:这些阶段的工作主要依赖于源语言而与目标机无关。
通常前端包括词法分析、语法分析、语义分析和中间代码生成这些阶段,某些优化工作也可在前端做,也包括与前端每个阶段相关的出错处理工作和符号表管理等工作。
(5)后端:指那些依赖于目标机而一般不依赖源语言,只与中间代码有关的那些阶段,即目标代码生成,以及相关出错处理和符号表操作。
(6)遍:是对源程序或其等价的中间语言程序从头到尾扫视并完成规定任务的过程。
第 2 题一个典型的编译程序通常由哪些部分组成?各部分的主要功能是什么?并画出编译程序的总体结构图。
一个典型的编译程序通常包含 8 个组成部分,它们是词法分析程序、语法分析程序、语义分析程序、中间代码生成程序、中间代码优化程序、目标代码生成程序、表格管理程序和错误处理程序。
其各部分的主要功能简述如下。
词法分析程序:输人源程序,拼单词、检查单词和分析单词,输出单词的机内表达形式。
语法分析程序:检查源程序中存在的形式语法错误,输出错误处理信息。
语义分析程序:进行语义检查和分析语义信息,并把分析的结果保存到各类语义信息表中。
中间代码生成程序:按照语义规则,将语法分析程序分析出的语法单位转换成一定形式的中间语言代码,如三元式或四元式。
中间代码优化程序:为了产生高质量的目标代码,对中间代码进行等价变换处理。
目标代码生成程序:将优化后的中间代码程序转换成目标代码程序。
表格管理程序:负责建立、填写和查找等一系列表格工作。
表格的作用是记录源程序的各类信息和编译各阶段的进展情况,编译的每个阶段所需信息多数都从表格中读取,产生的中间结果都记录在相应的表格中。
编译原理习题及答案(整理后)
第一章之相礼和热创作1、将编译程序分成多少个“遍”是为了.a.进步程序的执行服从b.使程序的结构愈加明晰c.利用无限的机器内存并进步机器的执行服从d.利用无限的机器内存但降低了机器的执行服从2、构造编译程序应掌握.a.源程序b.目口号言c.编译方法d.以上三项都是3、变量该当.a.持有左值b.持有右值c.既持有左值又持有右值d.既不持有左值也不持有右值4、编译程序尽大多数工夫花在上.a.出错处理b.词法分析c.目的代码生成d.管理表格5、不成能是目的代码.a.汇编指令代码b.可重定位指令代码c.尽对指令代码d.两头代码6、运用可以定义一个程序的意义.a.语义规则b.语法规则c.发生规则d.词法规则7、词法分析器的输入是.a.单词符号串b.源程序c.语法单位d.目的程序8、两头代码生成时所遵照的是-.a.语法规则b.词法规则c.语义规则d.等价变换规则9、编译程序是对.a.汇编程序的翻译b.高级言语程序的解释执行c.机器言语的执行d.高级言语的翻译10、语法分析应遵照.a.语义规则b.语法规则c.构词规则d.等价变换规则二、多项选择题1、编译程序各阶段的工作都触及到.a.语法分析b.表格管理c.出错处理d.语义分析e.词法分析2、编译程序工作时,通常有阶段.a.词法分析b.语法分析c.两头代码生成d.语义检查e.目的代码生成三、填空题1、解释程序和编译程序的区别在于.2、编译过程通常可分为5个阶段,分别是、语法分析、代码优化和目的代码生成.3、编译程序工作过程中,第一段输入是,末了阶段的输入为程序.4、编译程序是指将程序翻译成程序的程序.单选解答1、将编译程序分成多少个“遍”是为了使编译程序的结构愈加明晰,故选b.2、构造编译程序应掌握源程序、目口号言及编译方法等三方面的学问,故选d.3、对编译而言,变量既持有左值又持有右值,故选c.4、编译程序打交道最多的就是各种表格,因此选d.5、目的代码包含汇编指令代码、可重定位指令代码和尽对指令代码3种,因此不是目的代码的只能选d.6、词法分析遵照的是构词规则,语法分析遵照的是语法规则,两头代码生成遵照的是语义规则,而且语义规则可以定义一个程序的意义.因此选a.7、b 8、c 9、d 10、c多选解答1.b、c 2. a、b、c、e填空解答能否生成目的程序 2、词法分析两头代码生成 3、源程序目的代码生成4、源程序目口号言第二章一、单项选择题1、文法G:S→xSx|y所识此外言语是.n yx n(n≥0) d.x*yx*2、文法G描绘的言语L(G)是指.a. L(G)={α|S+⇒α, α∈V T*}b. L(G)={α|S*⇒α, α∈V T*}c. L(G)={α|S*⇒α,α∈(V T∪V N*)}d. L(G)={α|S+⇒α,α∈(V T∪V N*)}3、无限形态自动机能辨认.a. 上下文有关文法b. 上下文有关文法c.正轨文法d. 短语文法4、设G为算符优先文法,G的恣意闭幕符对a、b有以下关系成立.a. 若f(a)>g(b),则a>bb.若f(a)<g(b),则a<bc. a~b都纷歧定成立d.a~b一定成立5、假如文法G是无二义的,则它的任何句子α.a. 最左推导和最右推导对应的语法树一定相反b. 最左推导和最右推导对应的语法树可能分歧c. 最左推导和最右推导一定相反d. 可能存在两个分歧的最左推导,但它们对应的语法树相反6、由文法的开始符经0步或多步推导发生的文法符号序列是.a. 短语b.句柄c. 句型d. 句子7、文法G:E→E+T|TT→T*P|PP→(E)|I则句型P+T+i的句柄和最左素短语为.a.P+T和i和P+T 和P+T+id.P和T8、设文法为:S→SA|AA→a|b则对句子aba,下面是规范推导.ÞSAÞSAAÞAAAÞaAAÞabAÞabab. SÞSAÞSAAÞAAAÞAAaÞAbaÞabac. SÞSAÞSAAÞSAaÞSbaÞAbaÞabad. SÞSAÞSaÞSAaÞSbaÞAbaÞaba9、文法G:S→b|∧(T)T→T,S|S则FIRSTVT(T).a. {b,∧,(}b. {b,∧,)}c.{b,∧,(,,}d.{b,∧,),,}10、发生正轨言语的文法为.型 b. 1型 c. 2型 d. 3型11、采取自上而下分析,必须.a. 消弭左递回b. 消弭右递回c. 消弭回溯d. 提取公共左因子12、在规范回约中,用来刻画可回约串.a. 直接短语b. 句柄c. 最左素短语d. 素短语13、有文法G:E→E*T|TT→T+i|i句子1+2*8+6按该文法G回约,其值为.a. 23 B. 42 c. 30 d. 1714、规范回约指.a. 最左推导的逆过程b. 最右推导的逆过程c. 规范推导d.最左回约的逆过程二、多项选择题1、下面哪些说法是错误的.a. 有向图是一个形态转换图b. 形态转换图是一个有向图c.有向图是一个DFAd.DFA可以用形态转换图暗示2、对无二义性文法来说,一棵语法树每每代表了.a. 多种推导过程b. 多种最左推导过程c.一种最左推导过程d.仅一种推导过程e.一种最左推导过程3、假如文法G存在一个句子,满足下列条件之一时,则称该文法是二义文法.a. 该句子的最左推导与最右推导相反b. 该句子有两个分歧的最左推导c. 该句子有两棵分歧的最右推导d. 该句子有两棵分歧的语法树e.该句子的语法树只要一个4、有一文法G:S→ABA→aAb|εB→cBd|ε它不发生下面集合.a. {a n b m c n d m|n,m≥0}b. {a n b n c m d m|n,m>0}c. {a n b m c m d n|n,m≥0}d. {a n b n c m d m|n,m≥0}e. {a n b n c n d n|n≥0}5、自下而上的语法分析中,应从开始分析.a. 句型b. 句子c. 以单词为单位的程序d. 文法的开始符e. 句柄6、对正轨文法描绘的言语,以下有才能描绘它.a.0型文法b.1型文法c.上下文有关文法d.右线性文法e.左线性文法三、填空题1、文法中的闭幕符和非闭幕符的交集是.词法分析器交给语法分析器的文法符号一定是,它一定只出如今发生式的部.2、最左推导是指每次都对句型中的非闭幕符进行扩展.3、在语法分析中,最稀有的两种方法一定是分析法,另一是分析法.4、采取语法分析时,必须消弭文法的左递回.5、树代表推导过程,树代表回约过程.6、自下而上分析法采取、回约、错误处理、等四种操纵.7、Chomsky把文法分为品种型,编译器构造中采取和文法,它们分别发生和言语,并分别用和自动机辨认所发生的言语.四、判别题1、文法 S→aS|bR|ε描绘的言语是(a|bc)* ( )R→c S2、在自下而上的语法分析中,语法树与分析树一定相反.()3、二义文法不是上下文有关文法. ()4、语法分析时必须先消弭文法中的左递回.()5、规范回约和规范推导是互逆的两个过程.()6、一个文法全部句型的集合构成该文法所能接受的言语.()五、简答题1、句柄2、素短语3、语法树4、回约5、推导六、问答题1、给出上下文有关文法的定义.2、文法G[S]:S→aSPQ|abQQP→PQbP→bbbQ→bccQ→cc(1)它是Chomsky哪一型文法?(2)它生成的言语是什么?3、按指定类型,给出言语的文法.L={a i b j|j>i≥1}的上下文有关文法.4、有文法G:S→aAcB|BdA→AaB|cB →bScA|b(1)试求句型aAaBcbbdcc 和aAcbBdcc 的句柄; (2)写出句子acabcbbdcc 的最左推导过程.5、对于文法G[S]:S →(L )|aS|aL →L, S|S(1)画出句型(S,(a ))的语法树.(2)写出上述句型的全部短语、直接短语、句柄和素短语. 6、考虑文法G[T]:T →T*F|F F →F ↑P|P P →(T )|i证明T*P ↑(T*F )是该文法的一个句型,并指出直接短语和句柄. 单选[解答] 1、选c.2、选a.3、选c.4、虽然a 与b 没有优先关系,但构造优先函数后,a 与b 就一定存在优先关系了.以是,由f(a)>g)(b)或f(a)<g(b)其实不克不及断定原来的a 与b 之间能否存在优先关系:故选c.5、假如文法G 无二义性,则最左推导是老师长左边的枝叶:对于d6、选c.7、由图2-8-18、规范推导是最左推导,故选d.9、由T →T,…和T →(… 得 由T →S 得FIRSTVT(S)⊂∧,(};即FIRSTVT(T)={b,∧,(,,}; 10、d 11、c 12、b 13、b 14、b多选解答 1、e 、a 、c 2、a 、c 、e 3、、a 、b 、c 、d 、e填空解答 1、空集 闭幕符 右 2、最左3、自上而上 自下而上4、自上而上5、语法 分析6、移进 接受7、4 2 型 3型 上下文有关言语 正轨言语 下推自动机 无限 判别解答 1、对 2、错 3、错 4、错 5、错 6、错 简答[解答]1、句柄:一个句型的最左直接短语称为该句型的句柄.2、素短语:至多含有一个闭幕符的素短语,而且除它本身之外不再含任何更小的素短语.3、语法树:满足下面4个条件的树称之为文法G[S]的一棵语法树. ①每一闭幕均有一标识表记标帜,此标识表记标帜为V N ∪V T 中的一个符号;②树的根结点以文法G[S]的开始符S 标识表记标帜;③若一结点至多有一个直接后继,则此结点上的标识表记标帜为V N 中的一个符号;④若一个以A 为标识表记标帜的结点有K 个直接后继,且按从左至右的顺序,这些结点的标识表记标帜分别为X 1,X 2,…,X K ,则A→X 1,X 2,…,X K ,必定是G 的一个发生式.4、回约:我们称αγβ直接回约出αAβ,仅当A→γ是一个发生式,且α、β∈(V N∪V T)*.回约过程就是从输入串开始,反复用发生式右部的符号更换成发生式左部符号,直至文法开始符.5、推导:我们称αAβ直接推出αγβ,即αAβÞαγβ,仅当A→γ是一个发生式,且α、β∈(V N∪V T)*.假如α1Þα2Þ…Þαn,则我们称这个序列是从α1至α2的一个推导.若存在一个从α1αn的推导,则称α1可推导出αn.推导是回约的逆过程.问答1[解答]一个上下文有关文法G是一个四元式(V T,V N,S, P),其中:●V T是一个非空无限集,它的每个元素称为闭幕符号;●V N是一个非空无限集,它的每个元素称为非闭幕符号,V T∩V N=Φ;●S是一个非闭幕符号,称为开始符号;●P是一个发生式集合(无限),每个发生式的方式是P→α,其中,P∈V N,α∈(V T∪V N)*.开始符号S至多必须在某个发生式的左部出现一次.2[解答](1)由于发生式左部存在闭幕符号,且全部发生式左部符号的长度均小于等于发生式右部的符号长度,以是文法G[S]是Chomsky1型文法,即上下文有关文法.(2)按发生式出现的顺序规定优先级由高到低(否则无法推出句子),我们可以得到:SÞabQÞabcSÞaSPQÞaabQPQÞaabPQQÞaabbQQÞaabbcQÞaabbccSÞaSPQÞaaSPQPQÞaaabQPQPQÞaaabPQQPQÞaaabPQPQQÞaaaPP QQQÞaaabbPqqqÞaaabbQQQÞaaabbbcQQÞaaabbbccQÞaaabbbccc……于是得到文法G[S]生成的言语L={a n b n c n|n≥1}3【解答】(1)由L={a i b j|j>i≥1}知,所求该言语对应的上下文有关文法首先应有S→aSb型发生式,以包管b的个数很多于a的个数;其次,还需有S→Sb或S→bS型的发生式,用以包管b的个数多于a的个数;也即所求上下文有关文法G[S]为:G[S]:S→aSb|Sb|b4【解答】(1)分别画出对应两句型的语法树,如图2-8-2所示句柄:AaB BdÞ5((6【解答】 首先构造T*P ↑(T*F 由图2-8-4可知,T*P ↑(T*F 直接短语有两个,即P 和T*F 第三章 一、单项选择题1、词法分析所根据的是. a. 语义规则 b. d. 等价变换规则2、词法分析器的输入结果是.a. 单词的种别编码b. 单词在符号表中的地位c. 单词的种别编码和本身值d. 单词本身值3、正轨式M 1和M 2等价是指.a. M 1和M 2的形态数相称b. M 1和M 2的有向弧条数相称c. M 1和M 2所识此外言语集相称d. M 1和M 2形态数和有向弧条数相称4、形态转换图(见图3-6-1)接受的字集为.a. 以 0b. 以0结尾的二进制数组成的集合 c. d. 含偶数个0的二进制数组成的集合 5白,因此,. a. 词法分析器作为子程序较好c. 词法分析器分解为多个过程,由语法分析器选择运用d. 词法分析器其实不作为一个独立的阶段 二、多项选择题1、在词法分析中,能辨认出. a. 基本字 b. 四元式 c. 运算符 d. 逆波兰式 e. 常数2、令∑={a,b},则∑上全部以b 扫尾,后跟多少个ab 的字的全体对应的正轨式为.a.b(ab)*b. b(ab)+c.(ba)*bd. (ba)+b e. b(a|b) 三、填空题1、确定无限自动机DFA 是的一个特例.2、若二个正轨式所暗示的相反,则以为二者是等价的.3、一个字集是正轨的,当且仅当它可由所. 四、判别题1、一个无限形态自动机中,有且仅有一个独一终态. ( )2、设r 和s 分别是正轨式,则有L (r|s )=L(r)|L(s). ( )3、自动机M 和M ′的形态数分歧,则二者必不等价. ( )4、确定的自动机以及不确定的自动机都能正确地辨认正轨集. ( )5、对恣意一个右线性文法G ,都存在一个NFA M ,满足L(G)=L(M). ( )6、对恣意一个右线性文法G ,都存在一个DFA M ,满足L(G)=L(M). ( )7、对任何正轨表达式e ,都存在一个NFA M ,满足L(G)=L(e). ( )8、对任何正轨表达式e ,都存在一个DFA M ,满足L(G)=L(e). ( ) 五、基本题1、设M =({x,y}, {a,b}, f,x,{y})为一非确定的无限自动机,其中f 定义如下:图3-6-7 的NFA Mf (x,a )={x,y} f (x,b )={y} f (y,a )=φ f (y,b )={x,y}试构造相应的确定无限自动机M ′.2、对给定正轨式b*(d|ad )(b|ab )+,构造其NFA M ; 单选解答 1、b 2、c3、c4、d5、b 多选解答 1、a 、c 、e 2、a 、b 、d填空解答 1、NFA 2、正轨集 3、DFA (NFA )所辨认 判别解答 1 、2、3、错 4、5、6、7、8、正确基本1解答:对照自动机的定义M=(S,Σ,f,S 0,Z),由f 的定义可知将转换矩阵中的全部子集重新命名而构成表3-6-4所示的形态转换矩阵.表3-6-4 形态转换矩阵将图调查{1,2}.{1,2}都导向1所示化简21、 D → T 2、 S →P →3、 G[S]aAbDe|dA →BSD|eB →SAc| cD| εD→Se| ε(1)求出该文法的每一个非闭幕符U的FOLLOW集.(2)该文法是LL(1)文法吗?(3)构造C[S]的LL(1)分析表.4、将文法G[V]改形成为LL(1)的.G[V]:V→N|N[E]E→V|V+EN→i5、已知文法:G[A]:A→aAa|ε(1)该文法是LL(1)文法吗?为什么?(2)若采取LL(1)方法进行语法分析,怎样得到该文法的LL(1)分析表?(3)若输入符号串“aaaa”,请给出语法分析过程.1解答: LL(1)分析表见表4-3-1分析虽然这个文法很简单,我们还是从求开始符号集合和后继符号集合开始.FIRST(D)=FIRST(T)={int, real}FOLLOW(D)=FOLLOW (L)={#}FIRST(L)={id} FOLLOW(T)={id}FIRST(R)={,, ε} FOLLOW(R)={#}有了下面每个非闭幕符的FIRST集合,填分析表时要计算一个发生式右部α的FIRST(α)就不是件难事了.填表时独一要警惕的时,ε是发生式R→ε右部的一个开始符号,而#在FOLLOW(R)中,以是R→ε填在输入符号#的栏目中.2解答:该文法不是LL(1)文法,见下面分析中的阐明.分析只要三个非闭幕符有两个选择.1、P的两个右部d P 和ε 的开始符号一定不相交.2、Q的两个右部a Q 和ε 的开始符号一定不相交.3、对S来说,由于x ∈ FIRST(A B),同时也有x ∈ FIRST(P Q x)(由于P和Q都可能为空).以是该文法不是LL(1)文法.3解答:(1)求文法的每一个非闭幕符U的FOLLOW集的过程如下:由于:①S是辨认符号,且有A→BSD、B→SAc、D→Se,以是FOLLOW(S)应包含FIRST(D)∪FIRST(Ac)∪FIRST(e)∪{#}={a,d}∪{a,d,c,e}∪{e}∪{#}={a,c,d,e#}②又由于A→BSD和D→ε,以是FOLLOW中还包含FOLLOW(A).由于S→aAbDe和B→SAc,以是FOLLOW(A)=FIRST(bDe)∪FIRST(c)={b,c}综合①、②得FOLLOW(S)={a,d,c,e,#}∪{a,b,c,d,e,#}由于A→BSD,以是 FOLLOW(B)=FIRST(SD)={a,d}由于S→aAbDe | d、A→BSD| e和B→SAc | cD,以是FOLLOW(D)=FIRST(e)∪FOLLOW(A)∪FOLLOW (B)={e}∪{b,c}∪{a,d}={a,b,c,d,e}(2)G[S]不是LL(1)文法.由于发生式B→SAc|cD| ε中FIRST(SAc)∩FOLLOW(B)={a,d}≠Ø(3)构造G[S]的LL(1)分析表.按照LL(1)分析表的构造算法构造方法G[S]的LL(1)分析表如表4-3-2所示.4解答:对文法G[V]提取公共左因子后得到文法:G′[V]:V→NAA→ε|[E]E→VBB→ε|+EN→i求出文法G′[V]中每一个非闭幕符号的FIRST集:FIRST(V)={i} FIRST(A)={[,ε}FIRST(E)={i} FIRST(B)={+,ε}FIRST(N)={i}求出文法G′[V]中每一个非闭幕符号的FOLLOW集:FOLLOW(V)={#}∪FIRST(B)\{ε}∪FOLLOW(E)={#,+,]}FOLLOW(A)= FOLLOW(V)={+,,#}FOLLOW(E)= FIRST(])\{ε}∪FOLLOW(B)= FIRST(])\{ε}∪FOLLOW(E)={]}FOLLOW(B)= FOLLOW(E)={ ]}FOLLOW(N)= FIRST(A)\{ε}∪FOLLOW(V)={[,],+,#}可以看到,对文法G′[V]的发生式A→ε|[E],有FIRST([E])∩FOLLOW(A)={[}∩{+,],#}= Ø对发生式B→ε|+E,有FIRST(+E)∩FOLLOW(B)={+}∩{]}= Ø而文法的其他发生式都只要一个不为ε的右部,以是文法G′[V]是LL(1)文法.5解答:(1)由于发生式A→aAa|ε有空发生式右部,而FOLLOW(A)={#}∪FIRST(a)={a, #}形成 FIRST(A)∩FOLLOW(A)={A, ε}∩{a, #}≠Ø以是该文法不是LL(1)文法.(2)若采取LL(1)方法进行语法分析,必须修正该文法.因该文法发生偶数(可以为0)个a,以是得到文法G′[A]: A→aaA|ε此时对发生式A→aaA|ε,有FOLLOW(A)={#}∪FOLLOW(A)={#},因此FIRST(A)∩FOLLOW(A)={a, ε}∩{#}=Ø以是文法G′[A]是LL(1)文法,按LL(1)分析表构造算法构造该文法的LL(1)分析表如表4-3-3所示.”的分析过程如表4-3-4所示.第五章1.设有文法G[S]为:S→a|b|(A)A→SdA|S(1)完成下列算符优先关系表,见表5-7-1,并判别G[S]能否为算符优先文法.表5-7-1 算符优先关系表(2素短语.(3)给出输入串(adb)#的分析过程.解答:(1)先求文法G[S]的FIRSTVT集和LASTVT集:由S→a|b|(A)得:FIRSTVT(S)={a,b,( );由A→Sd…得:FIRSTVT(A)={d};又由A→S…得:FIRSTVT(S)⊂FIRSTVT(A),即FIRSTVT(A)={d,a,b,(};由S→a|b|(A)得;LASTVT(S)={a,b,}};由A→…dA得:LASTVT(A)={d},又由A→S得:LASTVT(S)⊂LASTVT(A),即LASTVT(A)={d,a,b,)}.构造优先关系表方法如下:①对P→…ab…,或P→…aQb…,有a≖b;②对P→…aR…,而b∈FIRSTVT(R),有a⋖b;③对P→…Rb…,而a∈FIRSTVT(R),有a⋗b.由此得到:①由S→(A)得:(≖);②由S→(A…得:(⋖FIRSTVT(A),即:(⋖d,(⋖a ,(⋖b,(⋖(;由A→…dA得:d⋖FIRSTVT(A),即:d⋖d,d⋖a,d⋖b,d⋖(;③由S→A)得,LASTVT(A)⋗),即:d⋗),a⋗),b⋗),)⋗);由A→Sd…得:LASTVT(S)⋗d,即:a⋗d,b⋗d,)⋗d;此外,由#S#得:#≖#;由#⋖FIRSTVT(S)得:#⋖a,#⋖b,#⋖(;脂由LASTVT(S)⋗#得:d⋗#,a⋗#,b⋗#,)⋗#.末了得到算符优先关系表,见表5-7-2.表5-7-2 算符优先关系表由表5-7-2≖、⋖、⋗三种优先关系之一,故G[S]为算符优先文法.(2)为求出句型(SdSdS)的短语、简单短语、句柄,我们先画出该句型对应的语法树,如图5-7-3所示.短语:S,SdS,SdSdS,(SdSdS)简单短语(即直接短语):S句柄(即最左直接短语):S素短语:SdS,它同时也是该句型的最左素短语.(3)输入串(adb)#的分析过程见表5-7-4表5-7-4 输入串(adb)#的分析过程第六章一、单项选择题1、若a为闭幕符,则A→α·aβ为项目a.回约b.移进c.接受d.待约2、若项目集I k含有A→α·,则在形态k时,仅当面临的输入符号a∈FOLLOW(A)时,才采纳“A→α·”动作的一定是.LR文法b.LR(0)文法c.LR(1)文法d.SLR(1)文法3、就文法的描绘才能来说,有.a. SLR(1)⊂LR(0)b. LR(1)⊂LR(0)c. SLR(1)⊂LR (1)d.无二义文法⊂LR(1)4、在LR(0)的ACTION子表中,假如某一行中存在标识表记标帜“r j”的栏,则.a.该行一定填满r jb.该行未填满r jc.其他行也有r j子表中也有r j5、一个指明了在分析过程中的某时候所能看到发生式多大一部分.a.活前缀b.前缀c.项目d.项目集二、多项选择题1、一个LR分析器包含.a.一个总控程序b.一个项目集c.一个活前缀d.一张分析表e.一个分析栈2、LR分析器核心部分是一张分析表,该表包含等子表.a.LL(1)分析b.优先关系c.GOTOd.LRe.ACTION3、每一项ACTION[S,a]所规定的动作包含.a.移进b.比较c.接受d.回约e.报错4、对LR分析表的构造,有可能存在动作冲突.a.移进b.回约c.移进/回约d.移进/移进e.回约/回约5、就文法的描绘才能来说,有.a. SLR(1)⊂LR(1)b. LR(1)⊂SLR(1)c. LR(0)⊂LR(1)d. LR(1)⊂无二义文法e. SLR(1)⊂无二义文法6、对LR分析器来说,存在等分析表的构造方法.LRb.LR(0)c.SLR(1)d.SLR(0)e.LR(1)7、自上而下的语法分析方法有 .a.算符优先分析法b.LL(1)分析法c.SLR(1)分析法d.LR(0)分析法LR(1)分析法三、填空题1、对于一个文法,假如可以构造.使得它的均是独一确定的,则称该文法为LR文法.2、字的前缀是指该字的.3、活前缀是指的一个前缀,这种前缀不含之后的任何符号.4、在LR分析过程中,只需的已扫描部分坚持可回约成一个,则扫描过的部分正确.5、将识此外NFA确定化,使其成为以为形态的DFA,这个DFA 就是建立的根底.6、A→α·称为项目;对文法开始符S′→α·为项目;若a为闭幕符,则称A→α·aβ为项目;若B为非闭幕符,则称A→α·aβ为项目.7、LR(0)分析法的名字中“L”暗示,“R”暗示,“0”暗示.四、综合题1、对于文法G[S]: S→AS|bA→SA|a(1)列出全部LR(0)项目(2)列出构成文法LR(0)项目集规范族.单项解答:1、A→α·称为回约项目,对文法开始符S′的回约项目,如S′→α·称为接受项目,A→α·aβ(a为闭幕符)称为移进项目.在此选b.2、当用发生式A→α回约时,LR(0)无论面临什么输入符号都进行回约;SLR(1)则仅当面临的输入符号a∈FOLLOW(A)时进行回约;LR(1)则当在把α回约为A的规范句型的前缀βAa前提下,当α后跟闭幕符a时,才进行回约;因此选d.3、由于LR(0)⊂SLR(1)⊂ LR(1)⊂无二义文法,故选c.4、选a.5、选c.多选解答:1、一个LR分析器包含一个总控程序和一张分析表,选a、d.2、选c、e.3、选a、c、d、e.4、在LR分析表的构造中有可能存在“移进”/“回约”和“回约”/“回约”冲突;故选c、e.5、选a、b、c、d、e.6、选a、b、c、e.7、选a、c、d、e.填空解答:1、一张分析表每个入口2、恣意首部3、规范句型句柄4、输入串活前缀5、活前缀项目集合 LR分析算法6、回约接受移进待约7、自左至右分析采取最右推导的逆过程即最左回约向右检查0个字符综合解答:首先将文法G拓广为G[S′]:S′→SS→AS|bA→SA|a(1)文法G[S′]的LR(0)项目是:。
编译原理课后习题解答
〈句子〉=>〈主语〉〈谓语〉
=>〈主语〉〈动词〉〈直接宾语〉
=>〈主语〉〈动词〉〈冠词〉〈名词〉
=>〈主语〉〈动词〉〈冠词〉peanut
=>〈主语〉〈动词〉the peanut
=>〈主语〉ate the peanut
=>〈冠词〉〈形容词〉〈名词〉ate the peanut
=>〈冠词〉〈形容词〉 elephant ate the peanut
=>〈冠词〉big elephant ate the peanut
=> the big elephant ate the peanut
(B) 〈句子〉=>〈主语〉〈谓语〉
=>〈主语〉〈动词〉〈直接宾语〉
=>〈冠词〉〈形容词〉〈名词〉〈动词〉〈直接宾语〉
=>〈冠词〉〈形容词〉〈名词〉〈动词〉〈冠词〉〈名词〉
〈偶数字〉::=0 | 2 | 4 | 6 | 8
3. 写一文法,使其语言是偶整数的集合,但不允许有以 0 开头的偶整数。
解:G[〈偶整数〉]:
〈偶整数〉::= 〈符号〉〈单偶数〉|〈符号〉〈首数字〉〈数字串〉〈尾偶数〉
〈符号〉::= + | — |ε
〈单偶数〉::=2 | 4 | 6 | 8
〈尾偶数〉::= 0 |〈单偶数〉
S::= a(B)a B::= bB |b|ε ( 2 ) 文法[G〈S〉]: S ::= (A)(B) A::= aA|a B::= bB|b 6. 文法 G3[〈表达式〉]: 〈表达式〉::=〈项〉|〈表达式〉+〈项〉|〈表达式〉—〈项〉 〈项〉::=〈因子〉|〈项〉*〈因子〉|〈项〉/〈因子〉 〈因子〉::=(〈表达式〉)| i 试给出下列符号串的推导: i, (i), i*i, i*i+i, i*(i+i) 解:(1)〈表达式〉=>〈项〉 =>〈因子〉