
tsfel时间序列特征提取
tsfel时间序列特征提取
时间序列特征提取是一种用于分析和预测时间序列数据的方法。
它通过将时间序列数据转化为具有固定维度的特征向量,来捕捉数据中的重要信息和模式。
tsfel是一个用于时间序列特征提取的Python库,它提供了一系列功能强大的特征提取方法。
下面将介绍tsfel的一些特征提取方法及其应用。
1. 基本统计特征:tsfel提供了一系列基本的统计特征,包括均值、标准差、最大值、最小值等。
这些特征能够反映时间序列数据的整体趋势和离散程度。
2. 时域特征:时域特征是在时间域上对时间序列数据进行分析的特征。
tsfel提供了一些常用的时域特征,如自相关系数、峰度、偏度等。
这些特征能够揭示时间序列数据中的周期性、趋势性和非线性等信息。
3. 频域特征:频域特征是通过对时间序列数据进行傅里叶变换或小波变换等频谱分析方法得到的特征。
tsfel提供了一些常用的频域特征,如频谱能量、频谱熵等。
这些特征能够反映时间序列数据中的频率分布和频率变化。
4. 自回归模型特征:自回归模型是一种用于描述时间序列数据的统计模型。
tsfel提供了一些自回归模型特征,如自回归系数、残差平均值等。
这些特征能够捕捉时间序列数据的自相关性和预测能力。
5. 信息熵特征:信息熵是一种衡量时间序列数据复杂度的指标。
tsfel提供了一些信息熵特征,如样本熵、近似熵等。
这些特征能够反映时间序列数据的随机性和规律性。
以上只是tsfel提供的一部分特征提取方法,它还提供了许多其他的特征提取方法,如小波能量特征、奇异值分解特征等。
通过使用tsfel,我们可以方便地对时间序列数据进行特征提取,从而为后续的分析和预测任务提供有价值的特征。
无论是在工业生产、金融市场还是医疗领域,时间序列特征提取都具有广泛的应用前景。
通过对时间序列数据的深入分析,我们可以更好地理解数据背后的规律和趋势,从而为决策提供有力支持。
tsfresh特征 衍生 逻辑

tsfresh特征衍生逻辑
摘要:
1.TSFresh 特征
2.特征衍生
3.逻辑运用
正文:
一、TSFresh 特征
TSFresh(Time Series Feature)是一种针对时间序列数据的特征提取方法。
它主要通过计算时间序列数据在时间窗口内的统计信息,以及对这些统计信息进行组合,形成具有代表性的特征向量。
TSFresh 特征可以有效地表征时间序列数据的局部结构,从而为后续的分析和建模提供有力支持。
二、特征衍生
在实际应用中,我们可以通过衍生方法进一步扩展TSFresh 特征。
特征衍生主要包括以下几个方面:
1.增加时间窗口大小:通过调整时间窗口的大小,我们可以得到不同粒度的特征信息,从而提高模型的泛化能力。
2.引入时间戳信息:在TSFresh 特征的基础上,我们可以将时间戳信息加入特征向量,使得模型能够更好地捕捉时间序列数据的长期依赖关系。
3.增加数据维度:我们可以通过对原始数据进行变换或者引入其他辅助信息,如历史价格、成交量等,来增加特征维度,提高模型的表现力。
三、逻辑运用
在实际应用中,我们可以将衍生后的TSFresh 特征运用于多种机器学习
算法,如线性回归、支持向量机、神经网络等。
通过这些算法,我们可以进一步挖掘时间序列数据中的潜在规律,为预测和决策提供有力依据。
总之,TSFresh 特征作为一种有效的时间序列特征提取方法,通过特征衍生和逻辑运用,可以为各种时间序列分析任务提供有力支持。
时间序列特征提取

时间序列特征提取时间序列特征提取:在时间序列分析中,有关时间序列特征提取的研究占有重要的地位,该领域的研究范围包括时间序列特征提取和分类、时间序列回归和统计抽取、时间序列模式分类等。
时间序列特征提取的方法可以分为统计方法、神经网络方法和混合方法。
前两种方法是解决时间序列特征提取最典型的统计和机器学习方法,它们统计分析时间序列数据,从而获得可以反映时间序列特征的度量和指标,以及基于时间序列特征的支持向量机分类模型等。
统计方法是指从时间序列中提取特征的统计方法,其特征提取方法主要是基于时间序列的基本统计特征,如时间序列的均值、标准差、峰值和相位等,以建立时间序列特征提取模型。
例如,它可以利用峰值极值和相位值,以提取时间序列模式的信息特征。
此外,统计方法还可以采用统计图形和图表,以提取时间序列模式的频谱特征。
神经网络方法是指对时间序列进行特征提取的神经网络技术。
这种方法的基本思想是,使用一组多层的神经元网络将时间序列数据拟合,以获得能够反映时间序列特征的参数。
由于神经网络可以模拟复杂的时间序列模式,它可以有效地提取时间序列模式的特征,如均值和方差等。
混合方法是指利用一种时间序列特征提取技术,以混合不同的特征提取方法进行时间序列特征提取。
这种方法可以有效地提取时间序列特征,因为它可以由多种特征提取技术组成,使用各种技术综合进行时间序列特征提取。
例如,可以融合统计、神经网络和支持向量机等技术,建立一种更加强大的时间序列特征提取模型。
此外,在时间序列特征提取的研究中,还存在许多有趣的问题,如自然语言处理、视觉特征提取等,它们可以结合以上特征提取技术进行研究,进一步提高时间序列特征提取的准确率和效率。
总之,时间序列特征提取是一门很有前景的研究领域,研究人员在这一领域的工作也不断受到推广与改进,期待我们在未来的时间序列分析中会有更多精彩的发现。
时间序列特征提取分类综述
时间序列特征提取分类综述
时间序列特征提取是指从时间序列数据中提取有意义的特征,
以便用于分类、预测或其他分析任务。
这些特征可以帮助我们更好
地理解数据的模式和趋势,从而提高机器学习模型的性能。
在时间序列特征提取中,常见的特征包括统计特征(如均值、
方差、最大最小值等)、频域特征(如傅里叶变换、功率谱密度等)、时域特征(如自相关、滞后特征等)、形状特征(如峰度、
偏度等)以及其他领域特定的特征(如金融领域的波动率、生物医
学领域的心率变异性等)。
在进行时间序列特征提取时,需要考虑数据的平稳性、周期性、趋势性以及噪声等因素,以选择合适的特征提取方法。
常用的特征
提取方法包括基于统计学的方法、频域分析方法、自回归模型、小
波变换、奇异值分解等。
对于时间序列数据的分类任务,特征提取的质量对分类器的性
能至关重要。
因此,选择合适的特征提取方法并结合合适的分类算
法是非常重要的。
常用的分类算法包括支持向量机、决策树、随机
森林、神经网络等。
总的来说,时间序列特征提取是时间序列分析中的重要环节,合适的特征提取方法可以帮助我们更好地理解数据并提高分类任务的准确性和效率。
时间序列特征提取方法
时间序列特征提取方法
时间序列是指在不同时间点上观测到的一系列数据点的集合。
时间序列数据具有时序依赖关系,观测值之间具有相关性。
时间序列的特征提取是利用时间序列的原始数据提取特征,用于时间序列分类,聚类和异常检测等任务。
常用的时间序列特征提取方法包括:
1. 基本描述统计特征
基本描述统计特征包括平均值、中位数、方差、标准差、最大值、最小值等。
这些特征可以描述时间序列的整体特征。
2. 频域特征
频域特征指的是通过傅里叶变换将时间序列转换到频率域中提取的特征,例如功率谱密度、频带能量等。
3. 时域特征
时域特征是指直接从时间序列数据提取的特征。
例如,均值、方差、斜率等。
4. 自回归特征
自回归特征是指用线性回归模型预测时间序列下一个数据点所需的回
归系数。
这些回归系数可以作为序列的特征。
5. 小波变换特征
小波变换是一种多尺度分析方法,可以将时间序列分解为多个具有不
同尺度的子序列,并对每个子序列进行变换,以提取特征。
例如小波
幅度、小波能量等。
以上是时间序列特征提取的常用方法,不同的任务需要不同的特征,
根据特定任务的需求选择合适的特征提取方法,才能得到更好的结果。
时间序列特征提取分类综述 -回复

时间序列特征提取分类综述-回复时间序列特征提取是时间序列分析中的重要任务之一,它可以将时间序列数据转化为具有判别能力的特征,用于后续的分类任务。
本文将以时间序列特征提取分类综述为主题,逐步回答相关问题。
1. 什么是时间序列特征提取?时间序列特征提取是将时间序列数据转化为一组能够描述时间序列特征的数字形式的过程。
通过提取和选择合适的特征,可以减少数据维度,去除冗余信息,并提高后续分类任务的性能。
2. 为什么需要时间序列特征提取?时间序列通常具有高维度和复杂性,包含大量的冗余和噪声信息。
通过特征提取,可以降低数据的维度,并提取出对分类任务有用的特征,从而提高分类的准确性和效率。
3. 时间序列特征提取有哪些常用方法?常用的时间序列特征提取方法包括统计特征、频域特征、时域特征和信息熵等。
统计特征包括均值、方差和协方差等;频域特征包括快速傅里叶变换(FFT)和小波变换等;时域特征包括自相关函数和差分等;信息熵包括样本熵和马尔可夫熵等。
4. 统计特征如何应用于时间序列特征提取?统计特征是最常用的时间序列特征提取方法之一。
通过计算时间序列的均值、方差、最大值、最小值、偏度、峰度和自相关系数等统计量,可以表征时间序列的整体趋势和分布特性,从而提取有用的特征进行分类。
5. 频域特征在时间序列特征提取中有何作用?频域特征可以通过将时间序列转换到频域中,从而捕捉时间序列的周期性和频率信息。
常用的频域特征提取方法包括傅里叶变换和小波变换。
通过计算频域表示中的频谱能量、频率分布和谱线特性等特征,可以有效地提取出与分类任务相关的频域特征。
6. 时域特征对时间序列特征提取有何帮助?时域特征是指直接从原始时间序列中提取的特征。
时域特征提取方法包括自相关函数、差分和移动平均等。
通过计算自相关函数的峰值位置、差分序列的统计特征以及移动平均序列的均值和标准差等特征,可以捕捉时间序列的趋势和周期性,从而提取有用的时域特征。
7. 信息熵在时间序列特征提取中有何应用?信息熵是一种衡量时间序列复杂度的指标。
时间序列挖掘分析:tsfresh特征提取概述
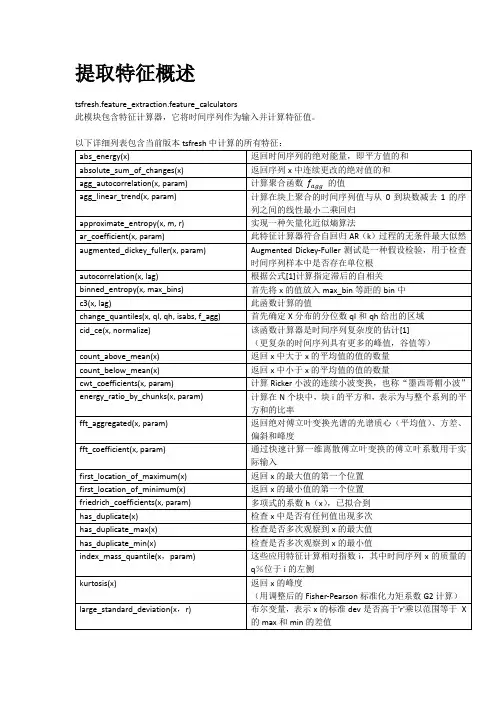
该特征计算器估计不同频率下时间序列x的交叉功率谱密度
standard_deviation(x)
返回x的标准偏差
sum_of_reoccurring_data_points(x)
返回多个时间序列中存在的所有数据点的总和
sum_of_reoccurring_values(x)
longest_strike_below_mean(x)
返回x中最长连续子序列的长度,该长度小于x的平均值
max_langevin_fixed_point(x,r,m)
最大动态定点:数学argmax_x {h(x)= 0}`,根据多项式h(x)估计
maximum(x)
计算时间序列x的最高值
mean(x)
ar_coefficient(x, param)
此特征计算器符合自回归AR(k)过程的无条件最大似然
augmented_dickey_fuller(x, param)
Augmented Dickey-Fuller测试是一种假设检验,用于检查时间序列样本中是否存在单位根
autocorrelation(x, lag)
如果时间序列中的所有值仅出现一次,则返回1,否则低于1
sample_entropy(x)
计算并返回x的样本熵
set_property(key, value)
此方法返回一个修饰符,用于将函数的属性键设置为value
skewness(x)
返回x的样本偏度(使用调整后的Fisher-Pearson标准化力矩系数G1计算)
计算x的q分位数
range_count(x,min,max)
计算区间[min,max]内的观测值
时间序列特征提取
时间序列特征提取
时间序列特征提取是在数据挖掘、机器学习和人工智能领域中发挥着越来越重要的作用的一种技术。
它的主要目的是生成有关时间序列的信息,并将其用于处理特定任务。
从最基本的角度看,时间序列特征提取指的是根据时间序列的模式、频率和其他变化特性,生成全部或部分适应性特征以支持预测、识别、分类任务等。
时间序列特征提取能够将定量数据(如测量中的数据变化)转换为定性特征,以便识别模式、频率、趋势等特征。
时间序列特征提取可以分为两个步骤:预处理步骤和特征提取步骤。
预处理步骤负责将原始数据预处理为结构化数据。
一旦数据被预处理过,就可以开始特征提取步骤,该步骤涉及对原始数据进行统计分析,以挖掘可能存在的重要特征,并将其转换为结构化的表示,以便进一步的处理。
除非经过特殊识别,否则时间序列中的特征提取不能用于其他任务。
它是一种不可转换的过程,其目的是在特定的任务中识别和挖掘时间序列的变化特性,以便充分利用其信息,以帮助解决相关问题。
例如,对于控制过程,时间序列特征提取可能会挖掘平稳(如平均值、标准差)、季节性变化(如季节性变量)、波动性(如脉冲噪声)等重要变化特性;而在机器学习任务中,该技术可用于分析时间序列数据,以提取重要统计特征,如相关系数、极大值、极小值等,以识别和预测模式。
因此,时间序列特征提取可以被认为是在信号处理、机器学习和模式识别等应用中不可或缺的一项技术,它可以挖掘时间序列数据中有用信息,用于识别或预测特定模式或变化特性。
不仅如此,时间序列特征提取还可以节省时间和成本,因为它减少了人们识别特定变化的工作量,使任务的完成更加有效快捷。
时间序列数据的特征提取方法及在预测中的应用
时间序列数据的特征提取方法及在预测中的应用时间序列数据是指按照时间顺序排列的数据集合,它在许多领域中都有着广泛的应用,例如金融、气象、交通等。
对于时间序列数据的分析和预测,特征提取是一个非常重要的步骤。
本文将介绍一些常用的时间序列数据特征提取方法,并探讨它们在预测中的应用。
一、时间序列数据的特征提取方法1.统计特征统计特征是最常用的时间序列数据特征提取方法之一。
它包括平均值、方差、最大值、最小值等。
通过计算这些统计特征,可以获取时间序列数据的一些基本信息,例如数据的集中趋势、离散程度等。
2.频域特征频域特征是将时间序列数据转换到频域进行分析的方法。
其中,最常用的是傅里叶变换。
通过傅里叶变换,可以将时间序列数据转换为频谱图,进而提取频域特征。
例如,可以提取频域上的主要频率成分、频率分布等。
3.时域特征时域特征是直接在时间域上对时间序列数据进行分析的方法。
其中,最常用的是自相关函数和自回归模型。
自相关函数可以用来描述时间序列数据之间的相关性,而自回归模型则可以用来预测未来的数值。
通过提取时域特征,可以获取时间序列数据的长期趋势、周期性等信息。
4.小波变换小波变换是一种将时间序列数据分解为不同频率成分的方法。
通过小波变换,可以将时间序列数据分解为低频和高频成分,进而提取不同频率上的特征。
例如,可以提取高频成分上的噪声、低频成分上的趋势等。
二、时间序列数据特征提取方法在预测中的应用时间序列数据特征提取方法在预测中有着广泛的应用。
以下是一些常见的应用场景:1.金融预测时间序列数据在金融领域中有着广泛的应用。
例如,股票价格预测是一个重要的金融预测问题。
通过提取时间序列数据的统计特征、频域特征和时域特征,可以建立预测模型,对股票价格进行预测。
2.气象预测气象数据是一种典型的时间序列数据。
通过提取气象数据的统计特征和时域特征,可以建立气象预测模型,对未来的气象情况进行预测。
例如,可以预测未来一周的温度、降雨量等。
时间序列特征工程与特征提取
时间序列特征工程与特征提取时间序列数据是指按照时间顺序排列的数据,其中时间是数据的一个重要属性。
在许多领域中,如金融、气象、交通等,时间序列数据的应用非常广泛。
对时间序列数据进行特征工程和特征提取,可以有效地提取数据中的有用信息,为后续的建模和分析提供支持。
特征工程是指从原始数据中提取、构造和选择有助于机器学习模型性能提升的特征的过程。
在时间序列数据中,特征工程的目标是从时间维度和数值维度提取有意义的特征,以便更好地描述数据的变化规律和趋势。
一种常见的时间序列特征是统计特征,包括均值、方差、最大值、最小值等。
这些特征可以反映数据的整体分布情况和波动程度。
另外,还可以利用滑动窗口的方式计算移动平均值和移动标准差,以捕捉数据的趋势和周期性。
另一种常见的时间序列特征是周期特征,用于描述数据中的周期性变化。
常见的周期特征包括傅里叶变换、自相关函数、周期图等。
傅里叶变换可以将数据从时域转换到频域,得到频谱分布,从而可以分析数据中的主要周期分量。
自相关函数可以衡量数据在不同时间点上的相关性,从而可以发现数据中的周期性模式。
周期图可以将数据在频域上的周期性分布可视化,便于观察和分析。
还可以利用时间序列的滞后特征进行特征工程。
滞后特征是指当前时刻的数据与过去若干时刻的数据之间的关系。
常见的滞后特征包括一阶差分、二阶差分、滞后平均值等。
一阶差分可以反映数据的一阶趋势,二阶差分可以反映数据的二阶趋势,滞后平均值可以反映数据与过去若干时刻的关联程度。
特征提取是指从原始时间序列数据中提取有意义的特征的过程。
特征提取的目标是通过对时间序列数据的变换和处理,得到更加简洁、有代表性的特征表示。
常见的特征提取方法包括小波变换、奇异值分解、主成分分析等。
小波变换是一种将时间序列数据从时域转换到时频域的方法。
通过小波变换,可以将时间序列数据分解成一系列具有不同频率和幅度的小波系数,从而可以提取数据的频域特征。
奇异值分解是一种将时间序列数据分解成奇异值和奇异向量的方法。
时间序列数据的特征提取
时间序列数据的特征提取时间序列数据的特征提取当你想对时间序列数据做分类时,有两种选择,一个是用时间序列特定的方法,比如说说LSTM模型。
另外一种方法就是来从时间序列中提取特征从而将这些特征用在有监督的模型上。
在这篇文章中,我们来看下如何使用tsfresh包自动的提取时间序列数据。
这份数据的来源是TimeSeriesClassificationRepository。
这个网站中提供对很多数据集有高精度的模型,如何有兴趣的,可以去详细了解一下。
时间序列比一般标准的目标要难一些,这是因为在时间序列里的数据本身每个样本就不是独立的,两个时间上月接近的样本,就越有相关性。
比如说温度,如果今天的温度问20度,那明天更加有可能是15或者25度,而不是5或者35度。
这表明这我们不能用常见的分类器来拟合数据,因为对于普通的分类器来说,数据的假设前提都是需要是样本和样本是独立的。
并且更重要的是,有的和时间相关的数据集有更加复杂的结构,一个样本包含了多个特征,比如说温度,湿度,分速等等。
虽然说时间序列的数据很特别,但是我们可以使用特征提起的方法将一个序列降低到一个点。
比如说,如果我们现在是在对一个月内的天气相关的数据做处理,我们可以使用以下多个特征最小最大温度温度平均值温度方差最小最大湿度这里只是给出了几个例子而已,当然了这里可以有很多种特征,将他们全部列举出来会特别麻烦,幸运的是,有一个tsfresh包,可以自动的提取出很多特征。
tsfresh包在提取出的众多的特征中,需要选取其中最为相关的,最具有预测能力的特征。
并且为了防止过拟合,需要首先对数据集做切分,并且只对训练集做特征选择,否则会造成过拟合的问题。
tsfresh包使用的是成对检验法来做特征选择的。
我们先来从数据列表列提取3个时间序列数据集,FordA,FordB,和Wafre.并且这些数据集中提取特征。
首先我们需要将这些1维的数据给上下拼接起来。
In[9]:d.head()Out[9]:012301.014301.01431.014301.014301-0.88485-1.0375-0.97771-1.0169020.580400.58040.597770.597773-0.88390-1.0371-0.97998-1.0121041.105001.28561.196301.25610需要使用stack做一次拼接d=d.stack()d.index.rename([''id'',''time''],inplace=True)d=d.reset_index()得出以下的结果In[11]:d.head()Out[11]:idtime00001.01431011.01432021.01433031.01434041.0143特征提取的工作量是非常大的,所以tsfresh使用分布计算的方法来高效的做特征提取。