
图的几种存储结构比较分析..
比较顺序存储结构和链式存储结构

1、试比较顺序存储结构和链式存储结构的优缺点;在什么情况下用顺序表比链表好答:① 顺序存储时,相邻数据元素的存放地址也相邻逻辑与物理统一;要求内存中可用存储单元的地址必须是连续的;优点:存储密度大=1,存储空间利用率高;缺点:插入或删除元素时不方便;②链式存储时,相邻数据元素可随意存放,但所占存储空间分两部分,一部分存放结点值,另一部分存放表示结点间关系的指针优点:插入或删除元素时很方便,使用灵活;缺点:存储密度小<1,存储空间利用率低;顺序表适宜于做查找这样的静态操作;链表宜于做插入、删除这样的动态操作;若线性表的长度变化不大,且其主要操作是查找,则采用顺序表;若线性表的长度变化较大,且其主要操作是插入、删除操作,则采用链表;顺序表与链表的比较基于空间的比较存储分配的方式顺序表的存储空间是静态分配的链表的存储空间是动态分配的存储密度 = 结点数据本身所占的存储量/结点结构所占的存储总量顺序表的存储密度 = 1链表的存储密度 < 1基于时间的比较存取方式顺序表可以随机存取,也可以顺序存取链表是顺序存取的插入/删除时移动元素个数顺序表平均需要移动近一半元素链表不需要移动元素,只需要修改指针顺序表和链表的比较顺序表和链表各有短长;在实际应用中究竟选用哪一种存储结构呢这要根据具体问题的要求和性质来决定;通常有以下几方面的考虑:┌───┬───────────────┬───────────────┐│ │ 顺序表│链表│├─┬─┼───────────────┼───────────────┤│基│分│静态分配;程序执行之前必须明确│动态分配只要内存空间尚有空闲,││于│配│规定存储规模;若线性表长度n变│就不会产生溢出;因此,当线性表││空│方│化较大,则存储规模难于预先确定│的长度变化较大,难以估计其存储││间│式│估计过大将造成空间浪费,估计太│规模时,以采用动态链表作为存储││考│ │小又将使空间溢出机会增多; │结构为好; ││虑├─┼───────────────┼───────────────┤││存│为1;当线性表的长度变化不大, │<1 │││储│易于事先确定其大小时,为了节约││││密│存储空间,宜采用顺序表作为存储││││度│结构; ││├─┼─┼───────────────┼───────────────┤│基│存│随机存取结构,对表中任一结点都│顺序存取结构,链表中的结点,需││于│取│可在O1时间内直接取得│从头指针起顺着链扫描才能取得;││时│方│线性表的操作主要是进行查找,很│││间│法│少做插入和删除操作时,采用顺序│││考││表做存储结构为宜; │││虑├─┼───────────────┼───────────────┤││插│在顺序表中进行插入和删除,平均│在链表中的任何位置上进行插入和│││入│要移动表中近一半的结点,尤其是│删除,都只需要修改指针;对于频│││删│当每个结点的信息量较大时,移动│繁进行插入和删除的线性表,宜采│││除│结点的时间开销就相当可观; │用链表做存储结构;若表的插入和││ │操│ │删除主要发生在表的首尾两端,则││ │作│ │采用尾指针表示的单循环链表为宜│为什么在单循环链表中设置尾指针比设置头指针更好答:尾指针是指向终端结点的指针,用它来表示单循环链表可以使得查找链表的开始结点和终端结点都很方便,设一带头结点的单循环链表,其尾指针为rear,则开始结点和终端结点的位置分别是rear->next->next 和 rear, 查找时间都是O1; 若用头指针来表示该链表,则查找终端结点的时间为On;在链表中设置头结点有什么好处头结点即在链表的首元结点之前附设的一个结点,该结点的数据域可以为空,也可存放表长度等附加信息,其作用是为了对链表进行操作时,可以对空表、非空表的情况以及对首元结点进行统一处理,编程更方便;。
路网分析算法的优化
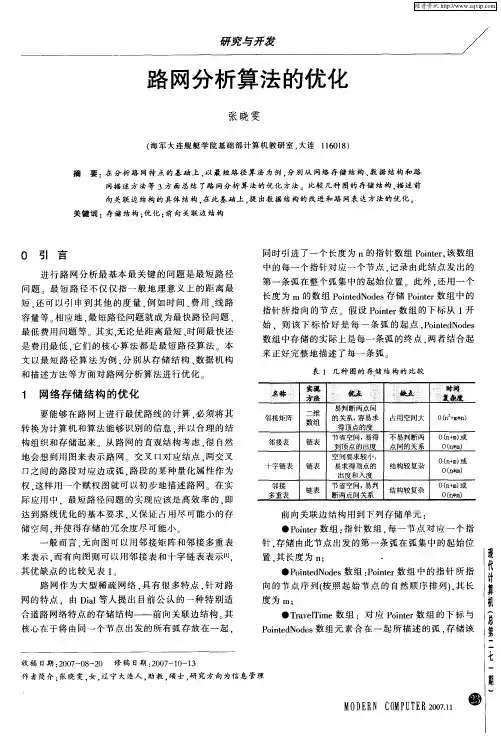
网描 述方 法等 3方面 总结 了路 网分析 算法 的优化 方法 。比较 几种 图的存储 结构 , 述前 描 向 关联 边 结构 的具体 结构 . 此基础 上 . 出数据 结构的 改进和 路 网表 达 方法的优 化。 在 提
关 键 词 :存 储 结 构 ; 化 ; 向 关 联 边 结 构 优 前
O 引 言
进行 路 网分 析最 基 本最 关键 的 问题是 最 短路 径
问 题 最 短 路 径 不 仅 仅 指 一 般 地 理 意 义 上 的 距 离 最
同时引进 了一个长度 为 n的 指针数 组 P itr该数组 one.
中 的 每 一 个 指 针 对 应 一 个 节 点 . 录 由 此 结 点 发 出 的 记 第 一 条 弧 在 整 个 弧 集 中 的 起 始 位 置 此 外 . 用 一 个 还
维普资讯
路 网分 析算 法 的优化
张 晓 雯
( 军大 连舰艇学 院基 础部计 算机教 研室 , 连 海 大 l6 1 ) 10 8
摘
要 :在 分 析 路 网 特 点 的 基 础 上 , 最 短 路 径 算 法 为 例 , 别 从 网 络 存 储 结 构 、 据 结 构 和 路 以 分 数
总
二
收 稿 日期 :0 7 8 2 修 稿 日期 :0 7 0 3 2 0 -0 — 0 2 0 —1 —1
- I
七
作 者 简 介 : 晓 雯 , , 宁 大 连 人 , 教 , 士 , 究 方 向 为信 息 管 理 张 女 辽 助 硕 研
期
M DR 0EN u E T R2 l
二维 易判断两点间 邻接矩阵 数组 的关系, 容易求 得顶 点的度 邻接表 链表 节 省空间, 易得 到顶点的出度 空间要求较 小, 十字链表 链表 易求得顶点的 出度和入度 邻接 多重表
表示逻辑关系的存储结构4种方式

表示逻辑关系的存储结构4种方式逻辑关系是人类思维的基础,也是计算机科学的重要研究领域之一。
在计算机科学中,表示逻辑关系的存储结构是一种重要的技术手段,它可以帮助我们把逻辑关系转化为计算机可以处理的形式,从而实现各种应用。
本文将介绍表示逻辑关系的存储结构4种方式,分别是关系模型、图模型、树模型和网络模型。
一、关系模型关系模型是表示逻辑关系的一种常用模型,它是一种通过表格形式来表示逻辑关系的方法。
在关系模型中,逻辑关系被视为一个表格,其中每一行代表一个实例,每一列代表一个属性。
例如,我们可以用一个关系模型来表示学生的信息,其中每一行代表一个学生,每一列代表学生的姓名、性别、年龄、成绩等属性。
关系模型的优点是易于理解和使用,而且可以方便地进行查询和修改。
缺点是不够灵活,不能很好地表示复杂的逻辑关系。
二、图模型图模型是另一种常用的表示逻辑关系的模型,它是一种用图形来表示逻辑关系的方法。
在图模型中,逻辑关系被视为一张图,其中每个节点代表一个实例,每个边代表实例之间的关系。
例如,我们可以用一个图模型来表示社交网络中的用户和他们之间的关系。
图模型的优点是可以很好地表示复杂的逻辑关系,而且可以方便地进行遍历和搜索。
缺点是不够直观,需要一定的图论知识才能理解和使用。
三、树模型树模型是一种特殊的图模型,它是一种用树形结构来表示逻辑关系的方法。
在树模型中,逻辑关系被视为一棵树,其中根节点代表一个实例,子节点代表与该实例有关系的其他实例。
例如,我们可以用一个树模型来表示组织结构中的部门和员工之间的关系。
树模型的优点是易于理解和使用,而且可以很好地表示层次结构的逻辑关系。
缺点是不能很好地表示非层次结构的逻辑关系。
四、网络模型网络模型是一种比较复杂的表示逻辑关系的模型,它是一种用图形和表格相结合的方式来表示逻辑关系的方法。
在网络模型中,逻辑关系被视为一张网,其中节点和边都可以有属性,节点和边之间的关系可以是多对多的。
例如,我们可以用一个网络模型来表示学术界中的作者、论文和会议之间的关系。
一种改进的图存储结构的实现及性能分析
其 中 ,V x x ={ ∈某 个 数 据 元 素集 合 )
E {x Y 或<, >x Y ) = (, ) x y J, ∈V
图的经典存储结构中,顶点 V 常采用顺序表或单链表 通 存储 , E则往往采用邻接矩 阵或邻接链表 。 边 分析不难发现 , 用 线性表 存储 图的边和用 邻接 矩阵或 邻接链 表存储 边 的信 息,都有不尽人意之处 : ( ) 点操作效率低 。 1顶 顶点的操作主要表 现为存取和插
ACHI EVEM ENT AND PERFoI ANCE ANALYS S 0F AN M PRoVED I I S ToRAGE S TRUCTURE OF GRAPH
Ab t c : ay i g t e c s cs r g t c u e o rp , r p sd a me h d t a o i ai n o i lsa d Hah tbe o i r v s a t An lzn l s t a es u t r fg a h p o o e t o h t mbn t fTr e n s lst mp o e r h ai o r c o p a
【 摘
要 】文章分析 了图的经典存储 结构,提 出了一种利 用三元组和哈希表结合的方法来改进 图的存储 结构 。通过算 法性
能分析和 比较 ,得 出用三元组和哈 希表 结合存储 的图结构 能够有效 的提 高图的存储结构的存储 效率的结论 。 【 关键词 】数据结构 ;图;三元组 ;哈 希表
【 中图分类号 】T 1 1 P 8 【 文献标识码 】A 【 文章编号 】1 0 — 1 1 2 1 )5 0 0 — 2 0 8 15 (0 2 0 — 0 6 0
e c v l r v eso a ee f in y o s r g l c r fg a h  ̄ u eyi mp o et t r g f c e c f t a es - t eo rp . h i o tu  ̄ Ke o d : aa s u t r ; r p ; i ls; s b e y W r s d t r cu e g a h Tr e Ha h t l t p a
BMP图像结构分析.doc

分析未知文件数据结构格式时需要熟悉不同文件类型的一种或多种该类公开文件的数据存储格式,因为通常情况下未知文件数据结构格式很可能是在公开的文件格式上建立起来的,或只稍微修改了一些地方。
编程人员一般不会自己发明一种文件格式,因为编程人员大多数都很"懒",他们通常的做法是参考一些公开文件的格式,稍微修改一下。
例如,如果要分析的未知文件格式是属于图像类的,那么这个未知的图像文件格式必定与BMP文件格式有相似的地方。
熟悉BMP格式对研究和分析这个未知的图像文件格式有极大的帮助,如果掌握了BMP图像文件存储格式就可以利用BMP格式去匹配和猜测未知图像文件格式。
例如,如要分析的未知文件格式是属于3D模型的,那么这个未知的3D模型文件格式必定与3DS和X文件格式有相似的地方,所以研究未知的3D模型文件前需要先参考和学习一些常见的公开格式的模型文件,这与解密某个加密算法之前需要研究一些公开的加密算法是同一个道理。
因为本书是针对游戏资源文件解密,所以下面将要介绍和分析游戏资源文件的常用文件存储格式。
游戏资源文件大体上可以归到多媒体数据格式上,学习和研究这些多媒体文件格式对日后分析未知的游戏资源文件格式有很大帮助。
通过本章的学习读者可以掌握以下内容:BMP图像文件格式;PNG图像文件格式;X模型文件格式;md3模型文件格式。
5.1 BMP图像文件格式BMP图像文件格式是游戏中常用的图像资源文件格式,BMP图像文件起源早,程序员对BMP都比较熟悉,再加上BMP格式简单,读取和写入非常容易实现,所以无论Windows 的还是Driect X,都有支持读取和写入BMP文件格式的API函数。
针对BMP压缩的算法比较成熟,压缩效果也不差,而且都是无损压缩编码,即可以100%还原BMP图像质量。
虽然JPG格式压缩效果比较理想,但游戏编程人员一般极少使用,因为JPG要牺牲图像的质量来换取大的压缩率,加上JPG解码速度较慢和格式复杂,所以游戏中使用JPG格式的图像的情况不多(笔者目前只发现一款网络游戏使用JPG格式作为游戏里的图像格式,并且使用额外的数据保存了图像中的透明通道信息来让JPG支持透明色)。
数据结构的四种基本逻辑结构
数据结构的四种基本逻辑结构数据结构是计算机科学中非常重要的一个概念,它是数据的组织、存储和管理的一种方式。
根据数据元素之间的关系,数据结构可以分为四种基本逻辑结构,包括线性结构、树形结构、图结构和集合结构。
下面将逐一介绍这四种基本逻辑结构。
一、线性结构:线性结构是最简单、最常见的数据结构之一,它的特点是数据元素之间存在一对一的关系。
线性结构有两种存储方式,分别是顺序存储和链式存储。
1. 顺序存储:顺序存储是将数据元素存储在一段连续的内存空间中,通过元素之间的物理位置来表示其之间的逻辑关系。
顺序存储的优点是访问速度快,缺点是插入和删除操作需要移动大量元素。
常见的线性结构有数组和字符串。
2. 链式存储:链式存储是通过指针将数据元素连接起来的存储方式,不要求元素在存储空间中的位置相邻。
链式存储的优点是插入和删除操作简单高效,缺点是访问速度相对较慢。
常见的线性结构有链表和栈。
二、树形结构:树形结构是一种层次化的数据结构,它的特点是每个节点可以有多个子节点,但每个节点只有一个父节点。
树形结构有很多种不同的实现方式,常见的有二叉树、平衡二叉树、B树等。
1. 二叉树:二叉树是树形结构中最基本的形式,每个节点最多只能有两个子节点。
二叉树可以为空树,也可以是非空的,非空二叉树又分为满二叉树、完全二叉树和搜索二叉树等。
二叉树的应用非常广泛,例如在排序、查找、哈夫曼编码等领域都有重要的作用。
2. 平衡二叉树:平衡二叉树是一种特殊的二叉查找树,它的左右子树的高度差不超过1。
平衡二叉树的设计可以有效提高查找和插入操作的效率,最常见的平衡二叉树就是AVL树。
3. B树:B树是一种多路搜索树,它的结构可以在节点中存储更多的关键字,从而减少树的层数,提高查找效率。
B树被广泛应用于数据库和文件系统等领域,例如MySQL的索引就是采用了B树的结构。
三、图结构:图结构由顶点(节点)和边(连接顶点的线段)组成,它的特点是顶点之间可以有多个连接关系。
计算机中图的名词解释
计算机中图的名词解释在计算机领域中,图(Graph)是一种常见的数据结构,用于描述对象之间的关系和相互作用。
图的概念最早由数学家欧拉提出,并且在计算机科学中得到广泛运用。
本文将从图的基本概念和操作开始,逐步介绍计算机中图的相关术语和应用。
1. 图的基本概念图由节点(Node)和边(Edge)组成。
节点表示对象或实体,边表示节点之间的连接关系。
图可以分为有向图(Directed Graph)和无向图(Undirected Graph)。
在有向图中,边具有方向性,表示从一个节点流向另一个节点;而在无向图中,边没有方向性,表示两个节点之间的相互关系。
2. 图的存储方式为了在计算机中表示和处理图,常见的存储方式有邻接矩阵(Adjacency Matrix)和邻接表(Adjacency List)。
邻接矩阵是一个二维数组,其中行和列表示节点,矩阵的值表示节点之间是否有边相连。
邻接表则使用链表的形式来表示节点之间的连接关系,每个节点对应一个链表,链表中存储了与该节点相连的其他节点。
3. 图的遍历图的遍历是指沿着图中的路径,依次访问所有节点的过程。
常见的图遍历算法有深度优先搜索(Depth-First Search)和广度优先搜索(Breadth-First Search)。
深度优先搜索先选择一个起始节点,沿着路径一直深入直到无法继续,然后回溯到其他未访问的节点,继续深入;而广度优先搜索则是从起始节点开始,并逐层扩展,逐层访问。
4. 最短路径算法最短路径算法用于计算两个节点之间的最短路径,即路径上边的权值之和最小。
其中,最常用的最短路径算法是狄克斯特拉算法(Dijkstra Algorithm)。
该算法通过逐步更新节点到其他节点的距离,找到起始节点到目标节点的最短路径。
5. 拓扑排序拓扑排序(Topological Sorting)是一种对有向无环图进行排序的算法。
在有向图中,如果节点 A 的边指向节点 B,那么 B 必须在 A 之后才能出现在排序结果中。
数据结构知识点全面总结—精华版
第1章绪论内容提要:◆数据结构研究的内容。
针对非数值计算的程序设计问题,研究计算机的操作对象以及它们之间的关系和操作。
数据结构涵盖的内容:◆基本概念:数据、数据元素、数据对象、数据结构、数据类型、抽象数据类型。
数据——所有能被计算机识别、存储和处理的符号的集合。
数据元素——是数据的基本单位,具有完整确定的实际意义。
数据对象——具有相同性质的数据元素的集合,是数据的一个子集。
数据结构——是相互之间存在一种或多种特定关系的数据元素的集合,表示为:Data_Structure=(D, R)数据类型——是一个值的集合和定义在该值上的一组操作的总称。
抽象数据类型——由用户定义的一个数学模型与定义在该模型上的一组操作,它由基本的数据类型构成。
◆算法的定义及五个特征。
算法——是对特定问题求解步骤的一种描述,它是指令的有限序列,是一系列输入转换为输出的计算步骤。
算法的基本特性:输入、输出、有穷性、确定性、可行性◆算法设计要求。
①正确性、②可读性、③健壮性、④效率与低存储量需求◆算法分析。
时间复杂度、空间复杂度、稳定性学习重点:◆数据结构的“三要素”:逻辑结构、物理(存储)结构及在这种结构上所定义的操作(运算)。
◆用计算语句频度来估算算法的时间复杂度。
第二章线性表内容提要:◆线性表的逻辑结构定义,对线性表定义的操作。
线性表的定义:用数据元素的有限序列表示◆线性表的存储结构:顺序存储结构和链式存储结构。
顺序存储定义:把逻辑上相邻的数据元素存储在物理上相邻的存储单元中的存储结构。
链式存储结构: 其结点在存储器中的位置是随意的,即逻辑上相邻的数据元素在物理上不一定相邻。
通过指针来实现!◆线性表的操作在两种存储结构中的实现。
数据结构的基本运算:修改、插入、删除、查找、排序1)修改——通过数组的下标便可访问某个特定元素并修改之。
核心语句:V[i]=x;顺序表修改操作的时间效率是O(1)2) 插入——在线性表的第i个位置前插入一个元素实现步骤:①将第n至第i 位的元素向后移动一个位置;②将要插入的元素写到第i个位置;③表长加1。
数据结构图
所以:对于点多边少的稀疏图来说,采用邻接表 结构使得算法在时间效 率上大大提高。
16
3/12
广度优先搜索(Breadth First Search,简称BFS ) BFS类似于树的层序遍历; 用一个数组用于标志已访问与否,还需要一个工作队列。
【例】一个无向图的BFS
8
6
CD
4
7
HG
BA
邻接多重表(Adjacency Multilist)
9
边表
• 在某些应用中,有时主要考察图中边的权值以及所依附的 两个顶点,即图的结构主要由边来表示,称为边表存储结 构。
• 边表结构采用顺序存储,用2个一维数组构成,一个存储 顶点信息,一个存储边的信息。边数组的每个元素由三部 分组成:
– 边的起点下标 – 边的终点下标 – 边的权值
1
A [i][
j]
0
如果 (vi , v j ) 或 vi , v j G的边 其它
无权图的邻接矩阵表示示例
V1
V2
V0
3
V3
4 12/15
带权图的邻接矩阵的定义
A [i][ j] wij
如果 (vi , vj ) 或 vi , v j G的边 其它
带图权的图邻的接邻矩接阵矩表阵示表示示例示[例例6.9]
1
第一部分 图的定义和术语
2
图的定义
“图” G可以表示为两个集合:G =(V, E)。每条 边是一个顶点对(v, w) E ,并且 v, w V。
通常:用 |V| 表示顶点的数量(|V| ≥ 1), 用 |E| 表示边的数量(|E| ≥ 0)。
(1) 无向图(完全有向图边数与顶点数之间的 关系) (2) 有向图(完全有向图弧数与顶点数之间的 关系) (3) 简单图:没有重边和自回路的图 (4) 邻接 (5) 路径,路径长度 (6) 无环(有向)图:没有任何回路的(有向)图 (7) 度,入度,出度 (8) 无向图的顶点连通、连通图、连通分量 (9) 有向图的顶点强连通,强连通图、连通分量
图的表示方法
图的表示方法图是一种常用的数据结构,用于描述事物之间的关系或连接。
在计算机科学和信息技术领域,图的表示方法是研究和应用的关键。
本文将介绍图的常见表示方法,并探讨它们的特点和适用场景。
1. 邻接矩阵表示法邻接矩阵是一种使用二维矩阵表示图的方式。
其中矩阵的行和列分别对应图中的顶点,而矩阵的元素表示图中顶点之间的边。
如果两个顶点之间存在边,则矩阵对应位置的元素为1,否则为0。
如果图是有权重的,则可以将权重值存储在矩阵的元素中。
邻接矩阵的优点是简单直观,易于理解和实现。
它可以快速检查两个顶点之间是否存在边,时间复杂度为O(1)。
然而,邻接矩阵的缺点是占用空间较大,特别是对于稀疏图而言,大量的0元素浪费了存储空间。
2. 邻接表表示法邻接表是一种使用链表表示图的方式。
其中每个顶点都对应一个链表,链表中存储与该顶点相邻的顶点。
如果图是有权重的,则链表节点可以包含权重值。
邻接表的优点是占用空间较小,特别适用于表示稀疏图。
它可以快速访问和遍历某个顶点相邻的顶点,时间复杂度为O(k),其中k是顶点相邻的边的数量。
然而,邻接表的缺点是不方便检查两个顶点之间是否存在边,需要遍历链表。
3. 关联矩阵表示法关联矩阵是一种使用二维矩阵表示图的方式,其中矩阵的行对应顶点,列对应边。
关联矩阵中,如果顶点与边相连,则对应位置元素为1,否则为0。
关联矩阵的优点是可以较为直观地表示图的结构和关系。
它适用于表示有向图和无向图,以及多重图。
然而,关联矩阵的缺点是占用空间较大,尤其对于有大量顶点和边的图而言。
4. 边列表表示法边列表是一种使用列表表示图的方式。
其中列表中的每个元素存储边的信息,包括起点、终点和权重等。
对于有向图,边列表包含有向边的信息。
边列表的优点是比较节省存储空间,特别适合表示稀疏图。
它便于遍历和访问边的信息,但相应地,检查两个顶点之间是否有边的操作较为耗时。
综上所述,图的表示方法有邻接矩阵、邻接表、关联矩阵和边列表等多种形式,每种方法都有自己的特点和适用场景。