
连续型分布随机数产生
1 / 3
连续型分布随机数的产生(反函数法)
一、定理:设随机变量X的分布函数为()XFx,其()XFx为严格单调的
连续函数,其反函数1()XxFy存在,则()XYFX服从(0,1)上的均匀
分布(0,1)U。
也即,若~(0,1)YU,则1()~()XXXFYFx
二、例
设~()XExp,分布函数为10()00xXexFxx
则,1~(0,1)XUeU,或若~(0,1)UU,11ln~()1XExpU
产生()Exp分布随机数的算法
(1)产生~(0,1)uU
(2)计算111lnln11xuu
x
即为()Exp分布的随机数。
如:产生10000个(14)Exp分布随机数的R程序代码为
lamda<-1/4
N<-10000
M<-c(rep(0,N))
for (k in 1:N) {
u<-runif(1)
x<--log(1-u)/lamda
M[k]<-x
}
M
hist(M)
mean(M)
var(M)
2 / 3
实验六
2
(10)
分布随机数的产生
编制程序产生10000个2(10)分布的随机数,并完成
(1)绘制该10000个随机数的直方图;
(2)求该10000个随机数的样本均值及样本方差。
2
2
222222
()(1,)1()(,)221121()(1,)(,)(2)2222(10)(2)(2)(2)(2)(2)(,)ExpGannGaExpGaGaGan
############卡方分布随机数##############
lamda<-1/2
N<-10000
M<-c(rep(0,N))
for(K in 1:N){
{n<-5
m<-c(rep(0,n))
for(k in 1:n){
u<-runif(1)
x<--log(1-u)/lamda
m[k]<-x
m1<-sum(m[1:k])
}
m1
}
M[K]<-m1
}
M
hist(M)
mean(M)
var(M)
############指数分布随机数###########
lamda<-1/2
N<-10000
3 / 3
M<-c(rep(0,N))
for(k in 1:N){
u<-runif(1)
x<--log(1-u)/lamda
m
M[k]<-x
}
M
hist(M) ### 画直方图 ###
mean(M) ### 均值 ###
var(M) ### 方差 ###
概率论与数理统计浙大四版 第二章3讲

f(x) 13, 2 x5, 0, 其他.
设 A 表示“ X 的观测值大于 3”,
即 A={ X >3 }.
由 P (A 于 ) P { X 3 }
51 dx
2,
33
3
设Y 表示3次独立观测中观测值大于3的次数,
则 因而有
Y
~
b 3,
32.
P{Y2}23322132333231320
解: F(x) = P(X x) =
x
f (t)dt
f(x)2 1x2, 1x1
0, 其它
解: 对x < -1,F(x) = 0
求 F(x).
对 1x1,
F(x)10d t x21t2dt
1
x
1x21ar
cxsi1n 2
对 x>1, F (x) = 1
即
0,
x1
F(x) x
1x21arcsx in1 2,
1, x 1
(2) 求X的概率密度.
解: (1) P(0.3<X<0.7)=F(0.7)-F(0.3)=0.72-0.32=0.4
(2)
f(x)= dF ( x ) dx
2x,
0,
0 x 1 其它
注意到F(x)在1处导数不存在,根据改变被积函数 在个别点处的值不影响积分结果的性质,可以在
F(x) 没意义的点处,任意规定 F(x)的值.
由此得, 1) 对连续型 r.v X,有
P ( a X b ) P ( a X b )
P(aXb) P(aXb)
2) 由P(X=a)=0 可推知
P (X R a ) f(x )d x P (X a ) 1 而 {X=a} 并非不可能事件 {XR{a}}并非必然事件
matlab 正态分布随机数

matlab 正态分布随机数正态分布是统计学中最为常见的连续型随机变量分布之一,也被称为高斯分布或钟形曲线。
在Matlab 中生成正态分布随机数可以使用randn 函数,该函数用于生成满足标准正态分布的随机数。
函数语法如下:r = randn(sz1,...,szN)其中,sz1,...,szN 为生成的随机数矩阵的维度大小,r 为生成的随机数矩阵。
在使用randn 函数时,我们可以使用mu 和sigma 参数来控制生成随机数的均值和标准差。
具体语法如下:r = mu + sigma.*randn(sz1,...,szN)其中,mu 为均值,sigma 为标准差。
下面我们来看一个简单的例子:%生成均值为2,标准差为0.5 的正态分布随机数矩阵mu = 2;sigma = 0.5;r = mu + sigma.*randn(1000,1);%绘制随机数的概率密度函数图像histogram(r,'Normalization','pdf');hold on;x = linspace(min(r),max(r),100);y = normpdf(x,mu,sigma);plot(x,y);hold off;运行代码后,我们可以得到一个均值为2,标准差为0.5 的正态分布随机数矩阵,并画出了随机数的概率密度函数图像,如下图所示:,以确保数据分析结果的准确性和可靠性。
正态分布的概率计算
正态分布的概率计算正态分布是统计学中最常用的分布之一,也被称为高斯分布。
在自然界和社会科学中,许多现象都服从于正态分布。
例如,身高、体重、智力、成绩等等。
正态分布具有许多优良的性质,使得其在实际应用中得到广泛的应用。
本文将介绍正态分布的概念、性质、参数估计、假设检验以及在实际问题中的应用。
正态分布的概念正态分布是一种连续型概率分布,其概率密度函数为:$$f(x)=frac{1}{sqrt{2pi}sigma}e^{-frac{(x-mu)^2}{2sigma^2}} $$其中,$mu$ 是分布的均值,$sigma$ 是分布的标准差,$pi$ 是圆周率。
正态分布的图像呈钟形曲线,以均值为对称轴,标准差越小,曲线越尖锐。
正态分布的性质1. 正态分布的均值和标准差唯一确定了整个分布。
2. 正态分布的概率密度函数在均值处取得最大值,即$f(mu)=frac{1}{sqrt{2pi}sigma}$。
3. 正态分布的标准差越大,分布的形状越平坦,标准差越小,分布的形状越尖锐。
4. 正态分布的面积为1,即 $int_{-infty}^{+infty}f(x)dx=1$。
5. 正态分布的累积分布函数可以用标准正态分布的累积分布函数来表示,即 $F(x)=Phi(frac{x-mu}{sigma})$,其中,$Phi(z)$ 表示标准正态分布的累积分布函数。
正态分布的参数估计在实际应用中,我们常常需要根据样本数据来估计正态分布的参数,即均值和标准差。
下面介绍两种参数估计方法。
1. 极大似然估计假设我们有 $n$ 个来自正态分布 $N(mu,sigma^2)$ 的独立观测值 $x_1,x_2,cdots,x_n$。
它们的联合概率密度函数为:$$L(mu,sigma^2)=prod_{i=1}^{n}frac{1}{sqrt{2pi}sigma}e^{-fr ac{(x_i-mu)^2}{2sigma^2}}$$对 $L(mu,sigma^2)$ 取对数,得到对数似然函数:$$lnL(mu,sigma^2)=-frac{n}{2}ln(2pi)-nlnsigma-sum_{i=1}^{n}frac {(x_i-mu)^2}{2sigma^2}$$极大似然估计就是找到可以最大化对数似然函数的参数值。
随机数学基础

随机数学基础引言随机数学是现代数学中的一个重要分支,它研究的是随机现象背后的数学规律。
在现代科学和工程领域,随机数学被广泛应用于概率论、统计学、密码学、模拟实验等各个领域。
本文将介绍随机数学的基础知识,包括概率论的基本概念、随机变量与概率分布、期望与方差等内容。
概率论基础概率论是随机数学的基石,它研究的是不确定性事件的数学描述和分析。
概率论的基本概念包括样本空间、事件、概率等。
样本空间与事件样本空间是指一个随机现象的所有可能结果的集合。
而事件是样本空间的子集,表示某些结果的集合。
例如,投掷一颗骰子的样本空间为{1, 2, 3, 4, 5, 6},而事件可以是“出现奇数点数的结果”。
概率概率是用于描述事件发生可能性大小的数值。
在概率论中,通过将事件与样本空间的元素对应起来,定义了概率函数。
概率函数具有以下性质: - 非负性:对于任意事件A,概率P(A)大于等于0。
- 单调性:如果事件A包含在事件B中,那么P(A)小于等于P(B)。
- 规范性:对于整个样本空间Ω,P(Ω)等于1。
- 可列可加性:对于任意可列个两两互不相容的事件Ai,它们的概率之和等于P(A1∪A2∪…)。
随机变量与概率分布随机变量是样本空间到实数域的映射,它将随机现象的结果映射为一个实数。
概率分布则是用于描述随机变量取值的概率规律的函数。
常见的概率分布包括离散型概率分布和连续型概率分布。
离散型概率分布在有限或可数个取值上存在,并且每个取值的概率都是非负的。
其中最常见的离散型概率分布是伯努利分布和二项分布。
连续型概率分布则在一个区间上存在,而每个点的概率为0。
最常见的连续型概率分布是正态分布。
期望与方差期望是随机变量取值的平均数,它描述了随机变量的中心位置。
方差则度量了随机变量取值与期望之间的差异,它描述了随机变量的离散程度。
随机数生成随机数生成是计算机科学中的一个重要问题,它研究如何生成接近真实随机数的数列。
而计算机科学中的随机数,实际上是伪随机数,通过一定的算法生成。
随机数原理
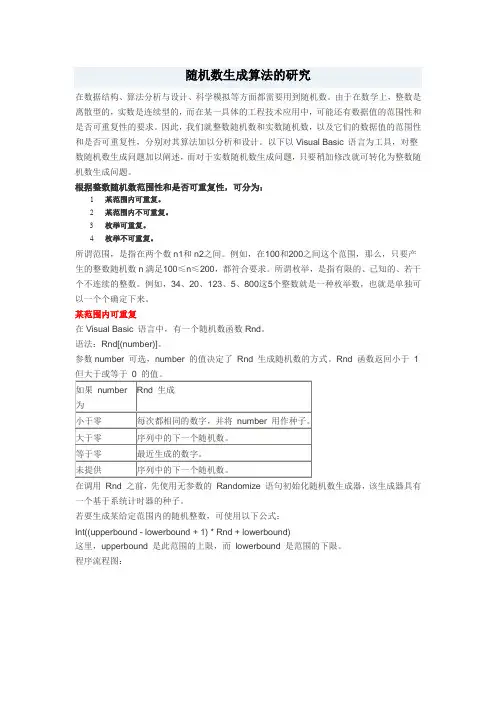
Dor = Int((upperbound - lowerbound + 1) * Rnd + lowerbound)yes = 0For j = 1 To i - 1If r = random(j) Then yes = 1: Exit ForNextLoop While yes = 1random(i) = rDebug.Print r;NextDebug.PrintEnd Sub运行结果:199 174 147 126 120 190 192 146 122 111粗看起来,上面的程序似乎没有什么问题,在执行过程中程序也能够通过。
但,仔细分析我们就会发现问题出在一个新产生的随机数是否已经存在的判定上。
既然是随机数,那么从数学的角度来说在概率上,每次产生的随机数r就有可能相同,尽管这种可能性很小,但确是一个逻辑性与正确性的问题。
因此,每次产生的新的随机数r都有可能是数组random的前i-1个数中的某一个,也就是说程序在运行过程中由此可能会导致死循环,那么,能否找到一个不在数组random中的随机数r的工作就变得不确定了。
从算法的角度来讲,在理论上,程序失去了有穷性、有效性和确定性。
什么是算法?通常人们将算法定义为一个有穷的指令集,这些指令为解决某一特定任务规定了一个运算序列。
一个算法应当具有以下特征:5输入:一个算法必须有0个或多个输入。
它们是算法开始运算前给予算法的量。
这些输入取自于特定的对象的集合。
它们可以使用输入语句由外部提供,也可以使用置初值语句或赋值语句在算法内提供。
6输出:一个算法应有1个或多个输出,输出的量是算法计算的结果。
7确定性:算法的每一步都应确切地、无歧义地定义。
对于每一种情况,需要执行的动作都应严格地、清晰地规定。
8有穷性:一个算法无论在什么情况下,都应在执行有穷步后结束。
9有效性:算法中每一条运算都必须是足够基本的。
就是说,它们原则上都能精确地执行,甚至人们只用纸和笔做有限次运算就能完成。
高中数学课件- (整数值)随机数的产生
填要点、记疑点
主目录
探要点、究所然
当堂测、查疑缺
明目标、知重点
1.了解随机数的意义. 2.会用模拟方法(包括计算器产生随机数进行模拟)估计概率. 3.理解用模拟方法估计概率的实质.
3.2.2
明目标、知重点
填要点、记疑点
主目录
探要点、究所然
当堂测、查疑缺
填要点、记疑点
3.2.2
1.随机数
要产生 1~n(n∈N*)之间的随机整数,把 n 个 大小形状
(1)选定 A1 格,键入“=RANDBETWEEN(0,9)”,按 Enter 键,则在此格中的
数是随机产生的;
(2)选定 A1 格,点击复制,然后选定要产生随机数的格,比如 A2 至 A100,点
击粘贴,则在 A2 至 A100 的数均为随机产生的 0~9 之间的数,这样我们就很
快就得到了 100 个 0~9 之间的随机数,相当于做了 100 次随机试验.
明目标、知重点
填要点、记疑点
主目录
探要点、究所然
当堂测、查疑缺
探要点、究所然
探究点一:随机数的产生
3.2.2
分析 2 能不能用古典概型求概率的公式求三天中恰有两天下雨的概率?为什么? 答 不能,因为试验结果出现不是等可能的,不能用古典概型公式,只好采取
随机模拟的方法求频率,近似看作概率.
分析 3 如果采用随机模拟的方法,如何操作?
明目标、知重点
填要点、记疑点
主目录
探要点、究所然
当堂测、查疑缺
探要点、究所然
探究点二:随机模拟方法
3.2.2
反思与感悟 整数随机数模拟试验估计概率时,首先要确定随机数的范围和用哪
些数代表不同的试验结果.我们可以从以下三方面考虑:
matlab随机数生成(全部函数)
matlab 全部的随机数函数(一)Matlab内部函数a.基本随机数Matlab中有两个最基本生成随机数的函数。
1.rand()生成(0,1)区间上均匀分布的随机变量。
基本语法:rand([M,N,P ...])生成排列成M*N*P... 多维向量的随机数。
如果只写M,则生成M*M矩阵;如果参数为[M,N]可以省略掉方括号。
一些例子:rand(5,1) %生成5个随机数排列的列向量,一般用这种格式rand(5) %生成5行5列的随机数矩阵rand([5,4]) %生成一个5行4列的随机数矩阵生成的随机数大致的分布。
x=rand(100000,1);hist(x,30);由此可以看到生成的随机数很符合均匀分布。
(视频教程会略提及hist()函数的作用) 2.randn()生成服从标准正态分布(均值为0,方差为1)的随机数。
基本语法和rand()类似。
randn([M,N,P ...])生成排列成M*N*P... 多维向量的随机数。
如果只写M,则生成M*M矩阵;如果参数为[M,N]可以省略掉方括号。
一些例子:randn(5,1) %生成5个随机数排列的列向量,一般用这种格式randn(5) %生成5行5列的随机数矩阵randn([5,4]) %生成一个5行4列的随机数矩阵生成的随机数大致的分布。
x=randn(100000,1);hist(x,50);由图可以看到生成的随机数很符合标准正态分布。
b.连续型分布随机数如果你安装了统计工具箱(Statistic Toolbox),除了这两种基本分布外,还可以用Matlab内部函数生成符合下面这些分布的随机数。
3.unifrnd()和rand()类似,这个函数生成某个区间内均匀分布的随机数。
基本语法unifrnd(a,b,[M,N,P,...])生成的随机数区间在(a,b)内,排列成M*N*P... 多维向量。
如果只写M,则生成M*M矩阵;如果参数为[M,N]可以省略掉方括号。
一维均匀分布随机数序列的产生方法
一维均匀分布随机数序列的产生方法引言:随机数序列主要应用于序列密码(流密码)。
序列密码的强度完全依赖于序列的随机性与不可预测性。
随机数在密码学中也是非常重要的,主要应用于数字签名(如美国数字签名标准中的数字签名算法)、消息认证码(如初始向量)、加密算法(如密钥)、零知识证明、身份认证(如一次性nonce)和众多的密码学协议。
关键词:随机数、随机数序列、均匀分布一、随机数及随机数序列的简介在统计学的不同技术中需要使用随机数,比如在从统计总体中抽取有代表性的样本的时候,或者在将实验动物分配到不同的试验组的过程中,或者在进行蒙特卡罗模拟法计算的时候等等。
产生随机数有多种不同的方法。
这些方法被称为随机数发生器。
随机数最重要的特性是:它所产生的后面的那个数与前面的那个数毫无关系。
随机数序列分为真随机数序列与伪随机数序列,随机数分为真随机数和伪随机数。
真随机数序列从真实世界的自然随机性源产生,办法是找出似乎是随机的事件然后从中提取随机性,如自然界中的抛币。
在计算机中噪音可以选取真实世界的自然随机性,如从计算机时钟寄存器中取得本机的当前系统时间到秒(或微秒)级的数值,测量两次击键的时间间隔,相邻两次鼠标移动的时间间隔以及由计算机硬件报告的鼠标实际位置等。
伪随机数序列用确定的算法产生,不是真正的随机数序列。
伪随机数序列发生器指使用短的真随机数序列(称为种子)x扩展成较长的伪随机数序列y。
在密码学中伪随机数序列的使用大大减少了真随机数序列的使用,但不能完全取代真随机数序列的使用(如种子)。
通常,我们需要的随机数序列应具有非退化性、周期长、相关系数小等优点。
二、一维均匀分布的简介设连续型随机变量X 的分布函数为 F(x)=(x-a)/(b-a),a ≤x≤b,则称随机变量X 服从[a,b]上的均匀分布,记为X ~U[a ,b]。
若[x1,x2]是[a,b]的任一子区间,则 P{x1≤x≤x2}=(x2-x1)/(b-a),这表明X 落在[a,b]的子区间内的概率只与子区间长度有关,而与子区间位置无关,因此X 落在[a,b]的长度相等的子区间内的可能性是相等的,所谓的均匀指的就是这种等可能性。
高中数学 第3章(整数值)随机数(random numbers)的产生配套课件 新人教版必修3
应用随机数估计古典概型的概率的步骤: 1.明确随机数的范围及数字与试验结果的对应关系; 2.产生随机数; 3.统计试验次数N及有利事件所包含的次数n; 4.计算Nn 便可.
第二十九页,共46页。
在题设条件不变的情况下,求“任取三个球,恰有两个 白球”的概率.
【解】 三个数一组(每组内数字不重复),统计总组数n
第二十六页,共46页。
【自主解答】 用1,2,3,4,5表示白球,6,7表示黑球. (1)步骤: ①利用计算器或计算机产生1到7的整数随机数,每一个 数一组,统计组数n; ②统计这n组数中小于6的组数m; ③则任取一球,得到白球的概率近似为mn .
第二十七页,共46页。
(2)步骤: ①利用计算器或计算机产生1到7的整数随机数,每三个 数一组,统计组数n; ②统计这n组数中,每个数字均小于6的组数m; ③则任取三球,都是白球的概率近似为mn .
引导学生回答所提问题,理解利用随机模拟的方法求古 典概型的概率的类型;通过例题与练习让学生掌握随机模拟 的步骤在解决问题的过程中更深入地理解随机模拟的思想和 作用,以强化重点.
第四页,共46页。
●教学建议 从教师这方面看,首先这部分内容操作性强,鉴于教学 条件及学生的差异,高效的组织教学将是一个突出的问题; 其次学生虽然已对随机事件、频率、概率的意义、古典概型 等方面都有所认识,但不可能从根本上理解随机模拟方法, 在完成操作任务的同时,还要结合一些典型案例的处理,使 学生经历较完整的数据处理的全过程,在过程中让学生体会 随机模拟的基本思想,学习数据处理的方法,把理性的认识 和实际的操作结合起来,对教师驾驭课堂、灵活应变能力提 出了较高的要求.
第三十一页,共46页。
【错因分析】 1.没有理解随机数产生范围的含义,题 目不同,取值范围也不一定相同,因题而异.
随机数的产生
均匀随机数的产生
• • 例1 取一根长度为3m的绳子,拉直后在任意位置剪断,那么剪得两段的长都 不小于1m的概率有多大? 分析:在任意位置剪断绳子,则剪断位置到一端点的距离取遍[0,3]内的任意 数,并且每一个实数被取到都是等可能的。因此在任意位置剪断绳子的所有 结果(基本事件)对应[0,3]上的均匀随机数,其中取得的[1,2]内的随机数 就表示剪断位置与端点距离在[1,2]内,也就是剪得两段长都不小于1m。这 样取得的[1,2]内的随机数个数与[0,3]内个数之比就是事件A发生的概率。 解法1:(1)利用计算器或计算机产生一组0到1区间的均匀随机数 a1=RAND. (2)经过伸缩变换,a=a1*3. (3)统计出[1,2]内随机数的个数N1和[0,3] 内随机数的个数N. (4)计算频率fn(A)=N1/N,即为概率P(A)的近似值. 解法2:做一个带有指针的圆盘,把圆周三等分,标上刻度[0,3](这里3和0 重合).转动圆盘记下指针在[1,2](表示剪断绳子位置在[1,2]范围内)的 次数N1及试验总次数N,则fn(A)=N1/N即为概率P(A)的近似值. 小结:用随机数模拟的关键是把实际问题中事件A及基本事件总体对应的区域 转化为随机数的范围。解法2用转盘产生随机数,这种方法可以亲自动手操作, 但费时费力,试验次数不可能很大;解法1用计算机产生随机数,可以产生大 量的随机数,又可以自动统计试验的结果,同时可以在短时间内多次重复试 验,可以对试验结果的随机性和规律性有更深刻的认识.
• • • • • • • • • • • • • • • • • • • • • •
【例2】天气预报说,在今后的三天中,每一天下雨的概率均为40%.这三天中恰有两天下雨的概率 大概是多少? 分析:试验的可能结果有哪些? 用“下”和“不”分别代表某天“下雨”和“不下雨”,试验的结果有 (下,下,下)、(下,下,不)、(下,不,下)、(不,下,下)、 (不,不,下)、(不,下,不)、(下,不,不)、(不,不,不) 共计8个可能结果,它们显然不是等可能的,不能用古典概型公式,只好采取随机模拟的方法求频 率,近似看作概率. 解:(1)设计概率模型 利用计算机(计算器)产生0~9之间的(整数值)随机数,约定用0、1、2、3表示下雨,4、5、6、7、8、 9表示不下雨以体现下雨的概率是40%。模拟三天的下雨情况:连续产生三个随机数为一组,作为 三天的模拟结果. (2)进行模拟试验 例如产生30组随机数,这就相当于做了30次试验. (3)统计试验结果 在这组数中,如恰有两个数在0,1,2,3中,则表示三天中恰有两天下雨,统计出这样的试验次数, 则30次统计试验中恰有两天下雨的频率f=n/30. 小结: (1)随机模拟的方法得到的仅是30次试验中恰有2天下雨的频率或概率的近似值,而不是概率.在 学过二项分布后,可以计算得到三天中恰有两天下雨的概率0.288. (2)对于满足“有限性”但不满足“等可能性”的概率问题我们可采取随机模拟方法. (3)随机函数RANDBETWEEN(a,b)产生从整数a到整数b的取整数值的随机数. 练习: 1.试设计一个用计算器或计算机模拟掷骰子的实验,估计出现一点的概率. 解析: (1).规定1表示出现1点,2表示出现2点,...,6表示出现6点. (2).用计算器或计算机产生N个1至6之间的随机数 (3).统计数字1的个数n,算出概率的近似值P=n/N