
多元数据处理——因子分析法
多元数据处理
---因子分析方法
多元数据处理主要包括多元随机变量,协方差分析,趋势面分析,聚类分析,判别分析,主成分分析,因子分析,典型相关分析,回归分析以及各个分析方法的相互结合等等。
本文主要针对其中的因子分析方法展开了论述,并举了一个因子分析法在我国房地产市场绩效评价中的应用实例。
第一章因子分析方法概述
1.1因子分析的涵义
为了更全面和准确的测量和评估对象的特征,在实际的应用中,我们往往尽可能多的选用特征指标进行系统评估,选取的指标越多,就越能全面、客观的反映评价对象的特征。
选取众多指标的同时也带来了统计分析的困难:一、不同的指标,不同重要程度需要赋予不同的权重,而靠主观的评价避免不了一些失误与错误。
二、收集到的指标之间可能存在较大的相关性,大量收集指标带来了人力、物力和财力的浪费。
而因子分析方法则较好的解决了上述问题。
因子分析[1]是一种多元统计方法,该方法起源于20世纪初Karl Pearson 和Charles Spearman 等人关于心理测试的统计分析,它的核心是用最少的相互独立的因子反映原有变量的绝大部分信息。
[2]通过分析事物内部的因果关系来找出其主要矛盾,找出事物内在的基本规律。
因子分析的基本思想是通过变量的相关系数矩阵内部结构的研究,找出能控制所有变量的少数几个随机变量去描述多个变量之间的相关关系,但是,这少数几个随机变量是不可观测的,通常称为因子。
然后根据相关性的大小把变量分组,使得同组内的变量之间相关性较高,使不同组内的变量相关性较低[3]。
对于所研究的问题就可试图用最少个数的所谓因子的线性函数与特殊因子之和来描述原来观测的每一变量[4]。
因子变量的特点:第一,因子变量的数量远小于原指标的数量,对因子变量的分析能够减少分析的工作量;第二,因子变量不是原有变量的简单取舍,而是对原有变量的
重新组构,他们能够反映原有变量的绝大部分信息,不会产生丢失;第三,因子变量之间线性相关性较低;第四,因子变量具有命名解释性[5]。
因子分析可以消除指标间的信息重叠,抽象出事物的本质属性,不仅可以综合评价,还可以综合分析对其产生影响的主要因素。
1.2因子分析统计模型
设p 个可以观测的指标为123,,,,p X X X X L ,m 个不可观测的因子为123,,,,m F F F F L ,则因子分析模型描述如下:[6] [7]
111112211
221122222
1122m m m m p p p pm m p
X a F a F a F X a F a F a F X a F a F a F m p εεε=++++=++++=++++<L L L L
L
其中:m<p
12(,,)m F F F F =L 是不可测的向量,我们把F 称为X 的公共因子,其均值向量 E (F )=0,协方差矩阵Cov (F )=1,即向量的各分量是相互独立的12(,,,)p εεεεL 是特殊因子,与F 相互独立,且E (e )=0。
()ij A a =,ij a 为因子载荷,数学上可以证明,因子载荷ij a 就是第 i 指标与第 j 因子的相关系数,载荷越大,说明第j 个指标与第i 个因子的关系越密切;反之载荷越小,关系越疏远[8]。
1.3因子分析步骤
(1)原始数据的标准化
原始数据的标准化包括指标正向化合和无量纲化处理两方面。
在多指标的评价中,有些指标数值越大,评价越好;有些指标数值越小,评价越好,这种指标称为逆向指标;还有些指标数值越靠近某个具体数值越好,这种指标称为适度指标。
根据不同类型的指标需要将逆向指标、适度指标转化为正向指标,此过程称为指标的正向化。
指标正向化过程既可以在无量纲化前处理也可以在无量纲化时处理。
逆向指标可以选用公式'
max max min ()/()i i X X X X X =--。
其中,max X 、min X 分别为指标的最大与最小
值。
适度指标方面,叶宗裕[9]认为正向化可以采用指标值减去适度值的绝对值的相反数。
公式为||xy xy Y X M =--。
其中xy Y 为正向后数据,xy X 为原始数据,M 为适度值。
指标的无量纲化则是通过标准化处理,将不同的指标通过数学变换转化为统一的相对值,消除各个指标不同量纲的影响。
常用的无量纲化包括:标准化法、均值法和极差正规化法。
本文采用最常见的标准化法进行无量纲化处理,公式处理如下:(X 是X 的期望值,
X σ是 X 的标准差)
(2)计算相关矩阵 R 的特征值和特征向量
根据特征方程||0R E λ-=,计算相关相关矩阵的特征值λ及对应的特征向量A ,λ的大小描述了各个因子在解释对象所起的作用的大小。
(3)计算因子贡献率及累积贡献率,确定公共因子个数
因子贡献率表示每个因子的变异程度占所有因子变异程度的比率,公式为:
,i C 表示方差贡献率。
当累积贡献率达到85%以上或者特征根λ不小于1,即确定了
公因子的个数。
(4)求解初始因子载荷矩阵
X=AF ,因子载荷矩阵A 并不唯一,软件则是运用不同的参数估计方法求出相应的估计矩阵,参数估计方法主要包括:最小平方法、极大似然法、主成分法、主因子法、多元回归法。
(5)因子载荷矩阵的旋转
若因子载荷较为平均,初始的因子载荷矩阵描述的经济含义不太明显,难以判断与各个因子的关系时,就需要进行因子旋转。
通过因子旋转,使使旋转后公共因子的贡献更加分散,并对主因子进行命名,确定经济含义[10]。
因子旋转主要有正交旋转法和斜交旋转法。
(6)计算样本的综合得分
通过因子载荷矩阵,可以得出因子的因子得分系数矩阵 B 。
然后计算出每个因子的得分F=BZ ,最后以各因子的方差贡献率占因子总方差的贡献率的比重作为权重加权汇总,得到应变综合得分
1212111m m m m m i i i i i i F F F F λλλλ
λλ====+++∑∑∑L 1i P i i
i C λλ
==∑X
X X
Z σ-=。
多元统计分析因子分析

多元统计分析因子分析多元统计分析是一种综合应用统计学和数学的方法,旨在分析多个变量之间的关系以及它们对其中一或多个隐含变量的影响。
其中,因子分析是多元统计分析中的一种方法,用于识别和解释观测数据中潜在的因子结构。
本文将介绍多元统计分析和因子分析的基本概念、原理和应用。
多元统计分析的基本概念主要包括变量、变量间的关系以及隐含变量。
变量是观测数据中的各个测量指标,可以是定量变量或定性变量。
变量间的关系描述了不同变量之间可能存在的相关性、相互作用关系或影响关系。
隐含变量是观测数据中未直接测量到但对所研究现象具有重要影响的一种潜在因素。
因子分析是一种常用的多元统计分析方法,其原理基于变量内部存在共同的变异性。
该方法尝试将观测数据中的变量通过线性组合转化为较少数量的潜在因子,以解释变量间的共同变异性。
因子分析可以分为探索性因子分析和确认性因子分析两种类型。
探索性因子分析旨在发现潜在因子的结构,确定因子的数目和变量的载荷;而确认性因子分析则是根据先前的理论和假设,验证数据是否符合所设定的因子结构。
因子分析的应用十分广泛。
在社会科学研究中,因子分析可以用于构建问卷调查中的量表,进一步检验其信度和效度。
在经济学领域,因子分析可以用于分析股票市场的主要因子,帮助投资者理解市场波动并制定投资策略。
在教育评价中,因子分析可以用于确定考试的难度、区分度和信度。
此外,因子分析还可以在医学研究中用于测量疾病的风险因素和干预效果。
在进行因子分析时,需要进行一系列的数据预处理步骤。
首先,需要检查数据的完整性,并根据需要进行数据清洗。
然后,可以进行因素提取,即确定因子的数目和每个变量在因子上的载荷。
最后,可以进行因子旋转,以使得因子的解释更为直观。
常用的因子旋转方法有正交旋转和斜交旋转两种类型。
正交旋转方法(如Varimax旋转)试图使得因子之间相互独立;而斜交旋转方法(如Oblimin旋转)允许因子之间存在一定的相关性。
总之,多元统计分析和因子分析提供了一种强大的工具,用于探索和解释多个变量之间的关系。
因子分析法详细步骤

因子分析法详细步骤因子分析是一种常用的多元统计分析方法,用于探索多个变量之间的潜在关系。
它通过将多个变量通过线性组合提取出共同的因子,从而减少变量的维度,并帮助我们理解变量之间的结构。
下面详细介绍了因子分析的步骤。
步骤一:确定研究的目的和研究对象在进行因子分析之前,我们需要明确研究的目的和研究对象。
例如,我们可能希望了解一组问卷测量的心理健康变量之间的结构关系。
步骤二:收集数据收集数据是因子分析的基础。
我们需要选择合适的问卷或量表,并向目标群体发放,以获取相关数据。
通常,我们会收集多个变量之间的相关数据。
步骤三:数据预处理在进行因子分析之前,我们需要对数据进行预处理。
这包括检查数据的缺失值、异常值和离群值,并进行处理。
还需要对变量进行标准化处理,以确保不同变量之间的度量单位一致。
步骤四:选择因子提取方法选择合适的因子提取方法是因子分析的核心。
常用的因子提取方法包括主成分分析(PCA)、最大似然估计和广义最小方差(GLS)等。
不同的方法对于数据的处理和解释有不同的要求和假设。
步骤五:因子提取在此步骤中,我们将应用所选择的因子提取方法,从数据中提取潜在的因子。
提取的因子是原始变量的线性组合,它们能够解释原始变量中的共同变异性。
通常,我们会根据一些准则(如特征值大于1)决定提取几个因子。
步骤六:因子旋转在因子提取之后,我们需要对提取的因子进行旋转,以使因子具有更好的解释性。
常用的旋转方法有方差最大化旋转(Varimax)、极大似然法(Promax)等。
旋转可以使因子在因子载荷矩阵中具有更清晰的结构,以便于解释。
步骤七:因子解释和命名在旋转之后,我们需要解释每个因子的含义,并为每个因子取一个能够反映其内涵的名称。
这需要我们仔细分析因子载荷矩阵,观察变量与因子之间的关系,然后进行命名。
步骤八:因子得分计算在因子分析的最后,我们可以计算每个观测值对于每个因子的得分。
这些得分可以用于进一步的数据分析或其他研究目的。
因子分析法详细步骤
因子分析法详细步骤1.研究设计:-确定研究目的和问题,并确定应用因子分析的数据集。
-确定所需要的变量类型和测量方式。
2.数据收集:-确定数据收集方式和样本大小。
-通过合适的数据收集工具,收集相关变量的数据。
3.数据预处理:-检查数据质量,包括数据完整性、异常值、缺失值等。
-进行数据清洗,如删除无关变量、处理异常值、填充缺失值等。
4.相关性分析:-对每个变量计算相关系数矩阵,用于评估变量之间的相关性。
-检查相关系数矩阵的变量之间的线性关系。
5.适度性检验:- 对数据进行测试适用性检验,可以使用统计方法如列总和测验、Bartlett检验等。
-如果样本适应性检验通过,则可以进行因子分析;否则需要重新考虑数据或模型。
6.因子提取:-使用适当的因子提取方法,如主成分分析、极大似然估计等,将多个变量转化为少数几个无关的因子。
-利用特征值、特征向量、共同度等指标,确定需要提取的因子数量。
7.因子旋转:-在因子提取后,进行因子旋转,以获得更简单的解释和解释性。
- 常用的因子旋转方法包括正交旋转(如Varimax旋转)和斜交旋转(如Oblique旋转)。
8.因子解释:-根据因子载荷、因子结构矩阵等指标,解释每个因子代表的含义和解释率。
-确定每个因子代表的潜在变量特征。
9.因子命名:-为每个因子命名,以便更好地理解和解释。
-命名应根据因子载荷权重和因子在数据集中的重要性进行。
10.因子得分:-使用因子分析结果,计算每个个体在各个因子上的得分。
-这可以帮助理解每个个体在不同潜在变量特征上的表现。
11.结果解释:-基于因子载荷、因子得分、因子解释,解释结果并得出结论。
-分析因子对原始变量的解释能力和解释率,判断因子分析是否有效。
12.结果验证:-使用因子分析结果进行验证,可基于交叉验证、重复抽样等方法。
-检验因子分析的结果是否稳定和可靠。
13.结果报告:-撰写因子分析报告,包括研究目的、方法描述、结果解释、结论等内容。
多元数据分析方法及其应用

多元数据分析方法及其应用随着数据技术的飞速发展,数据分析成为了企业决策和业务发展的基石。
数据分析技术的多元化不仅丰富了数据分析手段,同时也让数据分析更易于实现深入的数据挖掘和分析。
本文将介绍一些多元数据分析方法以及它们在不同场景下的应用。
一、主成分分析(PCA)主成分分析(PCA)是一种最基本的多元数据分析方法,常被用来降维。
PCA将原有的多元数据通过线性变换的方式,将其转化为一组新的维度(也即“主成分”),其中每个主成分都与原数据中的变量密切相关。
这使得数据的分析和处理更加直观和简便。
由于PCA的数学基础相对简单,因此其在各个领域都有广泛的应用,如金融、医学和自然科学等。
其中,在金融领域,PCA的应用最为广泛,常被用来对金融证券资产的利率、股票和基金结构等进行分析和预测。
二、聚类分析聚类分析是一种多元数据分析方法,其主要用于将一组具有相似特征的对象归为一类。
聚类分析通过减少数据的复杂性和噪声来揭示数据背后的模式和规律。
其最常用的方法是K-means,常被用来区分某类人群的行为、消费等数据,或者用于预测用户偏好。
在医学领域,聚类分析也被广泛应用,如对某种疾病的患者数据进行聚类分析,可以发现一些重要的疾病发生和症状特征信息。
三、判别分析判别分析是一种基于统计方法的多元数据分析方法,其主要通过变量之间的差异性来区分不同组别或分类。
判别分析最常用的方法是LDA(线性判别分析)。
判别分析在市场分析和数据挖掘等场景下有广泛的应用,如通过对用户购买行为的判别分析,来预测用户偏好和购买行为。
四、多元回归分析多元回归分析是一种通过多个自变量预测因变量的多元数据分析方法。
多元回归分析的模型可以建立在线性方程的基础之上,这使得它可以简单地揭示影响特定结果的变量。
多元回归分析在经济学、商业和市场等领域中有广泛的应用,如可帮助企业制定更好的市场策略,预测某地区的经济增长情况等。
五、因子分析因子分析是一种多元数据分析方法,其主要用于确定原始观测数据背后的潜在因子,以帮助我们更好地理解数据的结构和特征。
因子分析法(Factor Analysis)
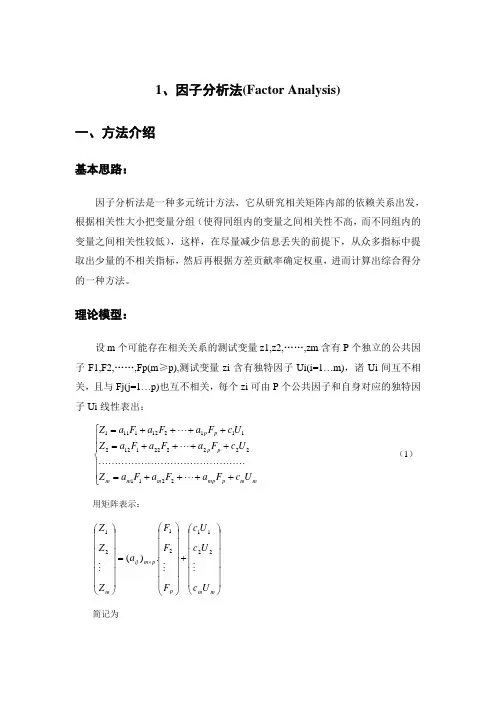
1、因子分析法(Factor Analysis)一、方法介绍基本思路:因子分析法是一种多元统计方法,它从研究相关矩阵内部的依赖关系出发,根据相关性大小把变量分组(使得同组内的变量之间相关性不高,而不同组内的变量之间相关性较低),这样,在尽量减少信息丢失的前提下,从众多指标中提取出少量的不相关指标,然后再根据方差贡献率确定权重,进而计算出综合得分的一种方法。
理论模型:设m 个可能存在相关关系的测试变量z1,z2,……,zm 含有P 个独立的公共因子F1,F2,……,Fp(m ≥p),测试变量zi 含有独特因子Ui(i=1…m),诸Ui 间互不相关,且与Fj(j=1…p)也互不相关,每个zi 可由P 个公共因子和自身对应的独特因子Ui 线性表出:⎪⎪⎩⎪⎪⎨⎧++++=++++=++++=m m p mp m m m p p p p U c F a F a F a Z U c F a F a F a Z U c F a F a F a Z 221122222211221112121111 (1) 用矩阵表示:⎪⎪⎪⎪⎪⎪⎭⎫ ⎝⎛+⎪⎪⎪⎪⎪⎪⎭⎫ ⎝⎛=⎪⎪⎪⎪⎪⎪⎭⎫⎝⎛⨯m m p p m ij m U c U c U c F F F a Z Z Z22112121.)(简记为(1)()(1)()(1)(*m m p p m m m Z A F CU ⨯⨯⨯⨯⨯=+对角阵)(2)且满足:(I) P ≤m ;(II) COV(F .U )=0 (即F 与U 是不相关的); (III) E(F )=0 COV(F )= p p p I =⨯)(11 。
即F1,……FP 不相关,且方差皆为1,均值皆为0(IV) E(U)=0 COV(U)=Im 即U1,……,Um 不相关,且都是标准化的变量,假定z1,……,zm 也是标准化的,但并不相互独立。
式中A 称为因子负荷矩阵,其元素(即(7.2-1)中各方程的系数)aij 表示第i 个变量(zi)在第j 个公共因子Fj 上的负荷,简称因子负荷,如果把zi 看成P 维因子空间的一个向量,则aij 表示zi 在坐标轴Fj 上的投影。
多元统计分析中的因子分析法的应用
多元统计分析中的因子分析法的应用多元统计分析是一种研究多个变量在一起的统计方法,因子分析是其中的一种方法,它被广泛应用于社会科学、心理学、市场研究和生物医学等领域。
本文将介绍因子分析法的基本概念、应用场景、步骤、优缺点以及其未来的发展趋势。
一、基本概念因子分析法是一种通过变量间的相关关系来推导出隐藏变量的分析方法,它是一种将多个变量归类并简化数据的技术。
它可以通过避免多个变量共线性的风险,减小提取样本信息损失,使得数据集变得更加容易理解和解释。
在因子分析中,我们将多个观察变量归纳为较少数量的因子,每一个因子代表一个经验观察变量。
这些因子可以通过解析方差或者协方差矩阵,来确定它们之间的因果关系。
例如,在市场调查中,我们可能收集到了许多关于产品质量、价格、宣传等方面的数据,通过因子分析,我们可以将这些数据归为一个“产品满意度”因子。
二、应用场景因子分析法可以应用于以下领域:1.市场调查:通过因子分析法分析出消费者对产品品质、价格、服务等因素的偏好,帮助企业制定产品营销策略。
2.心理学:通过因子分析法研究情绪、人格、智力等心理特征,揭示内心因素对个人行为的影响。
3.社会科学:通过因子分析法研究社会现象,例如,通过因子分析判断城市居民对住房品质的不同需求,帮助政府进行城市规划。
三、步骤因子分析法的步骤主要包括:1.文件准备:准备数据,并对数据进行必要的清洗和预处理。
2.确定因子数:确定需要提取的潜在因子的数量。
3.提取因子:使用方差分析或最大相似函数提取因子。
4.解释因子:确定因子与每个观测变量之间的相关性,根据它们的关系将它们标识为特定的因素。
5.旋转因子:如果因子过于复杂,则需要使用因子旋转技术来简化分析结果并使其结果更加可解释。
四、优缺点优点:1.简化数据:因子分析法可以帮助研究人员发现数据中的潜在因素,从而简化数据。
2.提高解释性:因子分析法可以提高数据的解释能力。
3.可视化数据:因子分析法可以通过可视化的方法来展示数据,使分析结果更加直观。
统计学中的多元数据分析方法
统计学中的多元数据分析方法统计学中的多元数据分析方法是指通过收集和分析多个变量之间的关系来揭示数据的复杂性和内在规律。
多元数据分析方法广泛应用于社会科学、工程、医学等领域,可以帮助研究人员更深入地理解数据,并做出准确的预测和决策。
本文将介绍几种常见的多元数据分析方法。
一、主成分分析(PCA)主成分分析是一种降维技术,旨在将原始数据转换为较少的维度,同时保留尽可能多的信息。
在主成分分析中,我们通过找到与原始数据中方差最大的方向来实现降维。
这些方向被称为主成分,它们可以解释原始数据的大部分方差。
主成分分析可以帮助我们发现数据中的重要特征,并简化数据的复杂性。
二、因子分析(FA)因子分析是一种统计方法,旨在揭示观测数据背后潜在的构造和维度。
通过因子分析,我们可以将一组相关的观测变量归纳为更少的无关潜在因子。
这些潜在因子可以反映出数据背后的结构和关系。
因子分析可以帮助我们理解多个变量之间的关系,并提供一种简化数据的方式。
三、聚类分析(Cluster analysis)聚类分析是一种将相似观测对象归为一组的统计方法。
在聚类分析中,我们根据观测对象之间的相似性或距离进行分类。
具有高相似性的观测对象将被分配到同一聚类中。
聚类分析可以帮助我们识别数据中的群组和模式,从而更好地理解数据的结构和特征。
四、判别分析(Discriminant analysis)判别分析是一种分类方法,旨在通过已知类别的样本数据来预测新样本的分类。
判别分析通过在特征空间中找到不同类别之间的最佳分隔准则来实现分类。
判别分析可以帮助我们预测和解释分类变量,并评估不同变量对分类的影响。
五、回归分析(Regression analysis)回归分析是一种用于建立变量间关系模型的方法。
通过回归分析,我们可以建立预测变量和响应变量之间的关系,并通过该关系进行预测。
回归分析可以帮助我们理解变量之间的因果关系,并进行预测和决策。
综上所述,统计学中的多元数据分析方法提供了一种强大的工具来处理复杂的多变量数据。
因子分析数据处理
因子分析数据处理因子分析是一种统计分析方法,用于研究多个变量之间的关系以及变量之间的隐含结构。
它可以帮助研究者将多个观测变量转化为更少的无关因子,从而更好地解释数据的结构和变异性。
在实际应用中,因子分析广泛应用于心理学、社会学、教育学、市场营销和管理等领域。
因子分析的数据处理过程包括几个步骤:数据收集、数据清洗、确定合适的因子数目、因子提取、因子旋转和因子解释。
数据收集是因子分析的第一步。
在进行因子分析之前,需要确定研究的目的和需要收集的变量。
数据可以通过实地调查、问卷调查、观察等方式进行收集。
收集到的数据应保证具有一定的样本量和多样性,以确保因子分析的结果具有代表性。
数据清洗是对收集到的数据进行准备和处理的过程。
首先,需要检查数据是否存在缺失值。
如果存在缺失值,可以选择删除缺失值或使用适当的方法进行填充。
其次,需要进行变量的标准化处理,以消除不同变量之间的度量单位和量纲差异。
最常见的标准化方法是将数据进行中心化,即减去均值使得变量的平均值为零。
此外,还可以进行正态化处理,将数据转化为服从正态分布的形式。
确定合适的因子数目是因子分析的关键步骤。
通常,通过计算变量的共同度和特征根来确定因子的数目。
共同度反映了每个变量与其他变量之间的共同因子的比例,值越大表示变量与因子之间的关联越强。
特征根是描述因子分析结果中变异量的指标,较大的特征根表示解释变量变异性的能力更强。
一般来说,选择特征根大于1的因子数目。
因子提取是通过计算和约简原始变量,得到更少的无关因子的过程。
常用的方法包括主成分分析和极大似然估计法。
主成分分析是一种线性变换方法,将原始变量转化为线性无关的因子,使得每个因子解释原始变量的变异性最大化。
极大似然估计法是一种参数估计方法,基于变量之间的相关性来估计因子之间的关系。
因子旋转是对提取得到的因子进行调整,使得每个因子更加清晰和解释性更强。
常用的旋转方法包括正交旋转和斜交旋转。
正交旋转(例如方差最大法)保留因子之间的独立性,斜交旋转(例如极大斜负约束似然)可以允许因子之间存在相关性,以更好地符合实际应用情况。
因子分析方法
因子分析方法因子分析是一种常用的多变量统计分析方法,它可以帮助研究者发现变量之间的内在关系,从而简化数据结构,揭示变量背后的潜在结构。
本文将介绍因子分析的基本概念、原理和应用,并对其在实际研究中的意义进行探讨。
首先,我们来看一下因子分析的基本概念。
在实际研究中,我们经常会面对大量的变量,而这些变量之间可能存在着一定的相关性。
因子分析的目的就是通过统计方法,将这些相关变量归纳为少数几个“因子”,从而减少变量的数量,简化数据分析过程。
这些因子可以被理解为是潜在的、无法直接观测到的变量,它们代表了原始变量中共同的特征或结构。
其次,我们来探讨一下因子分析的原理。
在进行因子分析时,我们通常会使用主成分分析或最大方差法来提取因子。
主成分分析是一种无信息损失的线性变换方法,它可以将原始变量转化为一组线性无关的主成分,从而实现数据的降维处理。
而最大方差法则是通过寻找能够最大程度解释变量方差的因子来进行因子提取。
在因子提取之后,我们还需要进行因子旋转,以便更好地解释因子与原始变量之间的关系。
最后,让我们来看一下因子分析的应用。
因子分析在实际研究中有着广泛的应用,例如在心理学领域,可以利用因子分析来发现人格特征和心理特质之间的内在关系;在市场调研领域,可以利用因子分析来识别消费者偏好和行为模式;在金融领域,可以利用因子分析来挖掘资产价格变动的共同因素。
通过因子分析,研究者可以更好地理解变量之间的关系,发现潜在的结构,从而为决策提供更为准确的信息支持。
综上所述,因子分析是一种强大的多变量分析方法,它可以帮助研究者发现变量之间的内在关系,简化数据结构,揭示潜在结构。
在实际应用中,研究者可以根据具体问题选择合适的因子提取和旋转方法,从而更好地理解数据,为决策提供支持。
因此,掌握因子分析方法对于开展科学研究具有重要意义。
希望本文的介绍能够帮助读者更好地理解因子分析方法,并在实际研究中加以运用。
因子分析法详细步骤-因子分析法操作步骤
心理学研究
在心理学研究中,因子分析法 常用于人格特质、智力等方面 的研究。
社会学研究
在社会学研究中,因子分析法 可用于社会结构、文化等方面
的研究。
02 因子分析法操作步骤
数据标准化
总结词
消除量纲和数量级的影响
详细描述
在进行因子分析之前,需要对数据进行标准化处理,即将原始数据转换为均值为0、标准差为1的标准化数据,以 消除不同量纲和数量级对分析结果的影响。
案例三:品牌定位研究
总结词
通过因子分析法,明确品牌的定位和竞争优 势,以便更好地进行市场推广和竞争策略制 定。
详细描述
首先,收集市场上同类竞争品牌的定位和竞 争优势数据。然后,利用因子分析法对这些 数据进行处理,提取出几个主要的因子,这 些因子代表了不同品牌的定位和竞争优势。 最后,根据因子分析的结果,明确自己品牌 的定位和竞争优势,制定相应的市场推广和 竞争策略,以提高品牌的市场份额和竞争力
要点二
详细描述
首先,收集大量关于消费者行为和偏好的数据,包括购买 行为、品牌选择、价格敏感度等。然后,利用因子分析法 对这些数据进行降维处理,提取出几个主要的因子,这些 因子代表了消费者不同的需求和偏好。最后,根据这些因 子对市场进行细分,将消费者划分为不同的群体,并为每 个群体制定相应的营销策略。
计算相关系数矩阵
总结词
评估变量间的相关性
详细描述
计算标准化数据的相关系数矩阵,用于评估变量之间的相关性。相关系数矩阵 是一个对称矩阵,矩阵中的元素表示不同变量之间的相关系数,用于衡量变量 间的关联程度。
因子提取
总结词
找出主要因子
详细描述
通过因子提取的方法,从相关系数矩阵中找出主要因子。常用的因子提取方法有主成分分析法和公因 子分析法等。这一步的目标是找出能够解释原始数据变异的少数几个公共因子。