
oracle return into 用法
oracle return into 用法
CREATE TABLE t1 (id NUMBER(10),description VARCHAR2(50),CONSTRAINT t1_pk PRIMARY KEY (id));
CREATE SEQUENCE t1_seq;
INSERT INTO t1 VALUES (t1_seq.nextval, 'ONE');
INSERT INTO t1 VALUES (t1_seq.nextval, 'TWO');
INSERT INTO t1 VALUES (t1_seq.nextval, 'THREE');
returning into语句的主要作用是:
delete操作:returning返回的是delete之前的结果
insert操作:returning返回的是insert之后的结果
update操作:returning语句是返回update之后的结果
注意:returning into语句不支持insert into select 语句和merge语句
下面演示该语句的具体用法
(1)获取添加的值
declare
l_id t1.id%type;
begin
insert into t1 values(t1_seq.nextval,'four')
returning id into l_id;
dbms_output.put_line('id='||l_id);
end
运行结果id=4
(2)更新和删除
1 DECLARE l_id t1.id%TYPE;
2 BEGIN
3 UPDATE t1
4 SET description = 'two2'
5 WHERE ID=2
6 RETURNING id INTO l_id;
7 DBMS_OUTPUT.put_line('UPDATE ID=' || l_id);
8 DELETE FROM t1 WHERE description = 'THREE'
9 RETURNING id INTO l_id;
10 DBMS_OUTPUT.put_line('DELETE ID=' || l_id);
11 COMMIT;
12* END;
SQL> /
UPDATE ID=2
DELETE ID=3
(3)如果更新dml操作影响多条记录可以通过bulk collect into 来提取
2 type t_tab is table of t1.id%type;
3 l_tab t_tab;
4 begin
5 update t1
6 set description=description
7 returning id bulk collect into l_tab;
8 for i in l_tab.first..l_st loop
9 dbms_output.put_line('update id='||l_tab(i));
10 end loop;
11* end;
SQL> /
update id=21
update id=22
update id=23
(4)如果插入操作影响多行也可以获取
declare
type description_table_type is table of t1.description%type;
type t1_table_type is table of t1%rowtype;
description_table description_table_type:=description_table_type('FIVE', 'SIX', 'SEVEN'); t1_table t1_table_type;
begin
forall i in description_table.first..description_st
insert into t1 values(t1_seq.nextval,description_table(i))
returning id ,description bulk collect into t1_table;
for i in t1_table.first..t1_st loop
DBMS_OUTPUT.put_line('INSERT ID=' || t1_table(i).id ||'DESC='|| t1_table(i).description); end loop;
end;
/
执行结果
INSERT ID=27DESC=FIVE
INSERT ID=28DESC=SIX
INSERT ID=29DESC=SEVEN
PL/SQL procedure successfully completed.
forall指的是同时插入,如果使用for循环也可以插入三条记录,但默认returing只显示最后一条。
Oracle函数返回游标的方法及应用

Oracle函数返回游标的方法及应用在Oracle中,游标是一种使用SELECT语句检索数据的数据库对象。
Oracle提供了一些内置函数来返回游标,这些函数可以用于各种应用和场景。
下面将介绍几个常用的Oracle函数返回游标的方法及其应用。
1.SYS_REFCURSORSYS_REFCURSOR是Oracle提供的一种特殊类型,可以用于返回游标。
它允许在PL/SQL程序中打开和操作游标,然后将其作为参数传递给其他过程或函数。
SYS_REFCURSOR的使用如下:```CREATE OR REPLACE FUNCTION get_employee_cursorRETURNSYS_REFCURSORISemp_cursor SYS_REFCURSOR;BEGINOPEN emp_cursor FOR SELECT * FROM employees;RETURN emp_cursor;END;```在上述例子中,`get_employee_cursor`函数返回一个SYS_REFCURSOR类型的游标,该游标打开并检索了employees表中的所有数据。
其他过程或函数可以调用这个函数来获取该游标,并使用FETCH语句获取数据。
2.CURSOR返回值在PL/SQL中,可以使用`CURSOR`来定义一个游标类型的变量,并将其作为函数的返回值。
这种方式主要用于在PL/SQL代码中处理游标。
下面是一个示例:```CREATE OR REPLACE FUNCTION get_employee_cursorRETURN employees%ROWTYPEISemp_cursor employees%ROWTYPE;BEGINSELECT * INTO emp_cursor FROM employees;RETURN emp_cursor;END;```在这个例子中,`get_employee_cursor`函数返回一个employees表中的行数据,使用`%ROWTYPE`声明了一个与employees表结构相匹配的记录类型变量emp_cursor。
Oracle数据库的游标和for循环使用
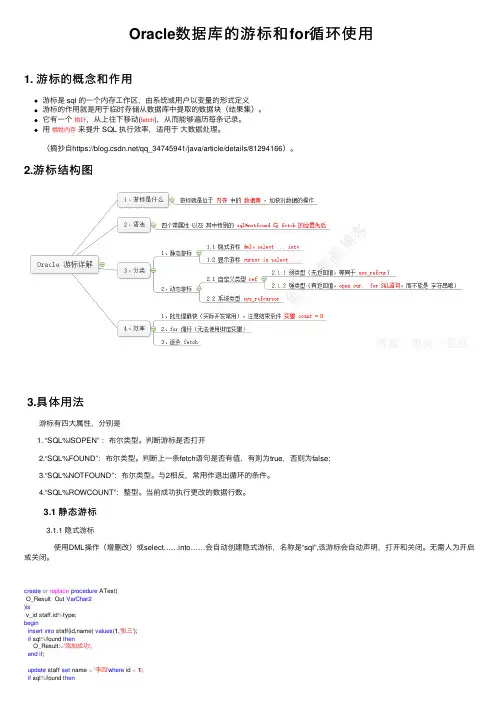
Oracle数据库的游标和for循环使⽤1. 游标的概念和作⽤游标是 sql 的⼀个内存⼯作区,由系统或⽤户以变量的形式定义游标的作⽤就是⽤于临时存储从数据库中提取的数据块(结果集)。
它有⼀个指针,从上往下移动(fetch),从⽽能够遍历每条记录。
⽤牺牲内存来提升 SQL 执⾏效率,适⽤于⼤数据处理。
(摘抄⾃https:///qq_34745941/java/article/details/81294166)。
2.游标结构图3.具体⽤法 游标有四⼤属性,分别是1. “SQL%ISOPEN” :布尔类型。
判断游标是否打开 2.“SQL%FOUND”:布尔类型。
判断上⼀条fetch语句是否有值,有则为true,否则为false; 3.“SQL%NOTFOUND”:布尔类型。
与2相反,常⽤作退出循环的条件。
4.“SQL%ROWCOUNT”:整型。
当前成功执⾏更改的数据⾏数。
3.1 静态游标 3.1.1 隐式游标 使⽤DML操作(增删改)或select……into……会⾃动创建隐式游标,名称是“sql”,该游标会⾃动声明,打开和关闭。
⽆需⼈为开启或关闭。
create or replace procedure ATest(O_Result Out VarChar2)isv_id staff.id%type;begininsert into staff(id,name) values(1,'张三');if sql%found thenO_Result:='添加成功';end if;update staff set name ='李四'where id =1;if sql%found thenO_Result:='更新成功';end if;delete from staff where id =1;if sql%found thenO_Result:='删除成功';end if;select id into v_id from staff;if sql%found thenO_Result:='查询成功';end if;if sql%isopen thenO_Result:='游标为开启状态,但不可能⾛到这⼀步'; --游标只有在执⾏上述增删改操作才会开启并⾃动关闭elseO_Result:='游标为关闭状态';end if;exceptionwhen Others thenbeginO_Result:='N_SQLCODE is '||SQLCODE||' and SQLERRM is '||SQLERRM;rollback;end;end; 3.1.2 显式游标 显⽰游标⼜分为不带参数和带参数两种 ⽆参:create or replace procedure ATest(O_Result Out VarChar2)isv_cur_info staff%rowtype;cursor v_cur is--声明游标为staff表的数据集select*from staff;beginopen v_cur; --打开游标fetch v_cur into v_cur_info; --赋值给游标O_Result:='ID:'||v_cur_info.id||',Name:'||v_cur_;--输出值close v_cur; --关闭游标exceptionwhen Others thenbeginO_Result:='N_SQLCODE is '||SQLCODE||' and SQLERRM is '||SQLERRM;rollback;end;end;输出结果: ID:1,Name:张三带参:create or replace procedure ATest(O_Result Out VarChar2)isv_cur_info staff%rowtype;cursor v_cur(v_id staff.id%type) is--声明游标为staff表的数据集select*from staff where id =v_id; --参数:v_idbeginopen v_cur(1); --打开游标fetch v_cur into v_cur_info; --赋值给游标O_Result:='ID:'||v_cur_info.id||',Name:'||v_cur_;close v_cur; --关闭游标exceptionwhen Others thenbeginO_Result:='N_SQLCODE is '||SQLCODE||' and SQLERRM is '||SQLERRM;rollback;end;end;输出结果: ID:1,Name:张三 3.2 动态游标 3.2.1 ⾃定义类型游标 ⾃定义游标类型声明写法:TYPE ref_type_name IS REF CURSOR[RETURN return_type];ref_type_name代表我们⾃定义类型的名称,cursor是系统默认的return_type代表数据库表中的⼀⾏,或⼀个记录类型,是⼀个返回类型;返回值不是必要的,⽆返回值则称为弱类型,更加灵活;有返回值称为强类型,减少错误;弱类型写法:create or replace procedure ATest(O_Result Out VarChar2)isv_cur_info staff%rowtype;type v_cur_type is ref cursor; --⾃定义游标类型v_cur v_cur_type;beginopen v_cur for--打开游标并声明select*from staff where id<5;loop --开始循环fetch v_cur into v_cur_info; -- 赋值exit when v_cur%notfound; --判断没有值就退出循环O_Result:= O_Result||chr(10)||'ID:'||v_cur_info.id||',Name:'||v_cur_;end loop;close v_cur;exceptionwhen Others thenbeginO_Result:='N_SQLCODE is '||SQLCODE||' and SQLERRM is '||SQLERRM;rollback;end;end;另⼀种写法:create or replace procedure ATest(O_Result Out VarChar2)isv_sql varchar(1000);v_param staff.id%type:=5;v_cur_info staff%rowtype;type v_cur_type is ref cursor; --⾃定义游标类型v_cur v_cur_type;beginv_sql:='select * from staff where id <:id';open v_cur for v_sql --打开游标并声明using v_param; --绑定参数⽅法loop --开始循环fetch v_cur into v_cur_info; -- 赋值exit when v_cur%notfound; --判断没有值就退出循环O_Result:= O_Result||chr(10)||'ID:'||v_cur_info.id||',Name:'||v_cur_;end loop;close v_cur;exceptionwhen Others thenbeginO_Result:='N_SQLCODE is '||SQLCODE||' and SQLERRM is '||SQLERRM;rollback;end;end;强类型写法:三个注意事项:1.强类型⽆法使⽤绑定参数⽅法 2.for后⾯必须是sql,不能是字符串,如上⾯的v_sql; 3.参数必须对应;create or replace procedure ATest(O_Result Out VarChar2)isv_cur_info staff%rowtype;type v_cur_type is ref cursor return staff%rowtype ; --⾃定义游标类型v_cur v_cur_type;beginopen v_cur for--打开游标并声明select*from staff where id <5;loop --开始循环fetch v_cur into v_cur_info; -- 赋值exit when v_cur%notfound; --判断没有值就退出循环O_Result:= O_Result||chr(10)||'ID:'||v_cur_info.id||',Name:'||v_cur_;end loop;close v_cur;exceptionwhen Others thenbeginO_Result:='N_SQLCODE is '||SQLCODE||' and SQLERRM is '||SQLERRM;rollback;end;end; 3.2.2 系统类型游标 简写⼿动声明⾃定义游标的过程type v_cur_type is ref cursor return staff%rowtype ; --⾃定义游标类型v_cur v_cur_type;等同于 v_cur sys_refcursor;4.效率问题没有实际测试过,根据其他博客总结是这样:⼀般来说批量处理的速度要最好,隐式游标的次之,单条处理的最差以下是⽰例:1、批量处理open游标;loopfetch游标bulk collect into集合变量(也就是table类型哦) limit 数值; -- ⼀般 500 左右exit when条件--(变量.count = 0,如果⽤ sql%notfound 不⾜ limit 的记录就不会被执⾏哦)close游标;2、隐式游标for x in (sql 语句) loop... 逻辑处理end loop;3、单条处理open游标;loopfetch游标into变量;exit when条件end loop;close游标;————————————————原⽂链接:https:///qq_34745941/java/article/details/81294166批量处理的关键字不是很了解,下次学习下在记录起来;隐式游标写法最简洁明了,类似于程序中的for循环写法;单条处理⼤概就是上⾯那些范例的写法。
oracle,select into用法

oracle,select into用法Oracle中的SELECT INTO用法在Oracle数据库中,SELECT INTO是一种非常有用的语句,用于将查询结果存储到变量中或将查询结果插入到表或视图中。
它提供了更灵活和便捷的方法来处理查询结果。
本文将详细介绍SELECT INTO的用法,并提供一些示例来加深理解。
一、SELECT INTO的语法和基本用法SELECT INTO语句的基本语法如下:SELECT column1, column2, ...INTO variable1, variable2, ...FROM table_name[WHERE conditions];其中,column1,column2等为表中的列,variable1,variable2等为与之对应的变量。
FROM子句指定要查询的表名称,WHERE子句是可选的,用于过滤查询结果。
使用SELECT INTO的最常见用法是将查询结果存储到变量中。
例如,假设有一个名为employee的表,其中包含了员工的姓名和薪水信息。
我们可以使用SELECT INTO语句将查询结果存储到变量中:DECLAREv_employee_name TYPE;v_employee_salary employee.salaryTYPE;BEGINSELECT name, salaryINTO v_employee_name, v_employee_salaryFROM employeeWHERE employee_id = 1;DBMS_OUTPUT.PUT_LINE('Employee Name: 'v_employee_name);DBMS_OUTPUT.PUT_LINE('Employee Salary: 'v_employee_salary);END;上面的例子中,我们声明了两个变量v_employee_name和v_employee_salary来存储查询结果。
oracle进阶之model子句

oracle进阶之model⼦句 本博客是⾃⼰在学习和⼯作途中的积累与总结,仅供⾃⼰参考,也欢迎⼤家转载,转载时请注明出处。
⼀, model⼦句 制作表格数据,⽤传统sql来实现的话,⼀般通过多个表的⾃联结实现,⽽model的出现则使得不⽤⾃联结就能实现表格,因为model拥有了跨⾏应⽤能⼒。
(1) 语法 MODEL [] [] [MAIN ] [PARTITION BY ()] DIMENSION BY () MEASURES () [] [RULES] (, ,.., ) ::= ::= RETURN {ALL|UPDATED} ROWS ::= [IGNORE NAV | [KEEP NAV] [UNIQUE DIMENSION | UNIQUE SINGLE REFERENCE] ::= [UPDATE | UPSERT | UPSERT ALL] [AUTOMATIC ORDER | SEQUENTIAL ORDER] [ITERATE () [UNTIL ]] ::= REFERENCE ON ON () DIMENSION BY () MEASURES ()------------建表,初始化数据,才好讲下⾯的内容------------------------ 创建表create table ademo(id number(18) primary key,year varchar2(4),week number(8),sale number(8,2),area varchar2(100));-- 创建序列create sequence seq_ademo_idminvalue 1start with 1increment by 1nomaxvaluenocachenocycle;-- 创建触发器create or replace trigger trigger_ademo_idbefore insert on ademo for each row when (new.id is null)beginselect seq_ademo_id.nextval into :new.id from dual;end;-- 初始化数据insert into ademo (AREA, YEAR, WEEK, SALE)values ('astiya', '2000', 1, 52.12);insert into ademo (AREA, YEAR, WEEK, SALE)values ('astiya', '2001', 1, 110.12);insert into ademo (AREA, YEAR, WEEK, SALE)values ('astiya', '2001', 2, 110.12);insert into ademo (AREA, YEAR, WEEK, SALE)values ('astiya', '2001', 3, 1210.12);insert into ademo (AREA, YEAR, WEEK, SALE)values ('astiya', '2002', 1, 170.12);insert into ademo (AREA, YEAR, WEEK, SALE)values ('astiya', '2002', 2, 680.12);insert into ademo (AREA, YEAR, WEEK, SALE)values ('astiya', '2002', 3, 680.12);insert into ademo (AREA, YEAR, WEEK, SALE)values ('anter', '2001', 1, 80.12);insert into ademo (AREA, YEAR, WEEK, SALE)values ('anter', '2001', 2, 56.72);insert into ademo (AREA, YEAR, WEEK, SALE)values ('anter', '2001', 3, 156.72);insert into ademo (AREA, YEAR, WEEK, SALE)values ('anter', '2002', 1, 640.12);insert into ademo (AREA, YEAR, WEEK, SALE)values ('anter', '2002', 2, 980.12);insert into ademo (AREA, YEAR, WEEK, SALE)values ('anter', '2002', 3, 1980.12);/*delete from ademo;*/-- 注释(这是我的个⼈习惯,不想⿇烦的可以不加)comment on table ademo is '测试经济类的表';comment on column ademo.id is '主键';comment on column ademo.year is '年份';comment on column ademo.week is 'xxx周';comment on column ademo.sale is '销售额';comment on column ademo.area is '地区';-- 展⽰数据select * from ademo;-- 例⼦1select year,week,sale,area,up_salefrom ademomodel return updated rows -- model 语句partition by (area) -- 分组dimension by (year,week) -- 维度列measures(sale,0 up_sale) -- 度量值列rules( -- 规则up_sale[year,week]=sale[cv(year),cv(week)]*10,up_sale[1999,1]=100.00 )order by year,week;-- 例⼦2select year,week,sale,area,up_salefrom ademomodelpartition by (area)dimension by (year,week)measures(sale,0 up_sale)rules(up_sale[year,week]=sale[cv(year),cv(week)]*10,up_sale[1999,for week from 1 to 3 increment 1]=100.00)order by year,week;-------------------------------------------------------------------- (2) 规则 a. 位置标记 即指定确定的位置明确的维度列值,例如:例⼦1中的规则(rules)中的up_sale[1999,1]=100.00,明确指出,year=1999,week=1的up_sale列的值为100.00, 作⽤: 位置标记通常也叫UPSERT,即update and insert,当结果集中不存在则插⼊,数量随分组的数量⽽定;存在时,则更新数据,更新的数据条数同样与分组的组数相同。
oracle 自定义函数

oracle 自定义函数oracle自定义函数是最重要的函数之一,下面就为您介绍oracle自定义函数的使用,实现返回表类型,希望对您能够有所帮助。
oracle中的函数可以返回表类型。
但是,这个表类型实际上是集合类型(与数组类似)这个类型不能直接作为 from 的宾语。
从oracle 9i 开始,提供了一个叫做“管道化表函数”的概念,来解决这个问题。
这种类型的函数,必须返回一个集合类型,且标明 pipelined。
这个函数不能返回具体变量,必须以一个空 return 返回。
这个函数中,通过 pipe row () 语句来送出要返回的表中的每一行。
调用这个函数的时候,通过 table() 关键字把管道流仿真为一个数据集以下是一个十分简单的实例:create table tb1(k number, v varchar2(10));insert into tb1(k, v) values(100,'aaa');insert into tb1(k, v) values(200,'bbb');insert into tb1(k, v) values(200,'ccc');select * from tb1;create type row_type1 as object(k number, v varchar2(10));create type table_type1 as table of row_type1;create or replace function fun1 return table_type1 pipelined asv row_type1;beginformyrow in (select k, v from tb1) loopv := row_type1(myrow.k, myrow.v);pipe row (v);end loop;return;end;select * from table(fun1);。
Oracle循环中的EXIT、RETURN、CONTINUE解密

Oracle循环中的EXIT、RETURN、CONTINUE解密有时候编写Oracle中⽤游标等信息去循环处理逻辑的时候,对EXIT、RETURN、CONTINUE很容易搞混淆,⽹上搜了资料也不是很清楚,所以本⼈⾃⼰写了⼀⼩段代码测试了这三种⽤法。
案例代码如下:PROCEDURE P_TASK ISBEGINFOR MY_CU IN (SELECT SPBH, SPMCH FROM FUCM) LOOPFOR MY IN (SELECT SPBH, SPMCH FROM FUCM) LOOPIF MY_CU.SPBH = 'AAA' THENRETURN;--exit;--continue;ELSIF MY.SPBH = 'BBB' THENINSERT INTO FUCM_JG (SPBH, SPMCH) VALUES ('123', '123');ELSEINSERT INTO FUCM_JG (SPBH, SPMCH) VALUES ('222', '222');END IF;INSERT INTO FUCM_JG (SPBH, SPMCH) VALUES ('333', '333');END LOOP;END LOOP;INSERT INTO FUCM_JG (SPBH, SPMCH) VALUES ('444', '444');END P_TASK;案例测试得到结果如下(分析的结果中注意本次循环和本循环的区别。
本次循环是本循环执⾏的这次循环):第⼀种:使⽤RETURN的时候,直接跳出存储过程或者函数第⼆种:使⽤EXIT的时候,跳出本循环转⽽执⾏本循环的上⼀级循环的下⼀次循环。
就此案例⽽⾔MY_CU.SPBH = 'AAA'为真的时候,直接跳出MY循环转⽽去执⾏MY_CU的下⼀次循环第三种:使⽤CONTINUE的时候,本次循环后⾯的代码部分不再执⾏,转⽽执⾏本循环的下⼀次循环。
oracle 自定义函数入门
oracle 自定义函数入门博客分类:oracle用户定义函数是存储在数据库中的代码块,可以把值返回到调用程序。
调用时如同系统函数一样,如max(value)函数,其中,value被称为参数。
函数参数有3种类型。
IN 参数类型:表示输入给函数的参数。
OUT 参数类型:表示参数在函数中被赋值,可以传给函数调用程序。
IN OUT参数类型:表示参数既可以传值也可以被赋值。
1、语法格式:SQL语法方式创建的语法格式为:CREATE OR REPLACE FUNCTION function_name /*函数名称*/(Parameter_name1,mode1 datatype1,/*参数定义部分*/Parameter_name2,mode2 datatype2,Parameter_name3,mode3 datatype3…)RETURN return_datatype/*定义返回值类型*/IS/ASBEGINFunction_body/*函数体部分*/RETURN scalar_expression /*返回语句*/END function_name;说明:function_name::用户定义的函数名。
函数名必须符合标示符的定义规则,对其所有者来说,该名在数据库中是唯一的。
parameter:用户定义的参数。
用户可以定义一个或多个参数。
mode:参数类型。
datatype:用户定义参数的数据类型。
return_type::用户返回值的数据类型。
函数返回scalar_expression表达式的值,function_body函数体由pl/sql语句构成。
2、示例函数代码:create or replace function T01001_countreturn numberiscount_T01001 number;beginselect count(*) into count_T01001 from T01001;return(count_T01001);end T01001_count; --记得一定要打分号调用:declarei number;begini:=T01001_count();dbms_output.put_line(to_char(i));end;--记得一定要打分号注意:(1)如果函数没有参数,那么函数名后不应该要括号;(2)创建函数的时候end后面一定要记得写函数名--没有参数的函数create or replace function get_user return varchar2 isv_user varchar2(50);beginselect username into v_user from user_users;return v_user;end get_user;--测试方法一select get_user from dual;方法二SQL> var v_name varchar2(50)SQL> exec :v_name:=get_user;PL/SQL 过程已成功完成。
oracle回退语句
oracle回退语句摘要:1.简介2.Oracle回退语句的类型3.Oracle回退语句的使用方法4.Oracle回退语句的注意事项5.总结正文:1.简介Oracle回退语句是Oracle数据库管理系统中的一种重要命令,用于在执行某些操作后,撤销该操作并恢复到之前的状态。
它可以确保数据的一致性和完整性,防止误操作造成数据损失。
在实际应用中,回退语句的使用频率非常高,熟练掌握回退语句的使用对于Oracle数据库管理员和开发人员来说至关重要。
2.Oracle回退语句的类型Oracle回退语句主要有以下几种类型:- ROLLBACK:回滚当前事务,撤销已执行的操作。
- ROLLFORWARD:将当前事务向前推进,继续执行已提交的操作。
- SAVEPOINT:设置一个事务保存点,用于回滚到该点。
- RELEASE SAVEPOINT:释放一个事务保存点,不再回滚到该点。
- COMMIT:提交当前事务,将已执行的操作永久保存在数据库中。
3.Oracle回退语句的使用方法以下是一些Oracle回退语句的使用示例:- 回滚当前事务:```ROLLBACK;```- 将当前事务向前推进:```ROLLFORWARD;```- 设置事务保存点:```SAVEPOINT savepoint_name;```- 回滚到事务保存点:```ROLLBACK TO SAVEPOINT savepoint_name; ```- 释放事务保存点:```RELEASE SAVEPOINT savepoint_name;```- 提交当前事务:```COMMIT;```4.Oracle回退语句的注意事项- 在使用回退语句时,要确保事务已正确地启动和结束。
- 在执行ROLLBACK或ROLLFORWARD语句时,需要具有相应的权限。
- 在使用事务保存点时,不同的数据库版本可能有所不同,需参照相应文档进行操作。
5.总结Oracle回退语句是Oracle数据库管理系统中非常重要的一部分,掌握回退语句的使用对于保证数据的一致性和完整性具有重要意义。
oracle常用的SQL及语法
1、两个oracle 开发工具介绍a)SqlDbx王金生曾推荐过的一款数据库客户端开发工具,使用容易,不需要额外的安装其它插件,有sql提示功能,支持Oracle,Sybase ASE, IBM,DB2/UDB, MicrosoftSQL Server 和ODBC数据源,免费绿色版。
b)PLSQL Developer专门针对oracle开发的一款比较专业的客户端工具,除了常用的数据库操作外,还支持存储过程及函数的调试功能等比较高级的功能,详细的操作可以安装完毕后大家去慢慢研究。
配置方式见网上找的一段方法,第二种:/view/65b5a80f6c85ec3a87c2c583.html以上提到的工具及可能用到的插件见共享目录中的文件。
2、oracle 与 sqlserver 语法大比较a)oracle各类型字段描述b)字段类型比较c)常用函数比较注:此处仅记录语法有区别的地方,更多丰富的语法请查看附件中的手册。
以下的exp为expression的缩写d)关于脏读目前我们使用的sqlserver 数据库,在查询数据时,都要求在select语句中后面跟一个(nolock)或(with nolock)来保证读取大表时不影响其它程序进程的数据操作。
在oracle中,目前还不允许脏读的方式,在每次select 后,读到的数据都是已经commit的数据,所以为了避免读取数据的不准确,程序中如果有比较耗时的sql 操作,尤其是在insert 和update后,尽量减小事务,而且要在事务结束后及时commit。
e)表(主键、外键、CHECK、UNIQUE、DEFAULT、INDEX)在创建表及其主键、外键、CHECK、UNIQUE、DEFAULT、INDEX时,SQL SERVER 与ORACLE的语法大致相同。
主要区别如下:Oracle定义表字段的default属性紧跟字段类型之后,如下:Create table MZ_Ghxx( ghlxh number primay key ,rq date default sysdate not null,….)而不能写成Create table MZ_Ghxx( ghlxh number primay key ,rq date not null default sysdate,….)f)存储过程/函数结构的不同SQLSERVER中存储过程的结构大致如下CREATE PROCEDURE procedure_name/*输入、输出参数的声明部分*/ASDECLARE/*局部变量的声明部分*/BEGIN/*主体SQL语句部分*//*游标声明、使用语句在此部分*/ENDORACLE中存储过程的结构大致如下CREATE OR REPLACE PROCEDURE procedure_name(/*输入、输出参数的声明部分*/ )AS/*局部变量、游标等的声明部分*/BEGIN/*主体SQL语句部分*//*游标使用语句在此部分*/EXCEPTION/*异常处理部分*/END ;ORACLE端FUNCTION语法说明CREATE [OR REPLACE] FUNCTION function_name[(argument [{IN | OUT | IN OUT }] ) type,…[(argument [{IN | OUT | IN OUT }] ) typeRETURN return_type {IS | AS}BEGIN…END;变量赋值在SQL SERVER语句中用如下语句对局部变量赋值(初始值或数据库表的字段值或表达式):“SELECT 局部变量名= 所赋值(初始值或数据库表的字段值或表达式)”;而在ORACLE中,将初始值赋给局部变量时,用如下语句:“局部变量名: = 所赋值(初始值或表达式);”,将检索出的字段值赋给局部变量时,用如下语句:“SELECT 数据库表的字段值INTO 局部变量名…”。
oracle into的用法
oracle into的用法"Into" 是一个常用的前置介词,它通常表示向某个方向或目的地移动或转化。
在Oracle中,"into"通常用于将查询结果放入一个变量或记录中。
以下是一些"into"在Oracle中的用法示例:1.SELECTINTO。
SELECTINTO语句允许将查询结果存储到变量中。
例如:```。
DECLARE。
v_emp_name st_name%TYPE;。
BEGIN。
SELECT last_name INTO v_emp_name。
FROM employees。
WHERE employee_id = 100;。
DBMS_OUTPUT.PUT_LINE('Employee name is: ' || v_emp_name);。
END;。
```。
这个例子查询employee_id为100的雇员的姓氏,并将其存储在名为v_emp_name的变量中。
最后,使用DBMS_OUTPUT.PUT_LINE输出结果。
2.INSERTINTO。
INSERTINTO语句用于向表中插入新行。
例如:```。
INSERT INTO employees (employee_id, last_name, first_name)。
VALUES (101, 'Smith', 'John');。
```。
这个例子将员工信息插入到employees表中。
注意,通过使用"values"子句,我们可以将数据直接插入到指定的列中。
3.UPDATE...SET...INTO。
UPDATE语句可被用来更新现有记录。
例如:```。
DECLARE。
v_old_salary employees.salary%TYPE;。
BEGIN。
UPDATE employees。
SET salary = salary * 1.1 -- 给所有雇员涨薪10%。