
数理统计之回归分析基础
1978
23.8 41.4
1979
27.6 51.8
1980
31.6 61.7
1981
32.4 67.9
1982
33.7 68.7
1983
34.9 77.5
1984
43.2 95.9
1985
52.8 137.4
1986
63.8 155
1987
73.4 175
试求社会商品零售总额 y 对职工工资总额 x 的线性回归方程,
直线用处就不大; 如果误差比较小, 那么求出来的回归直线就 比较理想,可见 2 的大小反映回归直线拟合程度的好坏。
1 n 2 如何估计 ?自然想到利用 n ( i E i ) 来估计 2 。 i 1
2
ˆx ˆi yi a ˆ b 由于 i , i 1,2,, n 是未知的,而 i yi a bxi i
ˆ 称之为 Y 对 X 的回归直线方程。 ˆ a ˆ bx 即 y
在实际试验中,对变量 X 与 Y 作 n 次试验观察,并假定在 X 的各 个值上对
Y
的观察值是相互独立的,得到
n
对试验值
xi , yi
i , 1, 2 n。 ...,
在平面直角坐标系中, 画出 xi , yi , i 1, 2..., n 共 n 个点, 它们所构 成的图形成为点图。如果点图中的 n 个点分布在一条直线附近,直观 上可以认为 X 与 Y 的关系具有一元线性回归模型。
ˆ b) l (b 2 xx ˆ ~ N (0,1) ,因为一般 由于 b ~ N (b, l ) ,所以 xx
2是
未 知 的 , 可 用
2
ˆ2 Q 代 入 : 的 无 偏 估 计 n2
1
ˆ b) l ˆ b) l / 2 (b ~ (b xx xx T ~ t (n 2) ˆ2 ˆ 2 /( n 2) 2 (n 2)
2 i 1 i 1
n
n
2
ˆ 作为 a, b 的估计。这就 ˆ, b 来表示总偏差,以使 Q 达到极小的 a
是著名的最小二乘法。 注意, Q
i 1 n
ˆ ˆ bx yi a i
2
使 Q 达到极小的 a, b ,
应满足下面的方程组:
n Q 2 yi a bxi 0 a i 1 n Q 2 y a bx x 0 i i i i 1 b
2
特 别 : b0 0 , 若 此 零 假 设 成 立 , 则 线 性 模 型 化 为 :
yi a i , i 1 , .n ..,
这表明:变量 关关系。 在线性回归分析中, 一旦参数估计问题解决, 立即就要检验假
y 并不依赖于 x ,也即 x , y 间不存在线性相
设 H 0 : b0 0 以决定 x , y 之间的线性关系是否显著,此时用
制变量,另一个变量是随机的,而且随着控制变量的变化而变化,则 这两个变量之间的关系称为回归关系。 如果两个变量都是随机的,则它们之间的关系称为相关关系。
二者的差别在于把自变量看作是随机变量还是控制变量。
尽管回归和相关的含义不同, 不过从计算的角度来看, 二者的差别 又不是很大,因此常常忽略其区别而混杂使用。例如,在研究相关关 系时,可以把其中一个变量看作是控制变量而着重考察另一个变量对 它的统计依赖关系,这就是说把两个变量的关系看作是回归关系。
经整理得如下正规方程:
n n na xi b yi i 1 i 1 n n n 2 xa x b x y , i i i i i 1 i 1 i 1
解正规方程组:
n n n n n n 1 n n xi yi xi yi xi yi xi yi xi x yi y n i 1 i 1 i 1 i 1 i 1 i 1 ˆ i 1 b 2 2 n n n n n 2 1 2 xi x n xi2 xi x x i i i 1 n i 1 i 1 i 1 i 1 ˆ ˆ y bx a
Y 相应于 x1 , x2 ,..., xn 的 n 个观察值 y1 ,..., yn 可看成 Y1 ,..., Yn 的试验
值。 而
Yi a bxi i , i 1,2,n, 其 中 i ~ N (0, 2 )
2
且
1 ,, n 相互独立。此式通常称为线性模型。
第四章 回归分析
一切客观事物都是互相联系和具有内部规律的,这些关系表现在 量上,只要有两种类型:
一是变量之间存在着完全确定性的关系,例如函数关系。
S r 2 等。
另一类是统计关系,或称相关关系。
(变量之间存在着一定的关系, 然而一个变量有一个确定的值后, 不能得出另一个变量相应的确定的值, 把这种不确定性关系的 变量间的联系称为相关关系。) 例:家庭的支出与其收入之间的关系; 儿子的身高与他父亲的身高的关系; 某种商品的销售量与其价格的关系等。
易证, Yi ~ N (a bxi , ) 且 Y1 ,..., Yn 相互独立。
1.2 未知参数 a, b 的估计 (利用最小二乘法求出 a, b 的
ˆ) ˆ, b 最小二乘估计 a
ˆ , b 为参数 a, b 的估计. 设a
希望每个观察点 xi , yi 同直线 y a bx 之间的偏差尽可 能的小。 ( 即在 x xi 处, xi , yi 与直线 y a bx 之间的偏差是
回归分析与相关分析均为研究及度量两个或两 个以上变量之间相关关系的一种统计方法。
(在进行分析,建立数学模型时,常需选择其中之一为因变量,而 其余的均为自变量,然后根据样本资料,研究及测定自变量与因变量 之间的关系。 )
严格说来,回归与相关的含义是不同的。 如果两个变量中的一个变量是人力加以控制的, 非随机的, 简称控
2 易知,当 x 取固定值时, Y 服从正态分布 N a bx,
, n 来估计 a, b ,得估计 xn y 用样本值 x1 , y1 , x 2 , y 2 , ...,
ˆ ,记作 y ˆ , b 。从而得到 a bx 的一个估计 a ˆ。 ˆ bx 值a
ˆ
1 n 1 n x xi , y yi 记 n i 1 n i 1
称
ˆ 为 参 数 a, b 的 最 小 二 乘 估 计 , 并 得 回 归 方 程 , ˆ, b a
ˆ ˆ a ˆ bx y
ˆx x ˆ y b 改写成: y 。即回归直线一定通过 x , y 这一
ˆ l b xx T 的统计量为: ˆ Q /( n 2) ˆ l b xx
当 H 0 成立时,它服从于 t n 2 例 1.3:上例中,试问上海市市区的职工工资总额 x 与社会商 品零售总额
y 之间是否确实存在显著的线性关系?
同理:对检验假设 H 0 : a a0 可以用统计量
lxy ˆ bL lxx ˆx ˆL y b a L 1 n 2 ˆ ˆ L yi a ˆ bx i n i 1
2
ˆ L 不是 的无偏估计 易见
2
2
2.参数 a, b 的假设检验 一元线性回归中的检验问题不外乎是对参数作出检验假 设: (1)统计假设: H 0 : b b0 H1 : b b0 (2) 统计假设: H 0 : a a0 H1 : a a0
独立的)
ˆ
ˆ , b 的方差,协方差分别为: 4. a
2 1 x 2 ˆ n D a 2 n x x i i 1
ˆ
,
ˆ D b
2
x x
i 1 i
n
2
ˆ ˆ, b cov a
x 2
x x
点。 记
lxx xi x , l yy yi y , lxy l yx xi x yi y
2 2 i 1 i 1 i 1
n
n
n
ˆ xy ˆ b 此时, b 可记为: l
l
xx
1.3 未知参数 2 的估计
2 是随机误差 的方差。如果误差大,那么求出来的回归
§1 一元线性回归的参数估计
只有一个自变量的回归分析称为一元回归分析, 有多于一个自变量的回归分析称为多元回归分析。
1.1 模型
设 X 是可控变量, Y 是依赖于 X 的随机变量,它们的关系 是:
Y a bX
其中 a, b 是常数, 服从于正态分布 N 0, 2 , X 与 Y 的这种 关系称为一元线性回归(模型) 。
2
化肥用量与水稻产量
化肥用量 x/kg 水稻产量 y/kg
15 330
20 345
25 365
30 405
35 445
40 490
45 455
例 1.2:实例分析,上海市市区的社会商品零售总额和全民所 有制职工工资总额的数据如下:
年份 / 年 职工工资 总额 x / 亿元 社会商品 零售额 y/亿元
T ˆ ˆ a0 a 1 x n lxx
ˆ
yi yi a bxi , i 1, 2..., n 共有 n 个偏差值,应该综合考虑。显然
不能用代数和来表示,因为偏差有正有负,它们的代数和会出现正负 相抵而不能代表真正的总偏差。若取绝对值后再求和可以避免这一缺 点,但却不便于做数学处理。)
概率论与数理统计(回归分析)

调整R方值 考虑到自变量数量的R方值,用 于比较不同模型之间的拟合优度。 调整R方值越接近于1,说明模型 拟合优度越好。
残差图 通过观察残差与实际观测值之间 的关系,判断模型是否符合线性 关系、是否存在异方差性等。
05
逻辑回归分析
逻辑回归模型
01
逻辑回归模型是一种用于解决 二分类问题的统计方法,基于 逻辑函数将线性回归的预测值 转换为概率形式。
多元非线性回归模型
在多个自变量X1, X2, ..., Xp的条件下,预测因变量Y的非线性数 学模型。模型形式为Y = f(β0, β1*X1, β2*X2, ... , βp*Xp),其
中f表示非线性函数。
多元逻辑回归模型
用于预测分类结果的多元回归模型,适用于因变量Y为二分 类或多分类的情况。
多重共线性问题
非线性回归模型是指因变量和自 变量之间的关系不是线性的,需 要通过变换或参数调整来拟合数 据。
形式
非线性回归模型通常采用指数函 数对数函数、多项式函数等形 式来表达。
适用范围
非线性回归模型适用于因变量和 自变量之间存在非线性关系的情 况,例如生物医学、经济学、社 会学等领域。
常用非线性回归模型
指数回归模型
线性回归模型假设因变量和自变 量之间存在一种线性关系,即当 一个自变量增加或减少时,因变 量也会以一种恒定的方式增加或 减少。
最小二乘法
01
02
03
最小二乘法是一种数学 优化技术,用于估计线
性回归模型的参数。
最小二乘法的目标是找 到一组参数,使得因变 量的观测值与预测值之
间的平方和最小。
最小二乘法的数学公式为: β=(XTX)^(-1)XTY,其中 X是自变量的数据矩阵,Y 是因变量的数据向量,β
数学地质第三章 回归分析

yi
n
(3-9)
n 1 1 y yi x xi n i 1 n i 1 则式(3-9)可化为
n
n n 2 na x b xi xi y i i 1 i 1 a bx y
(3-10)
二、参数a,b的最小二乘估计
由式(3-10)中第一个方程得
y x
一、一元线性回归的数学模型
将式(3-2)及式(3-3)两边取对数,则分别为 Lny=lnα+βx (3-4) 及 lny=lnα+βlnx (3-5) 如果在式(3-4)中令Y=lny,则Y与x即成线性 关系;如果在式(3-5)中令Y=lny,X=lnx,则Y与X 就成线性关系。此外,还有一些函数,只要经过简单 变换,也可变为线性关系。这些统称为可化为线性关 系的情况,只要线性情况得到解决,可化为线性的情 况也就不难解决。
一元线性回归分析,主要是处理两个变量
x、y之间的关系。两个变量之间的关系有线性 和非线性两种情况,这里主要讨论线性关系及 可化为线性关系的非线性情况。
一、一元线性回归的数学模型
线性关系数学模型,如 y=a+bx (a,b为常数) (3-1) 非线性的情况,如指数函数 x y e (α,β为常数) (3-2) 幂函数形式 (3-3)
n Q 2 ( yi a bxi ) 0 a i 1 n Q 2 ( yi a bxi ) xi 0 b i 1
( 3-8)
二、参数a,b的最小二乘估计
即
令
i 1 i 1 n n n a xi b xi2 xi y i i 1 i 1 i 1 na b xi
二、参数a,b的最小二乘估计
数理统计CH回归分析课件

2024/10/4
21
回归最小二乘估计
(2)最小二乘思想
n
n
| i |
2 i
i 1
i 1
残差计算:
yi a bxi i
i yi a bxi
➢用残差(误差)平 方和代表试验点与 回归直线旳总距离
2024/10/4
➢回归方程旳最小二乘
估计可归结为求解下
面旳优化模型:
n
Min a,b
n i 1
yi
a
bxi
2
n i 1
b
yi a bxi
2
n
2 yi a bxi xi i 1
2024/10/4
24
回归最小二乘估计
(3)回归最小二乘估计
x
1 n
n i 1
xi
y
1 n
n i 1
yi
Q 0 a aˆ,b bˆ a
n
即 2 yi aˆ bˆxi 0 i 1
2024/10/4
40
回归明显性检验
(3)模型和假设
线性回归模型 线性有关假设
➢由线性回归模型可推论:
E yi E a bxi i a bxi
Var yi Var a bxi i Var i 2
2024/10/4
10
7.2 一元线性回归
(1)案例和问题
x称作自变量 y称作响应变量
案例:某特种钢抗拉强度试 抗拉强度试验成果 验,控制某稀有金属含量x
x(%) y(MPa) 测得不同抗拉强度y,试验
2.07 128 成果如表所示。
3.10 194 4.14 273 5.17 372 6.20 454
yi
数理统计第一次大作业——回归分析
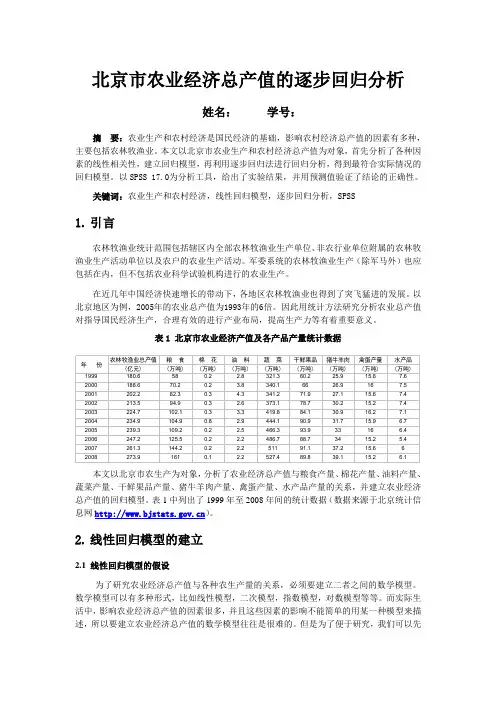
北京市农业经济总产值的逐步回归分析姓名:学号:摘要:农业生产和农村经济是国民经济的基础,影响农村经济总产值的因素有多种,主要包括农林牧渔业。
本文以北京市农业生产和农村经济总产值为对象,首先分析了各种因素的线性相关性,建立回归模型,再利用逐步回归法进行回归分析,得到最符合实际情况的回归模型。
以SPSS 17.0为分析工具,给出了实验结果,并用预测值验证了结论的正确性。
关键词:农业生产和农村经济,线性回归模型,逐步回归分析,SPSS1.引言农林牧渔业统计范围包括辖区内全部农林牧渔业生产单位、非农行业单位附属的农林牧渔业生产活动单位以及农户的农业生产活动。
军委系统的农林牧渔业生产(除军马外)也应包括在内,但不包括农业科学试验机构进行的农业生产。
在近几年中国经济快速增长的带动下,各地区农林牧渔业也得到了突飞猛进的发展。
以北京地区为例,2005年的农业总产值为1993年的6倍。
因此用统计方法研究分析农业总产值对指导国民经济生产,合理有效的进行产业布局,提高生产力等有着重要意义。
表1 北京市农业经济产值及各产品产量统计数据本文以北京市农生产为对象,分析了农业经济总产值与粮食产量、棉花产量、油料产量、蔬菜产量、干鲜果品产量、猪牛羊肉产量、禽蛋产量、水产品产量的关系,并建立农业经济总产值的回归模型。
表1中列出了1999年至2008年间的统计数据(数据来源于北京统计信息网)。
2.线性回归模型的建立2.1 线性回归模型的假设为了研究农业经济总产值与各种农生产量的关系,必须要建立二者之间的数学模型。
数学模型可以有多种形式,比如线性模型,二次模型,指数模型,对数模型等等。
而实际生活中,影响农业经济总产值的因素很多,并且这些因素的影响不能简单的用某一种模型来描述,所以要建立农业经济总产值的数学模型往往是很难的。
但是为了便于研究,我们可以先假定一些前提条件,然后在这些条件下得到简化后的近似模型。
以下我们假定两个前提条件:1) 农产品的价格是不变的。
回归分析有哪些基本的步骤

回归分析有哪些基本的步骤回归分析是确定两种或两种以上变量间相互依赖的定量关系的一种统计分析方法。
回归分析也有一定的步骤。
以下是由店铺整理回归分析的内容,希望大家喜欢!回归分析的简介①从一组数据出发,确定某些变量之间的定量关系式,即建立数学模型并估计其中的未知参数。
估计参数的常用方法是最小二乘法。
②对这些关系式的可信程度进行检验。
③在许多自变量共同影响着一个因变量的关系中,判断哪个(或哪些)自变量的影响是显著的,哪些自变量的影响是不显著的,将影响显著的自变量入模型中,而剔除影响不显著的变量,通常用逐步回归、向前回归和向后回归等方法。
④利用所求的关系式对某一生产过程进行预测或控制。
回归分析的应用是非常广泛的,统计软件包使各种回归方法计算十分方便。
在回归分析中,把变量分为两类。
一类是因变量,它们通常是实际问题中所关心的一类指标,通常用Y表示;而影响因变量取值的的另一类变量称为自变量,用X来表示。
回归分析研究的主要问题是:(1)确定Y与X间的定量关系表达式,这种表达式称为回归方程;(2)对求得的回归方程的可信度进行检验;(3)判断自变量X对因变量Y有无影响;(4)利用所求得的回归方程进行预测和控制。
回归分析的应用相关分析研究的是现象之间是否相关、相关的方向和密切程度,一般不区别自变量或因变量。
而回归分析则要分析现象之间相关的具体形式,确定其因果关系,并用数学模型来表现其具体关系。
比如说,从相关分析中我们可以得知“质量”和“用户满意度”变量密切相关,但是这两个变量之间到底是哪个变量受哪个变量的影响,影响程度如何,则需要通过回归分析方法来确定。
一般来说,回归分析是通过规定因变量和自变量来确定变量之间的因果关系,建立回归模型,并根据实测数据来求解模型的各个参数,然后评价回归模型是否能够很好的拟合实测数据;如果能够很好的拟合,则可以根据自变量作进一步预测。
例如,如果要研究质量和用户满意度之间的因果关系,从实践意义上讲,产品质量会影响用户的满意情况,因此设用户满意度为因变量,记为Y;质量为自变量,记为X。
第七章 回归分析

第七章回归分析前几章所讨论的内容,其目的在于寻求被测量的最佳值及其精度。
在生产和科学实验中,还有另一类问题,即测量与数据处理的目的并不在于获得被测量的估计值,而是为了寻求两个变量或多个变量之间的内在关系,这就是本章所要解决的主要问题。
表达变量之间关系的方法有散点图、表格、曲线、数学表达式等,其中数学表达式能较客观地反映事物的内在规律性,形式紧凑,且便于从理论上作进一步分析研究,对认识自然界量与量之间关系有着重要意义。
而数学表达式的获得是通过回归分析方法完成的。
第一节回归分析的基本概念一、函数与相关在生产和科学实验中,人们常遇到各种变量。
从贬值辩证唯物主义观点来看,这些变量之间是相互联系、互相依存的,它们之间存在着一定的关系。
人们通过实践,发现变量之间的关系可分为两种类型:1.函数关系(即确定性关系)数学分析和物理学中的大多数公式属于这种类型。
如以速度v作匀速运动的物体,走过的距离s与时间t之间,有如下确定的函数关系:s=vt若上式中的变量有两个已知,则另一个就可由函数关系精确地求出。
2.相关关系在实际问题中,绝大多数情况下变量之间的关系不那么简单。
例如,在车床上加工零件,零件的加工误差与零件的直径之间有一定的关系,知道了零件直径可大致估计其加工误差,但又不能精确地预知加工误差。
这是由于零件在加工过程中影响加工误差的因素很多,如毛坯的裕量、材料性能、背吃刀量、进给量、切削速度、零件长度等等,相互构成一个很复杂的关系,加工误差并不由零件直径这一因素所确定。
像这种关系,在实践中是大量存在的,如材料的抗拉强度与其硬度之间;螺纹零件中螺纹的作用中径与螺纹中径之间;齿轮各种综合误差与有关单项误差之间;某些光学仪器、电子仪器等开机后仪器的读数变化与时间之间;材料的性能与其化学成分之间等等。
这些变量之间既存在着密切的关系,又不能由一个(或几个)变量(自变量)的数值精确地求出另一个变量(因变量)的数值,而是要通过试验和调查研究,才能确定它们之间的关系,我们称这类变量之间的关系为相关关系。
武汉大学数理统计ppt 5回归分析
…,
yn
的总变差为
:
S
2 总
( yi y)2
i 1
y
yi
yˆ 0 1 x
y i yˆ i
aˆ
yˆ
y
o
xi
x
可以证明
n
n
n
S
2 总
( y i y ) 2 ( yˆ i y ) 2 ( y i yˆ i ) 2
i 1
i 1
i 1
n
S
2 回
( yˆ i y ) 2
i 1
n
出检验.
(2)如果方程真有意义,用它预测y时,预测值与
真值的偏差能否估计?
4.线性回归方程的显著性检验
对任意两个变量的一组观察值
(xi , yi), i=1, 2, …, n 都可以用最小二乘法形式上求得 y 对 x的 回归方程, 如果y 与x 没有线性相关关系, 这种形式的回归方程就没有意义 .
i 1
ˆ 0 y ˆ1 x
x
1 n
n i 1
xi
y
1 n
n i 1
yi
n
n
若记பைடு நூலகம்Lxx ( xi x )2 xi2 nx 2
i 1
i 1
n
n
Lxy ( xi x )( yi y ) xi yi nxy
i 1
i 1
n
n
Lyy ( yi y )2 yi2 ny 2
y x 1
高尔顿对此进行了深入研究.他们将观察值在平 面直角坐标系上绘成散点图,发现趋势近乎一条直线, 计算出的回归直线方程为
yˆ 3 3 .7 3 0 .5 1 6 x
在回归分析中, 当自变量只有两个时, 称 为一元回归分析; 当自变量在两个以上时, 称 为多元回归分析. 变量间成线性关系, 称线性 回归,变量间不具有线性关系, 称非线性回归.
统计学中的回归分析方法
统计学中的回归分析方法统计学是一门应用科学,可以帮助我们理解和解释数据。
在统计学中,回归分析是一种常用的方法,用于研究变量之间的关系以及预测未来的趋势。
回归分析是一种基于概率论和数理统计的方法,用于描述和模拟数据的线性关系。
通过回归分析,我们可以确定一个或多个自变量与因变量之间的数学关系。
这使得我们能够根据已有的数据预测未来的趋势和结果。
回归分析的核心概念是回归方程。
回归方程是用于描述自变量与因变量之间关系的数学公式。
在简单线性回归中,回归方程可以用y = a+ bx来表示,其中y是因变量,x是自变量,a和b是回归方程的参数。
通过回归方程,我们可以计算自变量对因变量的影响程度。
回归的目标是找到最适合数据的回归方程,并通过该方程对未知数据做出预测。
回归分析有不同的类型。
简单线性回归是最基本的形式,用于研究两个变量之间的关系。
多元线性回归则用于研究多个自变量对因变量的影响。
此外,还有逻辑回归用于处理二元分类问题,和多项式回归适用于非线性关系。
回归分析还可以帮助我们评估各个变量对因变量的相对重要性。
通过计算回归方程中各个参数的显著性,我们可以确定哪些自变量对因变量的影响更为显著。
在回归分析中,误差的处理也是非常重要的。
误差代表了回归模型无法解释的数据波动。
最小二乘法是一种常用的方法,用于最小化回归模型的总体误差。
除了简单的回归分析,还有一些衍生的方法可以扩展回归模型的适用范围。
岭回归和Lasso回归是用于应对多重共线性问题的方法。
弹性网络回归则是将岭回归和Lasso回归进行结合,取两种方法的优点。
回归分析在许多领域都有广泛的应用。
在经济学中,回归分析常用于研究经济指标之间的关系。
在市场营销中,回归模型可以用于预测销量和分析市场趋势。
在医学研究中,回归分析可以帮助研究人员研究疾病和治疗方法之间的关系。
总之,统计学中的回归分析是一种强大的工具,用于研究变量之间的关系和预测未来的趋势。
通过回归分析,我们可以理解数据并做出有意义的预测。
数理统计分析知识及回归分析方法
数理统计分析知识及回归分析方法把研究对象的全体称为总体,构成总体的每个单位称为 个体,通常用N 表示总体所包含的个体数。
总体的一部分称 为样本(或成子样),通常用n 表示样本所含的个体数,称 为样本容量。
从总体中抽区样本称为抽样。
若总体中每个个体被抽取的可能性相同,这样的抽样称为随机抽样,所获得的样本称 为随机样本。
在许多情况下不可能直接试验或研究总体,例如灯泡的 寿命、混凝土强度等,总是采用抽样的方法,通过试验或研 究样品的特性,去估计该批产品的特性或质量状况。
数理统 计就是一种以概率论为理论基础、 通过研究随机样本(样品) 对总体的特性或质量状况作出估计和评价的方法。
对于工程试验中常见的正态分布,主要计算样本的三个 统计量,即平均值、标准差(或极差)和变异系数。
一、样本平均值:以算术平均值 X 表示,可按下式计xi式中:xi ——各个试验数据试验数据个数nxi各个试验数据之和、样本标准差:以标准差s表示,可按下式计算:xi上式又称贝塞尔公式。
标准差表示一组试验数据对于其平均值的离散程度,也就是数据的波动情况,具有与平均值相同的量纲。
在相同平均值条件下,标准差大表示数据离散程度大,即波动大;标准差小表示数据离散程度小,波动小三、样本极差:极差也可以表示数据的离散程度。
极差是数据中最大值与最小值之差:极差也可以表示数据的离散程度。
极差是数据中最大值与最小值之差:当一批数据不多时(n W 10),可用样本极差估计总体标准差:A式中::标准差的估计值;R :极差;dn:与n有关的系数,一般,dn可近似地取为:X max x mins1ni 1,2< n W 10四、样本变异系数:变异系数表示数据的相对波动大小,按下式表示:sC v 100%x数据的性Cv可用于不同平均制条件下数据饿波动情况,更能反映质。
回归分析回归分析是一重处理变量与变量之间关系的数学方法。
变量与变量之间存在对应关系的,称为函数关系。
数理统计回归分析
Y XB E ( ) 0 Cov( ) 2 I
(6)
这里 X 为 n ( p 1) 的设计矩阵. Y 为 n 1的观测向 n 1 随机误差向量 量. B 为 p 1 的未知数参数向量, I 是 n 阶单位矩阵。当误差 Cov( ) 为其协方差阵, 服从正态分布 ~ N (0 , 2 I ) .
• 通常假定 ε~N(0, σ2);
根据回归函数的不同形式, 可分为
一元线性回归 线性回归 多元线性回归 非线性回归一元非线性回归 多元非线性回归
数据 ( xi , y i ) 满足
yi a bxi i , i 1, 2 ,, n
其中误差 i 表示 y i 中不能由 a bxi 来表示的部分 我们自然假设其均值为零,即 E ( i ) 0 通常还假设 它满足 : (1) Var ( i ) 2 , i 1, 2 ,, n ; (2) Cov( i , j ) 0 , i j
b 求偏导数,令他们等于零, 将 Q(a, b) 分别对 a , 得到方程组:
n Q 2 ( y i a bxi ) 0 a i 1 Q n 2 ( y i a bxi ) xi 0 i 1 b
这些假设被称为Gauss-Markov假设,这里第一条假 设误差 i 是等方差的.第二条则要求不同次的观测 误差是不相关的.
b 是待估计参数,估计他们的 (1)式中未知数 a 、 ˆ 是用最小二乘 ˆ 与b 最基本方法是最小二乘法,设 a 法获得的估计,即所谓的最小二乘估计,将它们代 入一元线性回归模型并略去误差项 ,即对给定的 x ,得到方程:
若进行 n 次独立测量,得到样本: