
高斯混合模型EM算法
Another way of knowing: p(X , Z |θ) Q (Z )
L(θ|X ) = ln (p(X |θ)) ≥
Z
ln
Q (Z )
is to use Jensen’s inequality:
L(θ|X ) = ln p(X |θ) = ln
Z
p (X , Z | θ )
= ln
Z
When you have data that looks like:
Can you fit them using a single-mode Gaussian distribution, i.e.,: p(X ) = N (X |µ, Σ) = (2π )−k /2 |Σ|− 2 exp− 2 (x −µ)
i =1
pi f (xi )
≤
i =1
pi Φ(f (xi ))
by replacing xi with f (xi ) p(x ) = 1:
Can also generalised to the continous case, by letting
x ∈S
Φ
x ∈S
f (x )p(x )
≤
x ∈S
1 1 T
Σ−1 (x −µ)
Clearly NOT! This is typically modelling using Mixture Densities, in the case of Gaussian Mixture Model (k-mixture) (GMM):
k k
p (X ) =
l =1
Θ(g +1) = arg max
θ z
log (p(X , Z |θ))p(Z |X , Θ(g ) ) dz
However, we must ensure convergence: log[p(X |Θ(g +1) )] = L(Θ(g +1) ) ≥ L(Θ(g ) )
∀i
Richard Yi Da Xu
Since Φ(.) = − ln is a convex unction:
Richard Yi Da Xu
Expectation Maximization
The E-M Examples
Gaussian Mixture Model Probabilistic Latent Semantic Analysis (PLSA)
Figure: gmm fitting result
Richard Yi Da Xu
Expectation Maximization
Convห้องสมุดไป่ตู้x function
f ((1 − t )x1 + tx2 ) ≤ (1 − t )f (x1 ) + tf (x2 )
t ∈ (0 . . . 1)
Richard Yi Da Xu
z ∈S
ln[p(Z , X , θ)]p(z |X , Θ(g ) )dz −
z ∈S
ln[p(Z |X , θ)]p(z |X , Θ(g ) )dz ln[p(Z |X , θ)]p(z |X , Θ(g ) )dz
z ∈S H (θ,Θ(g )
=⇒ ln[p(X |θ)] =
z ∈S
ln[p(Z , X , θ)]p(z |X , Θ(g ) )dz −
Φ(f (xi ))p(x ) =⇒ ΦE[f (x )] ≤ E[Φ(f (xi ))]
Richard Yi Da Xu
Expectation Maximization
Jensens inequality: − log(x )
Φ(x ) = − log(x ) is a convex function: when Φ(.) is convex ΦE[f (x )] ≤ E[Φ(f (xi ))] =⇒ − log E[f (x )] ≤ E[− log(f (xi ))] when Φ(.) is concave ΦE[f (x )] ≥ E[Φ(f (xi ))] =⇒ − log E[f (x )] ≥ E[− log(f (xi ))]
αl N (X |µl , Σl )
l =1
αl = 1
Richard Yi Da Xu
Expectation Maximization
Gaussian Mixture model result
Let Θ = {α1 , . . . αk , µ1 , . . . µk , Σ1 , . . . Σk } ΘMLE = arg max L(Θ|X )
H (Θ(g ) , Θ(g ) ) − H (θ, Θ(g ) ) ≥ 0 ∀θ
H (Θ(g ) , Θ(g ) ) − H (θ, Θ(g ) ) =
z ∈S
ln[p(Z |X , Θ(g ) )]p(z |X , Θ(g ) )dz −
z ∈S
ln[p(Z |X , θ)]p(z |X , Θ
Expectation Maximization
Proof of convergence: “Tagare” approach (1)
L(θ|X ) = ln[p(X |θ)] = ln[p(Z , X , θ)] − ln[p(Z |X , θ)] =⇒
z ∈S
ln[p(X |θ)]p(z |X , Θ(g ) )dz =
Then L(Θ(g +1) = Q (Θ(g +1) , Θ(g ) ) − H (Θ(g +1) , Θ(g ) ) ≥ Q (Θ(g ) , Θ(g ) ) − H (Θ(g ) , Θ(g ) ) = L(Θ(g )
≥Q (Θ(g ) ,Θ(g ) ) ≤H (Θ(g ) ,Θ(g ) )
Richard Yi Da Xu
Θ
= arg max
Θ
n
k
αl N (X |µl , Σl )
log
i =1 l =1
Unlike single mode Gaussian, we can’t just take derivatives and let it equal zero easily. We need to use Expectation-Maximization to help us solving this
E-M becomes a M-M algorithm p(X , Z |Θ) Q (Z ) Q (Z ) p(Z |X , Θ)
L(Θ|X ) =
Z
ln
Q (Z ) +
Z
ln
Q (Z )
= F (Θ, Q ) + KL(Q (Z ) p(Z |X , Θ)) STEP 1 Fix Θ = Θ(g ) , maximize Q (Z ) L(Θ|X ) is fixed, i.e., indepedant of Q (Z ). Therefore, L(Θ|X ) is the upper bound of F (Θ, Q ). To make L(Θ|X ) = F (Θ, Q ), i.e, KL(.) = 0, we choose Q (Z ) = p(Z |X , Θ(g ) ). Therefore:
Z
Q (Z ) +
Q (Z ) p (Z | X , θ )
Q (Z )
=
Z
Q (Z ) + KL(Q (Z ) p(Z |X , θ))
≥0
= F (θ, Q ) +
Q (Z ) p(Z |X , θ)
Q (Z )
Richard Yi Da Xu
Expectation Maximization
Proof of convergence: using M-M (2)
=
z ∈S
ln
p(Z |X , Θ(g ) ) p(z |X , Θ(g ) )dz = p (Z | X , θ )
− ln
z ∈S
p(Z |X , θ) p(z |X , Θ(g ) )dz p(Z |X , Θ(g ) )
≥ − ln
z ∈S
p(Z |X , θ) p(z |X , Θ(g ) )dz = 0 p(Z |X , Θ(g ) )
Figure: plot of Φ(x ) = − log(x )
Richard Yi Da Xu
Expectation Maximization
The Expectation-Maximization Algorithm
Instead of perform: θMLE = arg max(L(θ)) = arg max (log[p(X |θ)])
= ln = ln =⇒ ln (p(X |θ)) =
Z
p(X , Z |θ) Q (Z ) × Q (Z ) p(Z |X , θ) p(X , Z |θ) Q (Z ) ln ln + ln Q (Z ) p (Z | X , θ ) ln
Z
p(X , Z |θ) Q (Z ) p(X , Z |θ) Q (Z ) ln
p(X , Z |θ) Q (Z ) Q (Z )
ln EQ (z ) [f (Z )]
≥
Z
ln
p(X , Z |θ) Q (Z )
EQ (z ) ln[f (Z )]
Q (Z )
Richard Yi Da Xu
Expectation Maximization
Proof of convergence: using M-M (3)
n i =1
t ∈ (0 . . . 1)
pi = 1:
n
EM算法用于高斯混合模型

EM算法用于高斯混合模型高斯混合模型(Gaussian Mixture Model,简称GMM)是一种常用的概率密度估计方法,其基本思想是将数据分解为由多个高斯分布组成的混合模型。
每个高斯分布对应于数据中的一个潜在类别,而混合系数则表示每个类别的权重。
GMM的参数估计通常使用期望最大化(Expectation Maximization,简称EM)算法来进行。
EM算法是一种迭代优化算法,用于求解含有隐变量的最大似然估计问题。
GMM中,EM算法被用来最大化对数似然函数,从而估计GMM的参数。
EM算法的基本思想是,在每一次迭代中,先进行E步(Expectation),计算隐变量在给定参数下的后验概率。
然后进行M步(Maximization),通过极大化对数似然函数来估计参数。
重复执行E步和M步,直到收敛为止。
在GMM中,E步计算的是隐藏变量对应的后验概率,即每个样本属于每个高斯分布的概率。
这个概率可以使用贝叶斯公式计算得到。
假设有N个样本,K个高斯分布,那么对于每个样本i和高斯分布j,可以计算其后验概率:$$w_{ij} = \frac{\pi_j \cdot \mathcal{N}(x_i,\mu_j,\Sigma_j)}{\sum_{k=1}^{K} \pi_k \cdot \mathcal{N}(x_i,\mu_k,\Sigma_k)}$$其中,$w_{ij}$表示样本i属于高斯分布j的后验概率,$\pi_j$表示高斯分布j的混合系数,$\mathcal{N}(x_i,\mu_j,\Sigma_j)$表示高斯分布j的概率密度函数。
在M步中,需要利用E步计算得到的后验概率,更新GMM的参数。
更新过程分两步进行:首先,根据后验概率的加权平均来更新混合系数,即每个高斯分布对应的权重;然后,根据后验概率的加权平均来更新高斯分布的均值和协方差矩阵。
混合系数的更新可以通过对每个高斯分布的后验概率求平均得到:$$\pi_j = \frac{1}{N} \sum_{i=1}^{N} w_{ij}$$高斯分布的均值和协方差矩阵的更新可以通过将样本加权平均来得到:$$\mu_j = \frac{1}{\sum_{i=1}^{N} w_{ij}} \sum_{i=1}^{N} w_{ij} \cdot x_i$$$$\Sigma_j = \frac{1}{\sum_{i=1}^{N} w_{ij}} \sum_{i=1}^{N}w_{ij} \cdot (x_i - \mu_j)(x_i - \mu_j)^T$$重复执行E步和M步,直到收敛为止。
混合高斯模型和EM算法
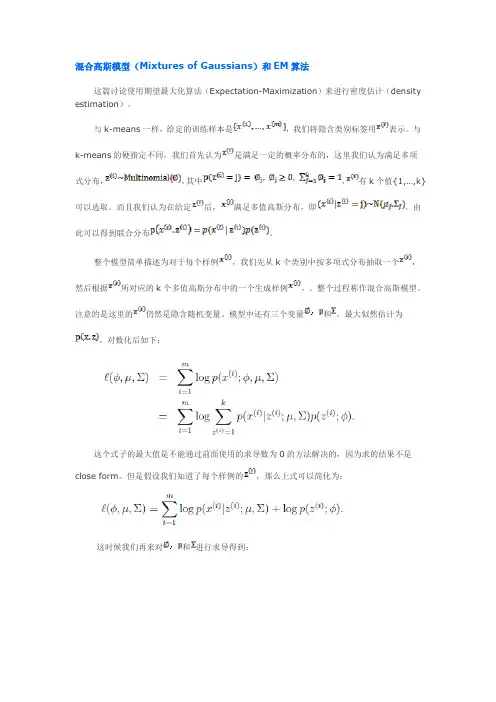
混合高斯模型(Mixtures of Gaussians)和EM算法这篇讨论使用期望最大化算法(Expectation-Maximization)来进行密度估计(density estim ation)。
与k-m eans一样,给定的训练样本是,我们将隐含类别标签用表示。
与k-m eans的硬指定不同,我们首先认为是满足一定的概率分布的,这里我们认为满足多项式分布,,其中,有k个值{1,…,k}可以选取。
而且我们认为在给定后,满足多值高斯分布,即。
由此可以得到联合分布。
整个模型简单描述为对于每个样例,我们先从k个类别中按多项式分布抽取一个,然后根据所对应的k个多值高斯分布中的一个生成样例,。
整个过程称作混合高斯模型。
注意的是这里的仍然是隐含随机变量。
模型中还有三个变量和。
最大似然估计为。
对数化后如下:这个式子的最大值是不能通过前面使用的求导数为0的方法解决的,因为求的结果不是close form。
但是假设我们知道了每个样例的,那么上式可以简化为:这时候我们再来对和进行求导得到:就是样本类别中的比率。
是类别为j的样本特征均值,是类别为j的样例的特征的协方差矩阵。
实际上,当知道后,最大似然估计就近似于高斯判别分析模型(Gaussian discriminant analysis m odel)了。
所不同的是GDA中类别y是伯努利分布,而这里的z是多项式分布,还有这里的每个样例都有不同的协方差矩阵,而GDA中认为只有一个。
之前我们是假设给定了,实际上是不知道的。
那么怎么办呢?考虑之前提到的EM 的思想,第一步是猜测隐含类别变量z,第二步是更新其他参数,以获得最大的最大似然估计。
用到这里就是:在E步中,我们将其他参数看作常量,计算的后验概率,也就是估计隐含类别变量。
估计好后,利用上面的公式重新计算其他参数,计算好后发现最大化最大似然估计时,值又不对了,需要重新计算,周而复始,直至收敛。
的具体计算公式如下:这个式子利用了贝叶斯公式。
机器学习算法总结(六)——EM算法与高斯混合模型

机器学习算法总结(六)——EM算法与⾼斯混合模型 极⼤似然估计是利⽤已知的样本结果,去反推最有可能(最⼤概率)导致这样结果的参数值,也就是在给定的观测变量下去估计参数值。
然⽽现实中可能存在这样的问题,除了观测变量之外,还存在着未知的隐变量,因为变量未知,因此⽆法直接通过最⼤似然估计直接求参数值。
EM算法是⼀种迭代算法,⽤于含有隐变量的概率模型的极⼤似然估计,或者说是极⼤后验概率估计。
1、经典的三硬币模型 引⼊⼀个例⼦来说明隐变量存在的问题。
假设有3枚硬币,分别记作A,B,C。
这些硬币正⾯出现的概率分别是π,p,q。
我们的实验过程如下,先投掷硬币A,根据其结果选出硬币B和硬币C,正⾯选B,反⾯选C;然后投掷选出的硬币,此时出现正⾯记作1,出现反⾯记作0。
在这个例⼦中我们观察到的变量只是B或者C的结果,⽽对A的结果并不知道,在这⾥A的结果也就是我们的隐变量。
A的结果对最终的结果是有影响的,因此在估计参数时必须将A的结果考虑进去。
1、EM算法 我们将观测变量表⽰为Y = (Y1,Y2,....,Y n),隐变量表⽰为Z = (Z1,Z2,....,Z n),则观测数据的似然函数可以表⽰为 在这⾥P(Y|θ) 是P(Y, Z|θ) 的边缘概率,通过转换后可以表⽰成右边的形式,我们将其转换成对数形式,这样便于求联合概率 然⽽对于这样的式⼦直接根据极⼤化求θ的值是很困难的,因为这⾥还存在隐变量Z,在这⾥引⼊EM算法,通过迭代求解,假设在第i 次迭代后θ的估计值为θ(i)。
我们希望新估计值能是L(θ)增加,通过迭代逐步的达到最⼤值。
为此我们考虑第i+1步迭代后两者的差: 利⽤Jensen不等式将上述式⼦展开并得到其下界(对数函数是凹函数): 令 则有 在这⾥B(θ, θ(i)) 是L(θ) 的⼀个下界,⽽且由的表达式可知 因此任何能使得B(θ, θ(i)) 增⼤的θ,也能使得L(θ) 增⼤。
因此求θ值使得B(θ, θ(i)) 增⼤就可以转变成求θ使得L(θ) 增⼤,即求 将上述式⼦展开可得(在这⾥去掉常数项,因为常数项不会影响最终的结果) 因此问题就演变成了求Q函数的极⼤化。
EM算法用于高斯混合模型

EM算法用于高斯混合模型EM算法(Expectation-Maximization algorithm)是一种迭代算法,用于估计含有隐变量的概率模型参数。
它被广泛应用于高斯混合模型(Gaussian Mixture Model,GMM)的参数估计。
GMM 是一种概率模型,它由若干个高斯分布组成,每个高斯分布对应数据的一个分量。
具体来说,EM算法包含两个步骤:E步骤(Expectation step)和M步骤(Maximization step)。
在E步骤中,给定当前参数估计,我们计算隐变量的期望值。
而在M步骤中,根据这些隐变量的期望值,我们重新估计参数。
这两个步骤会反复迭代,直到参数收敛为止。
首先,我们来看E步骤。
在GMM中,每个观测值都可以由多个高斯分布生成。
我们需要计算每个数据点属于每个高斯分布的后验概率。
这个后验概率可以表示为每个高斯分布生成一些数据点的概率除以所有高斯分布生成这个数据点的概率之和。
这个后验概率即为数据点属于每个高斯分布的权重。
计算后验概率的方法是使用贝叶斯公式。
然后,我们来看M步骤。
在M步骤中,我们根据E步骤计算得到的后验概率,重新估计高斯分布的参数。
具体来说,对于每个高斯分布,我们计算其均值和协方差矩阵。
均值可以通过将数据点乘以其对应的后验概率,再除以所有后验概率之和来计算。
协方差矩阵可以通过计算每个数据点与对应高斯分布的均值之间的差的外积,再乘以其对应的权重,最后除以所有权重之和来计算。
在每次迭代中,E步骤和M步骤会交替进行,直到算法收敛。
算法的收敛条件可以选择参数变化的很小或达到一定的迭代次数。
在每次迭代中,EM算法会逐渐提高对数据的拟合程度,也就是逐渐改善参数的估计。
EM算法有很多优点。
首先,它是一种通用的算法,适用于各种类型的概率模型估计。
其次,EM算法在估计参数时可以有很大的灵活性,可以根据需求自定义参数的个数和选择去模型每个分量的数据。
此外,EM 算法收敛到局部最优,而跳出局部最优通常需要全局优化方法。
聚类之高斯混合模型与EM算法
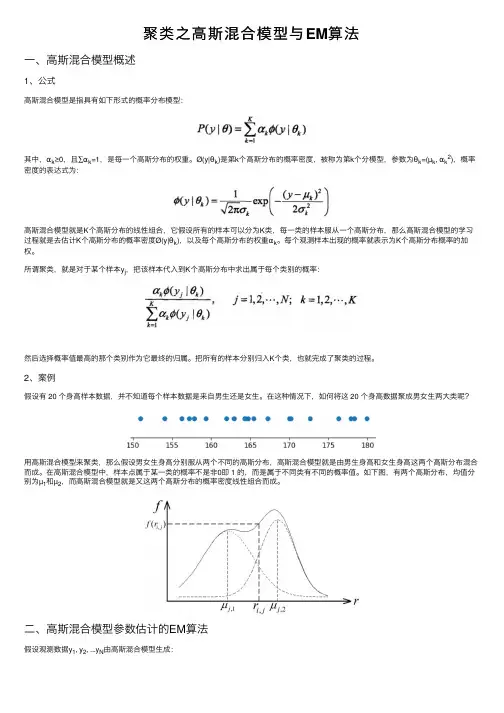
聚类之⾼斯混合模型与EM算法⼀、⾼斯混合模型概述1、公式⾼斯混合模型是指具有如下形式的概率分布模型:其中,αk≥0,且∑αk=1,是每⼀个⾼斯分布的权重。
Ø(y|θk)是第k个⾼斯分布的概率密度,被称为第k个分模型,参数为θk=(µk, αk2),概率密度的表达式为:⾼斯混合模型就是K个⾼斯分布的线性组合,它假设所有的样本可以分为K类,每⼀类的样本服从⼀个⾼斯分布,那么⾼斯混合模型的学习过程就是去估计K个⾼斯分布的概率密度Ø(y|θk),以及每个⾼斯分布的权重αk。
每个观测样本出现的概率就表⽰为K个⾼斯分布概率的加权。
所谓聚类,就是对于某个样本y j,把该样本代⼊到K个⾼斯分布中求出属于每个类别的概率:然后选择概率值最⾼的那个类别作为它最终的归属。
把所有的样本分别归⼊K个类,也就完成了聚类的过程。
2、案例假设有 20 个⾝⾼样本数据,并不知道每个样本数据是来⾃男⽣还是⼥⽣。
在这种情况下,如何将这 20 个⾝⾼数据聚成男⼥⽣两⼤类呢?⽤⾼斯混合模型来聚类,那么假设男⼥⽣⾝⾼分别服从两个不同的⾼斯分布,⾼斯混合模型就是由男⽣⾝⾼和⼥⽣⾝⾼这两个⾼斯分布混合⽽成。
在⾼斯混合模型中,样本点属于某⼀类的概率不是⾮0即 1 的,⽽是属于不同类有不同的概率值。
如下图,有两个⾼斯分布,均值分别为µ1和µ2,⽽⾼斯混合模型就是⼜这两个⾼斯分布的概率密度线性组合⽽成。
⼆、⾼斯混合模型参数估计的EM算法假设观测数据y1, y2, ...y N由⾼斯混合模型⽣成:其中,要估计的参数θ=(α1, α2, ...αK; θ1, θ2, ..., θK),θk=(µk, αk2),k=1,2,...,K。
因此如果⾼斯混合模型由K个⾼斯分布混合⽽成,那么就有3K个参数需要估计。
我们⽤极⼤似然估计法来估计参数θ,也就是求参数θ,使得观测数据y的对数似然函数L(θ)=logP(y|θ)的极⼤化:由于对数似然函数L(θ)中包含了和的对数,⽐较难以求解,因此考虑⽤EM算法。
EM算法详细例子及推导

EM算法详细例子及推导EM算法(Expectation-Maximization Algorithm)是一种用于求解含有隐变量(latent variable)的概率模型的参数估计方法。
其基本思想是通过迭代的方式,通过观测数据得到对隐变量的估计,然后再基于该估计对模型参数进行优化。
下面我们以一个简单的高斯混合模型为例,详细介绍EM算法的推导和实例。
1. 高斯混合模型(Gaussian Mixture Model, GMM)高斯混合模型是一种概率模型,由多个高斯分布组合而成。
假设我们观测到的数据由K个高斯分布组成,每个高斯分布对应一个参数向量:均值miu和方差sigma^2、同时,我们还有一个隐变量Z,表示观测数据属于哪个高斯分布,取值范围为{1,2,...,K}。
2.EM算法EM算法的核心思想是通过交替进行两个步骤:E步(Expectation)和M步(Maximization)。
在E步中,我们对当前模型参数下的隐变量进行估计,得到对隐变量的最大似然估计。
在M步中,我们利用得到的隐变量估计更新模型参数,使模型对观测数据的似然函数最大化。
不断重复这两步直至模型收敛。
下面我们通过具体的例子来推导EM算法。
假设我们观测到了一个数据集X = {x1, x2, ..., xn},我们希望通过EM算法对其进行建模。
Step1: 初始化模型参数首先,我们需要初始化模型参数。
选择K个高斯分布的参数miu和sigma^2,并假设所有的高斯分布对应的隐变量Z服从均匀分布。
这时,我们得到了初始模型参数Theta = {miu1, sigma^21, ..., miuK,sigma^K, pi1, pi2, ..., piK}。
Step2: E步,计算隐变量的后验分布在E步中,我们计算隐变量的后验分布。
对于每个观测样本xi,我们计算其属于每个高斯分布的概率,即:gamma(k,i) = P(Zi=k,xi, Theta) = P(Zi=k,xi, miu_k,sigma_k^2) = pi_k * N(xi,miu_k, sigma_k^2) / sum(pi_j * N(xi,miu_j, sigma_j^2), j=1 to K其中N(xi,miu_k, sigma_k^2)表示xi在第k个高斯分布下服从的概率密度函数。
混合高斯分布的em算法
混合高斯分布的em算法
混合高斯分布是一种常用的数据建模方法,它假设数据样本是由多个高斯分布的混合所组成。
EM算法是一种用于估计混合高斯分布参数的常用方法。
具体步骤如下:
1. 初始化混合系数、均值和协方差矩阵:随机初始化混合系数、均值和协方差矩阵来作为模型参数。
2. E步骤:计算每个样本点属于每个高斯分布的概率。
3. M步骤:基于E步骤中计算出的概率,分别计算每个高斯分布的混合系数、均值和协方差矩阵。
4. 重复执行E步骤和M步骤,直到似然函数收敛或达到指定的最大迭代次数。
5. 输出混合系数、均值和协方差矩阵作为混合高斯分布模型的参数。
EM算法的核心是通过E步骤计算样本点的概率,并通过M步骤更新混合高斯分布的模型参数。
这两个步骤交替执行,不断迭代,直到达到收敛条件。
最终得到的模型可以用于数据分类、聚类等应用中。
EM算法
• 优点:EM算法简单且稳定,迭代能保证观察数据对数后验似然是单调不减的。
• 缺点:对于大规模数据和多维高斯分布,迭代速度易受影响;算法收敛速度,非 常依赖初始值的设置,设置不当,计算时代价大;EM算法中的M-Step依然是采用 求导函数的方法,所以它找到的是极值点,即局部最优解,而不一定是全局最优解。
log似然函数定义为 l( | ) log L( | )
^
的极大似然估计为 arg max L( | )
当这个概率表示在概率密度函数的参数是θ时,得到X这组样本的概率。
arg maxl( | )
因为这里X是已知的,抽取样本也是已知的,所以它是θ的函数。称为参数θ相对于样本集X的似然
函数(likehood function)。记为L(θ)。
问题:当抽取得到的每个样本都不知道是从哪个分布抽取的
需要估计: 一、样本的所属类别? 二、各类别所对应的高斯分布的参数是多少?
EM算法的基本思想
EM算法的基本思想通俗说明:
在开始状态下参数均未知,但假定已知A的信息就可以得到B的信息,反过来知道了 B也就得到了A。可以考虑首先赋予A某种初值,以此得到B的估计值,然后从B的当 前值出发,重新估计A的取值,持续迭代直到收敛为止。
(1,xpectation Maximization)算法最典型的应用
最大似然函数
从分布是p(x|θ)的总体样本中抽取到n个样本的概率,用下式表示:
n
L( ) L(x1, x2,..., xn; ) p(xi; ), i1
高斯混合模型参数估计的EM算法(以高维数据为例)
EM算法总结
• EM算法是一种迭代算法,主要用于计算后验分布的众数或极大似然估计,广泛地 应用于缺损数据、截尾数据、成群数据、带有讨厌参数的数据等所谓不完全数据 的统计推断问题。
EM算法应用(1)-高斯混合模型
高斯混合模型(聚类).定义:122(y |)(y |)(y )..(y |))2Kk k k k k k p s t θαφθμφθσ==-=-∑ 由K 个高斯分布混合而成的分布模型红色线为最终模型的分布曲线。
其是由三个用蓝色线的高斯分布模型混合而成。
对于图像上某一点有:112233(x)(x)(x)(x)P p p p ααα=++类似于其他模型使用极大似然方法求解:求解一个分布函数p(x)使得按照这个分布,观测数据出现的概率最大。
对上述目标函数取对数有:可以发现上面函数包含和的对数。
很难通过求取偏导数而获得参数的值。
下面讲述如通过EM算法求解的思路。
一个假设:先假定,如果这个观测数据只是由其中一个高斯模型K产生,则隐变量是一个向量,并且这个向量中只有一个元素取值为1,其它的都是0。
然后计算分模型K对观测数据的响应度(E步)。
该响应度是一个概率值,表示该观测由该高斯分量唯一生成的概率值。
每个高斯分量其实都可以产生这个观测数据只是输出不同而已,即产生观测数据的概率不同。
最后,根据每个高斯分量对观测数据的响应度,计算更新每个分模型的参数,以及汇总出整个GMM产生这个观测数据的每个分模型权值。
计算过程分析:GMM:先计算所有数据对每个分模型的响应度。
求响应度隐变量的均值。
根据响应度计算每个分模型的参数。
极大化模型的似然函数迭代K-means:先计算所有数据对于K个点的距离,取距离最近的点作为自己所属于的类根据上一步的类别划分更新点的位置(点的位置就可以看做是模型参数)迭代Kmeans与高斯混合模型的异同点可以看出GMM和K-means还是有很大的相同点的。
GMM中高斯分量对数据的响应度就相当于K-means中根据距离,划分样本到与其最近的聚类中心,GMM中的根据响应度计算高斯分量参数就相当于K-means中计算聚类中心点的位置。
然后它们都通过不断迭代达到最优。
不同的是:GMM模型给出的是每一个观测点由哪个高斯分量生成的概率,而K-means直接给出一个观测点属于哪一类。
混合高斯模型EM算法
混合高斯模型EM算法1.归纳偏执在机器学习中,一个学习算法也会有一个前提假设,这里被称作“归纳偏执(bias)”(bias 这个英文词在机器学习和统计里还有其他许多的意思)。
例如线性回归,目的是要找一个函数尽可能好地拟合给定的数据点,它的归纳偏执就是“满足要求的函数必须是线性函数”。
一个没有归纳偏执的学习算法从某种意义上来说毫无用处,就像一个完全没有归纳能力的人一样,在第一次看到鱼的时候有人告诉他那是鱼,下次看到另一条鱼了,他并不知道那也是鱼,因为两条鱼总有一些地方不一样的,或者就算是同一条鱼,在河里不同的地方看到,或者只是看到的时间不一样,也会被他认为是不同的,因为他无法归纳,无法提取主要矛盾、忽略次要因素。
机器学习中称作“过拟合(Overfitting)”,没有归纳偏执或者归纳偏执太宽泛会导致Overfitting ,然而另一个极端──限制过大的归纳偏执也是有问题的:如果数据本身并不是线性的,强行用线性函数去做回归通常并不能得到好结果。
难点正在于在这之间寻找一个平衡点。
2.GMM作为一个流行的算法,GMM 肯定有它自己的一个相当体面的归纳偏执了。
其实它的假设非常简单,顾名思义,Gaussian Mixture Model ,就是假设数据服从Mixture Gaussian Distribution ,换句话说,数据可以看作是从数个Gaussian Distribution 中生成出来的。
另外,Mixture Model 本身其实也是可以变得任意复杂的,通过增加Model 的个数,我们可以任意地逼近任何连续的概率密分布。
每个GMM 由K个Gaussian分布组成,每个Gaussian 称为一个“Component”,这些Component 线性加成在一起就组成了GMM 的概率密度函数:根据上面的式子,如果我们要从 GMM 的分布中随机地取一个点的话,实际上可以分为两步:首先随机地在这 K 个 Component 之中选一个,每个 Component 被选中的概率实际上就是它的系数 k π ,选中了 Component 之后,再单独地考虑从这个 Component 的分布中选取一个点就可以了──这里已经回到了普通的 Gaussian 分布,转化为了已知的问题。