
(完整版)计量经济学知识点(超全版)
1.经济变量:经济变量是用来描述经济因素数量水平的指标。
(3分)2.解释变量:是用来解释作为研究对象的变量(即因变量)为什么变动、如何变动的变量。
(2分)它对因变量的变动做出解释,表现为方程所描述的因果关系中的“因”。
(1分)3.被解释变量:是作为研究对象的变量。
(1分)它的变动是由解释变量做出解释的,表现为方程所描述的因果关系的果。
(2分)4.内生变量:是由模型系统内部因素所决定的变量,(2分)表现为具有一定概率分布的随机变量,是模型求解的结果。
(1分)5.外生变量:是由模型系统之外的因素决定的变量,表现为非随机变量。
(2分)它影响模型中的内生变量,其数值在模型求解之前就已经确定。
(1分)6.滞后变量:是滞后内生变量和滞后外生变量的合称,(1分)前期的内生变量称为滞后内生变量;(1分)前期的外生变量称为滞后外生变量。
(1分)7.前定变量:通常将外生变量和滞后变量合称为前定变量,(1分)即是在模型求解以前已经确定或需要确定的变量。
(2分)8.控制变量:在计量经济模型中人为设置的反映政策要求、决策者意愿、经济系统运行条件和状态等方面的变量,(2分)它一般属于外生变量。
(1分)9.计量经济模型:为了研究分析某个系统中经济变量之间的数量关系而采用的随机代数模型,(2分)是以数学形式对客观经济现象所作的描述和概括。
(1分)10.函数关系:如果一个变量y的取值可以通过另一个变量或另一组变量以某种形式惟一地、精确地确定,则y与这个变量或这组变量之间的关系就是函数关系。
(3分)11.相关关系:如果一个变量y的取值受另一个变量或另一组变量的影响,但并不由它们惟一确定,则y与这个变量或这组变量之间的关系就是相关关系。
(3分)12.最小二乘法:用使估计的剩余平方和最小的原则确定样本回归函数的方法,称为最小二乘法。
(3分)13.高斯-马尔可夫定理:在古典假定条件下,OLS估计量是模型参数的最佳线性无偏估计量,这一结论即是高斯-马尔可夫定理。
(3分)14.总变差(总离差平方和):在回归模型中,被解释变量的观测值与其均值的离差平方和。
(3分)15.回归变差(回归平方和):在回归模型中,因变量的估计值与其均值的离差平方和,(2分)也就是由解释变量解释的变差。
(1分)16.剩余变差(残差平方和):在回归模型中,因变量的观测值与估计值之差的平方和,(2分)是不能由解释变量所解释的部分变差。
(1分)17.估计标准误差:在回归模型中,随机误差项方差的估计量的平方根。
(3分)18.样本决定系数:回归平方和在总变差中所占的比重。
(3分)19.点预测:给定自变量的某一个值时,利用样本回归方程求出相应的样本拟合值,以此作为因变量实际值和其均值的估计值。
(3分)20.拟合优度:样本回归直线与样本观测数据之间的拟合程度。
(3分)21.残差:样本回归方程的拟合值与观测值的误差称为回归残差。
(3分)22.显著性检验:利用样本结果,来证实一个虚拟假设的真伪的一种检验程序。
(3分)23.回归变差:简称ESS,表示由回归直线(即解释变量)所解释的部分(2分),表示x对y的线性影响(1分)。
24.剩余变差:简称RSS,是未被回归直线解释的部分(2分),是由解释变量以外的因素造成的影响(1分)。
25.多重决定系数:在多元线性回归模型中,回归平方和与总离差平方和的比值(1分),也就是在被解释变量的总变差中能由解释变量所解释的那部分变差的比重,我们称之为多重决定系数,仍用R 2表示(2分)。
26.调整后的决定系数:又称修正后的决定系数,记为2R ,是为了克服多重决定系数会随着解释变量的增加而增大的缺陷提出来的,(2分) 其公式为:22/(1)1()/(1)tte n k R y y n --=---∑∑(1分)。
27.偏相关系数:在Y 、X 1、X 2三个变量中,当X 1 既定时(即不受X 1的影响),表示Y 与X 2之间相关关系的指标,称为偏相关系数,记做 2.1Y R 。
(3分)28.异方差性:在线性回归模型中,如果随机误差项的方差不是常数,即对不同的解释变量观测值彼此不同,则称随机项i u 具有异方差性。
(3分)29.戈德菲尔特-匡特检验:该方法由戈德菲尔特(S.M.Goldfeld )和匡特(R.E.Quandt )于1965年提出,用对样本进行分段比较的方法来判断异方差性。
(3分)30.怀特检验:该检验由怀特(White )在1980年提出,通过建立辅助回归模型的方式来判断异方差性。
(3分)31.戈里瑟检验和帕克检验:该检验法由戈里瑟和帕克于1969年提出,其基本原理都是通过建立残差序列对解释变量的(辅助)回归模型,判断随机误差项的方差与解释变量之间是否存在着较强的相关关系,进而判断是否存在异方差性。
(3分)32.序列相关性:对于模型01122i i k ki i y x x x i ββββμ=+++++… 1,2,,i n =…随机误差项互相独立的基本假设表现为(,)0i j Cov μμ= ,,1,2,,i j i j n ≠=…(1分) 如果出现 (,)0i j Cov μμ≠ ,,1,2,,i j i j n ≠=…即对于不同的样本点,随机误差项之间不再是完全互相独立,而是存在某种相关性,则认为出现了序列相关性(Serial Correlation)。
(2分)33.虚假序列相关:是指模型的序列相关性是由于省略了显著的解释变量而导致的。
34.差分法:差分法是一类克服序列相关性的有效方法,被广泛的采用。
差分法是将原模型变换为差分模型,分为一阶差分法和广义差分法。
35.广义差分法:广义差分法可以克服所有类型的序列相关带来的问题,一阶差分法是它的一个特例。
36.自回归模型:t t t y y μρ+=-137.广义最小二乘法:是最有普遍意义的最小二乘法,普通最小二乘法和加权最小二乘法是它的特例。
38. DW 检验:德宾和瓦特森与1951年提出的一种适于小样本的检验方法。
DW 检验法有五个前提条件。
39.科克伦-奥克特迭代法:是通过逐次跌代去寻求更为满意的ρ的估计值,然后再采用广义差分法。
具体来说,该方法是利用残差t μ去估计未知的ρ。
(40. Durbin 两步法:当自相关系数ρ未知,可采用Durbin 提出的两步法去消除自相关。
第一步对一多元回归模型,使用OLS 法估计其参数,第二步再利用广义差分。
41.相关系数:度量变量之间相关程度的一个系数,一般用ρ表示。
)()()(C j i j i Var Var ov μμμμρ= ,10≤≤ρ ,越接近于1,相关程度越强,越接近于0,相关程度越弱。
42.多重共线性:是指解释变量之间存在完全或不完全的线性关系。
43.方差膨胀因子:是指解释变量之间存在多重共线性时的方差与不存在多重共线性时的方差之比。
44.把质的因素量化而构造的取值为0和1的人工变量。
45.在设定模时如果模型中解释变量的构成.模型函数的形式以及有关随机误差项的若干假定等内容的设定与客观实际不一致,利用计量经济学模型来描述经济现象而产生的误差。
46.是指与模型中的随机解释变量高度相关,与随机误差项不相关的变量。
47.用工具变量替代模型中与随机误差项相关的随机解释变量的方法。
48.由于引进虚拟变量,回归模型的截距或斜率随样本观测值的改变而系统地改变。
49. 这是虚拟变量的一个应用,当解释变量x 低于某个已知的临界水平*x 时,我们取虚拟变量**10x x D x x⎧ ≥⎪=⎨ <⎪⎩设置而成的模型称之为分段线性回归模型。
50. 分布滞后模型:如果滞后变量模型中没有滞后因变量,因变量受解释变量的影响分布在解释变量不同时期的滞后值上,则称这种模型为分布滞后模型。
51.有限分布滞后模型:滞后期长度有限的分布滞后模型称为有限分布滞后模型。
52.无限分布滞后模型:滞后期长度无限的分布滞后模型称为无限分布滞后模型。
53.几何分布滞后模型:对于无限分布滞后模型,如果其滞后变量的系数bi 是按几何级数列衰减的,则称这种模型为几何分布滞后模型。
54.联立方程模型:是指由两个或更多相互联系的方程构建的模型。
55. 结构式模型:是根据经济理论建立的反映经济变量间直接关系结构的计量方程系统。
56. 简化式模型:是指联立方程中每个内生变量只是前定变量与随机误差项的函数。
57. 结构式参数:结构模型中的参数叫结构式参数58. 简化式参数:简化式模型中的参数叫简化式参数。
59.识别:就是指是否能从简化式模型参数估计值中推导出结构式模型的参数估计值。
60.不可识别:是指无法从简化式模型参数估计值中推导出结构式模型的参数估计值。
61. 识别的阶条件:如果一个方程能被识别,那么这个方程不包含的变量的总数应大于或等于模型系统中方程个数减1。
62.识别的秩条件:一个方程可识别的充分必要条件是:所有不包含在这个方程中的参数矩阵的秩为m-1。
63.间接最小二乘法:先利用最小二乘法估计简化式方程,再通过参数关系体系,由简化式参数的估计值求解得结构式参数的估计值。
四、简答题(每小题5分)1.简述计量经济学与经济学、统计学、数理统计学学科间的关系。
答:计量经济学是经济理论、统计学和数学的综合。
(1分)经济学着重经济现象的定性研究,计量经济学着重于定量方面的研究。
(1分)统计学是关于如何收集、整理和分析数据的科学,而计量经济学则利用经济统计所提供的数据来估计经济变量之间的数量关系并加以验证。
(1分)数理统计学作为一门数学学科,可以应用于经济领域,也可以应用于其他领域;计量经济学则仅限于经济领域。
(1分)计量经济模型建立的过程,是综合应用理论、统计和数学方法的过程,计量经济学是经济理论、统计学和数学三者的统一。
2、计量经济模型有哪些应用?答:①结构分析。
(1分)②经济预测。
(1分)③政策评价。
(1分)④检验和发展经济理论。
(2分)3、简述建立与应用计量经济模型的主要步骤。
答:①根据经济理论建立计量经济模型;(1分)②样本数据的收集;(1分)③估计参数;(1分)④模型的检验;(1分)⑤计量经济模型的应用。
(1分)4、对计量经济模型的检验应从几个方面入手?答:①经济意义检验;(2分)②统计准则检验;(1分)③计量经济学准则检验;(1分)④模型预测检验。
(1分)5.计量经济学应用的数据是怎样进行分类的?答:四种分类:①时间序列数据;(1分)②横截面数据;(1分)③混合数据;(1分)④虚拟变量数据。
(2分)6.在计量经济模型中,为什么会存在随机误差项?答:随机误差项是计量经济模型中不可缺少的一部分。
(1分)产生随机误差项的原因有以下几个方面:①模型中被忽略掉的影响因素造成的误差;(1分)②模型关系认定不准确造成的误差;(1分)③变量的测量误差;(1分)④随机因素。
计量经济学复习笔记要点
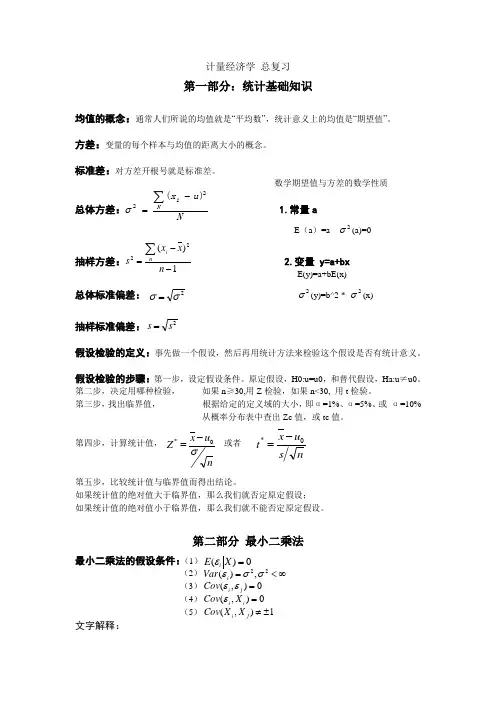
计量经济学 总复习第一部分:统计基础知识均值的概念:通常人们所说的均值就是“平均数”,统计意义上的均值是“期望值”。
方差:变量的每个样本与均值的距离大小的概念。
标准差:对方差开根号就是标准差。
数学期望值与方差的数学性质总体方差: 1.常量aE (a )=a 2σ(a)=0抽样方差: 2.变量 y=a+bxE(y)=a+bE(x)总体标准偏差: 2σ(y)=b^2 * 2σ(x)抽样标准偏差:假设检验的定义:事先做一个假设,然后再用统计方法来检验这个假设是否有统计意义。
假设检验的步骤:第一步,设定假设条件。
原定假设,H0:u=u0,和替代假设,Ha:u ≠u0。
第二步,决定用哪种检验, 如果n ≥30,用Z 检验,如果n<30, 用t 检验。
第三步,找出临界值, 根据给定的定义域的大小,即α=1%、α=5%、或 α=10% 从概率分布表中查出Zc 值,或tc 值。
第四步,计算统计值, 或者第五步,比较统计值与临界值而得出结论。
如果统计值的绝对值大于临界值,那么我们就否定原定假设; 如果统计值的绝对值小于临界值,那么我们就不能否定原定假设。
第二部分 最小二乘法最小二乘法的假设条件:(1) (2) (3) (4) (5) 文字解释:Nu x Ni ∑-=22)(σ1)(22--=∑n x xs ni2σσ=2s s =nux Z σ0*-=n s u x t 0*-=)(=X E i ε∞<=22,)(σσεi Var 0),(=j i Cov εε0),(=i i X Cov ε1),(±≠j i X X Cov(1)每个误差必须是随机的,其误差的期望值是零;(2)误差都是雷同的,其方差相等,同时其方差的变化量必须是有限的; (3)每个误差之间必须是相互独立的; (4)误差项与方程式中的自变量是无关的; (5)自变量之间无直接的线性关系。
通用最小二乘法的步骤:第一步:求出误差项:第二步:求误差的平方和最小。
计量经济学知识点(超全版)
1 .经济变量:经济变量是用来描述经济因素数量水平的指标。
(3分)2. 解释变量:是用来解释作为研究对象的变量(即因变量)为什么变动、如何变动的变量。
(2分)它对因变量的变动做出解释,表现为方程所描述的因果关系中的因”。
1 分)3. 被解释变量:是作为研究对象的变量。
(1分)它的变动是由解释变量做出解释的,表现为方程所描述的因果关系的果。
(2分)4. 内生变量:是由模型系统内部因素所决定的变量,(2分)表现为具有一定概率分布的随机变量,是模型求解的结果。
(1分)5. 外生变量:是由模型系统之外的因素决定的变量,表现为非随机变量。
(2分)它影响模型中的内生变量,其数值在模型求解之前就已经确定。
(1分)6•滞后变量:是滞后内生变量和滞后外生变量的合称,(1分)前期的内生变量称为滞后内生变量;(1分)前期的外生变量称为滞后外生变量。
(1分)7.前定变量:通常将外生变量和滞后变量合称为前定变量,(1分)即是在模型求解以前已经确定或需要确定的变量。
(2分)&控制变量:在计量经济模型中人为设置的反映政策要求、决策者意愿、经济系统运行条件和状态等方面的变量,(2分)它一般属于外生变量。
(1分)9•计量经济模型:为了研究分析某个系统中经济变量之间的数量关系而采用的随机代数模型,(2分)是以数学形式对客观经济现象所作的描述和概括。
(1分)10 .函数关系:如果一个变量y的取值可以通过另一个变量或另一组变量以某种形式惟一地、精确地确定,则y与这个变量或这组变量之间的关系就是函数关系。
(3分)11 .相关关系:如果一个变量y的取值受另一个变量或另一组变量的影响,但并不由它们惟一确定,则y与这个变量或这组变量之间的关系就是相关关系。
(3分)12 .最小二乘法:用使估计的剩余平方和最小的原则确定样本回归函数的方法,称为最小二乘法。
(3分)13 .高斯-马尔可夫定理:在古典假定条件下,OLS估计量是模型参数的最佳线性无偏估计量,这一结论即是高斯—马尔可夫定理。
(完整)计量经济学考试重点整理

计量经济学考试重点整理第一章:P1:什么是计量经济学?由哪三组组成?定义:“用数学方法探讨经济学可以从好几个方面着手,但任何一个方面都不能和计量经济学混为一谈。
计量经济学与经济统计学绝非一码事;它也不同于我们所说的一般经济理论,尽管经济理论大部分具有一定的数量特征;计量经济学也不应视为数学应用于经济学的同义语。
经验表明,统计学、经济理论和数学这三者对于真正了解现代经济生活的数量关系来说,都是必要的,但本身并非是充分条件。
三者结合起来,就是力量,这种结合便构成了计量经济学。
”P9:理论模型的设计主要包含三部分工作,即选择变量,确定变量之间的数学关系,拟定模型中待估计参数的数值范围。
P12:常用的样本数据:时间序列,截面,虚变量数据P13:样本数据的质量(4点)完整性;准确性;可比性;一致性P15-16:模型的检验(4个检验)1、经济意义检验2、统计检验拟合优度检验总体显著性检验变量显著性检验3、计量经济学检验异方差性检验序列相关性检验共线性检验4、模型预测检验稳定性检验:扩大样本重新估计预测性能检验:对样本外一点进行实际预测P16计量经济学模型成功的三要素:理论、方法和数据。
P18-20:计量经济学模型的应用1、结构分析经济学中的结构分析是对经济现象中变量之间相互关系的研究.结构分析所采用的主要方法是弹性分析、乘数分析与比较静力分析。
计量经济学模型的功能是揭示经济现象中变量之间的相互关系,即通过模型得到弹性、乘数等。
2、经济预测计量经济学模型作为一类经济数学模型,是从用于经济预测,特别是短期预测而发展起来的。
计量经济学模型是以模拟历史、从已经发生的经济活动中找出变化规律为主要技术手段。
对于非稳定发展的经济过程,对于缺乏规范行为理论的经济活动,计量经济学模型预测功能失效。
模型理论方法的发展以适应预测的需要。
3、政策评价政策评价是指从许多不同的政策中选择较好的政策予以实行,或者说不同的政策对经济目标所产生的影响的差异。
计量经济学重点知识整理
计量经济学重点知识整理计量经济学是经济学中重要的一个分支,主要研究经济现象和经济理论的数理化方法。
本文将整理计量经济学中的重点知识,帮助读者系统地理解和掌握这门学科。
一、计量经济学简介计量经济学是运用统计方法和经济模型对经济问题进行定量分析的学科。
它利用数理统计学的工具,根据经济理论和实证研究的需要,对经济现象进行测度和解释。
计量经济学方法的特点是同时考虑了外生性和内生性变量之间的关系,能够揭示其中的因果关系。
二、计量经济学的基本原理1. 线性回归模型线性回归模型是计量经济学中最基本的模型之一,用于描述因变量与自变量之间的线性关系。
常见的线性回归模型有简单线性回归模型和多元线性回归模型。
对于简单线性回归模型,可以通过最小二乘法估计模型参数,求得最佳拟合曲线。
而多元线性回归模型则通过矩阵运算推导出参数的估计公式。
2. 假设检验在计量经济学中,假设检验是一种重要的统计方法,用于验证经济理论的假设。
常见的假设检验包括 t 检验、F 检验和卡方检验等。
通过构建原假设和备择假设,并计算相应的统计量,可以对经济理论提出的假设进行检验,从而得出结论。
3. 时间序列分析时间序列分析是计量经济学中的一个重要分支,用于研究随时间变化的经济现象。
常见的时间序列分析方法包括自相关函数(ACF)和偏自相关函数(PACF)的计算,以及平稳性检验、白噪声检验、单位根检验等。
这些方法可以帮助我们了解时间序列数据的性质,并进行有效的预测。
4. 面板数据分析面板数据是计量经济学中常用的一种数据类型,指同一时期内多个个体或单位的多个观测数据。
面板数据分析方法可以更好地解决普通截面数据和时间序列数据的缺陷,提高分析的效果。
常见的面板数据模型包括固定效应模型和随机效应模型,通过估计模型参数,可以得到各个因素对经济变量的影响。
三、计量经济学的应用领域1. 消费者行为分析计量经济学方法可以应用于消费者行为的分析,通过对消费者支出和收入等因素的测度和分析,揭示消费者行为背后的规律。
(完整版)计量经济学重点知识归纳整理
1.普通最小二乘法(Ordinary Least Squares,OLS):已知一组样本观测值{}n i Y X i i ,2,1:),(⋯=,普通最小二乘法要求样本回归函数尽可以好地拟合这组值,即样本回归线上的点∧i Y 与真实观测点Yt 的“总体误差”尽可能地小。
普通最小二乘法给出的判断标准是:被解释变量的估计值与实际观测值之差的平方和最小。
2.广义最小二乘法GLS :加权最小二乘法具有比普通最小二乘法更普遍的意义,或者说普通最小二乘法只是加权最小二乘法中权恒取1时的一种特殊情况。
从此意义看,加权最小二乘法也称为广义最小二乘法。
3.加权最小二乘法WLS :加权最小二乘法是对原模型加权,使之变成一个新的不存在异方差性的模型,然后采用普通最小二乘法估计其参数。
4.工具变量法IV :工具变量法是克服解释变量与随机干扰项相关影响的一种参数估计方法。
5.两阶段最小二乘法2SLS, Two Stage Least Squares :两阶段最小二乘法是一种既适用于恰好识别的结构方程,以适用于过度识别的结构方程的单方程估计方法。
6.间接最小二乘法ILS :间接最小二乘法是先对关于内生解释变量的简化式方程采用普通小最二乘法估计简化式参数,得到简化式参数估计量,然后过通参数关系体系,计算得到结构式参数的估计量的一种方法。
7.异方差性Heteroskedasticity :对于不同的样本点,随机干扰项的方差不再是常数,而是互不相同,则认为出现了异方差性。
8.序列相关性Serial Correlation :多元线性回归模型的基本假设之一是模型的随机干扰项相互独立或不相关。
如果模型的随机干扰项违背了相互独立的基本假设,称为存在序列相关性。
9.多重共线性Multicollinearity :对于模型i k i i X X X Y μββββ++⋯+++=i k 22110i ,其基本假设之一是解释变量X 1,X 2,…,Xk 是相互独立的。
计量经济学 主要知识点

《计量经济学》《经济计量学》《Econometrics》一、主要知识点第一章绪论第一节计量经济学一、经济计量学的产生过程1930 世界经济计量学会二、经济计量学与其他学科的关系计量经济学的定义第二节建立计量经济学模型的步骤和要点一、数据类型1、时间序列数据2、截面数据3、面板数据二、经济变量与经济参数(一)、经济变量1、内生变量和外生变量内生变量(endogenous variable):随机变量,模型自身决定;内生变量影响模型中内生变量,同时又受外生变量和其它内生变量影响。
外生变量(exogenous variable):通常为非随机变量,在模型之外决定。
而外生变量只影响模型中的内生变量,不受模型中任何其它变量影响。
2、解释变量与被解释变量3、滞后变量与前定变量(二)建模步骤和要点。
模型假定把所研究的经济变量之间的关系用适当的数学模型表达出来。
估计参数模型检验:经济意义的检验、统计推断的检验、计量经济的检验、预测的检验第三节计量经济学模型的应用模型应用:政策评价、经济预测、结构分析、检验和发展经济理论第二章一元线性回归模型第一节概述一、相关关系与回归分析1、函数关系与统计相关关系2、相关分析与回归分析的区别和联系二、总体回归模型与样本回归模型1、总体回归模型(PRF):总体回归函数随机扰动项2、样本回归模型(SRF):样本回归函数残差第二节简单线性回归模型的参数估计一、对线性回归模型的假设(古典假定)如何表示?1、零均值假定2、同方差假定3、无自相关假定4、 与解释变量不相关5、 正态性假定二、普通最小二乘法(OLS )1、 OLS 的思想 参数估计式2、Y i 的分布三、普通最小二乘估计量的统计性质 高斯—马尔可夫定理 BLUE1、参数估计量的性质 高斯-马尔科夫定理2、 总体方差/随机扰动项方差的估计式3、 参数估计量的概率分布四、最大似然估计的概念第三节 简单线性回归模型的检验一、对估计值的直观判断(经济意义的检验) 二、拟和优度的检验1、 TSS=ESS+RSS2、 TSS ESS RSS 各自的含义3、 R2的构造4、 ∑∑==22212ˆiyx TSSESS R iβ5、 2R [0,1]三、对1β的显著性检验(T 检验) 检验步骤 四、均值预测与个值预测的置信区间 P49 第三章 多元线性回归模型 第一节 概述一、基本概念偏回归系数及其解释二、多元线性回归的基本假定如何表示和理解?1、零均值假定2、同方差假定3、无自相关假定4、无多重共线性5、扰动项与解释变量不相关6、正态性假定第二节多元线性回归模型的最小二乘估计一、矩阵形式的OLS参数估计式二、总体方差/随机扰动项方差的OLS估计式三、参数估计量的性质:同一元情形四、样本容量问题第三节多元回归模型的检验一、拟和优度检验1、判定系数2、调整后的判定系数二、对单个回归系数的显著性检验(T检验)检验步骤三、总体回归模型的显著性检验(F检验)检验步骤第四节预测对个值预测、区间预测的理解:p74第五节可以线性化的其他函数形式一、线性回归模型的形式:对参数而言是线性的回归系数的含义:边际效应二、几种常见的线性回归模型1、 双对数模型 回归系数的经济含义:弹性2、 半对数模型3、 倒数变换模型第六节 受约束回归 基本思想和检验步骤 第四章 违背经典假设的回归模型第一节 异方差一、异方差1、 异方差,指的是回归模型中的随机误差项的方差不是常数。
计量经济学重点知识整理
计量经济学重点知识整理1一般性定义计量经济学是以经济理论和经济数据的事实为依据,运用数学和统计学的方法,通过建立数学模型来研究经济数量关系和规律的一门经济学科。
研究的主体(出发点、归宿、核心):经济现象及数量变化规律研究的工具(手段):模型数学和统计方法必须明确:方法手段要服从研究对象的本质特征(与数学不同),方法是为经济问题服务2注意:计量经济研究的三个方面理论:即说明所研究对象经济行为的经济理论——计量经济研究的基础数据:对所研究对象经济行为观测所得到的信息——计量经济研究的原料或依据方法:模型的方法与估计、检验、分析的方法——计量经济研究的工具与手段三者缺一不可3计量经济学的学科类型●理论计量经济学研究经济计量的理论和方法●应用计量经济学:应用计量经济方法研究某些领域的具体经济问题4区别:●经济理论重在定性分析,并不对经济关系提供数量上的具体度量●计量经济学对经济关系要作出定量的估计,对经济理论提出经验的内容5计量经济学与经济统计学的关系联系:●经济统计侧重于对社会经济现象的描述性计量●经济统计提供的数据是计量经济学据以估计参数、验证经济理论的基本依据●经济现象不能作实验,只能被动地观测客观经济现象变动的既成事实,只能依赖于经济统计数据6计量经济学与数理统计学的关系联系:●数理统计学是计量经济学的方法论基础区别:●数理统计学是在标准假定条件下抽象地研究一般的随机变量的统计规律性;●计量经济学是从经济模型出发,研究模型参数的估计和推断,参数有特定的经济意义,标准假定条件经常不能满足,需要建立一些专门的经济计量方法3、计量经济学的特点:计量经济学的一个重要特点是:它自身并没有固定的经济理论,而是根据其它经济理论,应用计量经济方法将这些理论数量化。
4、计量经济学为什么是一门单独的学科计量经济学是经济理论、数理经济、经济统计与数理统计的混合物。
1、经济理论所作的陈述或假说大多数是定性性质的,计量经济学对大多数经济理论赋予经验内容。
(完整版)计量经济学知识点(超全版)
1.经济变量:经济变量是用来描述经济因素数量水平的指标。
(3分)2.解释变量:是用来解释作为研究对象的变量(即因变量)为什么变动、如何变动的变量。
(2分)它对因变量的变动做出解释,表现为方程所描述的因果关系中的“因”。
(1分)3.被解释变量:是作为研究对象的变量。
(1分)它的变动是由解释变量做出解释的,表现为方程所描述的因果关系的果。
(2分)4.内生变量:是由模型系统内部因素所决定的变量,(2分)表现为具有一定概率分布的随机变量,是模型求解的结果。
(1分)5.外生变量:是由模型系统之外的因素决定的变量,表现为非随机变量。
(2分)它影响模型中的内生变量,其数值在模型求解之前就已经确定。
(1分)6.滞后变量:是滞后内生变量和滞后外生变量的合称,(1分)前期的内生变量称为滞后内生变量;(1分)前期的外生变量称为滞后外生变量。
(1分)7.前定变量:通常将外生变量和滞后变量合称为前定变量,(1分)即是在模型求解以前已经确定或需要确定的变量。
(2分)8.控制变量:在计量经济模型中人为设置的反映政策要求、决策者意愿、经济系统运行条件和状态等方面的变量,(2分)它一般属于外生变量。
(1分)9.计量经济模型:为了研究分析某个系统中经济变量之间的数量关系而采用的随机代数模型,(2分)是以数学形式对客观经济现象所作的描述和概括。
(1分)10.函数关系:如果一个变量y的取值可以通过另一个变量或另一组变量以某种形式惟一地、精确地确定,则y与这个变量或这组变量之间的关系就是函数关系。
(3分)11.相关关系:如果一个变量y的取值受另一个变量或另一组变量的影响,但并不由它们惟一确定,则y与这个变量或这组变量之间的关系就是相关关系。
(3分)12.最小二乘法:用使估计的剩余平方和最小的原则确定样本回归函数的方法,称为最小二乘法。
(3分)13.高斯-马尔可夫定理:在古典假定条件下,OLS估计量是模型参数的最佳线性无偏估计量,这一结论即是高斯-马尔可夫定理。
(完整word版)计量经济学复习笔记
计量经济学复习笔记CH1导论1、计量经济学:以经济理论和经济数据的事实为依据,运用数学、统计学的方法,通过建立数学模型来研究经济数量关系和规律的一门经济学科。
研究主体是经济现象及其发展变化的规律。
2、运用计量分析研究步骤:模型设定一一确定变量和数学关系式估计参数一一分析变量间具体的数量关系模型检验一一检验所得结论的可靠性模型应用一一做经济分析和经济预测3、模型变量:解释变量:表示被解释变量变动原因的变量,也称自变量,回归元。
被解释变量:表示分析研究的对象,变动结果的变量,也成应变量。
内生变量:其数值由模型所决定的变量,是模型求解的结果。
外生变量:其数值由模型意外决定的变量。
外生变量数值的变化能够影响内生变量的变化,而内生变量却不能反过来影响外生变量。
前定内生变量:过去时期的、滞后的或更大范围的内生变量,不受本模型研究范围的内生变量的影响, 但能够影响我们所研究的本期的内生变量。
前定变量:前定内生变量和外生变量的总称。
数据:时间序列数据:按照时间先后排列的统计数据。
截面数据:发生在同一时间截面上的调查数据。
面板数据:虚拟变量数据:表征政策,条件等,一般取0或1.4、估计评价统计性质的标准无偏:E (人3 )= 3 随机变量,变量的函数?有效:最小方差性一致:N趋近无穷时,3估计越来越接近真实值5、检验经济意义检验:所估计的模型与经济理论是否相等统计推断检验:检验参数估计值是否抽样的偶然结果,是否显著计量经济检验:是否符合计量经济方法的基本假定预测检验:将模型预测的结果与经济运行的实际对比CH2 CH3线性回归模型模型(假设)一一估计参数一一检验一一拟合优度一一预测1、模型(线性)(1)关于参数的线性模型就变量而言是线性的;模型就参数而言是线性的。
Yi = 3 1+ 3 2lnX i+u线性影响随机影响Y i=E (Y|X i) +u E (Y|X i) =f(X i)= 3 1+3 2lnX 引入随机扰动项,(3)古典假设A零均值假定 E ( U i |X i) =0B同方差假定Var(u i|XJ=E(u i2)=2(TC无自相关假定Cov(u i ,u j)=0D随机扰动项与解释变量不相关假定Cov(u i ,X i )=0E正态性假定u~N(0, d 2)F无多重共线性假定Rank(X)=k2、估计在古典假设下,经典框架,可以使用OLS方法:OLS 寻找min Ee i2人B iois = (Y均值)-人B 2(X均值)人B 2ois = Ex i y〃Ex i23、性质OLS回归线性质(数值性质)(1)回归线通过样本均值(X均值,Y均值)(2)估计值人Y的均值等于实际值Y的均值(3)剩余项e i的均值为0(4)被解释变量估计值人Y与剩余项8不相关Cov(人Y,ej=0(5)解释变量X与剩余项8不相关Cov(e i,X i)=0在古典假设下,OLS的统计性质是BLUE统计最佳线性无偏估计4、检验(1) Z检验Ho: B 2=0原假设验证B 2是否显著不为0标准化:Z= (A B 2- B 2) /SE (A B 2)〜N( 0,1 ) 在方差已知,样本充分大用Z检验拒绝域在两侧,跟临界值判断,是否B2显著不为0(2) t检验一一回归系数的假设性检验方差未知,用方差估计量代替 A d 2=Ee i2/(n-k) 重点记忆t =(人卩2- B 2) / A SE (A B 2)〜t (n-2)拒绝域:|t|>=t 2/a( n-2)拒绝,认为对应解释变量对被解释变量有显著影响。
计量经济学复习要点
计量经济学复习要点第1章 绪论数据类型:截面、时间序列、面板用数据度量因果效应,其他条件不变的概念 习题:C1、C2第2章 简单线性回归回归分析的基本概念,常用术语现代意义的回归是一个被解释变量对若干个解释变量依存关系的研究,回归的实质是由固定的解释变量去估计被解释变量的平均值;简单线性回归模型是只有一个解释变量的线性回归模型; 回归中的四个重要概念1. 总体回归模型Population Regression Model,PRMt t t u x y ++=10ββ--代表了总体变量间的真实关系;2. 总体回归函数Population Regression Function,PRFt t x y E 10)(ββ+=--代表了总体变量间的依存规律;3. 样本回归函数Sample Regression Function,SRFtt t e x y ++=10ˆˆββ--代表了样本显示的变量关系; 4. 样本回归模型Sample Regression Model,SRMtt x y 10ˆˆˆββ+=---代表了样本显示的变量依存规律; 总体回归模型与样本回归模型的主要区别是:①描述的对象不同;总体回归模型描述总体中变量y 与x 的相互关系,而样本回归模型描述所关的样本中变量y 与x 的相互关系;②建立模型的依据不同;总体回归模型是依据总体全部观测资料建立的,样本回归模型是依据样本观测资料建立的;③模型性质不同;总体回归模型不是随机模型,而样本回归模型是一个随机模型,它随样本的改变而改变;总体回归模型与样本回归模型的联系是:样本回归模型是总体回归模型的一个估计式,之所以建立样本回归模型,目的是用来估计总体回归模型; 线性回归的含义线性:被解释变量是关于参数的线性函数可以不是解释变量的线性函数 线性回归模型的基本假设简单线性回归的基本假定:对模型和变量的假定、对随机扰动项u 的假定零均值假定、同方差假定、无自相关假定、随机扰动与解释变量不相关假定、正态性假定 普通最小二乘法原理、推导最小二乘法估计参数的原则是以“残差平方和最小”;Min21ˆ()niii Y Y =-∑01ˆˆ(,)ββ: 1121()()ˆ()nii i n ii XX Y Y X X ==--β=-∑∑ , 01ˆˆY X β=-βOLS 的代数性质拟合优度R 2离差平方和的分解:TSS=ESS+RSS“拟合优度”是模型对样本数据的拟合程度;检验方法是构造一个可以表征拟合程度的指标——判定系数又称决定系数;121SSE SST SSR SSRR SST SST SST-===-,表示回归平方和与总离差平方和之比;反映了样本回归线对样本观测值拟合优劣程度的一种描述; 2 2[0,1]R ∈;3 回归模型中所包含的解释变量越多,2R 越大改变度量单位对OLS 统计量的影响函数形式对数、半对数模型系数的解释101ˆˆˆi iY X =β+β:X 变化一个单位Y 的变化 201ˆˆˆln ln i i Y X =β+β: X 变化1%,Y 变化1ˆβ%,表示弹性; 301ˆˆˆln i i Y X =β+β:X 变化一个单位,Y 变化百分之1001ˆβ 401ˆˆˆln i i Y X =β+β:X 变化1%,Y 变化1ˆβ%; OLS 无偏性,无偏性的证明 OLS 估计量的抽样方差 误差方差的估计 OLS 估计量的性质1线性:是指参数估计值0β和1β分别为观测值t y 的线性组合; 2无偏性:是指0β和1β的期望值分别是总体参数0β和1β; 3最优性最小方差性:是指最小二乘估计量0β和1β在在各种线性无偏估计中,具有最小方差;高斯-马尔可夫定理OLS 参数估计量的概率分布2^22()iVar x σβ=∑OLS 随机误差项μ的方差σ2的估计 简单回归的高斯马尔科夫假定 对零条件均值的理解习题:4、5、6;C2、C3、C4第3章 多元回归分析:估计1、变量系数的解释剔除、控制其他因素的影响对斜率系数1ˆβ的解释:在控制其他解释变量X2不变的条件下,X1变化一个单位对Y 的影响;或者,在剔除了其他解释变量的影响之后,X1的变化对Y 的单独影响2、多元线性回归模型中对随机扰动项u 的假定,除了零均值假定、同方差假定、无自相关假定、随机扰动与解释变量不相关假定、正态性假定以外,还要求满足无多重共线性假定;3、多元线性回归模型参数的最小二乘估计式;参数估计式的分布性质及期望、方差和标准误差;在基本假定满足的条件下,多元线性回归模型最小二乘估计式是最佳线性无偏估计式;最小二乘法 OLS 公式:Y ' X X)' (X ˆ-1=β 估计的回归模型:的方差协方差矩阵:残差的方差 : 估计的方差协方差矩阵是: 拟合优度 遗漏变量偏误 多重共线性多重共线性的概念多重共线性的后果 多重共线性的检验 多重共线性的处理习题:1、2、6、7、8、10;C2、C5、C6第4章 多元回归分析:推断经典线性模型假定 正态抽样分布2^22i e n σ=-∑变量显着性检验,t 检验 检验β值的其他假设 P 值实际显着性与统计显着性 检验参数的一个线性组合假设 多个线性约束的检验:F 检验 理解排除性约束 报告回归结果习题:1、2、3、4、6、7、10、11;C3、C5、C8第6章 多元回归分析:专题测度单位对OLS 统计量的影响 进一步理解对数模型 二次式的模型 交互项的模型 拟合优度修正可决系数的作用和方法;习题:1、3、4、7;C2、C3、C5、C9、C12第7章 虚拟变量虚拟变量的定义如何引入虚拟变量:如果一个变量分成N 组,引入该变量的虚拟变量形式是只能放入N-1个虚拟变量 虚拟变量系数的解释虚拟变量系数的解释:不同组均值的差基准组或对照组与处理组 以下几种模型形式表达的不同含义;1tt t t u D X Y +++=210βββ:截距项不同; 2tt t t t u X D X Y +++=210βββ:斜率不同;3tt t t t t u X D D X Y ++++=3210ββββ:截距项与斜率都不同;其中D 是二值虚拟变量,X 是连续的变量;虚拟变量陷阱虚拟变量的交互作用习题:2、4、9;C2、C3、C6、C7、C11第8章异方差异方差的后果异方差稳健标准误BP检验异方差的检验White检验加权最小二乘法习题:1、2、3、4;C1、C2、C8、C9Eviews回归结果界面解释表计量经济学复习题第1章习题:C1、C2第2章习题:4、5、6;C2、C3、C4第3章习题:1、2、6、7、8、10;C2、C5、C6 第4章习题:1、2、3、4、6、7、10、11;C3、C5、C8 第6章习题:1、3、4、7;C2、C3、C5、C9、C12 第7章习题:2、4、9;C2、C3、C6、C7、C11 第8章习题:1、2、3、4;C1、C2、C8、C9 1、判断下列表达式是否正确2469 2、给定一元线性回归模型:1叙述模型的基本假定;2写出参数0β和1β的最小二乘估计公式; 3说明满足基本假定的最小二乘估计量的统计性质; 4写出随机扰动项方差的无偏估计公式; 3、对于多元线性计量经济学模型:1该模型的矩阵形式及各矩阵的含义; 2对应的样本线性回归模型的矩阵形式; 3模型的最小二乘参数估计量;4、根据美国1961年第一季度至1977年第二季度的数据,我们得到了如下的咖啡需求函数的回归方程:D D D P I P t t t t t t tT Q 321'0097.0157.00961.00089.0ln 1483.0ln 5115.0ln 1647.02789.1ˆln ----++-=其中,Q=人均咖啡消费量单位:磅;P=咖啡的价格以1967年价格为不变价格;I=人均可支配收入单位:千元,以1967年价格为不变价格;P '=茶的价格1/4磅,以1967年价格为不变价格;T=时间趋势变量1961年第一季度为1,…,1977年第二季度为66;D 1=1:第一季度;D 2=1:第二季度;D 3=1:第三季度; 请回答以下问题:① 模型中P 、I 和P '的系数的经济含义是什么 ② 咖啡的需求是否很有弹性③ 咖啡和茶是互补品还是替代品 ④ 你如何解释时间变量T 的系数 ⑤ 你如何解释模型中虚拟变量的作用 ⑥ 哪一个虚拟变量在统计上是显着的 ⑦ 咖啡的需求是否存在季节效应5、为研究体重与身高的关系,我们随机抽样调查了51名学生其中36名男生,15名女生,并得到如下两种回归模型:h W5662.506551.232ˆ+-= t=h D W7402.38238.239621.122ˆ++-= t=其中,Wweight=体重 单位:磅;hheight=身高 单位:英寸 请回答以下问题:① 你将选择哪一个模型为什么② 如果模型确实更好,而你选择了,你犯了什么错误 ③ D 的系数说明了什么6、简述异方差对下列各项有何影响:1OLS 估计量及其方差;2置信区间;3显着性t 检验和F 检验的使用;4预测;7、假设某研究者基于100组三年级的班级规模CS 和平均测试成绩TestScore 数据估计的OLS 回归为:(1) 若某班级有22个学生,则班级平均测试成绩的回归预测值是多少 (2) 某班去年有19个学生,而今年有23个学生,则班级平均测试成绩变化的回归预测值是多少(3) 100个班级的样本平均班级规模为,则这100个班级的样本平均测试成绩是多少(4) 100个班级的测试成绩样本标准差是多少提示:利用R 2和SER 的公式 (5) 求关于CS 的回归斜率系数的95%置信区间;(6) 计算t 统计量,根据经验法则t=2来判断显着性检验的结果; 8、设从总体中抽取一容量为200的20岁男性随机样本,记录他们的身高和体重;得体重对身高的回归为:其中体重的单位是英镑,身高的单位是英寸;(1) 身高为70英寸的人,其体重的回归预测值是多少65英寸的呢74英寸的呢(2) 某人发育较晚,一年里蹿高了英寸;则根据回归预测体重增加多少 (3) 解释系数值和的含义;(4)假定不用英镑和英寸度量体重和身高而分别用厘米和千克,则这个新的厘米-千克回归估计是什么给出所有结果,包括回归系数估计值,R2和SER;(5)基于回归方程,能对一个3岁小孩的体重假设身高1米作出可靠预测吗9、假设某研究使用250名男性和280名女性工人的工资Wage数据估计出如下OLS回归:标准误其中WAGE的单位是美元/小时,Male为男性=1,女性=0的虚拟变量;用男性和女性的平均收入之差定义工资的性别差距;1性别差距的估计值是多少2计算截距项和Male系数的t统计量,估计出的性别差距统计显着不为0吗5%显着水平的t统计量临界值为3样本中女性的平均工资是多少男性的呢4对本回归的R2你有什么评论,它告诉了你什么,没有告诉你什么这个很小的R2可否说明这个回归模型没有什么价值5另一个研究者利用相同的数据,但建立了WAGE对Female的回归,其中Female为女性=1,男性=0的变量;由此计算出的回归估计是什么10、基于美国CPS人口调查1998年的数据得到平均小时收入对性别、教育和其他特征的回归结果,见下表;该数据集是由4000名全年工作的全职工人数据组成的;其中:AHE=平均小时收入;College=二元变量大学取1,高中取0;Female女性取1,男性取0;Age=年龄年;Northeast居于东北取1,否则为0;Midwest居于中西取1,否则为0;South居于南部取1,否则为0;West居于西部取1,否则取0;表1:基于2004年CPS数据得到的平均小时收入对年龄、性别、教育、地区的回归结果概括统计量和联合检验SERR2注:括号中是标准误;(1)计算每个回归的调整R2;(2)利用表1中列1的回归结果回答:大学毕业的工人平均比高中毕业的工人挣得多吗多多少这个差距在5%显着性水平下统计显着吗男性平均比女性挣的多吗多多少这个差距在5%显着性水平下统计显着吗(3)年龄是收入的重要决定因素吗请解释;使用适当的统计检验来回答; (4)Sally是29岁女性大学毕业生,Betsy是34岁女性大学毕业生,预测她们的收入;(5)用列3的回归结果回答:地区间平均收入存在显着差距吗利用适当的假设检验解释你的答案;(6)为什么在回归中省略了回归变量West如果加上会怎样;解释3个地区回归变量的系数的经济含义;7Juantia是南部28岁女性大学毕业生,Jennifer是中西部28岁女性大学毕业生,计算她们收入的期望差距计量经济学补充复习题一、填空题1、 计量经济学常用的三类样本数据是_横截面数据__、__时间序列数据__和_面板数据;2、虚拟解释变量不同的引入方式产生不同的作用;若要描述各种类型的模型在截距水平的差异,则以 加法形式 引入虚拟解释变量;若要反映各种类型的模型的不同相对变化率时,则以 乘法形式 引入虚拟解释变量;二、选择题1、参数的估计量βˆ具备有效性是指 BA Var βˆ=0B Var βˆ为最小C βˆ-=0D βˆ-为最小2、产量x,台与单位产品成本y, 元/台之间的回归方程为yˆ=356-,这说明 DA 产量每增加一台,单位产品成本增加356元B 产量每增加一台,单位产品成本减少元C 产量每增加一台,单位产品成本平均增加356元D 产量每增加一台,单位产品成本平均减少元3、在总体回归直线E x y10)ˆ(ββ+=中,1β表示 B A 当x 增加一个单位时,y 增加1β个单位B 当x 增加一个单位时,y 平均增加1β个单位C 当y 增加一个单位时,x 增加1β个单位D 当y 增加一个单位时,x 平均增加1β个单位4、以y 表示实际观测值,yˆ表示回归估计值,则普通最小二乘法估计参数的准则是使 DA )ˆ(i i yy -∑=0 B 2)ˆ(i i y y -∑=0 C )ˆ(i i yy -∑为最小 D 2)ˆ(i i y y -∑为最小 5、设y 表示实际观测值,yˆ表示OLS 回归估计值,则下列哪项成立 D A yˆ=y B y ˆ=y C yˆ=y D y ˆ=y 6、用普通最小二乘法估计经典线性模型t t t u x y ++=10ββ,则样本回归线通过点 DA x,yB x,yˆ C x ,yˆ D x ,y 7、判定系数2R 的取值范围是 CA 2R -1B 2R 1C 02R 1D -12R 18、对于总体平方和TSS 、回归平方和RSS 和残差平方和ESS 的相互关系,正确的是 BA TSS>RSS+ESSB TSS=RSS+ESSC TSS<RSS+ESSD TSS 2=RSS 2+ESS 29、决定系数2R 是指 CA 剩余平方和占总离差平方和的比重B 总离差平方和占回归平方和的比重C 回归平方和占总离差平方和的比重D 回归平方和占剩余平方和的比重10、如果两个经济变量x 与y 间的关系近似地表现为当x 发生一个绝对量变动x 时,y 有一个固定地相对量y/y 变动,则适宜配合地回归模型是 BA i i i u x y ++=10ββB ln i i i u x y ++=10ββC i ii u x y ++=110ββ D ln i i i u x y ++=ln 10ββ 11、下列哪个模型为常数弹性模型 AA ln i i i u x y ++=ln ln 10ββB ln i i i u x y ++=10ln ββC i i i u x y ++=ln 10ββD i ii u x y ++=110ββ 12、模型i i i u x y ++=ln 10ββ中,y 关于x 的弹性为 C A i x 1β B i x 1β C iy 1β D i y 1β 13、模型ln i i i u x y ++=ln ln 10ββ中,1β的实际含义是 BA x 关于y 的弹性B y 关于x 的弹性C x 关于y 的边际倾向D y 关于x 的边际倾向14、当存在异方差现象时,估计模型参数的适当方法是 AA 加权最小二乘法B 工具变量法C 广义差分法D 使用非样本先验信息15、加权最小二乘法克服异方差的主要原理是通过赋予不同观测点以不同的权数,从而提高估计精度,即 BA 重视大误差的作用,轻视小误差的作用B 重视小误差的作用,轻视大误差的作用C 重视小误差和大误差的作用D 轻视小误差和大误差的作用16、容易产生异方差的数据是 CA 时间序列数据B 修匀数据C 横截面数据D 年度数据17、设回归模型为i i i u x y +=β,其中var i u =22i x σ,则的最小二乘估计量为 CA. 无偏且有效 B 无偏但非有效C 有偏但有效D 有偏且非有效18、如果模型t t t u x b b y ++=10存在序列相关,则 DA cov t x ,t u =0B cov t u ,s u =0tsC cov t x ,t u 0D cov t u ,s u 0ts19、下列哪种形式的序列相关可用DW 统计量来检验i v 为具有零均值,常数方差,且不存在序列相关的随机变量 AA t t t v u u +=-1ρB t t t t v u u u +++=-- 221ρρC t t v u ρ=D ++=-12t t t v v u ρρ20、DW 的取值范围是DA -1DW0B -1DW1C -2DW2D 0 DW421、当DW =4是时,说明 DA 不存在序列相关B 不能判断是否存在一阶自相关C 存在完全的正的一阶自相关D 存在完全的负的一阶自相关22、模型中引入一个无关的解释变量 CA 对模型参数估计量的性质不产生任何影响B 导致普通最小二乘估计量有偏C 导致普通最小二乘估计量精度下降D 导致普通最小二乘估计量有偏,同时精度下降23、如果方差膨胀因子VIF =10,则认为什么问题是严重的 CA 异方差问题B 序列相关问题C 多重共线性问题D 解释变量与随机项的相关性24、某商品需求函数为i i i u x b b y ++=10,其中y 为需求量,x 为价格;为了考虑“地区”农村、城市和“季节”春、夏、秋、冬两个因素的影响,拟引入虚拟变量,则应引入虚拟变量的个数为 BA 2B 4C 5D 625、根据样本资料建立某消费函数如下:tC ˆ=+tD +t x ,其中C 为消费,x 为收入,虚拟变量D =农村家庭城镇家庭⎩⎨⎧01,所有参数均检验显着,则城镇家庭的消费函数为AA t C ˆ=+t xB tC ˆ=+t xC t C ˆ=+t xD tC ˆ=+t x 26、假设某需求函数为i i i u x b b y ++=10,为了考虑“季节”因素春、夏、秋、冬四个不同的状态,引入4个虚拟变量形式形成截距变动模型,则模型的 DA 参数估计量将达到最大精度B 参数估计量是有偏估计量C 参数估计量是非一致估计量D 参数将无法估计27、对于模型i i i u x b b y ++=10,为了考虑“地区”因素北方、南方,引入2个虚拟变量形式形成截距变动模型,则会产生 DA 序列的完全相关B 序列不完全相关C 完全多重共线性D 不完全多重共线性28、如果一个回归模型中不包含截距项,对一个具有m 个特征的质的因素要引入虚拟变量的数目为 AA mB m-1C m-2D m+129、某一时间序列经一次差分变换成平稳时间序列,此时间序列称为A;A .1阶单整B .2阶单整C .K 阶单整D .以上答案均不正确30、当随机误差项存在自相关时,进行单位根检验是由B 来实现;A . DF 检验B .ADF 检验C .EG 检验D .DW 检验三、多项选择题:1、一元线性回归模型t t t u x y ++=10ββ的经典假设包括 ABCDEA 0)(=t u EB 2)(σ=t u Var 常数C 0),cov(=j i u uD t u ~N0,1E x 为非随机变量,且0),cov(=t t u x2、以带“”表示估计值,u 表示随机误差项,如果y 与x 为线性相关关系,则下列哪些是正确的 BEA t t x y 10ββ+=B t t t u x y ++=10ββC t t t u x y ++=10ˆˆββD tt t u x y ++=10ˆˆˆββ E tt x y 10ˆˆˆββ+= 3、用普通最小二乘法估计模型t t t u x y ++=10ββ的参数,要使参数估计量具备最佳线性无偏估计性质,则要求: ABCDEA 0)(=t u EB 2)(σ=t u Var 常数C 0),cov(=j i u uD t u 服从正态分布E x 为非随机变量,且0),cov(=t t u x4、假设线性回归模型满足全部基本假设,则其参数估计量具备 CDEA 可靠性B 合理性C 线性D 无偏性E 有效性5、下列哪些非线性模型可以通过变量替换转化为线性模型 ABC A i i i u x y ++=210ββ B i ii u x y ++=110ββ C ln i i i u x y ++=ln 10ββ D i i i u x y ++=210ββE i i i i u x y ++=ββ06、异方差性将导致 BCDEA 普通最小二乘估计量有偏和非一致B 普通最小二乘估计量非有效C 普通最小二乘估计量的方差的估计量有偏D 建立在普通最小二乘估计基础上的假设检验失效E 建立在普通最小二乘估计基础上的预测区间变宽7、当模型中解释变量间存在高度的多重共线性时 ACDA 各个解释变量对被解释变量的影响将难于精确鉴别B 部分解释变量与随机误差项之间将高度相关C 估计量的精度将大幅下降D 估计量对于样本容量的变动将十分敏感E 模型的随机误差项也将序列相关8、下述统计量可以用来检验多重共线性的严重性 ACDA 相关系数B DW 值C 方差膨胀因子D 特征值E 自相关系数三、判断题1、随机误差项u i 与残差项e i 是一回事; F2、当异方差出现时,常用的t 检验和F 检验失效; T3、在异方差情况下,通常预测失效; T四、计算分析题1、指出下列模型中的错误,并说明理由;1 tt Y C 2.1180ˆ+= 其中,C 、Y 分别为城镇居民的消费支出和可支配收入;2 tt t L K Y ln 28.0ln 62.115.1ˆln -+= 其中,Y 、K 、L 分别为工业总产值、工业生产资金和职工人数;2、对下列模型进行适当变换化为标准线性模型:(1) y =0β+1βx 1+2β21x +u ; (2) Q =A u e L K βα;(3) Y =exp 0β+1βx+u ;3、一个由容量为209的样本估计的解释CEO 薪水的方程为:其中,Y 表示年薪水平单位:万元, 1X 表示年收入单位:万元, 2X 表示公司股票收益单位:万元; 321D D D ,,均为虚拟变量,分别表示金融业、消费品工业和公用事业;假设对比产业为交通运输业;(1) 解释三个虚拟变量参数的经济含义;(2) 保持1X 和2X 不变,计算公用事业和交通运输业之间估计薪水的近似百分比差异;这个差异在1%的显着性水平上是统计显着吗消费品工业和金融业之间估计薪水的近似百分比差异是多少。