
knn分类器的原理
knn分类器的原理
KNN(K-Nearest Neighbor)分类器是一种基于实例的学习算法,它将新的样本数据与已知分类的数据进行比较,通过计算距离来确定新样本所属的分类。
KNN分类器的原理可以分为以下几个步骤:
1. 收集数据
首先需要收集一组已知分类的数据集,包括特征和标签。
特征是描述数据的属性,标签是每个数据所属的类别。
2. 计算距离
对于新样本,需要计算它与已知数据集中每个样本之间的距离。
常用的距离度量方法有欧氏距离、曼哈顿距离和闵可夫斯基距离等。
3. 确定K值
K值是指在计算距离时选择最近邻居数量。
通常情况下,K值越小则模型越复杂、容易过拟合;K值越大则模型越简单、容易欠拟合。
一般通过交叉验证来确定最优的K值。
4. 找到K个最近邻居
根据计算出来的距离,找到与新样本最接近(即距离最短)的K个邻居。
5. 统计邻居类别出现频率
对于这K个邻居,统计它们所属的类别出现的频率。
通常采用投票法,即将K个邻居中出现次数最多的类别作为新样本的预测类别。
6. 对新样本进行分类
根据统计结果,将新样本归入出现频率最高的类别中。
KNN分类器的优点是简单易用、适用于多分类问题、对异常值不敏感等。
缺点是需要大量存储训练数据、计算复杂度高、对样本分布不均
匀敏感等。
因此,在实际应用中需要根据具体情况选择合适的算法。
最近邻点法

最近邻点法最近邻点法(KNN)是一种基于数据距离度量的机器学习算法。
它是监督学习算法中最简单和最常用的算法之一。
其基本思想是通过测量不同特征之间的距离,将一个未知样本标记为与距离最近的已知样本相同的类别。
KNN算法可以用来分类或回归,常用于分类问题。
KNN分类器的工作原理如下:给定一组已分类的样本数据,将一个新的样本与已有样本数据进行比较,找到与新样本最接近的K个样本(K是一个既定的数目),并将新样本分配给这K个样本中最普遍的类别。
KNN算法的核心是进行距离度量。
KNN算法中距离度量方法的种类很多,例如欧氏距离、曼哈顿距离、马氏距离等。
其中欧氏距离最为常用。
KNN算法的距离度量可以通过计算每个特征的差异来实现,也可以使用其他方法进行度量。
距离度量完成后,KNN算法开始确定K值。
通常情况下,较小的K值能够产生较小的误差,而较大的K值则能更好地抵御噪声。
但是,较大的K值会使算法更加耗时,并且可能使一些例子中的极端离群值对算法产生负面影响。
KNN算法是一种简单而有效的算法,但需要注意以下几点:1.选择合适的K值:过大或过小的K值都可能导致算法的失效。
2.特征归一化:由于不同特征的度量单位和尺度不同,在距离度量时可能会对结果造成很大的影响。
为了使算法更加准确,应该对所有特征进行归一化处理。
3.算法的分类速度比较慢:当样本数据量很大时,KNN算法的计算量会非常庞大。
因此,在处理大量数据时,KNN算法可能会变得非常缓慢。
总的来说,KNN算法在数据量不大、特征数量较少的情况下,非常适合进行分类问题的处理,并且对于数据本身的特征分布不作限定,因此具有比较好的适应性。
但是,由于距离度量方法和K值的选择等问题,需要谨慎使用。
KNN分类器

KNN 分类器KNN 学习(K-Nearest Neighbor algorithm ,K 最邻近⽅法 )是⼀种统计分类器,对数据的特征变量的筛选尤其有效。
基本原理KNN 的基本思想是:输⼊没有标签(标注数据的类别),即没有经过分类的新数据,⾸先提取新数据的特征并与測试集中的每⼀个数据特征进⾏⽐較;然后从測试集中提取K 个最邻近(最类似)的数据特征标签,统计这K 个最邻近数据中出现次数最多的分类,将其作为新的数据类别。
KNN 的这样的基本思想有点类似于⽣活中的“物以类聚。
⼈以群分”。
在KNN 学习中,⾸先计算待分类数据特征与训练数据特征之间的距离并排序。
取出距离近期的K 个训练数据特征。
然后根据这K 个相近训练数据特征所属类别来判定新样本类别:假设它们都属于⼀类,那么新的样本也属于这个类;否则,对每⼀个候选类别进⾏评分,依照某种规则确定新的样本的类别。
笔者借⽤以下这个图来做更形象的解释:如上图,图中最⼩的那个圆圈代表新的待分类数据。
三⾓形和矩形分别代表已知的类型,如今须要推断圆圈属于菱形那⼀类还是矩形那⼀类。
可是我该以什么样的根据来推断呢?1. 看离圆形近期(K=1)的那个类型是什么,由图可知,离圆形近期的是三⾓形,故将新数据判定为属于三⾓形这个类别。
2. 看离圆形近期的3个数据(K=3)的类型是什么,由图可知离圆形近期的三个中间有两个是矩形,⼀个是三⾓形,故将新数据判定为属于矩形这个类别。
3. 看离圆形近期的9个数据(K=9)的类型是什么,由图可知离圆形近期的9个数据中间,有五个是三⾓形。
四个是矩形。
故新数据判定为属于三⾓形这个类别。
上⾯所说的三种情况也能够说成是1-近邻⽅法、3-近邻⽅法、9-近邻⽅法。
当然,K 还能够取更⼤的值,当样本⾜够多,且样本类别的分布⾜够好的话,那么K 值越⼤,划分的类别就越正确。
⽽KNN 中的K 表⽰的就是划分数据时。
所取类似样本的个数。
我们都知道,当K=1时,其抗⼲扰能⼒就较差。
KNN算法原理以及代码实现

KNN算法原理以及代码实现⼀、KNN简述KNN是⽐较经典的算法,也是是数据挖掘分类技术中最简单的⽅法之⼀。
KNN的核⼼思想很简单:离谁近就是谁。
具体解释为如果⼀个实例在特征空间中的K个最相似(即特征空间中最近邻)的实例中的⼤多数属于某⼀个类别,则该实例也属于这个类别。
换个说法可能更好理解,⽐如⼀个⼀定范围的平⾯随机分布着两种颜⾊的样本点,在这个平⾯内有个实例点不知道它是什么颜⾊,因此通过它周边的不同颜⾊的点分布情况进⾏推测,假设取K=3,意思是在离这个实例点最近的样本点中去前三个最近的,然后看这三个当中那种类别占⽐⼤,就判断该实例点属于那个类别的,当k=5的时候也⼀样这样判断,因此k的取值很关键,通常不会超过20。
当然,因为每个样本有多个特征,因此实际⼯作中,这个‘平⾯’就是三维甚⾄是多维的,道理是⼀样的。
如图:⼆、KNN算法原理在KNN中,通过计算对象间距离来作为各个对象之间的⾮相似性指标,避免了对象之间的匹配问题,在这⾥距离⼀般使⽤欧⽒距离或曼哈顿距离:对KNN算法的思想总结⼀下:就是在训练集中数据和标签已知的情况下,输⼊测试数据,将测试数据的特征与训练集中对应的特征进⾏相互⽐较,找到训练集中与之最为相似的前K个数据,则该测试数据对应的类别就是K个数据中出现次数最多的那个分类,其算法的描述为:1)计算测试数据与各个训练数据之间的距离;2)按照距离的递增关系进⾏排序;3)选取距离最⼩的K个点;4)确定前K个点所在类别的出现频率;5)返回前K个点中出现频率最⾼的类别作为测试数据的预测分类。
三、KNN算法优缺点以及算法改进优缺点:1、简单,易于理解,是⼀个天然的多分类器;2、不需要庞⼤的样本数据也可以完成⼀个简单的分类;3、不需要训练和求解参数(既是优点也是缺点);4、数据量⼤的时候,计算量也⾮常⼤(样本多,特征多);5、不平衡样本处理能⼒差;6、并没有学习和优化的过程,严格来说不算是机器学习。
改进:进⾏加权平均,离得近的样本给予更⼤的权重,离得远的样本使其权重变⼩。
KNN原理及应用
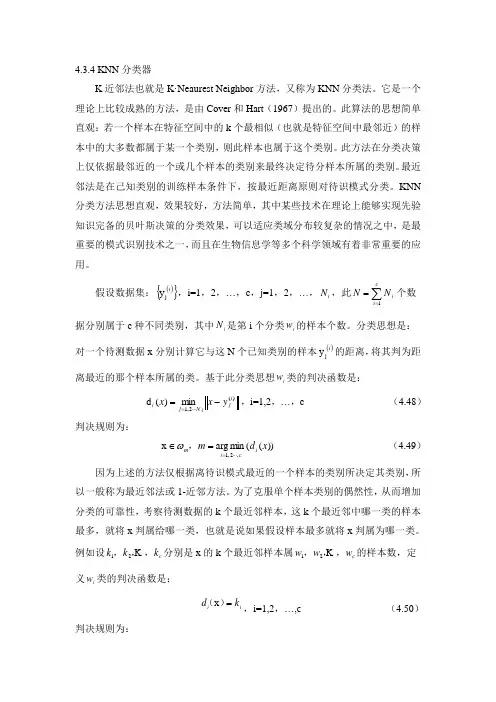
4.3.4 KNN 分类器K 近邻法也就是K·Neaurest Neighbor 方法,又称为KNN 分类法。
它是一个理论上比较成熟的方法,是由Cover 和Hart (1967)提出的。
此算法的思想简单直观:若一个样本在特征空间中的k 个最相似(也就是特征空间中最邻近)的样本中的大多数都属于某一个类别,则此样本也属于这个类别。
此方法在分类决策上仅依据最邻近的一个或几个样本的类别来最终决定待分样本所属的类别。
最近邻法是在己知类别的训练样本条件下,按最近距离原则对待识模式分类。
KNN 分类方法思想直观,效果较好,方法简单,其中某些技术在理论上能够实现先验知识完备的贝叶斯决策的分类效果,可以适应类域分布较复杂的情况之中,是最重要的模式识别技术之一,而且在生物信息学等多个科学领域有着非常重要的应用。
假设数据集:(){}i jy ,i=1,2,…,c ,j=1,2,…,iN,此∑==ci iN N 1个数据分别属于c 种不同类别,其中i N 是第i 个分类i w 的样本个数。
分类思想是:对一个待测数据x 分别计算它与这N 个已知类别的样本()i j y 的距离,将其判为距离最近的那个样本所属的类。
基于此分类思想i w 类的判决函数是:)(2,1m i n )(d i j iN j i y x x -=⋅⋅⋅=,i=1,2,…,c (4.48)判决规则为:))((min arg x ,2,1x d m i ci m ⋅⋅⋅==∈,ω (4.49)因为上述的方法仅根据离待识模式最近的一个样本的类别所决定其类别,所以一般称为最近邻法或1-近邻方法。
为了克服单个样本类别的偶然性,从而增加分类的可靠性,考察待测数据的k 个最近邻样本,这k 个最近邻中哪一类的样本最多,就将x 判属给哪一类,也就是说如果假设样本最多就将x 判属为哪一类。
例如设c k k k ,,, 21分别是x 的k 个最近邻样本属c w w w ,,, 21的样本数,定义i w 类的判决函数是: iik d =)(x ,i=1,2,…,c (4.50)判决规则为:))((ax x ,2,1x d m m i ci m ⋅⋅⋅==∈,ω (4.51)该方法通常称k 近邻算法,也就是KNN 。
kneighborsclassifier模型的核心原理和数学公式
kneighborsclassifier模型的核心原理和数学公式KNeighborsClassifier模型,也称为KNN模型,是一种基于实例的学习,或者说是非泛化学习的模型。
它的核心原理是“近朱者赤,近墨者黑”,即如果一个样本的k个最近邻居中大多数属于某一个类别,则该样本也属于这个类别。
在数学公式上,假设我们有一个数据集D,其中每个样本x都关联一个类别y。
对于一个新的样本x_new,我们可以计算它与D中每个样本的距离d(x_new, x_i),然后找出距离最近的k个点。
这k个点中的大多数属于的类别y_i即为x_new 的预测类别。
具体的计算步骤如下:
1. 计算已知类别数据集中的点与当前点之间的距离;
2. 按距离递增排序;
3. 选取与当前点距离最小的k个点;
4. 统计前k个点所在的类别出现的频率;
5. 返回前k个点出现频率最高的类别作为当前点的预测分类。
值得注意的是,在KNN算法中,所有的样本点都扮演着训练数据的角色,这使得KNN算法具有很强的可解释性,因为模型的输出直接依赖于输入数据的特定值。
此外,由于KNN算法只存储了训练数据本身,不需要进行参数估计或概率密度估计,因此其计算复杂性相对较低。
以上信息仅供参考,如需获取更多详细信息,建议咨询机器学习领域的专业人士或查阅相关书籍文献。
matlab近邻分类器的构建knn分类方法的实现
近邻分类器(k-nearest neighbor classifier,简称k-NN分类器)是一种常见的机器学习算法,可用于分类和回归问题。
它的工作原理是根据输入实例的特征向量,在训练集中找出与该实例特征最相似的k 个实例,然后使用这k个实例中的多数类别(对于分类问题)或平均值(对于回归问题)作为预测结果。
在本文中,我们将介绍如何使用Matlab编程语言来构建k-NN分类器,以及如何实现k-NN分类方法。
我们将从k-NN分类器的基本原理开始介绍,然后逐步介绍Matlab代码的实现过程,并结合实例进行演示。
1. k-NN分类器的原理及特点k-NN分类器是一种基于实例的学习方法,不同于传统的基于模型的学习方法(如决策树、支持向量机等)。
它的主要特点包括:- 非参数化:k-NN分类器没有显式的模型参数,它的预测结果完全依赖于训练集中实例的分布。
- 适用性广泛:k-NN分类器适用于各种类型的数据,包括连续型、离散型、多类别、多标签等。
- 可解释性强:k-NN分类器的预测结果可以直观地解释为与输入实例最相似的训练集实例的类别。
2. Matlab中k-NN分类器的构建在Matlab中,使用Statistics and Machine Learning Toolbox工具箱可以方便地构建k-NN分类器。
我们需要加载训练集数据和对应的类别标签,然后使用fitcknn函数来构建k-NN分类器模型。
具体的步骤如下:2.1 加载训练集数据和类别标签在Matlab中,可以使用csvread函数或readtable函数来加载训练集数据,然后将数据分为特征向量和类别标签两部分。
例如: ```matlabdata = csvread('train_data.csv');X = data(:, 1:end-1); % 特征向量Y = data(:, end); % 类别标签```2.2 构建k-NN分类器模型使用fitcknn函数可以构建k-NN分类器模型,需要指定k的取值和距离度量方法等参数。
knn分类器例题
knn分类器例题
KNN(K-Nearest Neighbors)分类器是一种基于实例的学习,或者说是非泛化学习。
它的基本思想是:在特征空间中,如果一个实例的大部分近邻都属于某个类别,则该实例也属于这个类别。
以下是一个简单的KNN分类器的例子:
假设我们有一个数据集,其中包含两个特征(例如:颜色和形状)和对应的类别标签(例如:水果的种类)。
我们的任务是根据给定的特征值预测一个实例的类别。
首先,我们需要计算待分类实例与数据集中每个实例的距离。
这可以通过欧几里得距离、曼哈顿距离等度量方式来完成。
然后,我们选择距离最近的k个实例。
通常,k是一个用户定义的常数,通常取一个较小的整数,如3或5。
最后,我们查看k个最近邻实例的类别标签,并选择最常见的类别作为待分类实例的预测类别。
以下是一个简单的Python代码示例:
例如,如果我们有以下训练数据和标签:
4], [5, 6], [7, 8]]
train_labels = ['A', 'B', 'B', 'A']
```一个新实例的类别:
这个例子中,我们使用了欧几里得距离作为度量方式,
但也可以使用其他距离度量方式,如曼哈顿距离。
此外,我们还可以使用其他方法来选择k个最近邻实例,例如基于密度的最近邻方法。
knn分类方法的原理
knn分类方法的原理
KNN(K-Nearest Neighbors)分类方法的原理是基于近邻实例的特征相似性原则。
它可以被描述为以下步骤:
1. 计算待分类样本与训练集中每个样本之间的距离。
常见的距离度量方式包括欧氏距离、曼哈顿距离、余弦距离等。
2. 选择与待分类样本距离最近的K个训练集样本,这些样本被称为K个最近邻。
3. 根据这K个最近邻的标签,进行投票或加权投票来确定待分类样本的类别。
投票策略可以是简单多数表决,也可以是加权投票,即根据距离远近对投票结果进行加权。
KNN分类方法的主要原理是基于实例间的相似性,即认为与一个实例相似的实例往往具有相似的类别标签。
KNN方法的可解释性较强,并且它不需要在训练阶段建立模型,因此它是一种懒惰学习(lazy learning)算法。
但是,KNN方法的计算复杂度较高,特别是在处理大规模数据集时。
另外,KNN方法对于维度灾难问题比较敏感,即在高维空间中往往会出现样本稀疏和距离失效的问题,因此需要进行特征选择和降维预处理。
knn算法实现鸢尾花的分类原理
K最近邻(K-Nearest Neighbors,KNN)是一种简单而直观的机器学习算法,用于分类和回归。
下面是KNN算法在鸢尾花分类问题中的基本原理和实现步骤:KNN 算法原理:
1.数据准备:收集带有标签的训练数据,这些数据包括输入特征和对应的标
签(类别)。
2.选择 K 值:确定要使用的邻居数量 K。
K值的选择可能会影响分类的准确
性,一般通过交叉验证等方式来确定。
3.计算距离:对于给定的未标记样本,计算它与训练集中所有样本的距离。
常用的距离度量包括欧氏距离、曼哈顿距离等。
4.排序:将距离按升序排列,选择前 K 个距离最近的训练样本。
5.投票:统计 K 个最近邻居中每个类别的数量,选择数量最多的类别作为未
标记样本的预测类别。
鸢尾花分类问题的实现:
下面是使用Python和scikit-learn库实现鸢尾花分类的简单示例:
在这个示例中,我们首先加载鸢尾花数据集,然后将数据集分为训练集和测试集。
接着,我们创建一个KNN分类器,使用训练集训练模型,并在测试集上进行预测。
最后,计算模型的准确性。
这是一个简单的KNN分类器的实现,可以在更复杂的
数据集和应用中进行进一步的调整和优化。
knn算法原理
knn算法原理KNN(K近邻算法)是一种基于实例的机器学习算法,是机器学习领域中非常常见的算法。
KNN法的基本思想是:如果一个样本在特征空间中的k个最相近的样本中的大多数属于某一个类别,则该样本也属于该类别。
KNN法中,所选择的邻居都是已经正确分类的对象。
KNN法的基本原理是:在给定一个未知类别的对象(样本数据)时,根据其特征属性和它最接近的K个已经知道分类的样本,对这个对象进行分类。
KNN法就是从训练集中找出这K个“邻居”,根据这K 个“邻居”的类别,来确定当前未知类别的对象的分类。
KNN法的基本流程如下:1. 从训练集中计算测试实例与每个训练集实例之间的距离;2.据距离选择K个最近邻;3.据K个邻居的类别,通过投票或者加权求和,确定测试实例的类别。
KNN法使用数据中“靠近”的训练实例来预测未知实例,因此,KNN法是一种基于实例的学习算法。
KNN法的实质是在训练集中查找与当前输入实例最在的 K 个实例,并将它们的“类标记”作为对应的输入实例的预测。
KNN法的优点是:1. KNN法的思想简单,实现容易,它不需要学习过程,也不需要假设数据的分布,只需要保存所有数据实例;2.实际数据建模时,可以有效地处理属性间关系比较复杂和数据不平衡的情况;3. KNN法可以灵活地处理不同的数据类型。
KNN法也存在一些缺点:1. KNN法需要大量的计算,当训练数据集特别大的时候,搜索K 个最近邻计算量就比较大,可能会耗费较多的时间;2. KNN法的效果依赖于k的值,但是k的值没有一个理论上的确定方法,只能选取不同的k值进行实验;3. KNN法不能很好地处理类别不平衡问题,因为它采用的算法是加权求和,类别不平衡的情况下,加权求和会倾向于那些比较多的类别;4. KNN法的思想是当前的数据点的类别取决于它的K个邻居,而这里的K个邻居都是已经被正确分类的,即每个邻居都是“正确”的,这种认为是不合理的,因为它假定K个邻居的类别都被正确分类了,而这并不一定是真的。