
计量经济学(安徽财经大学,李长风)第五章联立方程模型.
22
a2b1 a1 b1
待求的结构参数有5个,而参数关系体系中只
有4个方程,所以模型整体上是不可识别的。
第二节 联立方程模型的识别
第一节 联立方程模型概述
3.结构式模型与简化式模型的关系
第二节 联立方程模型的识别
一、识别的概念 二、识别的判别条件
第二节 联立方程模型的识别
一、识别的概念
1.识别的定义 有以下三种等价的表述形式: (1)如果联立方程模型中某个结构方程具有确定 的统计形式,则称该方程是可识别的;否则,称该 方程是不可识别的。 (2)如果联立方程模型中某个结构方程无法用模 型中的其它方程线性组合成相同的统计形式,则称 该方程是可识别的;否则为不可识别的。
第一节 联立方程模型概述
2.外生变量 取值由模型系统之外其它因素决定的变量。特点:
(1)外生变量的变化将对模型系统中的内生变量 直接产生影响,但自身变化却由模型系统之外其它因 素来决定。
(2)相对于所构造的联立方程模型,外生变量可 以视为可控的非随机变量,从而与模型中的随机误差 项不相关。
第一节 联立方程模型概述
2.联立方程模型由若干个单方程模型有机地组 合而成。
3.联立方程模型中可能同时包含随机方程和确 定性方程。
4.联立方程模型的各个方程中间可能含有随机 解释变量。
第一节 联立方程模型概述
二、联立方程模型的变量类型
1.内生变量 取值是由模型系统内部决定的变量。如例1中的消 费、投资、收入等。 特点如下: (1)既受模型中其它变量的影响,又影响模型中的其 它内生变量。 (2)一般都直接或间接地受模型系统中随机误差项的 影响,所以都是具有某种概率分布的随机变量。 (3)变量的变化一般都用模型中的某一方程来描述。
第四章 联立方程模型
第一节 第二节 第三节 第四节 第五节
联立方程模型概述 联立方程模型的识别 联立方程模型的估计 联立方程模型的检验 联立方程模型的应用
第一节 联立方程模型概述
一、联立方程模型的特点 二、联立方程模型的变量类型 三、联立方程模型的类型
返回
第一节 联立方程模型概述
一、联立方程模型的特点 【例1】宏观经济模型
Ct a0 a1Yt 1t
─消费函数
It b0 b1Yt b2Yt1 2t
─投资函数
Yt Ct It Gt
─恒等方程
式中,C=居民消费总额,Y=国内生产总值, I=投资总额,G=政府消费。
第一节 联立方程模型概述
【例2】农产品市场局部均衡模型
Qd a0 a1P a2Y 1 ─需求函数
第二节 联立方程模型的识别
2.恰好识别与过度识别 可识别的结构方程又分两种情况:如果根据参
数关系体系只能求得结构参数的唯一解,则称该结 构方程是恰好识别的;如果求解不唯一,则称其为 过度识别。
现以农产品的供需模型为例,分析模型识别状 态的变化过程。
第二节 联立方程模型的识别
模型1:
需求函数
Q=a0+a1P+a2Y+ε1
模型的经济意义明确。 (2)模型只反映了各变量之间的直接影响,却无法
直观地反映各变量之间的间接影响和总影响。 (3)无法直接运用结构式模型进行预测。
第一节 联立方程模型概述
2.简化式(Reduced form)模型 将联立方程模型中的每个内生变量都表示成前
定变量和随机误差项的函数,即用所有前定变量作 为每个内生变量的解释变量,这样形成的模型称为 简化式模型。简化式模型中的每个方程都称为简化 式方程。方程中的系数称为简化式参数(或简化式 系数),一般用符号π来表示。
Qs b0 b1P b2R 2 ─供给函数
Qd Qs
─恒等方程
式中,Qd 、Qs分别为某农产品的市场需求 量和供给量,P为该农产品的价格,Y为消费者
收入,R为影响农产品生产的天气条件指数。
第一节 联立方程模型概述
上述例题表明,联立方程模型具有如下特点:
1.联立方程模型便于研究经济变量之间的复杂 关系。
3.前定变量 相对于本期内生变量,滞后内生变量和外生变量 的值都是已知的(即已事先决定的),所以将它们统 称为前定变量(又称为先决变量)。如例1的宏观经济 模型中,前期国内生产总值Yt-1为滞后内生变量,与政 府消费G一起构成前定变量。
第一节 联立方程模型概述
三、联立方程模型的类型
1.结构式(Structural form)模型 根据经济理论和行为规律建立的、用以描述经济 变量之间关系结构的联立方程模型,称为结构式模型。 如例1、例2。 结构式模型中的每一个方程都称为结构方程,结构 方程中的系数称为结构参数,或结构式参数。
供给函数
Q=b0+b1P+ε2
在需求函数中加入一个外生变量——消费者收入
Y,则简化式模型为:
P=π10+π11Y+ν1 Q=π20+π21Y+ν2
第二节 联立方程模型的识别
参数关系体系为:
10
b0 a0 a1
a1b0 a1
a0b1 b1
第二节 联立方程模型的识别
(3)如果联立方程模型中某个结构方程中的结 构参数,可以从参数关系体系的方程组中求解得到, 则称该方程为可识别的,否则为不可识别的。
所谓统计形式,即方程中的变量和变量之间的 函数关系式。“确定的统计形式”,即模型中其它 方程或所有方程的任意线性组合所构成的新的方程, 都不再具有这种统计形式。
第一节 联立方程模型概述
结构方程一般包括以下几种类型: (1)行为方程 (2)技术方程 (3)制度方程 (4)统计方程 (5)恒等方程
如果结构式模型中方程个数等于内生变量个数, 则称结构式模型为完备的,或称其为完备模型。
第一节 联立方程模型概述
结构式模型具有如下特点: (1)模型直观地描述了经济变量之间的关系结构,
第一节 联立方程模型概述
简化式模型特点: (1)简化式方程的解释变量都是与随机误差项 不相关的前定变量。 (2)简化式参数反映了前定变量对内生变量的 总影响,包括直接影响和间接影响。 (3)利用简化式模型可以直接进行预测。 (4)简化式模型没有客观地描述经济系统内各 个变量之间的内在联系,模型的经济含义不明确。
计量经济学-联立方程计量经济学模型的系统估计

利用联立方程模型,可以分析金融市场波动性的成因和传导机制,如市
场风险、信用风险和流动性风险等。
02 03
资产配置与投资组合优化
通过构建包含多个资产类别的计量模型,可以研究不同资产之间的相关 性、风险收益特征和投资者偏好,为资产配置和投资组合优化提供决策 支持。
2
货币政策效果评估
通过构建包含多个方程的计量经济学模 型,可以评估货币政策对产出、就业、 通胀等宏观经济指标的影响,为政策制 定提供科学依据。
3
国际经济关系研究
系统估计方法可用于分析国际贸易、国 际投资和国际金融等宏观经济现象,揭 示不同国家之间经济的相互依存和影响 因素。
微观经济学领域的应用
劳动力市场分析
03
系统估计方法介绍
最小二乘法(OLS)
01 最小二乘法是计量经济学中最常用的估计方法之 一。
02
它通过最小化残差平方和来估计模型参数。
03 在满足经典假设条件下,OLS估计量具有无偏性、 一致性和有效性等优良性质。
工具变量法(IV)
1
工具变量法用于解决内生性问题,即解释变量与 误差项相关的问题。
联立方程模型的应用范围
广泛应用于宏观经济、微观经济、劳动经济、国际经济等领域的研究。
系统估计的目的和意义
系统估计的定义
系统估计是指对联立方程模型中的所有方程进行同时估计的方法。
系统估计的目的
通过同时估计所有方程,得到更加准确和一致的参数估计结果,进 而对经济现象进行更加深入的分析和预测。
系统估计的意义
2SLS可以在一定程度上减轻内生性 问题,但也可能导致估计效率降低。
三阶段最小二乘法(3SLS)
计量经济学联立方程模型
1 B 0 1
0 1 1
0 2 0
0 0 1
随堂练习二:
将前述商品的市场局部均衡模型(10-2)表示为式 (10-4)的矩阵形式
D t 0 1 Pt 2 Y t 1 t S t 0 1 Pt 2 Pt 1 2 t D S t t
1 1t 1 2 t 1 1 1 1 1t 1 2 t 1 1 1
又如:
(对于前述商品的市场局部均衡模型)
考察商品的市场局部均衡时,根据经济理论,商品需求Dt主要取决于 市场价格Pt和消费者收入Yt ,商品供给St主要取决于市场价格Pt和前一期 的市场价格Pt-1 。
提出原因:
1)为了完整、准确地描述经济系统中的变量之间的复杂关系, 2)为了进一步分析经济系统中的这种变量之间的复杂关系。
二、联立方程模型中的变量与方程
1.变 量
联立方程模型反映变量之间的双向或多向因果关系,在一个方程中
作为结果的变量,在另一方程中可能会作为原因,反之亦然。
分类:
依据——每个变量的内在含义和作用 内生变量 外生变量
D t 0 1 Pt 2 Y t 1 t S t 0 1 Pt 2 Pt 1 2 t D S t t
联立方程模型定义:
由多个方程构成的,用于描述经济系统中变量之间的相互依存关系的,
联立方程组形式的计量经济学模型。
需建立商品的市场局部均衡模型如下:
D t 0 1 Pt 2 Y t 1 t S t 0 1 Pt 2 Pt 1 2 t D S t t
需建立宏观经济模型如下:
计量经济学知识点整理:联立方程
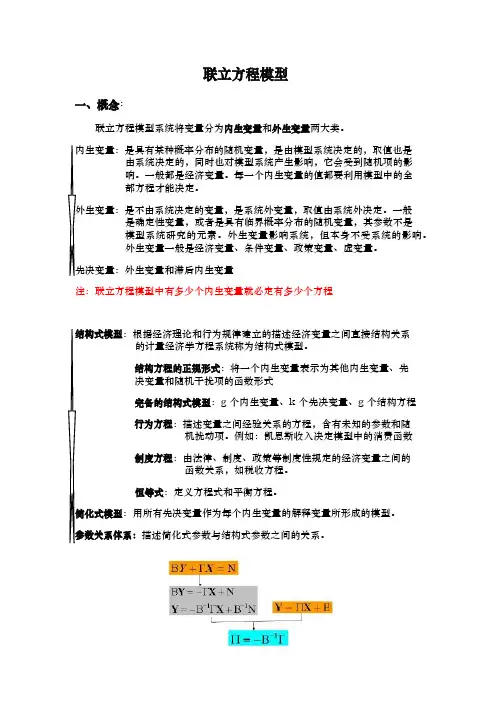
联立方程模型一、概念:联立方程模型系统将变量分为内生变量和外生变量两大类。
内生变量:是具有某种概率分布的随机变量,是由模型系统决定的,取值也是由系统决定的,同时也对模型系统产生影响,它会受到随机项的影响。
一般都是经济变量。
每一个内生变量的值都要利用模型中的全部方程才能决定。
外生变量:是不由系统决定的变量,是系统外变量,取值由系统外决定。
一般是确定性变量,或者是具有临界概率分布的随机变量,其参数不是模型系统研究的元素。
外生变量影响系统,但本身不受系统的影响。
外生变量一般是经济变量、条件变量、政策变量、虚变量。
先决变量:外生变量和滞后内生变量注:联立方程模型中有多少个内生变量就必定有多少个方程结构式模型:根据经济理论和行为规律建立的描述经济变量之间直接结构关系的计量经济学方程系统称为结构式模型。
结构方程的正规形式:将一个内生变量表示为其他内生变量、先决变量和随机干扰项的函数形式完备的结构式模型:g 个内生变量、k 个先决变量、g 个结构方程行为方程:描述变量之间经验关系的方程,含有未知的参数和随机扰动项。
例如:凯恩斯收入决定模型中的消费函数制度方程:由法律、制度、政策等制度性规定的经济变量之间的函数关系,如税收方程。
恒等式:定义方程式和平衡方程。
简化式模型:用所有先决变量作为每个内生变量的解释变量所形成的模型。
参数关系体系:描述简化式参数与结构式参数之间的关系。
二、识别方程之间的关系有严格的要求,一个方程模型想要能估计,必须可识别。
∴进行模型的估计之前需要判断模型是否可以识别(即是否能被估计)。
1、识别的基本定义:是否具有确定的统计形式。
注:识别的定义是针对结构方程而言的。
模型中每个需要估计其参数的随机方程都存在识别问题。
如果一个模型中的所有随机方程都是可以识别的,则认为该联立方程模型系统是可以识别的。
反之不识别。
恒等方程由于不存在参数估计问题,所以也不存在识别问题。
但是,在判断随机方程的识别性问题时,应该将恒等方程考虑在内。
联立方程计量经济学模型
C t 0 1Yt 1t I t 0 1Yt 2Yt 1 2t Y C I G t t t t
§6.3 联立方程计量经济学模型的识别
一、识别的概念
Ct 0 1Yt 1t I t 0 1Yt 2t Y C I t t t t 1,2, , n
• 内生变量既作为被解释变量,又可以在不 同的方程中作为解释变量。
C t 0 1Yt 1t I t 0 1Yt 2Yt 1 2 t Y C I G t t t t
一般情况,内生变量满足
Cov(Yi , i ) 0 即 E (Yi , i ) 0 因为 Cov(Yi , i ) E(Yi E (Yi )) ( i E( i )) E( (Yi E (Yi ))i ) E(Yi i ) - E(Yi )E(i ) E (Yi i )
⒊完备的结构式模型
• 具有g个内生变量、k个先决变量、g个结构方 程的模型被称为完备的结构式模型。即每个内 生变量都分别由一个方程来描述,结构方程的 数目等于内生变量的数目。
⒋完备的结构式模型的矩阵表示
• 习惯上用Y表示内生变量,X表示先决变 量,μ 表示随机项,β 表示内生变量的 结构参数,γ 表示先决变量的结构参数
11 12 1g 22 2 g 21 g1 g 2 gg
11 12 1k 21 22 2k g1 g 2 gk
简化式模型:⒈定义
• 用所有先决变量作为每个内生变量的解释变 量,所形成的模型称为简化式模型。 • 不反映经济系统中变量之间的直接关系。 • 简化式模型中作为解释变量的变量中没有内 生变量,可以采用OLS估计每个方程的参数。 • 简化式模型中每个方程称为简化式方程,方 程的参数称为简化式参数。
计量经济学联立方程
联立求解上述方程,得 P = 10 + 11Yt + 12 Pt-1 + 13 W + V1 Q = 20 + 21Yt + 22 Pt-1 + 23 W + V2 参数关系式体系为:
b20 b10 Π10 b11 b21 b11b20 b21b10 Π20 b11 b21 b12 Π11 b11 b21 b21b12 Π21 b11 b21
b22 Π12 b11 b21 b21b22 Π22 b11 b21 b13 Π13 b11 b21 b21b13 Π23 b11 b21
待求的结构式参数有七个,b10 ,b11 ,b20 , b21 , b22 , b13 ,b23,但却有八个方程组,方程有解,但 解不唯一,模型过度识别。
ct It = y t 11 12 v1 y t 1 21 22 G + v2 , t v 31 32 3
其中 ct,yt,It 为内生变量,yt-1, Gt 为前定变量,i j, (i=1, 2, 3, j=1, 2), 为简化型参数。 用如下矩阵符号表示上式 Y= X+v
b11b20 b21b10 b11u 2 b21u1 Q b11 b21 b11 b21
写成模型的简化形式: P = 10 + V1 Q = 20 + V2
b20 b10 Π10 b11 b21 b11b20 b21b10 Π20 b11 b21
如果无法从简化式模型参数估计出所有的结构模型参数——不可识别的。 如果能够从简化型模型参数估计出所有的结构模型参数——可识别的。 当结构模型参数与对应的简化型方程参数有一一对应关系——恰好识别的。 如果简化型模型,有些结构模型参数取值不惟一——过度识别的。 识别问题是完整的联立方程模型所特有的问题。只有行为方程才存在识别问题,对于定 义方程或恒等式不存在识别问题。 识别问题不是参数估计问题,但是估计的前提。不可识别的模型则不可估计。 识别依赖于对联立方程模型中每个方程的识别。若有一个方程是不可识别的,则整个联 立方程模型是不可识别的。 不可识别 模型的识别 恰好识别 可识别 过度识别
计量经济学联立方程组模型课件
Y X
2M Mt
21 1t
X u
2k k t
2t
Y
M1 1t
Y
MMMt
X
M1 1t
X u
MK k t
Mt
其中:ij 内生变量的参数 ij 前定变量的参数
矩阵形式: B Y X u
其中: 内生变量结构参数矩阵 、前定变量结构参数矩 阵分别为:
计量经济学联立方程组模型 课件
本章要解决的主要问题: 1、为什么要引入联立方程组模型(经济背景;计量经济问题);
2、联立方程组模型的识别问题;
3、联立方程组模型的估计。
前述的“单一方程模型”中只含一个被解释变量(如Y)和一个 (或多个)解释变量(如X)。
其特征:解释变量是被解释变量(如Y)变化的原因,是单向 的因果关系。
2 t1
2t
Ct =消费支出;YItt=投资Ct额;ItGt =G政t 府购买支出;Yt GDP;
解:先将模型写成一般 形式:
Ct 0 It 1Yt 0 0 Yt1 0 Gt u1t 0 Ct It 1Yt 0 2Yt1 0 Gt u2t
2)每个结构方程中的解释变量可以是前定变量(外生变量、滞 后的内生变量变量)、也可以是内生变量(当内生变量做解释变量 时,会造成解释变量与随机扰动项之间相关,违背了基本假定。此 时直接用OLS估计参数,参数估计是有偏、且不一致的(即:产生 了联立方程偏倚)) 稍后再证明。
3)结构参数表示解释变量对被解释变量的直接影响。
(它们之间的间接关系(影响)只能通过解方程才能取得)
前述 1中例 的方 1)程 中 1表 ( 的示 G: D ( Y P )每变动一 消费C支 t改 出 变 1个单位。
计量经济学联立方程模型
例11.1 凯恩斯收入决定模型
消费函数: Ct = B1 + B2*Yt +ut
(11.1)
收入恒等式:Yt = Ct + It
(11.2)
(11.1)和(11.2)表示了一个包含两个内生变量C和Y的双方程模 型。每个内生变量对应一个方程。
决定内生变量变化,描述经济中某个部门结构或行为的方程 称之为结构(structural)方程或行为(behavioral)方程。例如方 程(11.1)。
(3)假定投资I是外生决定的,比如由私人部门决定。
11.2 联立方程模型的性质
名词解释: 内生变量(endogenous variable):由系统决定的变量, 即方程中的联合相关变量。 外生变量(exogenous variable):研究系统之外决定的变 量,外生变量不受因果系统的影响。
11.2 联立方程模型的性质
11.1 联立方程模型的引入
单方程回归模型:单个因变量(Y)可以表示为若干 个解释变量(X)的函数。只考虑X对Y的影响,不考虑Y 对X的影响。
联立方程模型(Simultaneous Equation Regression Model):包含不止一个回归方程,而且变量之间存在反 馈关系的回归模型。
11.2 联立方程模型的性质
2
46
8 10 12 14 Q
Q
P 11.4 联立方程模型的识别
7
需求曲线确定。为什
s2
6 D 么?
s3
5
s1
4
E P3
2
1
0
2
46
8 10 12 14 Q
Q
11.4 联立方程模型的识别
识别问题(identification):能否唯一估计方程参数的问题。 恰度识别(exactly identified):能够唯一的估计方程参数。 不可识别(unidentified):无法估计方程参数。 过度识别(overidentified):方程中的一个或几个参数有若 干个估计值。
完整的计量经济学 计量经济学第五章 线性回归的PPT课件
X 若采用变量关系 E () ( 0 0 ) ( 1 1 )X 1 0 (2 2 )X 2 3 X 3
Y 0 1 X 1 2 X 2
Y Y
或
D 1i
0,当 i是男性时 1,当 i是女性时
38
对于截面数据计量分析的例子
对于截面数据计量分析中,观测对象特征差异导致的规律 性扰动,也可以利用虚拟变量加以处理。
如观测对象的性别是一个影响因素,解决的办法就是在模 型中引进虚拟变量,即
D1,D2,D3和D4,
这个虚拟变量就能解决由于观测对象的性别因素所导 致的误差项均值非0问题。
非线性变量关系的残差序列图
e
i
8
(三)问题的处理和非线性回归
1、模型修正和变换 恢复模型的合理非线性形式 然后再变换成线性模型
9
泰勒级数展开法
2、泰勒级数展开法 假设一个非线性的变量关系为:
Y f X 1 , ,X K ;1 P
在 处对 B 0b 1,0 ,b P 0 β1, ,P 作泰勒级数展开:
第五章 线性回归的定式偏差
1
标题添加
点击此处输入相 关文本内容
标题添加
点击此处输入相 关文本内容
总体概述
点击此处输入 相关文本内容
点击此处输入 相关文本内容
2
线性回归的定式偏差
本章讨论变量关系非线性、存在异常值、 规律性扰动和解释变量缺落等导致的线性 回归模型前两条假设不成立的定式偏差, 包括它们对线性回归分析的影响、判断和 处理的方法等。
1 0 2 0
1 1 X 2 1 X
1 2
计量经济学第五章 模型的建立与估计中的问题及对策
本章内容
第一节 误设定 第二节 多重共线性 第三节 异方差性 第四节 自相关
2
OLS估计量令人满意的性质,是根据一组假设条件而 得到的。在实践中,如果某些假设条件不能满足,则 OLS就不再适用于模型的估计。下面列出实践中可能碰 到的一些常见问题:
l 误设定(Misspecification 或specification error) l 多重共线性(Multicollinearity) l 异方差性(Heteroscedasticity或Heteroskedasticity) l 自相关(Autocorrelation)
ln Y t 01Xtut
对数-线性模型中,斜率的含义是Y的百分比变动, 即解释变量X变动一个单位引起的因变量Y的百分比 变动。这是因为,利用微分可以得出:
1dd ln YX Y 1 d d X Y d YY ( d X 1 )
7
这表明,斜率度量的是解释变量X的单位变动所 引起的因变量Y的相对变动。将此相对变动乘以100, 就得到Y的百分比变动,或者说得到Y的增长率。 由于对数-线性模型中斜率系数的这一含义,因而也 叫增长模型 (growth model)。增长模型通常用于测 度所关心的经济变量(如GDP)的增长率。例如, 我们可以通过估计下面的半对数模型
AICe2(k1)/n RSS n
与赤池信息准则类似的还有施瓦茨信息准则( Schwarz information criterion,SIC):
SICn(k1)/n RSS n
上述两个准则与前述准则 一样,可用于模型选择, 其值也是越小越好。
22
六. 检验误设定的RESET方法
前面给出了选择解释变量的四条原则。可是,有时 这些原则不能提供足够的信息使研究人员确信其设 定是最恰当的,在这种情况下,可考虑使用一些更 正规的检验方法来比较不同估计方程的性质。这类 方法相当多,这里就不一一列出,仅介绍拉姆齐(J. B. Ramsey ) 的 回 归 设 定 误 差 检 验 法 ( RESET 法 , Regression Specification Error Test)。
第五章 联立方程模型理论和方法
如果采用单方程模型方法估计某一个方程,是不 可能考虑这种相关性的,造成信息的损失。
结论:必须发展新的估计方法估计联立方程计量经济 学模型,以尽可能避免出现这些问题,这就从计量经 济学理论方法上提出了联立方程问题。
在结构方程中,解释变量中可以出现内生变量。 将一个内生变量表示为其它内生变量、先决变量和随 机误差项的函数形式,被称为结构方程的正规形式。
结构方程的类型如下:
随机方程 来自 恒等方程
行为方程
技术方程
制度方程 统计方程
定义方程 平衡方程
经验方程
例如 进行商品购买决策 由于存在收入或预算的制约,在决定是否购买某种
商品时, 必须考虑对其它商品的需求与其它商品的价格, 这样不同商品的需求量之间是互相影响、互为因果的。
那么,商品购买决策就是一个系统。 另例 国内生产总值(Y), 居民消费总额(C), 投资总额(I) 和政府消费额(或称政府支出)(G)等变量构成的简单宏观 经济系统。
对于联立方程模型系统而言,将变量分为内生变 量和外生变量两大类,外生变量和滞后内生变量又被统 称为先决变量。
1. 内生变量(endogenous variable)
• 内生变量是具有某种概率分布的随机变量, 其参数是联 立方程系统估计的元素, 内生变量是由模型系统决定的, 同时也对模型系统产生影响, 是模型求解的结果。 内生变量一般都是经济变量。
• 统计方程 描述由数据之间的相关性决定的变量之间的 关系。例如, 描述城镇居民收入与农村居民收入之间关系的方程. 在随机方程中,统计方程较多的结构式模型不是 好的模型,应尽可能地避免出现统计方程。