
生物信息数据库
生物信息数据库1生物信息数据库产生背景上个世纪60年代以来,随着核酸序列测定、蛋白质序列测定以及基因克隆和PCR技术的不断发展与完善,全世界各研究机构获得了大量的生物信息原始数据。
面对这些以指数方式增长的数据资源,传统的研究方式已经来不及迅速消化,因此有必要采用有效的方法将它们进行适当的储存、管理和维护,以便进一步分析、处理和利用,这就需要建立数据库即生物信息数据库[1]。
生物信息数据库是一切生物信息学工作的基础。
2生物信息数据库的特点2.1数据库种类的多样性。
生物信息学各类数据库几乎覆盖了生命科学的各个领域,如核酸序列数据库,蛋白质序列数据库,蛋白质、核酸、多糖的三维结构数据库,基因组数据库,文献数据库和其他各类达数百种。
2.2数据库的更新和增长快。
数据库的更新周期越来越短,有些数据库每天更新。
数据的规模以指数形式增长。
2.3数据库的复杂性增加、层次加深。
许多数据库具有相关的内容和信息,数据库之间相互引用,如PDB就与文献库、酶学数据库、蛋白质二级数据库、蛋白质结构分类数据库、蛋白折叠库等十几种数据库交叉索引。
2.4数据库使用高度计算机化和网络化。
越来越多的生物信息学数据库与因特网联结,从而为分子生物学家利用这些信息资源提供了前所未有的机遇[2]。
2.5面向应用。
首先各个数据库除了提供数据之外,还提供许多分析工具,如核酸数据库提供的序列搜索、基因识别程序等。
此外,还在原始数据库的基础上开发了许多面向特殊应用的二级数据库,如蛋白质二级结构数据库等[3]。
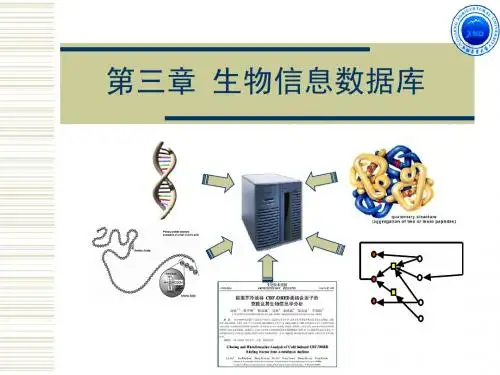
3生物信息数据库的分类生物信息数据库种类繁多,归纳起来,大体可以分为5个大类:核酸序列数据库、基因组数据库、蛋白质序列数据库、生物大分子(主要是蛋白质)结构数据库以及以这4类数据库和文献资料为基础构建的二次数据库。
其中主要类型是序列数据库[4]。
来自基因组作图的基因组数据库、来自序列测定的序列数据库以及来自X-衍射和核磁共振结构测定的结构数据库是分子生物信息学的基本数据资源,通常称为基本数据库或初始数据库,也称一次数据库。
根据生命科学不同研究领域的实际需要,在一次数据库、实验数据和理论分析的基础上进行整理、归纳和注释,构建具有特殊生物学意义和专门用途的数据库即二次数据库, 也称专门数据库、专业数据库或专用数据库[2, 3, 5]。
3.1核酸序列数据库EMBL、GenBank和DDBJ是国际上三大主要核酸序列数据库。
EMBL是德国海德堡市的欧洲分子生物学实验室(European Molecular Biology Laboratory)1980年创建的,其名称也由此而来。
美国国家健康研究院(National Institurte of Health,简称NIH)也于1982年委托洛斯阿拉莫斯(Los Alamos)国家实验室建立GenBank,后移交给美国国立卫生研究院国家生物技术中心(National Center for Bio-technology Information—NCBI)。
DDBJ是日本静冈市的日本国立遗传学研究所于1986年创建的日本DNA数据库(DNA Database of Japan—DDBJ)。
1988年,EMBL、GenBank与DDBJ共同成立了国际核酸序列联合数据库中心,建立了合作关系。
根据协议,这三个数据库分别收集所在区域的有关实验室和测序机构所发布的核酸序列信息,并共享收集到的数据,每天交换各自数据库新建立的序列记录,以保证这三个数据库序列信息的完整性[2]。
3.2基因组数据库基因组数据库的主体是模式生物基因组数据库,其中最主要的是由世界各国的人类基因组研究中心、测序中心构建的各种人类基因组数据库。
小鼠、河豚鱼、拟南芥、水稻、线虫、果蝇、酵母、大肠杆菌等各种模式生物基因组数据库或基因组信息资源都可以在网上找到[2]。
3.3蛋白质序列数据库PIR和SWISS-PROT是创建最早、使用最为广泛的两个蛋白质数据库。
1984年,“蛋白质信息资源”(Protein Information Resource,简称PIR)计划正式启动,蛋白质序列数据库PIR也因此而诞生。
SWISS-PROT由瑞士日内瓦大学生化系A.Bairoch于1986年创建,目前由瑞士生物信息学研究所(Swiss Institute of Bioinformatics,简称SIB)和欧洲生物信息学研究所(EBI)共同维护和管理。
其他主要的蛋白质序列数据库还有NRl3D、TrEMBL、GenPep、NRDB 和OWL等[2]。
3.4生物大分子结构数据库PDB是目前最主要的收集生物大分子(蛋白质、核酸和糖)三维结构的数据库,是通过X 射线单晶衍射、核磁共振、电子衍射等实验手段确定的蛋白质、多糖、核酸、病毒等生物大分子的三维结构数据库。
它是由美国纽约Brookhaven国家实验室于1971年创建的。
蛋白质结构分类数据库,是三维结构数据库的重要组成部分。
蛋白质结构分类可以包括不同层次,如折叠类型、拓扑结构、家族、超家族、结构域、二级结构、超二级结构等。
已经上网的蛋白质分类数据库很多,主要有SCOP和CA TH[2]。
3.5生物信息二次数据库随着基因组研究的不断深入,越来越多基因的结构和功能得到阐明,已有大量的公共数据库系统可供研究者使用。
但在针对特定物种的生物信息学分类和分析方面仍有待进一步开发,这些公共数据库在内容、数据综合和检索途径上不一定能满足实际研究的需要,因此以基因组、序列和结构数据库为基础,结合文献资料,研究开发更具特色、更便于使用的二次数据库,或专用数据库信息系统,已经成了生物信息学研究的一个重要方面[2, 6]。
3.5.1基因组二次数据库网上有各类基因组二次数据库,法国巴斯德研究所构建的大肠杆菌基因组数据库就是基因组二次数据库的一个实例。
其他的此类数据库还有德国生物工程研究所开发的真核生物基因调控转录因子数据库TransFac、真核生物启动子数据库EPD(Eukaryotic Promoter Database)、克隆载体数据库Vector,密码子使用表数据库CUTG[2]、禾本科比较基因组数据库Gramene[7, 8]、棉花微卫星标记数据库CMD[9]。
3.5.2蛋白质二次数据库PROSITE(Protein Sites and Patterns Database)数据库是第一个蛋白质序列二次数据库,90年代初期开始构建,现由瑞士生物信息学研究所SIB维护。
蛋白质功能位点序列片段数据库PRINTS,同源蛋白家族数据库Pfam,同源蛋白结构域数据库Blocks等也属此类数据库[2]。
另外,以具有特殊功能的蛋白为基础构建的二次数据库有免疫球蛋白数据库Kabat,蛋白激酶数据库PKinase等。
以三维结构原子坐标为基础构建的数据库为结构分子生物学研究提供了有效的工具,如蛋白质二级结构构象参数数据库DSSP,已知空间结构的蛋白质家族数据FSSP,已知空间结构的蛋白质及其同源蛋白数据库HSSP等[2]。
3.5.3文献数据库及软件目录数据库Internet上有许多生物软件目录和档案库,其中最主要的站点是美国印地安那大学的IUBio生物学软件档案和欧洲生物信息研究所EBI维护的Biocatalog软件目录[10]。
3.5.4生物信息数据库集成系统生物信息数据库设计中出现了向整合发展的新潮流,如将多种图谱、数据整合到一个数据库中,在数据库中还提供众多的通向其他网络数据库的途径,以实现多功能、复合、开放的新型数据库系统。
集成化还包括将数据库与数据分析软件整合,在新型的数据库系统中提供丰富的数据分析软件,为研究者分析利用数据提供方便[2]。
SRS序列检索系统(Sequence Retrieval System)是EBI/EMBL在WWW服务器上开发的功能十分强大的序列数据库检索系统,能够检索45个核酸和蛋白质序列数据库、三维结构库、基因数据库及其他生物信息学数据库[11]。
NCBI提供的Entrez是另一个基于多种数据库可进行交叉检索的集成系统,2003年10月进行了改版,可同时进行多个数据库的跨库检索,也可根据需求选择一个或若干数据库以及数据库内的信息进行有机的链接,服务方式灵活多样,充分满足不同用户的需求[11, 12]。
3.5.5二次数据库的开发张荣志[6]等开发了棉花分子生物学数据库,搭建数据库的环境为利用Linux操作系统建立Web站点,选用Apache服务器和MySQL数据库,主要采用PHP实现动态数据交换。
该生物学数据库系统包括用户登录系统、数据库查询系统和数据库管理系统。
4生物信息数据库的利用4.1运用数据库搜索及序列比较利用生物信息学数据库对于许多新得到的序列,我们并不知道其相应的生物功能。
生物学研究人员能够通过搜索序列数据库找到与新序列同源的已知序列,并根据同源性推测新序列的生物功能。
搜索同源序列在一定程度上就是通过相似比较寻找相似序列的[5]。
4.2运用数据挖掘技术利用生物信息学数据库数据挖掘是一种从大型数据库或数据仓库中提取隐藏的预测性信息的新技术,它能开采出潜在的知识,找出最有价值的信息,指导商业行为或辅助科学研究。
目前,序列分析、基因表达、同源性研究、蛋白质结构预测以及药物设计等领域都为数据挖掘提供了广阔的研究空间,也显示出了数据挖掘在这些方面的发展潜力[5]。
5生物信息数据库发展状况5.1国际发展状况2000年以前,生物信息学研究处于起步阶段,发展较为缓慢,自进入2000年以后,生物信息学数据库研究进入了快速发展阶段。
研究结果主要发表在Nucleic Acids Research、Bioinformatics、BMC Bioinformatics等期刊上[13]。
生物信息学数据库的研制开发主要集中在发达的欧美国家,如美国、英国、法国等。
而巴西、希腊、南非等国家创建和维护的数据库很少。
另一方面,无论哪一个国家,其研发的数据库并未占绝对优势。
生物信息学数据库的更新频率与当前生物信息的增长极不相称,尚不能及时满足广大科研人员对生物信息的需求,有待进一步加快数据库的更新频率[4]。
5.2国内发展状况北京大学生物信息中心PKUCB于1997年建立EMBnet的中国节点,同时它也是亚太生物信息网APBionet的中国节点,现在可提供92个数据库的检索与利用,这对我国的生物信息学的发展起着非常重要的作用。
北京大学物理化学研究所于1996年建立了国内第一家生物信息学网络服务器。
中国科学院上海生命科学研究院生物信息中心网站维护我国的核酸序列公共数据库[10]。
但是与发达国家仍存在较大差距,我们应加快生物信息学数据库引进的力度,同时研制开发更多的数据库,加速国内信息网络建设,提供快捷、方便的数据库、软件和在线服务,促进我国生物信息学的发展[4]。
生物信息学数据库分类整理汇总

生物信息学数据库分类整理汇总生物信息学数据库是存储和管理生物学领域的大量数据的重要工具和资源,对于生物信息学研究、基因组学、蛋白质组学、转录组学等领域的研究具有重要的意义。
本文将对生物信息学数据库进行分类整理和汇总,方便生物信息学研究者更好地使用和了解这些数据库。
1.基因组数据库:- GenBank:美国国家生物技术信息中心(NCBI)维护的基因序列数据库,包含已知基因的核酸序列。
- Ensembl:英国恩格斯尔基因组项目维护的一个综合性基因组数据库,包含多种物种的基因组数据。
- UCSC Genome Browser:加利福尼亚大学圣克鲁兹分校开发的一个基因组浏览器,提供多种物种的基因组序列和注释信息。
2.蛋白质数据库:- UniProt:一个综合性的蛋白质数据库,集成了多个蛋白质序列和注释信息资源。
- Protein Data Bank (PDB):存储大量已解析的蛋白质结构数据的数据库,提供原子级别的结构信息。
- Protein Information Resource (PIR):收集和整理蛋白质序列、结构和功能信息的数据库。
3.转录组数据库:- NCBI Gene Expression Omnibus (GEO):存储和共享大量的高通量基因表达数据的数据库。
- ArrayExpress:欧洲生物信息学研究所(EBI)开发的一个基因表达数据库,包含多种生物组织和疾病的表达数据。
4.疾病数据库:- Online Mendelian Inheritance in Man (OMIM):记录人类遗传疾病和相关基因的数据库。
- Orphanet:收集和整理罕见疾病和相关基因的数据库。
5.代谢组数据库:- Human Metabolome Database (HMDB):一个综合性的人类代谢物数据库,包括代谢产物的结构和功能信息。
- Kyoto Encyclopedia of Genes and Genomes (KEGG):包含多种生物体代谢途径的数据库。
生物信息学中的数据库和计算工具

生物信息学中的数据库和计算工具生物信息学是一门综合性学科,应用范围十分广泛。
生物信息学研究的是生物体内的遗传信息的获取、存储、分析和应用。
它结合了生物学、信息学、计算机科学、数学等多个学科,旨在解决生物大数据的存储、分析和挖掘问题。
本文将介绍生物信息学中的数据库和计算工具,以及它们在生物信息学中的应用。
一、生物信息学中的数据库生物信息学中的数据库是受到生物学家和计算机科学家制作和维护的存储和组织生物数据的资源。
这些数据库包括基因组、蛋白质、代谢、信号转导、基因表达谱等生物信息学数据库。
生物信息学中的数据库已经成为研究生物学的常规工具,研究人员可以通过分析数据库中的信息来更好地理解生物学现象。
1. 基因组数据库基因组数据库是生物信息学中最重要的数据库之一。
它存储了各种物种的基因组信息。
基因组数据库的应用包括基因预测、基因注释、基因功能鉴定、基因组进化分析等。
最知名的基因组数据库包括 GenBank、EMBL、Ensembl 等。
其中 GenBank 是最大的公共基因组数据库之一,它由美国国家生物技术信息中心(NCBI)维护。
2. 蛋白质数据库蛋白质数据库是存储蛋白质结构和序列信息的数据库。
其中,PDB是最著名的蛋白质数据库之一,它提供了大量的蛋白质三维结构的信息。
此外,UniProt 是另一重要的蛋白质数据库,它整合了多个独立的蛋白质数据库,提供了关于蛋白质序列、结构和功能的详细信息。
3. 引用数据库引用数据库存储了生物学家在论文、会议和其他出版物中发表的研究结果。
它们经常被生物信息学家用于构建生物信息学算法的基础,并分析特定领域的研究趋势。
PubMed 和 Web of Science 是引文数据库的代表性例子。
二、生物信息学中的计算工具随着数据量的增加和分析复杂度的提高,生物信息学中出现了大量的计算工具用于帮助生物科学家完成各种分析任务。
这些工具包括序列比对、序列拼接、批量序列处理、统计分析、数据可视化、机器学习等。
生物信息数据库的构建和管理研究

生物信息数据库的构建和管理研究随着生物学的逐步深入,越来越多的生物信息需要进行收集、整合和存储。
生物信息数据库的构建和管理成为了一个备受关注的领域。
它们不仅可以为科学研究提供重要的数据资料,同时也可以为学术交流和产业应用做出极大的贡献。
一、生物信息数据库的意义生物信息数据库是为研究生命科学而建立的集合性资料库,它是一个备受科学研究者和医学工作者欢迎的资源。
生物信息数据库可以用来存储和共享不同组织和实验室中的实验数据、观测结果和分析结果。
利用生物信息数据库,研究者们可以更方便的共享数据、访问信息,并且能够开展更高水平的数据挖掘和分析工作,从而推进生物学和医疗健康领域的变革和进步。
二、生物信息数据库构建的几个关键步骤生物信息数据库的构建是一个繁琐且复杂的过程。
具体来说,它包括了以下几个关键步骤:1、收集数据构建生物信息数据库的第一步是收集数据。
需要的数据可能来自于实验室、病理数据、临床测试数据或者电子医疗记录等不同的来源,需要考虑到收集到的数据是否有价值、可靠和完整,确保它们可以用于后续的数据分析和挖掘。
2、清理数据在收集数据之后,需要进行数据的清理。
数据清理的作用是去除错误、重复和缺少的数据,以确保数据的质量和完整性。
同时,还需要对数据进行转化,使其适合于不同的数据模型和数据存储结构。
3、建立数据库在数据清理之后,需要建立一个稳定可靠的数据库。
要确保数据库的数据模型、数据存储结构和扩展性能够与未来可能出现的需求相适应。
同时还需要考虑到数据库的性能需求和安全性。
4、填充数据库建立好数据库之后,需要将数据填充进去。
这个过程需要借助于数据导入和数据迁移工具,确保数据的顺利导入和转换。
在数据填充的过程中,还需要进行数据验证和数据校准,以确保数据的准确性和实用性。
5、实现数据分析与挖掘最后,需要实现数据库的数据分析和挖掘功能。
主要包括数据预处理、数据挖掘和数据可视化等方面。
这个过程需要借助于专业的数据分析工具和算法,确保数据分析和挖掘的准确性和结果可信度。
流行病学研究中的生物信息学数据库与资源应用

流行病学研究中的生物信息学数据库与资源应用随着科技的不断发展和进步,生物信息学在流行病学研究中的应用变得越来越重要。
生物信息学数据库和资源成为流行病学研究人员的重要工具,可以提供宝贵的数据和信息,帮助研究人员深入了解疾病的发生和传播机制。
本文将详细介绍流行病学研究中常用的生物信息学数据库和资源,以及它们的应用。
一、SNP数据库SNP(single nucleotide polymorphism)数据库是研究流行病学中最常用的数据库之一。
SNP是指基因组中的单个核苷酸变异,可用来研究人与人之间的遗传差异以及遗传变异与疾病之间的关系。
常见的SNP数据库包括dbSNP、HapMap和1000 Genome等。
这些数据库存储了大量的SNP信息,研究人员可通过检索和分析这些数据库中的数据,揭示SNP与疾病的相关性,为流行病学研究提供重要的依据。
二、基因表达数据库基因表达数据库存储了不同组织和细胞中的基因表达水平信息,对于分析疾病的遗传机制和发生发展过程起着重要作用。
常见的基因表达数据库包括Gene Expression Omnibus(GEO)和The Cancer Genome Atlas(TCGA)等。
研究人员可通过这些数据库获取基因在特定组织或疾病状态下的表达水平信息,进一步研究基因与疾病的关联性。
三、蛋白质数据库蛋白质数据库存储了大量的蛋白质序列和结构信息,对于研究疾病的发生机制和蛋白质功能起着重要作用。
常见的蛋白质数据库包括UniProt、Protein Data Bank(PDB)和STRING等。
研究人员可通过这些数据库获取蛋白质的序列、结构和功能信息,揭示蛋白质与疾病之间的关系,为流行病学研究提供有力支持。
四、基因组数据库基因组数据库存储了各种物种的基因组序列信息,为研究物种的遗传特性和基因功能提供了重要数据。
常见的基因组数据库包括GenBank、Ensembl和UCSC Genome Browser等。
生物信息数据库
NCBI:
二、重要生物信息数据库
生物信息学数据的表示形式
生物信息学数据的表示形式
平面文件 (flat-file)
– 信息在文件中顺序存放且具有特定格式 – 记录(Entry)通过“获得号”(accession #)
唯一确定 – 同一文件间和不同文件间信息的联系均
通过ac认为这些蛋白质具有 相同的折叠方式。在这些情况下,结构的相似性主要依 赖于二级结构单元的排列方式或拓扑结构。
蛋白质结构分类数据库CATH
类型Class、构架Architecture 、拓扑结构Topology和 同源性Homology 。
分类基础是蛋白质结构域。与SCOP不同的是,CATH 把蛋白质分为4类,即a主类、b主类,a-b类(a/b型 和a+b型)和低二级结构类。低二级结构类是指二级 结构成分含量很低的蛋白质分子。
描述了结构和进化关系。 SCOP数据库从不同层次对蛋白质结构进行分类,以反
映它们结构和进化的相关性。 第一个分类层次为家族,通常将序列相似性程度在30%
以上的蛋白质归入同一家族,有比较明确的进化关系。 超家族:序列相似性较低,结构和功能特性表明它们有
共同的进化起源,将其视作超家族。 折叠类型:无论有无共同的进化起源,只要二级结构单
EMBL格式: 欧洲分子生物学EMBL数据库的每个条目是一份纯文 本文件,每一行最前面是由两个大写字母组成的识别 标志,常见的识别标志列举在后面的表中。识别标志 “特性表”FT包含一批关键字,它们的定义已经与 GenBank和DDBJ统一。下欧洲国家的许多数据库如 SWISS-PROT、ENZYME、TRANSFAC等,都采用 与EMBL一致的格式。
1)头部包含关于整个序列的信息(描述字符),从 LOCUS行到 ORIGIN行;
第三章生物信息数据库
部分生物基因组计划网址
老鼠(Mouse) /mgd.html 小鼠(Rat) http://ratmap.gen.gu.se 狗(Dog) /dog.html 牛(Cow) http://locus.jouy.inra.fr/cgibin/bovmap/intro2.pl 猪(Pig) /pigmap/pigbase/pigbase.html 羊(Sheep) 鸡(Chicken) /chickmap/chickbase/manager.html 斑马鱼(Zebra fish) 线虫 (C. elegans) http://www.ddbj.nig.ac.jp/htmls/celegans/html/CE_INDEX.ht ml 果蝇(Drosophila) 蚊子(Mosquito) 拟南芥(Arabidopsis) /Arabidopsis 棉花(Cotton) 玉米(Maize) 水稻(Rice) http://www.staff.or.jp 大豆(Soya) :8000/main.html 树(Trees)
2、蛋白质序列数据库
SWISS-PROT (欧洲) PIR (美国)
SWISS-PROT (http://www.expasy.ch/sprot/sprot-top.html) 由瑞士日内瓦大学医学生物化学系和欧洲生物信息学研究 所(EBI)合作维护; 在EMBL和GenBank数据库上均建立了镜像站点;
SWISSPROT
到EMBL核酸序列数据库的索引, 到PROSITE模式数据库的索引, 到生物大分子结构数据库PDB的索引等
PIR (Protein Information Resource)
生物信息学中常用的数据类型和数据库类型
生物信息学中常用的数据类型和数据库类型
在生物信息学中,常用的数据类型包括:
1. 基因组序列数据:包括DNA和RNA序列的原始数据,如FASTA格式或FASTQ格式。
2. 转录组数据:包括基因表达谱、剪接变异等,如RNA-seq数据。
3. 蛋白质序列数据:包括蛋白质的氨基酸序列,如UniProt数据库。
4. 基因组结构数据:包括基因位置、外显子、内含子等信息。
5. 遗传变异数据:包括SNP、INDEL、CNV等遗传变异信息。
6. 蛋白质结构数据:包括蛋白质的三维空间结构,如PDB数据库。
在生物信息学中,常用的数据库类型包括:
1. 基因组数据库:如NCBI GenBank、ENSEMBL等,存储基因组序列和注释信息。
2. 转录组数据库:如NCBI SRA、ENA等,存储RNA-seq和其他转录组数据。
3. 蛋白质数据库:如UniProt、Swiss-Prot等,存储蛋白质序列和注释信息。
4. 遗传变异数据库:如dbSNP、ClinVar等,存储遗传变异信息。
5. 蛋白质结构数据库:如PDB、CATH等,存储蛋白质的三维结构信息。
6. 功能注释数据库:如GO数据库、KEGG数据库等,存储基因和蛋白质的功能注释信息。
7. 互作数据库:如STRING数据库、BioGRID数据库等,存储基因和蛋白质之
间的相互作用信息。
06第六章 常用生物信息学数据库简介
英国辛克斯顿
ID U00096 standard; circular genomic DNA; CON; 4639221 BP. AC U00096; SV U00096.1 DT 24-JUL-2003 (Rel. 76, Last updated, Version 3) DE Escherichia coli K-12 MG1655 complete genome. KW . OS Escherichia coli K12 OC Bacteria; Proteobacteria; Gammaproteobacteria; Enterobacteriales; OC Enterobacteriaceae; Escherichia; Escherichia coli. RN [1] RP 1-4639221 RX MEDLINE; 97426617. RX PUBMED; 9278503. RA Blattner F.R., Plunkett G. III, Bloch C.A., Perna N.T., Burland V.,… RT "The complete genome sequence of Escherichia coli K-12"; RL Science 277(5331):1453-1474(1997). DR GOA; O32528. DR REMTREMBL; AAC74436; AAC74436. DR SPTREMBL; O32530; O32530. DR SWISS-PROT; O32528; YPDI_ECOLI. …
EMBL数据库简介
EMBL是最早的DNA序列 数据库,于1982年建立。
EMBL的数据来源主要有两条途径: 一是由序列发现者直接提交。几乎所有的国际权 威生物学刊物都要求作者在文章发表之前将所测定的 序列提交给EMBL、GenBank或DDBJ,得到数据库管 理系统所签发的登录注册号。 二是从生物医学期刊上收录已经发表的序列资料。
生物信息学数据库
BLAST:碱基局部对准检索工具
Basic Locul Alignment Search Tool
可进行核苷酸序列、蛋白质序列方面的 同源性分析,能在8秒内在整个DNA数据库 中进行序列比较。
diabetes
顺序号中第1位数字表示所涉及 基因的遗传类型: 1:常染色体显性(1994.5.15前创建) 2:常染色体隐性(1994.5.15前创建) 3:X连锁基因座或表现型 4:Y连锁基因座或表现型 5:线粒体基因座或表现型 6:常染色体基因座或表现型 (1994.5.15后创建的条目)
比较结果页面
彩色积 分图
序 列 相 似 存贮号 描 述
描述
积分
检索 范围
E值 统计
链接
相似率为100%
序列对准 描述
三、基因组数据库
1、Genome:可获得800多种生物体的基 因组数据,部分已完成测序。
2、人类基因组资源: human genome resources
整合了多种相关的分子生物学数据库和 公共分析软件,为科研人员提供了自动化 的实验数据获得、加工和整理途径,为基 因区域的预测和基因功能预测提供了一系 列便捷的方法。
序列数据库 结构数据库 生物信息学数据库的种类 图谱数据库 突变数据库 文献数据库
专业杂志 生物信息学数据库的查找方法 专门数据库目录的网站
著名的生物信息学中心
参见教材p227--p242
NCBI数据库组织
一、NCBI中的生物信息数据库
1)、PubMed: 生物医学文献数据库 2)、Nucleotide:核酸序列数据库 3)、Protein sequence database:
生物信息数据库及生物信息分析软件应用
可以选择几款主流的生物信 息分析软件进行试用和比较, 了解其功能、性能和易用性 等方面的差异。
在使用软件之前,建议参加 相关的培训和学习课程,了 解软件的基本操作和分析流 程。
社区支持
大多数生物信息分析软件都 有活跃的社区和论坛,可以 在其中寻求帮助和交流经验。
软件的应用和发展趋势
广泛应用
生物信息分析软件在生命科学领域得 到了广泛应用,支持多种类型的生物 信息分析。
生物信息数据涉及个人隐私, 如何在分析利用数据的同时保 障安全和隐私是一大挑战。
许多生物信息分析软件操作复 杂,非专业用户难以掌握;同 时,随着新技术、新方法的出 现,软件需要不断更新和升级 以适应需求。
生物信息学领域发展迅速,新 的分析方法和技术不断涌现, 对硬件设备的要求也越来越高 ,如何平衡计算性能与成本是 一大挑战。
软件提供了多种数据分析工具,如差异表达分析、基因注释、 通路分析等。
软件可以将数据分析结果以图形、图表等形式直观地展示出来 ,方便用户理解和分析。
软件支持与其他生物信息软件的集成,同时也提供了开放的API 接口,方便用户进行二次开发和功能拓展。
软件的选择和使用
需求分析
试用与比较
培训与学习
在选择软件时,需要根据具 体需求进行分析,如数据规 模、分析目标、计算资源等。
生物信息数据库和软件可以帮助医生快速查找和比对疾病相关的文献、研究成果和临床数据,为疾病的 诊断和治疗提供参考。
在个性化治疗中的应用
01
个体化用药
02
细胞治疗
通过生物信息数据库和软件,医生可 以根据患者的基因型、表型等信息, 制定个体化的药物治疗方案,提高治 疗效果并减少副作用。
利用生物信息分析软件,对患者的细 胞进行基因编辑和改造,实现个体化 的细胞治疗,为癌症、遗传性疾病等 疾病的治疗提供新的途径。