
统计实验与SAS上机简易过程步
数据统计分析一般可遵循以下思路:(1)先确定研究目的,根据研究目的选择方法。
不同研究目的采用的统计方法不同,常见的研究目的主要有三类:①差异性研究,即比较组间均数、率等的差异,可用的方法有t检验、方差分析、χ2检验、非参数检验等。
②相关性分析,即分析两个或多个变量之间的关系,可用的方法有相关分析。
③影响性分析,即分析某一结局发生的影响因素,可用的方法有线性回归、logistic回归、Cox 回归等。
(2)明确数据类型,根据数据类型进一步确定方法:①定量资料可用的方法有t检验、方差分析、非参数检验、线性相关、线性回归等。
②分类资料可用的方法有χ2检验、对数线性模型、logistic回归等。
下图简要列出了不同研究目的、不同数据类型常用的统计分析方法。
(3)选定统计方法后,需要利用统计软件具体实现统计分析过程。
SAS中,不同的统计方法对应不同的命令,只要方法选定,便可通过对应的命令辅之以相应的选项实现统计结果的输出。
(4)统计结果的输出并非数据分析的完成。
一般统计软件都会输出很多结果,需要从中选择自己需要的部分,并做出统计学结论。
但统计学结论不同于专业结论,最终还需要结合实际做出合理的专业结论。
第一部分:统计描述1.定量资料的统计描述指标及SAS实现;(1)数据分布检验:PROC UNIVARIATE①基本格式:②语句格式示例:1.PROC UNIVARIATE normal;/*normal选项表示进行正态性检验*/2.CLASS group;/*指定group为分组变量*/3.VAR weight;/*指定分析变量为weight*/4.RUN;③结果:正态性检验(tests for normality)结果,常用的是Shapiro-Wilk 检验和Kolmogorov-Smirnov检验。
当例数小于2000时,采用Shapiro-Wilk检验W值为标准;当例数大于2000时,SAS中不显示Shapiro-Wilk检验结果,采用Kolmogorov-Smirnov检验D值为判断标准。
正态性检验的P≤0.05提示不服从正态分布,P>0.05提示服从正态分布。
注:若服从正态分布,进行PROC MEANS过程步;若不服从则计算百分位数,转(3)(2)数据描述(符合正态分布的数据):PROC MEANS①基本格式:关键字(可以无视):不写任何关键字时默认输出n,mean,std,max,min;n:有效数据记录数(有效样本量) median:中位数mean:均数 qrange:四分位数间距std:标准差 var:方差clm:95%可信区间 max、min:最大、最小值②语句格式示例:1.PROC MEANS n mean std median qrange clm;/*关调用proc means过程,要求输出的指标有例数、均值、标准差、中位数、四分位数间距、95%可信区间*/2.CLASS group;/*指定group为分组变量*/3.VAR weight;/*指定分析变量为weight*/4.Run;③结果以“均数±标准差”表示(3)偏正态分布的统计描述:①基本思想:计算中位数和百分位数,并且用“中位数(Q1~Q3)”表示②语句格式示例:1.proc univariate data=aa;2.var x;3.output out=c pctlpre=P pctlpts=0 to 100 by 2.5;/*计算0到100百分位数,间隔2.5个百分位数,并将结果输出在数据集“aa”中*/4.run;5.proc transpose data=c out=d;6.proc print data=d;7.run;/*以上是求解百分位数语句*/1.proc univariate data=aa2.CIPCTLDF(alpha=0.05);/* 求百分位数的95%可信区间,(alpha=0.05)此处可缺省;若需求可信区间,只需指定相应的alpha水平*/3.var x;4.run;③结果:a.偏态分布的统计描述以“中位数(Q1~Q3)”表示b.总体参数的95%可信区间2.分类(定性)资料的统计描述指标及SAS实现(1)输出频数表:PROC FREQ①基本格式:②语句格式示例:1.PROC FREQ;2.TABLE group * weight;/*table后有group和grade两个变量,交叉形成一个行X列的表格,若group为2类,grade为3类,因此形成2X3=6个格子,每一格子中给出例数和相应比例*/3.RUN;(2)直方图的绘制①基本语句:histogram 变量x②语句格式示例:1.proc univariate;2.var x;3.histogram x/midpoints=163 to 183 by 2; /*要求Univariate过程绘制的直方图中各直条的组中值为163、165、……183(自行改动)*/4.run;(3)计算基本统计量和95%可信区间:PROC UNIVARIATE①基本要求:计算定性资料的95%可信区间②语句格式示例:1.proc univariate cibasic; /*基本统计量及其可信区间,对应于CIBASIC选项*/2.var x;3.run;③结果:此步骤结果只需观察SAS结果中的“基本置信限正态假设”一栏,其他可无视。
第二部分:定量资料的统计分析1.单一样本均数的检验(1)直接公式编辑①适用条件:没有原始数据,而只知道样本均数及已知总体的总体均数时②方法示例:某医生测量了36名从事某作业的男性工人的血红蛋白含量,其均值为130.83g/L,标准差为25.74g/L。
问从事该作业男性工人的血红蛋白含量是否不同于正常成年男性的均值140g/L③SAS过程步:1.data aa;2.n=36;3.sm=130.83;/*样本均数*/4.std=25.74; /*样本标准差*/5.pm=140; /*总体均数*/6.df=n-1; /*自由度*/7.t=(sm-pm)/(std/sqrt(n)); /*单样本t 检验的计算公式*/8.p=(1-probt(abs(t),df))*2;/* ①abs(x)函数:返回x的绝对值。
②probt(x,df)函数:是student t分布的概率分布函数,用于计算自由度为df的t分布在t取x值时的概率。
因为是做双侧检验,所以求得一侧的概率值后再乘以2*/9.proc print;10.var t p;11.run;③结果使用t和p值(2)利用MEANS或UNIVARIATE过程计算①已知样本资料的原始数据,单样本t 检验可以利用MEANS过程和UNIVARIATE过程实现②语句格式示例:1.proc means mean std t ptr;2.var y;/*y值为每一个观测值与已知总体均数的差值*/3.run;或者1.proc univariate;2.var y;/*y值为每一个观测值与已知总体均数的差值*/3.run;③方法类似于统计描述,结果指标为t和p值2.完全随机两组正态分布资料的比较①分析思路:两组比较属于差异性研究,再看是否正太,可考虑方法有独立样本的t检验或Wilcoxon秩和检验,具体还应进一步看资料的分布情况。
②正态性检验:1.proc univariate normal;2.class group; var x;3.run;若为正态性则可使用t检验,否则使用Wilcoxon秩和检验(见后文)③t检验语句:1.proc ttest2.class group;3.var x;4.run;④结果:观察t值和p值,给出结论3.完全随机两组非正态分布资料的比较①思路同上2,首先进行正态性检验;语句略②非正态分布时两组之间的秩和检验语句:1.proc npar1way Wilcoxon;/*wilcoxon选项给出wilcoxon和Kruskal-Wallis检验值*/2.class group;3.var x;4.run;③秩和检验观察Z值和P值,得出结论4.完全随机多组正态分布资料的比较①前提是研究为完全随机设计,需要分析两组数据的变化值,因此可以考虑方差分析或Kruskal-Wallis秩和检验,具体还应进一步看资料是否符合正态分布;②正态性检验确定具体分析方法,若为正态,使用方差分析,否则为Kruskal-Wallis秩和检验(非参数检验,见后文):正态性检验过程步略···③方差分析:只有glm过程,anova过程请参考课件1.proc glm;2.class group;3.model x=group;4.means group/hovtest lsd;/*使用lsd法进行两两比较并给出p值*/5.run;④根据两组之间p值是否有意义给出结论5.完全随机多组非正态分布资料的比较①同上思路,首先正态检验,不符合时候,使用多组之间的Kruskal-Wallis 秩和检验;首先进行秩和检验:1.proc npar1way Wilcoxon;/*wilcoxon选项给出wilcoxon和Kruskal-Wallis检验值*/2.class group;3.var x;4.run;②多组非正态分布资料两两之间的比较的过程步:(原理:对研究变量的秩进行排序,用方差分析对秩次进行两两比较);1.proc rank data=ex12_5 out=rank5;2.var x;3.run;4.proc print data=ranks;5.run;6.proc glm data=ranks;7.class group;8.model x=group;9.means group/lsd;10.run;完全copyPPT···③结果观察:先看χ2和p值(总体指标)有无统计学意义,若无意义,无需进行两两比较,只有总体指标χ2和p值有意义才需进行两两检验。
6.析因设计方差分析①析因设计有一点重要的是:A和B两个指标之间可能会有交互作用,需考虑二者之间的交互作用a*b②首先仍然是正态性检验,若符合可直接用析因设计的方差分析,否则可用Kruskal-Wallis秩和检验(类似于完全随机设计);③析因设计的过程步(符合正态分布):1.proc glm data=aa;2.class a b;3.model x=a b a*b;/*计算a,b以及a*b,之间的相互作用*/4.output out=glmout P=pred R=resi; /*将三者之间的P值和R值输出到新的数据集glmout中,并对二者进行赋值*/5.run;1.proc gplot data=glmout ;2.plot pred*a=b/HAIXS=0.5 1 2 2.5 VAIXS=0.1 to 0.2 by 0.02; /*2*2析因设计交互效应作图*/3.symbol I=join;4.run;③结果参考:同样先看总体之间差异有无统计学意义:若有意义,继续观察两两之间的p值;若无意义,可无视。
第三章 sas过程步及简单统计

程序d:\sas2003\data3-2.sas:
proc means data = mysas.stua; var math; output out=result02 n=n mean=meanmath std=stdmath; run; proc print data=result02; run;
10. 二个重要的输出语句:
1) ods printer ① 直接输出结果到本地打印机.如: ODS printer; proc print data = mysas.stua; var name english; run;
ODS printer close;
② 直接输出结果到pdf文件.如: ODS printer file=‘d:\sas2003\1.sas’;
UNIVARIATE语句格式如下: PROC UNIVARIATE [选择项] ;
VAR
BY FREQ
变量 ;
变量 ; 变量 ;
WEIGHT
ID OUTPUT RUN;
变量 ;
变量 ; [关键词=新变量名] ;
OUT=SAS数据集
3.3.4 FREQ 过程 (频数过程)
FREQ过程用于产生1至N维的频数和交叉表。
3.3.2 MEANS 过程
MEANS过程(均值过程)用于对数值型变量产生
针对单个变量的简单描述性统计值。 语句格式为: PROC MEANS [选择项] ; VAR 变量名列表 ; BY 变量名列表 ; CLASS 变量名列表 ; FREQ 变量名列表 ; WEIGHT 变量名列表 ; ID 变量名列表 ; OUTPUT OUT=SAS数据集 统计量 … RUN ;
run;
3.2.3 全程语句 1. TITLE 标题语句 SAS系统有一默认的输出标题,使输出的每页 有一行标题,内容为“The SAS System”。事实 上,我们可以指定自己的标题来取代SAS缺省的 标题。指定标题TITLE语句格式为:
SAS数据分析与统计

一、数据集的建立1.导入Excel数据表的步骤如下:1) 在SAS应用工作空间中,选择菜单“文件”→“导入数据”,打开导入向导“Import Wizard”第一步:选择导入类型(Select importtype)。
2) 在第二步的“Select file”对话框中,单击“Browse”按钮,在“打开”对话框中选择所需要的Excel文件,返回。
然后,单击“Option”按钮,选择所需的工作表。
(注意Excel文件要是2003的!!)3) 在第三步的“Select library and member”对话框中,选择导入数据集所存放的逻辑库以及数据集的名称。
4 ) 在第四步的“Create SAS Statements”对话框中,可以选择将系统生成的程序代码存放的位置,完成导入过程。
2.用INSIGHT创建数据集1)启动SAS INSIGHT模块,在“SAS INSIGHT:Open”对话框的”逻辑库“列表框中,选定库逻辑名2)单击“新建”按钮,在行列交汇处的数据区输入数据值(注意列名型变量和区间型变量,这在后面方差分析相关性分析等都要注意!!)3)数据集的保存:•“文件”→“保存”→“数据”;•选择保存的逻辑库名,并输入数据集名;•单击“确定”按钮。
即可保存新建的数据集。
3.用VIEWTABLE窗口建立数据集1)打开VIEWTABLE窗口2)单击表头顶端单元格,输入变量名3)在变量名下方单元格中输入数据4)变量类型的定义:右击变量名/column attributes…4.用编程方法建立数据集DATA 语句; /*DATA步的开始,给出数据集名*/Input 语句;/*描述输入的数据,给出变量名及数据类型和格式等*/(用于DATA步的其它语句)Cards; /*数据行的开始*/[数据行]; /*数据块的结束*/RUN; /*提交并执行*/例子:data=数据集名字;input name$ phone room height; ($符号代表该列为列名型,就是这一列是文字!!比如名字,性别,科目等等)cards;rebeccah 424 112 (中间是数据集,中间每一行末尾不要加逗号,但是carol 450 112 数据集最后要加一个分号!!)louise 409 110gina 474 110mimi 410 106alice 411 106brenda 414 106brenda 414 105david 438 141betty 464 141holly 466 140;proc print data=; (这一过程步是打印出数据集,可要可不要!)run;*数据集中的框架我会用加粗来显示,大家主要记加粗的,下面的编程部分都是这样!!二、基本统计分析1.用INSIGHT计算统计量1)在INSIGHT中打开数据集在菜单中选择“Solution(解决方案)”→“Analysis(分析)”“Interactive Data Analysis(交互式数据分析)”,打开“SAS/INSIGHT Open”对话框,在对话框中选择数据集,单击“Open(打开)”按钮,即可在INSIGHT中打开数据窗口2)选择菜单“Analyze(分析)”→“Distribution (Y)(分布)”,打开“Distribution (Y)”对话框。
20个SAS过程步

20个SAS过程步
1、PROC
MEANS--数据描述:计算均数、标准差、最大值、最小值、变量有效数据个数、变量缺失个数
2、PROC UNIV ARIATE--正态性检验
3、PROC TTEST--两独立样本检验
4、PROC NPAR1WAR--秩和检验
5、PROC ANOV A--方差分析
6、PROC CORR--相关性分析
7、PROC REG--回归分析
8、PROC FREQ--计数资料描述;卡方检验;诊断试验
9、PROC LOGISTIC--结局是二分类的Logisitc回归分析
10、PROC PHREG--生存分析
11、PROC POWER--样本量及把握度计算
12、PROC PRINT--显示数据集
13、PROC GLM--回归分析或协方差分析
14、PROC RANK--给某变量排次或按序分组
15、PROC SORT--按某变量排序
16、PROC SURVEYSELECT--概率抽样
17、PORC IMPORT--导入数据集
18、PROC EXPORT--导出数据集
19、PROC CONTENTS--产生一个数据集的头文件,包含了多种该数据集的信息
20、PROC TABULATE--输出报表。
数据分析与统计软件-sas-第一章上机实验-
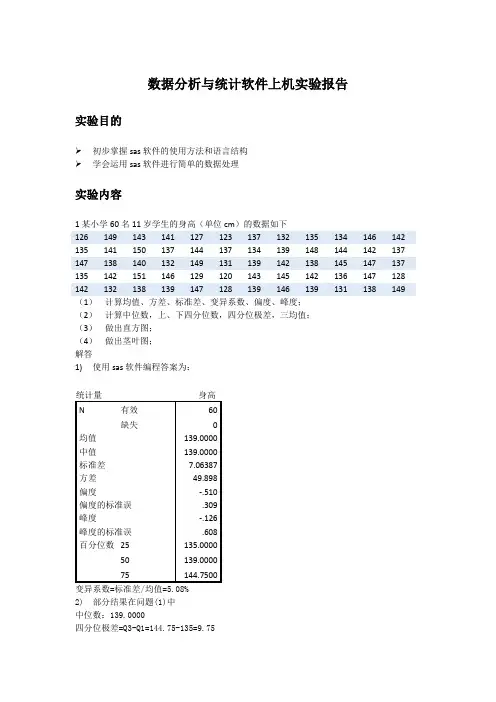
数据分析与统计软件上机实验报告实验目的➢初步掌握sas软件的使用方法和语言结构➢学会运用sas软件进行简单的数据处理实验内容1某小学60名11岁学生的身高(单位cm)的数据如下126 149 143 141 127 123 137 132 135 134 146 142 135 141 150 137 144 137 134 139 148 144 142 137 147 138 140 132 149 131 139 142 138 145 147 137 135 142 151 146 129 120 143 145 142 136 147 128 142 132 138 139 147 128 139 146 139 131 138 149 (1)计算均值、方差、标准差、变异系数、偏度、峰度;(2)计算中位数,上、下四分位数,四分位极差,三均值;(3)做出直方图;(4)做出茎叶图;解答1)使用sas软件编程答案为:统计量身高N 有效60缺失0均值139.0000中值139.0000标准差7.06387方差49.898偏度-.510偏度的标准误.309峰度-.126峰度的标准误.608百分位数25 135.000050 139.000075 144.7500变异系数=标准差/均值=5.08%2)部分结果在问题(1)中中位数:139.0000四分位极差=Q3-Q1=144.75-135=9.75三均值=0.25*Q1+0.5*M+0.25*Q3=139.4375 3)使用软件画图得到4)使用sas软件画图得到程序附录(1)DATA DQGZ;INPUT X @@;CARDS;126 149 143 141 127 123 137 132 135 134 146 142 135 141 150 137 144 137 134 139 148 144 142 137 147 138 140 132 149 131 139 142 138 145 147 137 135 142 151 146 129 120 143 145 142 136 147 128 142 132 138 139 147 128 139 146 139 131 138 149 PROC MEANS N MEAN STD VAR USS CSS;RUN;(4)身高 Stem-and-Leaf PlotFrequency Stem & Leaf1.00 Extremes (=<120)1.00 12 . 35.00 12 . 678897.00 13 . 112224418.00 13 . 555677777888899999 13.00 14 . 011222222334413.00 14 . 55666777789992.00 15 . 01Stem width: 10.00Each leaf: 1 case(s)。
SAS软件及统计应用教程

第i特征根 1CCaani2nRi2R
上式可以理解为第i对典型变量表示观测变量总方差 作用的指标,它的值越大说明表示作用越大。
SAS软件与统计应用教程
6. 典型相关系数的标准误
STAT
SECaniR1Cna1ni2R
7. 典型相关系数的假设检验
典型相关系数的假设检验包括对全部总体典型相关系
数的检验和对部分总体典型相关系数的检验。对数据的
前两个典型相关系数比形态指标和机能指标两组间的 任何一个相关系数都大。
SAS软件与统计应用教程
STAT
(2) 典型变量所解释的变异 第二部分是的5个特征根(Eigenvalues),包括:特
征根、相邻两个特征根之差、特征根所占方差信息量的
比例和累积方差信息量的比例。从中可以看出,前两对
典型变量所能解释的变异占总变异(方差)的91.18%, 如图7-4所示。其它三个典型相关变量的作用很小,一 共只解释了总变异的9%,可以不予考虑。
1 ,i j
C( U o i,U j r ) r 0 ,i j C( V o i,V j) r r 0 ,i j
SAS软件与统计应用教程
STAT
2) 同 一 对 典 型 相 关 变 量 Ui 和 Vi 之 间 的 相 关 系 数 为 CanRi,不同对的典型相关变量之间互不相关,即:
Co(U ri,V rj) C0ai nii Rjj
Ui = ai'X* = ai1X1* + ai2X2* + … + aipXp* Vi = bi'Y* = bi1Y1* + bi2Y2* + … + biqYq* i = 1,2,…,m = min(p,q);其中X*,Y*为原变量组
试验统计学实验二
proc univariate; var high;
run;
/*单变量正态性分析*/
proc means mean std min max range var cv; /*指定统计量*/ var high;
run;
(七)用菜单系统的analyst作数据整理和描述
Solution ⇒ Analysis ⇒ Analyst
plot y*x /vaxis=0 to 10 by 1;
run;
/*点线的表示*/ /*连线图*/ /*画出x—y图,纵轴由0按1 递增到10*/
(六)SAS数据描述过程
data fitness;
input name $& age sex $ high weight @@;
cards;
Zhang Sa 28 m 1.78 60
◆ SAS窗口
Editor窗口 程序编辑窗口 Log窗口 日志窗口 Output窗口 结果输出窗口
(二)SAS编程基础
SAS程序结构
数据步(DATA STEP)为SAS建立数据集 过程步(PROC STEP)为SAS提供分析函数
SAS程序示例
data fitness;
/*数据集名*/
input name $& age sex $ high weight @@; /*5个变量;$ 单字符串变量
实验二 统计分析软件SAS的应用
一、实验目的
• 了解SAS的基本统计功能 • 掌握SAS程序的编写和结果处理 • 掌握SAS的数据整理和描述过程
二、实验内容和步骤
(一)SAS简介
◆ 统计分析系统SAS (Statistical Analysis System)
SAS分析常用的过程过程步大全
SAS分析常用的过程过程步大全为区分过程名称的拼写,故意部分小写,以便识别和记忆。
基本SAS程序代码结构:---------PROC MODE data=Arndata.moddat; /* 命令的解释*/var y x1-x6; /* 命令的解释 */model y = x1-x6;run;------------------------------------------正态性检验PROC UNIvariate---------PROCUNIvariate data=Arndata.unidat;var x1;run;------------------------------------------相关分析和回归分析PROC REG 回归---------PROC REG data=Arndata.regdat;var y x1-x6;model y = x1-x6 / selection=stepwise;/* 加入逐步回归选项 */print cli; /* 加入输出预测结果部分,还可以输出acov,all,cli,clm,collin,collinoint,cookd,corrb,covb,dw(时序检验统计量),i,influence,p,partial,pcorr1,pcorr2,r,scorr1,scorr2,seqb,spec,ss1,ss2,stb,tol, vif(异方差检验统计量),xpx*/plot y*x2 / conf95; /* 做散点图 */run;---------------------------------------------------DATA Arndata.regdat;x2x2 = x2*x2;x1x2 = x1*x2;PROC REG data=Arndata.regdat;var y x1 x2 x2x2 x1x2 ; /* 多项式回归,非线性回归 */model y = x1 x2 x2x2 x1x2 / selection=stepwise; /* 加入逐步回归选项*/print cli;plot y*x2 / conf95; /* 做散点图 */run;------------------------------------------PROC RSreg 二次响应面回归PROC ORTHOreg 病态数据回归PROC NLIN 非线性回归PROC TRANSreg 变换回归PROC CALIS 线性结构方程和路径分析PROC GLM 一般线性模型PROC GENmod 广义线性模型方差分析PROC ANOVA 单因素均衡数据和非均衡数据---------PROC ANOVA data=Arndata.anovadat; /* 命令的解释 */class typ; /* 命令的解释 */model y = typ; /* 可以看出此处是单因素方差分析(分类型自变量对数值型自变量的影响) */run;------------------------------------------PROC GLM 多因素非均衡数据:---------PROC GLM data=Arndata.glmdat; /* 命令的解释*/class typea typeb; /* 命令的解释 */model y = typea typeb; /* 可以看出此处是不考虑交互作用的多因素方差分析(分类型自变量对数值型自变量的影响) */run;---------------------------------------------------PROC GLM data=Arndata.glmdat; /* 命令的解释*/class typea typeb; /* 命令的解释 */model y = typea typeb typea*typeb; /* 可以看出此处是考虑交互作用的多因素方差分析(分类型自变量对数值型自变量的影响) */run;------------------------------------------主成分分析PROC PRINcomp---------PROCPRINcomp data=Arndata.pmdat n=4 out=w1 outstat=w2 ;var x1-x6;PROC print data=w1;PROC plot data=w1 vpct=80; /* 一句话,其实print就是plot输出图形的文字形式而已 */plot prin1*prin2 $ districts='*'/haxis=-3.5 to 3 by 0.5 HREF=-2,0,2vaxis=-3 to 4.5 by 1.5 HREF=-2,0,2; /* 主成分的散点图,也就是载荷图 */run;------------------------------------------因子分析PROC FACTOR---------PROC FACTOR data=Arndata.factordat simple corr ;var y x1-x6;title'18个财务指标的分析';title2'主成分解';run;PROC FACTOR data=Arndata.factordatn=4 ; /* 选择4个公共因子 */ var y x1-x6;run;PROC FACTOR data=Arndata.factordat n=4rotate=VARImaxREorder; /* 因子旋转:方差最大因子法 */var y x1-x6;run;------------------------------------------PROC SCORE---------PROC FACTOR data=Arndata.factordat n=4rotate=VARImax REorder score out=score_Out; /* 输出因子得分矩阵 */run;PROC print data=score_Out;var districts factor1 factor2 factor3 factor4;run;PROC plot data=score_Out;plot factor1*factor2 $ districts='*' / href=0 Vref=0; /* 因子的散点图,也就是载荷图 */run;------------------------------------------典型相关分析PROC CANcorr基本SAS程序代码结构:---------DATAjt(TYPE=CORR); /*TYPE=CORR 表明数据类型为相关矩阵,而不是原始数据, type还可以是cov,ucov,factor,sscp,ucorr等*/input names$ 1-2(x1 x2 y1-y3)(6.); /* name $ 表示读取左侧的变量名,1-2表示变量名的字符落在第1,2列上 */cards;x1 1 0.8 ……x2 ……y1 ……y2 ……y3 ……;PROC CANcorrdata=Arndata.cancorrdatedf=70 redundancy; /* 误差自由度的参考值,默认值是n=1000;redundancy表示输出冗余度分析的结果 */var x1 x2;with y1 y2 y3;run;------------------------------------------对应分析 /* 交叉表分析的拓展,寻找行和列的关系,一般行指代各种cases,而列代表各种visions */PROC CORResp---------PROC CORRespdata=Arndata.correspdat out=result;var x1-x6;id Type;run;options ps=40;proc plot data=result;plot dim2*dim1="*" $ Type / boxhaxis=-0.2 to 0.3 by 0.1Vaxis=-0.1 to 0.3 by 0.1Href=0 Vref=0;run;------------------------------------------聚类分析PROC CLUSTER---------PROC CLUSTER data=Arndata.clusdatmethod=ave outtree=clusdat_Out;var x1-x6;id datid;run;proc tree horizontal; /* 做聚类树 */run;------------------------------------------PROC FASTclus---------PROC FASTclus data=Arndata.clusdatmaxclusters=3 list out=clusdat_Out;var x1-x6;id datid;run;------------------------------------------PROC ACEclusPROC VARCLUS---------PROC VARclus data=Arndata.clusdat;/* 系统默认使用主成分法聚类 */var x1-x6;run;---------PROC VARclus hierarchy data=Arndata.clusdat; /* 保证分析过程中不同水平的谱系结构 */var x1-x6;run;---------PROC VARclus centroid data=Arndata.clusdatouttree=clusdat_out; /* 使用重心法聚类 */ var x1-x6;run;------------------------------------------PROC TREE---------PROC TREE data=Arndata.clusdat horizontal; /* 使用TREE过程绘制聚类谱系图*/var x1-x6;run;------------------------------------------判别分析PROC DISCRIM---------PROC DISCRIM data=Arndata.discrimdatlist out=discrimdat_Out distance pool=yes;class Typ; /* 指定分类变量 */var x1-x6; /* 用于建立判别识别函数的变量 */id iddiscrim; /* 标注样本的变量 */run;---------第二种方法,将需要判别的新样本放在testdata里:---------PROC DISCRIM data=Arndata.discrimdat1testdata=Arndata.discrimdat2testlist testout=discrimdat_Out; /* 将原来的几个选项加注test标示 */class Typ; /* 指定分类变量 */var x1-x6; /* 用于建立判别识别函数的变量 */id iddiscrim; /* 标注样本的变量 */run;------------------------------------------PROC STEPdisc:逐步判别分析过程---------PROC STEPdisc method=stepwise data=Arndata.discrimdatSLentry=0.10 SLstay=0.10; /* 设定引入和剔除的显著性水平 */class Typ; /* 指定分类变量 */var x1-x6; /* 用于建立判别识别函数的变量 */run;------------------------------------------PROC CANdisc: Fisher判别分析过程---------PROC CANdiscdata=Arndata.discrimdatout=discrimdat_Outdistance simple;class Typ; /* 指定分类变量 */var x1-x6; /* 用于建立判别识别函数的变量 */run;proc print data=discrimdat_Out;run;-----------------------------------------------------------------------------------------------------------------------------------------------------------友情协助:特征库豆瓣统计学小组 /group/stats。
试验设计与统计分析SAS实践教程 第1章
proc g3grid data=aa out=bb; grid x1*x2=y / naxis1=20 naxis2=20; run;
proc g3d data=bb; plot x2*x1=y / caxis=black ctext=black cbottom=green ctop=blue tilt=75 rotate=60 xticknum= 9 yticknum= 9 zticknum= 9 grid; run;
2.Editor窗口 在Windows操作系统中,可以使用一个或者多个Editor 窗口(编程窗口)来进行输入、编辑和提交SAS程序。 Editor窗口提供了大量的编辑功能,包括SAS语言的彩色编 码和语法检查、可展开或折叠程序片段、可记录宏、支持键 盘快捷方式(Alt或Shift加上其它键)、多层撤消或恢复、其它 功能等。 初始化Editor窗口的标题栏上的标题是Editor-Untitled1, 只有打开一个已命名文件或把Editor窗口中的内容保存成文 件时,它才变为所命名的文件名。当修改窗口中的内容时, 标题中将出现一个星号。
Hale Waihona Puke 图1-5 Editor窗口及输入的SAS程序
3.Log窗口 Log窗口(日志窗口)用于显示用户所提交过的SAS程序、 程序语法出错信息、程序运行出错信息、SAS警告信息、程 序运行耗费时间和SAS运行报告等。 在Editor窗口输入名为“例子”的程序后,点击工具条 上的提交按钮(图标酷似一个奔跑的人),则该程序被提交运 行。查看Log窗口,显示内容如图1-6所示。
SAS软件和统计应用教程
2.1.3 表示数据分散程度的统计量
1. 极差(Range)与半极差(Interquartile range)
极差就是数据中的最大值和最小值之间的差:
极差 = max{xi} – min{xi} 上、下四分位数之差Q3 – Q1称为四分位极差或半极
差,它描述了中间半数观测值的散布情况。
2. 方差(Variance或Var)
RUN;
显示结果如图所示。
2. MEANS过程
(1) 语法格式 MEANS过程的一般格式:
PROC MEANS DATA=<数据集名>[<统计量关键字列表>]; [VAR <分析变量列表>;] [BY <分组变量名>;] [CLASS <分组变量名>;]
RUN;
PROC MEANS语句后的选项主要用来指定所要计算 的统计量,默认情况下,MEANS过程会给出频数、均 数、标准差、最大值和最小值等,其余统计量的计算均 需要在选项中指定。
中位数 x12((n2x1()n2)
x(n1)) 2
n为奇数 n为偶数
3. 众数(Mode)
观测值中出现最多的数称为众数。众数用得不如均值 和中位数普遍。在属性变量分析中,常需考虑频数,因 此众数用得多些。
4. 百分位数(Percentile)
分位数也是描述数据分布和位置的统计量。0.5分位 数就是中位数,0.75分位数和0.25分位数又分别称为上、 下四分位数,并分别记为Q3和Q1。
单击“OK”按钮,即可得到关于变量Income的矩统计 量和基本统计测度
2.2.3 编程实现描述性统计
SAS提供有多个不同的过程来实现统计量的计算,它 们 在 功 能 范 围 上 有 许 多 的 重 复 , 下 面 介 绍 用 FREQ 、 MEANS和UNIVARIATE这三个过程来计算简单的描述 统计量。
SAS数据分析与统计
一、数据集的建立1.导入Excel数据表的步骤如下:1) 在SAS应用工作空间中,选择菜单“文件”→“导入数据”,打开导入向导“Import Wizard”第一步:选择导入类型(Select import type)。
2) 在第二步的“Select file”对话框中,单击“Browse”按钮,在“打开”对话框中选择所需要的Excel文件,返回。
然后,单击“Option”按钮,选择所需的工作表。
(注意Excel文件要是2003的!!)3) 在第三步的“Select library and member”对话框中,选择导入数据集所存放的逻辑库以及数据集的名称。
4 ) 在第四步的“Create SAS Statements”对话框中,可以选择将系统生成的程序代码存放的位置,完成导入过程。
2.用INSIGHT创建数据集1)启动SAS INSIGHT模块,在“SAS INSIGHT:Open”对话框的”逻辑库“列表框中,选定库逻辑名2)单击“新建”按钮,在行列交汇处的数据区输入数据值(注意列名型变量和区间型变量,这在后面方差分析相关性分析等都要注意!!)3)数据集的保存:•“文件”→“保存”→“数据”;•选择保存的逻辑库名,并输入数据集名;•单击“确定”按钮。
即可保存新建的数据集。
3.用VIEWTABLE窗口建立数据集1)打开VIEWTABLE窗口2)单击表头顶端单元格,输入变量名3)在变量名下方单元格中输入数据4)变量类型的定义:右击变量名/column attributes…4.用编程方法建立数据集DATA 语句; /*DATA步的开始,给出数据集名*/Input 语句;/*描述输入的数据,给出变量名及数据类型和格式等*/(用于DATA步的其它语句)Cards; /*数据行的开始*/[数据行]; /*数据块的结束*/RUN; /*提交并执行*/例子:data=数据集名字;input name$ phone room height; ($符号代表该列为列名型,就是这一列是文字!!比如名字,性别,科目等等)cards;rebeccah 424 112 (中间是数据集,中间每一行末尾不要加逗号,但是carol 450 112 数据集最后要加一个分号!!)louise 409 110gina 474 110mimi 410 106alice 411 106brenda 414 106brenda 414 105david 438 141betty 464 141holly 466 140;proc print data=; (这一过程步是打印出数据集,可要可不要!)run;*数据集中的框架我会用加粗来显示,大家主要记加粗的,下面的编程部分都是这样!!二、基本统计分析1.用INSIGHT计算统计量1)在INSIGHT中打开数据集在菜单中选择“Solution(解决方案)”→“Analysis(分析)”“Interactive Data Analysis(交互式数据分析)”,打开“SAS/INSIGHT Open”对话框,在对话框中选择数据集,单击“Open(打开)”按钮,即可在INSIGHT中打开数据窗口2)选择菜单“Analyze(分析)”→“Distribution (Y)(分布)”,打开“Distribution (Y)”对话框。