
Mplus结构方程模型步骤(入门)
1数据格式转换
因为Mplus只能打开ASCII格式得文件(、dat与、txt文件),所以常规得SPSS数据库得数据不能被读取,所以数据分析之前先要将sav格式另存为dat格式。
另存为选项里有两类dat格式,一般可选用“以制表符分隔”,当数据量较大时,可选“固定ASCII格式”。
这两类并没有明显特异得使用条件。
选择某一种dat格式后,“将变量名写入表格”这一项不要勾选。
然后保存。
一般将该数据文件与mplus语句文件放在一个文件夹。
2 打开mplus程序,建立新文件,即点击“new”。
当然,新打开Mplus程序也会默认这个界面。
3 编辑命令。
这就是Mplus分析数据最核心得步骤
3、1 首先我们可以给该分析起个名字(该步骤可有可无),例如:
TITLE: example
3、2 然后表明我们引用得数据库来自于哪里,也就就是刚刚那个DAT文件。
命令为: DATA: C:\Users\dell\Desktop\MPLUS结构方程模型教程\数据库、dat;
这里面需要注意得就是: DATA: (或者DATA: FILE=)就是固定句式,就是必要得。
之后“C:\Users\dell\Desktop\MPLUS结构方程模型教程\数据库、dat”这就是DAT文件得保存路径。
一般情况下,如果mplus语句文件与dat文件在同一个文件夹中,只需要DATA: 数据库、dat; 但实际上很多情况下,两者即使在同一个文件中,也很可能读不出来,所以必要得话,可将该DAT文件得保存路径写全,这样肯定就是没错得。
另外,一个命令结束后,必须必须加上“;”即英文格式下得分号(除外TITLE)。
3、3 写出数据库中所有得变量名称以及本次分析需要得变量名称。
这需要按照spss数据库中变量名称顺序来写。
VARIABLE: NAMES ARE a1 a2 a3 a4 a5 a6 a7 a8 a9 b1 b2 b3 b4 c1 c2 c3 c4;
USEVARIABLES ARES ARE a1 a2 a3 a4 a5 a6 a7 a8 a9 b1 b2 b3 b4 c1 c2 c3 c4;
当然这就是最基本繁琐得写法,可以直接写为:
VARIABLE: NAMES ARE a1-a9 b1-b4 c1-c4;
USEVARIABLES ARES ARE a1-a9 b1-b4 c1-c4;
不同变量间有空格。
因为我们本次分析需要纳入该数据库所有变量,所以上下两行变量就是一样得,否则需要哪些变量,在USEVARIABLES里面纳入哪些变量。
3、4 分析方法
因为MPLUS中针对连续型变量得结构方程模型得默认分析方法就是最小二乘法即ML ,所以如果使用得方法就是这个,那么分析方法语句可以不写,当然也可以写,即ANALYSIS: ESTIMATOR = ML;
如果采用其她方法,需要写出来,例如ANALYSIS: ESTIMATOR = MLR;或者ANALYSIS: ESTIMATOR = WLSMV;
另外ANALYSIS中还有TYPE语句,MODEL语句,INFORMATION语句,如果没有特殊要求,我们就
按照Mplus得默认方式分析就可,故不用写出来。
如果分析采用其她方式,则需要写出来。
命令举例:ANALYSIS: ESTIMATOR = ML; TYPE = GENERAL;
MODEL=NOMEANSTRUCTURE; INFORMATION=EXPECTED;
3、5模型语句
比如我们预期得结构方程模型就是这样得:
首先我们要将各个观测变量使用“BY”合并得出三个潜变量,也就就是我们研究得自变量y2,中介变量y1,与因变量y3、
语句为:
MODEL: y1 BY a1-a9;
y2 BY b1-b4;
y3 BY c1-c4;
然后使用“ON”来表示各潜变量之间得回归关系,即:
y3 ON y1 y2;
y1 ON y2;
ON前面得就是结局变量,后面得就是预测变量。
所以模型语句合并起来就就是:
MODEL: y1 BY a1-a9;
y2 BY b1-b4;
y3 BY c1-c4;
y3 ON y1 y2;
y1 ON y2;
3、6 最后一步就是输出语句,如果没有特殊要求,我们需要得结构Mplus得默认程序都会呈现。
如果有特殊要求也可以写出来,例如:
OUTPUT: SAMPSTAT TECH1 TECH4 STDYX MOD;
所以将所有语句写出来就就是:
TITLE: example
DATA: C:\Users\dell\Desktop\MPLUS结构方程模型教程\数据库、dat;
VARIABLE: NAMES ARE a1 a2 a3 a4 a5 a6 a7 a8 a9 b1 b2 b3 b4 c1 c2 c3 c4;
USEVARIABLES ARES ARE a1 a2 a3 a4 a5 a6 a7 a8 a9 b1 b2 b3 b4 c1 c2 c3 c4;
MODEL: y1 BY a1-a9;
y2 BY b1-b4;
y3 BY c1-c4;
y3 ON y1 y2;
y1 ON y2;
如图
然后点击RUN按钮
它会提示您保存该语句
保存完成后,结果就出来了。
如果想瞧我们得到得结构方程图得话,点击菜单栏得Diagram,选择View diagram
这需要JAVA工具。
如果电脑没有得话,会提示您安装
安装完,既可以观瞧图示。
完整版Mplus结构方程模型步骤入门
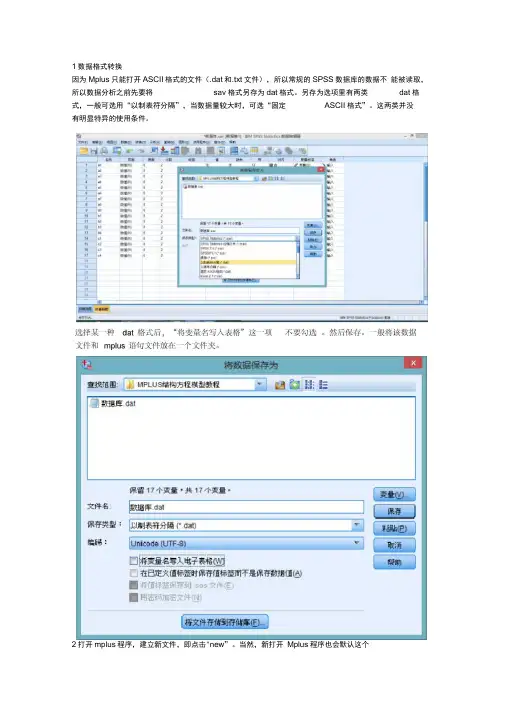
1数据格式转换因为Mplus只能打开ASCII格式的文件(.dat和.txt文件),所以常规的SPSS数据库的数据不能被读取,所以数据分析之前先要将sav格式另存为dat格式。
另存为选项里有两类dat格式,一般可选用“以制表符分隔”,当数据量较大时,可选“固定ASCII格式”。
这两类并没有明显特异的使用条件。
2打开mplus程序,建立新文件,即点击"new”。
当然,新打开Mplus程序也会默认这个TITLE: example3.2然后表明我们引用的数据库来自于哪里,也就是刚刚那个DAT文件。
命令为:DATA: FILE IS C:\Users\dell\Desktop\MPLUS结构方程模型教程数据库.dat;这里面需要注意的是:DATA: FILE IS (或者DATA: FILE=是固定句式,是必要的。
之后“C:\Users\dell\Desktop\MPLUS结构方程模型教程数据库.dat”这是DAT文件的保存路径。
一般情况下,如果mplus语句文件和dat文件在同一个文件夹中,只需要DATA: FILE I黴据库.dat;但实际上很多情况下,两者即使在同一个文件中,也很可能读不出来,所以必要的话,可将该DAT文件的保存路径写全,这样肯定是没错的。
另外,一个命令结束后,必须必须加上“;”即英文格式下的分号(除外TITLE)°3.3写出数据库中所有的变量名称以及本次分析需要的变量名称。
这需要按照spss数据库中变量名称顺序来写。
VARIABLE: NAMES ARE a1 a2 a3 a4 a5 a6 a7 a8 a9 b1 b2 b3 b4 c1 c2 c3 c4;USEVARIABLES ARES ARE a1 a2 a3 a4 a5 a6 a7 a8 a9 b1 b2 b3 b4 c1 c2 c3 c4;当然这是最基本繁琐的写法,可以直接写为:VARIABLE: NAMES ARE a1-a9 b1-b4 c1-c4;USEVARIABLES ARES ARE a1-a9 b1-b4 c1-c4;不同变量间有空格。
mplus结构方程模型步骤入门)
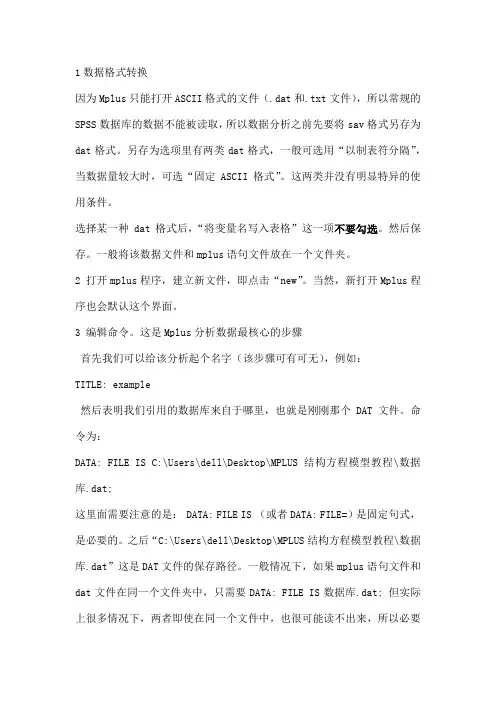
1数据格式转换因为Mplus只能打开ASCII格式的文件(.dat和.txt文件),所以常规的SPSS数据库的数据不能被读取,所以数据分析之前先要将sav格式另存为dat格式。
另存为选项里有两类dat格式,一般可选用“以制表符分隔”,当数据量较大时,可选“固定ASCII格式”。
这两类并没有明显特异的使用条件。
选择某一种dat格式后,“将变量名写入表格”这一项不要勾选。
然后保存。
一般将该数据文件和mplus语句文件放在一个文件夹。
2 打开mplus程序,建立新文件,即点击“new”。
当然,新打开Mplus程序也会默认这个界面。
3 编辑命令。
这是Mplus分析数据最核心的步骤首先我们可以给该分析起个名字(该步骤可有可无),例如:TITLE: example然后表明我们引用的数据库来自于哪里,也就是刚刚那个DAT文件。
命令为:DATA: FILE IS C:\Users\dell\Desktop\MPLUS结构方程模型教程\数据库.dat;这里面需要注意的是: DATA: FILE IS (或者DATA: FILE=)是固定句式,是必要的。
之后“C:\Users\dell\Desktop\MPLUS结构方程模型教程\数据库.dat”这是DAT文件的保存路径。
一般情况下,如果mplus语句文件和dat文件在同一个文件夹中,只需要DATA: FILE IS数据库.dat; 但实际上很多情况下,两者即使在同一个文件中,也很可能读不出来,所以必要的话,可将该DAT文件的保存路径写全,这样肯定是没错的。
另外,一个命令结束后,必须必须加上“;”即英文格式下的分号(除外TITLE)。
写出数据库中所有的变量名称以及本次分析需要的变量名称。
这需要按照spss数据库中变量名称顺序来写。
VARIABLE: NAMES ARE a1 a2 a3 a4 a5 a6 a7 a8 a9 b1 b2 b3 b4 c1 c2 c3 c4;USEVARIABLES ARES ARE a1 a2 a3 a4 a5 a6 a7 a8 a9 b1 b2 b3 b4 c1 c2 c3 c4;当然这是最基本繁琐的写法,可以直接写为:VARIABLE: NAMES ARE a1-a9 b1-b4 c1-c4;USEVARIABLES ARES ARE a1-a9 b1-b4 c1-c4;不同变量间有空格。
Mplus简介及实例应用
Mplus 6.1 使用示例Mplus结构方程模型步骤(入门)1数据格式转换因为Mplus只能打开ASCII格式的文件(.dat和.txt文件),所以常规的SPSS数据库的数据不能被读取,所以数据分析之前先要将sav格式另存为dat格式。
另存为选项里有两类dat格式,一般可选用“以制表符分隔”,当数据量较大时,可选“固定ASCII格式”。
这两类并没有明显特异的使用条件。
选择某种dat格式后,“将变量名写入表格”这一项不要勾选。
然后保存。
一般将该数据文件和mplus语句文件放在一个文件夹。
2 打开mplus程序,建立新文件,即点击“new”。
当然,新打开Mplus程序也会默认这个界面。
3 编辑命令。
这是Mplus分析数据最核心的步骤3.1 首先我们可以给该分析起个名字(该步骤可有可无),例如:TITLE: example3.2 然后表明我们引用的数据库来自于哪里,也就是刚刚那个DAT文件。
命令为:DATA: FILE IS C:\Users\dell\Desktop\MPLUS 结构方程模型教程\数据库.dat;这里面需要注意的是:DATA: FILE IS (或者DATA: FILE=)是固定句式,是必要的。
之后“C:\Users\dell\Desktop\MPLUS结构方程模型教程\数据库.dat”这是DAT文件的保存路径。
一般情况下,如果mplus语句文件和dat文件在同一个文件夹中,只需要DATA:FILE IS数据库.dat; 但实际上很多情况下,两者即使在同一个文件中,也很可能读不出来,所以必要的话,可将该DAT文件的保存路径写全,这样肯定是没错的。
另外,一个命令结束后,必须必须加上“;”即英文格式下的分号(除外TITLE)。
3.3 写出数据库中所有的变量名称以及本次分析需要的变量名称。
这需要按照spss数据库中变量名称顺序来写。
VARIABLE: NAMES ARE a1 a2 a3 a4 a5 a6 a7 a8 a9 b1 b2 b3 b4 c1 c2 c3 c4; USEVARIABLES ARES ARE a1 a2 a3 a4 a5 a6 a7 a8 a9 b1 b2 b3 b4 c1 c2 c3 c4;当然这是最基本繁琐写法,可直接写为:VARIABLE: NAMES ARE a1-a9 b1-b4 c1-c4; USEVARIABLES ARES ARE a1-a9 b1-b4 c1-c4;不同变量间有空格。
(完整版)Mplus结构方程模型步骤(入门)
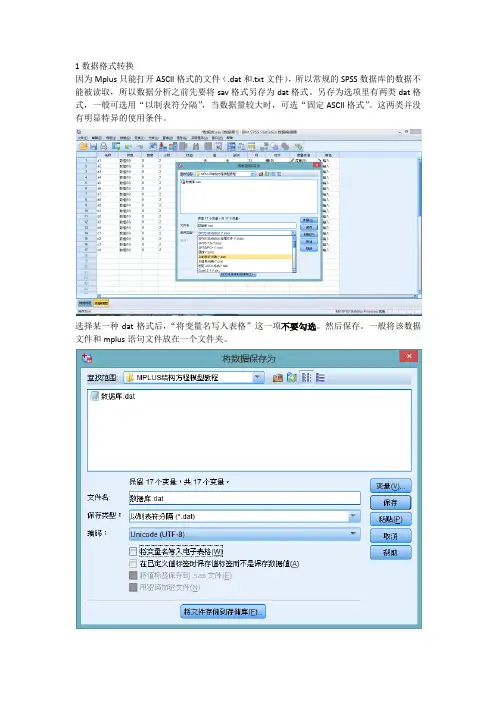
1数据格式转换因为Mplus只能打开ASCII格式的文件(.dat和.txt文件),所以常规的SPSS数据库的数据不能被读取,所以数据分析之前先要将sav格式另存为dat格式。
另存为选项里有两类dat格式,一般可选用“以制表符分隔”,当数据量较大时,可选“固定ASCII格式”。
这两类并没有明显特异的使用条件。
选择某一种dat格式后,“将变量名写入表格”这一项不要勾选。
然后保存。
一般将该数据文件和mplus语句文件放在一个文件夹。
2 打开mplus程序,建立新文件,即点击“new”。
当然,新打开Mplus程序也会默认这个界面。
3 编辑命令。
这是Mplus分析数据最核心的步骤3.1 首先我们可以给该分析起个名字(该步骤可有可无),例如:TITLE: example3.2 然后表明我们引用的数据库来自于哪里,也就是刚刚那个DAT文件。
命令为:DATA: FILE IS C:\Users\dell\Desktop\MPLUS结构方程模型教程\数据库.dat;这里面需要注意的是:DATA: FILE IS (或者DATA: FILE=)是固定句式,是必要的。
之后“C:\Users\dell\Desktop\MPLUS结构方程模型教程\数据库.dat”这是DAT文件的保存路径。
一般情况下,如果mplus语句文件和dat文件在同一个文件夹中,只需要DATA: FILE IS数据库.dat; 但实际上很多情况下,两者即使在同一个文件中,也很可能读不出来,所以必要的话,可将该DAT文件的保存路径写全,这样肯定是没错的。
另外,一个命令结束后,必须必须加上“;”即英文格式下的分号(除外TITLE)。
3.3 写出数据库中所有的变量名称以及本次分析需要的变量名称。
这需要按照spss数据库中变量名称顺序来写。
VARIABLE: NAMES ARE a1 a2 a3 a4 a5 a6 a7 a8 a9 b1 b2 b3 b4 c1 c2 c3 c4;USEVARIABLES ARES ARE a1 a2 a3 a4 a5 a6 a7 a8 a9 b1 b2 b3 b4 c1 c2 c3 c4;当然这是最基本繁琐的写法,可以直接写为:VARIABLE: NAMES ARE a1-a9 b1-b4 c1-c4;USEVARIABLES ARES ARE a1-a9 b1-b4 c1-c4;不同变量间有空格。
mplus结构方程模型 基础命令

一、mplus结构方程模型简介mplus是一种常用的结构方程模型(Structural Equation Modeling, SEM)分析软件,它具有强大的功能和灵活的操作方式,被广泛应用于社会科学、心理学、教育学等领域的数据分析中。
在mplus中,基础命令是进行SEM分析的基础,熟练掌握基础命令对于进行SEM分析是至关重要的。
二、mplus基础命令的语法结构mplus基础命令的语法结构主要包括变量定义、模型设置和分析选项三个部分,在编写基础命令时需要按照特定的格式书写。
1. 变量定义变量定义部分通过使用VARIABLE命令来定义观测变量和潜在变量,语法格式如下:VARIABLE:变量1-变量n;定义观测变量和潜在变量的名称,并使用分号进行分隔。
2. 模型设置模型设置部分通过使用ANALYSIS命令来指定模型的参数设置和分析选项,语法格式如下:ANALYSIS:TYPE = basic;在模型设置部分可以指定各种参数和选项,以满足具体的分析需求。
3. 分析选项分析选项部分通过使用MODEL命令来指定SEM模型的结构和参数估计方法,语法格式如下:MODEL:f1 BY x1-x3;f2 BY x4-x6;在分析选项部分可以定义模型中的路径和参数,以及指定变量之间的关系。
三、mplus基础命令的使用方法在使用mplus进行SEM分析时,需要按照以下步骤进行基础命令的编写和运行。
1. 打开mplus软件并创建新的分析文件。
2. 编写基础命令,包括变量定义、模型设置和分析选项。
3. 保存基础命令文件,并使用.mplus后缀名进行命名。
4. 运行基础命令文件,查看分析结果并进行进一步的模型检验和修正。
四、mplus基础命令的案例分析以下是一个基础的mplus命令案例,用于进行双因子结构方程模型的分析:VARIABLE:y1-y5;f1 f2;ANALYSIS:TYPE = general;MODEL:f1 BY y1 y2 y3;f2 BY y4 y5;在这个案例中,通过使用VARIABLE命令定义了观测变量和潜在变量,使用ANALYSIS命令指定了分析类型,使用MODEL命令定义了双因子结构方程模型,并指定了观测变量和潜在因子之间的关系。
mplus结构方程模型步骤
mplus结构方程模型步骤使用mplus进行结构方程模型分析需要以下步骤:一、确定研究目的和理论基础在进行结构方程模型分析之前,首先需要明确研究的目的和基本理论,确定所要研究的变量以及它们之间的关系。
二、准备数据集准备好所需的数据集,包括测量变量和观测样本。
确保数据的完整性和正确性,处理缺失值和异常值。
三、指定模型根据研究目的和理论基础,指定结构方程模型的变量和路径关系。
可以使用路径图或者文字描述的方式来表示模型。
四、选择合适的估计方法结构方程模型中需要选择适当的估计方法。
常用的估计方法包括最小二乘法(OLS)、最大似然估计(ML)和广义最小二乘法(GLS)等。
选择合适的估计方法可以提高模型拟合度。
五、进行模型拟合度检验在进行模型拟合度检验之前,需要先进行模型参数估计。
利用mplus软件进行模型拟合度检验,可以得到各项指标,如卡方拟合度指数(χ²)、比较拟合指数(CFI)、均方根误差逼近度(RMSEA)等。
六、修正模型根据模型拟合度检验结果,如果模型的拟合度不理想,可以进行模型修正。
可以根据修正指标对模型进行优化,如删除非显著路径、添加相关路径等。
七、解释模型结果根据结构方程模型的参数估计结果,解释模型中各个变量之间的关系。
可以通过路径系数、标准化回归系数来解释变量之间的直接和间接效应。
八、进行模型对比可以通过比较不同模型的拟合度指标来选择最佳模型。
常用的对比指标包括AIC(赤池信息准则)和BIC(贝叶斯信息准则)等。
九、进行模型稳健性检验为了验证模型的稳健性,可以进行Bootstrap检验或者多组样本比较。
这些检验可以帮助确认模型的稳健性和一致性。
十、撰写结构方程模型结果报告根据模型分析结果,撰写结构方程模型的结果报告。
报告中应包括模型的拟合度指标、路径系数、标准化回归系数以及模型的解释和结论等。
以上是使用mplus进行结构方程模型分析的步骤。
通过合理的研究设计、数据准备、模型建立和结果解释,可以得到科学可靠的研究结论。
动态结构方程模型mplus
动态结构方程模型mplus动态结构方程模型(Mplus)是一种常用的统计分析方法,可用于在多个时间点上对数据进行分析。
它可以用于测量模型、结构模型、纵向数据分析和多水平数据分析等方面。
本文将介绍如何使用Mplus进行动态结构方程模型分析。
1. 准备数据在使用Mplus进行动态结构方程模型分析之前,首先需要准备好数据。
在数据准备阶段,需要确认数据是否包含多个时间点,并且每个时间点的变量名称是否相同。
此外,需要检查数据是否具有足够的可测性以进行结构方程建模。
2. 设计结构方程模型设计结构方程模型是动态结构方程模型分析的关键一步。
首先需要确定理论模型的内容,以及各个时间点上需要测量的变量。
然后需要建立一个初始模型,并进行逐步的改进。
改进模型的过程中,需要根据拟合程度指标,对模型进行适当的适应。
适应的目标是让拟合程度指标最优,以便获得最好的拟合表现。
3. 模型拟合在设计好结构方程模型后,需要通过Mplus进行拟合,以得到相应的参数估计值。
拟合过程中需要注意以下问题:(1)确定程序设置。
这包括确定要使用哪一种算法,如BGM、EM等,以及确定最大迭代次数和容许误差等。
(2)确定模型拟合检验的方法。
模型提供了多个拟合指标,如卡方拟合指标、SRMR、RMSEA和CFI指标等,需要了解它们各自的含义,并根据实际需求进行选择。
4. 解释结果当模型拟合成功后,需要对结果进行解释,以确定模型的质量。
需要评估拟合指标,以评估模型是否符合预期。
如果模型拟合不佳,需要进行模型改进,并重新进行拟合。
总结:动态结构方程模型是一种有效的统计方法,能够在多个时间点上对论题进行探究。
在进行动态结构方程模型分析之前,需要准备好数据、设计结构方程模型、进行模型拟合和结果解释。
同时,需要注意拟合程度指标的使用,并进行根据实际需求的选择。
(完整版)Mplus简介及实例应用
Mplus 6.1 使用示例Mplus结构方程模型步骤(入门)1数据格式转换因为Mplus只能打开ASCII格式的文件(.dat和.txt文件),所以常规的SPSS数据库的数据不能被读取,所以数据分析之前先要将sav格式另存为dat格式。
另存为选项里有两类dat格式,一般可选用“以制表符分隔”,当数据量较大时,可选“固定ASCII格式”。
这两类并没有明显特异的使用条件。
选择某种dat格式后,“将变量名写入表格”这一项不要勾选。
然后保存。
一般将该数据文件和mplus语句文件放在一个文件夹。
2 打开mplus程序,建立新文件,即点击“new”。
当然,新打开Mplus程序也会默认这个界面。
3 编辑命令。
这是Mplus分析数据最核心的步骤3.1 首先我们可以给该分析起个名字(该步骤可有可无),例如:TITLE: example3.2 然后表明我们引用的数据库来自于哪里,也就是刚刚那个DAT文件。
命令为:DATA: FILE IS C:\Users\dell\Desktop\MPLUS 结构方程模型教程\数据库.dat;这里面需要注意的是:DATA: FILE IS (或者DATA: FILE=)是固定句式,是必要的。
之后“C:\Users\dell\Desktop\MPLUS结构方程模型教程\数据库.dat”这是DAT文件的保存路径。
一般情况下,如果mplus语句文件和dat文件在同一个文件夹中,只需要DATA:FILE IS数据库.dat; 但实际上很多情况下,两者即使在同一个文件中,也很可能读不出来,所以必要的话,可将该DAT文件的保存路径写全,这样肯定是没错的。
另外,一个命令结束后,必须必须加上“;”即英文格式下的分号(除外TITLE)。
3.3 写出数据库中所有的变量名称以及本次分析需要的变量名称。
这需要按照spss数据库中变量名称顺序来写。
VARIABLE: NAMES ARE a1 a2 a3 a4 a5 a6 a7 a8 a9 b1 b2 b3 b4 c1 c2 c3 c4; USEVARIABLES ARES ARE a1 a2 a3 a4 a5 a6 a7 a8 a9 b1 b2 b3 b4 c1 c2 c3 c4;当然这是最基本繁琐写法,可直接写为:VARIABLE: NAMES ARE a1-a9 b1-b4 c1-c4; USEVARIABLES ARES ARE a1-a9 b1-b4 c1-c4;不同变量间有空格。
pls pm 结构方程
pls pm 结构方程
PLS-PM是结构方程建模(StructuralEquation Modeling,SEM)的一种变体,主要用于探索和验证因果关系、估计模型参数、检验假设等。
其原理和计算过程如下:
1. 迭代获得隐变量ξ和η的表达式。
2. 用通常的最小二乘法获得内部关系的系数β的估计,即隐变量之间的关系度量。
3. 用通常的最小二乘法获得外部关系的系数λ的估计,即隐变量和显变量之间的关系度量。
PLS-PM通常用于分析连续型数据,特别适用于因子分析和路径模型,其中变量之间存在线性关系。
在社会科学、管理研究和市场调查等领域中,PLS-PM尤其适用于样本量相对较小或变量之间存在多重共线性的情况。
mplus 结构方程模型
mplus 结构方程模型mplus 结构方程模型是一种广泛应用于心理学、教育学、社会科学等领域的统计分析方法。
它通过同时考虑多个变量之间的关系,帮助研究者理解复杂的数据模式和构建理论模型。
在实际研究中,mplus 结构方程模型能够帮助我们检验假设、验证理论、探究因果关系,从而提高研究的科学性和可信度。
mplus 结构方程模型的基本概念包括测量模型和结构模型。
测量模型用来描述观测变量与潜在变量之间的关系,即通过衡量观测指标来评估潜在概念。
结构模型则是用来描述不同潜在变量之间的关系,从而揭示变量之间的直接和间接作用。
通过这两个模型的结合,我们可以全面地理解各种变量之间的关系,并进行系统的分析。
在构建mplus 结构方程模型时,需要考虑以下几个关键步骤。
首先,确定研究的目的和研究问题,明确研究的理论框架和假设。
其次,设计合适的测量工具和指标,确保观测变量能够准确地反映潜在变量。
然后,建立测量模型和结构模型,进行模型拟合和参数估计。
最后,对模型进行检验和修正,确保模型的稳健性和可靠性。
mplus 结构方程模型的优势在于可以同时考虑多个变量之间的复杂关系,能够较全面地解释研究问题。
其灵活性和多样性也使得研究者能够根据具体问题选择合适的模型和方法。
此外,mplus 软件提供了丰富的功能和工具,帮助研究者进行模型拟合、参数估计和模型比较,大大简化了研究的过程。
然而,mplus 结构方程模型也存在一些局限性和挑战。
首先,模型的拟合需要满足一定的假设和前提条件,如果数据不符合假设,模型可能会失效。
其次,模型的复杂性和参数估计的不确定性使得结果的解释和推断存在一定的困难。
因此,在应用mplus 结构方程模型时,研究者需要谨慎地选择合适的模型和方法,同时注意数据的质量和一致性。
总的来说,mplus 结构方程模型是一种强大的统计分析方法,能够帮助研究者深入理解数据模式、验证理论假设。
通过合理的设计和分析,mplus 结构方程模型可以为研究提供有力的支持和证据。