
介绍一下SQL中union,intersect和minus
介绍一下SQL中union,intersect和
minus
Delete命令用来删除表的全部或者一部分数据行,执行delete 之后,用户需要提交(commmit)或者回滚(rollback) transaction 来执行删除或者撤销删除,delete命令会触发这个表上所有的delete 触发器。
Truncate删除表中的所有数据,这个操作不能回滚,也不会触发
(1)非聚集索引非聚集索引与课本中的索引类似。
数据存储在一个地方,索引存储在另一个地方,索引带有指针指向数据的存储位置。
索引中的项目按索引键值的顺序存储,而表中的信息按另一种顺序存储(这可以由聚集索引规定)。
如果在表中未创建聚集索引,则无法
只要使用特定的输入值集并且数据库具有相同的状态,不管何时调用,始终都能范围相同结果的函数叫确定性函数。
几十访问的数据库的状态不变,每次书用特定的输入值都可能范围不同结果的函数叫非确定性函数。
一个表只能由一个主键,一个表可以有很多个唯一键(UNIQUE Key) 主键不允许有null值,UNIQUE允许null值
唯一索引可以确保索引列不包含重复的值。
在多列唯一索引的情况下,该索引可以确保索引列中每个值组合都是唯一的。
例如,如果
在last_name、first_name 和middle_initial 列的组合上创建了唯一索引full_name,则该表中任何两个人都不可以具有相同的全名。
聚
Union用来返回多个查询的结果的总和去掉重复的结果语法:SELECT column1, column2 FROM tablename1 UNION SELECT column1, column2 FROM tablename2; Intersect 用来返回多个查询中共同的结果,intersect会忽略null值语法:SELECT column1, column2 FROM。
oracle 交集函数

oracle 交集函数
在Oracle数据库中,你可以使用INTERSECT关键字来找到两个或多个查询结果的交集。
交集是那些同时出现在所有查询结果中的行。
以下是一个基本的INTERSECT操作示例:
sql
SELECT column1, column2, ...
FROM table1
WHERE condition1
INTERSECT
SELECT column1, column2, ...
FROM table2
WHERE condition2;
在这个例子中,column1, column2, ...是要比较的列,table1和table2是要进行交集操作的表,而condition1和condition2是用于过滤各自表格数据的条件。
需要注意的是,INTERSECT操作符要求参与运算的两个查询返回的列数相同,并且对应的列具有相同的名称和数据类型。
另外,INTERSECT会自动去除重复的行,如果需要包含重复的行,可以使用UNION ALL而不是UNION。
此外,你还可以使用其他集合操作,如并集(UNION/UNION ALL)和差集(MINUS),它们的用法与INTERSECT类似,但得到的结果不同:
1、UNION返回两个查询结果的并集,其中重复的行会被去除。
2、UNION ALL返回两个查询结果的并集,包括重复的行。
3、MINUS返回第一个查询结果中存在但第二个查询结果中不存在的行。
记得在使用这些集合操作时,确保列的顺序和数据类型是一致的,否则可能会出现错误。
Oracle中in和notin的巨大区别
Oracle中in和notin的巨大区别在很多软件系统中,系统的性能很大程度上由数据库的性能决定。
以前也曾经做过很多次关于性能方面的各种测试,特别是关于oracle的,我想到也应该记录下来一部分,为大家共享。
事情发生在我们的系统从sqlserver移植到oracle,用户在一个查询的操作上等待的时间无法忍受了,我们关于这个查询的处理与原来的方式一下,难道sqlserver 同oracle有什么地方不一样么,让我们来看看oracle有什么地方有问题,或者是我们使用的有问题?业务问题大概可以这样描述,一个父表,一个子表,查询的结果是找到子表中没有使用父表id的记录,这种情况估计很多系统都会牵涉得到。
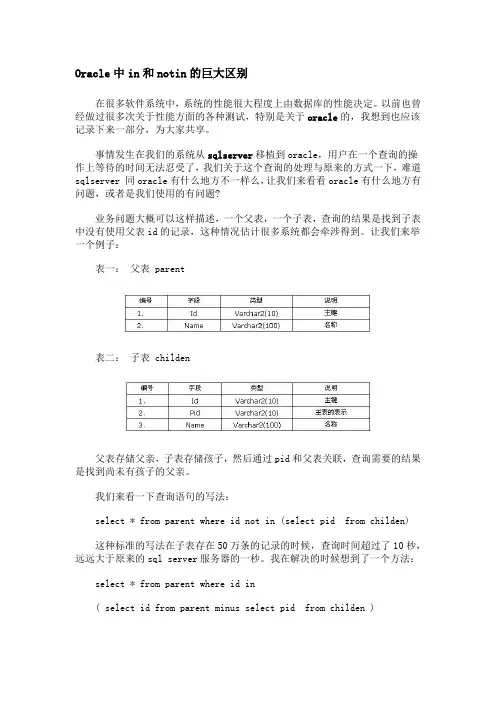
让我们来举一个例子:表一:父表 parent表二:子表 childen父表存储父亲,子表存储孩子,然后通过pid和父表关联,查询需要的结果是找到尚未有孩子的父亲。
我们来看一下查询语句的写法:select * from parent where id not in (select pid from childen)这种标准的写法在子表存在50万条的记录的时候,查询时间超过了10秒,远远大于原来的sql server服务器的一秒。
我在解决的时候想到了一个方法:select * from parent where id in( select id from parent minus select pid from childen )正常理解下,这个语句应该更加费时,但是事实完全出乎意料,这条语句不仅仅在子表存在大量记录的情况下速度良好,在子表少量数据的情况下速度也非常的好,基本在1秒内完成。
SQL语句的MINUS,INTERSECT和UNION ALLSQL语句中的三个关键字:MINUS(减去),INTERSECT(交集)和UNION ALL(并集);关于集合的概念,中学都应该学过,就不多说了.这三个关键字主要是对数据库的查询结果进行操作,正如其中文含义一样:两个查询,MINUS是从第一个查询结果减去第二个查询结果,如果有相交部分就减去相交部分;否则和第一个查询结果没有区别. INTERSECT是两个查询结果的交集,UNION ALL是两个查询的并集;虽然同样的功能可以用简单SQL语句来实现,但是性能差别非常大,有人做过实验:made_order共23万笔记录,charge_detail共17万笔记录:SELECT order_id FROM made_orderMINUSSELECT order_id FROM charge_detail耗时:1.14 secSELECT a.order_id FROM made_order aWHERE a.order_id NOT exists (SELECT order_idFROM charge_detailWHERE order_id = a.order_id)耗时:18.19 sec性能相差15.956倍!因此在遇到这种问题的时候,还是用MINUS,INTERSECT和UNION ALL来解决问题,否则面对业务中随处可见的上百万数据量的查询,数据库服务器还不被咱玩的死翘翘?PS:应用两个集合的相减,相交和相加时,是有严格要求的:1.两个集合的字段必须明确(用*就不行,报错);2.字段类型和顺序相同(名称可以不同),如:集合1的字段1是NUMBER,字段2是VARCHAR,那么集合2的字段1必须也是NUMBER,字段2必须是VARCHAR;3.不能排序,如果要对结果排序,可以在集合运算后,外面再套一个查询,然后排序,如前面的例子可以改成:SELECT * FROM(SELECT order_id FROM made_orderMINUSSELECT order_id FROM charge_detail)ORDER BY ORDER_ID ASC其中在SQL SERVER中是没有MINUS函数的,不过可以使用except函数代替。
OracleSET运算符

OracleSET运算符SET操作符可以将多个查询组合成一个新的查询。
在使用SET操作符时,特别需要注意的是查询的两个集合字段要互相对应,即数量和数据类型要相互对应。
SET操作符有UNION、UNION ALL、INTERSECT、MINUS。
查询出来的结果默认排序顺序是升序排序,可以用ORDER BY改变排序方式,而且ORDER BY语句只能出现在最后。
NUMONE表与NUMTWO表:一、UNION(并集、去重复)UNION 操作符返回两个查询结果集的并集,对于两个结果集重复的部分会去除。
由上面的全表查询可以知道NUMONE表中有五条数据,NUMTWO表中有六条数据,这两个表经过UNION操作符求并集然后去重复之后返回的结果是9条,也就是说这两个表中存在两条相同的数据(1,2和1,4)。
二、UNION ALL(并集、不去重)UNION ALL 操作符返回两个查询结果集的并集,对于两个结果集重复的部分不会去除。
UNION ALL 操作符返回的是两个表的并集且不会去除重复的数据,所以返回的数据中是含有重复数据的。
条数为NUMONE表中的5条数据加上NUMTWO表中的6条数据,即11条数据。
三、INTERSECT(交集)INTERSECT 操作符返回两个查询结果集的交集。
INTERSECT 操作符返回的是两个查询结果集的交集,也就是返回这两个查询结果中重复的数据,这两条数据与UNION操作符去除掉的数据是一样的,因为UNION操作符去除的就是重复数据。
四、MINUS(差集)MINUS操作符返回两个查询结果集的差集。
MINUS操作符返回在第一个集合中存在且在第二个集合中不存在的数据,所以返回的结果是第一个查询结果集减去两个查询结果集中重复的数据。
五、多个SET操作符SET操作符中并不仅限于只能用一个操作符来对结果集进行处理,可以同时使用多个相同的操作符或者不同的操作符左图用两个INTERSECT来对这三个查询结果集求交集,右图用MINUS和INTERSECT来对这三个查询结果集求差集之后再求交集。
SQL基础:Select语句,各种join,union用法

SQL基础:Select语句,各种join,union⽤法⼀、基本的SELECT语句1. “*”的注意事项:在SELECT语句中,⽤*来选取所有的列,这是⼀个应该抵制的习惯。
虽然节省了输⼊列名的时间,但是也意味着获得的数据⽐真正需要的数据多的多。
相应的,也会降低应⽤程序的性能及⽹络性能。
良好的规则是只选所需。
2. join⼦句join是⽤来定义如何从多个表中选取数据并组合成⼀个结果集。
join必需是因为(1)我们所要获取的所有信息并不都在⼀个表中,或者(2)所要返回的信息都在⼀个表中,但是其上设置的条件信息却在另⼀个表中。
join的共同点是通过记录的连接列,把⼀条记录同⼀条或者多条其他记录进⾏匹配,从⽽产⽣出是这些记录的超级的记录。
2.1 INNER JOININNER JOIN只返回进⾏联接的字段上匹配的记录。
INNER JOIN是在做排除。
⾃引⽤是为了某种原因把⼀个表联接回它⾃⾝。
INNER JOIN是默认的联接⽅式。
2.2 OUTER JOINOUTER JOIN有左右联接之分,⽽INNER JOIN没有左右联接之分。
RIGHT(LEFT) OUTER JOIN是既想要包含右侧表中的所有⾏,以及左侧表中有匹配记录的⾏。
2.3 FULL JOINFULL JOIN联接,就是要包含位于联接两侧的表中所有的⾏。
2.4 CROSS JOINCROSS JOIN没有ON联接符,并且将join⼀侧表中的每⼀条记录与另⼀侧的表中所有的记录联接起来。
即联接表中的笛卡尔积。
CROSS JOIN可⽤于提供样本数据和科学数据3. WHERE⼦句⼀些常⽤且不太熟悉的操作符:BETWEEN: <列> BETWEEN num1 AND num2LIKE: LIKE "ANY%" %代表0个或者多个任意字符。
_代表单个任意字符。
[]表⽰括号中包含的任意单个字符。
^排除下⼀个。
EXISTS: EXISTS 查询语句。
数据库系统原理课程总结

数据库系统原理课程总结第一章数据库基础知识1.信息、信息特征及作用(1)信息的内容是关于客观事物或思想方面的知识。
(2)信息是有用的。
(3)信息能够在空间可时间上传递。
(4)信息需要一定的形式表示。
2.数据、数据与信息的关系及数据的特征(1)数据哟“型”与“值”之分。
(2)数据受数据类型和取值范围的约束。
(3)数据有定性表示和定量表示之分。
(4)数据应具有载体和多种表现形式。
3.手工管理数据库阶段(1)手工管理阶段不保存大量的数据。
(2)手工管理数据库阶段没有软件系统对数据刻库进行管理。
(3)手工管理阶段基本上没有“文件”概念。
(4)手工管理阶段是一组数据对应一个程序。
4.数据库技术的发展历程(1)出现了许多商品化的数据库管理系统。
(2)数据库技术成为实现和优化信息系统的基本技术。
(3)关系方法的理论研究和软件系统的研制取得了很大成果。
5.数据库系统的软件的组成(1)操作系统。
(2)数据库管理系统和主语言编译系统。
(3)数据库应用开发工具软件。
(4)数据库应用系统及数据库。
第二章数据库模型与概念模型1.数据模型的三要素a.数据结构b.数据操作c.数据约束条件2.常见的数据模型当前,数据库领域最常用的数据模型主要有3种,它们是层次模型,网状模型和关系模型。
3.层次模型1)层次模型的定义a.有且仅有一个节点没有双亲结点,这个节点成为根结点。
b.出去根节点之外的其他结点有且只有一个双亲结点。
2)层次模型的存储结构a.邻接存储法。
邻接存储法是按照层次书前序穿越的顺序,把所有纪录值依次邻接存放,即通过物理空间的位置相邻来安排层次顺粗,实现存储。
b.链接存储法。
链接存储法是指用引元来反映数据之间的层次联系,它主要有子女-兄弟链接法和层次序列链接法两种方法。
4.网状模型1)网状模型的基本特征a.有一个以上的结点没有双亲。
b.结点可以有多余一个的双亲。
5.关系模型1)关系模型的存储结构在关系数据库的物理组织中,关系以文件形式存储。
Oracle数据库语句大全

Oracle数据库语句大全一.入门部分1.创建表空间create tablespace schooltbs datafile ‘D:\oracle\datasource\schooltbs.dbf’ size 10M autoextend on;2.删除表空间drop tablespace schooltbs[including contents and datafiles];3.查询表空间基本信息select *||tablespace_name from DBA_TABLESPACES;4.创建用户create user lihuaidentified by lihuadefault tablespace schooltbstemporary tablespace temp;5.更改用户alter user lihuaidentified by 123default tablespace users;6.锁定用户alter user lihua account lock|unlock;7.删除用户drop user lihua cascade;--删除用户模式8.oracle数据库中的角色connect,dba,select_catalog_role,delete_catalog_role,execute_catalo g_role,exp_full_database,imp_full_database,resource9.授予连接服务器的角色grant connect to lihua;10.授予使用表空间的角色grant resource to lihua with grant option;--该用户也有授权的权限11.授予操作表的权限grant select,insert on user_tbl to scott;--当前用户grant delete,update on er_tbl to scott;--系统管理员二.SQL查询和SQL函数1.SQl支持的命令:数据定义语言(DDL):create,alter,drop数据操纵语言(DML):insert,delete,update,select数据控制语言(DCL):grant,revoke事务控制语言(TCL):commit,savepoint,rollback2.Oracle数据类型字符,数值,日期,RAW,LOB字符型char:1-2000字节的定长字符varchar2:1-4000字节的变长字符long:2GB的变长字符注意:一个表中最多可有一列为long型Long列不能定义唯一约束或主键约束long列上不能创建索引过程或存储过程不能接受long类型的参数。
SQL语句 UNION 和 UNION ALL使用
SQL语句UNION 和UNION ALL 使用(二)在MS-SQL如果将两个或更多查询的结果组合为单个结果集,该结果集包含联合查询中的所有查询的全部行,常用的方法如下:一.使用union 或union All语句1. union 与union all语句的区别ØUNION 组合多个表(或结果集)并将其作为单个结果集返回;ØUNION ALL 在结果中包含所有的行,包括重复行。
Ø也就是说,使用UNION组合两个表时,将重复的记录删除;而使用UNION ALL组合两多个表时,不考虑结果集中是否存在重复记录,包括重复行。
2. 使用UNION 运算符时请注意:(1)所有查询中的列数和列的顺序必须相同。
在使用UNION 运算符组合的语句中,所有显示列表的数目必须相同(列表内容可以包括:列名、算术表达式、聚合函数等);(2)数据类型必须兼容。
在使用UNION 组合的结果集中的相应列必须具有相同数据类型,或者两种数据类型之间存在隐性数据转换,或提供了类型转换。
例如,在datetime 数据类型的列和binary 数据类型的列之间不可能存在UN ION 运算符,除非提供了显式转换,而在money 数据类型的列和int 数据类型的列之间可以存在UN ION 运算符,因为它们可以进行隐性转换。
(3)用UNION 运算符组合的各语句中对应的结果集列出现的顺序必须相同,因为UNION 运算符是按照各个查询给定的顺序逐个比较各列。
3. 与其它Transact-SQL语句一起使用UNION 语句时,应注意:(1)如果在有UNION的语句中使用INTO语句,则只能在最终表(或结果集)中使用,如果要在单个表(或结果集)中使用INTO语句,MS-SQL将会提示错误;错误语句:Select AID,AName,ADemo Into From ATable Union All Select BID,BName,BDem o Into From Btable(2)只有在UNION 语句的结尾,才允许使用ORDER BY 和COMPUTE 子句以定义最终结果的顺序或计算汇总值。
SQL集合运算及常用函数
SQL 集合运算及常用函数SQL 函数一、字符转换函数1.ASCII ()返回字符表达式最左端字符的ASCII 码值。
在ASCII()函数中,纯数字的字符串可不用‘’2.CHAR ()3.LOWER ()4.UPPER ()5.STR ()把数值型数据转换为字符型数据。
STR (<float_expression>[,length[,<decimal>]])length 指定返回的字符串的长度,decimal 指定返回的小数位数。
如果没有指定长度,缺省的length 值为10,decimal 缺省值为0。
当length 或者decimal 为负值时,返回NULL;当length 小于小数点左边(包括符号位)的位数时,返回length 个*;先服从length ,再取decimal ;当返回的字符串位数小于length ,左边补足空格。
二、去空格函数1.LTRIM ()2.RTRIM ()三、取子串函数1.LEFT ()LEFT (<character_expression>,<integer_expression>)返回character_expression 左起integer_expression 个字符。
2.RIGHT ()RIGHT (<character_expression>,<integer_expression>)3.SUBSTRING ()SUBSTRING (<expression>,<starting_ position>,length)返回从字符串左边第starting_ position 个字符起length个字符的部分。
四、字符串比较函数1.CHARINDEX ()返回字符串中某个指定的子串出现的开始位置。
CHARINDEX (<’substring_expression’>,<expression>)其中substring _expression 是所要查找的字符表达式,expression 可为字符串也可为列名表达式。
sqlserver的union用法
sqlserver的union用法一、概述UNION是SQL语言中的一个操作符,用于合并两个或多个SELECT 语句的结果集。
在SQL Server中,UNION操作符将两个或多个SELECT语句的结果集合并为一个结果集,并去除重复的行。
二、基本用法UNION操作符的基本语法如下:SELECT column1, column2, ... FROM table1UNIONSELECT column1, column2, ... FROM table2;其中,column1、column2等表示要查询的列名,table1、table2等表示要查询的表名。
需要注意的是,每个SELECT语句中列数必须相同,并且数据类型必须兼容。
如果不满足这些条件,则会出现错误。
三、去重复行当使用UNION操作符时,默认情况下会去除重复行。
也就是说,如果两个查询结果存在相同的行,则只会保留一行。
如果想保留重复行,则可以使用UNION ALL操作符。
其语法与UNION类似:SELECT column1, column2, ... FROM table1UNION ALLSELECT column1, column2, ... FROM table2;四、排序在使用UNION操作符时,可以通过ORDER BY子句对结果进行排序。
ORDER BY子句只能放在最后一个SELECT语句之后。
例如:SELECT column1, column2, ... FROM table1UNIONSELECT column1, column2, ... FROM table2ORDER BY column1;五、限制结果集数量在使用UNION操作符时,可以通过TOP关键字限制结果集的数量。
TOP关键字只能放在每个SELECT语句之前。
例如:SELECT TOP 10 column1, column2, ... FROM table1UNIONSELECT TOP 10 column1, column2, ... FROM table2;六、使用子查询在使用UNION操作符时,可以将一个SELECT语句作为子查询嵌套到另一个SELECT语句中。
intersect sql语法
intersect sql语法SQL是结构化查询语言的缩写,它是一种通用的数据库语言,用于在关系数据库中执行各种操作,包括数据查询、数据操作、数据定义、数据控制等。
SQL语言具有简单、灵活、高效的特点,被广泛应用于数据管理和开发。
在SQL语言中有许多关键词,其中之一就是intersect(交集)。
它表示在两个表之间获取相同行的查询结果。
在SQL中,intersect是一个组合关系运算符,用于比较两个SELECT语句的结果集,并返回两个结果集之间的所有交集行。
可以在两个SELECT语句之间使用intersect关键字,其基本语法如下:SELECT column_name(s) FROM table1INTERSECTSELECT column_name(s) FROM table2在以上语法中,INTERSECT关键字会比较表1和表2的结果集,并返回相同的行。
要注意的是,intersect只返回相同的行,只能应用于两个SELECT语句,而且这两个SELECT语句必须拥有相同的列数和相同的列顺序。
下面是一个使用intersect的例子,假设我们有两个表students和teachers,我们想要找出既是学生又是教师的人员信息,可以使用如下SQL语句:在这个例子中,我们从学生表和教师表中选择姓名、年龄和性别列,并使用intersect关键字获取两个表之间相同的行。
如果学生表和教师表中都存在相同的人员信息,那么这些信息会被返回,否则不会返回。
使用intersect可以减少我们在数据库中操作的复杂性,并且可以提高查询效率。
intersect可以帮助我们更快速地找到两个表之间的交集,以便更好地管理和分析数据。
总之,intersect是SQL语言的一种组合关系运算符,用于找到两个表之间相同的行。
要使用intersect,我们必须确保两个SELECT语句的列数和列顺序相同。
在操作数据库时,尤其是需要查找数据的时候,intersect是一个非常有用的工具,可以方便我们快速查找出数据中的相关信息。