
多元统计分析及R语言建模(第五版)课件第一二章
2 多元数据的数学表达及R使用
数据框(data frame)是一种矩阵形式的数据,但数据框中各列可以是不同类型的数据。 数据框录入限制条件
数 据 框
在数据框中 以变量形式 出现的向量 长度必须一 致,矩阵结 构必须有一 样的行数。
2 多元数据的数学表达及R使用
#矩阵按列求和 apply(A,2,sum)
#矩阵按列求均值 aplly(A,2,mean)
#矩阵按列求方差 A=matrix(rnorm(100),20,5) aplly(A,2,var)
#矩阵按列求函数结果 B=matrix(1:12,3,4) apply(B,2,function(x,a) x*a, a=2)
#矩阵按行求和 rowSums(A)
#矩阵按行求均值 colSums(A)
#矩阵按列求和 colSums(A)
#矩阵按列求均值 colSums(A)
apply()函数
apply(X, MARGIN, FUN, ...)
#矩阵按行求和 apply(A,1,sum)
#矩阵按行求均值 apply(A,1,mean)
命令结果窗口
R里面有什么?
Packages (每个都有大量数据和可以读写修 改的函数/程序)
base boot class cluster ctest eda foreign grid KernSmooth lattice lqs MASS methods mgcv
The R base package Bootstrap R (S-Plus) Functions (Canty) Functions for classification Functions for clustering (by Rousseeuw et al.) Classical Tests Exploratory Data Analysis Read data stored by Minitab, SAS, SPSS, ... The Grid Graphics Package Functions for kernel smoothing for Wand & Jones (1995) Lattice Graphics Resistant Regression and Covariance Estimation Main Library of Venables and Ripley's MASS Formal Methods and Classes Multiple smoothing parameter estimation and GAMs by GCV
#本例性别、风险、专兼职、职业、教育和结果 为定性变量,年龄是定量变量,有时为了分析问 题方便,也可将其定量化,例如
年龄(age):19岁以下(1);20至29岁(2); 30 至39岁(3);40至49岁(4);50至59岁 (5);60岁 及以上(6);缺失(*)。
性别(sex): 男(1),女(2)。 风险(risk):有(1);无(2)。 专兼职(post):专职(1);业余(2)。 职业(career):干部(1);管理(2);3科教
内 数学表达、数据矩阵及R表示、数据的R语言表示、R调用多元的数据和
容 多元的数据的简单R语言分析。 与
要
求
要求学生熟练如何收集和整理多元统计分析资料、数据的数学表
达、掌握多元数据的数字特征的解析表达式、数字特征的基本性质。数据下,求样本均值、样本离差阵、样本协差阵等。
板
read.table("clipbo ard",header=T)
S-PLUS
■操作简单 ■无须编程 ■方便的数据接口 ■灵活的功能模块组合
■操作界面简单 ■全面的统计模型和分析手段 ■很强的图形处理能力 ■兼容性极好
3 多元数据直观表示及R使用
2
完整的 数值计 算软件
MATLAB
■数值分析 ■数值和符号计算 ■工程与科学绘图 ■控制系统的设计与仿真 ■数字图像处理技术 ■数字信号处理技术 ■通讯系统设计与仿 ■财务与金融工程
Survival analysis, including penalised likelihood. Interface to Tcl/Tk
Tools for Package Development and Administration Time series functions
所有这些Packages都是在base package上添加的
modreg mva nlme nls nnet rpart spatial splines
survival tcltk tools ts
Packages (继续)
Modern Regression: Smoothing and Local Methods
Classical Multivariate Analysis Linear and nonlinear mixed effects models Nonlinear regression Feed-forward neural networks and multinomial log-linear models Recursive partitioning functions for kriging and point pattern analysis Regression Spline Functions and Classes stepfun Step Functions, including Empirical Distributions
• Base包含所有固有的应用和数据 • 而其他的packages包含各统计学家自己发展
的方法和数据。 • 希望你是下一个加盟这些packages的作者之
一。☺
多元统计分析及R语言建模
第2章 多元数据的数学表达及R使用
多元统计分析及R语言建模
多元统计分析及R语言建模
多元数据的基本格式,如何收集和整理多元统计分析资料、数据的
1 多元统计分析概述
多
元 统
4 简化系统结构,探讨 系统内核
3 进行数值分类,构 造分类模式
计 分
2 构造预测模型,进 行预报控制
析
1 变量之间相依性 分析
的
用
途
综决
合 考 虑 。
实 际 问 题 , 需 要 对 问 题 进 行
如
何 选 择 适 当 的 方 法 来 解
1 多元统计分析概述
多1
元2 统
多元统计分析及R语言建模
第1章 多元统计分析概述
- 1-
课程安排
1、在基本统计方法学习的基础上,深入学习 多元统计分析模型及模型实现、分析方法。
2、该门课程每周2.5课时,理论与上机结合。
• 期末考核: 总成绩=平时(20%)+上机(20%)+期末考试(60%)
• 考试方式 平时(20):课堂(40%)+出勤(60%) 上机(20):两次实验报告,一次50% 期末考试:闭卷
2
学习资料
教学教材: 王斌会编著《多元统计分析及R语言建模》
2016.1(第4版)暨南大学出版社
扩充资料: [1]王斌会编著《数据统计分析及R语言编程》
2017.6(第2版) 北京大学出版社,暨南大学出版社
3
多元统计分析及R语言建模
多元统计分析及R语言建模
多元分析基本内容,以及本课程的主要安排。相关的补充
计3
分 析
4
的5
内6 容
7
多元数据的数学表示 多元数据的直观分析 多元线性相关分析 多元线性回归分析 广义和一般线性模型 判别分析 聚类分析
8
主成分分析
9
因子分析
10
对应分析
11
典型相关分析
12
多维标度法
13
综合评价法
1 多元统计分析概述
SAS
SPSS
1
强大的 统计分 析软件
■著名统计分析软件 ■组合软件系统 ■入门比较困难
内 容
知识和将要涉及的计算软件程序。
与
要
求
要求学生了解多元分析的基本内容及应用领域,并掌握
一些基本概念。对统计分析软件有一个基本认识。
1 多元统计分析概述
多 现实生活中,受多种指标共同作用和影响的现象大 元 量存在。 统 计 在经济生活中,受多种指标(随机变量)共同作用 分 和影响的现象大量存在。 析 的 多元统计分析是运用数理统计方法来研究解决多指 历 标问题的理论和方法。 史
2 多元数据的数学表达及R使用
2 多元数据的数学表达及R使用
【例2.1】为了了解股民的投资状况,研 究股民的股票投资特征,我们在2002年组 织统计系本科生进行小范围的“股民投资 状况抽样调查”。本次调查的抽样框主要 涉及广东省的6个城市(广州、深圳、珠 海、中山、佛山和东莞,其中,广州、深 圳各100份,其他城市各80份),共发放 问卷520份,回收有效问卷514份。问卷中 设计了18个问题。为了简化分析,本例只 考虑:年龄、性别、风险意识、是否专兼 职、职业状况、教育程度和投资结果共7 个变量进行分析。
#创建按照行排列的矩阵 matrix(x1,nrow=3,ncol=4,byrow=T)
2 多元数据的数学表达及R使用
#创建两个相同的矩阵 A=B=matrix(1:12,nrow=3,ncol=4)
#矩阵加法 A+B
#矩阵转置 t(A)
#矩阵加法 A+B
2 多元数据的数学表达及R使用
#矩阵相乘 A=matrix(1:12,nrow=3,ncol=4) B=matrix(1:12,nrow=4,ncol=3) A%in%B
《多元统计分析及R语言》第2章多元数据的数学表达
5 - 16
饼图: 分析单变量分布特征 pie(table(结果))
5 - 17
(2)两因素分析
条形图:分析单变量分布特征 data=read.table("clipboard",header=T) table(年龄,性别) #二维列联表 barplot(table(年龄,性别),beside=T, col=1:7)
所在包 base base base base base base base base base
base
base
base base base base
2.4 数据的R语言表示-数据框
数据框:是一种矩阵形式的数据,但数据框中各列可 以是不同类型的数据。
地区 A A A B B A D
性别(X1) 教育程度(X2) 观点(X3)
t diag solve
eigen
chol
svd qr kronecker dim
用途 向量生成函数 向量长度函数 对象类型函数 行合并函数 列合并函数 矩阵生成函数 矩阵转置函数 对角阵生成函数 逆矩阵计算函数
矩阵的特征值与特征向量函数
进行Choleskey分解
进行奇异值分解 进行QR分解 kronecker积计算函数 矩阵维数
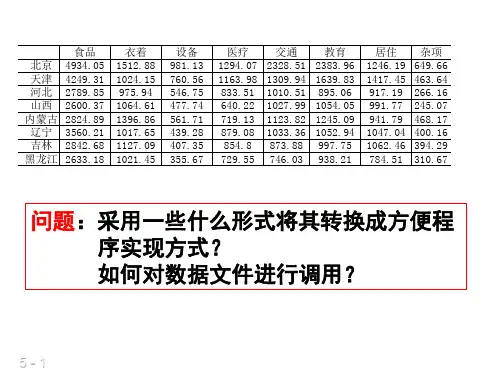
设备 981.13 760.56 546.75 477.74 561.71 439.28 407.35 355.67
医疗 1294.07 1163.98 833.51 640.22 719.13 879.08
854.8 729.55
交通 2328.51 1309.94 1010.51 1027.99 1123.82 1033.36 873.88 746.03
数学建模-多元统计分析引论(共52张PPT)

持续吸烟组的死亡相对危险度怎么比不吸
烟组低呢?(烟草公司希望) 在你假定在此研究中可能有差错之前,
一些其它研究发现在冠状动脉疾病血栓溶 解治疗中,吸烟和预后具有同样的关系, 这一作用被称为“吸烟者悖论”
是什么原因导致这一“悖论”呢?
Barbash, G.L.,Reiner, J., White, H.D., Et al. “Evaluation of paradoxical beneficial effects of smoking in patients receiving thrombolytic therapy for acute myocardial infarction: Mechanisms of the ‘smoker’s paradox’ from the GUSTO-I trial, with angiographic insights.” J. Am. Coll. Cardiol. 1995;26:1222-9.
MI
Coffee
90
No coffee 60
NoMI
60
90
%
60
40
Pearson chi2(1) = 12.0,P = 0.001。
说明喝咖啡人MI发生的危险性是不喝的2.25倍。 两组MI发生率差异有显著意义。 结论:喝咖啡与心肌梗塞MI有关!对否?
研究者怀虑结论,考虑到其中可能混杂其它因
表1.5 Aerobics 中心追踪研究全死亡率危险因素 的多元分析
自变量 死亡率 调整相对危险度RR
(百万分数) (95%CI)
运动量 低
中/高
38.1
25.0
1.52(1.28-1.82)*
1.0(参照组)
多元统计分析及R语言建模(第五版)课件第一二章
2 多元数据的数学表达及R使用
数据框(data frame)是一种矩阵形式的数据,但数据框中各列可以是不同类型的数据。 数据框录入限制条件
数 据 框
在数据框中 以变量形式 出现的向量 长度必须一 致,矩阵结 构必须有一 样的行数。
(3);金融(4);工人(5);农民(6);个体 (7);无业(8)。 教育(edu):文盲(1);小学(2);中学(3); 高中(4);中专(5); 大专(6);大学(7);研究生(8)。 投资结果(result):赚钱(1);不赔不赚(2); 赔钱(3)。
2 多元数据的数学表达及R使用
一元数据
2
学习资料
教学教材: 王斌会编著《多元统计分析及R语言建模》
2016.1(第4版)暨南大学出版社
扩充资料: [1]王斌会编著《数据统计分析及R语言编程》
2017.6(第2版) 北京大学出版社,暨南大学出版社
3
多元统计分析及R语言建模
多元统计分析及R语言建模
多元分析基本内容,以及本课程的主要安排。相关的补充
1 多元统计分析概述
R
3
免费的 数据分 析软件
01 功能强大 02 免费,开源
03
前景广阔
1 多元统计分析概述
R
优点
缺点
软
件
自由软件,统计功能强大
初学较为麻烦,需一
优
,可以看作Splus的免费
点
1 多元统计分析概述
#三窗口排列
#Rstudio界面
语句编程窗口 图形显示窗口
多元统计分析及R语言建模答案(王斌会)
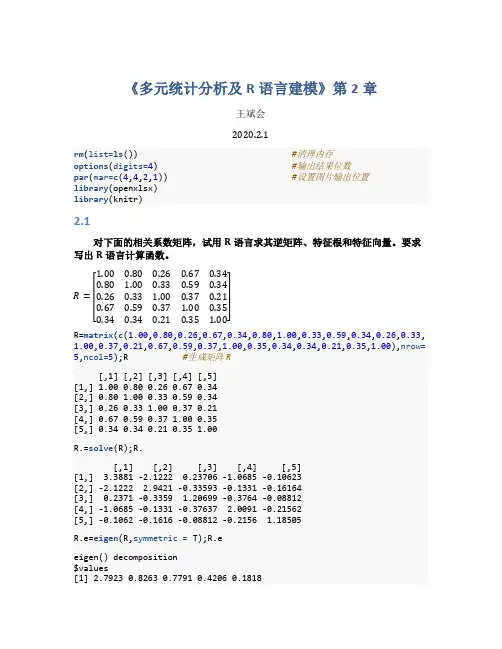
《多元统计分析及R 语言建模》第2章王斌会2020.2.1 rm (list=ls ()) #清理内存options (digits=4) #输出结果位数par (mar=c (4,4,2,1)) #设置图片输出位置 library (openxlsx)library (knitr)2.1对下面的相关系数矩阵,试用R 语言求其逆矩阵、特征根和特征向量。
要求写出R 语言计算函数。
R =[ 1.000.800.260.670.340.80 1.000.330.590.340.260.33 1.000.370.210.670.590.37 1.000.350.340.340.210.35 1.00]R=matrix (c (1.00,0.80,0.26,0.67,0.34,0.80,1.00,0.33,0.59,0.34,0.26,0.33, 1.00,0.37,0.21,0.67,0.59,0.37,1.00,0.35,0.34,0.34,0.21,0.35,1.00),nrow=5,ncol=5);R #生成矩阵R[,1] [,2] [,3] [,4] [,5][1,] 1.00 0.80 0.26 0.67 0.34[2,] 0.80 1.00 0.33 0.59 0.34[3,] 0.26 0.33 1.00 0.37 0.21[4,] 0.67 0.59 0.37 1.00 0.35[5,] 0.34 0.34 0.21 0.35 1.00R.=solve (R);R.[,1] [,2] [,3] [,4] [,5][1,] 3.3881 -2.1222 0.23706 -1.0685 -0.10623[2,] -2.1222 2.9421 -0.33593 -0.1331 -0.16164[3,] 0.2371 -0.3359 1.20699 -0.3764 -0.08812[4,] -1.0685 -0.1331 -0.37637 2.0091 -0.21562[5,] -0.1062 -0.1616 -0.08812 -0.2156 1.18505R.e=eigen (R,symmetric = T);R.eeigen() decomposition$values[1] 2.7923 0.8263 0.7791 0.4206 0.1818$vectors[,1] [,2] [,3] [,4] [,5][1,] -0.5255 0.34022 -0.1665 0.15938 0.74494[2,] -0.5187 0.23435 -0.1778 0.50823 -0.62142[3,] -0.3131 -0.90308 -0.2287 0.14943 0.10844[4,] -0.4966 0.03869 -0.1186 -0.83116 -0.21673[5,] -0.3318 -0.11084 0.9350 0.05616 0.013552.2某厂对50个计件工人某月份工资进行登记,获得以下原始资料(单位:元)。
《多元统计分析》课件
采用L1正则化,通过惩罚项来选择最重要 的自变量,实现特征选择和模型简化。
比较
应用场景
岭回归适用于所有自变量都对因变量有影 响的情况,而套索回归更适用于特征选择 和模型压缩。
适用于数据集较大、自变量之间存在多重 共线性的情况,如生物信息学数据分析、 市场细分等。
主成分回归与偏最小二乘回归
主成分回归
适用于自变量之间存在多重 共线性的情况,同时要求高 预测精度,如金融市场预测 、化学计量学等。
06 多元数据的典型相关分析
典型相关分析的基本思想
01
典型相关分析是一种研究多个 随机变量之间相关性的多元统 计分析方法。
02
它通过寻找一对或多个线性组 合,使得这些线性组合之间的 相关性达到最大或最小,从而 揭示多个变量之间的关系。
原理
基于最小二乘法原理,通过最小化预 测值与实际值之间的平方误差来估计 回归系数。
应用场景
适用于因变量与自变量之间存在线性 关系的情况,如预测房价、股票价格 等。
注意事项
需对自变量进行筛选和多重共线性诊 断,以避免模型的不稳定性和误差。
岭回归与套索回归
岭回归
套索回归
是一种用于解决多重共线性的回归方法, 通过引入一个小的正则化项来稳定系数估 计。
层次聚类
01
步骤
02
1. 将每个数据点视为一个独立的集群。
2. 计算任意两个集群之间的距离或相似度。
03
层次聚类
01 3. 将最相近的两个集群合并为一个新的集群。 02 4. 重复步骤2和3,直到满足终止条件(如达到预
设的集群数量或最大距离阈值)。
03 应用:适用于探索性数据分析,帮助研究者了解 数据的分布和结构。
【最新】R语言北大多元统计分析 PPT课件教案讲义(附代码数据)图文
7
北大数学学院
第二章 多元正态分布及参数的估计
§2.1 随机向量—
(4) Σ=L2 ,其中L为非负定阵.
由于Σ≥0(非负定),利用线性代数中实对称阵的对角化定理,存 在正交阵Γ,使
1 0 LL
2
北大数学学院
第二章 多元正态分布及参数的估计
目
§2.1 随机向量
录
§2.2 多元正态分布的定义与 基本性质
§2.3 条件分布和独立性
§2.4 随机矩阵的正态分布
§2.5 多元正态分布的参数估计
3
北大数学学院
第二章 多元正态分布及参数的估计
§2.1 随 机 向
本课程所讨论的是多变量总体.把 p个随机变量放在一起得 X=(X1,X2,…,Xp)′ 为一个p维随机向量,如果同时对p维 总体进行一次观测,得一个样品为 p 维数据.常把n个样品排成一个n×p 矩阵,称为样本资料阵.
12
北大数学学院
第二章 多元正态分布及参数的估计
多元正态分布的性质1 在一元统计中,若X~N(μ,σ2),则X的特征函数为 §2.2σ2 /2]
当 X~N(0,1)时,φ(t)=exp[-t 2 /2].
13
北大数学学院
第二章 多元正态分布及参数的估计
§2.2
记Σ=AA′,则有以下定义。 定义2.2.2 若p维随机向量X的特征函数 t ' t 为:
X (t ) exp[ it '
则称X服从 p 维正态分布,记为 X ~Np(μ,Σ) . 一元正态: (p=1) 2 2 2 t t t (t ) exp[ it ] exp[ it ] 2 2
多元统计分析及R语言建模
y
X 连续变量
连续变量 线性回归方程
0-1变量
有序变量
多分类变量
分类变量
实验设计模型(方 差分析模型)
logistic回归模型
累积比数模型 对数线性模型
对数线性模型 多分类logistic回归模型
连续伴有删失 cox比例风险模型
连续变量 分类变量
协方差分析模型
5广义与一般线性模型及R使用
5.2 广义线性模型
程 序 与 结 果
得到初步的logistic回归模型:
5广义与一般线性模型及R使用
5.2 广义线性模型
(2)逐步筛选变量logistic回归模型:
logit.step<-step(logit.glm,direction="both") summary(logit.step)
#逐步筛选法变量选择
#逐步筛选法变量选择结果
序
pre2<-predict(logit.step,data.frame(x1=0)) #预测视力有问题的司机Logistic回归结果
与
p2<-exp(pre2)/(1+exp(pre2)) #预测视力有问题的司机发生事故概率
结
c(p1,p2) #结果显示
果
5广义与一般线性模型及R使用
5.2 广义线性模型
程 序 与 结 果
PA>0.05,说明各种燃料A对火箭射程有无显著影响,
PB>0.05,说明各种推进器B对火箭射程也无显著影响。
5广义与一般线性模型及R使用
案例分析 广义线性模型及其应用
关于40个不同年龄(age,定量变量)和性别(sex,定性变量,用0和1代表 女和男)的人对某项服务产品的观点(y,二水平定性变量,用1和0代表认可
多元统计分析——基于R 语言 PPT课件-聚类分析
(1)把样品粗略分成K个初始类。
(2)进行修改,逐个分派样品到其最近均值类中(通常用标准化数据或非标准化数据计算欧氏距
离)。重新计算接受新样品的类和失去样品的类的形心(均值)。
(3)重复第2步,直到各类无元素进出。
注意:
样品的最终聚类在某种程度上依赖于最初的划分或种子点的选择。
为了检验聚类的稳定性,可用一个新的初始分类重新检验整个聚类算法。如果最终分类与原来
✓有序样品的聚类:n个样品按某种原因(时间、地层深度等)排成次序,必须是
次序相邻的样品才能聚成一类。
✓分解法:首先所有的样品均在一类,然后用某种最优准则将它分为两类,再试
图用同种准则将这两类各自分裂为两类,从中选一个使目标函数较好者,这样
由两类变成三类,如此下去,一直分裂到每类只有一个样品为止(或采用其他停
1. 可能的分类数目
′
对于有序样品,n个样品分成k类的一切可能的分法有: , =
−
−
2. 最优分割法(又称Fisher算法)
(1)定义类的直径
设某一类 是{ , +1 , … , }( > ),均值为ഥ
,ഥ
=
σ= 。
−+
(2)定义目标函数
= ≤≤ { − , − + , }
当我们要分k类时,首先找 使上式达到最小,即
(2)最长距离法: , = max{ | ∈ , ∈ },表示类 与类 最邻近的两个样本距
离。
定义
(3)类平均法: , =
σ∈ σ∈
,表示类 与类 任两个样品距离的平均。
(4)重心法: , = ഥpഥ ,表示两个重心ഥ
R语言版应用多元统计分析多元正态抽样分布
应用多元统计分析第2章 多元正态抽样分布- 1-第2章 多元正态抽样分布•在多元统计分析中,多元正态分布占有相当重要的地位。
这是因为,许多实际问题涉及到的随机向量服从正态分布或近似服从正态分布;当样本量很大时,许多统计量的极限分布往往和正态分布有关。
此外,对多元正态分布,理论与实践都比较成熟,已有一整套行之有效的统计推断方法。
•基于这些理由,我们在介绍多元统计分析的种种具体方法之前,首先介绍多元正态分布的定义、性质及多元正态分布中参数的估计问题。
多元统计分析讨论的是多变量总体。
以p个随机变量作为分量构成的向量称为p维随机向量。
如果我们同时对p个变量作一次观测,得到观测值 ,它是一个样品。
如果我们观察n次得到n 个样品品 ,而n个样品就构成一个样本。
常把n个样品排成一个n×p矩阵,称为样本数据矩阵(或样本资料阵),记为在多元统计分析理论中涉及到的向量一般都是随机向量,或是由多个随机向量构成的随机矩阵。
均值向量和协方差阵设 是一个随机向量。
称向量为随机向量X 的均值向量。
称矩阵为随机向量X 的协方差矩阵,其中 。
均值向量和协方差阵设 是另一个随机向量。
称矩阵为随机向量X 与Y 的协方差矩阵,其中均值向量和协方差阵若 为X 的协方差阵,则 称为X 的相关阵,其中若记 ,则有或均值向量和协方差阵的性质性质1.设X 和Y 是适当维数的随机向量,A和B是适当阶数的常数矩阵,则有均值向量和协方差阵的性质性质2.若X 与Y 相互独立,则 ;反之则不一定成立。
性质3.随机向量X 的协方差阵 是对称非负定矩阵。
性质4. ,其中L 为非负定矩阵,称为 的平方根矩阵,记为 ,即 。
证明 由于 ,利用实对称非负定矩阵的对角化原理,存在正交矩阵 ,使得均值向量和协方差阵的性质其中 这里 为 的特征值, 为 的与 对应的单位正交特征向量。
2.1 随机向量均值向量和协方差阵的性质性质5. ,其中A为列满秩矩阵,若 则A为非退化矩阵。
多元统计分析PPT课件
#预转化后物种数据k-均值划分
# **************************** spe.kmeans <- kmeans(spe.norm, centers=4, nstart=100) spe.kmeans
#注意:即使给定的nstart相同,每次运行上述命令,所产生的结果也不一定 #完全相同,因为每次运算设定的初始结构是随机的。 # 如果不知道多多少组,怎么办,下面SSI 图帮助你
spe.ch.ward$height <- sqrt(spe.ch.ward$height) plot(spe.ch.ward)
16
非层次聚类
• 非层次聚类(non-hierarchical clustering)是对一组对象进行简单分组的方 法,也可以表述为:在p维空间内有n个对象(点),将n个对象分为k组( 或称为聚类簇),分组的依据是尽量使组内的对象之间比组间对象之间的 相似度更高。此时用户需要自己决定分组的数量k。非层次聚类的算法首先 需要有个初始的结构,即首先将所有对象任意分为k组,然后在初始结构的 基础上进行不断替换迭代,以达到最优化的分组结果。初始结构的设定可 以依据某种理论,但大多数情况下是随机分配。通常是设定不同的初始结 构,然后通过大量的迭代以找到最佳的解决方案。
13
14
Ward最小方差聚类
15
# 计算Ward最小方差聚类 # *********************** par(mfrow=c(2,1)) spe.ch.ward <- hclust(spe.ch, method="ward") plot(spe.ch.ward)
#使用距离平方造成此聚类树上半部分过于膨胀。为了使聚类树比例看起来 #更协调而不影响结构,可以使用当前融合水平的平方根重新绘图