
第五讲-多重共线性、异方差、自相关
X5 0.55 0.18 0.36 0.45 1.00
发现: X1与X4间存在高度相关性。
3、找出最简单的回归形式
分别作Y与X1, X3 ,X2,X4,X5间的回归:
ˆ 30867 Y .64 4.576X 1
(25.58) (11.49) R2=0.8919 F=132.1 (-0.49) (1.14) R2=0.075 F=1.30
结果恰是负的。
注:除非是完全共线性,多重共线性并不意味着任何基本假设的违背。
三、多重共线性的诊断
多重共线性表现为解释变量之间具有相关关系,
所以用于多重共线性的检验方法主要是统计方法:
如判定系数检验法、逐步回归检验、方差膨胀因
子(VIF)法等。
多重共线性诊断的任务是: (1)检验多重共线性是否存在; (2)估计多重共线性的范围,即判断哪些变量之间 存在共线性。
1、用OLS法估计上述模型:
ˆ 12816 Y .44 6.213X1 0.421X 2 0.166X 3 0.098X 4 0.028X 5
(-0.91)
(8.39)
(3.32)
(-2.81)
(-1.45)
(-0.14)
R2接近于1; 给定=5%,得F临界值 F0.05(5,12)=3.11 F=137.11 > 3.11, 故认上述粮食生产的总体线性关系显著成立。 但X4 、X5 的参数未通过t检验,且符号不正确, 故解释变量间可能存在多重共线性。
另一等价的检验是:
在模型中排除某一个解释变量 X j,估计模 型;
如果拟合优度与包含X j时十分接近,则说 明X j与其它解释变量之间存在共线性。
(2)逐步回归法
以Y为被解释变量,逐个引入解释变量,构 成回归模型,进行模型估计。 根据拟合优度的变化决定新引入的变量是否 独立。
如果拟合优度变化显著,则说明新引入的变 量是一个独立解释变量;
1、第一类方法:排除引起共线性的变量
找出引起多重共线性的解释变量,将它排除出 去。
以逐步回归法得到最广泛的应用。
注意:
这时,剩余解释变量参数的经济含义和数值都 发生了变化。
2、第二类方法:差分法
时间序列数据、线性模型:将原模型变 换为差分模型: Yi=1 X1i+2 X2i++k Xki+ i 可以有效地消除原模型中的多重共线性。 一般讲,增量之间的线性关系远比总量 之间的线性关系弱得多。
X4 动力 (万千瓦) 18022 19497 20913 22950 24836 26575 28067 28708 29389 30308 31817 33802 36118 38547 42016 45208 48996 52574
农业劳动 力X5 (万人) 31645.1 31685.0 30351.5 30467.0 30870.0 31455.7 32440.5 33330.4 34186.3 34037.0 33258.2 32690.3 32334.5 32260.4 32434.9 32626.4 32911.8 32797.5
(1)解释变量x受到同一个因素的影响; 例如:政治事件对很多变量都产生影响,这些变量同时上升 或同时下降。 (2)解释变量x自己的当期和滞后期; (3)错误设定。
二、多重共线性的后果 1、完全共线性下参数估计量不存在 Y X
完全共线性指的是解释变量中 的OLS估计量为: 某个变量是其他变量的线性组 合,即c1X1+c2X2+…+ckXk=0 1 ˆ ( XX) XY 其中ci不全为0,i=1,…k β
2、判明存在多重共线性的范围
如果存在多重共线性,需进一步确定究竟由哪些 变量引起。 (1) 判定系数检验法 使模型中每一个解释变量分别以其余解释变量 为解释变量进行回归,并计算相应的拟合优度。 如果某一种回归 Xji=1X1i+2X2i+kXki 的判定系数较大,说明 X j 与其他X间存在共线性。
调用数据库E:\博士计量课程软ቤተ መጻሕፍቲ ባይዱ应用\multi
年份
粮食产量
表 4.3.3 中国粮食生产与相关投入资料 受灾面积 农业化肥施 粮食播种面 农业机械总 用量 X 1 (万公斤) 1659.8 1739.8 1775.8 1930.6 1999.3 2141.5 2357.1 2590.3 2806.1 2930.2 3151.9 3317.9 3593.7 3827.9 3980.7 4083.7 4124.3 4146.4
具体可进一步对上述回归方程作F检验: 构造如下F统计量
/ k 1 R F (k 1,n k ) F ~ 2 / (1 R j) (n k )
2 j j
式中:Rj•2为第j个解释变量对其他解释变量的回归方程
的可决系数,
若存在较强的共线性,则Rj•2较大且接近于1,这时(1Rj•2 )较小,从而Fj的值较大。 因此,给定显著性水平,计算F值,并与相应的临界值 比较,来判定是否存在相关性。
1、检验多重共线性是否存在
(1)对两个解释变量的模型,采用简单相关系数法
求出X1与X2的简单相关系数r,若|r|接近1,则说 明两变量存在较强的多重共线性。
(2)对多个解释变量的模型,采用综合统计检验法 若 在OLS法下:R2与F值较大,但t检验值较小, 说明各解释变量对Y的联合线性作用显著,但各解 释变量间存在共线性而使得它们对Y的独立作用不 能分辨,故t检验不显著。
5、结论 回归方程以Y=f(X1,X2,X3)为最优:
Y 11978 5.26X 1 0.41X 2 0.19X 3
§5.2 异方差 ( Heteroscedasticity )
R2
0.8852 0.9558
DW 1.56 2.01 1.53 1.80 1.55
0.67 5.16 0.41 3.35 0.42 3.57 0.40 3.02
-0.19 -3.57 -0.17 -3.09 -0.20 -3.47
0.9752 -0.09 -1.55 0.07 0.37 0.9775 0.9798
Y
1983 1984 1985 1986 1987 1988 1989 1990 1991 1992 1993 1994 1995 1996 1997 1998 1999 2000 (万吨) 38728 40731 37911 39151 40208 39408 40755 44624 43529 44264 45649 44510 46662 50454 49417 51230 50839 46218
3、第三类方法:减小参数估计量的方差 多重共线性的主要后果是参数估计量具有较大的 方差,所以 采取适当方法减小参数估计量的方差,虽然没有 消除模型中的多重共线性,但确能消除多重共线性 造成的后果。 例如: 增加样本容量可使参数估计量的方差减小。
六、案例——中国粮食生产函数
根据理论和经验分析,影响粮食生产(Y)的 主要因素有: 农业化肥施用量(X1);粮食播种面积(X2) 成灾面积(X3); 农业机械总动力(X4); 农业劳动力(X5) 已知中国粮食生产的相关数据,建立中国粮食 生产函数: Y=0+1 X1 +2 X2 +3 X3 +4 X4 +5 X5 +
ˆ 33821 Y .18 0.699X 2
ˆ 37712.86 0.3549X Y 3
(1.74) (7.25) R2=0.1596 F=3.04
ˆ 31919 Y .0 0.380X 4
(17.45) (6.68) R2=0.7527 F=48.7
ˆ 28259 Y .19 2.240X 5
2、检验简单相关系数 列出X1,X2,X3,X4,X5的相关系数矩阵:
X1 X2 X3 X4 X5
X1 1.00 0.01 0.64 0.96 0.55
X2 0.01 1.00 -0.45 -0.04 0.18
X3 0.64 -0.45 1.00 0.69 0.36
X4 0.96 -0.04 0.69 1.00 0.45
(-1.04) (2.66) R2=0.3064 F=7.07
可见,应选第1个式子为初始的回归模型。
4、逐步回归 将其他解释变量分别导入上述初始回归模型,寻 找最佳回归方程。
Y=f(X1) t值 Y=f(X1,X2) t值 Y=f(X1,X2,X3) t值 Y=f(X1,X2,X3,X4) t值 Y=f(X1,X3,X4,X5) t值 C 30868 25.58 -43871 -3.02 -11978 0.85 -13056 -0.97 -12690 -0.87 X1 4.23 11.49 4.65 18.47 5.26 19.6 6.17 9.61 5.22 17.85 X2 X3 X4 X5
X2 积 (千公顷) 114047 112884 108845 110933 111268 110123 112205 113466 112314 110560 110509 109544 110060 112548 112912 113787 113161 108463
X3
(公顷) 16209.3 15264.0 22705.3 23656.0 20392.7 23944.7 24448.7 17819.3 27814.0 25894.7 23133.0 31383.0 22267.0 21233.0 30309.0 25181.0 26731.0 34374.0
如果拟合优度变化很不显著,则说明新引入 的变量与其它变量之间存在共线性关系。
(3) 方差膨胀因子 ( VIF: Variance Inflation Factor ) VIF指标: VIF
(b K )
多元线性回归(共线性 异方差 自相关)
多元线性回归
南开大学商学院 周宝源
w1xi1 + w2 xi 2 + ... + wk xik = 0
a Collinearity Diagnostics
Model 1
Dimension Eigenvalue 1 2.930 2 6.971E-02 3 1.060E-04
Condition Index 1.000 6.483 166.245
Variance Proportions (Constant) X1 X2 .01 .00 .00 .98 .00 .00 .00 1.00 1.00
(二)原因
1、经济变量的惯性 、 2、模型设定偏琦:省略解释变量的影响 、模型设定偏琦: 3、模型设定偏琦:错误的函数形式的影响 、模型设定偏琦: 4、滞后效应 、 5、其他原因 、
二、自相关主要后果
很可能高估R 很可能高估 2。 t-检验与 检验结果都变得无效。 检验与F-检验结果都变得无效 检验与 检验结果都变得无效。 其他
a. Predictors: (Constant), X b. Dependent Variable: Y
结
束
例:变量X、Y的部分 变量 、 的部分 数据如右表所示。 数据如右表所示。 下面运用图示法进行 分析模型是否存在严 重的异方差现象。 重的异方差现象。
从Analyze → Regression → Linear 打开 Linear 线性回归主对话框 将自变量与因变量分别选入相应框中。 点击“Plot”按钮,在新打开的对话框中将 将“DEPENDNT”选入“X”框中,将“*ZRESID” “*ZRESID”选入“Y”框中. 点击“Continue” 点击“OK”
计量经济学第五章
Variables-Likelihood Ratio • 出现对话框时,写入删除变量名--OK • 对比删除前后的AIC与SC信息值,信息
值小的结论是应采纳的。
9
用Eviews的误设定检验3
• 第一,估计出简单(单纯)方程 • 第二,在命令窗口上写入genr v_hat=resid 或者 Procs/Generate Series中 v_hat=resid 发现 v_hat • 第三,估计出新的回归方程
无约束模型(U)
有约束模型(K) (general to simple)
计算统计量F
F=(RSSK-RSSu)/J RSSu/(n-k-1)
~F(J, n-k)
J 为表示约束条件数, K 为表示自变量数 或者 应估计的参数数, n 为表示样本数(obs)
4
2. LM检验(Lagrange Multiplier
多重共线性多出现在横截面资料上。
16
三、异方差性的检验及对策
Var(ℇi)≠Var(ℇj) (i≠j)时, ℇi中存在异方差性(Herteroskedasticity)。 即随机项中包含着对因变量的影响因素。 异方差性多发生在横截面资料上。
17
异方差性的检验
1.图示检验法 如模型为Yi=0+1X1i+2X2i+…+ℇi 时,
7
用Eviews的误设定检验1
• 首先估计出简单(单纯)方程 • View/Coefficient Tests/Omitted
Variables-Likelihood Ratio • 出现对话框时,写入新变量名 OK • 检验结果出现在上端,如果P值很小时, 拒
多重共线性-异方差-内生性-自相关总结对照表
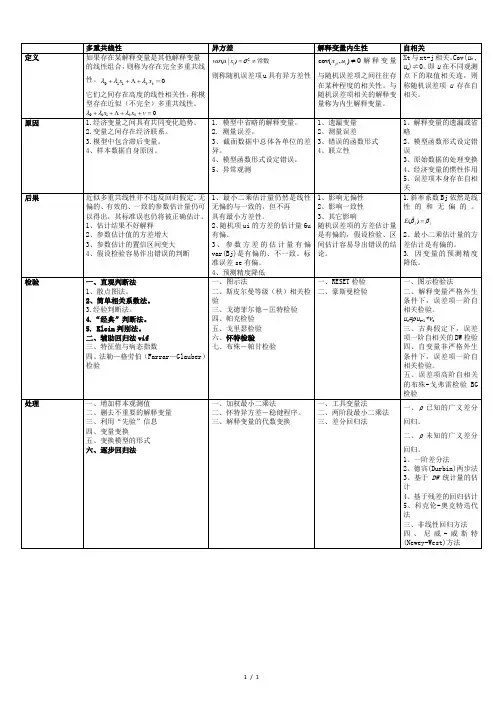
六、怀特检验
七、布殊-帕甘检验
一、RESET检验
二、豪斯曼检验
一、图示检验法
二、解释变量严格外生条件下,误差项一阶自相关检验。
ut=ut-1+vt
三、古典假定下,误差项一阶自相关的DW检验
四、自变量非严格外生条件下,误差项一阶自相关检验。
五、误差项高阶自相关的布殊-戈弗雷检验BG检验
处理
3.因变量的预测精度降低。
检验
一、直观判断法
1、散点图法。
2、简单相关系数法。
3.经验判断法。
4.“经典”判断法。
5. Klein判别法。
二、辅助回归法vif
三、特征值与病态指数
四、法勒—格劳伯(Farrar—Glauber)检验
一、图示法
二、斯皮尔曼等级(秩)相关检验
三、戈德菲尔德-匡特检验
四、帕克检验
3、基于DW统计量的估计
4、基于残差的回归估计
5、科克伦-奥克特迭代法
三、非线性回归方法
四、尼威-威斯特(Newey-West)方法
3、原始数据的处理变换
4、经济变量的惯性作用
5、误差项本身存在自相关
后果
近似多重共线性并不违反回归假定。无偏的、有效的、一致的参数估计量仍可以得出,其标准误也仍将被正确估计。
1、估计结果不好解释
2、参数估计值的方差增大
3、参数估计的置信区间变大
4、假设检验容易作出错误的判断
1、最小二乘估计量仍然是线性无偏的与一致的,但不再
一、增加样本观测值
二、删去不重要的解释变量
三、利用“先验”信息
四、变量变换
五、变换模型的形式
六、逐步回归法
一、加权最小二乘法
异方差、自相关、多重共线性比较(计量经济学)

BG检验
基于所分析模型普通最小二乘估计的残差贵解释变量和一定数量滞后残差的辅助回归,如果滞后残差足以解释当前残差的差异,就拒绝误差项无自相关的原假设。
1.用OLS估计原模型式,并得到残差e.
2.用残差e对解释变量X及滞后残差e(-1)做辅助回归。
3.计算辅助回归的可决系数R^2,构建统计量LM=TR^2。LM=TR^2~χ²
2.构造子样本区间,建立回归模型。在sample菜单里定义区间,然后用OLS方法回归,分别得到残差平方和 和 。
3.求F统计量值。F
4.判断。比较F与
的大小,判断模型是否存在异方差。
White检验
基本思想:
如果存在异方差,其方差δ^2与解释变量有关系,分析δ^2是否与解释变量有某些形式的联系以判断异方差。
注意:较高的简单相关系数师多重共线性的充分条件而不是必要条件。特别师在多于两个解释变量的回归模型中,有时较低的简单相关系数也可能存在多重共线性。
方差扩大(膨胀)因子检验
多元线性回归模型,构造辅助回归。方差扩大因子VIF=1/(1-R^2),它的大小反映了解释变量之间是否存在多重共线性。VIF越大,多重共线性越严重。
各种序列相关检验方法比较
检验方法
操作思想
操作步骤
适用性
软件操作
图示法
对给定的回归模型直接用普通最小二乘法估计其参数,求出残差项e,以e作为随机项u的估计值,再描绘e的散点图,根据散点图来判断e的相关性。
两种方法:1.绘制e(-1)和e的散点图。用(e(-1),e)作为散布点绘图,若多数点落在一三象限,表明随即误差项u存在正自相关。否则,u存在负自相关。
2.Quick/graph,在series list对话框中输入“e(-1) e”,选择scatter’,得到e(-1)与e的散点图。
第5章 异方差性
5、计算统计量:
RSS2
F
nc ( k 1) nc nc 2 ~ F( k 1, k 1) RSS1 2 2 nc ( k 1) 2
6、在给定的显著性水平下比较判断。
注意: (1) 当模型含有多个解释变量时,应以每一个解释变 量为基准检验异方差。 (2)对于截面样本,计算F统计量之前,必须先把数据 按解释变量的值从小到大排序。 (3)G—Q检验仅适用于检验递增或递减型异方差。 (4)检验结果与数据剔除个数c的选取有关。 (5) G—Q检验无法判定异方差的具体形式。
5.2异方差性的后果
5.2.1对模型参数估计值无偏性的影响
以简单线性回归模型为例,对模型 yt = b0 + b1 xt + ut ˆ 当Var(ut) = t 2,为异方差时,以 b1 为例:
ˆ b1
k
t
yt b1 kt ut
ˆ E (b1 ) E (b1 kt ut ) b1
划分方法是: 把成对(组)的观测值按解释变量的大小顺序排列, 略去c个处于中心位置的观测值 (通常n 30时,取c n/ 4), 余下的n- c个观测值自然分成容量相等,(n- c) / 2的两 个子样本。
{x1, x2, …, xt-1, xt, xt+1, …, x n-1, xn}
n1 = (n-c) / 2
5.2.3对模型参数估计值显著性检验的影响
ee ˆ 并非随机误差项 在异方差情况下, n k 1 方差的无偏估计量。
2
ˆ 导致在此基础上估计的 s ( b j ) 也出现偏误。
ˆ bj 而变量的显著性检验中,构造了t统计量 t ˆ s(b j )
变量的显著性检验失去意义。
计量经济学重点整理
一、含义:多重共线性:对于解释变量 ,如果存在不全为0的数 ,使得 则称解释变量 之间存在着完全的多重共线性。
或者 异方差性:如果对于模型中随机误差项Ui 有: 则称Ui 具有异方差性。
自相关:是指总体回归模型的随机误差项之间存在相关关系。
即不同观测点上的误差项彼此相关。
可以表示为:造成的后果:不完全的多重共线性:(1)OLS 估计量仍保持BLUE 的性质(2)假设检验容易作出错误的判断(3)可能造成可决系数较高,但对各个参数单独的 t 检验却可能不显著,甚至可能使估计的回归系数符号相反,得出完全错误的结论。
异方差性和自相关:(1)OLS 估计量仍然是线性无偏的,但不再是有效的,即方差不再是最小的。
(2) T 检验和F 检验失效。
检验方法:多重共线性:(1)简单相关系数检验法(如果每两个解释变量的简单相关系数比较高,如果大于0.8则可以认为存在着严重的多重共线性.但此种方法只是充分条件而不是必要条件,也需要同时检查偏相关系数) (2)方差扩大(膨胀)因子法(3)直观判断法(当增加一个或者剔除一个解释变量改变一个观测值时,回归参数的估计值发生较大变化;从定性分析一些重要的解释变量的回归系数的标准误差较大,在回归方程没有通过显著性检验;有些解释变量回归系数所带正负号与定性结果违背时;相关矩阵种自变量之间的相关系数较大时都可能存在多重共线性一些重要的解释变量在回归方程中没有通过显著性检验,同时R2很高(或F 检验显著),即t 检验和F 检验的结果相矛盾,或解释变量的回归系数所带正负号与定性分析结果违背时,模型可能存在严重的多重共线性。
(4)逐步回归法。
异方差性:(1)图示检验法(2)Goldfeld-Quanadt 检验作用:检验递增性(或递减性)异方差。
(3)White 检验检验步骤1)提出假设2)构造辅助回归方程 3)构造统计量并计算统计量的值,构造并计算统计量nR ²。
R ²为辅助回归的可决系数,n 为样本容量。
多重共线性、异方差、自相关的检测与模型修正
多重共线性、异方差、自相关的检测与模型修正从《国家统计数据库》找到了自1978—2008年我国人均居民消费、人均国内生产总值、居民消费价格指数、前期人均居民消费、城镇居民人均可支配收入以及农村居民人均纯收入的官方数据。
以此来分析我国人均消费的影响因素以及它们具体是如何对消费产生影响的。
1978—2008年我国人均消费及其影响因素相关数据城镇居民农村居民人均居民人均国内居民消费前期人均年份人均可支人均纯收消费生产总值价格指数居民消费配收入入343 134 1978 184 381 100.7 165405 160 1979 208 419 101.9 184477 191 1980 238 463 107.5 208501 223 1981 264 492 102.5 238535 270 1982 288 528 102 264564 310 1983 316 583 102 288652 355 1984 361 695 102.7 316739 398 1985 446 858 109.3 361901 424 1986 497 963 106.5 4461002 463 1987 565 1112 107.3 4971180 545 1988 714 1366 111.8 5651373 602 1989 788 1519 118 7141510 686 1990 833 1644 103.1 7881701 709 1991 932 1893 103.4 8332027 784 1992 1116 2311 106.4 9322577 922 1993 1393 2998 114.7 11163496 1221 1994 1833 4044 124.1 13934283 1578 1995 2355 5046 117.1 18334839 1926 1996 2789 5846 108.3 23555160 2090 1997 3002 6420 102.8 27895425 2162 1998 3159 6796 99.2 30025854 2210 1999 3346 7159 98.6 31596280 2253 2000 3631 7858 100.4 33466859 2366 2001 3886 8622 100.7 36317703 2476 2002 4143 9398 99.2 38868472 2622 2003 4474 10542 101.2 41439422 2936 2004 5031 12336 103.9 447410493 3255 2005 5572 14053 101.8 503111759 3587 2006 6263 16165 101.5 557213786 4140 2007 7255 19524 104.8 626315781 4761 2008 8348 23648 105.9 7255来自《国家统计数据库》设定如下形式的计量经济模型1:=++++ Y,X,,,X,Xi33i24124其中,Y为人均居民消费 , X2为人均国内生产总值 , X3为居民消费价格指数 , X4为前期人均消费。
第二部分 异方差性、多重共线性和自相关
Ch5 双变量回归的区间估计与假设检验 (Interval estimation and hypothesis test) 第三章的OLS 得到如下模型:1224.45450.5091i i iY X X ββ∧∧=+=+上述模型中(MPC)2β∧=0.5091,与2β的差距有多大?(虽然E(2β∧)=2β)。
寻找δ和α(0<α<1)使随机区间(2β∧-δ,2β∧+δ)包含2β的概率为1-α 一、区间估计我们是否能找到一个区间,使其包含真值。
22222()1(,)P βδββδαβδβδ∧∧∧∧-≤≤+=--+为置信区间*置信区间是随机的。
二、12ββ和的置信区间2β的置信区间:222~(,())N V a r βββ∧∧222~(0,1)()z N se ββσβ∧∧-==因σ未知,则:22222()tseββσβββσ∧∧∧∧--===~遵循自由度为n-2的t分布。
用t分布建立2β的置信区间22()1p t t tααα-≤≤=-给定α,可以确定一个临界值2tα,t在此区间[-2tα,2tα]的概率为1-α。
22222()1()p t tseααββαβ∧∧--≤≤=-2222222222(()())1100(1)()p t se t set seαααβββββαβαββ∧∧∧∧∧⇒-≤≤+=-⇒-±2的置信区间为:同理可推出1β的置信区间:112()t seαββ∧∧±注:置信区间宽度的决定因素:22()t se αβ∧(==)在支出一收入一例中220.5091,()0.0357,8.5%se df ββα∧∧====取22.306t α=则;2(0.5091 2.3060.03570.5091 2.3060.0357)15%p β-⨯≤≤+⨯=-2(0.42680.5914)95%p β≤≤=解释:从长远看,在类似于(0.4268,0.5914)的每100个区间,将有95个包含真实的2β值。
第五讲-多重共线性、异方差、自相关
根据理论和经验分析,影响粮食生产(Y)的 主要因素有:
农业化肥施用量(X1);粮食播种面积(X2)
成灾面积(X3);
农业机械总动力(X4);
农业劳动力(X5)
已知中国粮食生产的相关数据,建立中国粮食 生产函数:
Y=0+1 X1 +2 X2 +3 X3 +4 X4 +5 X5 +
调用数据库E:\博士计量课程软件应用\multi
y (1 2 )x1
这时,只能确定综合参数1+2的估计值:
一个方程确定两个未知数,有无穷多个解。
2、近似共线性下OLS估计量非有效
近似共线性下,可以得到OLS参数估计量, 但参数估计量方差的表达式为 Cov(βˆ ) 2 (XX)1
由于(X X )1 0 ,引起主对角线元素 (X X )1较大, 使参数估计值的方差增大,OLS参数估计量非有 效。
X2 0.01
1.00 -0.45 -0.04 0.18
X3 0.64 -0.45 1.00 0.69 0.36
X4 0.96 -0.04 0.69 1.00 0.45
X5 0.55
0.18 0.36 0.45 1.00
❖ 发现: X1与X4间存在高度相关性。
3、找出最简单的回归形式
分别作Y与X1, X3 ,X2,X4,X5间的回归:
C
X1 X2 X3
X4
X5 R 2
DW
Y=f(X1)
30868 4.23
0.8852 1.56
t值
25.58 11.49
Y=f(X1,X2)
-43871 4.65 0.67
0.9558 2.01
t值
第5章、违背基本假设的问题:多重共线性、异方差和自相关
第5章、违背基本假设的问题:多重共线性、异方差和自相关回顾并再次记住最小二乘法(LS)的三个基本假设:1.y=Xβ+ε2.Rank(X)=K3.ε|X~N(0,σ2I)§1、多重共线性(multicollinearity)1、含义及后果1)完全的多重共线性如果存在完全的多重共线性(perfect multicollinearity),即在X中存在不完全为0的a i,使得a1x1+…+a K x K=0即X的列向量之间存在线性相关。
因此,有Rank(X)<K,从而|X’X|=0,即b=(X’X)-1X’y不存在,OLS失效。
也即违背了基本假设2。
例子:C=β1+β2nonlabor income + β3salary +β4income + ε2)近似共线性常见为近似共线性,即a 1x 1+…+a K x K ≈0 则有|X’X|≈0,那么(X’X)-1对角线元素较大。
由于21|[,(')]b X N X X βσ- , 21|[,(')]k k kkb X N X X βσ- ,所以b k 的方差将较大。
例子:Longley 是著名例子。
2、检验方法1)VIF 法(方差膨胀因子法,variance inflation factor )第j 个解释变量的VIF 定义为21V IF 1j jR=-此处2j R 是第j 个解释变量对其他解释变量进行回归的确定系数。
若2j R 接近于1,那么VIF 数值将较大,说明第j 个解释变量与其他解释变量之间存在线性关系。
从而,可以用VIF 来度量多重共线性的严重程度。
当2jR 大于0.9,也就是VIF 大于10时,认为自变量之间存在比较严重的多重共线性。
K 个解释变量,就有K 个VIF 。
可以计算K 个VIF 的平均值。
若大于10,认为存在比较严重的多重共线性。
VIF方法直观,但是Eviews不能直接计算VIF的数值。
需要逐个进行回归,较为麻烦。