
回归分析相关定义
回归分析是一类数学模型,特别当因变量和自变量为线性关系时,它是一种特殊的线性模型。
最简单的情形是一个自变量和一个因变量,且它们大体上有线性关系,这叫一元线性回归,即模型为Y=a+bX+ε,这里X 是自变量,Y是因变量,ε是随机误差,一般的情形,有k个自变量和一个因变量,因变量的值可以分解为两部分:一部分是由自变量的影响,即表示为自变量的函数,其中函数形式已知,但含一些未知参数;另一部分是由于其他未被考虑的因素和随机性的影响,即随机误差。
当函数形式为未知参数的线性函数时,称线性回归分析模型;当函数形式为未知参数的非线性函数时,称为非线性回归分析模型。
相关分析研究的是现象之间是否相关、相关的方向和密切程度,一般不区别自变量或因变量。
而回归分析则要分析现象之间相关的具体形式,确定其因果关系,并用数学模型来表现其具体关系。
两个变量之间到底是哪个变量受哪个变量的影响,影响程度如何,则需要通过回归分析方法来确定。
一般来说,回归分析是通过规定因变量和自变量来确定变量之间的因果关系,建立回归模型,并根据实测数据来求解模型的各个参数,然后评价回归模型是否能够很好的拟合实测数据;如果能够很好的拟合,则可以根据自变量作进一步预测。
R2又称为方程的确定性系数(coefficient of determination),表示方程中变量X对Y的解释程度。
R2取值在0到1之间,越接近1,表明方程中X对Y的解释能力越强。
通常将R2乘以100%来表示回归方程解释Y 变化的百分比。
F检验是通过方差分析表输出的,通过显著性水平(significant level)检验回归方程的线性关系是否显著。
一般来说,显著性水平在0.05以下,均有意义。
回归分析的步骤
根据预测目标,确定自变量和因变量
明确预测的具体目标,也就确定了因变量。
如预测具体目标是下一年度的销售量,那么销售量Y就是因变量。
通过市场调查和查阅资料,寻找与预测目标的相关影响因素,即自变量,并从中选出主要的影响因素。
建立回归预测模型
依据自变量和因变量的历史统计资料进行计算,在此基础上建立回归分析方程,即回归分析预测模型。
进行相关分析
回归分析是对具有因果关系的影响因素(自变量)和预测对象(因变量)所进行的数理统计分析处理。
只有当变量与因变量确实存在某种关系时,建立的回归方程才有意义。
因此,作为自变量的因素与作为因变量的
预测对象是否有关,相关程度如何,以及判断这种相关程度的把握性多大,就成为进行回归分析必须要解决的问题。
进行相关分析,一般要求出相关关系,以相关系数的大小来判断自变量和因变量的相关的程度。
检验回归预测模型,计算预测误差
回归预测模型是否可用于实际预测,取决于对回归预测模型的检验和对预测误差的计算。
回归方程只有通过各种检验,且预测误差较小,才能将回归方程作为预测模型进行预测。
计算并确定预测值
利用回归预测模型计算预测值,并对预测值进行综合分析,确定最后
的预测值。
三、一元线性回归模型
对于具有线性因果关系的两个变量,由于有随机因素的干扰,两变量的线性
关系中应包括随机误差项μ,即有:
u bx a y ++= (9—3)
对于x 某一确定的值,其对应的y 值虽有波动,但在大量观察中随机误差的
期望值为零,即()E μ=0,因而从平均意义上说,总体线性回归方程为:
()Y E Y a bX ==+ (9—4)
上式中,a 是回归直线的截距项,即X 为0时Y 的值,从数学意义上理解,它表示在没有自变量X 的影响时,其它各种因素对因变量Y 的平均影响;b 是回归系数(直线的斜率),表示自变量x 每变动一个单位时,因变量Y 平均变动b 个单位。
我们可通过样本观察值计算参数a 、b 的估计值,求得参数的估计值后,即
求得样本回归方程,用它对总体线性回归方程进行估计。
样本回归直线方程又称一元线性回归方程,其表达形式为:
x b a y ˆˆˆ+= (9-5)
式中:ˆy 表示因变量的估计值(回归理论值);ˆa
和ˆb 是待定参数a 和b 的估计值。
一元线性回归方程中的待定参数是根据样本数据资料估计确定的。
确定回归方程就是要找出a 与b 的估计值ˆa 及ˆb ,使直线ˆˆˆy a b =+总体看来与所有的散点最接近,即确定最优的ˆa
与ˆb ,统计学上常采用最小二乘法(Ordinary least squares estimation,亦称最小平方法)。
设样本回归模型为:
ˆˆi i y a bx e =++ 1, 2, , i n =L (9-6)
于是有:ˆˆˆi i i i i e y a
bx y y =--=- 从式(9-6)可以看出,ˆa
和ˆb 取不同值就有不同的样本回归直线,从而有不同的残差i e 。
为了保证残差最小,希望i e 接近于0,但由于有n 个i e ,还必须考虑总体残差最小,又因为i e 可能存在正负相互抵消,i e ∑最小不能真正表达总体残差最小的思想。
故此又想到使i e ∑最小,但使i e ∑达到最小,确定参数
估计值的计算较为复杂,最终选择普通最小二乘法确定ˆa
和ˆb ,就是估计使得所有Y 的估计值与观察值的残差平方和2
i e ∑达到最小的参数ˆa
、ˆb 即: 22)ˆˆ(min ∑∑--==i i i x b a y e Q
这就是最小二乘法的基本原理。
由于本书旨在介绍该种方法在统计中的应用,故数学推导过程省略,根据最小二乘法原理,利用微积分中求极值的方法,求得a 、b 的估计值, ⎪⎩⎪⎨⎧-=∑-∑∑∑-∑=x b y a x x n y x xy n b ˆ)(ˆ22 (9-7)
当ˆa 、ˆb 求出后,一元线性回归方程ˆˆˆy a b =+便确定了。
单次测量值x1与测定平均值之差的平方的总和,以Q 表示,Q 值越大,表示测定值之间的差异越大,用偏差平方和表征差异的优点是能充分利用测度数据所提供的信息,缺点是Q 随着测定值数目的增多而增大,为了克服这一缺点,用方差S2=Q/f 来表征差异的大小,其中f 为自由度。
如一个测定结果受多个因素影响,则总偏差平方和等于实验误差与各因素(包括固定因素与随机因素)所形成的偏差平方和之总和。
为了明确解释变量和随机误差各产生的效应是多少,统计学上把数据点与它在回归直线上相应位置的差异称残差,把每个残差的平方后加起来 称为残差平方和,它表示随机误差的效应
意义:
每一点的y 值的估计值和实际值的平方差之和称为残差平方和,而y 的实际值和平均值的平方差之和称为总平方和。
残差平方和:为了明确解释变量和随机误差各产生的效应是多少,统计学上把数据点与它在回归直线上相应位置的差异 称残差,把每个残差的平方后加起来 称为残差平方和,它表示随机误差的效应。
回归平方和
总偏差平方和=回归平方和 + 残差平方和。
残差平方和与总平方和的比值越小,判定系数 r2 的值就越大。
残差图的评价
“残差图”以回归方程的自变量为横坐标,以残差为纵坐标,将每一个自变量的残差描在该平面坐标上所形成的图形。
当描绘的点围绕残差等于0的直线上下随机散布,说明回归直线对原观测值的拟合情况良好。
否则,说明回归直线对原观测值的拟合不理想。
从“残差图”可以直观地看出残差的绝对数值都比较小,所描绘的点都在以0为横轴的直线上下随机散布,回归直线对各个观测值的拟合情况是良好的。
说明变量X与y之间有显著的线性相关关系。
Welcome !!! 欢迎您的下载,资料仅供参考!。
第七章相关与回归分析
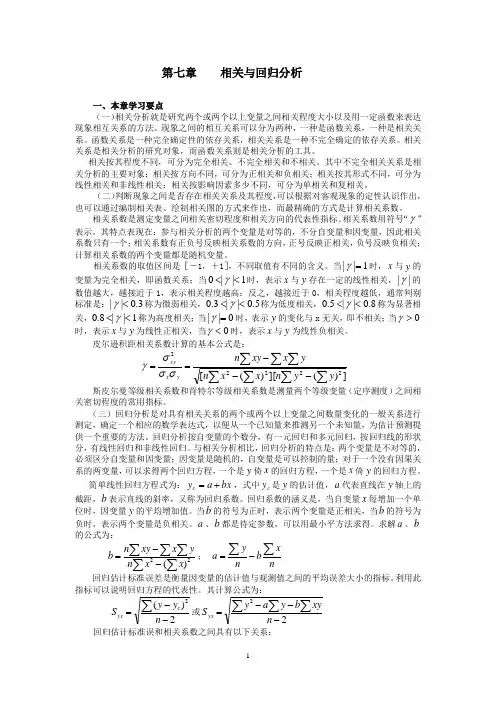
第七章 相关与回归分析一、本章学习要点(一)相关分析就是研究两个或两个以上变量之间相关程度大小以及用一定函数来表达现象相互关系的方法。
现象之间的相互关系可以分为两种,一种是函数关系,一种是相关关系。
函数关系是一种完全确定性的依存关系,相关关系是一种不完全确定的依存关系。
相关关系是相关分析的研究对象,而函数关系则是相关分析的工具。
相关按其程度不同,可分为完全相关、不完全相关和不相关。
其中不完全相关关系是相关分析的主要对象;相关按方向不同,可分为正相关和负相关;相关按其形式不同,可分为线性相关和非线性相关;相关按影响因素多少不同,可分为单相关和复相关。
(二)判断现象之间是否存在相关关系及其程度,可以根据对客观现象的定性认识作出,也可以通过编制相关表、绘制相关图的方式来作出,而最精确的方式是计算相关系数。
相关系数是测定变量之间相关密切程度和相关方向的代表性指标。
相关系数用符号“γ”表示,其特点表现在:参与相关分析的两个变量是对等的,不分自变量和因变量,因此相关系数只有一个;相关系数有正负号反映相关系数的方向,正号反映正相关,负号反映负相关;计算相关系数的两个变量都是随机变量。
相关系数的取值区间是[-1,+1],不同取值有不同的含义。
当1||=γ时,x 与y 的变量为完全相关,即函数关系;当1||0<<γ时,表示x 与y 存在一定的线性相关,||γ的数值越大,越接近于1,表示相关程度越高;反之,越接近于0,相关程度越低,通常判别标准是:3.0||<γ称为微弱相关,5.0||3.0<<γ称为低度相关,8.0||5.0<<γ称为显著相关,1||8.0<<γ称为高度相关;当0||=γ时,表示y 的变化与x 无关,即不相关;当0>γ时,表示x 与y 为线性正相关,当0<γ时,表示x 与y 为线性负相关。
皮尔逊积距相关系数计算的基本公式是: ∑∑∑∑∑∑∑---==])(][)([22222y y n x x n y x xy n y x xy σσσγ 斯皮尔曼等级相关系数和肯特尔等级相关系数是测量两个等级变量(定序测度)之间相关密切程度的常用指标。
回归系数与相关系数的关系

回归系数与相关系数的关系回归分析是一种常用的统计方法,它可以用来研究两个或多个变量之间的关系。
其中,回归系数和相关系数是回归分析中非常重要的概念,它们之间存在着密切的关系。
本文将从回归系数和相关系数的定义、计算方法以及意义等方面,探讨它们之间的关系。
一、回归系数和相关系数的定义回归系数是用来描述自变量与因变量之间关系的参数。
在一元线性回归中,回归系数通常表示为β1,它表示因变量y对自变量x的变化量,即y的平均值随着x的变化而变化的程度。
在多元回归中,回归系数通常表示为βi,表示因变量y对自变量xi的变化量,即y 的平均值随着xi的变化而变化的程度。
相关系数是用来描述两个变量之间线性相关程度的指标。
它通常用r表示,在一定程度上反映了两个变量之间的相似程度。
当r=1时,表示两个变量完全正相关;当r=-1时,表示两个变量完全负相关;当r=0时,表示两个变量之间不存在线性相关关系。
二、回归系数和相关系数的计算方法在一元线性回归中,回归系数β1的计算方法为:β1=Σ((xi- x)(yi- y))/Σ(xi- x)^2其中,x表示自变量的平均值,y表示因变量的平均值,xi和yi 分别表示第i个样本的自变量和因变量的值。
相关系数r的计算方法为:r=Σ((xi- x)(yi- y))/√(Σ(xi- x)^2Σ(yi- y)^2)在多元回归中,回归系数βi的计算方法为:βi=(XTX)^-1XTY其中,X表示自变量的矩阵,Y表示因变量的向量,T表示转置,-1表示矩阵的逆。
三、回归系数和相关系数的意义回归系数和相关系数都是用来描述两个变量之间关系的指标,但它们的意义有所不同。
回归系数描述的是因变量在自变量变化时的变化量,它可以用来预测因变量的变化情况。
例如,一个人的身高和体重之间存在一定的关系,假设我们已经建立了身高和体重之间的回归模型,其中回归系数为2.5,那么当这个人的身高增加1厘米时,他的体重预计会增加2.5公斤。
简述数学中的回归分析与相关性检验
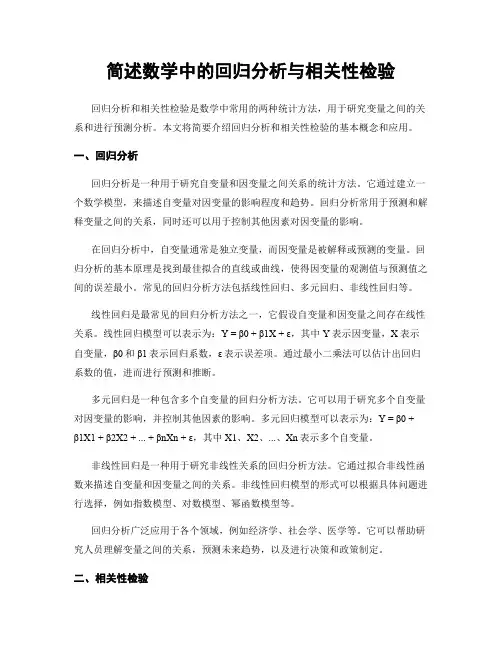
简述数学中的回归分析与相关性检验回归分析和相关性检验是数学中常用的两种统计方法,用于研究变量之间的关系和进行预测分析。
本文将简要介绍回归分析和相关性检验的基本概念和应用。
一、回归分析回归分析是一种用于研究自变量和因变量之间关系的统计方法。
它通过建立一个数学模型,来描述自变量对因变量的影响程度和趋势。
回归分析常用于预测和解释变量之间的关系,同时还可以用于控制其他因素对因变量的影响。
在回归分析中,自变量通常是独立变量,而因变量是被解释或预测的变量。
回归分析的基本原理是找到最佳拟合的直线或曲线,使得因变量的观测值与预测值之间的误差最小。
常见的回归分析方法包括线性回归、多元回归、非线性回归等。
线性回归是最常见的回归分析方法之一,它假设自变量和因变量之间存在线性关系。
线性回归模型可以表示为:Y = β0 + β1X + ε,其中Y表示因变量,X表示自变量,β0和β1表示回归系数,ε表示误差项。
通过最小二乘法可以估计出回归系数的值,进而进行预测和推断。
多元回归是一种包含多个自变量的回归分析方法。
它可以用于研究多个自变量对因变量的影响,并控制其他因素的影响。
多元回归模型可以表示为:Y = β0 + β1X1 + β2X2 + ... + βnXn + ε,其中X1、X2、...、Xn表示多个自变量。
非线性回归是一种用于研究非线性关系的回归分析方法。
它通过拟合非线性函数来描述自变量和因变量之间的关系。
非线性回归模型的形式可以根据具体问题进行选择,例如指数模型、对数模型、幂函数模型等。
回归分析广泛应用于各个领域,例如经济学、社会学、医学等。
它可以帮助研究人员理解变量之间的关系,预测未来趋势,以及进行决策和政策制定。
二、相关性检验相关性检验是一种用于判断两个变量之间关系强度和方向的统计方法。
它可以帮助研究人员确定变量之间是否存在相关性,以及相关性的程度。
常用的相关性检验方法包括皮尔逊相关系数、斯皮尔曼相关系数等。
皮尔逊相关系数用于度量两个连续变量之间的线性相关性,取值范围在-1到1之间。
相关与回归的区别与联系
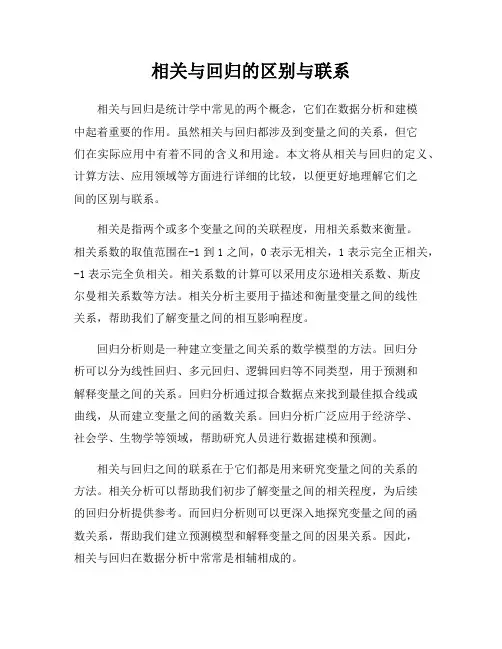
相关与回归的区别与联系相关与回归是统计学中常见的两个概念,它们在数据分析和建模中起着重要的作用。
虽然相关与回归都涉及到变量之间的关系,但它们在实际应用中有着不同的含义和用途。
本文将从相关与回归的定义、计算方法、应用领域等方面进行详细的比较,以便更好地理解它们之间的区别与联系。
相关是指两个或多个变量之间的关联程度,用相关系数来衡量。
相关系数的取值范围在-1到1之间,0表示无相关,1表示完全正相关,-1表示完全负相关。
相关系数的计算可以采用皮尔逊相关系数、斯皮尔曼相关系数等方法。
相关分析主要用于描述和衡量变量之间的线性关系,帮助我们了解变量之间的相互影响程度。
回归分析则是一种建立变量之间关系的数学模型的方法。
回归分析可以分为线性回归、多元回归、逻辑回归等不同类型,用于预测和解释变量之间的关系。
回归分析通过拟合数据点来找到最佳拟合线或曲线,从而建立变量之间的函数关系。
回归分析广泛应用于经济学、社会学、生物学等领域,帮助研究人员进行数据建模和预测。
相关与回归之间的联系在于它们都是用来研究变量之间的关系的方法。
相关分析可以帮助我们初步了解变量之间的相关程度,为后续的回归分析提供参考。
而回归分析则可以更深入地探究变量之间的函数关系,帮助我们建立预测模型和解释变量之间的因果关系。
因此,相关与回归在数据分析中常常是相辅相成的。
然而,相关与回归之间也存在一些区别。
首先,相关分析更注重描述变量之间的关系,而回归分析更注重建立变量之间的函数关系。
其次,相关系数的取值范围在-1到1之间,而回归系数则可以是任意实数。
最后,相关分析不涉及因果关系,而回归分析可以用来解释变量之间的因果关系。
综上所述,相关与回归在统计学中有着不同的含义和用途,但又有着密切的联系。
通过对相关与回归的区别与联系进行深入理解,我们可以更好地运用它们来分析数据、建立模型,为科学研究和决策提供有力支持。
希望本文能够帮助读者更好地理解相关与回归的概念和应用,提升数据分析能力和研究水平。
相关分析与回归分析的基本原理

相关分析与回归分析的基本原理1. 引言相关分析与回归分析是统计学中常用的两种数据分析方法,它们可以帮助研究者理解变量之间的关系,并根据这些关系进行预测。
本文将介绍相关分析和回归分析的基本原理,包括其定义、应用场景以及计算方法。
2. 相关分析2.1 定义相关分析是一种用来研究两个或多个变量之间关系的统计方法。
它通过计算相关系数来衡量变量之间的相关性。
相关系数的取值范围为-1到1,其中-1表示完全的负相关,1表示完全的正相关,0表示无相关关系。
2.2 应用场景相关分析可应用于许多领域,如市场研究、医学研究、金融分析等。
例如,在市场研究中,我们可以使用相关分析来研究产品销量与广告投入之间的关系,了解其相关性,并根据相关性进行决策。
2.3 计算方法计算两个变量之间的相关系数可以使用皮尔逊相关系数或斯皮尔曼相关系数。
皮尔逊相关系数适用于连续变量,而斯皮尔曼相关系数适用于有序变量或非线性关系。
3. 回归分析3.1 定义回归分析是一种用来研究变量之间关系的统计方法,其基本思想是通过构建适当的数学模型来描述一个或多个自变量对因变量的影响。
回归分析可以帮助预测未来的观察值,并理解变量之间的因果关系。
3.2 应用场景回归分析可以应用于各种预测和建模的场景。
例如,在金融领域,回归分析可以用来预测股票价格的变动,了解影响股价的各种因素,并根据这些因素进行投资决策。
3.3 计算方法回归分析通常使用最小二乘法来拟合变量间的线性关系。
在回归分析中,自变量可以是单个变量或多个变量,而因变量是需要预测或解释的变量。
通过最小化残差平方和,可以得到最佳拟合的回归模型。
4. 相关分析与回归分析的联系与区别4.1 联系相关分析和回归分析都是用来研究变量之间关系的统计方法,它们都可以帮助研究者理解变量之间的相关性和影响程度。
4.2 区别相关分析主要关注变量之间的相关性,通过计算相关系数来衡量相关性的强度和方向;而回归分析则更加关注自变量对因变量的影响程度和预测能力,适用于建立因果关系和预测模型。
相关分析和回归分析

相关分析和回归分析相关分析和回归分析是统计学中最基础的两种分析方法,它们都用于研究数据变量之间的关系。
因为它们都是研究两个变量之间关系的,所以它们常常会被混淆起来,但它们其实在原理上是不同的,有不同的应用场景。
一、相关分析相关分析是一种简单的统计分析,用来检验不同变量之间是否存在相互关系。
它可以通过计算出变量之间的相关系数,来判断变量之间是线性关系还是非线性关系。
另外,它还可以度量两个变量的线性关系的相关程度,用来度量不同变量之间的关系强度。
相关分析的应用非常广泛,它可以帮助研究者了解数据之间的关系,也可以用来预测数据的变化趋势。
比如,可以用相关分析来研究一个地区的薪水水平和就业水平之间的关系,用来预测未来就业水平和薪资水平会有怎样的变化趋势。
二、回归分析回归分析是一种统计分析,用以研究两个变量之间的数量关系,并建立起变量之间的数量模型。
它用于预测和分析数据,从而探索数据之间的关系。
比如,从客户收入、购买频率等多个因素来建立一个回归模型,从而预测客户的未来购买意愿。
回归分析也是一种非常有用的统计方法,它可以用来研究数据之间的关系,并预测数据未来的变化趋势。
另外,它还可以用来预测特定变量的值,比如预测未来股市的涨跌情况。
总结以上就是相关分析和回归分析的基本内容介绍。
相关分析用于研究数据变量之间的关系,可以帮助研究者了解数据之间的关系,并预测数据的变化趋势;而回归分析是一种统计分析,用以研究两个变量之间的数量关系,可以用来预测特定变量的值,也可以研究数据之间的关系,并预测数据未来的变化趋势。
相关分析和回归分析可以说是统计学中最基础的两种分析方法,它们都具有重要的应用价值,广泛用于各种数据分析工作。
统计学中的相关性和回归分析
统计学中的相关性和回归分析统计学中,相关性和回归分析是两个重要的概念和方法。
它们旨在揭示变量之间的关系,并可以用来预测和解释观察结果。
本文将介绍相关性和回归分析的基本原理、应用及其在实践中的意义。
一、相关性分析相关性是指一组变量之间的关联程度。
相关性分析可以帮助我们理解变量之间的关系,以及这种关系的强度和方向。
常用的相关性指标有皮尔逊相关系数、斯皮尔曼相关系数和判定系数等。
皮尔逊相关系数是最常见的衡量变量之间线性关系的指标。
它的取值范围在-1到1之间,其中-1表示完全负相关,1表示完全正相关,0表示无相关。
例如,在研究身高和体重之间的关系时,如果相关系数为0.8,则说明身高和体重呈现较强的正相关。
斯皮尔曼相关系数则不要求变量呈现线性关系,而是通过对变量的序列进行排序,从而找到它们之间的关联程度。
它的取值也在-1到1之间,含义与皮尔逊相关系数类似。
判定系数是用于衡量回归模型的拟合程度的指标。
它表示被解释变量的方差中可由回归模型解释的部分所占的比例。
判定系数的取值范围在0到1之间,越接近1表示模型对数据的拟合越好。
二、回归分析回归分析是一种用于建立变量之间关系的统计方法。
它通过建立一个数学模型来解释和预测依赖变量和自变量之间的关系。
回归模型可以是线性的,也可以是非线性的。
线性回归是最常见的回归分析方法之一。
它假设自变量和因变量之间存在着线性关系,并通过最小二乘法来估计模型中的参数。
线性回归模型通常表示为y = β0 + β1x1 + β2x2 + ... + βnxn,其中y为因变量,x1、x2等为自变量,β0、β1等为模型的参数。
非线性回归则适用于自变量和因变量之间存在非线性关系的情况。
非线性回归模型可以是多项式回归、指数回归、对数回归等。
回归分析在实践中有广泛的应用。
例如,在市场营销中,回归分析可以用来预测销售量与广告投入之间的关系;在医学研究中,回归分析可以用来探究疾病发展与遗传因素之间的联系。
薪酬数据回归分析
薪酬数据回归分析引言概述:薪酬数据回归分析是一种常用的统计方法,用于研究薪酬与其他变量之间的关系。
通过回归分析,我们可以了解薪酬与不同因素之间的相关性,从而为企业制定合理的薪酬策略提供依据。
本文将从五个方面详细阐述薪酬数据回归分析的相关内容。
正文内容:1. 薪酬数据回归分析的基本概念1.1 回归分析的定义及作用:回归分析是一种用于探究因变量与自变量之间关系的统计方法。
在薪酬数据回归分析中,我们可以通过回归模型来预测薪酬与其他因素的关系。
1.2 薪酬数据回归分析的应用场景:薪酬数据回归分析可以用于研究薪酬与员工绩效、工作经验、学历等因素之间的关系,从而为企业制定合理的薪酬政策提供依据。
2. 回归分析的前提条件2.1 线性关系假设:薪酬数据回归分析假设薪酬与其他因素之间存在线性关系,即薪酬随着其他因素的变化而线性变化。
2.2 残差的独立性:回归分析要求残差项之间相互独立,即残差项之间没有相关性。
2.3 残差的正态分布:回归分析要求残差项服从正态分布,即残差项的分布应该呈现钟形曲线。
3. 回归分析的步骤3.1 数据收集与准备:薪酬数据回归分析需要收集相关的薪酬数据以及其他自变量的数据,并对数据进行清洗和整理。
3.2 模型建立与变量选择:根据实际需求,选择适当的回归模型,并选择与薪酬相关的自变量进行建模。
3.3 参数估计与显著性检验:利用最小二乘法对回归模型进行参数估计,并进行显著性检验,判断模型的拟合程度和变量的影响力。
3.4 模型解释与预测:通过回归系数的解释,了解薪酬与自变量之间的关系,并可以利用回归模型进行薪酬的预测。
4. 回归分析结果的解释4.1 回归系数的含义:回归系数表示薪酬与自变量之间的关系强度和方向,正系数表示正相关,负系数表示负相关。
4.2 拟合优度的解释:拟合优度指标可以衡量回归模型对薪酬数据的拟合程度,值越接近1表示模型拟合效果越好。
4.3 显著性检验的解释:显著性检验可以判断回归模型中的变量是否对薪酬具有显著影响,显著性水平一般设定为0.05。
回归分析概念相关多元回归分析
回归分析概念相关多元回归分析回归分析是一种统计学方法,用于研究因变量和一个或多个自变量之间的关系。
它可以用来预测或解释因变量在自变量变化时的变化情况。
相关分析是回归分析的一种特殊情况,用于研究两个变量之间的关系。
它通过计算两个变量之间的相关系数来衡量它们的线性相关程度。
相关系数的取值范围在-1到1之间,接近1表示正相关,接近-1表示负相关,接近0表示无相关。
与相关分析相比,多元回归分析可以同时研究一个因变量和多个自变量之间的关系。
它通过拟合一个线性模型来预测或解释因变量的变化。
多元回归分析的最常见形式是多元线性回归,它可以用来研究因变量在多个自变量变化时的变化情况。
在多元回归分析中,每个自变量都有一个回归系数,代表它对因变量的影响程度。
多元回归分析需要满足一些假设,包括线性假设(因变量和自变量之间的关系是线性的)、独立性假设(观测之间是相互独立的)、等方差性假设(残差的方差是恒定的)和正态性假设(残差是正态分布的)。
如果这些假设不成立,可能需要采取一些特殊技术,如非线性回归或转换变量。
多元回归分析的步骤包括数据收集、模型建立、模型拟合和结果解释。
在数据收集阶段,需要收集因变量和自变量的数据。
在模型建立阶段,需要选择适当的自变量,并建立一个数学模型。
在模型拟合阶段,需要使用统计软件拟合模型,并计算回归系数和拟合优度。
在结果解释阶段,需要解释回归系数的含义,并进行模型的诊断和解释。
多元回归分析有很多应用领域,包括经济学、社会科学、医学等。
它可以用来预测销售额、分析市场需求、评估政策效果等。
通过多元回归分析,研究人员可以深入了解因变量与多个自变量之间的复杂关系,并得出有关预测和解释的结论。
总结起来,回归分析是一种统计学方法,用于研究变量之间的关系。
相关分析是其特殊情况,用于研究两个变量之间的关系。
多元回归分析是同时研究一个因变量和多个自变量之间的关系。
多元回归分析的步骤包括数据收集、模型建立、模型拟合和结果解释。
《回归分析 》课件
通过t检验或z检验等方法,检验模型中各个参数的显著性,以确定 哪些参数对模型有显著影响。
拟合优度检验
通过残差分析、R方值等方法,检验模型的拟合优度,以评估模型是 否能够很好地描述数据。
非线性回归模型的预测
预测的重要性
非线性回归模型的预测可以帮助我们了解未来趋势和进行 决策。
预测的步骤
线性回归模型是一种预测模型,用于描述因变 量和自变量之间的线性关系。
线性回归模型的公式
Y = β0 + β1X1 + β2X2 + ... + βpXp + ε
线性回归模型的适用范围
适用于因变量和自变量之间存在线性关系的情况。
线性回归模型的参数估计
最小二乘法
最小二乘法是一种常用的参数估计方法,通过最小化预测值与实 际值之间的平方误差来估计参数。
最大似然估计法
最大似然估计法是一种基于概率的参数估计方法,通过最大化似 然函数来估计参数。
梯度下降法
梯度下降法是一种迭代优化算法,通过不断迭代更新参数来最小 化损失函数。
线性回归模型的假设检验
线性假设检验
检验自变量与因变量之间是否存在线性关系 。
参数显著性检验
检验模型中的每个参数是否显著不为零。
残差分析
岭回归和套索回归
使用岭回归和套索回归等方法来处理多重共线性问题。
THANKS
感谢观看
04
回归分析的应用场景
经济学
研究经济指标之间的关系,如GDP与消费、 投资之间的关系。
市场营销
预测产品销量、客户行为等,帮助制定营销 策略。
生物统计学
研究生物学特征与疾病、健康状况之间的关 系。