
如何用栈实现递归与非递归的转换
如何用栈实现递归与非递归的转换(一)三种遍历树的算法递归与非递归转换的基础知识是能够正确理解三种树的遍历方法:前序,中序和后序,第一篇就是关于这三种遍历方法的递归和非递归算法。
一.为什么要学习递归与非递归的转换的实现方法?1)并不是每一门语言都支持递归的.2)有助于理解递归的本质.3)有助于理解栈,树等数据结构.二.三种遍历树的递归和非递归算法递归与非递归的转换基于以下的原理:所有的递归程序都可以用树结构表示出来.需要说明的是,这个"原理"并没有经过严格的数学证明,只是我的一个猜想,不过在至少在我遇到的例子中是适用的.学习过树结构的人都知道,有三种方法可以遍历树:前序,中序,后序.理解这三种遍历方式的递归和非递归的表达方式是能够正确实现转换的关键之处,所以我们先来谈谈这个.需要说明的是,这里以特殊的二叉树来说明,不过大多数情况下二叉树已经够用,而且理解了二叉树的遍历,其它的树遍历方式就不难了。
1)前序遍历a)递归方式:void preorder_recursive(Bitree T) /* 先序遍历二叉树的递归算法*/ {if (T) {visit(T); /* 访问当前结点*/preorder_recursive(T->lchild); /* 访问左子树*/preorder_recursive(T->rchild); /* 访问右子树*/}}b)非递归方式void preorder_nonrecursive(Bitree T) /* 先序遍历二叉树的非递归算法*/{initstack(S);push(S,T); /* 根指针进栈*/while(!stackempty(S)) {while(gettop(S,p)&&p) { /* 向左走到尽头*/visit(p); /* 每向前走一步都访问当前结点*/push(S,p->lchild);}pop(S,p);if(!stackempty(S)) { /* 向右走一步*/pop(S,p);push(S,p->rchild);}}}2)中序遍历a)递归方式void inorder_recursive(Bitree T) /* 中序遍历二叉树的递归算法*/ {if (T) {inorder_recursive(T->lchild); /* 访问左子树*/visit(T); /* 访问当前结点*/inorder_recursive(T->rchild); /* 访问右子树*/}}b)非递归方式void inorder_nonrecursive(Bitree T){initstack(S); /* 初始化栈*/push(S, T); /* 根指针入栈*/while (!stackem pty(S)) {while (gettop(S, p) && p) /* 向左走到尽头*/push(S, p->lchild);pop(S, p); /* 空指针退栈*/if (!stackem pty(S)) {pop(S, p);visit(p); /* 访问当前结点*/push(S, p->rchild); /* 向右走一步*/}}}3)后序遍历a)递归方式void postorder_recursive(Bitree T) /* 中序遍历二叉树的递归算法*/ {if (T) {postorder_recursive(T->lchild); /* 访问左子树*/postorder_recursive(T->rchild); /* 访问右子树*/visit(T); /* 访问当前结点*/}}b)非递归方式typedef struct {BTNode* ptr;enum {0,1,2} mark;} PMType; /* 有m ark域的结点指针类型*/void postorder_nonrecursive(BiTree T) /*后续遍历二叉树的非递归算法*/{PMType a;initstack(S); /* S的元素为PMType类型*/push (S,{T,0}); /* 根结点入栈*/while(!stackempty(S)) {pop(S,a);switch(a.m ark){case 0:push(S,{a.ptr,1}); /* 修改m ark域*/if(a.ptr->lchild)push(S,{a.ptr->lchild,0}); /* 访问左子树*/break;case 1:push(S,{a.ptr,2}); /* 修改m ark域*/if(a.ptr->rchild)push(S,{a.ptr->rchild,0}); /* 访问右子树*/break;case 2:visit(a.ptr); /* 访问结点*/}}}三.实现递归与非递归的换转原理和例子一)原理分析通常,一个函数在调用另一个函数之前,要作如下的事情:a)将实在参数,返回地址等信息传递给被调用函数保存; b)为被调用函数的局部变量分配存储区;c)将控制转移到被调函数的入口.从被调用函数返回调用函数之前,也要做三件事情:a)保存被调函数的计算结果;b)释放被调函数的数据区;c)依照被调函数保存的返回地址将控制转移到调用函数.所有的这些,不论是变量还是地址,本质上来说都是"数据",都是保存在系统所分配的栈中的.ok,到这里已经解决了第一个问题:递归调用时数据都是保存在栈中的,有多少个数据需要保存就要设置多少个栈,而且最重要的一点是:控制所有这些栈的栈顶指针都是相同的,否则无法实现同步.下面来解决第二个问题:在非递归中,程序如何知道到底要转移到哪个部分继续执行?回到上面说的树的三种遍历方式,抽象出来只有三种操作:访问当前结点,访问左子树,访问右子树.这三种操作的顺序不同,遍历方式也不同.如果我们再抽象一点,对这三种操作再进行一个概括,可以得到:a)访问当前结点:对目前的数据进行一些处理;b)访问左子树:变换当前的数据以进行下一次处理;c)访问右子树:再次变换当前的数据以进行下一次处理(与访问左子树所不同的方式).下面以先序遍历来说明:void preorder_recursive(Bitree T) /* 先序遍历二叉树的递归算法*/{if (T) {visit(T); /* 访问当前结点*/preorder_recursive(T->lchild); /* 访问左子树*/preorder_recursive(T->rchild); /* 访问右子树*/}}visit(T)这个操作就是对当前数据进行的处理, preorder_recursive(T->lchild)就是把当前数据变换为它的左子树,访问右子树的操作可以同样理解了.现在回到我们提出的第二个问题:如何确定转移到哪里继续执行?关键在于一下三个地方:a)确定对当前数据的访问顺序,简单一点说就是确定这个递归程序可以转换为哪种方式遍历的树结构;b)确定这个递归函数转换为递归调用树时的分支是如何划分的,即确定什么是这个递归调用树的"左子树"和"右子树"c)确定这个递归调用树何时返回,即确定什么结点是这个递归调用树的"叶子结点".二).三个例子好了上面的理论知识已经足够了,下面让我们看看几个例子,结合例子加深我们对问题的认识.即使上面的理论你没有完全明白,不要气馁,对事物的认识总是曲折的,多看多想你一定可以明白(事实上我也是花了两个星期的时间才弄得比较明白得).1)例子一:f(n) = n + 1; (n <2)= f[n/2] + f[n/4](n >= 2);这个例子相对简单一些,递归程序如下:int f_recursive(int n){int u1, u2, f;if (n < 2)f = n + 1;else {u1 = f_recursive((int)(n/2));u2 = f_recursive((int)(n/4));f = u1 * u2;}return f;}下面按照我们上面说的,确定好递归调用树的结构,这一步是最重要的.首先,什么是叶子结点,我们看到当n < 2时f = n + 1,这就是返回的语句,有人问为什么不是f = u1 * u2,这也是一个返回的语句呀?答案是:这条语句是在u1 = exmp1((int)(n/2))和u2 = exmp1((int)(n/4))之后执行的,是这两条语句的父结点. 其次,什么是当前结点,由上面的分析,f = u1 * u2即是父结点然后,顺理成章的u1 = exmp1((int)(n/2))和u2 = exmp1((int)(n/4))就分别是左子树和右子树了.最后,我们可以看到,这个递归函数可以表示成后序遍历的二叉调用树.好了,树的情况分析到这里,下面来分析一下栈的情况,看看我们要把什么数据保存在栈中:非递归程序中我们已经看到了要加入一个标志域,因此在栈中要保存这个标志域;另外,u1,u2和每次调用递归函数时的n/2和n/4参数都要保存,这样就要分别有三个栈分别保存:标志域,返回量和参数,不过我们可以做一个优化,因为在向上一层返回的时候,参数已经没有用了,而返回量也只有在向上返回时才用到,因此可以把这两个栈合为一个栈.如果对于上面的分析你没有明白,建议你根据这个递归函数写出它的递归栈的变化情况以加深理解,再次重申一点:前期对树结构和栈的分析是最重要的,如果你的程序出错,那么请返回到这一步来再次分析,最好把递归调用树和栈的变化情况都画出来,并且结合一些简单的参数来人工分析你的算法到底出错在哪里.ok,下面给出我花了两天功夫想出来的非递归程序(再次提醒你不要气馁,大家都是这么过来的).代码:int f_nonrecursive(int n){int stack[20], flag[20], cp;/* 初始化栈和栈顶指针*/cp = 0;stack[0] = n;flag[0] = 0;while (cp >= 0) {switch(flag[cp]) {case 0: /* 访问的是根结点*/if (stack[cp] >= 2) { /* 左子树入栈*/flag[cp] = 1; /* 修改标志域*/cp++;stack[cp] = (int)(stack[cp - 1] / 2);flag[cp] = 0;} else { /* 否则为叶子结点*/stack[cp] += 1;flag[cp] = 2;}break;case 1: /* 访问的是左子树*/if (stack[cp] >= 2) { /* 右子树入栈*/flag[cp] = 2; /* 修改标志域*/cp += 2;stack[cp] = (int)(stack[cp - 2] / 4);flag[cp] = 1;} else { /* 否则为叶子结点*/stack[cp] += 1;flag[cp] = 2;}break;case 2: /* */if (flag[cp - 1] == 2) { /* 当前是右子树吗? *//** 如果是右子树, 那么对某一棵子树的后序遍历已经* 结束,接下来就是对这棵子树的根结点的访问*/stack[cp - 2] = stack[cp] * stack[cp - 1];flag[cp - 2] = 2;cp = cp - 2;} else/* 否则退回到后序遍历的上一个结点*/cp--;break;}}return stack[0];}算法分析:a)flag只有三个可能值:0表示第一次访问该结点,1表示访问的是左子树,2表示已经结束了对某一棵子树的访问,可能当前结点是这棵子树的右子树,也可能是叶子结点.b)每遍历到某个结点的时候,如果这个结点满足叶子结点的条件,那么把它的flag域设为2;否则根据访问的是根结点,左子树或是右子树来设置flag域,以便决定下一次访问该节点时的程序转向.2)例子二快速排序算法递归算法如下:代码:void swap(int array[], int low, int high){int tem p;tem p = array[low];array[low] = array[high];array[high] = temp;}int partition(int array[], int low, int high){int p;p = array[low];while (low < high) {while (low < high && array[high] >= p)high--;swap(array,low,high);while (low < high && array[low] <= p)low++;swap(array,low,high);}return low;}void qsort_recursive(int array[], int low, int high)int p;if(low < high) {p = partition(array, low, high);qsort_recursive(array, low, p - 1);qsort_recursive(array, p + 1, high);}}需要说明一下快速排序的算法: partition函数根据数组中的某一个数把数组划分为两个部分,左边的部分均不大于这个数,右边的数均不小于这个数,然后再对左右两边的数组再进行划分.这里我们专注于递归与非递归的转换,partition函数在非递归函数中同样的可以调用(其实partition函数就是对当前结点的访问).再次进行递归调用树和栈的分析: 递归调用树:a)对当前结点的访问是调用partition函数;b)左子树:qsort_recursive(array, low, p - 1);c)右子树:qsort_recursive(array, p +1, high); d)叶子结点:当low < high时;e)可以看出这是一个先序调用的二叉树.栈:要保存的数据是两个表示范围的坐标.代码:void qsort_nonrecursive(int array[], int low, int high){int m[50], n[50], cp, p;/* 初始化栈和栈顶指针*/cp = 0;m[0] = low;n[0] = high;while (m[cp] < n[cp]) {while (m[cp] < n[cp]) { /* 向左走到尽头*/p = partition(array, m[cp], n[cp]); /* 对当前结点的访问*/cp++;m[cp] = m[cp - 1];n[cp] = p - 1;}/* 向右走一步*/m[cp + 1] = n[cp] + 2;n[cp + 1] = n[cp - 1];cp++;}}3)例子三阿克曼函数:代码:akm(m, n) = n + 1; (m = 0时)akm(m - 1, 1); (n = 0时)akm(m - 1, akm(m, n - 1)); (m != 0且n != 0时) 递归算法如下:int akm_recursive(int m, int n){int tem p;if (m == 0)return (n + 1);else if (n == 0)return akm_recursive(m - 1, 1);else {tem p = akm_recursive(m, n - 1);return akm_recursive(m - 1, tem p);}}这道题的难点就是确定递归调用树的情况,因为从akm函数的公式可以看到,有三个递归调用,一般而言,有几个递归调用就会有几棵递归调用的子树,不过这只是一般的情况,不一定准确,也不一定非要机械化的这么作,因为通常情况下我们可以做一些优化,省去其中的一些部分,这道题就是一个例子.递归调用树的分析:a)是当m=0时是叶子结点;b)左子树是akm(m - 1, akm(m, n - 1))调用中的akm(m, n - 1)调用,当这个调用结束得出一个值tem p时,再调用akm(m - 1, tem p),这个调用是右子树.c)从上面的分析可以看出,这个递归调用树是后序遍历的树.栈的分析:要保存的数据是m, n,当n = 0 或m = 0时开始退栈,当n = 0时把上一层栈的m值变为m - 1,n变为1,当m = 0时把上一层栈的m值变为0,n变为n + 1.从这个分析过程可以看出,我们省略了当n = 0时的akm(m - 1, 1)调用,原来在系统机械化的实现递归调用的过程中,这个调用也是一棵子树,不过经过分析,我们用修改栈中数据的方式进行了改进.代码:int akm_nonrecursive(int m, int n){int m1[50], n1[50], cp;cp = 0;m1[0] = m;n1[0] = n;do {while (m1[cp] > 0) { /* 压栈, 直到m1[cp] = 0 */while (n1[cp] > 0) { /* 压栈, 直到n1[cp] = 0 */cp++;m1[cp] = m1[cp - 1];n1[cp] = n1[cp - 1] - 1;}/* 计算akm(m - 1, 1),当n = 0时*/m1[cp] = m1[cp] - 1;n1[cp] = 1;}/* 改栈顶为akm(m - 1, n + 1),当m = 0时*/cp--;m1[cp] = m1[cp] - 1;n1[cp] = n1[cp + 1] + 1;} while (cp > 0 || m1[cp] > 0);return n1[0] + 1;}五.递归程序的分类及用途递归程序分为两类:尾部递归和非尾部递归.上面提到的几个例子都是非尾部递归,在一个选择分支中有至少一个的递归调用.相对而言,尾部递归就容易很多了,因为与非尾部递归相比,每个选择分支只有一个递归调用,我们在解决的时候就不需要使用到栈,只要循环和设置好循环体就可以了.下面再举几个尾部递归的例子吧,比较简单我就不多说什么了.1)例子一g(m, n) = 0 (m = 0, n >= 0)= g(m - 1, 2n) + n; (m > 0, n >= 0)a)递归程序int g_recursive(int m, int n){if (m == 0 && n >= 0)return 0;return (g_recurse(m - 1, 2*n) + n);}b)非递归程序int g_nonrecursive(int m, int n){int p;for (p = 0; m > 0 && n >= 0; m--, n *= 2)p += n;return p;}2)例子二f(n) = n + 1 (n = 0)= n * f(n/2) (n > 0)a)递归程序int f_recursive(int n){if (n == 0)return 1;return (n * f_recurse(n/2));}b)非递归程序int f_nonrecursive(int n){int m;for (m = 1; n > 0; n /= 2)m *= n;return m++;}分析完了递归程序的分类,让我们回头看看在向非递归转换的过程中用到了什么来实现转换:1)循环,因为程序要在某个条件下一直执行下去,要代替递归程序,循环必不可少,对于尾部递归,循环结束的条件十分容易确定,只要按照不同分支的条件写出来就可以了.而对于非尾部递归程序,循环结束的条件一般是当栈为空时或者是结束了对递归调用树的遍历从树的根结点退出时,而且有的时候写成while()的形式,有时写成do ...while的形式(如上面的akm函数),具体怎样,很难说清楚,取决于你对整个递归程序的分析。
递归函数的非递归实现

递归函数的非递归实现递归函数是一种非常常见的编程技巧,但是在某些情况下,递归函数可能会导致栈溢出等问题。
因此,我们可以通过非递归的方式来实现递归函数。
首先,我们需要了解递归函数的本质:递归函数是一种自我调用的函数,每次调用都会将当前的状态保存在栈中,并等待递归结束后依次弹出栈帧,恢复调用时的状态。
因此,非递归实现递归函数的核心思想就是利用栈来保存状态,模拟递归时的栈帧。
具体实现方法如下:1. 把递归函数中的自我调用转换为循环调用,并使用栈来保存每次调用的参数和状态。
2. 每次循环调用时,将参数和状态入栈,并更新参数和状态。
3. 循环调用结束时,从栈中弹出上一个状态,恢复参数和状态。
例如,假设我们要实现一个阶乘函数:```pythondef factorial(n):if n == 1:return 1else:return n * factorial(n-1)```我们可以使用非递归的方式来实现:```pythondef factorial(n):stack = [(n, 1)]res = 1while stack:num, acc = stack.pop()res *= accif num > 1:stack.append((num-1, num))return res```在这个实现中,我们使用栈来保存每次调用的状态,每次循环调用时,将参数和状态入栈,并更新参数和状态。
循环调用结束时,从栈中弹出上一个状态,恢复参数和状态。
最终得到阶乘的结果。
总的来说,非递归实现递归函数可以避免栈溢出等问题,同时也可以提高代码的执行效率。
但是,非递归实现递归函数可能会影响代码的可读性和维护性,需要根据具体情况进行权衡。
c语言递归函数的非递归实现

c语言递归函数的非递归实现递归函数是指在函数内部调用自身的函数,这种函数调用方式能够简化问题的表达和解决。
但是在实际编程中,递归函数可能会消耗大量的系统资源,因此有时候需要将递归函数改写为非递归形式,以减少资源消耗。
接下来将介绍如何在C 语言中实现递归函数的非递归形式。
一种常见的方法是使用栈来模拟递归函数的调用过程。
在递归函数中,每次调用都会将函数的参数、局部变量和返回地址保存在栈中,而函数执行完毕后会从栈中取出这些信息以便返回上一层调用。
因此,我们可以自己创建一个栈来模拟这个过程。
首先,我们需要定义一个结构体来表示栈的节点,包括函数的参数、局部变量和返回地址等信息。
接着,我们可以创建一个栈,用来保存这些节点。
在非递归函数中,我们首先将函数的初始参数压入栈中,然后开始一个循环,每次循环中执行函数的一次递归调用。
在调用函数时,我们将函数的参数和局部变量保存在一个节点中,然后将这个节点压入栈中。
当函数执行完毕后,我们从栈中弹出这个节点,取出其中的参数和局部变量,以便返回上一层调用。
通过这种方式,我们可以在不使用递归的情况下实现递归函数的功能。
这样一来,我们可以减少系统资源的消耗,提高程序的效率。
当然,这种方法在一些情况下可能会增加代码的复杂性,但在需要避免递归调用的情况下,这是一种可行的替代方案。
总的来说,非递归实现递归函数的方法是使用栈来模拟函数调用的过程,将函数的参数、局部变量和返回地址保存在栈中,以便在函数执行完毕后能够返回上一层调用。
通过这种方式,我们可以在不消耗过多系统资源的情况下,实现递归函数的功能。
这种方法在一些情况下可能会增加代码的复杂性,但是在需要避免递归调用的情况下,是一种有效的解决方案。
递归算法向非递归算法转换

递归算法向非递归算法转换递归算法向非递归算法转换递归算法实际上是一种分而治之的方法,它把复杂问题分解为简单问题来求解。
对于某些复杂问题(例如hanio塔问题),递归算法是一种自然且合乎逻辑的解决问题的方式,但是递归算法的执行效率通常比较差。
因此,在求解某些问题时,常采用递归算法来分析问题,用非递归算法来求解问题;另外,有些程序设计语言不支持递归,这就需要把递归算法转换为非递归算法。
将递归算法转换为非递归算法有两种方法,一种是直接求值,不需要回溯;另一种是不能直接求值,需要回溯。
前者使用一些变量保存中间结果,称为直接转换法;后者使用栈保存中间结果,称为间接转换法,下面分别讨论这两种方法。
1. 直接转换法直接转换法通常用来消除尾递归和单向递归,将递归结构用循环结构来替代。
尾递归是指在递归算法中,递归调用语句只有一个,而且是处在算法的最后。
例如求阶乘的递归算法:long fact(int n){if (n==0) return 1;else return n*fact(n-1);}当递归调用返回时,是返回到上一层递归调用的下一条语句,而这个返回位置正好是算法的结束处,所以,不必利用栈来保存返回信息。
对于尾递归形式的递归算法,可以利用循环结构来替代。
例如求阶乘的递归算法可以写成如下循环结构的非递归算法:long fact(int n){int s=0;for (int i=1; i<=n;i++)s=s*i; //用s保存中间结果return s;}单向递归是指递归算法中虽然有多处递归调用语句,但各递归调用语句的参数之间没有关系,并且这些递归调用语句都处在递归算法的最后。
显然,尾递归是单向递归的特例。
例如求斐波那契数列的递归算法如下:int f(int n){if (n= =1 | | n= =0) return 1;else return f(n-1)+f(n-2);}对于单向递归,可以设置一些变量保存中间结构,将递归结构用循环结构来替代。
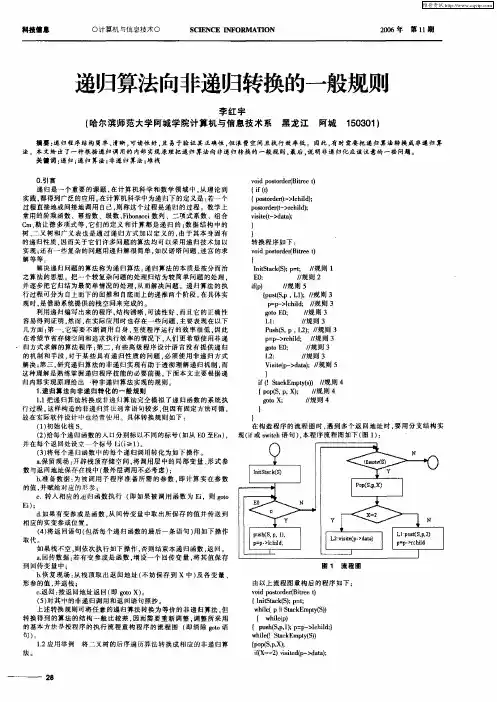
递归算法向非递归转换的一般规则
科技信息
0计算机与信 息技术0
S IN E IF R TO CE C O MA I N N
20 年 06
第 l 期 l
递归算法向非递归转换的一般规则
李 红字
( 尔滨 师范 大学 阿城 学院计 算 机与信 息技 术 系 黑 龙江 阿城 哈
100 ) 5 3 1
摘要 : 归程序结构简单、 递 清晰, 可读性 好 , 易于验证其 正确性 。 浪费空问且执行效率低 。因此 , 且 但 有时需要 把递归算法转换成非递归算 法。本文培 出了一种根据递归调 用的内部 实现原理把递归算法向非递归转换的一般规则。 最后 , 明非递归化 应谊注意的一些问题 。 说
关键பைடு நூலகம்词 : 归 ; 归 算 法 ; 递 递 非递 归 算 法 ; 栈 堆
vi ot dr ie o p s re( t et d o Br ) 递归是一个重要 的课题 。 在计算机科学 和数学领域 中 , 从理论到 {f( i0 实践 , 都得到广泛的应用 。 在计算机科学中为递 归下 的定义是 : 若一个 { otre( >ci ) ps d r- l l ; o t h d 过 程 直 接 地 或 间接 地 调 用 自 己 , 称 这 个 过 程是 递 归 的 过 程 。数 学 上 则 p s re( >c i ) ot dr - rhl ; o t d 常 用 的 阶乘 函数 、幂 指 数 、级 数 、io ac 数 列 、= 项 式 系 数 、组 合 Fb nci vset> aa; it( dt) i - C 勒 让 德 多 项 式 等 。 们 的 定 义 和计 算 都 是 递 归 的 : 据 结 构 中的 m、 它 数 】 树、 二叉树和广义表也是通 过递归方式加 以定义的 。 由于其本身 固有 } 的 递 归性 质 , 而关 于 它 们 许 多 问 题 的算 法 均 可 以 采 用 递 归 技 术 加 以 因 转换 程 序 如下 : 实 现 ; 有一 些 复杂 的 问题 用 递 归 解 很 简 单 , 汉 诺 塔 问题 、 宫 的求 还 如 迷 vi otre(ie odp s d r t et o Br ) 解等等。 { 解 决 递 归 问题 的算 法 称 为 递 归 算 法 。 归 算 法 的本 质 是按 分 而治 递 Ii tc()p t / 则 1 nt akS; -; / S 规 之算法的思想 ,把一・ 个较复杂问盾的处理归结为较简单问题 的处理 , E: 0 / 则 2 / 规 并 逐 步 把 它 归结 为最 简 单 情 况 的处 理 , 而 解 决 问 题 。 递 归 算 法 的执 从 ip f) ( / 则5 / 规 行 过 程 可 分 为 自上而 下 的 回推 和 白底 而 上 的 递 推 两 个 阶段 。 具 体 实 在 {ut , L ) / 则 3 p s(P, 1;/ S 规 现时 , 是借助系统提供 的栈空 间来完成的。 p p >ci ; / 则 3 = 一 1hl d / 规 利 用 递 归 编写 出来 的程 序 , 构 清 晰 . 读 性 好 , 且 它 的正 确 性 结 可 而 gt 0 ooE ; , 则 3 , 规 容易得到证明 。 然而 , 实 际应 用 时 也 存 在 一 些 问 盾 。 要 表 现 在 以下 在 主 L: I / 则 3 / 规 P s(, L ) , 则 3 uhS P, 2; , 规 几方面 : 一, 第 它需要不 断调用 自身 , 至使程序运行 的效率很低 。 因此 p p >ci ; , 则 3 = - rhl , d 规 在希望节省存储空间和追求执行效率 的情况下 。 人们更希望使用非递 归方 式 求 解 的算 法 程 序 ; 二 , 些 高 级 程 序 设 计 语 言 没 有 提 供 递 归 第 有 gt 0 o E; o , 则3 , 规 的机制和手段 , 对于某些 具有递归性质 的问题 . 必须使 用非递归方式 L: 2 , 则3 , 规 解 决 ; 三 . 究 递 归 算 法 的非 递 归 实 现 有 助 于 透 彻 理 解 递 归 机 制 . 第 研 而 Vit(一 dt) / 则 5 sep > aa 规 i ;/ 这种理解是熟练掌握递归程序技能的必要前提。 下面本 文主要 根据递 】 归 内部 实 现 原 理 给 出 ・ 非 递 归 算 法 实 现 的 规 则 。 种 i Sak mpys / 则 4 f t E t ) / c () 规 { o(, , ) ppS P x; , 则4 , 规 1递 归 算 法 向非 递 归 转 化 的 一 般 规 则 . 11 递 归算 法 转 换 成 非 递 归 算 法 完 全 模 拟 了递 归 函数 的 系 统执 .把 gt oox: / 则4 / 规 行 过程。 这样构造 的非递归算法通常语句较多 . 但因有固定方法可循 。 】 故在实际软件设计 中也经常他用 。具体转换规则如下 : 】 ( ) 始 化 栈 S 1初 。 在 构 造 程 序 的 流 程 图时 , 到 多 个 返 回 地 址 时 。 用 分 支 结 构 实 遇 要 () 2 给每个递归函数的人 口分别标 以不 同的标号 ( 如从 E O至E ) 现 ( 或 s i h n, i wt 语句 )本程序流程 图如下 ( 1 : f c , 图 ) 并 在 每 个 返 回 处设 立 一 个 标 号 “(≥ 1 。 i ) () 3 将每个递归函数 中的每个递 归调用转化为如下操作。 a保 留 现 场 ; 辟 栈 顶 存 储 空 间 。 调用 层 中 的 局 部 变 量 、 式 参 . 开 将 形 数 与返 回地 址 保 存 在栈 中 ( 外层 调 用不 必 考 虑 ) 最 ; b准备 数据 : . 为被调用子 程序准备 所需的参 数 . 即计算实在参 数 的值 , 赋 给 对 应 的 形 参 : 并 c 转 入相 应 的进 归 函 数 执 行 ( . 即如 果 被 调 用 函数 为 E .则 gt i oo
从递归算法到非递归的变换
Ab t a t: s r c Thi p r ma s a s ud r o ys f r t a s o m i e ur i e a g ihms t on r — s pa e ke t y ofva i us wa o r n f r ng r c s v l ort o n — e c s v l rt m s, ur i e a go ih whih h l o i c e s he e fc e c o o a mi c e p t n r a e t fi i n y f r pr gr m ng.A fe tv o u i n o t e e f c i e s l to t h
Ke r s:e ur i e; t c c i ls ; na y—r e y wo d r c sv s a k; ha n—it bi r t e
一
般 而 言 , 归 算 法 与 实 际 问 题 的 表 达 相 近 , 别 符 合 人 们 的 思 维 习 惯 , 多 数 学 函 数 也 是 用 递 归 来 表 达 , 具 有 简 递 特 许 它
归或间 接递归.
鉴 于 上 述 多 方 面 的 原 因 , 握 递 归 算 法 的 非 递 归 实 现 , 有 利 于 程 序 的移 植 性 , 时 对 初 学 者 来 说 , 有 效 地 培 养 、 掌 将 同 将
提高其算 法设计能 力.
1 递 归 算 法 的 非 递 归 实 现
下 面 将 用 栈 、 环 迭 代 等 方 法 来 实 现 非 递 归 化 , 法 均 以类 P sa 进 行 描 述 . 循 算 acl 1 1 用 迭 代 来 实 现 递 归 的 非 递 归 化 .
从 递 归 算 法 到 非 递 归 的变 换
算法设计中递归转为非递归探讨

对于递归函数而言, 若某条赋值语句中包含 两处或多处递归调用 ( 假设为 n 处) , 则应首先把 它拆成 n 条赋值语句, 使得每条赋值语句只包含 一处递归调用, 同时对增加的 n- 1 条赋值语句, 要增设 n- 1 个局部变量, 然后按以上六条规则转 换成非递归函数。
a [ top] : = n; n: = n- 1; { 实参减 1}
goto 1; { 转向开 始, 继 续}
end ; 2: f1: = n* f1; { 根据 n 和 f ( n- 1) , 求 f ( n) } 3: if top> 0 then begin n: = a [ top] ; { 做返回处理}
设 P 是一个递归算法, 假定 P 中共有 m 个值 参和局部变量, 共有 t 处递归调用 P 的语句, 则 把 P 改写成一个非递归算法的一般规则为:
定义一个栈 S, 用来保存每次递归调用前值参 和局部变量的当前值以及调用后的返回地址。即 S 应该含有 m+ 1 个域, 且 S 的深度必须足够大, 使 得递归过程中不会发生栈溢出。
[ 收稿日期] 2005- 07- 04 [ 作者简介] 廖慧芳, 女, 助教, 研究方向: 计算机算法设计。
2005 年第 4 期
九江学院学报 ( 自然科学版)
15
( n) 时, 系统首先为后面的递归调用建立一 个含 有 3 个域 ( 值参 n, 局部变量 k 和一个返回地址) 的栈; 在每次执行递归调用 tran ( n) 前, 系统自 动把 n 和 k 的当前值以及 write ( k: 1) 语句 的开 始位置 ( 即调用结束后的返回地址) 压栈; 在每 次执行到最后的 end 语句 ( 即一次递归调用结束) 后, 又自动把栈顶的与 n 和 k 对应的值分别赋给 n 和 k ( 出栈) , 接着无条件转向 write ( k: 1) 语句 的开始位置继续向下执行程序。 3 递归的缺点
二叉树的递归及非递归的遍历及其应用
二叉树的递归及非递归的遍历及其应用二叉树是一种常见的数据结构,由节点和边组成,每个节点最多有两个子节点,分别称为左子节点和右子节点。
递归和非递归是两种遍历二叉树的方法,递归是通过递归函数实现,而非递归则利用栈的数据结构来实现。
二叉树的遍历是指按照一定的顺序访问二叉树中的每个节点。
常见的遍历方式有前序遍历、中序遍历和后序遍历。
1.前序遍历(Preorder Traversal):在前序遍历中,首先访问根节点,然后递归地遍历左子树和右子树。
遍历顺序为:根节点-左子树-右子树。
2.中序遍历(Inorder Traversal):在中序遍历中,首先递归地遍历左子树,然后访问根节点,最后递归地遍历右子树。
遍历顺序为:左子树-根节点-右子树。
3.后序遍历(Postorder Traversal):在后序遍历中,首先递归地遍历左子树和右子树,最后访问根节点。
遍历顺序为:左子树-右子树-根节点。
递归遍历方法的实现相对简单,但可能存在性能问题,因为递归调用会导致函数的调用和返回开销,尤其是在处理大规模二叉树时。
而非递归遍历方法则能够通过利用栈的特性,在迭代过程中模拟函数调用栈,避免了函数调用的性能开销。
非递归遍历二叉树的方法通常利用栈来实现。
遍历过程中,将节点按照遍历顺序入栈,然后访问栈顶元素,并将其出栈。
对于前序遍历和中序遍历,入栈顺序不同,而对于后序遍历,需要维护一个已访问标记来标识节点是否已访问过。
以下是非递归遍历二叉树的示例代码(以前序遍历为例):```pythonclass TreeNode:def __init__(self, val=0, left=None, right=None):self.val = valself.left = leftself.right = rightdef preorderTraversal(root): if not root:return []stack = []result = []stack.append(root)while stack:node = stack.pop()result.append(node.val)if node.right:stack.append(node.right)if node.left:stack.append(node.left)return result```在实际应用中,二叉树的遍历方法有很多应用。
递归算法转换为非递归算法
递归算法转换为非递归算法想象一下,递归就像是你的好朋友,老是在你耳边叨叨,告诉你:“再来一次,再来一次。
”而非递归就像是那个实在的家伙,给你一份清晰的计划,告诉你该干嘛。
用非递归的方式,咱们就能更好地控制进度,不会再像在黑暗中摸索,而是一步步地稳稳前进。
说到这里,有的人可能会问:“非递归的难度是不是太高了?”其实呢,非递归并没有想象中那么复杂,特别是如果你能掌握一些基本的技巧,就像玩拼图一样,轻松上手。
举个例子,大家都知道计算斐波那契数列吧。
那种用递归的方式计算,简直像在爬一座高山,一级一级上去,最后发现自己爬了个寂寞,特别是数字一多,简直就是给自己挖坑。
非递归的方法其实就是把这个过程变得更直白,像是在教你怎么把山坡变成一条平坦的大路。
我们可以用一个简单的循环来实现,拿着一张小纸条,把每一步都写下来。
随着每一轮的循环,数据就一点点填满,直到达成目标。
就像煮面一样,慢慢煮,耐心等待,最后面条总会熟透的。
再说个有趣的事儿,遍历树结构的时候,递归的方法就像你在给小朋友讲故事,每讲完一层就得回到上一层,像是在玩捉迷藏,兜兜转转。
可是,非递归就不一样了,咱们可以用一个栈,把要访问的节点先都存起来,等到该去的时候,再一层层取出来,就像用一根绳子把它们串起来,拉出来的时候,结果就乖乖地在眼前了。
想象一下,树上的苹果,一个一个摘下来,效率简直高得惊人,没那么多折腾。
非递归的方式往往能让代码变得更加清晰,特别是当你给别人分享你的代码时,大家都能看得明白,不会一脸懵逼。
这样的好处简直就像是给大家开了一扇窗,阳光照进来,温暖了整个房间。
哎,真的是好得不得了。
说到大家不妨试试把自己的递归代码转换成非递归,可能会觉得自己像获得了一种新技能。
学会这一招,编程之路就更加宽广了,就像是打开了一扇新天地,眼前的风景愈加美丽。
不论是递归还是非递归,各有千秋,关键是看你自己怎么用。
编程的乐趣在于探索,敢于尝试,保持好奇心,那才是最重要的!好啦,今天的分享就到这里,祝大家编程愉快,玩得开心!。
用栈实现递归
用栈实现递归
递归是一种常见的编程思想,它可以将一个问题分解为更小的问题,直到问题变得足够简单,然后再进行求解。
在递归中,函数会不断地调用自身,直到达到某个终止条件。
然而,递归也有一些缺点,例如递归调用会消耗大量的栈空间,可能导致栈溢出等问题。
因此,我们可以使用栈来模拟递归的过程,从而避免这些问题。
具体实现方法是,将递归调用中的参数和局部变量存储在一个栈中,然后循环执行以下步骤:
1. 取出栈顶元素,获取相应的参数和局部变量。
2. 判断是否达到终止条件,如果是则跳出循环。
3. 否则,执行相应的操作,并将新的参数和局部变量入栈。
通过这种方式,我们可以在不使用递归的前提下,实现递归的效果。
同时,由于我们可以控制栈的大小,因此也可以避免栈溢出等问题。
需要注意的是,在使用栈实现递归时,可能需要对程序进行一些改动,以适应栈的操作方式。
例如,可能需要将某些变量改为全局变量,以便在栈中传递。
同时,由于使用栈会增加代码的复杂度,因此也需要仔细考虑是否真的需要使用这种方法。
- 1 -。
递归与栈的转化(迷宫+n皇后+汉诺塔)
递归与栈的转化(迷宫+n皇后+汉诺塔)参考:《数据结构教程》第五版李春葆⼀,递归到⾮递归的转换1,递归的分类 递归可分为尾递归和⾮尾递归2,尾递归 ① 如果⼀个递归过程会递归函数中的递归调⽤语句是最后⼀条语句,则称这种递归调⽤为尾递归 ② ⼀般情况下,尾递归可以通过循环或者迭代⽅式转化为等价的⾮递归算法。
3,⾮尾递归 ① 对于⾮尾递归算法,在理解递归调⽤实现过程的基础上可以⽤栈来模拟递归执⾏过程。
4,总结 尾递归需要只⽤到递归函数的搜索功能,所以可以⽤循环替换; ⽽⾮尾递归除了循环部分,还⽤到了递归函数的回溯功能,所以只能⽤栈模拟。
⼆,⼀个栈帧只有⼀个递归函数的递归转化1,迷宫寻路递归:#define _CRT_SECURE_NO_WARNINGS#include<stdio.h>#include<stdlib.h>#define N 1111int n, m, cnt;int map[N][N];int dx[4] = { -1,0,1,0 }, dy[4] = { 0,1,0,-1 };struct Node{int x, y;}way[N];void show(){printf("(0,0)");for (int i = 0; i < cnt; i++)printf("->(%d,%d)", way[i].x, way[i].y);puts("");}void DFS(int a, int b){if (a == n - 1 && b == m - 1){show();return;}for (int i = 0; i < 4; i++){if (a + dx[i] < 0 || b + dy[i] < 0 || a + dx[i] >= n || b + dy[i] >= m)continue;if (map[a + dx[i]][b + dy[i]] == 0){map[a][b] = 1;way[cnt].x = a + dx[i], way[cnt].y = b + dy[i];cnt++;DFS(a + dx[i], b + dy[i]);cnt--;map[a][b] = 0;}}}int main(void){// ⼊⼝是 map[0][0], 出⼝是 map[m-1][n-1]while (scanf("%d%d", &n, &m) != EOF){for (int i = 0; i < n; i++)for (int j = 0; j < m; j++)scanf("%d", &map[i][j]);cnt = 0;DFS(0, 0);}system("pause");return0;}/*测试数据第⼀组6 50 0 1 1 10 0 0 0 11 0 1 0 11 1 1 0 11 0 1 0 0结果(0,0)->(0,1)->(1,1)->(1,2)->(1,3)->(2,3)->(3,3)->(4,3)->(5,3)->(5,4) (0,0)->(1,0)->(1,1)->(1,2)->(1,3)->(2,3)->(3,3)->(4,3)->(5,3)->(5,4)第⼆组6 50 0 1 1 10 0 0 0 11 0 1 0 11 0 1 0 11 0 1 0 11 0 0 0 0结果(0,0)->(0,1)->(1,1)->(1,2)->(1,3)->(2,3)->(3,3)->(4,3)->(5,3)->(5,4) (0,0)->(0,1)->(1,1)->(2,1)->(3,1)->(4,1)->(5,1)->(5,2)->(5,3)->(5,4) (0,0)->(1,0)->(1,1)->(1,2)->(1,3)->(2,3)->(3,3)->(4,3)->(5,3)->(5,4) (0,0)->(1,0)->(1,1)->(2,1)->(3,1)->(4,1)->(5,1)->(5,2)->(5,3)->(5,4) */View Code栈:#define _CRT_SECURE_NO_WARNINGS#include<stdio.h>#include<stdlib.h>#define N 101#define MaxSize 10086int dx[] = { -1, 0, 1, 0 }, dy[] = { 0, 1, 0, -1 };int map[N][N];typedef struct Box{int x, y;int di; // 点的编号}bx;typedef Box any; // 可修改数据类型typedef struct SqStack // 顺序栈{#define MaxSize 666any a[MaxSize];int pt; // 栈顶指针SqStack() {pt = -1;}void push(any e) { // ⼊栈a[++pt] = e;}void pop() { // 出栈pt--;}any top() { // 取栈顶元素return a[pt];}bool empty() { // 判断栈是否为空return pt == -1;}int size() { // 返回栈的⼤⼩return pt + 1;}}st;void show(st s){st t;while (!s.empty()){bx v = s.top();s.pop();t.push(v);}int cnt = 0;while (!t.empty()){bx v = t.top();t.pop();if (cnt++ == 0)printf("(%d,%d)", v.x, v.y);elseprintf("->(%d,%d)", v.x, v.y);}puts("");}void dfs(int xi, int yi){st s; // 定义栈bx start = { xi,yi,0 };map[xi][yi] = -1;s.push(start); // 起点进栈int cnt = 1; // 记录路径数while (!s.empty()){// 1,取栈顶元素,相当于函数形参bx vertex = s.top();// 2,找到终点,回溯(关键点:消除搜索的痕迹)if (vertex.x == n - 1 && vertex.y == m - 1){show(s);s.pop();map[vertex.x][vertex.y] = 0;continue;}// 3,如果有路可⾛,就继续搜索int find = 0; // find = 1 表⽰下⼀步可⾛,0 表⽰下⼀步不可⾛for (int i = vertex.di; i < 4; i++){bx next{ vertex.x + dx[i], next.y = vertex.y + dy[i] ,0 };if (next.x < 0 || next.y < 0 || next.x >= n || next.y >= m)continue;if (map[next.x][next.y] == 0){find = 1;vertex.di = i + 1; // 标记这个⽅块已经⾛过的⽅向,⼿动确定回溯时不会重复回溯。