
Weka的安装配置及使用
对于一条关联规则L->R,我们常用支持度(Support)和置信度 (Confidence)来衡量它的重要性。规则的支持度是用来估计在一个 购物篮中同时观察到L和R的概率P(L,R),而规则的置信度是估计购物 栏中出现了L时也出会现R的条件概率P(R|L)。关联规则的目标一般是 产生支持度和置信度都较高的规则。 有几个类似的度量代替置信度来衡量规则的关联程度,它们分别是 Lift: P(L,R)/(P(L)P(R)) Lift=1时表示L和R独立。这个数越大,越表明L和R存在在一个购物篮 中不是偶然现象。 Leverage:P(L,R)-P(L)P(R) 它和Lift的含义差不多。Leverage=0时L和R独立,Leverage越大L和R 的关系越密切。 Conviction:P(L)P(!R)/P(L,!R) (!R表示R没有发生) Conviction也是用来衡量L和R的独立性。从它和lift的关系(对R取反, 代入Lift公式后求倒数)可以看出,我们也希望这个值越大越好。
(1)在WEKA根目录%WEKA_HOME%中新建lib目录,将 mysql的jdbc驱动 (jar包)拷贝进lib目录 (2)编辑classpath环境变量,加入驱动所在路径 (3)修改DatabaseUtils.props (4)制作weka.jar并替代原来的weka.jar
a.从命令行进入%WEKA_HOME%/weka目录 b.执行jar cvf weka.jar weka/*.* c.将%WEKA_HOME%/weka下的weka.jar复制到%WEKA_HOME%
例子: 利用C4.5决策树算法预测银行客户是否具有个人股权计划 (PEP=YES);训练数据集bank.arff;测试数据集bank-new.arff 操作: (1)训练:打开bank.arff;切换到Classify,点击Choose按钮后可以 看到很多分类或者回归的算法列在一个树型框里,树型框下方 有一个Filter …按钮,点击可以根据数据集的特性过滤掉不合适 的算法。我们数据集的输入属性中有“Binary”型和Numeric型的 属性,而Class属性是“Binary”的,于是勾选“Binary attributes”“Numeric attributes”和“Binary class”。选择“trees”下 的“J48”,这就是我们需要的C4.5算 法。
《数据挖掘:实用机器学习技术》
数据挖掘的6种任务
预处理(Preprocess) 关联规则(Associate) 分类(Classify) 回归(Regress) 聚类(Cluster) 可视化(Visualize)
(1).Weka和Myeclipse都需要Java运行环境(JRE)的支持,建 议先安装JRE ,同时配置好Java环境变量 (2).根据操作系统位数下载合适的Weka安装文件 ——32位Windows:Windows X86 ——64位Windows:Windows X64 (3).添加Weka环境变量WEKA_HOME (4).data子目录预存了数据文件
Explorer界面
(1).切换不同数据挖掘任务的面板 (2).数据源操作面板 (3).数据过滤(预处理)面板 (4).当前关系面板 (5).当前属性信息面板 (6).属性选择面板 (7).当前属性可视化面板
删除无意义的属性 属性的离散化 (1)整型的离散化:直接修改ARFF文件的属性定义 (2)浮点型的离散化:通过图形界面工具 Explorer→Preprocess→Filter→Choose→Weka.filters.unsuper vised.attribute.Discretize 实例: bank-data.arffbank-data-final.arff
1.安装WEKA 2.数据格式 3.数据预处理 4.关联规则 5.分类与回归 6.聚类 7.WEKA连接mysql数据库 8.在myeclipse中使用WEKA
定位
开源的数据挖掘平台 集合了大量能承担数据挖掘任务的机器学习算法
项目主页
书籍
/ml/weka/
分类(Classification)和回归(Regression)同在“Classify”选项 卡 。在这两个任务中,都有一个目标属性(输出变量)。 我们希望根据一个样本(WEKA中称作实例)的一组特征 (输入变量),对目标进行预测。为了实现这一目的, 我 们需要有一个训练数据集,这个数据集中每个实例的输入 和输出都是已知的。观察训练集中的实例,可以建立起预 测的模型。利用该模型预测新实例的输出变量。衡量模型 的好坏就在于预测的准确程度。 在WEKA中,待预测的目标(输出)被称作Class属性。一 般的,若Class属性是分类型时我们的任务才叫分类,Class 属性是数值型时我们的任务叫回归。
例子:用Apriori算法(weka.associations.Apriori)寻找 bankdata-final.arff(600个实例)中的关联规则 目标: 挖掘出支持度在0.1到1之间,lift值超过1.5且lift值排在前 100位的关联规则。 操作: 在Preprocess选项卡中打开bank-data-final.arff,切换至 Associate选项卡,点击choose按钮后面的文本框, lowerBoundMinSupport设为0.1,upperBoundMinSupport设 为1,metricType设为 lift,minMetric设为1.5,numRules设 为100,其他选项保持默认
例子: 用SimpleKMeans算法对bank.arff进行聚类 操作: 用“Explorer”打开 “bank.arff”,并切换到“Cluster”。点 “Choose”按钮选择 “SimpleKMeans”,这是WEKA中实现K均值 的算法。点击旁边的文本框,修改“numClusters”为6,说明我 们希望把这600条实例 聚成6类,即K=6。下面的“seed”参数是 要设置一个随机种子,依此产生一个随机数,用来得到K均值 算法中第一次给出的K个簇中心的位置,不妨暂时让它就为10。 选中“Cluster Mode”的“Use training set”,点击“Start”按钮, 观察右边“Clusterer output”给出的聚类结果。也可以在左下角 “Result list”中这次产生的结果上点右键,“View in separate window”在新窗口中浏览结果。
Weka数据的逻辑形式:二维表 Weka的数据来源
(1)ARFF文件 (2)关系数据库:mysql,sql server,oracle等
“行”的术语 数据库理论 统计学 记录 样本
“列”的术语 字段 变量
Weka
实例
属性
Weka的数据类型
numeric 数值型 nominal 分类型(枚举型) string 字符串型 Date 时间型
在myeclipse中使用WEKA是非常简单的,只需要将weka.jar 以外部jar包(external jars)的形式添加到工程的编译路径(java build path)中,即可调用weka中的类和接口。
[1]Weka基础教程V1.1(贵州大学).pdf [2]数据挖掘工具WEKA中文教程.pdf [3]Weka入门教程./91798212.html [4]在eclipse下使用java调用weka. /felomeng/article/details/4688257
我们没有专门设置检验数据集,为了保证生成的模型的准确性 而不至于出现过拟合(overfitting)的现象,我们有必要采用10 折交叉验证(10-fold cross validation)来选择和评估模型。在左 边的Test Option面板选择“Cross-validation”并在“Folds”框填上 “10”,点“Start”按钮生成决策树模型,训练结果出现在右边 的“Classifier output”中。 (2)预测:在“Test Opion”中选择“Supplied test set”,并且“Set” 成“bank-new.arff”文件。重新“Start”一次。右键点击“Result list”中刚产生的那一项,选择“Visualize classifier errors”。我们 不去管新窗口中的图有什么含义,点“Save”按钮,把结果保存 成“bank-predicted.arff”。这个ARFF文件中 就有我们需要的预测 结果。在“Explorer”的“Preprocess”选项卡中打开这个新文件, 可以看到多了一个属性 “predictedpep”。“predictedpep”就是模 型预测的结果。点“Edit”按钮可以查看这个数据集的内容。
CSV文件
为了解析更多的二维数据,WEKA提 供 了对CSV文件的 支持。CSV文件被很多“数据处理”软件支持,如EXCEL, MATLAB。
CSV转换为ARFF
图形界面方法: 通过Explorer界面的“Open file”按钮打开CSV文件,通过 “Save”按钮保存为ARFF文件,格式转换操作会由Weka 在后台自动完成。
如何使用Weka进行机器学习和数据挖掘

如何使用Weka进行机器学习和数据挖掘1. 引言机器学习和数据挖掘是当今计算机科学领域中非常热门的技术,它们的应用已经渗透到各个行业。
Weka是一个功能强大且易于使用的开源软件工具,广泛应用于机器学习和数据挖掘任务中。
本文将介绍如何使用Weka进行机器学习和数据挖掘,帮助读者快速上手。
2. 安装与配置Weka是使用Java编写的跨平台软件,可以在Windows、Linux 和Mac OS等操作系统上运行。
首先,从Weka官方网站上下载最新版本的Weka软件包。
下载完成后,按照官方提供的安装指南进行安装。
安装完成后,打开Weka软件,在"Tools"菜单下找到"Package Manager",确保所有必需的包(例如data-visualization)都已被安装。
3. 数据预处理在进行机器学习和数据挖掘任务之前,通常需要对原始数据进行预处理。
Weka提供了许多强大的工具来处理数据。
首先,可以使用Weka的数据编辑器加载并查看原始数据集。
然后,可以进行数据清洗,包括处理缺失值、异常值和重复数据等。
Weka还提供了特征选择和降维等功能,帮助提取有意义的特征。
4. 分类与回归分类和回归是机器学习中的两个重要任务。
Weka支持多种分类和回归算法,包括决策树、朴素贝叶斯、支持向量机和神经网络等。
在Weka主界面中,选择"Classify"选项卡,选择相应的算法,并配置参数。
然后,可以使用已经预处理的数据集进行模型训练和测试。
Weka提供了丰富的性能评估指标和可视化工具,帮助分析模型的效果。
5. 聚类分析聚类是一种无监督学习方法,用于将样本划分到不同的组或簇中。
Weka提供了各种聚类算法,如K均值、层次聚类和基于密度的聚类。
在Weka主界面中,选择"Cluster"选项卡,选择相应的算法,并配置参数。
然后,使用预处理的数据集进行聚类分析。
weka中安装libsvm

5.运行Runweka.bat即可
6.最后,有一个要说的事情是,如果你的weka装在C盘,在修改runweka.ini文件时会提示需要管理员身份的问题,所以,可以重新安装一下weka,不要安装在C盘。
3.将libsvm.jar文件放到weka的安装目录中,我的是D:\Program Files (x86)\Weka-3-6
4.将weka安装目录中的Runweka.ini中的
cmd_default=javaw-Dfile.encoding=#fileEncoding# -Xmx#maxheap# #javaOpts# -classpath"#wekajar#;#cp# " #mainclass#修改为
最后有一个要说的事情是如果你的weka装在c盘在修改runwekaini文件时会提示需要管理员身份的问题所以可以重新安装一下weka不要安装在c盘
Weka中安装libsvm
之前在网上试过很多种方法都失败了,后来偶然一次成功了,而且是超级简单的方的安装包,我下载的是3.20版本,找到java文件夹中的libsvm.jar
电算化常用数据挖掘与机器学习工具操作指南
电算化常用数据挖掘与机器学习工具操作指南在当今数字化时代,数据的快速增长和复杂性使得传统的数据处理方式已无法满足实际需求。
因此,数据挖掘和机器学习成为了解决大规模数据处理的重要工具。
本文将介绍电算化常用的数据挖掘和机器学习工具的操作指南,帮助读者更好地理解和应用这些工具。
一、WEKA软件WEKA是一个十分常用的机器学习工具,其功能强大、易于使用。
以下是WEKA软件的操作指南:1. 安装WEKA软件下载WEKA安装文件并按照提示完成软件的安装。
2. 数据预处理在WEKA中,选择“预处理”选项,对数据进行清洗、去除噪声、处理缺失值等操作,以获得干净的数据集。
3. 特征选择通过选择合适的特征,提高模型的准确性和效率。
使用WEKA的“特征选择”功能,可以根据不同的特征选择算法来进行特征选择。
4. 模型构建与评估选择合适的机器学习算法,使用WEKA中的“分类”或“回归”功能,进行模型的构建与训练。
同时,可以使用WEKA提供的交叉验证、混淆矩阵等评估工具,评估模型的性能。
5. 模型应用与保存完成模型的构建和评估后,可以使用WEKA对新数据进行预测和分类。
同时,也可以将模型保存下来,以备将来使用。
二、Python编程语言与相关库Python是一种广泛应用于数据挖掘和机器学习领域的编程语言,其丰富的库使得数据处理和模型构建变得更为便捷。
以下是使用Python进行数据挖掘和机器学习的操作指南:1. 安装Python环境与相关库首先,安装Python编程环境,并通过pip命令安装相关库,如NumPy、Pandas、Scikit-learn等。
2. 数据加载与预处理使用Pandas库加载数据,并利用库中的函数进行数据清洗、去除异常值等预处理操作。
3. 特征工程在数据挖掘和机器学习中,特征工程是提取和选择合适的特征,以增加模型的准确性和泛化能力。
可以利用特征选择、特征提取、特征变换等方法进行特征工程。
利用Scikit-learn库中的各种机器学习算法,可以构建多种模型。
weka使用教程

weka使用教程Weka是一个强大的开源机器学习软件,它提供了各种功能和算法来进行数据挖掘和预测分析。
以下是一个简单的Wea使用教程,帮助您了解如何使用它来进行数据分析和建模。
1. 安装Weka:首先,您需要下载并安装Weka软件。
您可以从官方网站上下载Weka的最新版本,并按照安装说明进行安装。
2. 打开Weka:安装完成后,打开Weka软件。
您将看到一个欢迎界面,上面列出了各种不同的选项和功能。
选择“Explorer”选项卡,这将帮助您导航和执行不同的任务。
3. 导入数据:在Explorer选项卡上,点击“Open file”按钮以导入您的数据集。
选择您要导入的数据文件,并确认数据文件的格式和结构。
4. 数据预处理:在导入数据之后,您可能需要对数据进行预处理,以清除噪声和处理缺失值。
在Weka中,您可以使用各种过滤器和转换器来处理数据。
点击“Preprocess”选项卡,然后选择适当的过滤器和转换器来定义您的预处理流程。
5. 数据探索:在数据预处理之后,您可以使用Weka的可视化工具来探索您的数据。
点击“Classify”选项卡,然后选择“Visualize”选项。
这将显示您的数据集的可视化图表和统计信息。
6. 建立模型:一旦您对数据进行了足够的探索,您可以使用Weka的各种机器学习算法建立模型。
在“Classify”选项卡上选择“Choose”按钮,并从下拉菜单中选择一个适当的分类算法。
然后,使用“Start”按钮训练模型并评估模型的性能。
7. 模型评估:一旦您建立了模型,您可以使用Weka提供的评估指标来评估模型的性能。
在“Classify”选项卡上,选择“Evaluate”选项,Weka将自动计算模型的准确性、精确度、召回率等指标。
8. 导出模型:最后,一旦您满意您的模型性能,您可以将模型导出到其他应用程序或格式中。
在Weka中,点击“Classify”选项卡,选择“Save model”选项,并指定模型的保存位置和格式。
weka配置教程
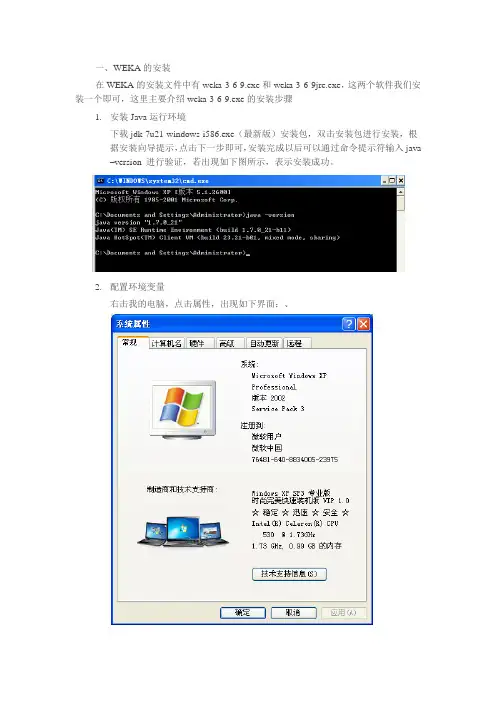
一、WEKA的安装在WEKA的安装文件中有weka-3-6-9.exe和weka-3-6-9jre.exe,这两个软件我们安装一个即可,这里主要介绍weka-3-6-9.exe的安装步骤1.安装Java运行环境下载jdk-7u21-windows-i586.exe(最新版)安装包,双击安装包进行安装,根据安装向导提示,点击下一步即可,安装完成以后可以通过命令提示符输入java–version 进行验证,若出现如下图所示,表示安装成功。
2.配置环境变量右击我的电脑,点击属性,出现如下界面:、选择高级——>环境变量,如图所示:出现环境变量配置界面:双击Path,然后出现编辑系统变量窗口:在变量值编辑框中,将光标移动至最后,添加一个分号“;”,然后将java的jdk安装路径追加到编辑框最后,我的系统中安装路径为:C:\ProgramFiles\Java\jdk1.7.0_21\bin,所以在编辑框最后写入:“; C:\ProgramFiles\Java\jdk1.7.0_21\bin”,即可完成环境变量的配置。
3.weka-3-6-9.exe双击此文件开始进行安装,在出现的窗口中点击Next,然后点击I Agree,再点击Next,此时出现如下窗口,Browse左边的区域是WEKA的默认安装路径,我们可以点击Browse选择我们想要安装WEKA的位置,然后点击窗口下方的NEXT,也可以不点击Browse直接将WEKA安装到默认的目录下,即直接点击窗口下方的NEXT,在新出现的窗口中点击Install开始安装,等待几秒种后点击Next,在新窗口中会有一个Start Weka单选框(默认情况下是选中的),如果我们想安装完成后就启动WEKA,那么我们就直接点击新窗口下方的FINISH 完成安装,如果我们不想立即启动WEKA可以单击Start Weka前面的单选框,然后点击FINISH即可完成安装,此时WEKA已经安装到我们的电脑中。
WEKA教程完整版(新)

@attribute <attribute-name> <datatype> 其中<attribute-name>是必须以字母开头的字符串。和关系名称一 样,如果这个字符串包含空格,它必须加上引号。
2021/3/7
CHENLI
10
2、数据格式(续)
❖ WEKA支持的<datatype>有四种
Format)文件,这是一种ASCII文本文件。上图所示的二维
表格存储在如下的ARFF文件中。这也就是WEKA自带的
“weather.arff”文件,在WEKA安装目录的“data”子目录下可
以找到。
2021/3/7
CHENLI
6
2021/3/7
CHENLI
7
2、数据格式(续)
❖ 文件内容说明 识别ARFF文件的重要依据是分行,因此不能在这种文 件里随意的断行。空行(或全是空格的行)将被忽略。 以“%”开始的行是注释,WEKA将忽略这些行。如果你 看到的“weather.arff”文件多了或少了些“%”开始的行, 是没有影响的。 除去注释后,整个ARFF文件可以分为两个部分。
2021/3/7
CHENLI
9
2、数据格式(续)
❖ 属性声明
属性声明用一列以“@attribute”开头的语句表示。数据集中的每一 个属性都有它对应的“@attribute”语句,来定义它的属性名称和数 据类型。
这些声明语句的顺序很重要。首先它表明了该项属性在数据部分 的位置。例如,“humidity”是第三个被声明的属性,这说明数据部 分那些被逗号分开的列中,第三列数据 85 90 86 96 ... 是相应的 “humidity”值。其次,最后一个声明的属性被称作class属性,在分 类或回归任务中,它是默认的目标变量。
WEKA中文详细教程
2019/8/2
17
数据类型
WEKA支持四种数据类型 numeric <nominal-specification> string date [<date-format>]
数值型 标称(nominal)型 字符串型 日期和时间型
2019/8/2
2
WEKA软件
WEKA的界面
主要特点
它是集数据预处理、学习算法(分类、回归、聚类、关 联分析)和评估方法等为一体的综合性数据挖掘工具。
具有交互式可视化界面。 提供算法学习比较环境
通过其接口,可实现自己的数据挖掘算法
2019/8/2
3
探索环境 知识流环境
2019/8/2
WEKA数据文件
WEKA存储数据的格式是ARFF(AttributeRelation File Format)文件
这是一种ASCII文本文件
文件的扩展名为.arff
可以用写字板打开、编辑 ARFF文件
文件中以“%”开始的行是注释,WEKA将忽略这些行。
除去注释后,整个ARFF文件可以分为两个部分:
2019/8/2
11
表格里的一个横行称作一个实例(Instance),相当 于统计学中的一个样本,或者数据库中的一条记录。
竖行称作一个属性(Attribute),相当于统计学中的 一个变量,或者数据库中的一个字段。
这样一个表格,或者叫数据集,在WEKA看来,呈现了 属性之间的一种关系(Relation)。
对于数值属性和标称属性,摘要的方式是不一样的。图中显示的 是对数值属性“income”的摘要。
weka操作介绍讲解学习
标变量,直方图中的每个长方形
就会按照该变量的比例分成不同
颜色的段。默认地,分类或回归
任务的默认目标变量是数据集的
最后一个属性。要想换个分段的
依据,即目标变量,在区域7上 方的下拉框中选个不同的分类属
性就可以了。下拉框里选上
“No Class”或者一个数值属性会 变成黑白的直方图。
wekቤተ መጻሕፍቲ ባይዱ操作介绍
在KnowledgeFlow 窗口顶部有八个标签: DataSources--数据载入器 DataSinks--数据保存器 Filters--筛选器 Classifiers--分类器 Clusterers--聚类器 Associations—关联器 Evaluation—评估器 Visualization—可视化
关联运行结果
此课件下载可自行编辑修改,仅供参考! 感谢您的支持,我们努力做得更好!谢谢
3 4
5 8
1 2
6 7
1.区域1的几个选项卡是用来切换不同的 挖掘任务面板。
Preprocess(数据预处理) Classify(分类) Cluster(聚类) Associate(关联分析) Select Attributes(选择属性) Visualize(可视化)
2. 区域2是一些常用按钮。包括打开数据, 保存及编辑功能。我们可以在这里把 “bank-data.csv”,另存为“bank-data.arff”
Cluster
主要算法包括: SimpleKMeans — 支持分类属性的K均值算法 DBScan — 支持分类属性的基于密度的算法 EM — 基于混合模型的聚类算法 FathestFirst — K中 心点算法 OPTICS — 基于密度的另一个算法 Cobweb — 概念聚类算法 sIB — 基于信息论的聚类算法,不支持分类属性 XMeans — 能自动确定簇个数的扩展K均值算法,不 支持分类属性
weka使用总结(数据库的连接以及myeclipse的配置)
Weka使用总结:1.weka的下载安装去官网上下载这个程序,找这个程序时要细心点,官网的搜索若不使用下面的搜索词就不一定能找到这个软件的下载地址2.双击软件,运行安装程序,在c盘路径下生成下面的文件3.在MyEClipse中新建java项目WEKA,将上面的weka-src.jar解压缩,把解压后的文件拷到WEKA项目中,lib文件夹中要引入相应的包4.weka连接mysql数据库。
在weka/experiment目录中找到修改databaseutils.props将jdbcDriver=org.gjt.mm.mysql.Driver[修改为-->jdbcDriver=com.mysql.jdbc.Driver]修改jdbcURL=jdbc:mysql://server_name:3306/database_name完整的代码修改如下# General information on database access can be found here:# /Databases## Version: $Revision: 5836 $# The comma-separated list of jdbc drivers to use#jdbcDriver=RmiJdbc.RJDriver,jdbc.idbDriver#jdbcDriver=jdbc.idbDriver#jdbcDriver=RmiJdbc.RJDriver,jdbc.idbDriver,org.gjt.mm.mysql.Driver,com.mck oi.JDBCDriver,org.hsqldb.jdbcDriverjdbcDriver=com.mysql.jdbc.Driver# The url to the experiment database#jdbcURL=jdbc:rmi://expserver/jdbc:idb=experiments.prp#jdbcURL=jdbc:idb=experiments.prpjdbcURL=jdbc:mysql://server_name:3306/database_name# the method that is used to retrieve values from the db# (java datatype + RecordSet.<method>)# string, getString() = 0; --> nominal# boolean, getBoolean() = 1; --> nominal# double, getDouble() = 2; --> numeric# byte, getByte() = 3; --> numeric# short, getByte()= 4; --> numeric# int, getInteger() = 5; --> numeric# long, getLong() = 6; --> numeric# float, getFloat() = 7; --> numeric# date, getDate() = 8; --> date# text, getString() = 9; --> string# time, getTime() = 10; --> date# the original conversion: <column type>=<conversion>#char=0#varchar=0#longvarchar=0#binary=0#varbinary=0#longvarbinary=0#numeric=2#decimal=2#tinyint=3#smallint=4#integer=5#bigint=6#real=7#float=2#double=2#date=8#time=10#timestamp=8#mysql-conversionstring, getString() = 0; --> nominal boolean, getBoolean() = 1; --> nominal double, getDouble() = 2; --> numeric byte, getByte() = 3; --> numeric short, getByte()= 4; --> numeric int, getInteger() = 5; --> numeric long, getLong() = 6; --> numeric gloat, getFloat() = 7; --> numeric date, getDate() = 8; --> datetext, getString() = 9; --> string TINYINT=3SMALLINT=4#SHORT=4SHORT=5INTEGER=5INT=5LONG=6REAL=7NUMERIC=2DECIMAL=2FLOAT=2DOUBLE=2CHAR=0TEXT=0VARCHAR=0LONGVARCHAR=9BINARY=0VARBINARY=0 LONGVARBINARY=9BIT=1BLOB=9DATE=8TIME=8DATETIME=8TIMESTAMP=8#mappings for table creation CREATE_STRING=TEXTCREATE_INT=INTCREATE_DOUBLE=DOUBLECREATE_DATE=DATETIME DateFormat=yyyy-MM-dd HH:mm:ss#database flagscheckUpperCaseNames=falsecheckLowerCaseNames=falsecheckForTable=truesetAutoCommit=truecreateIndex=false# All the reserved keywords for this databaseKeywords=\AND,\ASC,\BY,\DESC,\FROM,\GROUP,\INSERT,\ORDER,\SELECT,\UPDATE,\WHERE# The character to append to attribute names to avoid exceptions due to # clashes between keywords and attribute namesKeywordsMaskChar=_#flags for loading and saving instances using DatabaseLoader/Saver nominalToStringLimit=50idColumn=auto_generated_id配好之后在lib目录下加载一个要重新生成jar包需下载一个将这个压缩包解压之后置于C:\Users\ys\AppData\Local\Genuitec\MyEclipse 8.x Latest\dropins目录下,重新启动myeclipse,此时在WEKA项目中点右键出现build fat jar文件,点击进去之后,它会自动把引用的数据库连接包自动加载进去,生成一个weka-fat.jar包打开weka-fat.jar包,运行weka,就能和数据库连接了。
WEKA中文详细教程
Weka可以将分析结果导出为多种格式,如CSV、ARFF、LaTeX等,用户可以通过“文件”菜单 选择“导出数据”来导出数据。
数据清理
缺失值处理
Weka提供了多种方法来处理缺失值, 如删除含有缺失值的实例、填充缺失 值等。
异常值检测
Weka提供了多种异常值检测方法, 如基于距离的异常值检测、基于密度 的异常值检测等。
Weka中文详细教程
目录
• Weka简介 • 数据预处理 • 分类算法 • 关联规则挖掘 • 回归分析 • 聚类分析 • 特征选择与降维 • 模型评估与优化
01
Weka简介
Weka是什么
01 Weka是一款开源的数据挖掘软件,全称是 "Waikato Environment for Knowledge Analysis",由新西兰怀卡托大学开发。
解释性强等优点。
使用Weka进行决策树 分类时,需要设置合 适的参数,如剪枝策 略、停止条件等,以 获得最佳分类效果。
决策树分类结果易于 理解和解释,能够为 决策提供有力支持。
贝叶斯分类器
贝叶斯分类器是一种 基于概率的分类算法, 通过计算不同类别的 概率来进行分类。
Weka中的朴素贝叶斯 分类器是一种基于贝 叶斯定理的简单分类 器,适用于特征之间 相互独立的场景。
08
模型评估与优化
交叉验证
01
交叉验证是一种评估机器学习模型性能的常用方法,通过将数据集分成多个子 集,然后使用其中的一部分子集训练模型,其余子集用于测试模型。
02
常见的交叉验证方法包括k-折交叉验证和留出交叉验证。在k-折交叉验证中, 数据集被分成k个大小相近的子集,每次使用其中的k-1个子集训练模型,剩余 一个子集用于测试。