
多发射指令的算法细节讲解
循环展开4次(straightforward way)
1 Loop: LD
2
ADDD
3
SD
4
LD
5
ADDD
6
SD
7
LD
8
ADDD
9
SD
10
LD
11
ADDD
12
SD
13
SUBI
14
BNEZ
15
NOP
F0,0(R1) stall
F4,F0,F2 stall stall
0(R1),F4
;drop SUBI & BNEZ
Ch 4 指令级并行
Embedded System Lab Fall 2012
4.1 指令级并行 (Instruction Level Parallelism)
• 相关是程序运行的本质特征
• 相关带来数据冒险
Loop: LD F0,0(R1) SUBI R2,R2,8
• 冒险导致CPU停顿 Stall
产生结果的指令 FP ALU op FP ALU op Load double Load double Integer op
使用结果的指令 Another FP ALU op Store double FP ALU op Store double Integer op
所需的延时 3 2 1 0 0
• 需要在哪里加stalls?(假设分支在ID段得到地址和条件)
A[1] = A[1] + B[1];
for (i=1; i<=99; i=i+1) {
NEW:
B[i+1] = C[i] + D[i];
A[i+1] = A[i+1] + B[i+1];
}
B[101] = C[100] + D[100];
4.2 硬件调度方案:
• 为什么要使用硬件调度方案?
– 在编译时无法确定的相关,可以通过硬件调度来优化 – 简化了编译器的设计 – 代码在不同组织结构的机器上,同样可以有效的运行
1. S1和S2没有相关,S1和S2互换不会影响程序的正 确性 2. 在第一次循环中,S1依赖于前一次循环的B[i].
循环展开(3/3)
for (i=1; i<=100; i=i+1) {
OLD:
A[i] = A[i] + B[i]; /* S1 */
B[i+1] = C[i] + D[i];} /* S2 */
下列是否有名相关?
1 Loop: LD
F0,0(R1)
2
ADDD F4,F0,F2
3
SD
0(R1),F4
4
LD
F0,-8(R1)
5
ADDD F4,F0,F2
6
SD
-8(R1),F4
7
LD
F0,-16(R1)
8
ADDD F4,F0,F2
9
SD
-16(R1),F4
;
10
LD
F0,-24(R1)
11
ADDD F4,F0,F2
-24(R1),F16
R1,R1,#32 stall ;alter to 4*8
R1,LOOP
Rewrite loop to minimize stalls?
名相关如何解决
15 + 4 x (1+2) + 1 = 28 cycles, or 7 per iteration Assumes R1 is multiple of 4
• 这表示循环间存在相关,不能并行执行,它与我们前面的例 子中循环间无关是有区别的
循环展开(2/3)
• Example:A,B,C,D distinct & nonoverlapping
• for (i=1; i<=100; i=i+1) { A[i] = A[i] + B[i]; /* S1 */ B[i+1] = C[i] + D[i];} /* S2 */
F6,-8(R1) stall
F8,F6,F2 stall stall
-8(R1),F8
;drop SUBI & BNEZ
F10,-16(R1) stall
F12,F10,F2 stall stall
-16(R1),F12 ;drop SUBI & BNEZ
F14,-24(R1) stall
F16,F14,F2 stall stall
for (i=1; i<=100; i=i+1) { A[i+1] = A[i] + C[i]; B[i+1] = B[i] + A[i+1];
}
/* S1 */ /* S2 */
1. S2使用由S1在同一循环计算出的 A[i+1]. 2. S1 使用由S1在前一次循环中计算的值,同样S2也使用由S2在前一次循 环中计算的值. 这种存在于循环间的相关,我们称为 “loop-carried dependence”
;add scalar in F2
4
stall
5
stall6ຫໍສະໝຸດ SD0(R1),F4
;store result
7
SUBI R1,R1,8
;decrement pointer 8B (DW)
8
stall
9
BNEZ R1,Loop
;branch R1!=zero
10
stall
;delayed branch slot
FP 循环中的Stalls
1 Loop: 2 3 4 5 6 7 8 9 10
LD F0,0(R1) stall ADDD F4,F0,F2 stall stall SD 0(R1),F4 SUBI R1,R1,8 stall BNEZ R1,Loop stall
;F0=vector element ;add scalar in F2
SUBI R3,R3,8
相关的分类:
ADDD F4,F0,F2
– 数据相关
– 结构相关
– 控制相关
• ILP: 无关的指令重叠执行
名相关
• 另一种相关称为名相关( name dependence): 两条指令使用同一个名字(register or memory location) 但不交换数据
– 反相关(Antidependence) (WAR)
;store result ;decrement pointer 8B (DW) ;branch R1!=zero ;delayed branch slot
产生结果的指令 使用结果的指令
所需的延时
FP ALU op
Another FP ALU op
3
FP ALU op
Store double
2
Load double
• 基本思想: 允许 stall后的指令继续向前流动
DIVD F0,F2,F4 ADDD F10,F0,F8 SUBD F12,F8,F14 – 允许乱序执行(out-of-order execution) => out-of-order completion
• 记分牌算法 • Tomasulo算法
12
SD
-24(R1),F4
13
SUBI R1,R1,#32
14
BNEZ R1,LOOP
15
NOP
如何消除名相关?
指令级并行的若干定义
• 基本块的定义
– 直线型代码,无分支 – 整个程序是由分支语句连接基本块构成 – MIPS 的分支指令占15%左右,基本块的大小在4~7条指令
指令级并行的若干定义
一个循环的例子
for (i = 1; i <= 1000; i++) x(i) = x(i) + y(i);
• 特征
– 计算x(i)时没有相关
• 并行方式
– 最简单的方法,循环展开。 – 采用向量的方式
X=X+Y 60年代开始 Cray HITACHI NEC Fujitsu 目前均采用向量加速部件的形式 GPU DSP
循环级并行). • 不同次的循环,使用不同的寄存器. • 指令调度,必须保证程序运行的结果不变
• 指令重排+循环展开
– 不做任何优化 10000 – 采用指令重排 6000 – 4次循环展开 7000 – 4次循环展开+指令重排 3500
循环展开(1/3)
• Example: 下列程序段存在哪些数据相关? (A,B,C 指向不同的存储区且不存在覆盖区)
• 本章研究
– 减少停顿(stalls)数的方法和技术
指令集调度的基本途径
•基本途径
– 软件方法(编译器优化)
•Gcc: 17%控制类指令 •5 instructions + 1 branch •在基本块上,得到更多的并行性 •挖掘循环级并行
– 硬件方法
•动态调度方法
静态与动态调度
• 8086 IO周期和CPU周期 • 386 指令重叠执行 • 486 指令级并行 • 动态指令集调度
简单循环及其对应的汇编程序
for (i=1; i<=1000; i++) x(i) = x(i) + s;
Loop: LD F0,0(R1) ADDD F4,F0,F2 SD 0(R1),F4 SUBI R1,R1,8 BNEZ R1,Loop NOP
;F0=vector element ;add scalar from F2 ;store result ;decrement pointer 8B (DW) ;branch R1!=zero ;delayed branch slot
遥控器原理知识点总结

遥控器原理知识点总结遥控器原理知识点总结遥控器是现代电子产品中常见的一种控制设备,可以实现对电视、音响、空调等电器的遥控操作。
本文将针对遥控器的原理进行详细的解析和总结。
一、遥控器的工作频率遥控器的工作频率一般在30kHz到60kHz之间,不同品牌的遥控器可能有不同的工作频率。
这是因为电器设备的接收装置根据工作频率来解码遥控信号。
二、遥控器的编码方式遥控器的编码方式一般有两种,分别是固定编码和滚动编码。
固定编码指的是遥控器每次按下一个按键发送的信号都是相同的,而滚动编码则是每次按键都会自动改变一次编码。
滚动编码方式相对更加安全可靠,因为遥控信号不能被复制破解。
三、遥控器的发射方式遥控器的发射方式一般有红外线和无线射频两种。
红外线发射方式主要用于家庭电器控制,而无线射频发射方式则常用于汽车遥控器和无线门铃等场景。
红外线发射方式需要通过红外发射二极管发射特定的红外信号,而无线射频发射方式则通过无线射频模块进行信号发射。
四、遥控器的接收方式遥控器的接收方式一般是通过红外线接收模块或无线射频接收模块来接收信号。
红外线接收模块可以接收红外信号,并通过解码芯片将信号转换为数字信号,再传输给被控制的电器设备。
无线射频接收模块则可以接收无线射频信号,并通过解码芯片将信号转换为数字信号。
五、遥控器的电源遥控器一般使用纽扣电池或干电池作为电源。
红外线遥控器的电池一般使用3V的电压,而无线射频遥控器的电池则一般使用12V的电压。
六、遥控器的工作原理遥控器的工作原理是通过按键触发电路来发送指令信号。
当用户按下遥控器上的按键时,电路会将特定的信号编码并通过发射装置发送出去。
被控制的电器设备接收到信号后,会通过解码装置将信号转换为可识别的指令,然后采取相应的操作。
七、遥控器的遥控距离遥控器的遥控距离一般与发射装置的功率和接收装置的敏感度有关。
一般情况下,室内遥控距离可以达到10米到20米,而室外遥控距离可以达到50米到100米。
1分钟看懂CPU多发射超标量多线程多核概念的区别

1分钟看懂CPU多发射超标量多线程多核概念的区别最近在多个场合大肆宣扬多核多线程,收到对多线程表示不解的问题N多,苦思多日,终得一形象生动的模型,你肯定懂的。
因为是比喻和科普、过于严谨的技术控请勿吐槽。
处理器性能提高之公开秘笈:超标量、多线程、多核。
用于说明的生活模型:高速公路及收费站。
简单CPU的原型:单车道马路 + 单收费闸口,车辆只能一辆辆排队通过,并行度为1。
为了提高通行能力同时积极创收,相关部门运用世界顶尖CPU设计理念,对高速公路系统进行了如下拓宽改造:(1)增加车道(图示为3条车道);(2)增加收费通道(图示为2个通道);(3)每个收费通道放置多个收费员(图示每条通道有a和b两个收费窗口)。
其中(1)+(3)组合手段就是所谓的超标量结构,该图示为双发射超标量。
超标量指有多个车道,双发射是指有a和b两位收费员可以同时发卡,把两辆车送到不同车道上去。
手段(2)就是多线程的模型了,原有车道不变、只增加收费通道,这样多个车流来的时候可以同时发卡放行。
从这个比喻来看多线程显然是个非常直观和有用的办法,但为什么在CPU世界中似乎有点模糊难懂的感觉呢?那是因为CPU的指令流喜欢一个挨一个、一列纵队龟速前进,这样的话单通道多收费员还起点作用、多通道就形同虚设了。
收费员1.a和1.b会累死,而2.a和2.b则能够睡觉。
因此把车流进行整队就很重要——这就是并行编程,即要设法把一列纵队排列成多列纵队。
至于多核的概念,那就简单粗暴很多了,直接在这条马路边上进行征地拆迁、新修一条一模一样的高速公路便是,牛吧。
现在大家手机里面的多核,就是并排几条“单收费通道+多车道”的马路,车流稀少、路况不错,不过相关部门表示因为道路利用率底下、经济效益欠佳、回收投资压力巨大。
无论多核还是多线程,都有一个同样的问题需要解决,就是要把车流整成多列纵队,这样多条马路和多个收费通道的并行度才能发挥作用。
多发射处理器的指令调度算法研究
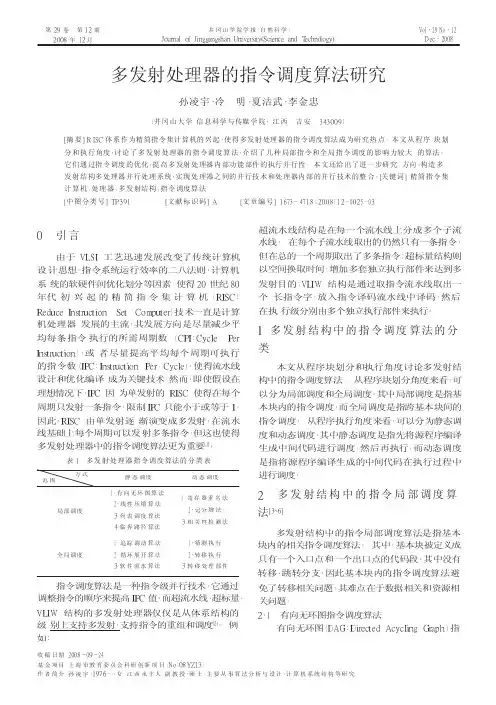
第 29 卷 第 12 期2008 年12 月井冈山学院学报(自然科学)Journal of Jinggangshan University(Science and Technology)Vol 〃29 No 〃12Dec 〃2008多发射处理器的指令调度算法研究孙凌宇,冷 明,夏洁武,李金忠(井冈山大学 信息科学与传媒学院, 江西 吉安 343009)[摘要] RI S C 体系作为精简指令集计算机的兴起,使得多发射处理器的指令调度算法成为研究热点。
本文从程序 块划分和执行角度,讨论了多发射处理器的指令调度算法,介绍了几种局部指令和全局指令调度的影响力较大 的算法。
它们通过指令调度的优化,提高多发射处理器内部功能部件的执行并行性。
本文还给出了进一步研究 方向,构造多发射结构多处理器并行处理系统,实现处理器之间的并行技术和处理器内部的并行技术的整合。
[关键词] 精简指令集计算机;处理器;多发射结构;指令调度算法 [中图分类号] TP391[文献标识码] A[文章编号] 1673-4718(2008)12-0025-030 引言由于VLSI 工艺迅速发展改变了传统计算机设 计思想、指令系统运行效率的二八法则、计算机系 统的软硬件间优化划分等因素,使得20世纪80年代 初 兴起的精简指令集计算机 (RISC :Reduce Instruction Set Computer )技术一直是计算机处理器 发展的主流,其发展方向是尽量减少平均每条指令 执行的所需周期数 (CPI :Cycle PerInstruction ),或 者尽量提高平均每个周期可执行的指令数 (IPC : Instruction Per Cycle ),使得流水线设计和优化编译 成为关键技术。
然而,即使假设在理想情况下,IPC 因 为单发射的RISC 使得在每个周期只发射一条指令, 限制IPC 只能小于或等于1。
因此,RISC 由单发射逐 渐演变成多发射,在流水线基础上每个周期可以发 射多条指令,但这也使得多发射处理器中的指令调 度算法更为重要[1]。
mips中为了减少停顿 采用的技术

mips中为了减少停顿采用的技术MIPS是一种常用的指令集架构,它采用了一系列的技术来优化指令的执行过程,从而减少停顿,提高程序的执行效率。
本文将介绍MIPS中为了减少停顿所采用的一些技术。
一、流水线技术流水线技术是指将指令的执行过程分为若干个阶段,然后将不同指令的不同阶段交错在一起,从而使得多条指令可以同时执行,提高了程序的执行效率。
MIPS中采用了五级流水线技术,将指令的执行过程分为取指阶段、译码阶段、执行阶段、访存阶段和写回阶段。
这样,每条指令在执行时都可以同时进行不同的阶段,从而提高了程序的执行效率。
二、分支预测技术分支指令是指在程序执行过程中需要根据条件进行跳转的指令。
在MIPS中,分支指令的执行会影响到流水线的执行顺序,从而导致停顿的发生。
为了减少这种停顿,MIPS采用了分支预测技术。
分支预测技术是指根据历史执行情况,对分支指令的跳转方向进行预测。
如果预测正确,程序可以继续执行;如果预测错误,程序会回滚到分支指令的位置重新执行。
通过这种技术,可以减少分支指令带来的停顿,提高程序的执行效率。
三、乱序执行技术乱序执行技术是指在流水线执行过程中,根据指令之间的依赖关系,动态调整指令的执行顺序,从而减少停顿的发生。
MIPS中采用了乱序执行技术,将指令的执行顺序动态调整,使得不同指令之间的依赖关系得到了更好的处理。
通过这种技术,可以充分利用流水线的并行性,提高程序的执行效率。
四、多发射技术多发射技术是指在一个时钟周期内同时发射多条指令,从而提高程序的执行效率。
MIPS中采用了多发射技术,将流水线分为多个单元,并且每个单元都可以发射一条指令。
通过这种技术,可以使得多条指令可以同时执行,提高程序的执行效率。
五、数据前推技术数据前推技术是指在指令执行过程中,将计算结果直接传递给需要使用这个结果的指令,从而减少停顿的发生。
MIPS中采用了数据前推技术,将计算结果直接传递给需要使用这个结果的指令,从而避免了停顿的发生,提高了程序的执行效率。
航天器发射多任务并行调度模型及算法
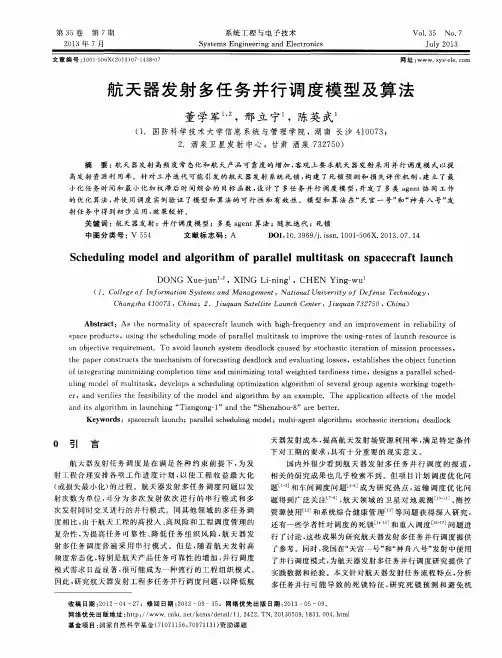
关 键 词 :航 天 器 发 射 ;并 行 调 度 模 型 ;多 类 a g e n t 算 法 ;随 机 迭 代 ; 死 锁
中圈分类 号 : V 5 5 4 文献标志 码 : A D OI : 1 0 . 3 9 6 9 / j . i s s n . 1 0 0 1 — 5 0 6 X . 2 0 1 3 . 0 7 . 1 4
( j .Co l l e g e o f I n f o r ma t i o n S y s t e ms a n d Ma n a g e me n t ,Na t i o n a l Un i v e r s i t y o f De f e n s e Te c h n o l o g y,
Ch a n g s h a 4 1 O 0 7 3,C h i n a;2.J i u q u a n S a t e l l i t e L a u n c h Ce n t e r,J i u q u a n 7 3 27 5 0,Ch i n a ) Ab s t r a c t :A s t h e n o r ma l i t y o f s p a c e c r a f t l a u n c h wi t h h i g h — f r e q u e n c y a n d a n i mp r o v e me nt i n r e l i a b i l i t y o f s p a c e p r o d u c t s ,u s i n g t h e s c h e d u l i n g mo d e o f p a r a l l e l mu l t i t a s k t o i mp r o v e t h e u s i n g — r a t e s o f l a u n c h r e s o u r c e i s
流水线的多发射技术

步流水化,使得一个功能部件在一个时钟周期中可以
处理多条指令(可以简单地理解为很长的流水线)
多发射流水线
0
1
2
3
4
5
6
7
T
正常流水线
Байду номын сангаас
超标量流水线
0
1
2
3
4
5
. 单发射处理机的指令流水线
取指令指令译码执行指令EX写回结果
FA1FA2FA3
浮点加法部件
来自指令
CacheIFIDMD1MD2MD3WR通用寄存器
后行写数栈
乘除法部件
AL
定点算术逻辑部件
LS
取数存数部件
. 同时发射两条指令的多发射处理机的指令流水线
取指令指令译码执行指令写回结果
8 流水线技术(3)
张伟
计算机学院
大纲
.回顾上节内容
.流水线相关
.结构相关
.数据相关
.控制相关
.高级流水线技术
流水线性能分析
.吞吐率(throughput rate)
单位时间内流水线所完成的任务数或输出结果
的数量
.加速比(speedup ratio)
超标量处理机的指令级并行度(ILP)大于1。
改变PC值的指令
结构相关
.1. 在流水线机器中,为了使各种指令组合能顺
利地重叠执行,需要把功能部件流水化,并把资
源重复设置。
.2. 如果某种指令组合因资源冲突而不能顺利重
多指令流出技术VLIW和Superscalar简介
如何使 CPI < 1? (2/2)
▪ 另一种方法
▪ (Very) Long Instruction Words (V)LIW: • 每个时钟周期流出的指令数(操作)固定 (4-16) • 由编译器调度,实际上由多个单操作指令构成一个超长指令 • 目前比较成功的应用于DSP,多媒体应用 • 1999/2000 HP和Intel达成协议共同研究VLIW • Intel Architecture-64 (Merced/A-64) 64-bit address • Style: “Explicitly Parallel Instruction Computer (EPIC)”
7 results in 9 clocks, or 1.3 clocks per iteration (1.8X)
Average: 2.5 ops per clock, 50% efficiency
注: 在VLIW中,一条超长指令有更多的读写寄存器操作(15 vs. 6 in SS)
计算机体系结构 Chapter4_4 11
▪ 多指令流出的处理器需要大量的硬件资源 • 需要多个功能部件来使得多个操作并行(Easy) • 需要更大的指令访问带宽(Easy) • 需要增加寄存器文件的端口数(以及通信带宽) (Hard) • 增加存储器的端口数(带宽) (Harder)
计算机体系结构 Chapter4_4 19
多发射处理器受到的限制(2/2)
• 不限于基本块(IU先行,解决控制相关) ▪ 贡献
• Dynamic scheduling • Register renaming • Load/store disambiguation ▪ 360/91 后 Pentium II; PowerPC 604; MIPS R10000; HP-PA 8000; Alpha 21264使用这种技术
并行计算机体系结构的分类
并行计算机体系结构的分类并行计算机体系结构是指在计算机系统中,通过多个处理单元同时执行任务以提高计算性能的架构框架。
根据不同的设计思想和实现方式,可以将并行计算机体系结构分为多种分类。
本文将介绍几种常见的并行计算机体系结构分类,并对其特点和应用进行讨论。
1.指令级并行体系结构指令级并行体系结构(ILP)是基于指令级并行技术的一种体系结构。
ILP通过将单个指令分解为多个子操作,并在不同的处理单元上同时执行这些子操作,从而实现指令级并行。
这种体系结构适用于需要大量计算的应用,如科学计算和图像处理。
其中,超标量和超流水线是常见的ILP体系结构。
超标量体系结构通过在一个时钟周期内同时发射多条指令,利用指令之间的独立性实现指令级并行。
而超流水线体系结构则通过将指令的执行过程分解为多个阶段,并在每个阶段上同时执行不同的指令,进一步提高了并行度。
这两种体系结构能够充分利用处理器资源,提高计算性能。
2.向量处理体系结构向量处理体系结构是基于向量处理器的一种体系结构。
向量处理器是一种特殊的处理器,能够同时处理多个数据元素。
在向量处理体系结构中,处理器通过执行向量指令,对向量数据进行并行操作。
这种体系结构适用于需要对大规模数据进行相同类型操作的应用,如科学计算和图像处理。
向量处理体系结构具有高度的并行性和数据吞吐量,能够充分利用数据级并行性,提高计算性能。
然而,由于向量处理器对数据的访问具有一定的限制,对于不适合向量化的应用,其性能优势可能会受到限制。
3.多核体系结构多核体系结构是指在一个计算机系统中,使用多个处理核心来执行任务的体系结构。
每个处理核心都具有独立的处理器和内存,能够同时执行不同的指令流。
多核体系结构适用于需要同时执行多个任务的应用,如服务器和大数据处理。
多核体系结构具有良好的可扩展性和并行性,能够提供更高的计算性能。
通过将任务分配给不同的处理核心,可以充分利用系统资源,提高系统的吞吐量和响应速度。
然而,多核体系结构也面临着任务调度和数据共享的挑战,需要采用合适的并行编程模型和调度算法来优化性能。
可扩展32位微处理器指令多发射技术的研究
可扩 展 3 位微处理器指 令 多发射技术 的研 究 2
王琦瑛 , 宁梅 , 伟 余 路
WANG Qiig Y Nig i U We yn , U n me, i L
需求 , 嵌入 的加速 部件 更突 出强化 数据处 理单 元的特 征和特
射 一条指令 的限制 , 增强并行执 行程序 的能 力 , 提高处理 器 是
运算 速度的有效方法 。
定应 用需求 。结 合 了加速部 件 的“ 专设专 用 ” 特性 , 得微处 使 理器具有指令执行针对性强, 效率高, 满足应用场景的多样化 需求 , 提高 芯片应用 的灵活性 , 因此将 上述两大特征 合二为一 的设计思想及其实现模式具有远大的前瞻意义。
t lw b b l, ih tr u h u mut is e tu tr c mbn d y,o u be hg ho g p t l—su srcue, o ie wi i s e ic p i zto s ae is te t cu e o te i t t p cf o t h s i miain t tge ,h sr t r f r h r u 8 is e u cin efciey mp o e h is e f ce c a d y tm fe u n yAn t ti lt r ,t c n e e up e wi - u fn t fe t l i rv s t e su e in y n s se r q e c . d a hs af m i a b q ip d s o v i p o t h
10-3 超标量、超级流水线和超长指令字计算机(郑宏)
• 单发射处理机在指令一级通 常采用流水线结构;
• 单发射处理机的设计目标是 每个时钟周期平均执行一条 机器指令;但由于转移和数 据相关的问题,还有其它的 资源冲突,使得实际上达不 到这一目标。
单发射和多发射
多发射
– 在一个时钟周期中发出多条指令。 – 常见的多发射处理机有:
✓ 超标量处理机 ✓ 超流水线处理机 ✓ 超长指令字( VLIW )处理机。
超标量处理机
特点:
– 有两条或两条以上能够同时工作的指令流水线;
– 一个时钟周期内能够同时发射多条指令。
1
I1
IF
I2
IF
I3
IF
I4
I5
I6
I7
I8
I9
I10
I11
I12 指令
2
3
4
5
ID
EX
WR
时钟周期
ID
EX
WR
ID
EX
WR
IF
ID
EX
WR
IF
ID
EX
WR
IF
ID
EX
WR
IF
ID
EX
WR
IF
超长指令字处理机
特点:
– 指令字长很长,可达数百位;
– 有多个功能部件并发工作;
– 用一条长指令来实现多个操作的并行执行;
1I1ຫໍສະໝຸດ IFI2I3
2
3
4
5
ID
EX
WR
时钟周期
EX
EX
IF
ID
EX
WR
EX
EX
IF
ID
EX
WR
EX