
一元线性回归的贝叶斯分析
贝叶斯线性回归
贝叶斯线性回归贝叶斯线性回归(Bayesian Linear Regression)关于参数估计在很多机器学习或数据挖掘问题中,我们所⾯对的只有数据,但数据中潜在的概率密度函数是不知道的,概率密度分布需要我们从数据中估计出来。
想要确定数据对应的概率分布,就需要确定两个东西:概率密度函数的形式和概率密度函数的参数。
有时可能知道的是概率密度函数的形式(⾼斯、瑞利等等),但是不知道具体的参数,例如均值或者⽅差;还有的时候可能不知道概率密度的类型,但是知道⼀些估计的参数,⽐如均值和⽅差。
关于上⾯提到的需要确定的两个东西:概率密度函数的形式和参数,⾄少在机器学习的教课书上,我所看到的情况都是:给了⼀堆数据,然后假设其概率密度函数的形式为⾼斯分布,或者是混合⾼斯分布,那么,剩下的事情就是对⾼斯分布的参数,µ 和σ2进⾏估计。
所以,参数估计,便成了极其最重要的问题。
其实,常⽤的参数估计⽅法有:极⼤似然估计、最⼤后验估计、贝叶斯估计、最⼤熵估计、混合模型估计。
极⼤似然估计这⾥先以⼀个分类问题来说明⼀般参数估计⾯对的数据形式。
考虑⼀个M类的问题,特征向量服从p(x|),i=1,2...,M 分布。
这是现实情况中最常见的⼀种数据存在形式,数据集合X是由M个类别的数据⼦集,m=1,2...,M 组成的,第m类别的数据⼦集对应的概率密度函数是p(x|)。
前⾯已经介绍过了,想要确定数据的概率分布,需要知道概率密度函数的形式和参数,这⾥⾸先做⼀个基本假设:概率分布的形式已知,⽐如假设每个类别的数据都满⾜⾼斯分布,那么,似然函数就可以以参数θi 的形式表⽰,如果是⾼斯分布,则参数为µi和,即θi=(µi)。
为了强调概率分布p(x|ωi)和θi有关,将对应的概率密度函数记为p(x|ωi;θi),这种记法属于频率概率学派的记法。
这⾥的极⼤似然估计对应于⼀个类条件概率密度函数。
在概率论中⼀直有两⼤学派,分别是频率学派和贝叶斯学派。
一元线性回归模型案例分析
一元线性回归模型案例分析一元线性回归是最基本的回归分析方法,它的主要目的是寻找一个函数能够描述因变量对于自变量的依赖关系。
在一元线性回归中,我们假定存在满足线性关系的自变量与因变量之间的函数关系,即因变量y与单个自变量x之间存在着线性关系,可表达为:y=β0+ β1x (1)其中,β0和β1分别为常量,也称为回归系数,它们是要由样本数据来拟合出来的。
因此,一元线性回归的主要任务就是求出最优回归系数和平方和最小平方根函数,从而评价模型的合理性。
下面我们来介绍如何使用一元线性回归模型进行案例分析。
数据收集:首先,研究者需要收集自变量和因变量之间关系的相关数据。
这些数据应该有足够多的样本观测值,以使统计分析结果具有足够的统计力量,表示研究者所研究的关系的强度。
此外,这些数据的收集方法也需要正确严格,以避免因相关数据缺乏准确性而影响到结果的准确性。
模型构建:其次,研究者需要利用所收集的数据来构建一元线性回归模型。
即建立公式(1),求出最优回归系数β0和β1,即最小二乘法拟合出模型方程式。
模型验证:接下来,研究者需要对所构建的一元线性回归模型进行验证,以确定模型精度及其包含的统计意义。
可以使用F检验和t检验,以检验回归系数β0和β1是否具有统计显著性。
另外,研究者还可以利用R2等有效的拟合检验统计指标来衡量模型精度,从而对模型的拟合水平进行评价,从而使研究者能够准确无误地判断其研究的相关系数的统计显著性及包含的统计意义。
另外,研究者还可以利用偏回归方差分析(PRF),这是一种多元线性回归分析技术,用于计算每一个自变量对相应因变量的贡献率,使研究者能够对拟合模型中每一个自变量的影响程度进行详细的分析。
模型应用:最后,研究者可以利用一元线性回归模型进行应用,以实现实际问题的求解以及数据挖掘等功能。
例如我们可以使用这一模型来预测某一物品价格及销量、研究公司收益及投资、检测影响某一地区经济发展的因素等。
综上所述,一元线性回归是一种利用单变量因变量之间存在着线性关系来拟合出回归系数的回归分析方法,它可以应用于许多不同的问题,是一种非常实用的有效的统计分析方法。
一元线性回归模型的贝叶斯分析推导过程
一元线性回归模型的贝叶斯分析推导过程在贝叶斯统计学中应用更多的是贝叶斯公式的密度函数形式. 一般情况下, 设θ为未知参数( 或向量) , 它的先验密度记为π(θ),x为观测量,当获得观测量x后, θ的后验密度由bayesian公式得出:πθx=f(x|θ)π(θ)f xθπ(θ)dθΘ其中:f(x|θ)为给定时样本概率密度函数, 也称似然函数;Θ为参数空间; π(θ|x)为获得试验样本之后对θ的新认识, 称为后验密度. 以π(θ|x)作为统计推断的出发点, 这就是贝叶斯统计方法。
在没有先验信息的情况下,采用均匀分布作为先验分布密度,这种确定先验分布的原则成为贝叶斯假设。
用“∝”表示成比例,贝叶斯假设可表示为π(θ)∝常数。
一元线性回归模型:y i=β1+β2x i+ε,i=1,2,…,n其中: x i表示自变量的第 i个观测值; y i表示在自变量x i下因变量的第 i 个观测值; β1, β2是未知参数. 这里假定ε服从正态分布N(0,σ2), 且相互独立, β1, β2, σ2之间也相互独立。
极大似然估计:极大似然函数为:L(β1,β2,σ )=121nexp −12y i−β1−β2x i2ni=1写成矩阵形式:Y=y1⋯y n T,X=x1⋯x n T,β= β1,β2Lβ=12πσ21exp −12σ2(Y−Xβ)2两边同时取对数为:LnL β =−n 4σ2(Y −Xβ)2Ln (2πσ2)对β求导并令其等于0:−2X T Y −2X T Xβ=0所以有:β=(X T X )−1X T Y即:β 1=y −β 2x β 2= (x i −x )(y i −y )n i =1 (x i−x )2n i =1从而可以看出,在一元线性回归模型中,极大似然估计同最小二乘估计的结果是相同的,从而说明了极大似然估计在一元线性回归模型参数估计的中的适用性。
贝叶斯估计:考虑无信息先验分布下的贝叶斯估计. 参数 β1,β2,σ的先验分布分别为:π β1 ∝1,π β2 ∝1,π σ ∝1利用贝叶斯假设, 则参数 β1,β2,σ的先验分布为π β1,β2,σ ∝1/σ由极大似然估计给出的估计结果可以得到:()()()222121211*********ˆˆˆˆ11E E 111(,)(cov(,))11[()]()2ˆn n i i i i i i n n T i i T T n y x E y x n n ER E y y tr y y n n n tr I x x x x n trI n n n nσββββσσσ====-=⎛⎫=--=-- ⎪⎝⎭===-=--=∑∑∑∑所以可知不是σ 2的无偏估计,但是nn−2σ2就是σ 2的无偏估计了,其无偏估计量为:E (σ 无)=S 2=n n −2∗1n(y i −β1−β 2x i )2ni =1由()()()()221212112211ˆˆˆˆnnii i i i ii i y x y x x x ββββββββ==⎡⎤-------⎦-⎣=∑∑ 令121122ˆˆˆˆ,,i i i iA x xB y xC ββββββ---===- 整理得: ()22221211(222)nnii i i y x A B C AB AC BC ββ==--++--+=∑∑()()1211ˆˆ*ˆi i y x AB ββββ-=-- 将β 1=y −β 2x 代入,并两边同时求和得:()()()()12112212111121221222212221**ˆˆˆˆˆˆˆˆˆˆˆˆˆˆ]ˆ[0ˆn nniii i i i i n i i i i i i i AB y x y y x x y x y y y y x y yy y x x xy x x x x y x x ββββββββββββββββββββββ=====---=-+--+=--+-+-+-+--=∑∑∑∑同理,可得AC =0.()()()()()()()()()22221211221122112211111222211211211(2)22122(2)()2()(ˆˆˆˆˆˆˆˆ)ˆˆnni i i i nnnnni ii ii i i i i nni ii i i i y x A B C BC x x x x i in S n x x x x y x ββββββββββββββββββ=========--+++=-++-=-+-+=-+----∴∑∑∑∑∑∑--+∑∑所以似然函数可以写为: 1212221211(2)()22(,,),nexp n S L C ββσββπσσ⎛⎫⎧⎫--+⎨⎬ ⎪⎝⎩=⎭⎭其中()()()12222112112112()()2((ˆˆ)ˆˆ,)nni ii i i i C n x x x x ββββββββ===-++---∑∑根据贝叶斯定理, 参数12(,,)ββσ12(,,)ββσ的后验分布密度与似然函数12(,,)L ββσ和先验分布密度12(,,)πββσ的乘积成正比, 因此参数12(,,)ββσ的联合后验分布密度函数为2212121212111[(2)(,,|,)(()],,)(,,2),n exp n S x y C L πββσββσπββσββσσ+∝⎧⎫--+⎨⎩∝⎬⎭ 此时,令1/2212[(2)(),]n S C u ββ-+=然后,对上式进行对σ在R +的谨防,得到模型系数12(,)ββ的后验边缘分布密度函数1212112222/21(,|,),11[(2)()]2[(2)),(]n n Rx y exp n S C d n S C πββββσβσβσ++⎧⎫--+∝⎨⎬+∝-⎩⎭⎰式( 3)最后一项是自由度为( n- 2) , 位置参数为(β 1,β 2), 精度矩阵为(X T X )/S 2的二元t 分布密度函数的核, 其中X T =1⋯2x 1⋯x 2所以, 给定 x , y , 参数(β1,β2)服从二元 t 分布, 其后验边缘分布密度函数具体可写为()()/2(2)/221/212122(2)[/2]|()/|1,|,1(,)(2)/2(2)n n T n n X X S x y C n n S πββββπ---⎡⎤-Γ=+⎢⎥Γ--⎣⎦根据二元 t 分布的性质, 参数(β1,β2)的后验期望为E β1 x ,y =β 1, E β2 x ,y =β2, 因此, 在二次损失函数下 β1,β2的贝叶斯估计为 β 1=y −β 2x β 2= (x i −x )(y i −y )n i =1 (x i−x )2n i =1。
贝叶斯岭回归算法

贝叶斯岭回归算法全文共四篇示例,供读者参考第一篇示例:贝叶斯岭回归(Bayesian Ridge Regression)是一种用于进行回归分析的统计模型。
它是在贝叶斯框架下推导出来的一种回归算法,结合了岭回归和贝叶斯回归的优点,能够克服传统线性回归模型中存在的过拟合等问题。
贝叶斯岭回归的本质是在回归过程中引入了一个正则化项,通过对模型参数的先验分布进行建模,可以有效控制模型的复杂度,从而提高模型的泛化能力。
贝叶斯岭回归的核心思想是基于贝叶斯定理,通过期望最大化的方法来估计模型参数。
具体来说,贝叶斯岭回归假设模型参数服从某种概率分布,一般是高斯分布,然后通过最大化后验概率来估计参数。
在构建模型之前,需要设定一些先验分布的超参数,通常选择一个较为宽泛的先验分布,使得模型更具有鲁棒性。
与传统的岭回归相比,贝叶斯岭回归的一个重要优势是能够提供参数的置信区间。
传统的岭回归只能得到点估计的参数值,而贝叶斯岭回归可以得到参数的后验分布,从而可以计算得到参数的置信区间。
这对于统计推断和模型评估非常有帮助,可以帮助我们更好地了解参数的不确定性。
贝叶斯岭回归算法在实际应用中有着广泛的应用。
比如在金融领域,可以通过贝叶斯岭回归来建立股票价格预测模型,从而帮助投资者做出更明智的投资决策;在医学领域,可以利用贝叶斯岭回归来分析疾病的风险因素;在工程领域,可以利用贝叶斯岭回归来建立可靠的预测模型等等。
值得注意的是,贝叶斯岭回归在计算上相对复杂,需要进行概率推断,因此对于大规模数据集和高维特征空间来说,计算成本可能会较高。
模型的性能也会受到先验分布的选择和超参数的设定的影响,在实际应用中需要仔细调参和评估模型。
贝叶斯岭回归算法是一种强大的回归分析方法,可以有效地提高模型的泛化能力,并且能够提供参数的置信区间,对于一些需要进行统计推断的应用场景具有较高的价值。
在实际应用中,可以根据具体问题的特点选择合适的先验分布和超参数,从而得到更好的模型表现。
6.2 一元线性回归分析
2
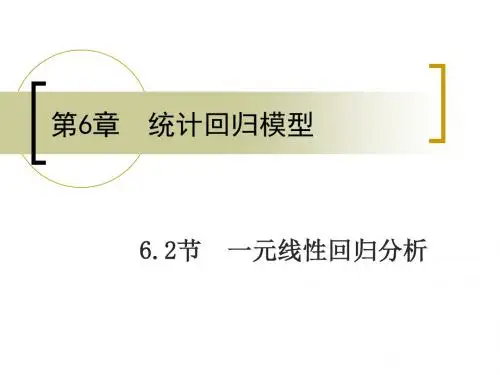
由(6.2.5)式,有恒等式 TSS=RSS+FSS
(6.2.6)
6.2.2 一元线性回归分析的原理 3. 决定系数
总平方和 TSS 表示没有使用自变量 x 的观测值, 仅由因变量 y 的观测值来预测 y 而产生的误差平方 和,注意总平方和只与因变量 y 的观测值有关,而与 自变量 x 无关; 残差平方和 RSS 表示使用自变量 x 和因变量 y 的观测值,由一元线性回归模型预测 y 而产生的误差 平方和; 回归平方和 FSS 表示由于使用一元线性回归模 型而使误差平方和下降的降幅.
6.2.2 一元线性回归分析的原理 4. 对自变量显著性的t检验
对于回归模型 y 0 1 x ,如果能由样本数 据 ( xi , yi )(i 1, 2, , n) 推断出拒绝原假设 H 0 : 1 0 而 采纳备择假设 H1 : 1 0 ,则可以认为在回归模型当 中,自变量 x 对因变量 y 的影响是显著的,也就是说 y 的观测值的平均值与 x 存在线性关系. 反之,如果 由样本数据推断出接受原假设 H 0 : 1 0 ,则可以认 为在回归模型当中,自变量 x 对因变量 y 的影响是不 显著的,也就是说 y 的观测值的平均值与 x 不存在线 性关系,一元线性回归模型不适用于该样本数据.
6.2.2 一元线性回归分析的原理 5. 对截距显著性的t检验
对于一元线性回归模型 y 0 1 x 和样本数 据 ( xi , yi )(i 1, 2, , n) ,给定显著性水平 α(默认值为 α=0.05) ,则截距 0 的 100(1−α)%置信区间为
n2) ( n2) [b0 t[( s , b t 2] b0 0 [ 2] sb0 ]
6.2.2 一元线性回归分析的原理 2. 最小二乘点估计
一元线性回归分析的作用方法步骤

一元线性回归分析的作用方法步骤一元线性回归分析是一种用于探究两个变量之间线性关系的统计方法。
它的作用是根据给定的自变量和因变量数据,建立一个线性回归模型,以预测未来的因变量值或者对自变量进行解释。
以下是一元线性回归分析的方法步骤:1. 收集数据:收集自变量(x)和因变量(y)的数据。
确保数据具有代表性,容量足够大,并且是可靠的。
2. 绘制散点图:根据所收集的数据,绘制自变量(x)和因变量(y)的散点图,以查看它们之间的大致关系。
3. 计算相关系数:计算自变量(x)和因变量(y)的相关系数,以评估它们之间的线性相关性。
通常使用皮尔逊相关系数来进行衡量。
4. 建立模型:使用最小二乘法来建立一元线性回归模型。
该模型的方程可表示为y = β₀+ β₁x,其中β₀是截距,β₁是斜率。
最小二乘法通过最小化残差平方和来确定最佳拟合的直线。
5. 评估模型:评估回归模型的拟合程度。
可以使用多种统计指标,如可决系数(R²)和均方根误差(RMSE),来评估模型的精度和稳定性。
6. 预测和推断:使用建立的回归模型进行预测和推断。
可以利用模型来预测因变量的值,或者对自变量进行解释和推断。
7. 检验假设:对回归系数进行假设检验,以判断自变量对因变量是否具有统计上显著的影响。
常见的方法是计算回归系数的t值和p值,并根据显著性水平来确定是否拒绝或接受假设。
8. 验证和诊断:验证回归模型的有效性和适用性。
可以使用残差分析、正态概率图和残差图等方法来检查模型的假设前提和模型的良好性。
以上是一元线性回归分析的一般方法步骤。
实际分析中,可能会根据具体问题进行调整和扩展。
一元线性回归模型的参数估计
斜率(β1)
表示 x 每变化一个单位,y 平均变化的数量。
一元线性回归模型的假设
线性关系
因变量 y 和自变量 x 之间存在线性关系。
误差项独立
误差项 ε 之间相互独 立,且与 x 独立。
误差项的正态性
误差项 ε 的分布是正 态的。
误差项的无偏性
误差项 ε 的期望值为 0,即 E(ε) = 0。
有限的方差
回归分析的分类
一元回归分析
研究一个自变量和一个因变量之间的关系。
多元回归分析
研究多个自变量和一个因变量之间的关系。
线性回归模型
线性回归模型是一种常用的回归分析方法,它假设自变量和因变量之间存在线性关系,即可以用一条 直线来描述它们之间的关系。
在一元线性回归模型中,自变量和因变量之间的关系可以表示为一条直线,即 y = ax + b,其中 a 是斜 率,b 是截距。
确定样本数据
收集用于估计参数的样本数据。
构建估计量
根据模型和样本数据构建用于估计参数的统计量。
计算估计值
通过计算统计量的值得到参数的估计值。
评估估计质量
通过统计检验和图形方法评估估计的质量和可靠性。
05 模型的评估与检验
模型的拟合度评估
决定系数(R^2)
衡量模型解释变量变异程度的指标,值越接 近1表示模型拟合度越好。
数据整理
将数据整理成适合进行统计分析 的格式,如表格或图形,以便后 续分析。
建立一元线性回归模型
确定自变量和因变量
根据研究问题选择合适的自变量和因变量,确 保它们之间存在一定的关联性。
散点图分析
绘制散点图,观察自变量和因变量之间的关系, 初步判断是否适合建立一元线性回归模型。
2019年高中数学第8章统计与概率8.5一元线性回归案例讲义含解析湘教版选修2_3
8.5一元线性回归案例[读教材·填要点]1.相关系数(1)定义:样本容量是n 的成对观测数据,用(x 1,y 1),(x 2,y 2),…,(x n ,y n )表示,用{}xi 表示数据x 1,x 2,…,x n ,用{}yi 表示数据y 1,y 2,…,y n ,用x 与y 分别表示{}xi 和{}yi 的均值,用s x 表示{}xi 的标准差,用s y 表示{}yi 的标准差,再引入:s xy =x1y1+x2y2+…+xnynn-x y .当s x s y ≠0时,称r xy=∑i =1n-x-y∑i =1n-x∑i =1n-y=∑i =1nxiyi -n xy⎝ ⎛⎭⎪⎪⎫∑i =1n x2i -n x 2⎝ ⎛⎭⎪⎪⎫∑i =1ny2i -n y 2=sxy sxsy 为{}xi 和{}yi 的相关系数.;正相关{}yi 和{}xi 时,我们称>0xy r 当① ;负相关{}yi 和{}xi 时,我们称<0xy r 当② 不相关.{}yi 和{}xi 时,我们称0=xy r 当③(2)性质:中取值;1,1]-[总在区间xy r ①,这时数增加也倾向于y ,增加x 的线性相关程度越强,且y ,x 时,1越接近于xy r 当②附近.一条上升的直线分散在)n y ,n x (,…,)2y ,2x (,)1y ,1x (据③当r xy 越接近于-1时,x ,y 的线性相关程度越强,且x 增加,y 倾向于减少,这时数附近.一条下降的直线分散在)n y ,n x (,…,)2y ,2x (,)1y ,1x (据④当r xy 越接近于0时,x ,y 的线性相关程度越弱.2.一元线性回归(1)回归直线方程:l :y ^=bx +a ,其中b =sxy s2x,a =y -b x .(2)一元线性回归模型:若样本量n 的成对观测数据,),n ,…,1,2=i (i e +a +i bx =i y 满足关系:i x 和i y 中)n y ,n x (,…,)2y ,2x (,)1y ,1x (,则称该模型为一元线性回归模型.随机误差表示n e ,…,2e ,1e 其中[小问题·大思维]1.|r xy |越接近1,及越接近于0,表示两个变量x 与y 之间线性相关程度如何?提示:|r xy |越接近1,表明两个变量的线性相关程度越强,它们的散点图越接近于一条直线,这时用线性回归模型拟合这组数据的效果就越好;|r xy |越接近0,表明两个变量的线性相关程度越弱,通常|r xy |>0.8时,认为有很强的相关关系. 2.在一元线性回归模型中,变量y 由变量x 唯一确定吗?提示:不唯一.y 值由x 和随机误差e 共同确定,即自变量x 只能解释部分y 的变化.3.随机误差e 产生的主要原因有哪些? 提示:随机误差e 产生的主要原因有:(1)所用的确定性函数不恰当引起的误差;(2)忽略了某些因素的影响;(3)存在观测误差.4.回归分析中,利用线性回归方程求出的函数值一定是真实值吗?为什么?提示:不一定是真实值.利用线性回归方程求的值,在很多时候是个预报值,例如,人的体重与身高存在一定的线性关系,但体重除了受身高的影响外,还受其他因素的影响,如饮食,是否喜欢运动等.[例1] 某班5(1)画出散点图;(2)求物理成绩y 对数学成绩x 的线性回归方程;(3)一名学生的数学成绩是96,试预测他的物理成绩.[解] (1)散点图如图.(2)x =15×(88+76+73+66+63)=73.2,y =15×(78+65+71+64+61)=67.8.∑i =15x i y i =88×78+76×65+73×71+66×64+63×61=25 054.∑i =15x2i =882+762+732+662+632=27 174.所以b =∑i =15xiyi -5xy∑i =15x2i -5x 2=25 054-5×73.2×67.827 174-5×73.22≈0.625.a =y --b x -≈67.8-0.625×73.2=22.05.所以y 对x 的回归直线方程是y =22.05+0.625x .(3)x =96,则y =0.625×96+22.05≈82,即可以预测他的物理成绩是82.1.回归直线方程中系数的两种求法(1)公式法:利用公式,求出回归系数b ,a .(2)待定系数法:利用回归直线过样本点中心(x -,y -)求系数.2.回归分析的两种策略(1)利用回归方程进行预测:把回归直线方程看作一次函数,求函数值.(2)利用回归直线判断正、负相关:决定正相关还是负相关的是回归系数b .1.从某居民区随机抽取10个家庭,获得第i 个家庭的月收入x i (单位:千元)与月储蓄y i (单位:千元)的数据资料,算得∑i =110x i =80,∑i =110y i =20,∑i =110x i y i =184,∑i =110x2i =720.(1)求家庭的月储蓄y 对月收入x 的线性回归方程y =bx +a ;(2)判断变量x 与y 之间是正相关还是负相关;(3)若该居民区某家庭月收入为7千元,预测该家庭的月储蓄.附:线性回归方程y =bx +a 中,b =∑i =1nxiyi -n x - y-∑i =1nx2i -n x -2,a =y --b x -,其中x -,y -为样本平均值.解:(1)由题意知n =10,x =1n ∑i =1n x i =8010=8,y -=1n ∑i =1n y i =2010=2.又∑i =1nx2i -n x -2=720-10×82=80, ∑i =1n x i y i -n x-y -=184-10×8×2=24,由此可得b =∑i =1nxiyi -n x - y-∑i =1nx2i -n x -2=2480=0.3,a =y --b x -=2-0.3×8=-0.4,故所求回归方程为y =0.3x -0.4.(2)由于变量y 的值随x 的值增加而增加(b =0.3>0),故x 与y 之间是正相关.(3)将x =7代入回归方程可以预测该家庭的月储蓄为y =0.3×7-0.4=1.7(千元).[例2][解] x -=17×(21+23+25+27+29+32+35)≈27.4,y -=17×(7+11+21+24+66+115+325)≈81.3,∑i =17x2i =212+232+252+272+292+322+352=5 414,∑i =17x i y i =21×7+23×11+25×21+27×24+29×66+32×115+35×325=18 542,∑i =17y2i =72+112+212+242+662+1152+3252=124 393,∴r =∑i =17xiyi -7x -y-∑i =17x2i -7x -∑i =17y2i -7y -=18 542-7×27.4×81.3414--≈0.837 5.由于r ≈0.837 5与1比较接近,∴x 与y 具有线性相关关系.回归分析是定义在具有相关关系的两个变量的基础上的,对于相关关系不明确的两个变量,可先作散点图,由图粗略的分析它们是否具有相关关系,在此基础上,求其回归方程,并作回归分析.2.某厂的生产原料耗费x (单位:百万元)与销售额y (单位:百万元)之间有如下的对应关系:解:画出(x ,y )的散点图,如图所示,由图可知x ,y 呈现线性相关关系.x -=5,y -=47.5,∑i =14x2i =120,∑i =14y2i =9 900,∑i =14x i y i =1 080,r =∑i =14xiyi -4x - y-∑i =14x2i -4x -∑i =14y2i -4y -=1 080-4×5×47.5--≈0.982 7.故x 与y 之间存在线性相关关系.[例3](2)求y 与x 之间的回归方程. [解] (1)散点图如图所示:(2)由散点图看出样本点分布在一条指数函数y =c 1e 图像的周围,于是令z =ln y ,则=e0.69x +1.112.非线性回归问题一般不给出经验公式,这时,应先画出已知数据的散点图,把它与所学过的各种函数图像作比较,挑选一种跟这些散点图拟合得最好的函数,采用适当的变量置换,把问题化为线性回归分析问题,使问题得以解决.3.在一次抽样调查中测得样本的5个样本点,数值如下表:x 之间的回归方程.解:由数值表可作散点图如下根据散点图可知y 与x 近似地呈反比例函数关系,设y =k x ,令t =1x ,则y =kt ,原数据变为由散点图可以看出y 与t 呈近似的线性相关关系.列表如下所以t =1.55,y -=7.2.所以b =∑i =15tiyi -5t - y-∑i =15t2i -5t -2=4.134 4.a =y -bt=0.8.所以y =0.8+4.134 4t .所以y 对x 的回归方程是y =0.8+4.134 4x.1.下列说法中正确的是( )A .y =2x 2+1中的x ,y 是具有相关关系的两个变量B .正四面体的体积与其棱长具有相关关系C .电脑的销售量与电脑的价格之间是一种确定性的关系D .传染病医院感染甲型H1N1流感的医务人员数与医院收治的甲型流感人数是具有相关关系的两个变量解析:选D 感染的医务人员不仅受医院收治的病人数的影响,还受防护措施等其它因素的影响.2.设(x 1,y 1),(x 2,y 2),…,(x n ,y n )是变量x 和y 的n 个样本点,直线l 是由这些样本点通过最小二乘法得到的线性回归直线(如图),以下结论中正确的是( )A .x 和y 的相关系数为直线l 的斜率B .x 和y 的相关系数在0到1之间C .当n 为偶数时,分布在l 两侧的样本点的个数一定相同D .直线l 过点(x -,y -)解析:选D 回归直线过样本中心点(x -,y -).3.为了解儿子身高与其父亲身高的关系,随机抽取5对父子的身高数据如下:( )A.y ^=x -1B.y ^=x +1C.y ^=88+12x D.y ^=176解析:选C 设y 对x 的线性回归方程为y ^=bx +a ,因为b =sxy s2x =12,a =176-12×176=88,所以y 对x 的线性回归方程为y ^=12x +88.4.在关于两个变量的回归分析中,作散点图的目的是________________________.答案:观察两个变量之间是否存在线性相关关系5.某服装厂的产品产量x (万件)与单位成本y (元/件)之间的回归直线方程是y =52.15-19.5x ,当产量每增加一万件时,单位成本下降________元.解析:由回归系数的意义得下降19.5元.答案:19.56.在一段时间内,分5次测得某种商品的价格x (万元)和需求量y (t)之间的一组数据为:已知∑i =1x i y i =62,∑i =15x2i =16.6.(1)画出散点图;(2)求出y 对x 的回归方程;(3)如价格定为1.9万元,预测需求量大约是多少?(精确到0.01 t).解:(1)散点图如下图所示:(2)因为x =15×9=1.8,y =15×37=7.4,∑i =15x i y i =62,∑i =15x2i =16.6,s xy =∑i =15xiyi5-x y =12.4-13.32=-0.92.所以b =sxy s2x =-0.920.08=-11.5,a =y -b x =7.4+11.5×1.8=28.1,故y 对x 的回归方程为y ^=28.1-11.5x .(3)y ^=28.1-11.5×1.9=6.25(t).一、选择题1.下表是x 与y 之间的一组数据,则y 关于x 的线性回归方程必过( )A.点(2,2)C .点(1,2)D .点(1.5,4)解析:选D x =0+1+2+34=64=1.5,y =1+3+5+74=4,∴线性回归方程必过点(1.5,4).2.已知变量x 和y 满足关系y ^=-0.1x +1,变量y 与z 正相关.下列结论中正确的是( )A .x 与y 正相关,x 与z 负相关B .x 与y 正相关,x 与z 正相关C .x 与y 负相关,x 与z 负相关D .x 与y 负相关,x 与z 正相关解析:选C 因为y =-0.1x +1的斜率小于0,故x 与y 负相关.因为y 与z 正相关,可设z =b ^y +a ^,b ^>0,则z =b ^y +a ^=-0.1b ^x +b ^+a ^,故x 与z 负相关.3.某医学科研所对人体脂肪含量与年龄这两个变量研究得到一组随机样本数据,运用Excel 软件计算得y ^=0.577x -0.448(x 为人的年龄,y 为人体脂肪含量).对年龄为37岁的人来说,下面说法正确的是( )A .年龄为37岁的人体内脂肪含量都为20.90%B .年龄为37岁的人体内脂肪含量为21.01%C .年龄为37岁的人群中的大部分人的体内脂肪含量为20.90%D .年龄为37岁的大部分的人体内脂肪含量为31.5%解析:选C 当x =37时,y =0.577×37-0.448=20.901≈20.90,由此估计:年龄为37岁的人群中的大部分人的体内脂肪含量为20.90%.4.某产品的广告费用x 与销售额y 的统计数据如下表:根据上表可得回归方程y =bx +a 中的b 为9.4,据此模型预报广告费用为6万元时销售额为( )A .63.6万元B .65.5万元C .67.7万元D .72.0万元解析:选B 样本中心点是(3.5,42),则a =y --b x -=42-9.4×3.5=9.1,所以回归直线方程是y =9.4x +9.1,把x =6代入得y =65.5.二、 填空题5.调查了某地若干户家庭的年收入x (单位:万元)和年饮食支出y (单位:万元),调查显示年收入x 与年饮食支出y 具有线性相关关系,并由调查数据得到y 对x 的回归直线方程:y ^=0.254x +0.321.由回归直线方程可知,家庭年收入每增加1万元,年饮食支出平均增加________万元.解析:以x +1代x ,得y =0.254(x +1)+0.321,与y =0.254x +0.321相减可得,年饮食支出平均增加0.254万元.答案:0.2546.下表是某厂1~4月份用水量(单位:百吨)的一组数据,由某散点图可知,用水量y 与月份x 之间有较好的线性相关关系,其线性回归方程是y ^=-0.7x +a ,则a =________.解析:x =2.5,y =3.5,b =-0.7,∴a =3.5+0.7×2.5=5.25.答案:5.257.已知回归直线的斜率的估计值为 1.23.样本点的中心为(4,5),则回归直线方程是________________.解析:由斜率的估计值为1.23,且回归直线一定经过样本点的中心(4,5),可得y -5=1.23(x -4),即y ^=1.23x +0.08.答案:y ^=1.23x +0.088.在研究硝酸钠的可溶性程度时,观察它在不同温度的水中的溶解度,得观测结果如下:.解析:根据s xy =∑ni =1xiyi n -x y ,及b =sxys2x,得b =0.880 9. 答案:0.880 9三、解答题9.在关于人体的脂肪含量(百分比)和年龄关系研究中,研究人员获得了如下一组数据:(2)求y 与x 之间的回归方程;(3)预测39岁的人脂肪含量.(保留四位有效数字)解:(1)画出散点图(2)由散点图可以看出y 与x 之间有较强的线性相关关系,可算得x =111∑i =111x i ≈44.545 5,y =111∑i =111y i ≈25.336 4,∑i =111x i y i =13 205,∑i =111x2i =23 224,∴b =sxys2x≈0.565 7,a =y -b x ≈0.137 0.∴y 与x 之间的线性回归方程为y ^=0.565 7x +0.137 0.(3)当x =39时,y =0.565 7×39+0.137 0≈22.20,∴39岁的人的脂肪含量约为22.20%.10.(2016·全国卷Ⅲ)下图是我国2008年至2014年生活垃圾无害化处理量(单位:亿吨)的折线图.(1)由折线图看出,可用线性回归模型拟合y 与t 的关系,请用相关系数加以说明;(2)建立y 关于t 的回归方程(系数精确到0.01),预测2016年我国生活垃圾无害化处理量.参考数据:∑i =17y i =9.32,∑i =17t i y i =40.17,∑i =17-y =0.55,7≈2.646.参考公式:相关系数r=∑i =1n-t-y∑i =1n-t∑i =1n-y,回归方程y ^=a ^+b ^t 中斜率和截距的最小二乘估计公式分别为b ^=∑i =1n-t -y∑i =1n-t,a ^=y -b ^t .解:(1)由折线图中数据和附注中参考数据得t =4,∑i =17(t i -t )2=28,∑i =17-y =0.55,∑i =17(t i -t)(y i -y )=∑i =17t i y i -t ∑i =17y i =40.17-4×9.32=2.89,r ≈2.892×2.646×0.55≈0.99.因为y 与t 的相关系数近似为0.99,说明y 与t 的线性相关程度相当高,从而可以用线性回归模型拟合y 与t 的关系.(2)由y =9.327≈1.331及(1)得b ^=∑i =17-t-y∑i =17-t=2.8928≈0.103,a ^=y -b ^t ≈1.331-0.103×4≈0.92.所以y 关于t 的回归方程为y ^=0.92+0.10t .将2018年对应的t =9代入回归方程得y ^=0.92+0.10×9=1.82.所以预测2018年我国生活垃圾无害化处理量将约为1.82亿吨.。
一元线性回归分析PPT课件
拟合程度评价
拟合程度是指样本观测值聚集在样本回归线周围的紧
密程度. ( Y t Y ) ( Y ˆ t Y ) ( Y t Y ˆ t)
n
n
n
(Y t Y )2 (Y ˆt Y )2 (Y t Y ˆ)2
t 1
t 1
t 1
n
(Yt Y)2 :总离差平方和,记为SST;
t1
n
第8页/共40页
例
食品序号 1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16
求和
脂肪Xt 4 6 6 8 19 11 12 12 26 21 11 16 14 9 9 5
热量Yt 110 120 120 164 430 192 175 236 429 318 249 281 160 147 210 120
第1页/共40页
回归分析的分类
一个自变量
一元回归
回归分析
两个及以上自变量
多元回归
线性 回归
非线性 回归
线性 回归
非线性 回归
第2页/共40页
一元线性回归模型
(一)总体回归函数
Yt=0+1Xt+ut
ut是随机误差项,又称随机干扰项,它是一个特殊的 随机变量,反映未列入方程式的其他各种因素对Y的 影响。
(ˆ1t(n2)Sˆ1)
2
第15页/共40页
回归分析的Excel实现
“工具”->“数据分析”->“回归”
第16页/共40页
ˆ 0
S ˆ 0
ˆ 1
S ˆ 1
(ˆ0t(n2)Sˆ0)
2
(ˆ1t(n2)Sˆ1)
2
第17页/共40页
基于MCMC算法的多元线性回归变点模型的贝叶斯估计
收稿日期:2020-04-13基金项目:国家自然科学基金青年项目(11801488);新疆师范大学重点实验室招标课题(XJNUSYS082019B05);新疆师范大学重点实验室项目(XJNUSYS082018A01);新疆师范大学教改工程项目(SDJG2018-46)作者简介:刘贞(1996-),女,硕士研究生,主要研究方向为数理统计通信作者:周菊玲(1968-),女,副教授,主要研究方向为概率论与数理统计基于MCMC 算法的多元线性回归变点模型的贝叶斯估计刘贞,周菊玲,董翠玲(新疆师范大学数学科学学院,乌鲁木齐830017)摘要:基于MCMC 算法,研究了多元线性回归系数变点模型的贝叶斯估计问题.首先由所有参数的联合后验分布得到各参数的满条件后验分布,再利用Gibbs 抽样和MH 算法相结合的MCMC 算法对满条件分布抽取样本,最后得到变点位置及其他参数的贝叶斯估计.随机模拟结果显示用该方法估计各参数的效果较好.关键词:多元线性回归;MCMC 算法;满条件分布;贝叶斯估计中图分类号:O 212.8文献标识码:ABayesian Estimation of Change-Point Model for Multiple LinearRegression Based on MCMC AlgorithmLIU Zhen ,ZHOU Juling ,DONG Cuiling(School of Mathematical Sciences ,Xinjiang Normal University ,Urumqi 830017,China )Abstract :Based on the MCMC algorithm ,the Bayesian estimation problem of the change-point model of multiple linear regression coefficients is studied.First ,the full-condition posterior distribution of each parameter is obtained from the joint posterior distribution of all parameters.Then each parameter is sampled from the full condition distribution by using MCMC algorithm combining Gibbs sampling and MH algorithm.Finally the Bayesian estimation of the change-point position and other parameters are obtained.The random simulation results show that the method is better for estimating each parameter.Key words :multiple linear regression ;MCMC algorithm ;full conditional distribution ;Bayesian estimation变点问题在经济、金融、医学、工程等领域应用广泛,是统计学中比较热门的研究方向之一.线性回归模型自19世纪发展以来就被广泛应用于各学科中.王振友和陈莉娥运用多元线性回归方法,建立了俄亥俄州臭氧含量与气象的回归方程[1].周晨等分析了多元线性回归模型在东北地区需水量中的应用[2].王培冬基于多元线性回归模型,分析及预测了沪深股价[3].袁水林利用多元线性回归模型,探讨了企业更有效的物流成本管理方法及对企业效益的影响动因[4].王康慧通过建立多元线性回归模型验证了工业、最终消费以及货币M2对我国GDP 的增长有较为显著的影响[5].近年关于线性回归系数变点模型问题的研究,主要有两种方法.一是通过构造统计量对变点进行检测.如Liu 等提出了一种新的经验似然比检验统计量来检验线性回归模型的回归系数变点问题[6].陈占寿等通过引进一个窗宽参数,对线性回归模型系数变点和方差变点进行在线监测[7].秦瑞兵等提出了两个基于回归残差的平方累积和的比值型监测统计量,并在这两个统计量的基础上讨论了线性回归模型系数变点的在线监测问题[8].杨兆新等在构建分位数LASSO 估计量的基础上研究了线性回归模型变点位置的估计问题[9].二是利用贝叶斯方法估计变点位置等未知参数.如Tang 等主要讨论了在先验分布为beta-binomial 分布和幂型先验的条件下,一元线性回归模型变点的贝叶斯估计[10].杨丰凯和袁海静基于非迭代IBF 抽样算法,详细讨论了线性回归模型中回归系数变点的贝叶斯估计问题[11].贝叶斯方法需要对后验分布进行计算,目前MCMC 算法因为能够高效处理复杂问题和程序相对容易等优点被广泛应用于贝叶斯方法中.关于利用贝叶斯方法研究线性回归变点的文献中,Tang 等[10]主要侧重于变点模型先验分布的选择,未详细介绍其算法,杨丰凯等[11]主要讨论了IBF 算法.本文在前人学者的研究基础上,研究了基于MCMC 算法的多元线性回归系数变点模型的贝叶斯估计,并对位置参数和其他参数做了随机模拟.1多元线性回归变点模型多元线性回归变点模型可用如下模型表示:对于序列y i ,i =1,…,n ,存在整数r ,p ≤r ≤n -p ,使得ìíîy i =x T i β1+εi , i =1,…,r ,y i =x Ti β2+εi , i =r +1,…,n ,εi ~N ()0,σ2, i =1,…,n ,(1)其中εi ,i =1,…,n 相互独立;自变量x T i =()1,x i 1,…,x i ,p -1,i =1,2,…,n ;p 维回归系数β1=()β11,β12,∙∙∙,β1p T,β2=()β21,β22,…,β2p T;N ()0,σ2表示均值为零,方差为σ2的正态分布.对于一般的正态分布N ()μ,σ2,其密度函数为f ()x |μ,σ2=12p σe-()x -μ22σ2,-∞<x <∞.进一步,(1)式可以写成ìíîïïy i ~N ()x T i β1,σ2, i =1,…,r ,y i ~N ()x T i β2,σ2, i =r +1,…,n ,εi ~N ()0,σ2, i =1,…,n ,(2)其中:y i ,i =1,…,n 相互独立.称(2)式为多元线性回归系数变点模型.2贝叶斯估计记y =()y 1,y 2,…,y n T,x =()x 1,x 2,…,x n T,由正态分布的密度函数和(2)式可以得到多元线性回归变点模型的似然函数为L ()|y β1,β2,σ2,r ,x =∏i =1r 12p σe-()y i -x T i β122σ2∏i =r +1n12p σe-()y i -x T i β222σ2.对于未知参数β1,β2,σ2,r 在此取如下先验分布.1)对于参数β1,β2和r 取无信息先验分布:p ()β1∝1,p ()β2∝1,p ()r =1n -2p +1.2)对于参数σ2取共轭先验分布:p ()σ2∝IG ()a ,b .假设参数β1,β2,σ2,r 相互独立,a ,b 为已知超参数且a >0,b >0.其中∝为正比符号,IG ()a ,b 表示参数为a ,b 的逆伽马分布,其密度函数为引用格式:刘贞,周菊玲,董翠玲.基于MCMC 算法的多元线性回归变点模型的贝叶斯估计[J ].河南科学,2020,38(8):1210-1214.--1211第38卷第8期河南科学2020年8月f ()σ2|a ,b =ìíîïïb a Γ()a ()σ2-()a +1e -bσ2,σ2>0,0, 其他.2.1满条件分布根据贝叶斯公式[12],由样本的似然函数和各参数的先验分布可以得到()β1,β2,σ2,r 的联合后验分布为:p ()β1,β2,σ2,r |x ,y ∝L ()|y β1,β2,σ2,r ,x p ()β1p ()β2p ()σ2p ()r ∝∏i =1r1σe-()y i -x T i β122σ2∏i =r +1n1σe-()y i -x T i β222σ2()σ2-()a +1e-b σ2=e-12σ2∑i =1r()y i -x T i β12e-12σ2∑i =r +1n()y i -x T i β22()σ2-æèöøn 2+a +1e-bσ2.下面求各参数的满条件后验分布.1)设X 1=()x 1,x 2,…,x r T,Y 1=()y 1,y 2,…,y r T,Σ-11=X T 1X 1,Z 1=Σ1X T 1Y 1.由联合后验分布得p ()β1|β2,σ2,r ,x ,y ∝e-12σ2∑i =1r()y i -x T i β12∝e-12σ2()X 1β1-Y 1T()X 1β1-Y 1∝e-12σ2()β1-Z 1TΣ-11()β1-Z 1.于是β1的满条件分布:β1|β2,σ2,r ,x ,y ~N ()Z 1,σ2Σ1.(3)2)同样的,设X 2=()x r +1,x r +2,…,x n T,Y 2=()y r +1,y r +2,…,y n T,Σ-12=X T 2X 2,Z 2=Σ2X T2Y 2.由联合后验分布得p ()β2|β1,σ2,r ,x ,y ∝e-12σ2∑i =r +1n()y i -x T i β22∝e-12σ2()X 2β2-Y 2T()X 2β2-Y 2∝e-12σ2()β2-Z 2T Σ-12()β2-Z 2,于是β2的满条件分布:β2|β1,r ,σ2,x ,y ~N ()Z 2,σ2Σ2.(4)3)由联合后验分布得p ()|σ2β1,β2,r ,x ,y =e-12σ2∑i =1r()y i -x T i β12e-12σ2∑i =r +1n()y i -x T i β22()σ2-æèöøn 2+a +1e -bσ2=()σ2-æèöøn 2+a +1e-1σ2æèççççöø÷÷÷÷∑i =1r()y i -x T i β122+∑i =r +1n ()y i -x T i β222+b .于是σ2的满条件分布:|σ2β1,β2,r ,x ,y ~IG æèççöø÷÷n 2+a ,∑i =1r ()y i -x T i β122+∑i =r +1n ()y i -x T i β222+b .(5)4)由联合后验分布得r 的满条件分布:p ()r |β1,β2,σ2,x ,y ∝e-12σ2∑i =1r()y i -x T i β12e-12σ2∑i =r +1n()y i -x T i β22.(6)--12122.2MCMC 抽样由文献[13-15]中关于MCMC 方法的基本理论,可以得到具体的MCMC 抽样步骤.先给定各参数的初值æèçöø÷β()01,β()02,()σ2()0,r ()0,再由各参数的满条件后验分布可以得到第t 次迭代过程如下:步骤1根据β1的满条件后验分布(3)式抽取β()t -11.步骤2根据β2的满条件后验分布(4)式抽取β()t -12.步骤3根据σ2的满条件后验分布(5)式抽取()σ2()t -1.步骤4根据r 的满条件后验分布(6)式,选取建议分布q ()r()t -1,r ′为取值p ,…,n -p 离散均匀分布,即q ()r()t -1,r ′=1n -2p +1,并从q ()r ()t -1,r ′生成一个备选值r ′.令s ()r ()t -1,r ′=min {}p ()r ′|β1,β2,σ2,x ,y /p ()r ()t -1|β1,β2,σ2,x ,y ,1,从U ()0,1中产生一个随机数u ,若u ≤s ()r ()t -1,r ′,则r ()t =r ′,否则r ()t =r ()t -1.3随机模拟本文使用R 软件进行随机模拟,利用Gibbs 抽样和M-H 算法相结合的MCMC 算法讨论多元线性回归变点的位置参数和其他参数的贝叶斯估计效果.考虑如下一元线性回归变点模型:ìíîy i =β11+β12x i +εi , i =1,…,r ,y i =β21+β22x i +εi , i =r +1,…,n ,εi ~N ()0,σ2,i =1,…,n .假设εi ,i =1,…,n 相互独立.在此取样本总数n =300,各参数的真实值β11=2,β12=1,β21=3,β22=2,σ2=1,r =120,超参数a =2,b =2.假设迭代过程重复104次,由各参数的满条件后验分布便可以得到104个独立同分布的随机样本,舍去产生的前5000个样本,取后M =5000个作为有效样本.取M 个样本的均值作为各参数的贝叶斯估计,并用β()t ij ()i =j =1,2,()σ2()t ,r ()t 的均方误差的平方根(RMS )来衡量估计的精度,RMS 越小估计的精度越高.即l =1M ∑t =1Ml ()t ,RMS=其中:l 表示待估参数的真值;l 表示该参数的贝叶斯估计;l ()t 表示第t 次迭代该参数产生的样本.模拟结果如表1所示.表1随机模拟结果Tab.1Stochastic simulation results参数r σ2β11β12β21β22真值12012132均值120.15401.03541.94820.98803.07871.98112.5%分位数1190.88301.76260.95012.92771.9499中位数1201.02981.94920.98803.07951.981297.5%分位数1211.21652.13701.02473.23062.0131RMS0.67820.09200.10810.02240.10970.0250MCMC 算法很重要的一个问题是收敛性诊断,如果用MCMC 方法生成的马尔可夫链不收敛,则得到的后验估计将是不可靠的.MCMC 算法收敛性的诊断一是判断由MCMC 方法抽样生成的马尔可夫链是否已经收引用格式:刘贞,周菊玲,董翠玲.基于MCMC 算法的多元线性回归变点模型的贝叶斯估计[J ].河南科学,2020,38(8):1210-1214.--1213第38卷第8期河南科学2020年8月敛到平稳分布,二是判断由MCMC 方法抽样生成的马尔可夫链的样本均值是否已经收敛到遍历均值[13].一般常用的方法是画出待估参数模拟得到的马尔可夫链的迭代图,通过迭代图可以直观地发现不正常或不平稳的状态,同时也可以对待估参数取不同初值,产生多条马尔可夫链,在一段时间后,若几条链逐渐稳定并且趋于重合,则说明抽样收敛.因参数较多,本文只列出参数变点位置r 的马尔可夫链迭代图,见图1和图2.从表1可以看到,各参数的估计值与真值很接近,RMS 均不超过0.7,估计精度较高.从图1可以看出,r 的马尔可夫链在迭代过程中比较稳定,从图2可以看出,r 的两条马尔科夫链稳定且趋于重合,说明马尔可夫链收敛,得到的估计是有效的.因此,随机模拟实验的效果较好.4结论本文结合贝叶斯方法和MCMC 算法得到了多元线性回归变点模型的变点位置参数和系数参数的贝叶斯估计.在随机模拟实验中,通过讨论贝叶斯估计的精度及MCMC 算法的收敛性,最终结果表明了该算法的有效性.参考文献:[1]王振友,陈莉娥.多元线性回归统计预测模型的应用[J ].统计与决策,2008,24(5):46-47.[2]周晨,冯宇东,肖匡心,等.基于多元线性回归模型的东北地区需水量分析[J ].数学的实践与认识,2014,44(1):118-123.[3]王培冬.基于多元线性回归的股价分析及预测[J ].科技经济市场,2020,36(1):84-85.[4]袁水林.企业物流成本对企业效益影响的多元线性回归分析[J ].统计与决策,2019,35(4):186-188.[5]王康慧.我国GDP 增长率影响因素回归分析[J ].中国管理信息化,2020,23(5):171-175.[6]LIU Y K ,ZOU C L ,ZHANG R C.Empirical likelihood ratio test for a change-point in linear regression model [J ].Communications in Statistics :Theory and Methods ,2008,37(16):2551-2563.[7]陈占寿,田铮,丁明涛.线性回归模型参数变点的在线监测[J ].系统工程理论与实践,2010,30(6):1047-1054.[8]秦瑞兵,孙丽,宋冠仪.线性回归模型系数变点的在线监测[J ].陕西科技大学学报,2020,38(1):175-179.[9]杨兆新,魏岳嵩,贾伟亚.线性回归模型变点位置估计的收敛速度[J ].淮北师范大学学报(自然科学版),2020,41(1):12-17.[10]TANG Y C ,WANG P P ,CHEN H.Bayesian analysis for change-point linear regression models [J ].应用概率统计,2015,31(1):89-102.[11]杨丰凯,袁海静.回归系数变点估计的快速非迭代抽样算法[J ].统计与决策,2017,33(24):10-13.[12]茆诗松,王静龙,濮晓龙.高等数理统计[M ].北京:高等教育出版社,2006.[13]刘金山,夏强.基于MCMC 算法的贝叶斯统计方法[M ].北京:科学出版社,2016.[14]孙玫.MCMC 算法及其应用[J ].应用数学进展,2018,7(12):1626-1637.[15]韩忠明,段大高.数据分析与R [M ].北京:北京邮电大学出版社,2014.(编辑张继学)图1r 的马尔可夫链迭代图Fig.1Markov chain iteration diagram of r 125120115110变点位置r0200040006000800010000迭代次数图2r 的多条马尔可夫链迭代图Fig.2Multiple Markov chains iteration diagram of r125120115110变点位置r0200040006000800010000迭代次数链1链2--1214。