
算法6--哈夫曼树
6 4 1 (3) WPL =6+4*2+(1+2)*3=23 2
根据定义求Huffman树的方法是:对给定的n个叶子结点 (外部结点),构造出全部二叉树并求出其WPL,然后找出 WPL最小的树。当n较大时,显然这种方法是不可取的。
二、构造huffman树算法
算法思想:
1.
根据权值{w1 , w2 ,…, wn}构造n个二叉树F={T1 ,
W={ 5, 15, 40, 30, 10 }
100
Y
a<60 N
a<70 N a<80 N a<90 N A
Y C Y B Y
70a<80
60
B
40 C 30
E Y D Y
N
80a<90 N 60a<70 N
30
D
15
E
15 5 10 A
C
Y B
D
Y
E
a<60 N A
输入10000个数据比较的总次数由31500次变为22000次。 WPL=5x4+10x4+15x3+30x2+40x1=205
6.7.2. Huffman编码
(一) 等长编码
假设要发送的数据中可能出现的字 符只有 4个:A、B、C、D,则可用 2位 二进制数进行编码,如图:
A B C D 00 01 10 11
若要发送的数据是:“ A B C D ”
编码:“00011011”
怎样缩短电文的总长度? 可缩短 每个字符的编码。如:
}
//从叶子到根逆向求每个字符的哈夫曼编码
HC=(HuffmanCode)malloc((n十1)*sizeof(char*));
//分配n个字符编码的头指针向量 cd=(char*)malloc(n*sizeof(char)); //分配求编码的工作空间 cd[n-1]="\0";; //编码结束符 for(i=1;i<=n;++i){ //逐个字符求哈夫曼编码 start=n-1; //编码结束符位置 for(c=i,f=HT[i].parent;f!=0;c=f,f=HT[f].parent) //从叶子到根逆向求编码 if(HT[f].lchild==c) cd[--start]="0"; else cd[--start]="1"; HC[i]=(char*)malloc((n—start)*sizeof(char)); //为第i个字符编码分配空间 strcpy(Hc[i],&cd[start]); //从cd复制编码(串)到Hc } free(cd); //释放工作空间 } //HuffanCoding
//——哈夫曼树和哈夫曼编码的存储表示——
typedef struct{
unsigned int weight;
unsigned int parent,lchild,rchild;
}HTNode,*HuffmanTree;
//动态分配数组存储哈夫曼树
typedef char **HuffmanCode;
6.7 哈夫曼树
David Huffman
6.7.1 Huffman树
问题提出:在数据通信中,用二进制给每个字 符编码,如何使电文总长最短且不产生二义性?
根据字符出现频率,利用Huffman树可以构造一种 不等长的二进制编码,并且构造所得的Huffman编码是 一种最优前缀编码,即使所传电文的总长度最短。任 何一个字符的编码都不是同一字符集中另一个字符的 编码的前缀。
29 14
29
15 23 7 8
42 19 11 5 8 3
42 23 11 19 29
58 29 14 3 15
5
29 14 23 15 7 29 23 19 11 5
3 7
19 8
8
8
5
8 11 5 29
7
8
3 42 23 11 5 19
100 58
29 8 3 14 7 29 15 8
8 14
2018/10/16
6.7.2. Huffman编码
设字符集为 {c1 , c2 ,…, cn} , 看作叶结点 出现概率为 {w1 , w2 ,…, wn} ,叶结点的权 (1)构造Huffman树 (2)左分支标0,右分支标1 (3)根到叶结点ci的路径上的二进制编码就是ci的编码 编码长度为{ l1 , l2 ,…, ln} 是叶结点的路径长度, 则树的带权路径长度WPL是: n WPL wk lk
A 0 B 1 C 00 D 01
电文越短,则在相同条件下传输越快,出错 的机率越小。
若要发送的数据是:“ A B C D ”
编码:“010001”
译码出现 “二义性” !
2018/10/16
如图所示二叉树:叶子结点分别表示A、B、 C、D 四个字符;且约定左分支表示字符“0”, 右分支表示字符“1”。则可以把从根结点到叶 子结点的路径上分支字符组成的字符串作为该 叶子结点字符的编码。
2018/10/16
T2 , …, Tn},其中 Ti中是只含权值为wi 的结点。
2. 从F中选两个权值最小的二叉树Ti和Tj,构造一个 根结点R, R的权wR为wi + wj 。 3. 从F中删除Ti和Tj ,加入新的树R到F中。
4. 重复2,3 直到F中只有一棵树(或执行n-1次)为止。
例: 已知权值 W={ 5, 6, 3, 9, 7 }
6.7.1 Huffman树
最优二叉树(Huffman) 如何构造最优二叉树
一、哈夫曼树(最优树)的定义
结点的路径长度:从根结点到该结点的路径上分支的 数目。 树的路径长度:树中每个结点的路径长度之和。 (结点)带权路径长度:结点的路径长度*结点的权=li*wi 树的带权路径长度:树中所有叶结点的带权路径长 度之和WPL(T)=
m=2*n-1;
HT=(HuffmanTree)malloc((m十1)*sizeof(HTNode));// 0号单元未用 for(p=HT+1, i=1; i<=n; ++i, ++p,++w) *p= {*w, 0,0,0 };//前n个结点
for(; i<=m; ++i,++p)
for(i=n+1;i<=m;++i){
5 6 3 9 7
6
9
7
3
8 5
例: 已知权值 W={ 5, 6, 3, 9, 7 }
5
6 3 9 7
17 9 3
13 8
5 6 7
例: 已知权值 W={ 5, 6, 3, 9, 7 }
5
6 3 9 30 17 9 3 13 7
8
5
6
7
引例:百分制转换成五级分制成绩
等级 E D C B A 分数段 0~59 60~69 70~79 80~89 90~100 0.10 比例 0.05 0.15 0.40 0.30
//动态分配数组存储哈夫曼编码表
构造哈夫曼树的算法
void HuffmanCoding(HuffmanTree &HT,HuffmanCode &Hc,int *w,int n)
{ //w存放n个字符的权值(均>0),构造哈夫曼树,并求出n个字符的赫夫曼编码Hc。 if(n<=1) return;
3 7
15
8
0 0 23
1 0 1 29 0 5
1
0
1
0
14
1
1 3
0 7
1 8
4(8):1111 8(11):010
1(5):0110 5(14):110
2(29):10 6(23):00
3(7):1110 7(3):0111
w={5, 29, 7, 8, 14, 23, 3, 11}
2018/10/16
设实际学生成绩的分布规律如下:
B E D A 等级 C 分数段 0~59 60~69 70~79 80~89 90~100 5% 比例 15% 40% 30% 10%
有80%的数据需进行3次或3次以上比较才 能得出结果。
问题:如何设计程序才能使得比较的总次数最少?
10/16/2018
以各个分数段上学生所占的百分比作为权值,构造一棵哈夫曼树:
k 1
Huffman编码:
根到任何ci的路径都不会经过任何其它ck, 因此
Huffman编码是无前缀编码,即任何一个编码都不
会是另一个编码的前缀。
例:字符集{a,b,c,d,e,f,g,h}出现概率分别是 {0.14, 0.08, 0.11, 0.23, 0.29, 0.05, 0.03, 0.07}
A
0 1 0 1 0 1
B 10
C 110
D 111
0
A
B
C
D
没有二义性
2018/10/16
(二)前缀编码
若任何一个字符的编码都不是同 一字符集中另一个字符的编码的前缀, 则此编码称为前缀编码。
A 00 B 01 C 10 D 11 A 0 B 1 C 00 D 01
采用前缀编码能够保证译码过程中不会出 现“二义性”。
例题:已知某系统在通信联络中只可
能出现8种字符,其概率分别为 0.05,0.29,0.07,0.08,0.14,0.23,0.0 3,0.11, 试设计huffman编码。
2018/10/16
例 w={5, 29, 7, 8, 14, 23, 3, 11} 5 29 7 8 14 23 3 11 29 7 8 14 23 11 8 5 29 14 23 11 8 3 15
哈夫曼树

哈夫曼树及其应用一、基本术语1.路径和路径长度在一棵树中,从一个结点往下可以达到的孩子或子孙结点之间的通路,称为路径。
通路中分支的数目称为路径长度。
若规定根结点的层数为1,则从根结点到第L层结点的路径长度为L-1。
2.结点的权及带权路径长度若将树中结点赋给一个有着某种含义的数值,则这个数值称为该结点的权。
结点的带权路径长度为:从根结点到该结点之间的路径长度与该结点的权的乘积。
3.树的带权路径长度树的带权路径长度(Weighted Path Length of Tree):也称为树的代价,定义为树中所有叶结点的带权路径长度之和,通常记为:其中:n表示叶子结点的数目wi和li分别表示叶结点ki的权值和根到结点ki之间的路径长度。
二、哈夫曼树构造1.哈夫曼树的定义在权为w l,w2,…,w n的n个叶子所构成的所有二叉树中,带权路径长度最小(即代价最小)的二叉树称为最优二叉树或哈夫曼树。
【例】给定4个叶子结点a,b,c和d,分别带权7,5,2和4。
构造如下图所示的三棵二叉树(还有许多棵),它们的带权路径长度分别为:(a)WPL=7*2+5*2+2*2+4*2=36(b)WPL=7*3+5*3+2*1+4*2=46(c)WPL=7*1+5*2+2*3+4*3=35其中(c)树的WPL最小,可以验证,它就是哈夫曼树。
2.哈夫曼树的构造假设有n个权值,则构造出的哈夫曼树有n个叶子结点。
n 个权值分别设为w1,w2,…,wn,则哈夫曼树的构造规则为:(1) 将w1,w2,…,wn看成是有n 棵树的森林(每棵树仅有一个结点);(2) 在森林中选出两个根结点的权值最小的树合并,作为一棵新树的左、右子树,且新树的根结点权值为其左、右子树根结点权值之和;(3)从森林中删除选取的两棵树,并将新树加入森林;(4)重复(2)、(3)步,直到森林中只剩一棵树为止,该树即为我们所求得的哈夫曼树。
下面给出哈夫曼树的构造过程,假设给定的叶子结点的权分别为1,5,7,3,则构造哈夫曼树过程如下图所示。
数据结构第六章 哈夫曼树
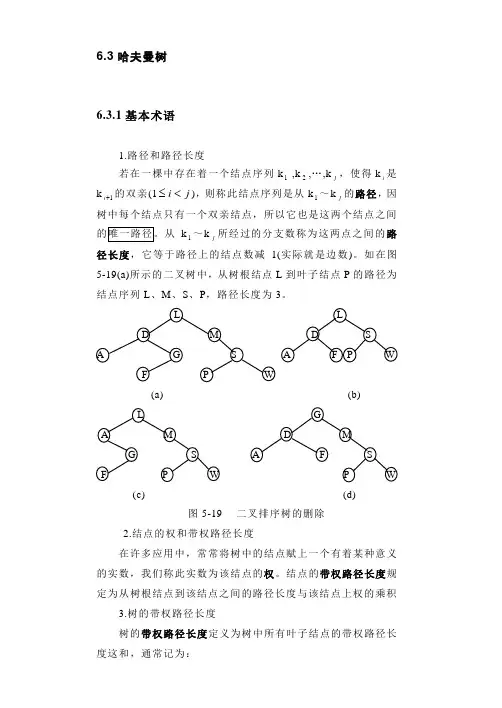
6.3哈夫曼树6.3.1基本术语1.路径和路径长度若在一棵中存在着一个结点序列k1 ,k2,…,kj,使得ki是k1+i 的双亲(1ji<≤),则称此结点序列是从k1~kj的路径,因树中每个结点只有一个双亲结点,所以它也是这两个结点之间k 1~kj所经过的分支数称为这两点之间的路径长度,它等于路径上的结点数减1(实际就是边数)。
如在图5-19(a)所示的二叉树中,从树根结点L到叶子结点P的路径为结点序列L、M、S、P,路径长度为3。
(a) (b)(c) (d)图5-19 二叉排序树的删除2.结点的权和带权路径长度在许多应用中,常常将树中的结点赋上一个有着某种意义的实数,我们称此实数为该结点的权。
结点的带权路径长度规定为从树根结点到该结点之间的路径长度与该结点上权的乘积3.树的带权路径长度树的带权路径长度定义为树中所有叶子结点的带权路径长度这和,通常记为:2 WPL = ∑=n i i i lw 1其中n 表示叶子结点的数目,i w 和i l 分别表示叶子结点i k 的权值和根到i k 之间的路径长度 。
4.哈夫曼树哈夫曼(Huffman)树又称最优二叉树。
它是n 个带权叶子结点构成的所有二叉树中,带权路径长度 WPL 最小的二叉树。
因为构造这种树的算法是最早由哈夫曼于1952年提出的,所以被称之为哈夫曼树。
例如,有四个叶子结点a 、b 、c 、d ,分别带权为9、4、5、2,由它们构成的三棵不同的二叉树(当然还有其它许多种)分别如图5-20(a)到图5-20(c)所示。
b ac a b cd d c a b d(a) (b) (c)图5-20 由四个叶子结点构成的三棵不同的带权二叉树 每一棵二叉树的带权路径长度WPL 分别为:(a) WPL = 9×2 + 4×2 + 5×2 + 2×2 = 40(b) WPL = 4×1 + 2×2 + 5×3 + 9×3 = 50(c) WPL = 9×1 + 5×2 + 4×3 + 2×3 = 37其中图5-20(c)树的WPL 最小,稍后便知,此树就是哈夫曼树。
数据结构哈夫曼树和哈夫曼编码权值
主题:数据结构——哈夫曼树和哈夫曼编码权值1. 引言在计算机科学中,对于大规模的数据存储和传输,有效地压缩数据是一项重要的任务。
哈夫曼树和哈夫曼编码权值是一种经典的数据结构和算法,用于实现数据的高效压缩和解压缩。
本文将介绍哈夫曼树和哈夫曼编码权值的概念和原理,探讨其在数据压缩中的应用以及个人对该主题的理解。
2. 哈夫曼树2.1 概念哈夫曼树,又称最优二叉树,是一种具有最小带权路径长度的二叉树。
树的带权路径长度定义为树中所有叶子节点的权值乘以其到根节点的距离,即路径长度的总和。
2.2 构造方法哈夫曼树的构造方法是一种贪心算法。
将所有的权值作为叶子节点构建n棵单节点树。
从这些树中选择两棵权值最小的树合并,得到一棵新的树,新树的根节点的权值为这两棵树根节点权值之和。
重复此过程,直到只剩下一棵树,即为哈夫曼树。
2.3 例子以数据集[7, 5, 2, 4]为例,构造哈夫曼树的过程如下: 1. 初始状态下,将每个权值看作一棵树:7、5、2、4。
2. 选择两棵权值最小的树2和4进行合并,得到一棵新树,根节点的权值为2+4=6。
此时,剩下的树为6、5、7。
3. 选择两棵权值最小的树5和6进行合并,得到一棵新树,根节点的权值为5+6=11。
此时,剩下的树为11、7。
4. 选择两棵权值最小的树7和11进行合并,得到一棵新树,根节点的权值为7+11=18。
得到最终的哈夫曼树。
3. 哈夫曼编码权值3.1 概念哈夫曼编码权值是指在哈夫曼树中,从根节点到每个叶子节点的路径上所经过的边的权值。
对于哈夫曼树中的每个字符(叶子节点),都可以通过从根节点到叶子节点的路径上的边的权值,来进行编码。
3.2 编码方法哈夫曼编码方法的基本原则是将出现频率高的字符用较短的编码表示,出现频率低的字符用较长的编码表示。
在哈夫曼树中,根节点到左子树的路径上的边标记为0,到右子树的路径上的边标记为1。
通过遍历哈夫曼树,可以分配每个字符的编码。
哈夫曼树的解码算法

哈夫曼树的解码算法1.引言1.1 概述哈夫曼树是一种常用的数据结构,它能够通过编码和解码的方式实现数据的无损压缩和解压缩。
在大数据处理和网络传输等领域,哈夫曼树的解码算法具有广泛的应用。
在本篇文章中,我们将重点讨论哈夫曼树的解码算法。
首先,我们将对哈夫曼树的构建算法进行简要介绍,以便更好地理解解码算法的实现原理。
然后,我们将详细探讨哈夫曼树的解码算法的概述和步骤。
哈夫曼树的构建算法基于字符频率的优先级构建了一棵二叉树。
字符的频率越高,其对应的编码长度越短,从而实现了数据的高效压缩。
而解码算法则是根据哈夫曼树的结构和编码表,将压缩后的数据重新转换为原始数据。
在解码算法的实现过程中,我们将会讨论如何根据哈夫曼树的特性进行字符的解码。
具体而言,我们将分析字符编码的二进制序列,并通过逐位比对和遍历哈夫曼树的路径来恢复原始字符。
解码算法的核心思想是通过识别叶子节点来还原字符并重建原始数据。
通过深入了解哈夫曼树的解码算法,我们将能够更好地理解数据的无损压缩和解压缩过程。
理解解码算法的实现原理将有助于我们在实际应用中更好地利用哈夫曼树,提高数据传输效率和存储空间利用率。
在接下来的文章内容中,我们将逐步介绍哈夫曼树的解码算法的具体步骤,并讨论其优化和应用。
希望读者通过本文的阅读,能够对哈夫曼树的解码算法有更深入的了解,并能够灵活应用于实际的数据处理场景中。
文章结构部分的内容可以按以下方式编写:1.2 文章结构本文主要围绕哈夫曼树的解码算法展开讨论。
文章结构如下:1. 引言:首先介绍哈夫曼树解码算法的背景和意义,为读者提供一个整体的概述。
2. 正文:2.1 哈夫曼树的构建算法:详细介绍哈夫曼树的构建过程,包括算法的概述和具体的步骤。
通过构建哈夫曼树,可以为后续的编码和解码算法奠定基础。
2.2 哈夫曼树的编码算法:详细介绍哈夫曼树的编码过程,包括算法的概述和具体的步骤。
通过编码,可以将待传输的数据转换成具有最小编码长度的比特流,实现数据的压缩。
哈夫曼树.ppt
n
w i pi
最小,其中
i 1
Wi是第i个字符的使用频度,而Pi是第i个字符的编码长度, 这正是度量报文的平均长度的式子。
2020/3/5
21
例2:要传输的电文是{CAS;CAT;SAT;AT}
要传输的字符集是 D={C,A,S,T, ;}
每个字符出现的频率是W={ 2,4, 2,3, 3 }
PL=0+1+1+2+2=6
2020/3/5
9
问题2:什么样的带权树路径长度最小?
例如:给定一个权值序列{2,3,4,7},可构造的多种 二叉树的形态。
2
3
4
7
2 34 7
(a) WPL=2×2+2×3+2×4+2×7=32 (b) WPL=1×2+2×3+3×4+3×7=41
2020/3/5
7
4
3
2
(c) WPL=1×7+2×4+3×3+3×2=30
10
哈夫曼树的构造
例:给定权值{7,5,2,4},构造哈夫曼树。
6
方法: 75 2 4
75
(1)a 初始b化:由c 原始d数据生成森林a ; b c
d
(次2小)的找二最叉小(树a树) 作:为在左森右林子中树选构取造两一棵棵根新结的点二权叉值树最(,小b)其的根和
A)先序遍历
B)中序遍历
C)后序遍历
D)从根开始进行层次遍历
2、某二叉树的先序序列和后序序列正好相反,则该二叉
树一定是( B )的二叉树。
A)空或只有一个结点
B)高度等于其结点数
C)任一结点无左孩子
D)任一结点无右孩子
哈夫曼树及哈夫曼编码的算法实现c语言

哈夫曼树及哈夫曼编码的算法实现c语言1.引言1.1 概述哈夫曼树及哈夫曼编码是数据压缩和编码中常用的重要算法。
哈夫曼树由大卫·哈夫曼于1952年提出,用于根据字符出现的频率构建一种最优的前缀编码方式。
而哈夫曼编码则是根据哈夫曼树构建的编码表将字符进行编码的过程。
在现代通信和计算机领域,数据传输和存储中往往需要大量的空间。
为了有效利用有限的资源,减少数据的存储和传输成本,数据压缩成为一个重要的技术。
而哈夫曼树及哈夫曼编码正是数据压缩中常用的技术之一。
哈夫曼树的概念及原理是基于字符的频率和概率进行构建的。
在哈夫曼树中,字符出现频率越高的节点越接近根节点,出现频率越低的节点离根节点越远。
这种构建方式保证了哈夫曼树的最优性,即最小化编码的总长度。
哈夫曼编码的算法实现是根据哈夫曼树构建的编码表进行的。
编码表中,每个字符都与一段二进制编码相对应。
在进行数据压缩和解压缩时,通过查表的方式将字符转化为相应的二进制编码,或将二进制编码解析为原始字符。
本文旨在介绍哈夫曼树及哈夫曼编码的概念和原理,并通过C语言实现算法。
通过深入理解哈夫曼树及哈夫曼编码的实现过程,可以更好地理解数据压缩和编码的原理,为后续的研究和应用提供基础。
接下来,我们将首先介绍哈夫曼树的概念和原理,然后详细讲解哈夫曼编码的算法实现。
最后,我们将总结哈夫曼树及哈夫曼编码的重要性,并提出对哈夫曼树和哈夫曼编码进一步研究的方向。
让我们一起深入探索哈夫曼树及哈夫曼编码的奥秘吧!1.2 文章结构文章结构部分的内容可以包括以下内容:文章结构部分主要介绍了本文的组织结构和各个章节的内容概述,以帮助读者更好地理解全文的逻辑结构和内容安排。
首先,本文包括引言、正文和结论三个部分。
引言部分主要对哈夫曼树及哈夫曼编码的算法实现进行了概述,包括相关的概念、原理和目的。
正文部分则深入介绍了哈夫曼树的概念和原理,以及哈夫曼编码的算法实现。
最后,结论部分对本文的主要内容进行了总结,并提出了对哈夫曼树和哈夫曼编码的进一步研究方向。
哈夫曼树
字符序列:DATA TRERTER ARE AREA ART 用0、1组合进行编码,希望01串长度最短。 字符集为{A,D,T,R,E},各字母出现的次 数为{6,1,4,6,4} 高频字符,译码尽可能短
一个方案
– – – – – A:10 D:010 T:011 R:11 E:00
基本术语
结点的权
– 在许多实际应用中,常常将树中的某些结 点赋上一个具有一定意义的实数,这个实 数称为该结点的权
结点的带权路径
– 从根结点到结点的路径长度*结点的权
树的带权路径WPL
– 树中所有叶子结点的带权路径长度之和
基本术语
对所有叶子结点i计算 Wi Li
计算WPL
哈夫曼树
最优树/哈夫曼树
(1)与n个权对应的结点构成具有n棵二叉 树的森林F={T1,T2,…,Tn},其中每棵二叉 树Ti都只有一个根结点,左右子树均空 (2)从F中选出根结点权值最小的两棵树 作为一棵树的左右子树,且置新树的根 结点权值为左右子树根结点权值之和 (3)从F中删除这两棵树,将新树加入F (4)重复(2)、(3),直到F中只含一棵树
哈夫曼树
哈夫曼(haffman)树又称为最优二叉树, 它是n个带权叶子结点构成的二叉树中 WPL最小的二叉树。 ??
ቤተ መጻሕፍቲ ባይዱ
– 所有叶子结点的权值均为1(或相等),构 成的二叉树形式? – 在哈夫曼树中叶子结点的权与路径长度的关 系? – 叶子数目已知,结点总数=? – 唯一性?
哈夫曼树—构造(贪心)
ht[m].codify:=“”; for i:=m downto n+1 do begin p:=ht[i].lchild; if p<>0 then ht[p].codify:=ht[i].codify+”0” p:=ht[i].rchild; if p<>0 then ht[p].codify:=ht[i].codify+”1” end;
数据结构哈夫曼树课件
总结词
优化、提升
详细描述
基于哈夫曼树的网络流量分类算法的优化策 略主要从以下几个方面进行优化和提升:一 是优化哈夫曼树的构造算法,提高树的构造 效率和准确性;二是利用多级哈夫曼编码技 术,降低编码和解码的时间复杂度;三是引 入机器学习算法,对网络流量特征进行自动
提取和分类,进一步提升分类准确率。
THANKS
基于堆排序的构造算法
总结词:堆排序是一 种基于比较的排序算 法,它利用了堆这种 数据结构的特点,能 够在O(nlogn)的时间 内完成排序。在哈夫 曼树的构造中,堆排 序可以用来找到每个 节点的父节点,从而 构建出哈夫曼树。
详细描述:基于堆排 序的构造算法步骤如 下
1. 定义一个最大堆, 并将每个节点作为一 个独立的元素插入到 堆中。每个元素包含 了一个节点及其权值 。
哈夫曼编码的基本概念
哈夫曼编码是一种用于无损数据压缩的熵编码算法,具有较高的编码效率和较低的 编码复杂度。
它利用了数据本身存在的冗余和相关性,通过构建最优的前缀编码来实现高效的数 据压缩。
哈夫曼编码是一种可变长编码,其中每个符号的编码长度取决于它在输入序列中出 现的频率。
哈夫曼编码的实现方法
构建哈夫曼树
节ቤተ መጻሕፍቲ ባይዱ。
优化编码长度
在分配码字时,通过一些策略优化 编码长度,例如给高频符号更短的 码字。
可变长度编码
为了提高压缩比,可以使用可变长 度编码,即对于高频符号赋予更短 的码字,对于低频符号赋予更长的 码字。
04
哈夫曼树在数据压 缩中的应用
基于哈夫曼编码的数据压缩算法
哈夫曼编码是一种可变长度的 编码方式,通过统计数据的出 现频率来构建哈夫曼树,实现 数据压缩。
哈夫曼树
n
(wk—第k个叶结点的权值;pk—第k个叶结点的带权路径长度)
达到最小。
2、最优二叉树的构造方法 假定给出n个结点ki(i=1‥n),其权值分别为wi(i=1‥n)。要构造以此n个 结点为叶结点的最优二叉树,其构造方法如下:
首先,将给定的n个结点构成n棵二叉树的集合F={T1,T2,……,Tn}。其 中每棵二叉树Ti中只有一个权值为wi的根结点ki,其左、右子树均为空。然后 做以下两步
}
测试数据: 输入: 5 75246 输出: 54
3、哈夫曼编码
使用频率高的采用短的的编码,则总的编码长度便可减少.
例如:在某通讯中只使用abcd四种字符,其出现频率分别 为:0.4,0.3,0.2,0.1。请进行哈夫曼编码。使通讯码尽可能 的短
并写出信息:bbdaac的编码。
1.给定一个整数集合{3,5,6,9,12},下列二叉树哪个 是该整数集合对应的霍夫曼(Huffman)树。 ( )
⑴在F中选取根结点权值最小的两棵二叉树作为左右子树,构造一棵新 的二叉树,并且置新的二叉树的根结点的权值为其左、右子树根结点的权值之 和; ⑵在F中删除这两棵二叉树,同时将新得到的二叉树加入F中;
重复⑴、⑵,直到在F中只含有一棵二叉树为止。这棵二叉树便是最优二叉树。 以上构造最优二叉树的方法称为哈夫曼(huffmann)算法。
int data;
int prt, lch, rch; };
//结点的权值
//父指针、左、右孩子指针
node ht[MAXN];
int n,m; int path[LEAF];
//ht[1]..ht[n]为叶结点,ht[n+1]..ht[2n-1]
//n 为读入的叶结点数,m 为总结点数 //叶结点到根的路径长度
数据结构哈夫曼树和哈夫曼编码PPT课件
C
AB
AC
BC
ABC
第27页/共55页
回朔策略—求幂集
000
000
100
000
010
100
110
000
001
010
011 100 101 110
111
第28页/共55页
回朔策略—求幂集
void powerSet(int num){ if (num<=len-1) { for (int i=0; i<2; i++){ if (i = = 0) mask[num]=1; else mask[num]=0; powerSet(num+1);} } else{ for (int j=0; j<len; j++){ if (mask[j]==1) printf("%c",set[j]);} printf("\n");}
}
第29页/共55页
回朔策略—求幂集
int len=3; int mask[]={0,0,0}; char set[]={'A','B','C'}; int main(int argc, char* argv[]) {
powerSet(0); return 0; }
第30页/共55页
章末复习
1. 熟练掌握二叉树的结构特性,了解相应的证 明方法。 2. 熟悉二叉树的各种存储结构的特点及适用范 围。 3. 遍历二叉树是二叉树各种操作的基础。实现 二叉树遍历的具体算法与所采用的存储结构有 关。掌握各种遍历策略的递归算法,灵活运用 遍历算法实现二叉树的其它操作。层次遍历是 按另一种搜索策略进行的遍历。