
Spark性能优化(shuffle调优)
Spark性能优化:shuffle调优 shuffle调优 调优概述
大多数Spark作业的性能主要就是消耗在了shuffle环节,因为该环节包含了大量的磁盘IO、序列化、网络数据传输等操作。因此,如果要让作业的性能更上一层楼,就有必要对shuffle过程进行调优。但是也必须提醒大家的是,影响一个Spark作业性能的因素,主要还是代码开发、资源参数以及数据倾斜,shuffle调优只能在整个Spark的性能调优中占到一小部分而已。因此大家务必把握住调优的基本原则,千万不要舍本逐末。下面我们就给大家详细讲解shuffle的原理,以及相关参数的说明,同时给出各个参数的调优建议。
ShuffleManager发展概述 在Spark的源码中,负责shuffle过程的执行、计算和处理的组件主要就是ShuffleManager,也即shuffle管理器。而随着Spark的版本的发展,ShuffleManager也在不断迭代,变得越来越先进。
在Spark 1.2以前,默认的shuffle计算引擎是HashShuffleManager。该ShuffleManager而HashShuffleManager有着一个非常严重的弊端,就是会产生大量的中间磁盘文件,进而由大量的磁盘IO操作影响了性能。
因此在Spark 1.2以后的版本中,默认的ShuffleManager改成了SortShuffleManager。SortShuffleManager相较于HashShuffleManager来说,有了一定的改进。主要就在于,每个Task在进行shuffle操作时,虽然也会产生较多的临时磁盘文件,但是最后会将所有的临时文件合并(merge)成一个磁盘文件,因此每个Task就只有一个磁盘文件。在下一个stage的shuffle read task拉取自己的数据时,只要根据索引读取每个磁盘文件中的部分数据即可。
下面我们详细分析一下HashShuffleManager和SortShuffleManager的原理。 HashShuffleManager运行原理 未经优化的HashShuffleManager
下图说明了未经优化的HashShuffleManager的原理。这里我们先明确一个假设前提:每个Executor只有1个CPU core,也就是说,无论这个Executor上分配多少个task线程,同一时间都只能执行一个task线程。
我们先从shuffle write开始说起。shuffle write阶段,主要就是在一个stage结束计算之后,为了下一个stage可以执行shuffle类的算子(比如reduceByKey),而将每个task处理的数据按key进行“分类”。所谓“分类”,就是对相同的key执行hash算法,从而将相同key都写入同一个磁盘文件中,而每一个磁盘文件都只属于下游stage的一个task。在将数据写入磁盘之前,会先将数据写入内存缓冲中,当内存缓冲填满之后,才会溢写到磁盘文件中去。
那么每个执行shuffle write的task,要为下一个stage创建多少个磁盘文件呢?很简单,下一个stage的task有多少个,当前stage的每个task就要创建多少份磁盘文件。比如下一个stage总共有100个task,那么当前stage的每个task都要创建100份磁盘文件。如果当前stage有50个task,总共有10个Executor,每个Executor执行5个Task,那么每个Executor上总共就要创建500个磁盘文件,所有Executor上会创建5000个磁盘文件。由此可见,未经优化的shuffle write操作所产生的磁盘文件的数量是极其惊人的。
接着我们来说说shuffle read。shuffle read,通常就是一个stage刚开始时要做的事情。此时该stage的每一个task就需要将上一个stage的计算结果中的所有相同key,从各个节点上通过网络都拉取到自己所在的节点上,然后进行key的聚合或连接等操作。由于shuffle write的过程中,task给下游stage的每个task都创建了一个磁盘文件,因此shuffle read的过程中,每个task只要从上游stage的所有task所在节点上,拉取属于自己的那一个磁盘文件即可。
shuffle read的拉取过程是一边拉取一边进行聚合的。每个shuffle read task都会有一个自己的buffer缓冲,每次都只能拉取与buffer缓冲相同大小的数据,然后通过内存中的一个Map进行聚合等操作。聚合完一批数据后,再拉取下一批数据,并放到buffer缓冲中进行聚合操作。以此类推,直到最后将所有数据到拉取完,并得到最终的结果。 优化后的HashShuffleManager 下图说明了优化后的HashShuffleManager的原理。这里说的优化,是指我们可以设置一个参数,spark.shuffle.consolidateFiles。该参数默认值为false,将其设置为true即可开启优化机制。通常来说,如果我们使用HashShuffleManager,那么都建议开启这个选项。
开启consolidate机制之后,在shuffle write过程中,task就不是为下游stage的每个task创建一个磁盘文件了。此时会出现shuffleFileGroup的概念,每个shuffleFileGroup会对应一批磁盘文件,磁盘文件的数量与下游stage的task数量是相同的。一个Executor上有多少个CPU core,就可以并行执行多少个task。而第一批并行执行的每个task都会创建一个shuffleFileGroup,并将数据写入对应的磁盘文件内。
当Executor的CPU core执行完一批task,接着执行下一批task时,下一批task就会复用之前已有的shuffleFileGroup,包括其中的磁盘文件。也就是说,此时task会将数据写入已有的磁盘文件中,而不会写入新的磁盘文件中。因此,consolidate机制允许不同的task复用同一批磁盘文件,这样就可以有效将多个task的磁盘文件进行一定程度上的合并,从而大幅度减少磁盘文件的数量,进而提升shuffle write的性能。
假设第二个stage有100个task,第一个stage有50个task,总共还是有10个Executor,每个Executor执行5个task。那么原本使用未经优化的HashShuffleManager时,每个Executor会产生500个磁盘文件,所有Executor会产生5000个磁盘文件的。但是此时经过优化之后,每个Executor创建的磁盘文件的数量的计算公式为:CPU core的数量 * 下一个stage的task数量。也就是说,每个Executor此时只会创建100个磁盘文件,所有Executor只会创建1000个磁盘文件。 SortShuffleManager运行原理 SortShuffleManager的运行机制主要分成两种,一种是普通运行机制,另一种是bypass运行机制。当shuffle read task的数量小于等于spark.shuffle.sort.bypassMergeThreshold参数的值时(默认为200),就会启用bypass机制。
普通运行机制 下图说明了普通的SortShuffleManager的原理。在该模式下,数据会先写入一个内存数据结构中,此时根据不同的shuffle算子,可能选用不同的数据结构。如果是reduceByKey这种聚合类的shuffle算子,那么会选用Map数据结构,一边通过Map进行聚合,一边写入内存;如果是join这种普通的shuffle算子,那么会选用Array数据结构,直接写入内存。接着,每写一条数据进入内存数据结构之后,就会判断一下,是否达到了某个临界阈值。如果达到临界阈值的话,那么就会尝试将内存数据结构中的数据溢写到磁盘,然后清空内存数据结构。 在溢写到磁盘文件之前,会先根据key对内存数据结构中已有的数据进行排序。排序过后,会分批将数据写入磁盘文件。默认的batch数量是10000条,也就是说,排序好的数据,会以每批1万条数据的形式分批写入磁盘文件。写入磁盘文件是通过Java的BufferedOutputStream实现的。BufferedOutputStream是Java的缓冲输出流,首先会将数据缓冲在内存中,当内存缓冲满溢之后再一次写入磁盘文件中,这样可以减少磁盘IO次数,提升性能。
一个task将所有数据写入内存数据结构的过程中,会发生多次磁盘溢写操作,也就会产生多个临时文件。最后会将之前所有的临时磁盘文件都进行合并,这就是merge过程,此时会将之前所有临时磁盘文件中的数据读取出来,然后依次写入最终的磁盘文件之中。此外,由于一个task就只对应一个磁盘文件,也就意味着该task为下游stage的task准备的数据都在这一个文件中,因此还会单独写一份索引文件,其中标识了下游各个task的数据在文件中的start offset与end offset。
SortShuffleManager由于有一个磁盘文件merge的过程,因此大大减少了文件数量。比如第一个stage有50个task,总共有10个Executor,每个Executor执行5个task,而第二个stage有100个task。由于每个task最终只有一个磁盘文件,因此此时每个Executor上只有5个磁盘文件,所有Executor只有50个磁盘文件。
Spark性能调优-RDD算子调优篇
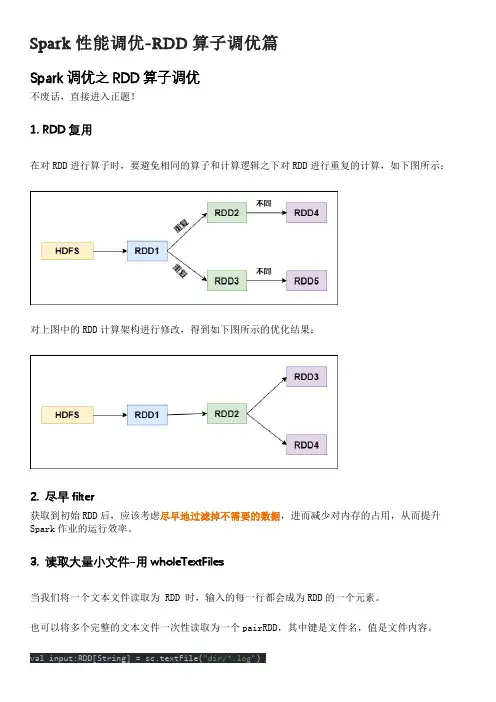
Spark性能调优-RDD算子调优篇Spark调优之RDD算子调优不废话,直接进入正题!1. RDD复用在对RDD进行算子时,要避免相同的算子和计算逻辑之下对RDD进行重复的计算,如下图所示:对上图中的RDD计算架构进行修改,得到如下图所示的优化结果:2. 尽早filter获取到初始RDD后,应该考虑尽早地过滤掉不需要的数据,进而减少对内存的占用,从而提升Spark作业的运行效率。
3. 读取大量小文件-用wholeTextFiles当我们将一个文本文件读取为 RDD 时,输入的每一行都会成为RDD的一个元素。
也可以将多个完整的文本文件一次性读取为一个pairRDD,其中键是文件名,值是文件内容。
val input:RDD[String] = sc.textFile("dir/*.log")如果传递目录,则将目录下的所有文件读取作为RDD。
文件路径支持通配符。
但是这样对于大量的小文件读取效率并不高,应该使用wholeTextFiles返回值为RDD[(String, String)],其中Key是文件的名称,Value是文件的内容。
def wholeTextFiles(path: String, minPartitions: Int = defaultMinPartitions): RDD[(String, String)])wholeTextFiles读取小文件:val filesRDD: RDD[(String, String)] =sc.wholeTextFiles("D:\\data\\files", minPartitions = 3)val linesRDD: RDD[String] = filesRDD.flatMap(_._2.split("\\r\\n"))val wordsRDD: RDD[String] = linesRDD.flatMap(_.split(" "))wordsRDD.map((_, 1)).reduceByKey(_ + _).collect().foreach(println)4. mapPartition和foreachPartition•mapPartitionsmap(_….) 表示每一个元素mapPartitions(_….) 表示每个分区的数据组成的迭代器普通的map算子对RDD中的每一个元素进行操作,而mapPartitions算子对RDD中每一个分区进行操作。
Spark应用的GC调优
计算中RDD的时候使用的内存
主要的内存消耗
Shuffle过程中用到的Serializer/Deserializer
很影响性能
首先检查Spark应用本身
是不是cache了没有必要cache的RDD
迭代计算,及时清除cache
iteration 0 1 2 3 iteration 4.3GB 8.2GB 98.8GB 90.8GB Totalcachesize 4.3GB 12.5GB 111.3GB 202.1GB Totalcachesize 4.3GB 8.2GB 98.8GB 90.8GB
GC方案分析 – GC调优的考量
Footprint
Application(soft/weak/phantom refs, ….)
Throughput
Latency
把暂停时的工作尽量往并行阶段转移
GC方案分析
如果不在意延时,可以先用Parallel GC试试,如果没有发生full GC,可以 使用Parallel GC,否则使用.
GC收集器 – G1
Remark(STW)
Completes marking (SnapshotAtTheBeginning[SATB] buffer (other GC use dirty card algorithm)) Reference processing
Cleanup (partial STW, namely mixed GC)
从Parallel迁移到G1
Don’t use –Xmn, -XX:-UseAdaptiveSizePolicy, -XX:SurvivorRatio=n
Spark内核源码解析十二:shuffle原理解析
Spark内核源码解析⼗⼆:shuffle原理解析第⼀个特点,在Spark早期版本中,那个bucket缓存是⾮常⾮常重要的,因为需要将⼀个ShuffleMapTask所有的数据都写⼊内存缓存之后,才会刷新到磁盘。
但是这就有⼀个问题,如果map side数据过多,那么很容易造成内存溢出。
所以spark在新版本中,优化了,默认那个内存缓存是100kb,然后呢,写⼊⼀点数据达到了刷新到磁盘的阈值之后,就会将数据⼀点⼀点地刷新到磁盘。
这种操作的优点,是不容易发⽣内存溢出。
缺点在于,如果内存缓存过⼩的话,那么可能发⽣过多的磁盘写io操作。
所以,这⾥的内存缓存⼤⼩,是可以根据实际的业务情况进⾏优化的。
第⼆个特点,与MapReduce完全不⼀样的是,MapReduce它必须将所有的数据都写⼊本地磁盘⽂件以后,才能启动reduce操作,来拉取数据。
为什么?因为mapreduce要实现默认的根据key的排序!所以要排序,肯定得写完所有数据,才能排序,然后reduce来拉取。
但是Spark不需要,spark默认情况下,是不会对数据进⾏排序的。
因此ShuffleMapTask每写⼊⼀点数据,ResultTask就可以拉取⼀点数据,然后在本地执⾏我们定义的聚合函数和算⼦,进⾏计算。
spark这种机制的好处在于,速度⽐mapreduce快多了。
但是也有⼀个问题,mapreduce提供的reduce,是可以处理每个key对应的value上的,很⽅便。
但是spark中,由于这种实时拉取的机制,因此提供不了,直接处理key对应的values的算⼦,只能通过groupByKey,先shuffle,有⼀个MapPartitionsRDD,然后⽤map算⼦,来处理每个key对应的values。
就没有mapreduce的计算模型那么⽅便。
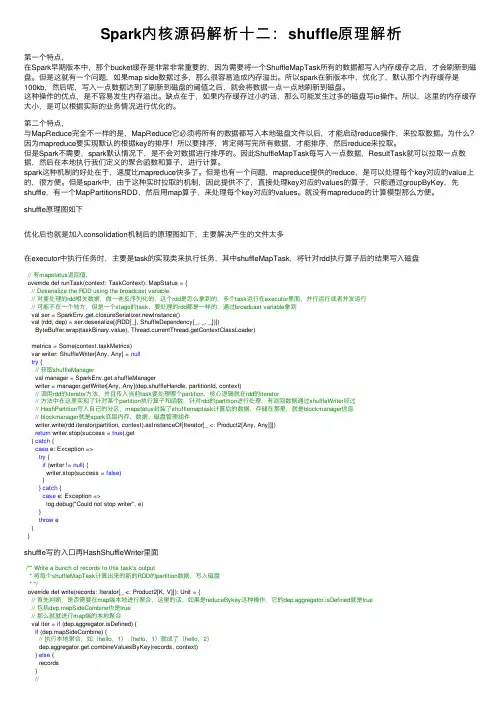
shuffle原理图如下优化后也就是加⼊consolidation机制后的原理图如下,主要解决产⽣的⽂件太多在executor中执⾏任务时,主要是task的实现类来执⾏任务,其中shuffleMapTask,将针对rdd执⾏算⼦后的结果写⼊磁盘// 有mapstatus返回值,override def runTask(context: TaskContext): MapStatus = {// Deserialize the RDD using the broadcast variable.// 对要处理的rdd相关数据,做⼀些反序列化的,这个rdd是怎么拿到的,多个task运⾏在executor⾥⾯,并⾏运⾏或者并发运⾏// 可能不在⼀个地⽅,但是⼀个stage的task,要处理的rdd都是⼀样的,通过broadcast variable拿到val ser = SparkEnv.get.closureSerializer.newInstance()val (rdd, dep) = ser.deserialize[(RDD[_], ShuffleDependency[_, _, _])](ByteBuffer.wrap(taskBinary.value), Thread.currentThread.getContextClassLoader)metrics = Some(context.taskMetrics)var writer: ShuffleWriter[Any, Any] = nulltry {// 获取shuffleManagerval manager = SparkEnv.get.shuffleManagerwriter = manager.getWriter[Any, Any](dep.shuffleHandle, partitionId, context)// 调⽤rdd的iterator⽅法,并且传⼊当前task要处理哪个partition,核⼼逻辑就在rdd的iterator// ⽅法中在这⾥实现了针对某个partition执⾏算⼦和函数,针对rdd的partition进⾏处理,有返回数据通过shuffleWriter经过// HashPartition写⼊⾃⼰的分区,mapstatus封装了shufflemaptask计算后的数据,存储在那⾥,就是blockmanager信息// blockmanager就是spark底层内存、数据、磁盘管理组件writer.write(rdd.iterator(partition, context).asInstanceOf[Iterator[_ <: Product2[Any, Any]]])return writer.stop(success = true).get} catch {case e: Exception =>try {if (writer != null) {writer.stop(success = false)}} catch {case e: Exception =>log.debug("Could not stop writer", e)}throw e}}shuffle写的⼊⼝再HashShuffleWriter⾥⾯/** Write a bunch of records to this task's output* 将每个shuffleMapTask计算出来的新的RDD的partition数据,写⼊磁盘* */override def write(records: Iterator[_ <: Product2[K, V]]): Unit = {// ⾸先判断,是否需要在map端本地进⾏聚合,这⾥的话,如果是reduceBykey这种操作,它的dep.aggregator.isDefined就是true// 包括dep.mapSideCombine也是true// 那么就就进⾏map端的本地聚合val iter = if (dep.aggregator.isDefined) {if (dep.mapSideCombine) {// 执⾏本地聚合,如(hello,1)(hello,1)就成了(hello,2)bineValuesByKey(records, context)} else {records}//} else {require(!dep.mapSideCombine, "Map-side combine without Aggregator specified!")records}// 如果要本地聚合,那么先本地聚合,然后遍历数据,对每个数据掉⽤partitioner// ,默认是hashPartitioner,⽣成bucketId,也就是决定每⼀份数据要写⼊那个bucket。
Spark2.x调优之AdaptiveExecution

Spark2.x调优之AdaptiveExecution在spark的优化过程中,shuffle的分区数量和数据倾斜问题⼀直是⼀个令⼈⽐较头疼的问题,⾃Spark 2.3.1版本后,⾃动设置shuffle Partition最新代码正式加⼊,但动态调整执⾏计划与处理数据倾斜并未同期并⼊该版本.关于原理很多⽂章已经分析的差不多了,这⾥并不做提及,主要是记录相关参数及说明1.⾃动设置 Shuffle Partitionspark.sql.adaptive.enabled=true启⽤ Adaptive Execution 从⽽启⽤⾃动设置 Shuffle Reducer 这⼀特性spark.sql.adaptive.shuffle.targetPostShuffleInputSize可设置每个 Reducer 读取的⽬标数据量,其单位是字节,默认值为 64 MB。
2.动态调整执⾏计划spark.sql.adaptive.enabled=true 与 spark.sql.adaptive.join.enabled=true当这两个设置都为 true 时,开启 Adaptive Execution 的动态调整 Join 功能spark.sql.adaptiveBroadcastJoinThreshold设置了 SortMergeJoin 转 BroadcastJoin 的阈值。
如果不设置该参数,该阈值与 spark.sql.autoBroadcastJoinThreshold 的值相等spark.sql.adaptive.allowAdditionalShuffleAdaptive Execution 可以提供除SortMergeJoin 转 BroadcastJoin等以外其它 Join 优化策略。
部分优化策略可能会需要增加 Shuffle。
该参数就决定了是否允许为了优化 Join ⽽增加 Shuffle。
Spark性能优化之道——解决Spark数据倾斜(DataSkew)的N种姿势

Spark性能优化之道——解决Spark数据倾斜(DataSkew)的N种姿势摘要本⽂结合实例详细阐明了Spark数据倾斜的⼏种场景以及对应的解决⽅案,包括避免数据源倾斜,调整并⾏度,使⽤⾃定义Partitioner,使⽤Map侧Join代替Reduce侧Join,给倾斜Key加上随机前缀等。
为何要处理数据倾斜(Data Skew)什么是数据倾斜对Spark/Hadoop这样的⼤数据系统来讲,数据量⼤并不可怕,可怕的是数据倾斜。
何谓数据倾斜?数据倾斜指的是,并⾏处理的数据集中,某⼀部分(如Spark或Kafka的⼀个Partition)的数据显著多于其它部分,从⽽使得该部分的处理速度成为整个数据集处理的瓶颈。
数据倾斜是如何造成的在Spark中,同⼀个Stage的不同Partition可以并⾏处理,⽽具有依赖关系的不同Stage之间是串⾏处理的。
假设某个Spark Job分为Stage 0和Stage 1两个Stage,且Stage 1依赖于Stage 0,那Stage 0完全处理结束之前不会处理Stage 1。
⽽Stage 0可能包含N个Task,这N个Task可以并⾏进⾏。
如果其中N-1个Task都在10秒内完成,⽽另外⼀个Task却耗时1分钟,那该Stage的总时间⾄少为1分钟。
换句话说,⼀个Stage所耗费的时间,主要由最慢的那个Task决定。
由于同⼀个Stage内的所有Task执⾏相同的计算,在排除不同计算节点计算能⼒差异的前提下,不同Task之间耗时的差异主要由该Task所处理的数据量决定。
Stage的数据来源主要分为如下两类从数据源直接读取。
如读取HDFS,Kafka读取上⼀个Stage的Shuffle数据如何缓解/消除数据倾斜尽量避免数据源的数据倾斜以Spark Stream通过DirectStream⽅式读取Kafka数据为例。
由于Kafka的每⼀个Partition对应Spark的⼀个Task(Partition),所以Kafka内相关Topic的各Partition之间数据是否平衡,直接决定Spark处理该数据时是否会产⽣数据倾斜。
spark调优之广播broadcast

1.手动广播小表手动广播/*+ broadcast(e) */,使用/*+ broadcast(e) */ 提示注释,可以告诉查询优化器将标记为(e) 的表进行广播连接。
这样,当执行查询时,系统会自动选择使用广播连接算法来高效地处理连接操作。
如:select /*+ broadcast(t2) */ * from t1 inner join t2 on t1.key = t2.key;注意:不能广播大表2.强制广播对于Spark来说有3种Join的实现,每种Join对应的不同的应用场景(SparkSQL自动决策使用哪种实现范式):1.Broadcast Hash Join:适合一张很小的表和一张大表进行Join;2.Shuffle Hash Join:适合一张小表(比上一个大一点)和一张大表进行Join;3.Sort Merge Join:适合两张大表进行Join;Broadcast Hash Join:适合一张很小的表和一张大表进行Join。
条件有以下几个:1.被广播的表需要小于spark.sql.autoBroadcastJoinThreshold所配置的信息,默认是10M,可根据实际情况指定更大的阈值;2.基表不能被广播,比如left outer join时,只能广播右表。
3.只能用于等值连接:因为广播后要将数据放入hash表中,然后根据连接key的hash值来查找,所以只支持等值连接;4.不支持full join:因为full join中两个表都需要遍历和查找,所以一个遍历表,一个查找表的模式不太适用;注意:我们spark默认是禁用广播连接的,若要使用广播连接,需手动指定广播参数:1.spark.sql.autoBroadcastJoinThreshold,自动广播的数据集大小(以字节为单位)。
这里spark.sql.autoBroadcastJoinThreshold=-1将禁用广播连接,而默认spark.sql.autoBroadcastJoinThreshold=10485760,即10MB。
Spark大数据之JVM虚拟机调优详解
Spark大数据之JVM虚拟机调优详解JVM虚拟机调优1)Java虚拟机垃圾回收调优的背景如果在持久化RDD的时候,持久化了大量的数据,那么Java虚拟机的垃圾回收就可能成为一个性能瓶颈。
因为Java虚拟机会定期进行垃圾回收,此时就会追踪所有的java对象,并且在垃圾回收时,找到那些已经不在使用的对象,然后清理旧的对象,来给新的对象腾出内存空间。
垃圾回收的性能开销,是跟内存中的对象的数量,成正比的。
所以,对于垃圾回收的性能问题,首先要做的就是,使用更高效的数据结构,比如array和string;其次就是在持久化rdd时,使用序列化的持久化级别,而且用Kryo序列化类库,这样,每个partition就只是一个对象——一个字节数组。
2)监测垃圾回收我们可以对垃圾回收进行监测,包括多久进行一次垃圾回收,以及每次垃圾回收耗费的时间。
只要在spark-submit脚本中,增加一个配置即可,--conf "spark.executor.extraJavaOptions=-verbose:gc -XX:+PrintGCDetails -XX:+PrintGCTimeStamps"。
但是要记住,这里虽然会打印出Java虚拟机的垃圾回收的相关信息,但是输出到了worker上的日志中,而不是driver的日志中。
其实也完全可以通过SparkUI(4040端口)来观察每个stage的垃圾回收的情况。
3)优化executor内存比例对于垃圾回收来说,最重要的就是调节RDD缓存占用的内存空间,与算子执行时创建的对象占用的内存空间的比例。
默认情况下,Spark使用每个executor 60%的内存空间来缓存RDD,那么在task执行期间创建的对象,只有40%的内存空间来存放。
在这种情况下,很有可能因为你的内存空间的不足,task创建的对象过大,那么一旦发现40%的内存空间不够用了,就会触发Java虚拟机的垃圾回收操作。
HiveonSpark参数调优
HiveonSpark参数调优前⾔Hive on Spark是指使⽤Spark替代传统MapReduce作为Hive的执⾏引擎,在HIVE-7292提出。
Hive on Spark的效率⽐on MR要⾼不少,但是也需要合理调整参数才能最⼤化性能,本⽂简单列举⼀些调优项。
为了符合实际情况,Spark也采⽤on YARN部署⽅式来说明。
executor参数spark.executor.cores该参数表⽰每个Executor可利⽤的CPU核⼼数。
其值不宜设定过⼤,因为Hive的底层以HDFS存储,⽽HDFS有时对⾼并发写⼊处理不太好,容易造成race condition。
根据我们的实践,设定在3~6之间⽐较合理。
假设我们使⽤的服务器单节点有32个CPU核⼼可供使⽤。
考虑到系统基础服务和HDFS等组件的余量,⼀般会将YARN NodeManager的yarn.nodemanager.resource.cpu-vcores参数设为28,也就是YARN能够利⽤其中的28核,此时将spark.executor.cores设为4最合适,最多可以正好分配给7个Executor⽽不造成浪费。
⼜假设yarn.nodemanager.resource.cpu-vcores为26,那么将spark.executor.cores设为5最合适,只会剩余1个核。
由于⼀个Executor需要⼀个YARN Container来运⾏,所以还需保证spark.executor.cores的值不能⼤于单个Container能申请到的最⼤核⼼数,即yarn.scheduler.maximum-allocation-vcores的值。
spark.executor.memory/spark.yarn.executor.memoryOverhead这两个参数分别表⽰每个Executor可利⽤的堆内内存量和堆外内存量。
堆内内存越⼤,Executor就能缓存更多的数据,在做诸如map join之类的操作时就会更快,但同时也会使得GC变得更⿇烦。
精选-Spark调优
总结
调优手段中最重要的是内存调优和串行化。大多数的程序 只要切换到kryo串行化基本上能够解决性能的问题。
➢ 如果Oldgen接近full,减少cache的量,降低 spark.memory.storageFraction;缓存少量的信息不要降低执 行效率
➢ minor GC很多,而major GC不多,分配更多内存给伊甸区。 -Xmn=4/3*E,E是伊甸区要设置的大小。
Garbage Collection
内存调优
➢ 常用集合类比如HashMap和LinkedList使用链式数据结构, 不仅有头还有指针。
➢ 基本类型集合要作为包装类进行存储。
调优涉及如何高效利用内存,尤其是如何检测对象的内存 使用数量,如何提升-改变数据结构或者串行化格式。缓存 的大小和垃圾回收器。
内存调优
➢ 内存管理 Spark中的内存使用主要取决于执行和存储中的一个。
从任何位置访问数据,没有本地首选。
➢ ANY
其他考虑
数据本地化 Spark首选最好的本地级别调度所有task,但不是总能成功。 在空闲的executor上如果没有未处理的data,Spark会切换到 低一级的local级别上。有两个选择:a)在data节点上进行等 待直到CPU释放出来 b)立即在较远的主机上启动task并将 data移动到此处。
➢ java串行化 默认机制,对象需要实现java.io.Serializable接口。也可以 实现java.io.Externalizable接口控制串行化性能。该机制比 较灵活但通常很慢,而且会导致众多类的大量串行化格 式。
Spark程序运行常见错误解决方法以及优化
Spark程序运⾏常见错误解决⽅法以及优化Spark程序运⾏常见错误解决⽅法以及优化task倾斜原因⽐较多,⽹络io,cpu,mem都有可能造成这个节点上的任务执⾏缓慢,可以去看该节点的性能监控来分析原因。
以前遇到过同事在spark的⼀台worker上跑R的任务导致该节点spark task运⾏缓慢。
作者:佚名来源:|2017-04-07 09:02⼀.org.apache.spark.shuffle.FetchFailedException1.问题描述这种问题⼀般发⽣在有⼤量shuffle操作的时候,task不断的failed,然后⼜重执⾏,⼀直循环下去,⾮常的耗时。
2.报错提⽰(1) missing output location1. org.apache.spark.shuffle.MetadataFetchFailedException: Missing an output location for shuffle 0(2) shuffle fetch faild1. org.apache.spark.shuffle.FetchFailedException: Failed to connect to spark047215/192.168.47.215:50268当前的配置为每个executor使⽤1cpu,5GRAM,启动了20个executor3.解决⽅案⼀般遇到这种问题提⾼executor内存即可,同时增加每个executor的cpu,这样不会减少task并⾏度。
spark.executor.memory 15Gspark.executor.cores 3spark.cores.max 21启动的execuote数量为:7个1. execuoteNum = spark.cores.max/spark.executor.cores每个executor的配置:1. 3core,15G RAM消耗的内存资源为:105G RAM1. 15G*7=105G可以发现使⽤的资源并没有提升,但是同样的任务原来的配置跑⼏个⼩时还在卡着,改了配置后⼏分钟就结束了。