
(推荐)《计量经济学案例》word版
案例一、建筑行业工资差异制度因素的分析一、引言我国目前正处在由计划经济向市场经济过渡的体制转型时期。
在这一时期,各行业之间的职工工资差异在日趋扩大的同时,呈现出与计划经济时期完全不同的特征。
本文试图通过考察体制转型时期行业(以建筑业为例)工资,以及行业垄断程度,提出基于体制转型这一特定时期的行业工资决定假说:行业相对工资差异的扩大是由于行业垄断程度的扩大引致的,并用回归方法分析对这一假说进行验证。
二、数据定义与经济理论假说(一)数据定义1.建筑业工资水平建筑业相对工资水平定义为建筑业平均工资与全社会平均工资之比。
本文之所以采用的是相对工资水平的概念,而没有采用绝对水平,因为我们更关注改革开放20多年来,建筑行业的工资相对于整个行业的变化,而不关心建筑业自身工资的发展趋势。
部分年份建筑业相对工资水平的时序数据见表1。
表1 部分年份建筑业相对工资水平时序数据2.垄断程度在西方国家,人们通常用一个行业中最大的几家厂商的销售收入的份额表示一个行业的垄断程度。
然而这种方法在我国目前的情况下并不完全适用,因为目前影响(甚至决定)我国行业职工工资水平的并不是一般意义上的垄断,,而是体制转型时期一种特有的垄断,它并不是针对企业的规模而言的,而是针对所有制结构或国有经济成分对行业的控制程度而言的,,即所谓“所有制垄断”或“行政垄断”。
在传统的计划经济体制下,我国经济属于典型的二元经济模式。
如果撇开农村经济这一“元”而不论,城市经济这一“元”的大多数行业基本上都是由国有经济控制的,各行业间在这一点上没有显著性的差别。
然而,随着计划经济体制向市场经济体制的过渡,这种国有经济一统天下的格局逐步被打破,呈现出所有制日趋多元化的的趋势。
但是,不同行业所有制多元化的进程并不一致,由此产生了不同行业间所有制结构的差异。
建筑业相对于电力、金融、房地产等行业,其非国有经济成分进入的门槛相对较低,竞争较为激烈,因此所有制多元化进展较快。
因此,在体制转型时期,我国建筑行业的垄断程度的绝对水平可以在建筑行业的国有化程度上得到大致的体现。
为了获取资料的方便,本文将建筑业国有化程度用建筑业国有单位职工人数占建筑业全部就业人数的比重来表示。
由于不管什么行业,所有制结构多元化、国有经济比重下降是一个总的趋势,而且决定相对工资高低的不是个行业垄断程度的绝对数,而是行业垄断程度与其他行业垄断程度或社会平均水平相比较的相对水平,所以引入相对垄断程度的概念:相对垄断程度=行业所有制垄断度的绝对数/全社会所有制垄断度的平均数改革开放以来部分年份建筑业相对垄断度的时序数据见表2。
表2 部分年份建筑业相对垄断度的时序数据(二)体制转型期行业工资决定假说从表1的数据看出,经过20多年,作为具有高劳动强度、艰苦、危险等特征的传统高工资行业之一—建筑业逐渐被挤出高工资行业的行列,在市场经济下建筑业具有进入门槛低、竞争激烈的特征,其工资相对水平逐年下降,2003年建筑业工资只相当于全国平均工资的82%。
而一些原来工资并不太高,但垄断程度至今仍保持较高水平的行业,如金融保险业、房地产业等则陆续进入最高工资行列。
基于上述事实,我们提出如下关于体制转型这一特定时期行业决定的假说:从总体上看,我国行业相对工资差异的扩大是由于行业垄断程度差异的扩大引致的;建筑业相对工资水平已经逐渐地不再取决于该行业的拉动强度及艰苦危险程度,而是主要取决于行业的垄断程度。
即建筑业相对工资水平的变化,可以由该行业垄断程度的相对变化所解释。
三、模型设定、估计与检验将我国建筑业1978年至2002年的主要17个年份的工资相对水平与其垄断相对程度,建立一元计量模型,理论模型如下:其中表示建筑业工资相对水平,表示建筑业相对国有化程度。
根据体制转型期行业工资决定假说,总体参数应该大于0,相对国有化程度越高,行业垄断程度越高,工资相对水平就越高。
利用计量经济分析软件Eviews进行估计,结果如下:Dependent Variable:建筑业工资相对水平Method: Least SquaresSample: 1 17Included observations: 17Variable Coefficient Std. Error t-Statistic Prob.C 2.93998411.782180.2495280.8063建筑业相对国有化程度 1.3110880.1508728.6900690.0000R-squared0.834286 Mean dependent var104.9118Adjusted R-squared0.823238 S.D. dependent var10.407865.900179S.E. of regression 4.375783 Akaike infocriterionSum squared resid287.2121 Schwarz criterion 5.998204Log likelihood-48.15152 F-statistic75.51731Durbin-Watson stat0.930656 Prob(F-statistic)0.000000合优度较高。
建筑业相对国有化程度对建筑业工资相对水平的回归系数为1.311088,t值达到8.690069,通过了变量的统计检验;并且该回归系数大于0,与理论模型总体参数的预期符号相一致,因此通过了经济意义检验。
但截距项系数2.939984,t值只有0.249528,未通过统计检验,说明建筑业相对国有化程度对建筑业工资相对水平的总体回归直线是通过原点的。
因此理论线性模型应设定为通过原点的回归直线模型,具体形式如下:再利用计量经济分析软件Eviews进行估计,结果如下:Dependent Variable: 建筑业工资相对水平Method: Least SquaresSample: 1 17Included observations: 17Variable Coefficient Std. Error t-Statistic Prob.建筑业相对国有化程度 1.3485820.013186102.27700.0000R-squared0.833598 Mean dependent104.9118var10.40786Adjusted R-squared0.833598 S.D. dependentvar5.786674S.E. of regression 4.245618 Akaike infocriterionSum squared resid288.4043 Schwarz5.835687criterion0.951702 Log likelihood-48.18673 Durbin-Watsonstat以上估计结果发现,修正的可决系数为0.833598,高于带截距项模型的修正可决系数,说明去掉截距项的模型拟合优度有了进一步改善。
建筑业相对国有化程度对建筑业工资相对水平的回归系数为1.348582,t值高达102.2770,通过了变量的统计检验。
但该模型的DW 值很低,只有0.951702,说明模型的随机误差项之间存在正自相关,因此还需要处理模型的自相关问题。
我们在模型中引入AR(1)来处理自相关。
估计结果如下:Dependent Variable: 建筑业工资相对水平Method: Least SquaresSample(adjusted): 2 17Included observations: 16 after adjusting endpointsConvergence achieved after 4 iterationsVariable Coefficient Std. Error t-Statistic Prob.建筑业相对国有化程度 1.3601340.02084665.246160.0000AR(1)0.4267430.208505 2.0466830.0599 R-squared0.889110 Mean dependent104.2125var10.32853Adjusted R-squared0.881190 S.D. dependentvarS.E. of regression 3.560126 Akaike info5.493937criterion5.590511Sum squared resid177.4429 Schwarzcriterion1.931114Log likelihood-41.95150 Durbin-WatsonstatInverted AR Roots .43满的解决。
同时模型修正的可决系数0.881190,又得以进一步提高。
四、结果分析1.本文验证了我们提出的关于体制转型时期行业决定的假说,我国建筑业相对工资差异的扩大主要是由于该行业垄断程度差异的扩大引致的。
2.建筑业相对国有化程度每下降1个百分点,建筑业工资相对水平将会平均下降1.360134个百分点。
案例二、咖啡需求函数——双对数线性模型与弹性系数由微观经济学中需求理论可知,一种商品的需求量与该商品的价格是息息相关的,一般情况下,商品的价格上涨,会引致该商品需求量下降。
通过观察1970年至1980年11年间美国咖啡消费量与咖啡实际零售价格,建立美国咖啡消费函数模型,考察美国咖啡消费行为规律。
1970年至1980年咖啡消费与平均实际零售价格的时序数据详见下表。
表咖啡消费(Y)与平均实际零售价格(X)的时序数据利用Eviews软件可以绘制咖啡消费Y与平均实际零售价格X的水平尺度散点图,见图1:从上图可发现咖啡消费y与平均实际零售价格X之间并不是呈线性关系,而是双曲线的非线性关系。
因此理论模型若设定为线性模型形式是不适当的。
处理方法可以有多种,可以采用双曲线模型形式,还可以采用双对数形式,都能够提高模型的拟合度。
而又由于双对数线性形式模型的参数具有很直观的经济含义——即是弹性的概念,于是这里我们试图采用双对数形式。
利用Eviews软件绘制咖啡消费Y与平均实际零售价格X的双对数尺度散点图,见图2:与图1相比,图2的线性关系更明显,双对数需求函数模型会给出比线性需求函数模型更好的拟合,因此有理由建立一个双对数线性需求函数理论模型。
估计后的结果如下:Dependent Variable: LYMethod: Least SquaresSample: 1970 1980Included observations: 11Variable Coefficient Std. Error t-Statistic Prob.C0.7774180.01524251.004550.0000LX-0.2530460.049374-5.1250860.0006 R-squared0.744800 Mean dependent var0.787284Adjusted R-squared0.716445 S.D. dependent var0.094174-2.984727 S.E. of regression0.050148Akaike infocriterionSum squared resid0.022633 Schwarz criterion-2.912383Log likelihood18.41600 F-statistic26.26651Durbin-Watson stat0.680136 Prob(F-statistic)0.000624从估计结果可以看到价格弹性系数为-0.25,意味着咖啡每磅实际价格每增加1%,咖啡需求量平均减少0.25%。
计量经济学第5章案例
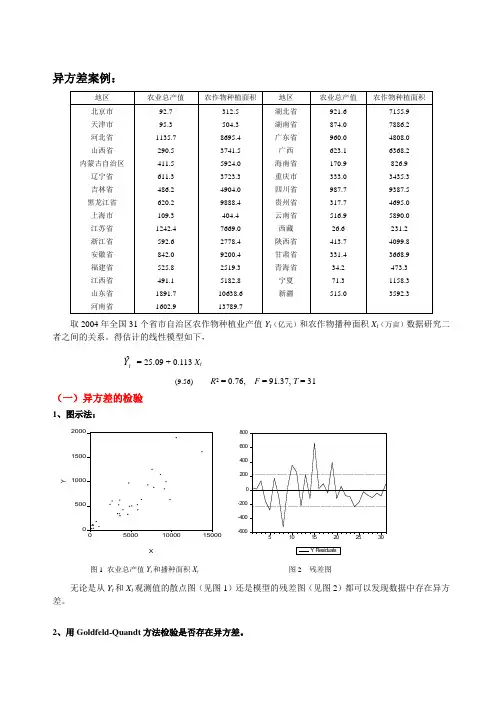
异方差案例:取2004年全国31个省市自治区农作物种植业产值Y t (亿元)和农作物播种面积X t (万亩)数据研究二者之间的关系。
得估计的线性模型如下,tY ˆ = 25.09 + 0.113 X t (9.56) R 2 = 0.76, F = 91.37,T = 31(一)异方差的检验1、图示法:050010001500200050001000015000XY-600-400-200020040060080051015202530图1 农业总产值Y t 和播种面积X t 图2 残差图无论是从Y t 和X t 观测值的散点图(见图1)还是模型的残差图(见图2)都可以发现数据中存在异方差。
2、用Goldfeld-Quandt 方法检验是否存在异方差。
①首先以X t 为基准对成对样本数据(Y t ,X t )按取值大小排序。
②去掉中间7个数据,按X t 取值大小分成样本容量各为11的两个子样本。
③用两个子样本各自回归得结果如下,tY ˆ = 35.14+ 0.1244 X t , (t = 1, …, 12) (4.96) R 2 = 0.71 F = 24.64, ESS =138421.2,tY ˆ= -241.18+ 0.1421X t , (t = 20, …, 29) (3.0) R 2 = 0.53 F = 11.48, ESS =996129.4统计量:F =)212/(2.138421)212/(4.996129-- = 7.196,因为F = 11.2 > F 0..05 (10, 10) = 2.98,所以存在异方差。
3、用Glejser 方法检验是否存在异方差。
用回归后残差的绝对值t e 对X t 的不同次幂作回归得如下回归式: t t X e 0281.0=(6.694) R 2=0.131 t t X e 4964.2=(7.339) R 2=0.225 20620.13.117t t X E e -+=(1.95) R 2=0.12经比较可以发现,随机误差项存在形如第二个方程形式的异方差。
计量经济学计量经济学教学案例
计量经济学教学案例案例一 简单线性回归模型一、主题与背景用真实数据进行简单线性回归分析,应用Eviews6.0分析软件进行操作,与课本内容相对应,分析模型的截距、斜率以及可决系数,引导学生熟悉Eviews6.0的基本操作,能够解读分析报告,并尝试进行被解释变量的预测,体会变量测度单位的改变和函数形式变化给OLS 估计结果和统计特征的影响。
二、情景描述对于由CEO 构成的总体,令y 代表年薪(salary),单位为千美元。
令x 表示某个CEO 所在公司在过去三年的平均股本回报率(roe ,股本回报率定义为净收入占普通股价的百分比)。
为研究该公司业绩指标和CEO 薪水之间的关系,可以定义以下模型:Salary=0β+1βroe + u . 斜率参数1β衡量当股本回报率增长一个单位(一个百分点)时CEO 年薪的变化量,由于更高的股本回报率预示更高的CEO 年薪,所以,1β>0。
三、教学过程设计(一)数据说明数据集CEOSAL1.RAW 包含1990年209位CEO 的相关信息,该数据来自《商业周刊》(5/6/91),该样本中CEO 年薪的平均值为$1,281,120,最低值和最高值分别为$223,000和$14,822,000,1988、1989和1990年的平均股本回报率是17.18%。
(二)操作建议1:在 eviews6.0命令输入窗口定义变量:data salary roe2、用 edit+/- 编辑数据3、描述统计分析过程:view---descriptive stats---common sample4、画散点图:Scat roe salary5、在eviews6.0命令输入窗口运行简单线性回归 Ls salary c roe6、用resids 观测残差7、产生新序列:S eries lsalary =log(salary)8、改变函数形式:Ls lsalary c lsales9、改变变量测度单位:Ls salary*1000 c roe四、教学研究(一)案例结论1、回归结果估计出的回归线为:salˆary = 963.191 + 18.501 roe(1)截距和斜率保留了3位小数,回归结果显示,如果股本回报率为0,年薪的预测值为截距963.191千美元,可以把年薪的预测变化看做股本回报率变化的函数:∆salˆary = 18.501 (∆roe),这意味着当股本回报率增加1个百分点,即∆roe =1,则年薪的预测变化就是18.5千美元,在线性方程中,估计的变化与初始年薪无关。
计量经济学 案例分析
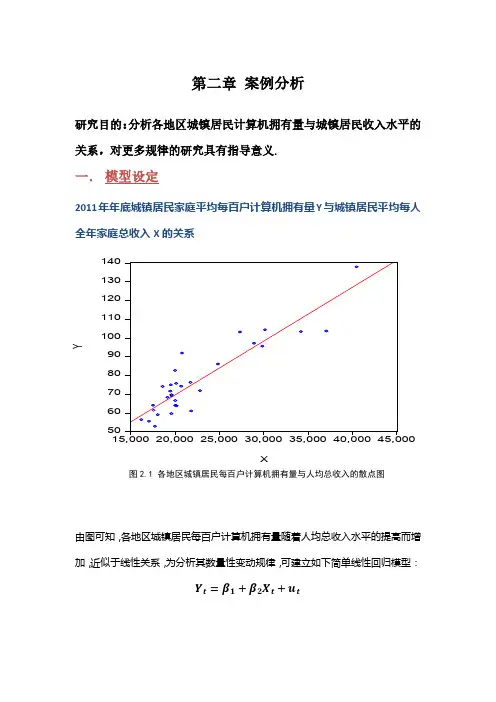
第二章 案例分析研究目的:分析各地区城镇居民计算机拥有量与城镇居民收入水平的关系,对更多规律的研究具有指导意义.一. 模型设定2011年年底城镇居民家庭平均每百户计算机拥有量Y 与城镇居民平均每人全年家庭总收入X 的关系图2.1 各地区城镇居民每百户计算机拥有量与人均总收入的散点图由图可知,各地区城镇居民每百户计算机拥有量随着人均总收入水平的提高而增加,近似于线性关系,为分析其数量性变动规律,可建立如下简单线性回归模型:Y t =β1+β2X t +u t5060708090100110120130140XY二.估计参数假定所建模型及其随机扰动项u i满足各项古典假设,用普通最小二乘法(OLSE)估计模型参数.其结果如下:表2.1 回归结果Dependent Variable: YMethod: Least SquaresDate: 11/13/17 Time: 12:50Sample: 1 31Included observations: 31Variable Coefficient Std. Error t-Statistic Prob.C 11.95802 5.622841 2.126686 0.0421X 0.002873 0.000240 11.98264 0.0000R-squared 0.831966 Mean dependent var 77.08161 Adjusted R-squared 0.826171 S.D. dependent var 19.25503 S.E. of regression 8.027957 Akaike info criterion 7.066078 Sum squared resid 1868.995 Schwarz criterion 7.158593 Log likelihood -107.5242 Hannan-Quinn criter. 7.096236 F-statistic 143.5836 Durbin-Watson stat 1.656123 Prob(F-statistic) 0.000000由表2.1可得,β1=11.9580,β2=0.0029故简单线性回归模型可写为:^ YX tt=11.9580+0.0029其中:SE(β1)=5.6228, SE(β2)=0.0002R-squared=0.8320,F=143.5836,n=31三.模型检验1.经济意义参数β1=11.9580 ,β2=0.0029,说明城镇居民家庭人均总收入每增加1元,城镇居民每百户拥有量平均增加0.0029台,与预期经济意义相符.2.拟合优度和统计检验拟合优度的度量:因为R-squared=0.8320,说明所建模型在整体上对样本数据拟合较好,解释变量对被解释变量的解释程度较高.回归系数的t检验:原假设H0:β1=0及H0:β2=0.回归系数β1的标准误差和t值分别为:SE(β1)= 5.6228,t(β1)=2.1267;回归系数β2的标准误差和t值分别为:SE(β2)= 0.0002,t(β2)= 11.9826.取α=0.05,故临界值t0.025(29)= 2.045,因为t(β1)= 2.1267>t0.025(29)= 2.045,故拒绝H0:β1=0;t(β2)= 11.9826.>t0.025(29)= 2.045,故拒绝H0:β2=0.对斜率系数的显著性检验表明:城镇居民人均总收入对城镇居民每百户计算机拥有量有显著影响. 四.回归预测若西部地区某省城镇居民家庭人均收入能达到25000元/人,利用所估计模型预测城镇居民每百户计算机拥有量。
(完整word版)计量经济学第四章习题详解

第四章习题4.1 没有进行t检验,并且调整的可决系数也没有写出来,也就是没有考虑自由度的影响,会使结果存在误差.4.3200224430.3120332。
7 330.6200334195。
6135822.8 334。
6200446435.8159878.3 l347.7200554273.7183084.8 353.9200663376.9211923。
5 359。
2200773284。
6249529。
9 376.5200879526.5314045.4 398.7200968618。
4340902。
8 395。
9201094699.3401512.8 408。
92011113161.4472881.6 431.0一研究的目的和要求我们知道,商品进口额与很多因素有关,了解其变化对进出口产品有很大帮助。
为了探究和预测商品进口额的变化,需要定量地分析影响商品进口额变化的主要因素。
二、模型的设定及其估计经分析,商品进口额可能与国内生产总值、居民消费价格指数有关。
为此,考虑国内生产总值GDP、居民消费价格指数CPI为主要因素。
各影响变量与商品进口额呈正相关。
为此,设定如下形式的计量经济模型:=+ln+lnCP式中,亿元);lnGDP为国内生产总值(亿元);lnCPI为居民消费价格指数(以1985年为100)。
各解释变量前的回归系数预期都大于零。
为估计模型,根据上表的数据,利用EViews软件,生成Y、lnGDP、lnCPI等数据,采用OLS方法估计模型参数,得到的回归结果如下图所示:模型方程为:lnY=-3。
111486+1。
338533lnGDP-0.421791lnCPI(0。
463010)(0。
088610)(0。
233295)t= (—6。
720126) (15。
10582)(—1。
807975)=0.988051 =0.987055 F=992。
2582该模型=0.988051,=0。
987055,可决系数很高,F检验值为992.2582,明显显著。
计量经济学案例分析
• =170575.819(亿元)
第十四页
为了做区间预测,取α=0.05,计算 Yf平均值 置信度95%的预测区间需用Eviews计量软件获得
相关数据。
第十五页
X和Y的描述统计结果
第十六页
根据统计结果可计算出: ∑xi2 =∑(Xi - X̄)2 =σ2x (n-1)= 68756.512 *(30-1)= 4.02 (Xf-X̄)2=( 316030.34-63270.07)2=63887754090 当Xf =316030.34时,将相关数据代入计算得到 170575.819 +̅2.048*3580.903* √(1∕30+63887754090∕4.02 ) •=为=3(11661057330095.337.5454亿.8211元9,时1,757+55̅ 8Y1.f8平029.均5297值)6亿9置1元即信。度是9说5%,的当预20测08区年间Xf
第一页
二、模型的确定
为研究中国改革开放以来国民总收入与最 终消费的关系,选择最终消费为被解释变量 (用Y表示),国民总收入为解释变量(用X表
示),表1为搜集到的相关数据:
第二页
年份
1978 1979 1980 1981 1982 1983 1984 1985 1986 1987 1988 1989 1990 1991 1992
?五回归预测?由相关资料得知中国2008年国民总收入为31603034亿元利用所估计的模型可预测2008年最终消费数据点预测值的计算方法为?y?f3044343053011231603034?170575819亿元为了做区间预测取005计算yf平均值置信度95的预测区间需用eviews计量软件获得相关数据
计量经济学实际案例

二、均值分析1、分性别对身高进行的比较假设男女身高相等,否定假设可认为男生身高明显高于女生。
2、分南北地区进行比较(1)身高假设两者均值相等,检验结果不能否定原假设,因而不能认为南北方身高有显著差异。
(2)体重通过假设两者均值相等,检验结果无法否定原假设,因而认为南北方体重没有明显差异。
3、分出生年份月份进行比较年份性别身高体重84 男均值172.00 56.00N 1 1总计均值172.00 56.00N 1 185 男均值180.33 70.67N 3 3女均值161.00 51.00N 2 2总计均值172.60 62.80N 5 586 男均值174.20 65.40N 20 20女均值162.11 52.28N 18 18总计均值168.47 59.1887 男均值178.50 66.58N 6 6女均值164.83 52.83N 18 18总计均值168.25 56.27N 24 2488 男均值170.50 65.00N 2 2女均值167.00 53.50N 2 2总计均值168.75 59.25N 4 489 女均值165.00 50.00N 1 1总计均值165.00 50.00N 1 1总计男均值175.28 65.80N 32 32女均值163.56 52.46N 41 41总计均值168.70 58.31N 73 73ANOVA 表由表可看出,各年份出生的人身高体重无显著性差异。
总计均值171.00 64.00N 6 6 3 男均值174.50 69.50N 4 4 女均值160.25 50.75N 4 4 总计均值167.38 60.13N 8 8 4 男均值181.25 68.50N 4 4 女均值162.25 52.00N 4 4 总计均值171.75 60.25N 8 8 5 男均值169.50 65.25N 2 2 女均值156.00 43.00N 1 1 总计均值165.00 57.83N 3 3 6 男均值175.00 63.00N 1 1 女均值171.50 57.50N 4 4 总计均值172.20 58.60N 5 5 7 男均值171.00 64.33N 3 3 女均值167.00 50.50N 2 2 总计均值169.40 58.80N 5 5 8 男均值179.20 64.90N 5 5 女均值161.50 52.50N 2 2 总计均值174.14 61.36N 7 7 9 男均值171.67 58.00N 3 3 女均值163.33 54.33N 3 3 总计均值167.50 56.1710 男均值174.67 61.83N 3 3总计均值174.67 61.83N 3 311 女均值162.50 51.67N 12 12总计均值162.50 51.67N 12 1212 男均值171.00 66.50N 2 2女均值167.00 57.00N 1 1总计均值169.67 63.33N 3 3总计男均值175.28 65.80N 32 32女均值163.56 52.46N 41 41总计均值168.70 58.31N 73 73ANOVA 表由表同样可得出,各月出生的人身高体重无显著性差异。
计量经济学案例分析汇总
计量经济学案例分析1一、研究的目的要求居民消费在社会经济的持续发展中有着重要的作用。
居民合理的消费模式和居民适度的消费规模有利于经济持续健康的增长,而且这也是人民生活水平的具体体现。
改革开放以来随着中国经济的快速发展,人民生活水平不断提高,居民的消费水平也不断增长。
但是在看到这个整体趋势的同时,还应看到全国各地区经济发展速度不同,居民消费水平也有明显差异。
例如,2002年全国城市居民家庭平均每人每年消费支出为6029.88元, 最低的黑龙江省仅为人均4462.08元,最高的上海市达人均10464元,上海是黑龙江的2.35倍。
为了研究全国居民消费水平及其变动的原因,需要作具体的分析。
影响各地区居民消费支出有明显差异的因素可能很多,例如,居民的收入水平、就业状况、零售物价指数、利率、居民财产、购物环境等等都可能对居民消费有影响。
为了分析什么是影响各地区居民消费支出有明显差异的最主要因素,并分析影响因素与消费水平的数量关系,可以建立相应的计量经济模型去研究。
二、模型设定我们研究的对象是各地区居民消费的差异。
居民消费可分为城市居民消费和农村居民消费,由于各地区的城市与农村人口比例及经济结构有较大差异,最具有直接对比可比性的是城市居民消费。
而且,由于各地区人口和经济总量不同,只能用“城市居民每人每年的平均消费支出”来比较,而这正是可从统计年鉴中获得数据的变量。
所以模型的被解释变量Y 选定为“城市居民每人每年的平均消费支出”。
因为研究的目的是各地区城市居民消费的差异,并不是城市居民消费在不同时间的变动,所以应选择同一时期各地区城市居民的消费支出来建立模型。
因此建立的是2002年截面数据模型。
影响各地区城市居民人均消费支出有明显差异的因素有多种,但从理论和经验分析,最主要的影响因素应是居民收入,其他因素虽然对居民消费也有影响,但有的不易取得数据,如“居民财产”和“购物环境”;有的与居民收入可能高度相关,如“就业状况”、“居民财产”;还有的因素在运用截面数据时在地区间的差异并不大,如“零售物价指数”、“利率”。
计量经济学案例
计量经济学案例
嘿,各位小伙伴们!今天咱就来讲讲超级有意思的计量经济学案例。
咱就说啊,你看那超市里的各种商品价格,是不是有时候会有波动呀?
这背后可就藏着计量经济学的奥秘呢!比如说牛奶,为啥这个月贵了,下个月又便宜了呢?这就好像是一个神秘的谜团等待我们去解开。
想象一下,我们就是那些聪明的侦探,要通过各种数据和分析,去找出
价格变化的原因。
计量经济学不就是我们手中的神奇工具嘛!比如说我们可以研究销售量和价格之间的关系,哇塞,那可太有趣了!
之前我就碰到过一个案例,一家公司想知道怎么能提高他们产品的销量。
于是呢,我们就开始收集各种数据,像消费者的喜好啦,市场的趋势啦。
这就好比是在拼凑一幅巨大的拼图!然后呢,通过计量经济学的方法,我们发现了一些很有意思的关联。
就好像突然找到了打开宝藏大门的钥匙!
我们分析出来要是调整一下价格,再改进一下产品的包装,那销量很可
能就蹭蹭往上涨啦!这不就是计量经济学的魅力所在嘛。
大家想一想,如果没有计量经济学,那我们不就像无头苍蝇一样乱撞啊!还怎么有效地做出决策呢?
所以啊,计量经济学真的超级重要,它就像我们的导航,指引着我们在商业的海洋中航行。
别小看这些案例,它们真的能给我们带来巨大的收获呢!它能帮助我们理解经济现象背后的逻辑,让我们更明智地做出选择。
小伙伴们,是不是对计量经济学更感兴趣了呢?赶紧去探索更多的计量经济学案例吧!。
计量经济学案例分析作业.doc
计量案例分析学院:国际贸易学院班级:贸易经济2班姓名:___________学号:_______2013年12月16日□ Equati on: UNTITLED Workfile: UNTITLED::Untitled、View | Proc | Object | Print〔Name〔Freeze] Estimate | Forecast | Stats | Resids |Dependent Variable: YMethod: Least SquaresDate: 12/21/13 Time: 19:06Sample: 1994 2007Included observations: 14VariableCoefficientStd.Errort-Statistic Prob.C•1471.9561137.046-1.294544 0.2316X2 0.042510.0046139.216082 0.0000X3 4.4324781.0633414.168445 0.0031X4 2.9222731.0936652.6720010.0283X5 1.4267861.4175551.006512 0.3436X6 -354.9821244.8486-1.449802 0.1852R-squared0.997311Mean dependent var3527.783Adjusted R-squared 0.995630 S.D. dependent var 1927.495S.E. of regression 127.4135 Akaike info criterion 12.83028Sum squared resid 129873.5 Schwarz criterion 13.10416Log likelihood -83.81195 Hannan-Quinn criter. 12.80493F-statistic 593.4168 Durbin-Watson stat 1.558415Prob(F-statistic) 0.0000019941997年中国旅游收入及相关数据¥=-1471.96+0.0425X2+4.432X3+2.922X4+1.427X5-354.98X6R2 =0.997 -R=0.996经济意义:说明假定其他变量不变的情况下,各每增加1万人次的国内旅游人数、1元的城镇居民人均旅游花费、1元的农村居民人均旅游花费、1万公里的公路里程和1万公里的铁路里程,国内旅游收入就会相应的增加0. 0425亿元、4. 432亿元、2.922亿元、1.427亿元和减少354. 98亿元。
用计量经济学解读可口可乐(WORD档)
用计量经济学解读可口可乐“市场渗透率”只能从统计学的角度解读,可口可乐为什么卖得这么多,我们先看看牛津大学计量经济学系的菲利普.琼斯教授对消费品的研究,了解琼斯教授是如何解读“市场渗透率”是什么,以及“市场渗透率”是如何影响销量的。
琼斯教授借助另外一位同行的分析工具,能相对精确计算出在某个区域某个时期某品牌的销售总额。
当然这套工具同样适合可口可乐。
埃伦伯格公式:(单位时间内/单位范围内)销售额=国内家庭数目(稳定的)×购买此品牌的家庭比例[市场渗透率-变化大]×每个消费者的购买次数[购买频率-变化小]×每次购买量(稳定的)×每件产品的重量或价格(稳定的)琼斯教授认为,在这五项指标中最活泼的因素是市场渗透率,对于市场渗透率,有着众多不同的解释,而琼斯教授的解释是:至少购买一件某产品的百分比(通常是家庭、凡购买过该产品的都算)。
通俗点讲就是:有多少人买过,或者叫“人气”。
琼斯教授不但规范了我们对“市场渗透率”的定义,并且琼斯教授精确推算出这个市场渗透率是呈递式的速度增加的。
这个怎么讲呢?通俗地讲是“在某个区域的人是有一个固定量的,这个地方总共只有一万人,不可能无限制地增长人气”。
所以可口可乐如果连深山老农这种“最角落”的人都喝过的话,说明他的人气太旺了,其市场渗透率太高了!试问天下人,有几个没喝过可口可乐?至此,琼斯教授认为只要有市场渗透率,其他相对都不重要!按他的意思讲就是,只要有人气,什么都有了!因为这个结论的依据是消费者买完某产品后,一定会继续回头再买。
并且消费者会按照一定的频率买,比如:烟草是一天一包,饮料通常是3天一次,牙膏是2个月一次。
而在这个频率下消费者迟早会再买你的品牌(对此琼斯教授的理由是消费者有定期更换品牌的需要)。
多么完美和理想化的工具,我们也希望这个世界是有序和理性的。
一切尽在掌握!但事实总会跟理想有差距,当我们再研究中国茶饮时却发现一个完全相反的悖论,就是有些茶饮的市场渗透度越高,这个品牌反而死得越快,为什么?我们认为主要有两个原因,第一个原因相对简单,也容易解释,那就是这个品牌的口感或者质量不符合消费者的要求,随着越来越多消费者的尝试,回头客也越来越少。