
李春葆《数据结构教程》(第4版)笔记和课后习题详解(外排序)【圣才出品】
第11章外排序
11.1 复习笔记
一、外排序概述
文件存储在外存上,因此外排序方法与各种外存设备的特征有关。
外排序的基本方法是归并排序法。
它分为以下两个步骤:
1.生成若干初始归并段(顺串)
将一个文件(含待排序的数据)中的数据分段读入内存,在内存中对其进行内排序,并将经过排序的数据段(有序段)写到多个外存文件上。
2.多路归并
对这些初始归并段进行多遍归并,使得有序的归并段逐渐扩大,最后在外存上形成整个文件的单一归并段,也就完成了这个文件的外排序。
二、磁盘排序
1.磁盘排序概述
磁盘是直接存取设备,读/写一个数据块的时间与当前读/写头所处的位置关系不大,存放在磁盘中的文件的排序属典型的外排序。
磁盘排序过程如图11-1所示.
图11-1 磁盘排序过程
磁盘中的F in文件包括待排序的数据,通过相关算法将F in文件中数据一部分一部分地调入内存(每个记录被读一次)处理,产生若干个文件F1~F n(每个记录被写一次),它们都是有序的,称为顺串。
然后再次将F1~F n文件中的记录调入内存(每个记录被读一次),通过相关归并算法产生一个有序的F out文件(每个记录被写一次),从而达到数据排序的目的。
可见,提高排序速度很重要的一个方面是减少对数据的扫描遍数。
2.生成初始归并段
使用置换—选择的排序算法用于生成较长的初始归并段。
采用置换—选择排序算法生成初始归并段时,内排序基于选择排序,即从若干个记录中通过关键字比较选择一个最小的记录,同时在此过程中进行记录的输入和输出,最后生成若干个长度可能各不相同的有序文件。
基本步骤如下:
(1)从待排序文件F in中按内存工作区WA的容量(设为w)读入w个记录,设归并段编号i=1;
(2)从WA中选出关键字最小的记录R min;
(3)将R min 记录输出到文件F i 中,作为当前归并段的一个成员;
(4)若F in 不空,则从F in 中读入下一个记录到WA 中替代刚输出的记录;
(5)从WA 工作区中所有大于或等于R min 的记录中选择出最小记录作为新的R min ,转(3),直到选不出这样的R min ;
(6)置i=i+1,开始一个新的归并段;
(7)若WA 工作区已空,则初始归并段已全部产生,否则转(2)。
置换-选择排序算法所生成的初始归并段的长度既与内存工作区的大小有关,也与输入文件中记录的排列次序有关。
3.多路平衡归并
(1)k 路平衡归并的效率分析
归并过程基本上是二路平衡归并的过程。
一般说来,如果初始归并段有m 个,那么这样的归并树就有
⎡⎤1log 2+m 层,要对数据进行⎡⎤m 2log 遍扫描。
类似地,采用k 路平衡归并时,则相应的归并树有⎡⎤1log 2+m 层,要对数据进行s=⎡⎤m 2log 遍扫描,显然,k 越大,磁盘读写次数越少。
在进行内部归并时,在k 个记录中选择最小者,需要进行k-1次关键字比较。
每趟归并u 个记录需要做(u-1)×(k-1)次关键字比较,则s 趟归并总共需要的关键字比较次数为:
⎡⎤⎡⎤⎡⎤k k u m k u m k u s k k 2log /)1()1(log )
1()1(log )1()1(-⨯-⨯=-⨯-⨯=-⨯-⨯
在初始归并段个数m 与记录个数u 一定时,其中的⎡⎤)1(log 2-⨯u m 是常量,而⎡⎤k k 2log /)1(-在k 增大时趋于无穷大。
因此,增大归并路数k ,会使内部归并的时间增
加,若k增大到一定的程度,就会抵消掉由于减少磁盘读写次数而赢得的时间。
也就是说,在k路平衡归并中,并非k越大,归并的效率就越高。
(2)k路平衡归并过程
利用败者树实现k路平衡归并的过程是,先建立败者树,然后对k个输入有序段进行k 路平衡归并。
败者树是一棵有k个叶子节点的完全二叉树,其中叶子节点存储记录,分支节点存放关键字对应的段号。
对k个有序段进行k路平衡归并的方法如下:
①取每个输入有序段的第一个记录作为败者树的叶子节点,建立初始败者树:叶子节点之间两两比较,在双亲节点中记录比赛的败者(关键字较大者),而让胜者去参加更高一层的比赛,如此,在根节点上胜出的“冠军”是关键字最小者;
②胜出的记录写至输出归并段,在对应的叶子节点处,补充输入有序段的下一个记录,若该有序段变空,则补充一个关键字大(比所有记录关键字都大,设为k max)的虚记录;
③调整败者树,选择新的关键字最小的记录:从补充记录的叶子节点向上和双亲节点的关键字比较,败者留在该双亲节点,胜者继续向上,直至树的根节点,最后将胜者放在根节点的双亲节点中;
④若胜出的记录关键字等于k max,则归并结束,否则转②继续。
当采用败者树实现多路平衡归并时,只要内存空间允许,增大归并路数k,可以有效地减少归并树的深度,从而减少读写磁盘的次数,提高外排序的速度。
4.最佳归并树
归并树是描述归并过程的k次树。
因为每一次做k路归并都需要有k个归并段参加,因此,归并树是只包含度为0和度为k的节点的标准k次树。
最佳归并树是带权路径长度最短的k次(阶)哈夫曼树,构造步骤如下:
(1)若(m-1)mod(k-1)≠0,则需附加(k-1)-(m-1)mod(k-1)个长度为0的虚段,以使每次归并都可以对应k个段;
(2)按照哈夫曼树的构造原则(权值越小的节点离根节点越远)构造最佳归并树。
在前面的例子中,m0=11,k=3,(11-1)mod(3-1)=0,可以不加空归并段,直接进行3路归并。
三、磁带排序
1.多路平衡归并排序
先对输入文件的各段进行内排序,生成初始归并段,再把它们写到磁带上,然后再把这些归并段进行反复的归并,直到只剩下一个归并段为止。
采用多路归并能够减少扫描的遍数,但对磁带排序来说,多路归并需要多台磁带,为了避免过多的磁带寻找时间,要归并的归并段需要放在不同的磁带上。
2.多阶段归并排序
多阶段归并排序实际上是多路非平衡归并排序,即各条带上的归并段不再保持平衡分布。
它在k路归并中仅使用(k+1)条磁带,就可避免在多路平衡归并排序法中遇到的重新分布有序段的问题。
开始时,初始归并段不平衡地分配在前k条磁带上,第(k+1)条磁带作为输出带,开始为空。
每一步归并只是部分记录参加,归并段最少的带在本步归并完成后便成为空带,作为下一步归并的输出带。
这样,(k+1)条磁带将轮流成为输出带,直到整个文件为一个排序文件为止。
11.2 课后习题详解
1.外排序中两个相对独立的阶段是什么?
答:外排序中两个相对独立的阶段是产生初始归并段和多路归并排序。
2.设输入的关键字满足k1>k2>…>k n,缓冲区大小为m,用置换—选择排序方法可产生多少个初始归并段?
答:可产生⌈n/m⌉个初始归并段。
设记录R i的关键字为k i(1≤i≤n),先读入m个记录R1,R2,…,R m,采用败者树选择R m,将其输出到归并段1,Rmin=k m,在该位置上读入R m+1,采用败者树选择R m-1,将其输出到归并段1,Rmin=k m-1,在该位置上读入R m+2,采用败者树选择R m-2,将其输出到归并段1,Rmin=k m-2,…,产生归并段1:{ R m,R m-1,…,R1}。
同样产生其他归并段{ R2m,R2m-1,…,R m+1},…,一共有⌈n/m⌉个初始归并段。
3.设输入的关键字满足k1<k2<…<k n,缓冲区大小为m,用置换—选择排序方法可产生多少个初始归并段?
答:可产生1个初始归并段。
设记录R i的关键字为k i(1≤i≤n),先读入m个记录R1,R2,…,R m,采用败者树选择R1,将其输出到归并段1,Rmin=k1,在该位置上读入R m+1,采用败者树选择R2,由于k2>Rmin,将其输出到归并段1,Rmin=k2,在该位置上读入
R m+2,…,如此,只产生一个初始归并段,其记录为:{ R1,R2,…,R n}。
实际上,由于关键字满足k1<k2<…<k n,它已经是一个初始归并段了。
4.如果某个文件经内排序得到80个初始归并段,试问:
(1)若使用多路归并执行3趟完成排序,那么应取的归并路数至少应为多少?
(2)如果操作系统要求一个程序同时可用的输入/输出文件的总数不超过15个,则。
李春葆《数据结构教程》(第4版)课后习题-数组和广义表(圣才出品)
第6章数组和广义表1.简述数组属于线性表的原因。
答:数组可以看成是线性表在下述含义上的扩展:线性表中的数据元素本身也是一个线性表。
在n维数组中的每个数据元素都受着n个关系的约束,在每个关系中,数据元素都有一个后继元素(除去最后一个元素)和一个前驱元素(除去最前一个元素)。
因此,这n个关系中的任一关系,就其单个关系而言仍是线性关系。
例如,m×n的二维数组的形式化定义如下:2.n阶对称矩阵A的下三角元素存储在一维数组B中,则B包含多少个元素?答:B中包含n阶对称矩阵A的下三角和主对角线上的元素,其元素个数为1+2+…+n=(n(n+1))/2,所以B包含(n(n+1))/2个元素。
3.设有三对角矩阵A n×n(从A1,1开始),将其三对角线上元素逐行存于数组B [1..m]中,使B[k]=A i,j,求:(1)用i,j表示k的下标变换公式;(2)用k表示i,j的下标变换公式。
答:在三对角矩阵中,除了第一行和最后一行各有两个元素外,其余各行均有三个非零元素,所以共有3n-2个非零元素。
(1)主对角线左下角的对角线上的元素的下标有关系式:i=j+1,此时的k有:k=3(i-1)=2(i-1)+j主对角线上的元素的下标有关系式:i=j,此时的k有:k=3(i-1)+1=2(i-1)+j主对角线右上角的对角线上的元素的下标有关系式:i=j-1,此时的k有:k=3(i-1)+2=2(i-1)+j综合起来得到:k=2(i-1)+j(2)k与i,j的变换公式为:i=k/3+1;j=k-2(i-1)4.用十字链表表示一个有k个非0元素的m×n的稀疏矩阵,则其总的节点数为多少?答:该十字链表有一个十字链表头节点,MAX(m,n)个行、列头节点。
另外,每个非零元素对应一个节点,即k个元素节点,所以共有MAX(m,n)+k+1个节点。
5.设定二维整数数组B[0..m-1,0..n-1]的数据在行、列方向上都按从小到大的顺序排序,且整型变量x中的数据在B中存在。
李春葆《数据结构教程》(第4版)模拟试题及详解(一)(圣才出品)
第四部分模拟试题李春葆《数据结构教程》(第4版)模拟试题及详解(一)一、单项选择题(每小题2分,共20分)1.队列的特点是()。
A.先进后出B.先进先出C.任意位置进出D.前面都不正确【答案】B2.有n个记录的文件,如关键字位数为d,基数为r,则基数排序共要进行()遍分配与收集。
A.nB.dC.rD.n-d【答案】B【解析】基数排序是按组成关键字的各位值进行分配收集而完成的。
3.在二叉树节点的先序序列、中序序列和后序序列中,所有叶子节点的先后顺序()。
A.都不相同B.完全相同C.先序和中序相同,而与后序不同D.中序和后序相同,而与先序不同【答案】B【解析】无论是哪种遍历方式,遍历叶子节点时,都是先访问左子树,后访问右子树。
4.限定在一端加入和删除元素的线性表称为()。
A.双向链表B.单向链表C.栈D.队列【答案】C【解析】根据栈后进先出的特性,可见栈都在一端对元素进行操作。
5.设内存工作区可容纳8个记录,初始文件共有64个关键字不同的记录,且已按关键字递减排列,如用置换.选择排序产生初始归并段,最长初始归并段所含记录数是()。
A.6B.7C.8D.9【答案】C【解析】对于置换选择排序,输入的文件是以关键字降序排列时,所得的初始归并段的最大长度为工作区的大小。
当输入的文件以关键字的升序排序时,只能得到一个长度为文件长度的初始归并段。
6.设森林F对应的二叉树为B,它有m个节点,B的根为p,p的右子树上的节点个数为n,森林F中第一棵树的节点个数是()。
A.m-n-1B.n+lC.m-n+1D.m-n【答案】D7.设有198个初始归并段,如采用K-路平衡归并三遍完成排序,则K值最大为()。
A.12B.13C.14D.15【答案】C【解析】k一路平衡归并,归并趟数公式s=[1og k m],m指归并段数,s指趟数。
要三遍完成遍历,那就看两遍完成排序的需遍历的最小数。
把s=2和m=198带入公式,可知两遍完成排序时k最小为15,所以k<15。
李春葆《数据结构教程》(第4版)笔记和课后习题详解(第8~10章)【圣才出品】
李春葆《数据结构教程》(第4版)笔记和课后习题详解第8章图8.1复习笔记一、图的基本概念1.图的定义图都是由顶点和边构成的。
采用形式化的定义,图G由两个集合V和E组成,记为G =(V,E),其中V是顶点的有限集合,记为V(G),E是连接V中两个不同顶点(顶点对)的边的有限集合,记为E(G)。
抽象数据类型图的定义如下:2.图的基本术语(1)端点和邻接点在一个无向图中,若存在一条边(i,j),则称顶点i和顶点j为该边的两个端点,并称它们互为邻接点,即顶点i是顶点j的一个邻接点,顶点j也是顶点i的一个邻接点。
(2)顶点的度、入度和出度①度在无向图中,某顶点所具有的边的数目称为该顶点的度。
②入度在有向图中,顶点i的度又分为入度和出度,以顶点i为终点的入边的数目,称为该顶点的入度。
③出度以顶点i为起点的出边的数目,称为该顶点的出度。
一个顶点的入度与出度的和为该顶点的度。
(3)完全图若无向图中每两个顶点之间都存在一条边,或有向图中每两个顶点之间都存在着方向相反的两条边,则称此图为完全图。
(4)稠密图和稀疏图①稠密图当一个图接近完全图时,称为稠密图。
②稀疏图当一个图含有较少的边数(即当e<<n(n-1))时,则称为稀疏图。
(5)子图设有两个图G=(V,E)和G′=(V′,E′),若V′是V的子集,即V′≤V,且E′是E的子集,即E′≤E,则称G′是G的子图。
(6)路径和路径长度①路径在一个图G=(V,E)中,从顶点i到顶点j的一条路径是一个顶点序列(i,i1,i2,…,i m),若此图G是无向图,则边(i,i1),(i1,i2),…,(i m-1,i m),(i m,j)属于E(G);若此图是有向图,N<i,i1>,<i1,i2>,…,<i m-1,i m>,<i m,j>属于E(G)。
②路径长度路径长度是指一条路径上经过的边的数目。
(7)回路或环若一条路径上的开始点与结束点为同一个顶点,则称此路径为回路或环。
数据结构教程李春葆第4版知识点习题答案
第1章绪论知识点归纳一、数据结构概述1.数据结构的定义(1)基本概念数据是描述客观事物的数和字符的集合,是计算机能操作的对象的总称,也是计算机处理信息的某种特定的符号表示形式。
(2)相关术语① 数据元素数据元素又称元素、节点、顶点、记录等。
数据元素是数据的基本单位。
有时候,一个数据元素可以由若干个数据项组成。
② 数据项数据项又称字段或域,它是具有独立含义的最小数据单位。
③ 数据对象数据对象是性质相同的数据元素的集合,它是数据的子集。
(3)数据结构的内容① 数据元素之间的逻辑关系,即数据的逻辑结构,它是数据结构在用户面前呈现的形式。
② 数据元素及其关系在计算机存储器中的存储方式,即数据的存储结构,又称数据的物理结构。
③ 施加在数据上的操作,即数据的运算。
(4)逻辑结构数据的逻辑结构是从逻辑关系(主要是指数据元素的相邻关系)上描述数据的,它与数据的存储无关,是独立于计算机的。
因此,数据的逻辑结构可以看作是从具体问题抽象出来的数学模型。
(5)存储结构数据的存储结构是逻辑结构用计算机语言的实现或在计算机中的表示(又称映像),也就是逻辑结构在计算机中的存储方式,它是依赖于计算机语言的。
一般只在高级语言(例如C/C++语言)的层次上讨论存储结构。
数据的运算最终需在对应的存储结构上用算法实现。
总之,数据结构是一门讨论“描述现实世界实体的数学模型(通常为非数值计算)及其之上的运算在计算机中如何表示和实现”的学科。
(6)数据结构的表示对于一种数据结构,其逻辑结构总是惟一的,但它可能对应多种存储结构,并且在不同的存储结构中,同一运算的实现过程可能不同。
描述数据结构通常采用二元组表示:B=(D,R)其中,B是一种数据结构,它由数据元素的集合D和D上二元关系的集合R组成,即:D={d i | 1≤i≤n,n≥0}R={r j | 1≤j≤m,m≥0}其中d i表示集合D中的第i个数据元素(或节点),n为D中数据元素的个数,特别地,若n=0,则D 是一个空集。
李春葆《数据结构教程》(第4版)笔记和课后习题详解(线性表)【圣才出品】

第2章线性表2.1 复习笔记一、线性表及其逻辑结构1.线性表的定义线性表是具有相同特性的数据元素的一个有限序列。
该序列中所含元素的个数叫做线性表的长度,用n表示,n≥0。
当n=0时,表示线性表是一个空表,即表中不包含任何元素。
2.线性表的表示设序列中第i(i表示逻辑序号)个元素为a i(1≤i≤n),则线性表的一般表示为:(a1,a2,…,a i,a i+1,…,a n)其中a1为第一个元素,又称做表头元素,a2为第二个元素,…,a n为最后一个元素,又称做表尾元素。
一个线性表可以用一个标识符来命名,如用L命名上面的线性表,则:L=(a1,a2,…,a i,a i+1,…,a n)线性表中的元素是与位置有关的,即第i个元素a i处在第i-1个元素a i-1的后面和第i+1个元素a i+1的前面。
这种位置上的有序性就是一种线性关系,所以线性表是一种线性结构,用二元组表示为:L=(D,R),其中:对应的逻辑结构如图2-1所示。
图2-1 线性表的逻辑结构示意图3.线性表的抽象数据类型描述抽象数据类型线性表的定义如下:二、线性表的顺序存储结构1.顺序表(1)线性表的存储结构线性表的顺序存储结构是把线性表中的所有元素按照其逻辑顺序依次存储到从计算机存储器中指定存储位置开始的一块连续的存储空间中,如图2-2所示。
图2-2 线性表到顺序表的映射由于线性表中逻辑上相邻的两个元素在对应的顺序表中的存储位置也相邻,所以这种映射称为直接映射。
这样,线性表中第一个元素的存储位置就是指定的存储位置,第i+1个元素(1≤i≤n-1)的存储位置紧接在第i个元素的存储位置的后面。
假定线性表的元素类型为ElemType,则每个元素所占用存储空间大小(即字节数)为sizeof(ElemType),整个线性表所占用存储空间的大小为n×sizeof(ElemType),其中n表示线性表的长度。
在C/C++语言中,线性表的顺序存储结构是利用数组来实现的,数组的基本类型就是线性表中元素的类型,数组的大小要大于等于线性表的长度。
李春葆《数据结构教程》(第4版)课后习题-串(圣才出品)
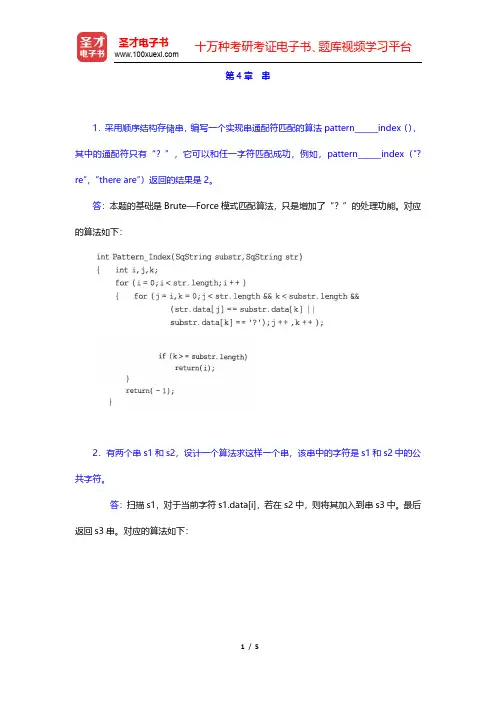
第4章串1.采用顺序结构存储串,编写一个实现串通配符匹配的算法pattern______index(),其中的通配符只有“?”,它可以和任一字符匹配成功,例如,pattern______index(″? re″,″there are″)返回的结果是2。
答:本题的基础是Brute—Force模式匹配算法,只是增加了“?”的处理功能。
对应的算法如下:2.有两个串s1和s2,设计一个算法求这样一个串,该串中的字符是s1和s2中的公共字符。
答:扫描s1,对于当前字符s1.data[i],若在s2中,则将其加入到串s3中。
最后返回s3串。
对应的算法如下:3.设目标为t=’abcaabbabcabaacbacba’,模式p=’abcabaa’。
(1)计算模式P的nextval函数值。
(2)不写算法,只画出利用KMP算法进行模式匹配时的每一趟匹配过程。
答:(1)先计算next数组,在此基础上求nextval数组,如表4-1所示。
表4-1 计算next数组和nextval数组(2)采用KMP算法求子串位置的过程如下(开始时i=0,j=0):第1趟匹配:此时i=4,j=4,匹配失败,而nextval[4]=0,则i=4,j=nextval[4]=0,即:第2趟匹配:此时i=6,j=2,匹配失败,而nextval[2]=0,则i=6,j=nextval[2]=0,即:第3趟匹配:此时i=6,j=0,匹配失败,而nextval[0]=-1,则i=6,j=nextval[0]=-1。
因j=-1,执行i=i+1=7,j=j+1=0,即:第4趟匹配:此时i=14,j=7,匹配成功,返回v=i-t.1ength=14-7=7。
上机实验题4实验题1编写一个程序algo4-1.cpp,实现顺序串的各种基本运算,并在此基础上设计一个程序exp4-1.cpp完成如下功能:(1)建立串s=″abcdefghefghijklmn″和串sl=″xyz″;(2)输出串s;(3)输出串s的长度;(4)在串s的第9个字符位置插入串s1而产生串s2;(5)输出串s2;(6)删除串s第2个字符开始的5个字符而产生串s2;(7)输出串s2;(8)将串s第2个字符开始的5个字符替换成串s1而产生串s2;(9)输出串s2;(10)提取串s的第2个字符开始的10个字符而产生串s3;(11)输出串s3;(12)将串s1和串s2连接起来而产生串s4;(13)输出串s4。
李春葆《数据结构教程》(第4版)课后习题-第一章至第十二章(圣才出品)
第二部分课后习题第1章绪论1.简述数据与数据元素的关系与区别。
答:凡是能被计算机存储、加工的对象统称为数据,数据是一个集合。
数据元素是数据的基本单位,是数据的个体。
数据与元素之间的关系是元素与集合之间的关系。
2.数据结构和数据类型有什么区别?答:数据结构是互相之间存在一种或多种特定关系的数据元素的集合,一般包括三个方面的内容,即数据的逻辑结构、存储结构和数据的运算。
而数据类型是一个值的集合和定义在这个集合上的一组运算的总称,如C语言中的int数据类型是由-32768~32767(16位机)的整数和+、-、*、/、%等运算符组成。
3.设3个表示算法频度的函数f、g和h分别为:f(n)=100n3+n2+1000g(n)=25n3+5000n2h(n)=n1.5+5000nlog2n求它们对应的时间复杂度。
答:f(n)=100n3+n2+1000=O(n3),g(n)=25n3+5000n2=O(n3),当n→∞时,√n>log2n,所以h(n)=n1.5+5000nlog2n=O(n1.5)。
4.用C/C++语言描述下列算法,并给出算法的时间复杂度。
(1)求一个n阶方阵的所有元素之和。
(2)对于输入的任意三个整数,将它们按从小到大的顺序输出。
(3)对于输入的任意n个整数,输出其中的最大和最小元素。
答:(1)算法如下:本算法的时间复杂度为O(n2)。
(2)算法如下:本算法的时间复杂度为O(1)。
(3)算法如下:本算法的时间复杂度为O(n)。
5.设n为正整数,给出下列各种算法关于n的时间复杂度。
(1)(2)(3)答:(1)设while循环语句执行次数为T(n),则:(2)算法中的基本运算语句是if(b[k]>b[j])k=j,其执行次数T(n)为:(3)设while循环语句执行次数为T(n),则:则6.有以下递归算法用于对数组a[i..j]的元素进行归并排序:求mergesort(a,0,n-1)的时间复杂度。
李春葆《数据结构教程》(第4版)课后习题-绪论(圣才出品)
第二部分课后习题第1章绪论1.简述数据与数据元素的关系与区别。
答:凡是能被计算机存储、加工的对象统称为数据,数据是一个集合。
数据元素是数据的基本单位,是数据的个体。
数据与元素之间的关系是元素与集合之间的关系。
2.数据结构和数据类型有什么区别?答:数据结构是互相之间存在一种或多种特定关系的数据元素的集合,一般包括三个方面的内容,即数据的逻辑结构、存储结构和数据的运算。
而数据类型是一个值的集合和定义在这个集合上的一组运算的总称,如C语言中的int数据类型是由-32768~32767(16位机)的整数和+、-、*、/、%等运算符组成。
3.设3个表示算法频度的函数f、g和h分别为:f(n)=100n3+n2+1000g(n)=25n3+5000n2h(n)=n1.5+5000nlog2n求它们对应的时间复杂度。
答:f(n)=100n3+n2+1000=O(n3),g(n)=25n3+5000n2=O(n3),当n→∞时,√n>log2n,所以h(n)=n1.5+5000nlog2n= O(n1.5)。
4.用C/C++语言描述下列算法,并给出算法的时间复杂度。
(1)求一个n阶方阵的所有元素之和。
(2)对于输入的任意三个整数,将它们按从小到大的顺序输出。
(3)对于输入的任意n个整数,输出其中的最大和最小元素。
答:(1)算法如下:本算法的时间复杂度为O(n2)。
(2)算法如下:本算法的时间复杂度为O(1)。
(3)算法如下:本算法的时间复杂度为O(n)。
5.设n为正整数,给出下列各种算法关于n的时间复杂度。
(1)(2)(3)答:(1)设while循环语句执行次数为T(n),则:(2)算法中的基本运算语句是if(b[k]>b[j])k=j,其执行次数T(n)为:(3)设while循环语句执行次数为T(n),则:则6.有以下递归算法用于对数组a[i..j]的元素进行归并排序:求mergesort(a,0,n-1)的时间复杂度。
李春葆《数据结构教程》(第4版)笔记和课后习题详解(内排序)【圣才出品】
第10章内排序10.1 复习笔记一、排序的基本概念1.定义排序,就是整理表中的元素,使之按关键字递增或递减的顺序排列,本章仅讨论递增排序的情况。
其确切定义如下:输入:n个元素,R0,R1,…,R n-1,相应的关键字分别为k0,k1,…,k n-1。
输出:R i0,R i1,…,R in-1,使得k i0≤k i1≤…≤k in-1。
因此,排序算法就是要确定0,1,…,n-1的一种排列i0,i1,…,i n-1,使表中的元素依此排列整理后按关键字有序。
2.排序的稳定性(1)稳定如果待排序的表中,存在多个关键字相同的元素,经过排序后这些具有相同关键字的元素之间的相对次序保持不变,则称这种排序方法是稳定的。
(2)不稳定若具有相同关键字的元素之间的相对次序发生变化,则称这种排序方法是不稳定的。
注意:排序算法的稳定性是针对所有输入实例而言的。
在所有可能的输入实例中,只要有一个实例使得算法不满足稳定性要求,则该排序算法就是不稳定的。
3.内排序和外排序(1)内排序在排序过程中,若整个表都是放在内存中处理,排序时不涉及内、外存数据的交换,则称之为内排序。
内排序适用于元素个数不很多的小表。
(2)外排序若排序过程中要进行内、外存数据的交换,则称之为外排序。
外排序则适用于元素个数很多,不能一次将全部元素放入内存的大表。
内排序是外排序的基础。
(3)排序方法的其他分类①需要关键字比较的排序需要关键字比较的排序方法有插入排序、选择排序、交换排序和归并排序等。
②不需关键字比较的排序不需要关键字比较的排序方法有基数排序。
4.排序数据的组织在本章中,以顺序表作为排序数据的存储结构,假设关键字类型为整型。
待排序的顺序表中数据元素的类型定义如下:二、插入排序1.插入排序的思想及方法基本思想是:每次将一个待排序的元素,按其关键字大小插入到已经排好序的子表中的适当位置,直到全部元素插入完成为止。
主要有两种插入排序方法,即直接插入排序和希尔排序。
李春葆数据结构教程第4版习题答案
1章答案1.简述数据与数据元素的关系与区别。
解:凡是能被计算机存储、加工的对象统称为数据,数据是一个集合。
数据元素是数据的基本单位,是数据的个体。
数据与元素之间的关系是元素与集合之间的关系。
2.数据结构和数据类型有什么区别?解:数据结构是互相之间存在一种或多种特定关系的数据元素的集合,一般包括三个方面的内容,即数据的逻辑结构、存储结构和数据的运算。
而数据类型是一个值的集合和定义在这个集合上的一组运算的总称,如C语言中的int数据类型是由-32768~32767(16位机)的整数和+、-、*、/、%等运算符组成。
3.设3个表示算法频度的函数f、g和h分别为:f(n)=100n3+n2+1000 g(n)=25n3+5000n2 h(n)=n1.5+5000nlog2n求它们对应的时间复杂度。
解:f(n)=100n3+n2+1000=O(n3),g(n)=25n3+5000n2=O(n3),当n→∞时,√n>log2n,所以h(n)=n1.5+5000nlog2n= O(n1.5)。
4.用C/C++语言描述下列算法,并给出算法的时间复杂度。
(1)求一个n阶方阵的所有元素之和。
(2)对于输入的任意三个整数,将它们按从小到大的顺序输出。
(3)对于输入的任意n个整数,输出其中的最大和最小元素。
解:(1)算法如下:本算法的时间复杂度为O(n2)。
(2)算法如下:本算法的时间复杂度为O(1)。
(3)算法如下:本算法的时间复杂度为O(n)。
5.设n为正整数,给出下列各种算法关于n的时间复杂度。
(1)(2)(3)解:(1)设while循环语句执行次数为T(n),则:(2)算法中的基本运算语句是if(b[k]>b[j])k=j,其执行次数T(n)为:(3)设while循环语句执行次数为T(n),则:则6.有以下递归算法用于对数组a[i..j]的元素进行归并排序:求mergesort(a,0,n-1)的时间复杂度。