
分类数资料统计推断(一)
医学统计学案例分析(1)
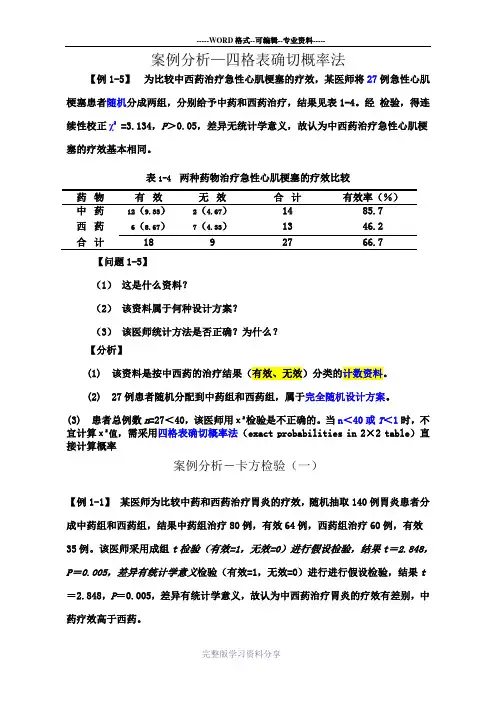
案例分析—四格表确切概率法【例1-5】为比较中西药治疗急性心肌梗塞的疗效,某医师将27例急性心肌梗塞患者随机分成两组,分别给予中药和西药治疗,结果见表1-4。
经检验,得连续性校正χ2=3.134,P>0.05,差异无统计学意义,故认为中西药治疗急性心肌梗塞的疗效基本相同。
表1-4 两种药物治疗急性心肌梗塞的疗效比较药物有效无效合计有效率(%)中药12(9.33)2(4.67)1485.7西药 6(8.67)7(4.33)1346.2合计1892766.7【问题1-5】(1)这是什么资料?(2)该资料属于何种设计方案?(3)该医师统计方法是否正确?为什么?【分析】(1) 该资料是按中西药的治疗结果(有效、无效)分类的计数资料。
(2) 27例患者随机分配到中药组和西药组,属于完全随机设计方案。
(3) 患者总例数n=27<40,该医师用χ2检验是不正确的。
当n<40或T<1时,不宜计算χ2值,需采用四格表确切概率法(exact probabilities in 2×2 table)直接计算概率案例分析-卡方检验(一)【例1-1】某医师为比较中药和西药治疗胃炎的疗效,随机抽取140例胃炎患者分成中药组和西药组,结果中药组治疗80例,有效64例,西药组治疗60例,有效35例。
该医师采用成组t检验(有效=1,无效=0)进行假设检验,结果t=2.848,P=0.005,差异有统计学意义检验(有效=1,无效=0)进行进行假设检验,结果t =2.848,P=0.005,差异有统计学意义,故认为中西药治疗胃炎的疗效有差别,中药疗效高于西药。
【问题1-1】(1)这是什么资料?(2)该资料属于何种设计方案?(3)该医师统计方法是否正确?为什么?(4)该资料应该用何种统计方法?【分析】(1) 该资料是按中西药疗效(有效、无效)分类的二分类资料,即计数资料。
(2) 随机抽取140例胃炎患者分成西药组和中药组,属于完全随机设计方案。
统计复习资料

第一章绪论(一)数据类型1资料的表现特征计数数据:没有计量单位,用于性质、类别等分类中。
属于离散变量。
测量数据:有计量单位。
属于连续变量,可无限分割。
分数是特殊的测量数据。
2 数据的测量水平称名数据:没有大小关系,或称分类数据。
(离散)顺序数据:有分类和排序功能,或称有序数据。
(离散)等距数据:能加减不能乘除,因人定参照点。
(连续)比率数据:可以加减乘除。
(连续)参考已发公式表1(二)变量、观测值、随机变量变量:实验、观察、调查中想要获得的数据。
观测值:通过研究一旦确定了某个值,就称这个值为某一变量的观测值。
随机变量:取值前不能预料取到什么值的变量就叫随机变量。
(三) 总体、样本、个体总体:又称母全体、全域。
指具有某种特征的一类事物的全体。
个体:构成总体的每个基本单元称为个体。
样本:从总体中抽取的一部分个体称为总体的一个样本。
一般来说,样本容量超过30的样本称为大样本,等于或小于30的样本称为小样本。
(四)次数、比率、频率与概率次数:次数是指某一事件在某一类别中出现的数目,又称为频数,用f表示。
比率:两个数的比称为比率。
频率:又称相对次数,即某一事件发生的次数与总的事件发生次数的比值。
概率:又称几率、或然率,用P表示,指某一事件在无限的观测中理应出现的次数。
(五)参数和统计量参数:又称总体参数,是描述一个总体情况的统计指标。
第二章统计量表(一) 数据的初步整理1. 审查资料(初步审查、逻辑审查、抽样审查)2. 数据排序3. 统计分组性质类别(或称品质分组)数量类别(或称数量分组)4. 资料汇总(统计表、统计图)(二) 制作分组次数分布表的步骤min max X X R -= 1求全距K Ri =()52187.1-=N K2 决定组距(i)与组数 (K)3 列出分组区间4 登记次数5 计算次数第三章 集中量数N X X i∑= (一)算数平均数1 直接计算法 ()NAM X AM X i ∑-+=2 用估计平均数计算 (AM 估计平均数,N 数据个数)3 平均数的特点①在一组数据中,每个变量与平均数之差的总合为0;②在一组数据中,每个数都加上常数C ,所得平均数为原来的平均数加上常数C ;③在一组数据中,每个数都乘以常数C ,所得平均数为原来的平均数乘以常数C 。
第13章 有序分类变量的统计推断——非参数检验
13.3.1 Mann-Whitney
U检验
记X和Y的秩和分别为WX和WY,满足 WX+WY=N(N+1)/2。 当X的样本全部排在Y的样本前面时, WX达到最小m(m+1)/2,定义统计量
U= WX -m(m+1)/2
当原假设成立时,两个样本交错出现, 分布均匀,U不会太小或者太大。反之, 如果U偏小或者偏大,则原假设不成立。
13.3.2 分析实例
例13.2
一家权威的房屋建筑协会 提供了最流行的家居装修工程的 成本数据,能否得出厨房的装修 成本与主卧室的装修成本存在差 异呢? 数据见npara2.sav
13.3.2 分析实例
AnalyzeNonparametric Tests 2 independent Samples
第13章计推断非参数检验有序分类变量的统第13章有序分类变量的统计推断非参数检验?131非参数检验概述?132两个配对样本的非参数检验?133两个独立样本的非参数检验131非参数检验概述?1311非参数检验的意义?1312非参数检验预备知识1311非参数检验的意义?非参数检验nonparametrictesting是指在总体不服从正态分布且分布情况不明时用来检验数据资料是否来自同一个总体假设的一类检验方法
13.3.1 Mann-Whitney
U检验
SPSS中提供了四种方法: Mann-Whitney U法(曼-惠特尼U检 验):
通过对平均秩的研究来实现推断的。 类似单样本检验的K-S法,通过对分布的 研究来实现推断。
Kolmogorov-Smirnov Z法:
13.3.1 Mann-Whitney
描述分类变量资料的主要统计指标

描述分类变量资料的主要统计指标在描述统计中,经常要描述两个变量之间的关系,这就是指标。
描述分类变量资料的主要统计指标有:平均数(AV)、中位数(median)、众数(major)、方差(F)、标准差(SD)、相关系数(r)、误差(SEM)、信赖区间(CI)、 F统计值等。
一、全距n。
平均数在统计学上指全部观察单位的算术平均数,即众数、中位数和方差的算术平均数。
它反映了各个变量在总体中所占的比例。
用公式表示为n=AV。
例如:成人牙齿脱落率调查,共调查成人2046人,其中有根以上完全不能保留者占4.5%,按标准脱落百分数计算,每根牙齿应脱落2%。
则该项调查结果的全距是2.5%。
全距愈小说明变量在总体中所占的比例愈大,代表性愈强。
二、方差 1。
方差又称离散系数或变异系数。
由于各个观察单位所得的资料是来自不同的变量,因而这些资料都是不可比的。
但在抽样调查时,要使各个单位取得同样的结论,在对总体进行分析时,就必须把各单位的观察结果加以平均化,从而消除了由于来源不同引起的资料不可比问题,并使各单位的离散状况趋于一致。
这就需要用变异系数将各单位的资料加以平均,使其成为总体的平均资料。
因此,方差就是各个单位的变异程度的一种度量。
方差的符号是σ,单位是标准差(SD)。
2。
标准差的计算公式为:SD=∑[(X-Y)÷2]×100%。
式中SD表示标准差。
标准差的大小是随研究的目的而异的,通常用于某些问题的检验或推断。
如:某县的全年工业总产值的多少与全年粮食总产量的多少成正比;销售额的增长速度快慢与企业利润成正比。
对于全距,方差,标准差,原因,方差是概率统计的专有名词。
在实际工作中,我们通常简单地用:均数×方差=总体标准差(均值×方差=总体方差),来概括变量之间的关系。
当然,我们在阅读统计资料时,有时也会碰到一些专门用语,如果只看题目或只看这些专门用语,也很难理解题意,但只要知道它们的含义就行了。
统计学--第一章医学统计学-绪论

统计量
parameter
参数
sampling error
抽样误差
systematic error
系统误差
measurement error
测量误差
5/10/2020
random event
课件
随机事件
19
relative frequency parameter numerical variable measurement data categorical variable enumeration data ordinal variable rank data design data collection missing data grouping data sorting data analysis descriptive statistics inferential statistics estimation hypothesis test
➢一个科学结论,除了理论机制的阐述外, 还要有一定数量的重复观察结果和合理的 对照等。
5/10/2020
课件
11
为什么要学习医学统计学?
乙药是否比甲药有效?
表 1 甲、乙两疗法对小儿单纯性消化不良治愈率比较
疗法
痊愈数 未痊愈数 合计 治愈率(%)
甲
26
7
33
78.79
乙
36
2
38
94.74
合计
62
讲解本课程的统计方法,并掌握统计软 件SPSS基本操作过程,以及理解其分析 结果。
5/10/2020
课件
3
授课目的
最终能应用SPSS统计软件,将学过的
各种统计分析方法结合具体实际问题或 有关的数据指标进行分析,领会各种统计 数量分析过程和应用中的意义,合理地解 释各种分析结果。
统计学(第五版)贾俊平_课后思考题和练习题答案(最终完整版)

第一部分 思考题
第一章思考题 1.1 什么是统计学 统计学是关于数据的一门学科,它收集,处理,分析,解释来自各个领域的数据并从中得 出结论。 1.2 解释描述统计和推断统计 描述统计;它研究的是数据收集,处理,汇总,图表描述,概括与分析等统计方法。 推断统计;它是研究如何利用样本数据来推断总体特征的统计方法。 1.3 统计学的类型和不同类型的特点 统计数据;按所采用的计量尺度不同分; (定性数据)分类数据:只能归于某一类别的非数字型数据,它是对事物进行分类的结果, 数据表现为类别,用文字来表述; (定性数据)顺序数据:只能归于某一有序类别的非数字型数据。它也是有类别的,但这 些类别是有序的。 (定量数据)数值型数据:按数字尺度测量的观察值,其结果表现为具体的数值。 统计数据;按统计数据都收集方法分; 观测数据:是通过调查或观测而收集到的数据,这类数据是在没有对事物人为控制的条件 下得到的。 实验数据:在实验中控制实验对象而收集到的数据。 统计数据;按被描述的现象与实践的关系分; 截面数据:在相同或相似的时间点收集到的数据,也叫静态数据。 时间序列数据:按时间顺序收集到的,用于描述现象随时间变化的情况,也叫动态数据。 1.4 解释分类数据,顺序数据和数值型数据 答案同 1.3 1.5 举例说明总体,样本,参数,统计量,变量这几个概念 对一千灯泡进行寿命测试,那么这千个灯泡就是总体,从中抽取一百个进行检测,这一百 个灯泡的集合就是样本,这一千个灯泡的寿命的平均值和标准差还有合格率等描述特征的 数值就是参数,这一百个灯泡的寿命的平均值和标准差还有合格率等描述特征的数值就是 统计量,变量就是说明现象某种特征的概念,比如说灯泡的寿命。 1.6 变量的分类 变量可以分为分类变量,顺序变量,数值型变量。 变量也可以分为随机变量和非随机变量。经验变量和理论变量。 1.7 举例说明离散型变量和连续性变量 离散型变量,只能取有限个值,取值以整数位断开,比如“企业数” 连续型变量,取之连续不断,不能一一列举,比如“温度” 。 1.8 统计应用实例 人口普查,商场的名意调查等。 1.9 统计应用的领域 经济分析和政府分析还有物理,生物等等各个领域。
统计学(第四版)期末复习资料
第一章统计和统计数据名词解释1.统计学:收集处理分析解释数据并从数据中得出结论的科学。
2.描述统计:研究数据收集处理汇总图表描述概括与分析等统计方法。
3.推断统计:研究如何利用样本数据来推断总体特征的统计方法。
4.分类数据:只能归于某一类别的非数字型数据。
5.顺序数据:只能归于某一有序类别的非数字型数据。
6.数值型数据:按数字尺度测量的观察值。
7.总体:包含所研究的全部个体(数据)的集合。
8.样本:从总体中抽取的一部分元素的集合。
9.参数:用来描述总体特征的概括性数字度量。
10.变量:说明现象某种特征的概念。
11.分类变量:说明事物类别的一个名称。
12.顺序变量:说明事物有序类别的一个名称。
13.数值型变量:说明事物数字特征的一个名称。
14.概率抽样:随机抽样,遵循随机原则进行的抽样,总体中每个单位都有一定的机会被选入样本。
15.非概率抽样:不随机,根据研究目的对数据的要求,采用某种方式从总体中抽出部分单位对其实施调查。
16.简单随机抽样:从包括总体的N个单位的抽样框中随机,一个个抽取n个单位作为样本,每单位等概论。
17.分层抽样:将抽样单位按某种特征或某种规则划分为不同的层,然后从不同层中独立、随机地抽取样本。
18.整群抽样:总体中若干单位合并为组,群,抽样时直接抽取群,然后对中选群中的所有单位全部实施调查。
19.系统抽样:总体中所有单位按顺序排列,在规定范围内随机抽取一单位作为初始单位,然后按事先规则确定其它样本单位。
20. 抽样误差:由于抽样的随机性引起的样本结果与总体真值之的误差简答题。
1.概率抽样与非概率抽样比较:性质不同,非概不依据随机原则选样本,样本统计量分布不确切,无法使用样本的结果对总体相应参数进行推断。
操作简便,时效快,成本低,专业要求不很高。
概率抽样依据随机原则抽选样本,理论分布存在,对总体有关参数可进行估计,计算估计误差,得到总体参数的置信区间。
提出精度要求。
2.数据收集方法的选择:抽样框中有关信息,目标总体特征,调查问题的内容,有形辅助物的使用,实施调查的资源,管理与控制,质量要求3.误差的控制:抽样误差是抽样随机性带来的,不可避免可以计算,改大样本量。
统计数据的分类和研究方法
统计数据的分类和研究方法统计数据是指经过收集、整理和处理后,用于描述、分析和解释现象的数字或指标。
统计数据的分类和研究方法对于人们理解和利用数据具有重要意义。
1.统计数据的分类:统计数据可以根据收集的对象、性质和用途进行分类:(1)根据收集的对象来分类:-人口统计数据:研究人口数量、结构、分布、迁移等,如人口普查数据、人口抽样调查数据等。
-经济统计数据:研究经济运行和发展的情况,如国内生产总值、企业利润、消费者物价指数等。
-社会统计数据:研究社会现象和问题,如教育、卫生、就业、犯罪等问题的数据。
-自然统计数据:研究自然现象和环境的数据,如气象、环境污染、地震、生物种群数量等。
(2)根据性质来分类:-定性数据:描述性的数据,以文字和符号表示,用于描述特征、性质、观点等,如调查问卷中的问答题。
-定量数据:具有数量属性的数据,可以进行数值运算和统计分析,如年龄、身高、收入、销售额等。
(3)根据用途来分类:-描述性统计数据:对已有数据进行总结、整理和描述,如均值、中位数、众数、标准差等。
-推断性统计数据:通过样本数据对总体数据进行推断,进行概率分布和参数估计,如抽样调查数据。
2.统计数据的研究方法:(1)抽样调查:选择样本进行调查和测量,通过样本数据来推断总体数据。
常见的抽样方法包括随机抽样、分层抽样、系统抽样等。
(2)实验方法:通过控制和观察变量来进行研究,确定因果关系。
实验方法需要设计实验方案、随机分组、实施实验、收集数据并分析。
(3)统计分析:对收集到的数据进行整理、分析和解释,包括描述性统计和推断性统计。
描述性统计包括中心趋势和离散程度的统计量,推断性统计包括假设检验和置信区间。
(4)模型建立:通过观察和分析数据,建立数学或统计模型来描述和预测现象。
常见的模型包括线性回归模型、时间序列模型、分类模型等。
(5)数据挖掘:利用计算机和统计学方法来发现数据中隐藏的模式、规律或关系。
数据挖掘包括聚类分析、关联分析、分类与回归等方法。
统计学知识点(前四章)
统计学知识点(前四章)第1章导论1.统计学:收集、处理、分析、解释数据并从数据中得出结论的科学。
2.按数据分析方法分类:↗描述统计—数据收集、处理、汇总、图表描述↘推断统计—利用样本数据推断总体特征3.统计数据是对现象进行测量的结果。
4.按照计量尺度的不同,将统计数据分为分类数据、顺序数据和数值型数据。
1)分类数据:对事物分类的结果,用文字表述,数据表现为类别(男女);2)顺序数据:有序的类别,如,一等品二等品、小学初中高中、同意;3)数值型数据:按数字尺度测量的观察值,具体的数值。
5.数据的计量尺度:1)定/分类尺度:数据表现为类别,按照事物的属性平行的分类,计量层次最低,具有“=”或“≠”的数学特性;2)定/顺序尺度:数据表现为有序的类别,具有“>”或“<”的数学特性;3)定距/间隔尺度:数据表现为数字,没有绝对零点;4)定比/比率尺度:数据表现为数字,有绝对零点。
3、4统称数值型数据。
6.定性/品质数据:分类数据和顺序数据统称。
定量/数量数据:数值型数据。
7.按照数据的收集方法:观测数据和实验数据。
按时间状况:截面数据和时间序列数据。
(统计数据的分类)8.总体:是包含所研究的全部个体(数据)的集合。
组成总体的每个元素成为个体。
按包含数目是否可数,分为有限总体和无限总体。
9.样本:是从总体中抽取的一部分元素的集合。
构成样本的元素的数目成为样本量。
抽样的目的是为了根据样本提供的信息推断总体的特征。
10.参数:是用来描述总体特征的概括性数字度量。
是研究者想要了解的总体的某种特征值,如,总体平均数μ、总体标准差σ。
11.统计量:是用来描述样本特征的概括性数字度量。
是根据样本数据计算出来的量,如,样本平均数χ 、样本标准差s。
12.变量:是说明现象某种特征的概念。
如,商品销售额、受教育程度。
变量的具体值称为变量值,比如商品的销售额可以是20万、30万。
13.变量的分类——分类变量:性别、行业;顺序变量:产品等级、受教育程度;数值型变量:↗离散型变量:产品数量、企业数(取值以整数位断开)↘连续性变量:年龄、温度、零件尺寸(取值连续不断)随机变量和非随机变量,经验变量和理论变量第2章数据的搜集1.数据的来源:间接来源和直接来源2.间接来源的数据:对原信息重新加工、整理,数据可以取自系统外部或内部。
统计学(贾俊平)第五版课后习题答案(完整版)
统计学(第五版)贾俊平课后习题答案(完整版)第一章思考题1.1什么是统计学统计学是关于数据的一门学科,它收集,处理,分析,解释来自各个领域的数据并从中得出结论。
1.2解释描述统计和推断统计描述统计;它研究的是数据收集,处理,汇总,图表描述,概括与分析等统计方法。
推断统计;它是研究如何利用样本数据来推断总体特征的统计方法。
1.3统计学的类型和不同类型的特点统计数据;按所采用的计量尺度不同分;(定性数据)分类数据:只能归于某一类别的非数字型数据,它是对事物进行分类的结果,数据表现为类别,用文字来表述;(定性数据)顺序数据:只能归于某一有序类别的非数字型数据。
它也是有类别的,但这些类别是有序的。
(定量数据)数值型数据:按数字尺度测量的观察值,其结果表现为具体的数值。
统计数据;按统计数据都收集方法分;观测数据:是通过调查或观测而收集到的数据,这类数据是在没有对事物人为控制的条件下得到的。
实验数据:在实验中控制实验对象而收集到的数据。
统计数据;按被描述的现象与实践的关系分;截面数据:在相同或相似的时间点收集到的数据,也叫静态数据。
时间序列数据:按时间顺序收集到的,用于描述现象随时间变化的情况,也叫动态数据。
1.4解释分类数据,顺序数据和数值型数据答案同1.31.5举例说明总体,样本,参数,统计量,变量这几个概念对一千灯泡进行寿命测试,那么这千个灯泡就是总体,从中抽取一百个进行检测,这一百个灯泡的集合就是样本,这一千个灯泡的寿命的平均值和标准差还有合格率等描述特征的数值就是参数,这一百个灯泡的寿命的平均值和标准差还有合格率等描述特征的数值就是统计量,变量就是说明现象某种特征的概念,比如说灯泡的寿命。
1.6变量的分类变量可以分为分类变量,顺序变量,数值型变量。
变量也可以分为随机变量和非随机变量。
经验变量和理论变量。
1.7举例说明离散型变量和连续性变量离散型变量,只能取有限个值,取值以整数位断开,比如“企业数”连续型变量,取之连续不断,不能一一列举,比如“温度”。