
聚类中K-means算法综述讲解
1
攻读硕士学位研究生试卷(作业)封面
( 2015 至 2016 学年度第一学期)
题 目 论文选读
科 目 聚类分析中K-means算法综述
姓 名 王苑茹
专 业 计算机技术
入学年月 2015年8月
简短评语
成绩: 授课教师签字:
2 聚类分析中K-means算法综述
摘要:聚类分析是数据挖掘中一个极其重要的研究方向,是一个将数据划分成簇的方法或手段。聚类分析可广泛利用在商务智能,Web搜索,生物学以及图像模式识别等众多方面。本文主要叙述聚类分析中的K-means聚类算法,总结了K-means聚类算法的研究现状,并针对K-means算法的相关改进做了综述。
关键词:K-means聚类算法;数据子集;聚类中心;相似性度量和距离矩阵
Overview of K-means algorithm in
clustering analysis
Abstract:Clustering is major field in data mining which also is an important
method of data partition or grouping. Clustering now has been applied into various
ways in business intelligence,Web classification,biology,market and so on.In this
paper, we introduce the spatial clustering rules,At the same time, the classical
K-means algorithm is describe,And some related improvements to K-means algorithm
are summarized.
Key words: K-means clustering algorithm; number of clusters K; cluster
initialization; distance metric
3
1、引言
K-means聚类算法是1955年由Steinhaus 、1957年 Lloyed、1965年 Ball &
Hall、1967年 McQueen分别在他们各自研究的不同的科学领域独立提出的。空间聚类分析方法是空间数据挖掘理论中一个重要的领域,是从海量数据中发现知识的一个重要手段。k-means算法是空间聚类算法中应用非常广泛的算法,同时它也在聚类分析中起着重要作用。日益丰富的空间和非空间数据收集存储于空间数据库中,随着空间数据的不断膨胀,海量的空间数据的大小、复杂性都在快速增长,远远超出了人们的解译能力,从这些空间数据中发现邻域知识迫切需求产生一个多学科、多邻域综合交叉的新兴研究邻域,空间数据挖掘技术应运而生。虽然k-means聚类算法被提出已经快60年了,但是目前仍然是应用最为广泛的划分聚类算法之一]1[。容易实施、简单、高效、成功的应用案例和经验是其仍然流行的主要原因。
本文主要叙述聚类分析中的K-means聚类算法,总结了K-means聚类算法的研究现状,并针对K-means算法的相关改进做了综述。
2、经典K-means算法
2.1 K-means算法
k-means 聚类算法是一种基于形心的划分技术,是数据挖掘领域最为常用的聚类方法之一,最初起源于信号处理领域。它的目标是划分整个样本空间为若干个子空间,每个子空间中的样本点距离该空间中心点平均距离最小。因此,k-means是划分聚类的一种。
k-means 算法接受输入量 k ;然后将n个数据对象划分为 k个聚类以便使得所获得的聚类满足:同一聚类中的对象相似度较高;而不同聚类中的对象相似度较小。聚类相似度是利用各聚类中对象的均值所获得一个“中心对象”(引力中心)来进行计算的。
大体上说,k-means 算法的工作过程说明如下:首先从n个数据对象任意选择 k 个对象作为初始聚类中心;而对于所剩下其它对象,则根据它们与这些聚类中心的相似度,分别将它们分配给与其最相似的聚类;然后再计算每个所获新聚类的聚类中心;不断重复这一过程直到标准测度函数开始收敛为止。一般都采
4 用均方差作为标准测度函数。 k个聚类具有以下特点:各聚类本身尽可能的紧凑,而各聚类之间尽可能的分开。
假设数据集D包含n个欧氏空间中的对象。划分方法把D中的对象分配到K个簇jCC,...,1中,使得对象1≦i,j≤k,iCD且iCjC=Ø,一个目标函数用来评估划分的质量,使得簇内对象相互相似,而与其他簇中的对象相异。也就是说,该目标函数以簇内高相似性和簇间低相似性为目标。
基于形心的划分iC技术使用簇的形心代表该簇。对象siC与该簇的代表ic之差用dist(s,ic)度量,其中dist(x,y)=sqrt( ∑(21iiyx)^2 ) 这里i=1,2..n。簇iC的质量可以用簇内变差度量,它是iC中所有对象和形心ic之间的误差的平方和,
α=21),(icpkicsdisti (1)
其中,α是数据集中所有对象的误差的平方和;s是空间中的点,表示给定的数据对象;ic是簇iC的形心]2[。
2.2 k-means算法流程
k-means算法流程,首先,随机的选择k个对象,每个对象初始地代表了一个聚类的平均值或中心,对剩下的各个对象,根据其与每个聚类中心的欧氏距离,将它派发给最相似的聚类。之后,应用更新之后的均值作为新的聚类中心,再重新分配全部对象。继续迭代,一直到分配趋于稳定,也就是本轮迭代所形成聚类与前一轮形成的聚类相同。
3、K-means聚类算法的参数及其改进
k-means聚类算法需要用户指定 3个参数:类别个数K,初始聚类中心、相似性和距离度量。针对这3个参数,k-means聚类算法出现了不同的改进和变种。
3.1 基于K值的改进
在 k-means 算法中 k 是事先给定的,这个 k 值的选定是非常难以估计的。很多时候,事先并不知道给定的数据集应该分成多少个类别才最合适。这也是
k-means 算法的一个不足。有的算法是通过类的自动合并和分裂,得到较为合理的类型数目 K,例如 ISODATA 算法。
1) 解决方法-聚类有效性函数
5 根据聚类有效性函数的方法是非常简单的一种解决方法,从[2,N]的区间内逐一选取k值,并利用该函数评价聚类的效果,最终得到最优的k值。
中外有许多学者也是按照这种思想提出了一系列的解决方法。
李永森等]3[提出的距离代价函数综合了类际距离和类内距离两项距离函数,类际距离为所有聚类中心到全域数据中心的距离之和。类内距离即所有类中对象到其聚类中心的距离之和。作者证明了当距离代价函数达到最小值时,空间聚类结果为最优,此时对应的k 值为最佳聚类数。
杨善林]4[提出的距离代价函数作为空间聚类的有效性检验函数, 就是当距离代价函数达到最小值时侯, 以距离代价最小准则实现了k 值优化算法,空间聚类结果为最优.根据经验规则计算和确定最优解的上界, 给出了求k值最优解kopt及其上界kmax的条件, 并在理论上证明了经验规则kmax≤n的合理性.
吴艳文等]5[提出的通过提供相对较易得到的k 初值( 大于kopt) ,得k 个初始聚类。分析聚类之间相互关系,判断那些聚类应是同一类,从而得到对k 值的优化。
王朔等]6[提出基于非模糊型集群评估指标(DBI)的概念。该指标主要利用几何原理进行运算,分别以聚类间离散程度及位于同一类内数据对象的紧密程度为依据。即不同聚类间的相异性高而同一类内数据对象的相似性高,并以此来进行聚类结果的评估。当类内各数据对象间距离越小而类间距离越大时指标值则越小,代表各聚类内的数据对象越紧密且聚类间的差异大。指标值越小,表明此聚类数目下聚类结果越佳。DBI 值越小代表各聚类内数据相似度越大而类间的相似度越小,由此得到最佳聚类数目。
2)解决方案-遗传算法
Bandyopadhyay 等]7[提出了GCUK 算法是基于遗传算法的。此算法的染色体是运用字符串方式来编码的,也就是将每个初始的聚类中心坐标按照顺序来进行编码,符号“#”来表示没有作为初始聚类中心的数据点,编码完成以后在逐代交叉运算中最后得到了最优k值。
张月琴等]8[提出了优化值参数是基于遗传算法的。在遗传算法中, 通过编码来实现染色体。依据k-means算法要找到最佳的k值, 染色体的编码既是对k值的编码。在一般情况下,对于某类问题,总是有一聚类的最大类数MaxClassnum,
这个值即可由用户来进行输入,也可以是给定的聚类样本个数。k是介于1和MaxClassnum之间的整数,可以使用二进制串既染色体来表示。
6 胡彧等]9[提出了由遗传操作中的变异操作来控制k值的大小。变异操作的本质是挖掘群体中个体的多样性,同时提高算法的局部随机搜索能力,防止出现未成熟收敛通过对个体适应度函数的求解,决定聚类数k值的变化方向。由于最初所给的聚类数k值并非是最佳聚类数,因此将最初所给种群中具有最大适应度值的个体做为最佳聚类数的榜样个体,其它个体的长度(即k值)向榜样个体的长度靠扰。
3)其他方法
孙雪等]10[提出了一种基于半监督k-means 的k 值全局寻优算法。
设初始少量数据集带标记的为监督信息, 数据集无标记的,监督信息数据集的标记为i和j.设k =2为初值, 在完整的数据集上来进行const rained-k-means
聚类.当k取不同值时, 计算监督信息中被错误标记的数据总数N,公式如下:
kcjcicnnN1),min( (1)
其中c 表示聚类后各簇的标号;icn,jcn 表示在第c簇中标记的数据所占的比例为i , j .出现空簇的频率取决于K值上限, 当出现空簇的频率大于50 %时, 则此时k被认为已取得最大值.在k值优化的整个过程中, 如果某一簇内的监督信息满足以下条件, 即
jcicjcicnnnn),max(阈值 (2)
则该次聚类结果被认为是无效,保留有效的簇中心值,再开始新一轮聚类,在中心点选择上采取了半增量的迭代方式,提高了算法性能。上式阈值选取可采取重复实验的方法,一般当icn与jcn的数量相差较少时,类标记为c的簇就为无效的簇.使N取得最小值的k取值就为k-means聚类算法的最佳初值。
田森平等]10[提出了根据所需聚类数据的分布的属性,来计算他们间的距离,经过这一系列变换,得到最终的聚类参数k值。从需要聚类的数据之中抽取出一部分样本数据,来获取聚类参数的抽样数据;再计算抽样数据间的距离来得到一沿对角线对称的距离矩阵,从这一距离矩阵之中找出一个大于零的最小距离即为mind(jixx,) , 作为高密度半径和簇划分半径的一个项,来保证这两个半径不会太小;对距离矩阵按列求平均值,再对这些平均值求iR求平均值得到R,根据|RRi| / R的误差来去掉噪声点,在噪声点去除完全后,重新计算R,根据R和min d(jixx,), 求得了高密度半径R。再找出min iR,依据, d(jixx,)< min iR
K-MEANS算法(K均值算法)
k-means算法
一.算法简介
k-means算法,也被称为k-平均或k-均值,是一种得到最广泛使用的聚类算法。 它是将各个聚类子集内的所有数据样本的均值作为该聚类的代表点,算法的主要思想是通过迭代过程把数据集划分为不同的类别,使得评价聚类性能的准则函数达到最优,从而使生成的每个聚类内紧凑,类间独立。这一算法不适合处理离散型属性,但是对于连续型具有较好的聚类效果。
二.划分聚类方法对数据集进行聚类时包括如下三个要点:
(1)选定某种距离作为数据样本间的相似性度量
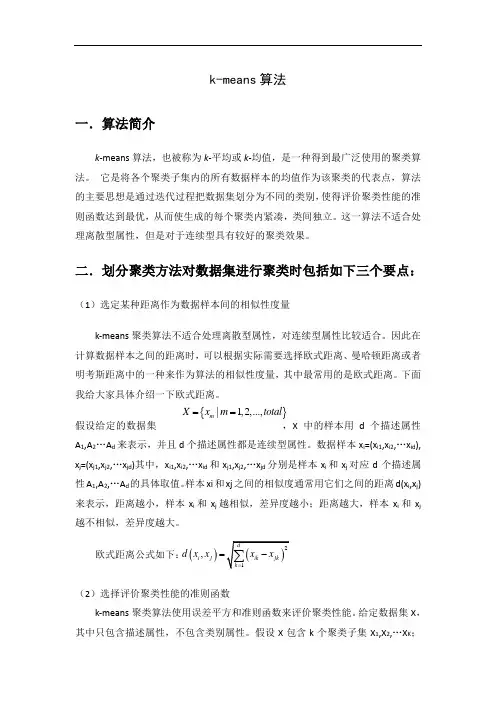
k-means聚类算法不适合处理离散型属性,对连续型属性比较适合。因此在计算数据样本之间的距离时,可以根据实际需要选择欧式距离、曼哈顿距离或者明考斯距离中的一种来作为算法的相似性度量,其中最常用的是欧式距离。下面我给大家具体介绍一下欧式距离。
假设给定的数据集 ,X中的样本用d个描述属性A1,A2…Ad来表示,并且d个描述属性都是连续型属性。数据样本xi=(xi1,xi2,…xid),
xj=(xj1,xj2,…xjd)其中,xi1,xi2,…xid和xj1,xj2,…xjd分别是样本xi和xj对应d个描述属性A1,A2,…Ad的具体取值。样本xi和xj之间的相似度通常用它们之间的距离d(xi,xj)来表示,距离越小,样本xi和xj越相似,差异度越小;距离越大,样本xi和xj越不相似,差异度越大。
欧式距离公式如下:
(2)选择评价聚类性能的准则函数
k-means聚类算法使用误差平方和准则函数来评价聚类性能。给定数据集X,其中只包含描述属性,不包含类别属性。假设X包含k个聚类子集X1,X2,…XK;|1,2,...,mXxmtotal21,dijikjkkdxxxx
各个聚类子集中的样本数量分别为n1,n2,…,nk;各个聚类子集的均值代表点(也称聚类中心)分别为m1,m2,…,mk。
加权k-means算法

加权k-means算法
加权K-means算法是一种改进的K-means算法,它在计算簇心点时考虑了每个样本点的重要性。加权K-means算法根据每个样本点的重要程度为其分配不同的权重,使得权重较大的样本点在计算簇心点时具有更大的影响力。通过为样本点分配不同的权重,加权K-means算法能够更好地处理具有不同重要性的数据,从而得到更加准确和可靠的聚类结果。
加权K-means算法的实现步骤如下:
1.初始化:选择K个样本点作为初始簇心点,并为每个样本点分配一个权重值。
2.分配样本点到簇:根据每个样本点到各个簇心点的距离,将样本点分配到最近的簇中。
3.计算新的簇心点:根据每个簇中样本点的权重和坐标,计算新的簇心点。权重较大的样本点对计算簇心点时的贡献更大。
4.更新权重:根据每个样本点到新计算的簇心点的距离,更新样本点的权重。
5.重复步骤2-4直到满足停止条件(例如,达到预设的最大迭代次数或簇心点收敛)。
6.输出结果:最终得到的K个簇心点和每个样本点的簇标签即为加权K-means算法的输出结果。
需要注意的是,加权K-means算法的权重值可以是人为设定的,也可以通过其他算法或启发式方法计算得到。另外,由于加权K-mea
ns算法需要为每个样本点分配权重,因此对于大规模数据集,加权K-means算法可能需要更多的计算资源和时间。
简述k-means算法的基本原理
简述k-means算法的基本原理
k-means算法是一种聚类算法,其基本原理是将数据集中的样本分为k个簇,使得每个簇内的样本越相似,不同簇的样本越不相似。
具体实现过程如下:
1. 首先需要确定簇的数目k,一般需要经过试错法确定。
2. 随机选择k个点作为初始簇中心。
3. 对于每个样本,计算它与每个簇中心的距离,将其归为距离最近的簇中心所在的簇。
4. 对于每个簇,重新计算簇中心。
5. 重复以上两个步骤,直到簇中心不再变化或达到一定的迭代次数为止。
k-means算法的目标是最小化所有簇内样本与其簇中心的距离和,即最小化平方误差和。因此,k-means算法的评估指标就是平方误差和。
1. 实现简单,计算速度快。
2. 可用于大规模数据集的聚类。
3. 可用于对数据集的预处理和降维。
k-means算法的缺点和局限性是:
1. 需要预先确定簇数k,但实际应用中往往不知道簇数。
2. 对于初始的随机选择的簇中心,有可能会导致聚类结果不稳定,需要多次运行算法取平均。
3. 对于不同样本分布的数据集,k-means算法的效果可能会有所下降。
4. 对于非凸的簇结构,k-means算法可能会出现聚类结果偏差。
总之,k-means算法是一种简单有效的聚类算法,可用于对数据集进行分组处理和降维处理,但需要在具体应用中注意其局限性。
kmeans参数
- 1 - kmeans参数
K-Means算法是机器学习中最基本的聚类算法。它基于一种假设,即每个数据点都属于某个簇,而K-Means算法会将数据点划分到K个不同的簇中。
K-Means算法的参数涉及三个重要的内容:簇的个数、距离度量和迭代次数。
簇的个数是指要将数据点划分到多少簇中,这决定了结果的准确性和可解释性。一般来说,簇的个数会与数据集中的实际类别数量相关,因此确定簇的个数也是一个关键步骤。
距离度量是指用于度量两个点之间距离的函数。K-Means算法可以使用任意的距离度量,但是一般来说,欧氏距离或曼哈顿距离是最常用的两种距离度量,对于维度较少的数据集来说,欧氏距离是最常用的距离度量。
迭代次数是指K-Means算法在训练过程中多少次的迭代,它决定了算法的准确性和收敛度,一般来说,迭代次数越多,算法的准确度越高,但迭代次数越多,算法的运行时间也会变得越长。
此外,K-Means算法在每次迭代过程中,都需要计算所有数据点到中心点的距离,以便将数据点分类到不同的簇中,因此可以设置一个距离阈值,以便在数据点和簇中心之间的距离超过阈值后停止迭代。
总之,K-Means算法的参数有多种,每个参数都会对整个算法的准确度和运行时间产生重大影响,因此选择合适的参数也是重要的环节。 - 2 - K-Means算法的优缺点
K-Means算法的优点在于实现简单,计算量小,适用于大多数数据集,可以有效地处理大量数据,并且可以获得较好的结果。
K-Means算法的缺点在于需要事先指定簇的个数,如果簇的个数不合适,那么结果的准确性可能会受到影响;此外,K-Means算法假定所有数据点的变量具有相同的权重,但实际上变量的权重可能会有所不同,这些都会影响结果的准确性。
K-Means算法的应用
K-Means算法有着广泛的应用,如图像处理、文本分析、聚类分析等等。
k-means参数
k-means参数详解
K-Means 是一种常见的聚类算法,用于将数据集划分成 K 个不同的组(簇),其中每个数据点属于与其最近的簇的成员。K-Means 算法的参数包括聚类数 K,初始化方法,迭代次数等。以下是一些常见的 K-Means 参数及其详细解释:
1. 聚类数 K (n_clusters):
- 说明: K-Means 算法需要预先指定聚类的数量 K,即希望将数据分成的簇的个数。
- 选择方法: 通常通过领域知识、实际问题需求或通过尝试不同的 K 值并使用评估指标(如轮廓系数)来确定。
2. 初始化方法 (init):
- 说明: K-Means 需要初始的聚类中心点,初始化方法决定了这些初始中心点的放置方式。
- 选择方法: 常见的初始化方法包括 "k-means++"(默认值,智能地选择初始中心点以加速收敛)和 "random"(从数据中随机选择初始中心点)。
3. 最大迭代次数 (max_iter):
- 说明: K-Means 算法是通过迭代优化来更新聚类中心的。max_iter 参数定义了算法运行的最大迭代次数。
- 调整方法: 如果算法没有收敛,你可以尝试增加最大迭代次数。
4. 收敛阈值 (tol):
- 说明: 当两次迭代之间的聚类中心的变化小于阈值 tol 时,算法被认为已经收敛。
- 调整方法: 如果算法在较少的迭代后就收敛,可以适度增加 tol 以提高效率。
5. 随机种子 (random_state):
- 说明: 用于初始化算法的伪随机数生成器的种子。指定相同的种子将使得多次运行具有相同的结果。
- 调整方法: 在调试和复现实验时,可以使用相同的随机种子。
这些参数通常是实现 K-Means 算法时需要关注的主要参数。在实际应用中,还可以根据数据的特性和问题的需求来选择合适的参数值。通常,通过尝试不同的参数组合并使用评估指标(如轮廓系数)来评估聚类结果的质量。
kmeans 聚类算法
kmeans 聚类算法
Kmeans聚类算法
Kmeans聚类算法是一种基于距离的无监督机器学习算法,它可以将数据集分为多个类别。Kmeans算法最初由J. MacQueen于1967年提出,而后由S. Lloyd和L. Forgy独立提出。目前,Kmeans算法已经成为了机器学习领域中最常用的聚类算法之一。
Kmeans算法的基本思想是将数据集划分为k个不同的簇,每个簇具有相似的特征。簇的数量k是由用户指定的,算法会根据数据集的特征自动将数据集分成k个簇。Kmeans算法通过迭代的方式来更新每个簇的中心点,以此来不断优化簇的划分。
Kmeans算法的步骤
Kmeans算法的步骤可以概括为以下几个步骤:
1. 随机选择k个点作为中心点;
2. 将每个数据点与离它最近的中心点关联,形成k个簇;
3. 对于每个簇,重新计算中心点;
4. 重复2-3步骤,直到簇不再变化或达到最大迭代次数。
Kmeans算法的优缺点
Kmeans算法的优点包括:
1. 算法简单易实现;
2. 能够处理大规模数据集;
3. 可以处理多维数据。
Kmeans算法的缺点包括:
1. 需要用户指定簇的数量;
2. 对于不规则形状的簇,效果不佳;
3. 对于包含噪声的数据集,效果不佳。
Kmeans算法的应用
Kmeans算法在机器学习和数据挖掘中有着广泛的应用。以下是Kmeans算法的一些应用:
1. 图像分割:将图像分为多个不同的区域;
2. 文本聚类:将文本数据划分为多个主题;
3. 市场分析:将消费者分为不同的群体,以便进行更好的市场分析;
4. 生物学研究:将生物数据分为不同的分类。
总结
Kmeans聚类算法是一种基于距离的无监督机器学习算法,它可以将数据集分为多个类别。Kmeans算法的步骤包括随机选择中心点、形成簇、重新计算中心点等。Kmeans算法的优缺点分别是算法简单易实现、需要用户指定簇的数量、对于不规则形状的簇效果不佳等。Kmeans算法在图像分割、文本聚类、市场分析和生物学研究等领域有着广泛的应用。
k-means聚类算法研究及应用
k-means聚类算法研究及应用
K-means聚类算法研究及应用
一、简介
K-means聚类算法是一种非监督学习算法,它是一种广泛应用在模式分类和无监督式学习的数据挖掘技术。它使用了基于距离的聚类算法,以相似性作为衡量子簇类别的标准,任务是将样本(属性)空间中的数据分为K个不同的类,使聚类的误差平方和最小化:通常假设样本由簇中心所处的子空间所构建,每个子空间由一个簇中心控制,因此K-means算法常常被形象地称为“均值聚类”算法。
二、 原理
K-means聚类算法是一种迭代算法,它的基本思想是:首先,随机选取若干个“簇中心”,然后将其他的数据点根据其与“簇中心”的距离,归到最近的“簇中心”所代表的簇中。然后根据新聚集的簇,重新更新这些“簇中心”;如此不断迭代,最终计算得到一组稳定的“簇中心”,这组“簇中心”所代表的簇就是最后的结果了。
三、应用
1、生物信息学:K-means聚类算法用于基因芯片和定量PCR,以及蛋白质表达数据。
2、计算机视觉:K-means用于图像分割,聚类,像素重新分配等。 3、自然语言处理:K-means用于文本聚类,文档分类,文本挖掘等方面。
4、机器学习:K-means用于各种拟合问题,比如参数估计,探索异常值等等。
四、总结
K-means聚类算法是一种简单高效的聚类算法,它可以有效地将数据空间分割成几个簇,属于非监督学习算法,它的核心在于划分数据空间,对数据的模式分类和无监督式学习有较好的应用,如生物信息学、计算机视觉、自然语言处理、机器学习等领域。
kmean计算聚类中心点
kmean计算聚类中心点
K-means是一种常用的聚类算法,用于将数据集分成多个类别,并找出每个类别的聚类中心点。在本文中,我们将讨论K-means算法的原理、应用和优缺点。
一、K-means算法原理
K-means算法是一种迭代的聚类算法,其基本步骤如下:
1. 初始化:随机选择K个数据点作为初始聚类中心点。
2. 分类:将数据集中的每个数据点分配到与其最近的聚类中心点所属的类别。
3. 更新:根据每个类别中的数据点,重新计算聚类中心点的位置。
4. 重复步骤2和步骤3,直到聚类中心点的位置不再改变,或者达到预定的迭代次数。
二、K-means算法应用
K-means算法在数据挖掘和机器学习领域被广泛应用,例如:
1. 客户细分:根据客户的消费行为和偏好,将客户分成不同的群体,以便进行个性化的营销策略。
2. 图像压缩:通过将相似的像素点归为一类,用聚类中心点来代替这些像素点,从而实现图像的压缩。
3. 文本分类:将文本数据根据语义和主题进行分类,以便进行信息检索、情感分析等应用。
4. 基因表达谱聚类:将基因表达谱数据分成不同的基因簇,以便研究基因的功能和相互作用。
三、K-means算法优缺点
K-means算法具有以下优点:
1. 简单而高效:K-means算法的原理和实现都相对简单,计算效率较高。
2. 可解释性强:K-means算法的结果易于理解和解释,每个聚类中心点代表一个类别。
3. 可扩展性好:K-means算法适用于大规模的数据集,并且可以通过并行化和分布式计算来加速处理。
然而,K-means算法也存在一些缺点:
1. 对初始聚类中心点敏感:初始聚类中心点的选择可能导致不同的聚类结果,需要多次运行算法来选择最佳结果。
2. 需要预先指定聚类数量:K-means算法需要事先确定聚类的数量K,而这个值可能不容易确定。
3. 对离群点敏感:离群点的存在可能会对聚类的结果产生较大的影响,导致聚类中心点偏离实际的数据分布。
k-means聚类算法实验总结
K-means聚类算法实验总结
在本次实验中,我们深入研究了K-means聚类算法,对其原理、实现细节和优化方法进行了探讨。K-means聚类是一种无监督学习方法,旨在将数据集划分为K个集群,使得同一集群内的数据点尽可能相似,不同集群的数据点尽可能不同。
实验步骤如下:
1. 数据准备:选择合适的数据集,可以是二维平面上的点集、图像分割、文本聚类等。本实验中,我们采用了二维平面上的随机点集作为示例数据。
2. 初始化:随机选择K个数据点作为初始聚类中心。
3. 迭代过程:对于每个数据点,根据其与聚类中心的距离,将其分配给最近的聚类中心所在的集群。然后,重新计算每个集群的聚类中心,更新聚类中心的位置。重复此过程直到聚类中心不再发生明显变化或达到预设的迭代次数。
4. 结果评估:通过计算不同指标(如轮廓系数、Davies-Bouldin指数等)来评估聚类效果。
实验结果如下:
1. K-means聚类能够有效地将数据点划分为不同的集群。通过不断迭代,聚类中心逐渐趋于稳定,同一集群内的数据点逐渐聚集在一起。
2. 在实验中,我们发现初始聚类中心的选择对最终的聚类结果有一定影响。为了获得更好的聚类效果,可以采用多种初始聚类中心并选择最优结果。 3. 对于非凸数据集,K-means算法可能会陷入局部最优解,导致聚类效果不佳。为了解决这一问题,可以考虑采用其他聚类算法,如DBSCAN、层次聚类等。
4. 在处理大规模数据集时,K-means算法的时间复杂度和空间复杂度较高,需要进行优化。可以采用降维技术、近似算法等方法来提高算法的效率。
通过本次实验,我们深入了解了K-means聚类算法的原理和实现细节,掌握了其优缺点和适用场景。在实际应用中,需要根据数据集的特点和需求选择合适的聚类算法,以达到最佳的聚类效果。
kmeans计算公式sse
kmeans计算公式sse
K-means算法是一种常用的聚类算法,用于将数据集划分为K个不同的簇。SSE(Sum of Squared Errors)是衡量聚类结果的一个指标,用于评估聚类的准确性和紧密度。
K-means算法的计算公式如下:
1. 首先,选择K个初始的聚类中心点,可以是随机选择或者通过其他方法选择。
2. 对于每个数据点,计算其与每个聚类中心的距离,并将其分配给距离最近的聚类中心。常用的距离度量方法是欧氏距离。
3. 根据数据点的分配情况,更新每个簇的聚类中心。计算每个簇中所有数据点的均值,作为新的聚类中心。
4. 重复步骤2和步骤3,直到聚类中心不再发生变化或者达到预设的迭代次数。
5. 计算SSE,即将每个数据点与其所属簇的聚类中心计算距离的平方和。SSE越小,表示聚类结果越紧密。
SSE的计算公式如下:
SSE = Σ(i=1 to N) Σ(j=1 to K) ||x(i) μ(j)||^2。
其中,N表示数据点的数量,K表示簇的数量,x(i)表示第i个数据点,μ(j)表示第j个簇的聚类中心。
需要注意的是,K-means算法是一种迭代算法,初始的聚类中心的选择可能会影响最终的聚类结果。因此,为了得到更好的聚类效果,可以尝试多次运行K-means算法,选择SSE最小的结果作为最终的聚类结果。