
Kettle设置变量的几种方法
Kettle设置变量的几种方法
在Kettle中,我们可以通过以下几种方法来设置变量:
1. 使用Set Variables组件:
Set Variables组件是一个常用于设置变量的组件。
通过该组件,我们可以设置一个或多个变量,并将其存储在Kettle的变量数据库中。
在转换或作业的其他组件中,可以使用该变量进行各种操作。
使用Set Variables组件设置变量的步骤如下:
- 从左侧Design面板中选择Set Variables组件,将其拖动到转换或作业的主区域中。
- 右键单击Set Variables组件,选择“Edit”以打开Set Variables对话框。
- 在Set Variables对话框中,可以设置变量名称和值。
可以设置多个变量。
单击“OK”以保存设置。
- 在Set Variables组件的输入或输出链接中拖动其他组件,以在转换或作业中使用设置的变量。
2.使用参数变量:
参数变量是通过命令行或调度器传递给Kettle的变量。
通过使用参数变量,我们可以在运行转换或作业时动态地为变量设置值。
参数变量的设置过程如下:
- 在命令行或调度器中运行转换或作业时,使用如下格式传递参数变量:-param:变量名称=变量值。
如果要传递多个参数变量,可以使用逗号分隔。
- 在转换或作业的一些组件中,使用${变量名称}的格式引用参数变量。
Kettle会自动将传递的参数值赋给变量。
3. 使用Get Variables组件:
Get Variables组件是用于获取Kettle变量的组件。
通过Get Variables组件,我们可以获取之前设置的变量,并将其传递给转换或作业的其他组件使用。
使用Get Variables组件获取变量的步骤如下:- 从左侧Design面板中选择Get Variables组件,将其拖动到转换或作业的主区域中。
- 右键单击Get Variables组件,选择“Edit”以打开Get Variables对话框。
- 在Get Variables对话框中,可以指定要获取的变量名称。
可以获取多个变量。
单击“OK”以保存设置。
- 在Get Variables组件的输出链接中拖动其他组件,以在转换或作业中使用获取的变量。
4. 使用JavaScript脚本:
JavaScript脚本是一种更灵活的方式来设置Kettle的变量。
通过使用JavaScript脚本步骤,我们可以编写自定义的脚本逻辑来设置变量。
使用JavaScript脚本设置变量的步骤如下:
- 从左侧Design面板中选择JavaScript脚本组件,将其拖动到转换或作业的主区域中。
- 右键单击JavaScript脚本组件,选择“Edit”以打开JavaScript 脚本对话框。
- 在JavaScript脚本对话框中,可以编写自定义的JavaScript代码来设置变量。
可以使用脚本步骤提供的API函数来操作变量。
-单击“OK”以保存设置。
使用上述方法之一,可以方便地在Kettle中设置变量,从而实现不同的业务需求。
Kettle使用文档
1.Kettle简介Kettle是一款国外开源的ETL工具,纯java编写,可以在Window、Linux、Unix上运行,数据抽取高效稳定。
Kettle 中文名称叫水壶,该项目的主程序员MATT 希望把各种数据放到一个壶里,然后以一种指定的格式流出。
Kettle主要由资源库、数据库、作业(job)、转换、步骤五部分组成,资源库是用来存储用户所编写的作业和转换(即kjb文件和ktr文件)一般是在数据库中存储,方便用户的查找和使用。
数据库就是处理数据是需要的数据库。
作业是用来确定一个工程中需要使用的转换和转换的执行顺序。
转换是数据在ktr文件中的具体转换过程,类似于Java的一个方法,而作业就类似于java的一个类,它可以调用各种不同的方法(转换)。
2.Kettle框架搭建(1)下载安装可以从下载最新版的Kettle软件,同时,Kettle 是绿色软件,下载后,解压到任意目录即可。
(2)配置环境变量使用Kettle前提是配置好Java的环境变量,因为Kettle是java编写,需要本地的JVM的运行环境。
配置Java环境变量可参考:/zzq900503/article/details/9770237配置Kettle环境变量步骤:一、在系统的环境变量中添加KETTLE_HOME变量,目录指向kettle的安装目录:D:kettledata-integration(具体以安装路径为准)二、新建系统变量:KETTLE_HOME变量值:D:kettledata-integration(具体以安装路径为准,Kettle的解压路径,直到Kettle.exe所在目录)三、选择PATH添加环境变量:变量名:PATH变量值:%KETTLE_HOME%;(3)Kettle工具的运行在Windows系统下运行,只需要解压kettle文件后,双击data-integration文件夹中的Spoon.bat文件在Linux下运行则双击data-integration文件夹中的Spoon.sh文件3.Kettle的基本概念(1)作业(job)负责将【转换】组织在一起进而完成某一块工作,通常我们需要把一个大的任务分解成几个逻辑上隔离的作业,当这几个作业都完成了,也就说明这项任务完成了。
Kettle参数化配置

Kettle参数化配置Kettle参数化配置在做系统化的Kettle实现⽅案,我们基本要定义⼀些不变的参数,在整个⽣命周期中使⽤,或者设置⼀些特定的参数,在⼀些特定的JOB 中使⽤。
参数化配置有利⽤我们Kettle实现规范化和合理化。
现整理介绍基本Kettle参数化配置的实现⽅案;1、整个Kettle级别的参数:这些参数只要你打开Kettle就可以使⽤的,默认保存的KETTLE_HOME中的.kettle⽂件中的kettle.properties⽂件中;!如果你没有设置KETTLE_HOME的环境变量的话,默认保存的路径是在 java的user.home ⽬录下;??之前有⼈问我在使⽤⾼版本的Kettle时,安装⽬录下怎么没有了.kettle⽂件夹,那我们设置变量怎么设置啊。
这个呢,我的回答是:在低版本的Kettle中确实有了这个⽬录,但是使⽤⾼版本的时候,如果你没有设置KETTLE_HOME的环境变量的话,默认读取的就是user.home的⽬录如果设置了KETTLE_HOME就会读取你指定的⽬录下的配置(指定的⽬录下必须要有.kettle的⽂件,不⼀定要是Kettle的安装路径,但是建议指定Kettle的安装路径,便于统⼀管理。
设置的⽅式类似于设置JAVA的环境变量,这⾥不再说明);设置完之后重启就可以使⽤${PARAM_KEY}的⽅式读取设置的参数值了。
!!!由于这⼀种是直接在Kettle的整个⽣命周期中设置的,有点污染Kettle的意思,建议慎⽤;2、设置特定环境的参数(基于⾃定义配置⽂件)针对⼀个JOB或者若⼲个JOB单独指定所使⽤的配置⽂件设置⽅式:3、数据库中建⽴参数表,进⾏读取;!如果做整体的Kettle实现⽅案的话,推荐使⽤这种⽅式,统⼀出⼊⼝,便于维护和管理;。
kettle转换里参数的写法

转换里参数的写法在计算机编程中,经常需要使用到转换函数来将一个数据类型转换成另一个数据类型。
在使用转换函数的过程中,我们经常需要传递参数来对转换过程进行控制和定制。
本文将介绍在kettle中常见的转换函数的参数写法,希望能够帮助大家更好地理解和使用kettle中的转换功能。
一、函数及参数介绍1. 转换函数:在kettle中,常见的转换函数包括字符串转换、日期转换、数值转换等。
这些函数通常会接收一个或多个参数来控制转换的行为。
2. 参数格式:kettle中的参数可以分为静态参数和动态参数。
静态参数是在转换步骤中直接指定的固定数值,而动态参数则可以通过变量或其他方式进行动态设置。
3. 参数使用:对于不同的转换函数,参数的使用方式也会有所不同。
一些函数可能只接收一个参数,而另一些函数可能需要多个参数来完整地指定转换行为。
二、静态参数的写法1. 常量参数:在kettle中,可以直接在转换步骤的参数设置中指定一个固定的数值作为参数。
在字符串转换函数中指定要转换的目标字符串。
2. 固定格式:静态参数通常需要按照一定的格式来填写,比如日期转换函数中要求的日期格式、数值转换函数中要求的小数位数等。
3. 示例:以下是一个使用静态参数的示例,假设我们需要将一个日期字段转换成特定格式的字符串,参数设置如下:- 转换函数:日期转换- 输入字段:源日期字段- 输出格式:yyyy-MM-dd三、动态参数的写法1. 变量参数:在kettle中,可以通过使用变量来动态设置参数的数值。
这样可以使参数的值随着转换过程的变化而动态调整。
2. 参数替换:动态参数通常需要使用一些特定的语法来指定变量的值,比如用 ${} 来表示变量的替换。
3. 示例:以下是一个使用动态参数的示例,假设我们需要从配置文件中读取日期格式并将日期字段转换成对应的格式,参数设置如下:- 转换函数:日期转换- 输入字段:源日期字段- 输出格式:${日期格式变量}四、参数的注意事项1. 参数校验:在使用参数时,需要注意参数的合法性和正确性。
kettle 字段名 变量-概述说明以及解释
kettle 字段名变量-概述说明以及解释1.引言1.1 概述概述部分的内容可以写作如下:引言部分在现代数据处理和数据转换的领域中,Kettle(也称为Pentaho Data Integration)扮演着一个关键的角色。
Kettle是一种开源的ETL(抽取、转换和加载)工具,广泛应用于数据仓库、数据集成和数据转换等领域。
它提供了一种灵活、可扩展的方法来处理各种复杂的数据转换任务,并具备强大的数据处理能力。
在进行数据转换的过程中,Kettle使用字段名(Variables)来表示数据的属性或特征。
字段名充当了连接源数据和目标数据之间的桥梁,它们在Kettle中起到了至关重要的作用。
每个字段名都代表了源数据中的一个数据列,它们包含了关键的信息,如数据类型、长度、精度等等。
本文将重点探讨Kettle字段名在数据转换中的作用和定义。
我们将分析字段名的重要性,并展望其未来的发展趋势。
通过深入理解Kettle字段名,我们将能够更好地应用Kettle工具,提高数据转换和数据处理的效率。
接下来的章节将对Kettle的定义和功能进行介绍,并详细讨论Kettle 字段名的作用和定义。
通过对这些内容的探索,我们将能够更好地理解和应用Kettle工具,从而更好地满足不同场景下的数据处理需求。
1.2文章结构文章结构部分的内容应该是对整篇文章的组织结构进行介绍和说明。
可以从以下几个方面进行阐述:首先,介绍文章的整体框架和章节划分。
说明文章采用的大纲结构以及每个章节的主题和内容。
其次,说明每个章节的主要目的和内容。
简要介绍每个章节的主题和要点,让读者对整篇文章的内容有一个整体的把握。
接着,说明各个章节之间的衔接和关联。
指出每个章节之间的逻辑关系和衔接点,使读者能够理解各个章节之间的连贯性和一脉相承的思路。
最后,提醒读者如何通过文章的结构来理解和掌握文章内容。
可以提醒读者在阅读文章时关注每个章节的主题句和段落结构,以及章节之间的过渡和回顾,从而更好地掌握文章的逻辑和要点。
【Kettle】8、变量参数传递介绍

【Kettle】8、变量参数传递介绍本⽂为转载,感觉作者的⾟勤劳作:/rotkang/article/details/21008271-----------------------------------------------------------------------------------------------------------------------------------------------------------------对于ETL参数传递是⼀个很重要的环节,因为参数的传递会涉及到业务数据是如何抽取。
下⾯我为⼤家举例⼀个简单的需求。
需求说明:需要抽取昨天的数据装载到⽬标表中。
概念篇1、参数作⽤域?答:Kettle中参数⼤致可分为两类:⼀类是全局参数,⼀类是局部参数。
2、参数如何定义?答:A:全局参数定义是通过当前⽤户下.kettle⽂件夹中的kettle.properties⽂件来定义。
定义⽅式是采⽤键=值对⽅式来定,如:start_date=20130101 注:在配置全局变量时需要重启Kettle才会⽣效。
B:局部参数变量是通过“Set Variables”与“Get Variables”⽅式来设置。
注:在“Set Variables”时在当前转换当中是不能马上使⽤,需要在作业中的下⼀步骤中使⽤,⼤家可以思考下什么时候⽤到“Set Variables”,什么时候⽤到“GetVariables”参数使⽤优先级顺序:全局变量-->局部变量-->本⾝变量3、参数如何使⽤?答:Kettle中参数使⽤⽅法有两种:⼀种是%%变量名%%,⼀种是${变量名}。
这两种⽅法变量数据类型都是数字类型。
注:在SQL中使⽤变量时需要把“是否替换变量”勾选上,否则⽆法使变量⽣效。
实现需求篇1、创建相应的参数变量设置转换(Set_Param.ktr)与数据流抽取转换(RotKang_Test01.ktr)。
kettle的作业和参数组件
kettle的作业和参数组件1、⼤多数ETL项⽬都需要完成各种各样的维护⼯作。
例如,如何传送⽂件;验证数据库表是否存在,等等。
⽽这些操作都是按照⼀定顺序完成。
1.1)、因为转换以并⾏⽅式执⾏,就需要⼀个可以串⾏执⾏的作业来处理这些操作。
⼀个作业包含⼀个或者多个作业项,这些作业项以某种顺序来执⾏。
作业执⾏顺序由作业项之间的跳(Job hop)和每个作业项的执⾏结果来决定。
1.2)、作业项是作业的基本构成部分。
如同转换的步骤,作业项也可以使⽤图标的⽅式图形化展⽰。
但是,如果你再仔细观察,还是会发现作业项有⼀些地⽅不同于步骤:在作业项之间可以传递⼀个结果对象(result object)。
这个结果对象⾥⾯包含了数据⾏,它们不是以数据流的⽅式来传递的。
⽽是等待⼀个作业项执⾏完了,再传递个下⼀个作业项。
因为作业顺序执⾏作业项,所以必须定义⼀个起点。
有⼀个叫“开始”的作业项就定义了这个点。
⼀个作业只能定⼀个开始作业项。
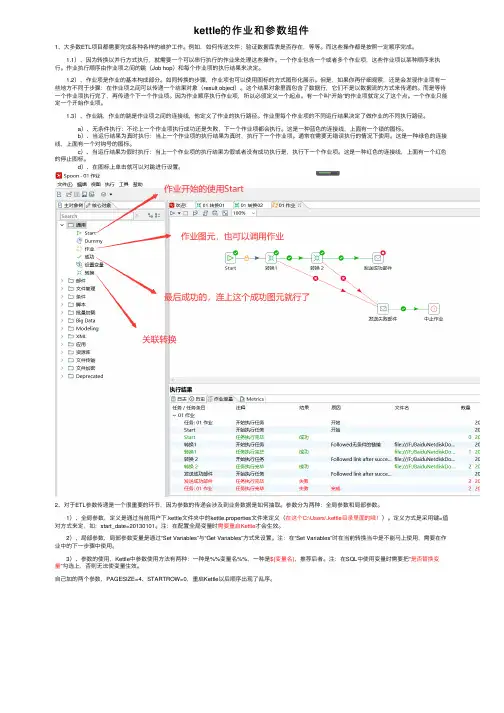
1.3)、作业跳,作业的跳是作业项之间的连接线,他定义了作业的执⾏路径。
作业⾥每个作业项的不同运⾏结果决定了做作业的不同执⾏路径。
a)、⽆条件执⾏:不论上⼀个作业项执⾏成功还是失败,下⼀个作业项都会执⾏。
这是⼀种蓝⾊的连接线,上⾯有⼀个锁的图标。
b)、当运⾏结果为真时执⾏:当上⼀个作业项的执⾏结果为真时,执⾏下⼀个作业项。
通常在需要⽆错误执⾏的情况下使⽤。
这是⼀种绿⾊的连接线,上⾯有⼀个对钩号的图标。
c)、当运⾏结果为假时执⾏:当上⼀个作业项的执⾏结果为假或者没有成功执⾏是,执⾏下⼀个作业项。
这是⼀种红⾊的连接线,上⾯有⼀个红⾊的停⽌图标。
d)、在图标上单击就可以对跳进⾏设置。
2、对于ETL参数传递是⼀个很重要的环节,因为参数的传递会涉及到业务数据是如何抽取。
参数分为两种:全局参数和局部参数。
1)、全局参数,定义是通过当前⽤户下.kettle⽂件夹中的kettle.properties⽂件来定义(在这个C:\Users\.kettle⽬录⾥⾯的哦!)。
kettle使用手册
Spoon.bat修改在set opt=*最后"-Dfile.encoding=UTF-8",解决乱码问题表输入替换SQL语句中的变量:变量用‘?’ 表示从步骤中插入数据:这个组件之前的流程名称新建/编辑Wizard(向导)填写数据库连接名称(选择数据库连接类型和数据库访问类型)NEXT端口号默认NEXT点击测试数据库连接获取SQL查询语句选择表或者视图,确定也可以自定义SQL语句.预览查询查询所需关键字:字段1为流入字段查询返回的值:字段为数据库表字段,可以起个别名,类型不选可能导致跨库乱码获取查询关键字:流入的所有字段获取返回字段:所选数据库表所有字段Switch/CaseSwitch字段:流入的字段Case值数据类型:视情况而定Case值:此处为空时-转到-查询DEPT_CODE 默认目标步骤(default):自定义流程,如图字段选择移除:移除流入字段元数据:修改元数据字段选择和修改:如果指定了移除和元数据就不能选择列映射增加常量添加一列到元数据流中设置字段值替换流字段的值表输出主选项默认不是临时表的话,千万不要选中剪裁表,这个用于删除表中的数据勾选’指定数据库字段’后才能操作’数据库字段面板’提交记录数量:每次批处理的数量,一批对应一个事务输入字段映射不要随便点’猜一猜’空操作什么也不做删除查询所需的关键字:删除的条件插入/更新不推荐使用比较流中和数据库表的值,不同则更新编辑映射:同表输出字符串替换过滤两个或以上中文并设置为空串去除重复记录注意:去除的记录要排序,否则只去除连续的值行扁平化详解:/Document/detail/tid/73025Access输入选择mdb格式文件,支持正则过滤Kettle增量更新/s/blog_6d35752501015dtm.html 获取系统信息类型预览记录计算器如下是移除元数据流字段,新数据流加负号Kettle变量(1)名称对应参数值:可以写SQL函数,比如sysdate+1,to_date()等相对应的变量名(2)位置对应参数获取系统信息此处添加两个变量作为增量的值设置变量变量活动类型:2)通过属性文件(常用)在C:\Users\${userName}\.kettle\kettle.properties中添加变量(key=value)Java Virtual Machine:S系统级作用域,凡是在一个java虚拟机下运行的线程都受其影响。
KETTLE使用说明及带输入参数JAVA调用
ETL工具——kettle使用说明1简介ETL(Extract-Transform-Load的缩写,即数据抽取、转换、装载的过程),Kettle是一款国外开源的etl工具,纯java编写,数据抽取高效稳定。
2运行环境:OS:Window、Linux、Unix均可Jdk1.4以上3开始使用:Kettle可以在/网站下载。
下载kettle压缩包,因kettle为绿色软件,解压缩到任意本地路径即可。
(本文着重介绍kettle3.2.0稳定版)Spoon是一个图形用户界面,在不同平台上运行Spoon需要不同的脚本:Spoon.bat:在windows平台运行Spoon(或直接点击Kettle.exe)。
Spoon.sh:在Linux、Apple OSX、Solaris平台运行Spoon。
登陆一般选择没有资源库:Kettle中有两种脚本文件,transformation和job,transformation完成针对数据的基础转换,job则完成整个工作流的控制。
4转换(Transformation)新建一个转换kettle默认transformation文件保存后后缀名为ktr新建数据库连接(此链接也可在用到的节点处配置)填写数据源配置内容点击Test测试连接成功:核心对象切换到核心对象,菜单列出的是Transformation中可以调用的环节列表,可以通过鼠标拖动的方式对环节进行添加。
并且可通过shift+鼠标拖动,实现环节之间的连接。
常用节点介绍(红色节点后面逐一演示)类别环节名称功能说明输入文本文件输入从本地文本文件输入数据表输入从数据库表中输入数据获取系统信息读取系统信息输入数据输出文本文件输出将处理结果输出到文本文件表输出将处理结果输出到数据库表插入/更新根据处理结果对数据库表机型插入更新,如果数据库中不存在相关记录则插入,否则为更新。
会根据查询条件中字段进行判断更新根据处理结果对数据库进行更新,若需要更新的数据在数据库表中无记录,则会报错停止删除根据处理结果对数据库记录进行删除,若需要删除的数据在数据库表中无记录,则会报错停止查询数据库查询根据设定的查询条件,对目标表进行查询,返回需要的结果字段流查询将目标表读取到内存,通过查询条件对内存中数据集进行查询调用DB存储过程调用数据库存储过程转换字段选择选择需要的字段,过滤掉不要的字段,也可做数据库字段对应过滤记录根据条件对记录进行分类排序记录将数据根据某以条件,进行排序空操作无操作增加常量增加需要的常量字段脚本Modified Java扩展功能,编写JavaScript脚本,对数据进行相应处理Script Value映射映射(子转换)数据映射作业Sat Variables设置环境变量Get Variables获取环境变量表输入双击拖动到工作面板上的表输入结点,选择(或者新建)所需要的数据库连接,点击获取SQL查询语句或自行编辑SQL。
Kettle入门.docx
目录Kettle中元素介绍 (2)变量 (4)转换 (5)转换连接颜色 (6)步骤(右键属性) (6)文本文件输入 (7)表输入 (8)获取系统信息 (8)生成记录 (9)Cube输入 (10)Xbase输入 (10)Excel输入 (10)XML输入 (10)获取文件名 (10)获取文件行数 (10)文本文件输出 (11)表输出 (11)插入/更新 (12)更新(可以用插入/更新替代) (12)删除 (12)序列化到文件(以前是Cube output) (12)XML输出 (12)Excel输出 (13)Access输出 (13)数据库查询(Database lookup) (13)流查询 (13)调用数据库存储过程 (14)HTTP客户端 (14)字段选择 (14)过滤记录 (15)排序记录 (15)添加序列 (15)空操作(什么也不做) (15)行转列(Row Normaliser) (16)拆分字段 (17)去除重复记录 (17)分组(Statistics) (17)设置为空值(Null if) (18)计算器 (18)增加XML(Add XML) (18)增加常量 (18)行转列(Row Denormaliser) (19)行扁平化 (19)值映射 (20)被冻结的步骤(Blocking Step) (20)记录关联(笛卡尔输出) (21)数据库连接 (21)合并记录 (21)排序合并(Sorted Merge) (22)Merge Join(合并连接) (22)Java Script值(Modified Java Script Value) (23)执行SQL语句 (23)Execute row SQL script (24)维度更新/查询 (25)联合更新查询 (25)映射(子转换) (26)从结果获取记录 (27)复制记录到结果(字符串) (27)Set Variables(设置变量) (27)Get Variables(获取变量) (28)Get files from result(从以前的结果获取文件) (28)Set files in result (28)Injector(记录注射器) (29)Socket reader(套接字读入器) (29)套接字输写器(Socket writer) (30)聚合记录 (30)流XML输入(属sax解析,和Get data from xml功能相同) (30)Abort(中止) (31)Oracle Bulk Loader(Oracle 批量装载) (31)任务设置(Job Settings)未找到 (33)任务条目(Job Entries)未找到 (33)Start (33)附录1 : (36)JS函数 (36)资源库:转换和job的保存地点1、kettle 有两种方式连接资源库,一种是纯数据库式,所有的转换全部都保存在一个数据库中;另外一种连接方式是使用文本文件,也就是xml 文件,在做完任何转换之后,我们都可以把转换或者Job 变成xml 文件输出。
Kettle变量和自己定义java代码的实例应用
Kettle变量和⾃⼰定义java代码的实例应⽤1 kettle.properties參数配置数据源连接和FTP连接因为測试环境和⽣产环境中数据库连接FTP等配置会在部署过程中变更,所以预先定义成配置项,在配置⽂件⾥改动。
这样測试和公布将会变得简单,以下以数据库为例说明这类配置的使⽤。
(1)⾸先要找到配置⽂件,不同的操作系统路径也不⼀样。
本⼈⽤win7进⾏开发,配置⽂件的路径为“C:\Users\chenpeng\.kettle\kettle.properties”。
例如以下:(2)配置⽂件⾥的详细配置例如以下:还能够可视化设置:(3)详细使⽤演⽰样例l 下⽅是数据库连接配置:l 下⽅是FTP连接配置:1.1.2 kettle.properties參数设置和路径及与正则配合使⽤(1)在kettle.properties中设置变量值(2)kettle.properties设置例如以下(win7下的路径为:C:\Users\chenpeng\.kettle)(4)在输出⽂件时使⽤參数中指定的路径:注:假设路径出现错误,如把某个⽬录删除则会报错。
仅仅要是报错,即使把⽬录建好了也仍然会报⽬录错误(好像有记忆功能),这时必须⼜⼀次启动kettle才⼲正常执⾏。
l 在输出⽂件时使⽤參数中和正則表達式混合使⽤场景:1.1.3 kettle.properties參数在java代码中的应⽤1.1.4 作业中变量使⽤并⽤javascript设置变量值上⾯的样例都是kettle.properties中声明的变量的应⽤。
这些都是全局范围内通⽤的,但⾮常多时间。
⼦作业须要有内部专⽤的变量參数。
这时就不能使⽤kettle.properties中声明的变量了。
须要在流程中声明变量,并把作⽤域设置为当前作业有效。
下⾯应⽤场景业务例如以下:⽂件名称要命名成当前⽇期格式的。
所以在作业级别定义了⼀个变量,但⽆法给它赋值。
如是採⽤了javascript脚本⽅式给该变量赋值,然后在输出⽂件名称的位置应⽤该变量就可以,后⾯⽂件的删除上传都是公⽤部分都须要⽤到这个变量做为接⼝參数来做处理。