
图1非线性变量关系的残差序列
b10 ,
f bi 0 , bP 0 i 1 i
b10 ,
, bP 0
i
16
若令:
P
f M Y f X1,, X K ; b10 bP 0 i 1 i
b10 ,,bP 0 bi 0
f Zi i
11
三、问题处理和非线性回归
解决错误的第一步,是恢复变量之间的 真实函数关系。 然后再设法通过幂函数、对数化等数学 变换等,把非线性关系转化为正确的线 性回归模型。 如果变量关系可以用初等数学变化转化 为线性模型,那么只要在转化后再进行 线性回归分析就可以了。
12
但也有不少非线性变量关系无法通过初 等数学变换转化为线性模型。例如Y和X 之间有两变量关系如下: Y eX 是未知参数,这个函数就无 、 其中 、 法通过初等数学变换转化为线性模型。 这时候就需要直接处理非线性回归模型。 非线性回归分析是线性回归分析的自然 扩展。
3
第一节 变量关系非线性
一、问题
二、发现与判断 三、问题处理和非线性回归
4
一、问题
线性回归模型都假设变量关系是线性随机函数 关系,或者经过特定数学变换以后是线性随机 函数关系。 但实际变量关系可能会存在偏差,存在用线性 模型分析非线性关系的可能性。 把非线性变量关系当作线性关系处理,也可以 说是违反误差项均值为0的假设,对线性回归 分析的有效性有根本性的破坏作用。
9
例如当发现模型的回归残差序列有图5.1所示 的规律性变化,就应该考虑存在把非线性关系 (二次函数等)当作线性关系进行回归的问题, 必须进行处理。
e
i
图5.1 非线性变量关系的残差序列
10
用回归残差序列判断变量关系非线性的 最大问题是,线性回归模型的其他某些 一些问题,如参数(结构)改变等,与 变量关系非线性的表现形式常常很相似, 不容易正确区分。 因此必须结合问题背景分析、相关理论 和经验进行综合判断,然后再通过处理 和结果的反复比较加以确定。
14
泰勒级数展开先要取一组参数的初始值:
然后将上述非线性函数在该点处对 1 ,, P 作泰勒级数展开,并只取其中的线性项而忽 略所有高次项,得到:
, X K ; b10
, bP 0
b10 ,, bP0
Y f X1 , f P
b10 ,
f bP 0 1
b10 ,, bP 0
我们得到:M 1Z1 2 Z 2 P Z P 这是一个M 对 Z1 ,, Z P 的线性回归模型,可以 用最小二乘法估计其中参数 1,, P 的估计值, 我们记为 b11,, bP1
17
经过泰勒级数展开得到的线性模型只是原变量 关系的近似,虽然可以把 b11,, bP1 作为原模型 参数的估计,但效果可能没有保证。 由于b10 ,, bP0 和参数真实值的近似程度越高, 级数展开忽略的高阶项越不重要,因此提高级 数展开初始值与参数真实值的近似程度有利于 提高上述间接估计的精度。 提高近似程度的方法是,把前一次回归得到的 估计值作为新的级数展开初始值,再进行新的 级数展开。然后再作变换和线性回归,得到另 18 一组参数估计值。
8
更重要的方法是根据回归残差序列,从技术角 度发现和判断异常值问题。 回归残差序列根据被解释变量的实际值和回归 理论值之差计算。 在EViews软件进行回归分析时,可以在得到回 归结果后在回归结果窗口点击View/Actual, Fitted,Residual/ Actual,fitted,residual table,直接得到回归残差序列和残差序列图。 如果模型存在变量关系非线性问题,回归残差 序列会表现出有规律的变化。
5
例如若两个变量之间的真实关系为: Y 0 1 X 2
其中 满足 E ( )=0和线性回归模型的其他假 1X 进行 设,但如果我们直接用: Y 0 回归分析,那么因为: 2 0 0 1 X 1X 因此: 1 X 2 1X E 0 0
13
我们假设非线性函数关系为: Y f X1,, X K ; 1,, P
1 ,, P 是模型 其中 X1,, X K 是K个解释变量, 的P个参数, f 为多元非线性函数,且对1 ,, P 是连续可微的。 对于这种非线性回归模型,解决的方法之一是 利用级数展开方法作非线性函数的近似线性函 数,把模型强制性化为线性模型。
第五章 线性回归的定式偏差
1
前面介绍的线性回归分析建立在模型假 设成立的基础上,但这些假设并不必然 成立。 本章讨论变量关系非线性、存在异常值、 规律性扰动和解释变量缺落等,导致线 性回归模型前两条假设不成立的定式偏 差,包括它们对线性回归分析的影响, 判断和处理的方法等。
2
本章结构
第一节 第二节 第三节 第四节 第五节 变量关系非线性 异常值 规律性扰动 解释变量缺落 参数变化
P bP 0
15
其中 为原变量关系中的误差项 与泰勒级数 展开的高阶项之和。 整理上述展开式,移项合并可化为:
Y f X1 , f i 1 i
P
, X K ; b10
bP 0
E ( ) 显然不可能始终为0。
6
把非线性变量关系作为线性关系进行分 析是变量关系的误识别。 不仅会使得回归分析的拟合程度降低, 还会对经济规律作出错误判断,以及导 致较大的预测偏差,属于计量经济分析 比较严重的问题。
7
二、发现与判断
由于有随机扰动因素的影响,线性回归 模型的错误设定并不是很容易发现的。 发现和判断变量关系非线性,首先是用 数理经济分析的方法,对模型的函数关 系进行更深入的分析。 其次是根据数据和及其分布图形、散点 图进行直接判断。
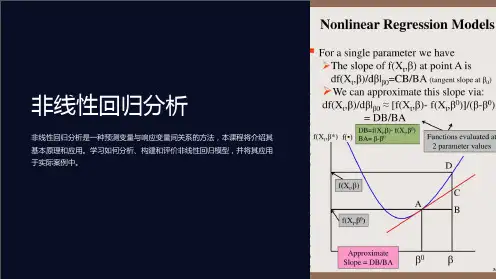
《非线性回归分析》课件
封装式
• 基于模型的错误率和复 杂性进行特征选择。
• 常用的封装方法包括递 归特征消除法和遗传算 法等。
嵌入式
• 特征选择和模型训练同 时进行。
• 与算法结合在一起的特 征选择方法,例如正则 化(Lasso、Ridge)。
数据处理方法:缺失值填充、异常值 处理等
1
网格搜索
通过预定义的参数空间中的方格进行搜
随机搜索
2
索。
在预定义的参数空间中进行随机搜索。
3
贝叶斯调参
使用贝叶斯优化方法对超参数进行优化。
集成学习在非线性回归中的应用
集成学习是一种将若干个基学习器集成在一起以获得更好分类效果的方法,也可以用于非线性回归建模中。
1 堆叠
使用多层模型来组成一个 超级学习器,每个模型继 承前一模型的输出做为自 己的输入。
不可避免地存在数据缺失、异常值等问题,需要使用相应的方法对其进行处理。这是非线性回归 分析中至关重要的一环。
1 缺失值填充
常见的方法包括插值法、代入法和主成分分析等。
2 异常值处理
常见的方法包括删除、截尾、平滑等。
3 特征缩放和标准化
为了提高模型的计算速度和准确性,需要对特征进行缩放和标准化。
偏差-方差平衡与模型复杂度
一种广泛用于图像识别和计算机 视觉领域的神经网络。
循环神经网络
一种用于处理序列数据的神经网 络,如自然语言处理。
sklearn库在非线性回归中的应用
scikit-learn是Python中最受欢迎的机器学习库之一,可以用于非线性回归的建模、评估和调参。
1 模型建立
scikit-learn提供各种非线 性回归算法的实现,如 KNN回归、决策树回归和 支持向量机回归等。
计量经济学课件PPT课件
非线性模型转换方法
多项式回归
通过引入自变量的高次项,将非线性关系转化为线性 关系进行处理。
变量变换
对自变量或因变量进行某种函数变换,以改善模型的 拟合效果。
非参数回归
不假定具体的函数形式,通过数据驱动的方式拟合非 线性关系。
实例分析:金融时间序列预测
数据准备
收集金融时间序列数据,如股票 价格、交易量等,并进行预处理。
模型选择依据
Hausman检验,LM检验等。
实例分析:经济增长收敛性问题研究
研究背景
探讨不同国家或地区间经济增长差异及其收 敛性。
模型构建
选择合适的面板数据模型,设定经济增长收 敛假设。
实证分析
收集相关数据,运用计量经济学软件进行回 归分析,检验收敛性假设是否成立。
结论与政策建议
根据实证结果得出结论,提出促进经济增长 收敛的政策建议。
机器学习算法与计量经济学模型结合
将机器学习算法与传统计量经济学模型相结合,形成更具解释性和预测能力的混合模型。
大数据背景下计量经济学挑战与机遇
01
大数据背景概述
数据量巨大、类型多样、处理速度快等 特点。
02
计量经济学面临的挑 战
数据质量、计算效率、模型可解释性等 问题。
03
计量经济学面临的机 遇
利用大数据技术挖掘更多信息,提高模 型预测精度和政策评估效果;同时推动 计量经济学理论和方法的发展创新。
Geary's C指数
与Moran's I指数类似,也是用于检验全局空间自相关。
LISA集聚图 用于检验局部空间自相关,可以直观展示空间集聚或异常 值区域。
空间滞后和空间误差模型选择
空间滞后模型(SLM)
计量经济学--模型设定偏误问题31-精选文档
二、模型设定偏误的后果
• 当模型设定出现偏误时,模型估计结果也会与 “实际”有偏差。这种偏差的性质与程度与模
型设定偏误的类型密切相关。
来自 中国最大的资料 库下载
1、遗漏相关变量偏误
采用遗漏相关变量的模型进行估计而带来的 偏误称为遗漏相关变量偏误(omitting relevant variable bias)。 设正确的模型为 Y=0+1X1+2X2+ 却对 Y=0+ 1X1+v 进行回归,得
显然,两者的参数具有完全不同的经济含义, 且估计结果一般也是不相同的。
来自 中国最大的资料 库下载
三、模型设定偏误的检验
1、检验是否含有无关变量
可用t 检验与F检验完成。
检验的基本思想:如果模型中误选了无关变量, 则其系数的真值应为零。因此,只须对无关变量 系数的显著性进行检验。 t检验:检验某1个变量是否应包括在模型中;
(6.692)
在=5%下,查得临界值F0.05(2, 20)=3.49 判断:拒绝原模型与引入新变量的模型可决系数 无显著差异的假设,表明原模型确实存在遗漏相 关变量的设定偏误。
来自 中国最大的资料 库下载
*(3)同期相关性的豪斯蔓(Hausman) 检验
由于在遗漏相关变量的情况下,往往导致解 释变量与随机扰动项出现同期相关性,从而使得 OLS估计量有偏且非一致。 因此,对模型遗漏相关变量的检验可以用模 型是否出现解释变量与随机扰动项同期相关性的 检验来替代。这就是豪斯蔓检验(1978)的主要 思想。
(*)
(*)式表明,IV估计量与OLS估计量无差异当且 仅当ziei=0,即工具变量与OLS估计的残差项无 关。
来自 中国最大的资料 库下载
残差序列存在负自相关-概述说明以及解释

残差序列存在负自相关-概述说明以及解释1.引言1.1 概述在时间序列分析中,自相关是一个常用的概念,它描述了时间序列中的观测值与其自身滞后观测值之间的相关性。
自相关可以是正的,也可以是负的。
本文旨在探讨残差序列存在负自相关的情况。
残差序列是通过将实际观测值与根据模型预测的值之间的差异计算而得到的。
在许多时间序列分析中,我们假设残差序列是无相关性的,即不具有自相关性。
然而,实际上,残差序列可能会显示出正的或负的自相关性。
负自相关意味着当一个观测值较大时,其滞后观测值往往较小;反之亦然。
这种负相关关系可能源于许多因素,比如某些趋势或周期性变化的存在。
负自相关性的存在对于我们理解时间序列的动态行为和未来趋势具有重要的意义。
在本文的剩余部分,我们将首先介绍负自相关的概念,讨论其与时间序列分析的关系。
接着,我们将探讨残差序列存在负自相关的原因,探究可能导致这种现象的因素。
最后,我们将总结本文的主要发现,并展望负自相关性对时间序列分析的影响和应用前景。
通过深入研究负自相关的现象,我们可以更好地理解和解释时间序列的特征,并为未来的预测和决策提供更准确的依据。
这对于经济学、金融学、社会科学等领域的研究和应用具有重要的意义。
1.2文章结构1.2 文章结构本文将按照以下结构进行描述和分析残差序列存在负自相关的原因。
首先,通过引言部分对本文的整体内容进行概述,让读者了解文章主题和目的。
接着,正文部分将从负自相关的概念入手,介绍了负自相关的定义和特点,为后续的分析提供基础。
然后,本文将详细探讨导致残差序列存在负自相关的原因,并提供解释和解答。
最后,在结论部分,对本文的主要内容进行总结,并展望负自相关的影响和应用。
通过这样的结构安排,读者将能够清晰地了解到残差序列存在负自相关的相关概念、原因分析以及未来可能的应用方向,从而更好地理解和应用负自相关的知识。
1.3 目的本文的主要目的是探讨和提供关于残差序列存在负自相关的相关信息和理论支持。
ggb画散点图回归方程和残差分析

ggb画散点图回归方程和残差分析第21讲观察性研究统计策略(6):线性回归的应用条件和模型评价构建线性回归必须满足一定的条件,主要包括:(1)自变量x和应变量y理论上有因果关系。
(2)结局y是定量变量。
(3)各x与y存在着线性关系。
(4)正态性、独立性、方差齐性。
1、2、3在之前一讲已经有所提及,今天介绍第四点的重要性及其诊断方法。
线性(Linear)、正态性(Normal)、独立性(independence)、方差齐性(Equal Variance),俗称LINE,是线性回归分析的四大前提条件。
LINE条件往往采用残差分析的方法来诊断。
若你要掌握线性回归,残差分析必须得学会的基本技巧。
线性回归模型构建是否成功,用什么来评价也是重要的内容。
SPSS一般来说统计分析时会产生两个指标,R^2和方差分析的P值,本文同时展开介绍。
这篇推文将全面介绍多因素线性回归的一些细节处理方法,请不要错过。
篇幅较长(约6000字),请耐心阅读。
实例分析例1:研究究高血压患者血压与性别、年龄、身高、体重等变量的关系,随机测量了32名40岁以上的血压y、年龄X1、体重指数X2、性别X3,试建立多重线性回归方程。
数据文件见mreg2.sav。
线性回归模型的主要分析结果本题应该考虑多因素回归分析方法。
本系列在上一讲已经介绍该方法(多因素线性回归分析,为什么和单因素回归结果不一样?)。
最终,结合SPSS得到以下的分析结果:从表格结果来看,年龄对血压的影响的存在着统计学差异(b=1.24,P<0.001);男性相对女性,提高了血压值(b=-8.721,P=0.002),体重指数对血压的影响的没有统计学差异(b=0.509,P=0.052)。
线性回归分析,建模型不够,还得包括模型的总体拟合效果评价,模型条件的诊断。
若模型诊断和评价结果不理想,上表的结果可能毫无意义。
LINE与残差分析(1)LINE条件的正确理解学过医学统计学的往往都知道,不是所有定量数据都可以开展线性回归的,线性回归模型有一些适用条件,简称LINE:线性(L)、独立性(I)、正态性(N)、方差齐性(E)。
计量经济分析方法与建模课件第二版第05章时间序列
§5.1 序列相关及其检验
第3章在对扰动项ut的一系列假设下,讨论了古典线性回归模型的估计、检验及预测问题。如果线性回归方程的扰动项 ut 满足古典回归假设,使用OLS所得到的估计量是线性无偏最优的。 但是如果扰动项 ut 不满足古典回归假设,回归方程的估计结果会发生怎样的变化呢?理论与实践均证明,扰动项 ut 关于任何一条古典回归假设的违背,都将导致回归方程的估计结果不再具有上述的良好性质。因此,必须建立相关的理论,解决扰动项不满足古典回归假设所带来的模型估指在给定ut-1,ut-2,…,ut-k-1的条件下,ut 与ut-k 之间的条件相关性。其相关程度用偏自相关系数k,k 度量。在 k 阶滞后下估计偏自相关系数的计算公式如下 (5.2.27)其中:rk 是在 k 阶滞后时的自相关系数估计值。 (5.2.28)这是偏自相关系数的一致估计。
在时间序列模型的发展过程中,一个重要的特征是对统计均衡关系做某种形式的假设,其中一种非常特殊的假设就是平稳性的假设。通常一个平稳时间序列能够有效地用其均值、方差和自相关函数加以描述。本章首先通过讨论回归方程扰动项通常会存在的序列相关性问题,介绍如何应用时间序列数据的建模方法,修正扰动项序列的自相关性。进一步讨论时间序列的自回归移动平均模型(ARMA模型),并且讨论它们的具体形式、估计及识别方法。
例5.1: 利用相关图检验残差序列的相关性
考虑美国的一个投资方程。美国的GNP和国内私人总投资INV是单位为10亿美元的名义值,价格指数P为GNP的平减指数(1972=100),利息率R为半年期商业票据利息。回归方程所采用的变量都是实际GNP和实际投资;它们是通过将名义变量除以价格指数得到的,分别用小写字母gnp,inv表示。实际利息率的近似值 r 则是通过贴现率R减去价格指数变化率 p 得到的。样本区间:1963年~1984年,建立如下线性回归方程: t = 1, 2, , T
线性模型知识点总结
线性模型知识点总结一、线性模型概述线性模型是统计学中一类简单而又常用的模型。
在线性模型中,因变量和自变量之间的关系被描述为一个线性方程式。
线性模型被广泛应用于各种领域,如经济学、医学、社会科学等。
线性模型的简单和普适性使得它成为数据分析中的一种重要工具。
线性模型可以用来建立预测模型、对变量之间的关系进行建模和推断、进行变量选择和模型比较等。
在实际应用中,线性模型有多种形式,包括简单线性回归、多元线性回归、广义线性模型、岭回归、逻辑回归等。
这些模型在不同的情况下可以更好地满足数据的特点和要求。
二、线性回归模型1. 简单线性回归简单线性回归是最基本的线性模型之一,它描述了一个因变量和一个自变量之间的线性关系。
简单线性回归模型可以用如下的方程式来表示:Y = β0 + β1X + ε其中,Y是因变量,X是自变量,β0和β1分别是截距项和斜率项,ε是误差项。
简单线性回归模型基于最小二乘法估计参数,从而得到最优拟合直线,使得观测值和拟合值的离差平方和最小。
简单线性回归模型可以用来分析一个自变量对因变量的影响,比如身高和体重的关系、学习时间和考试成绩的关系等。
2. 多元线性回归多元线性回归是在简单线性回归的基础上发展而来的模型,它能够同时描述多个自变量对因变量的影响。
多元线性回归模型可以用如下的方程式来表示:Y = β0 + β1X1 + β2X2 + ... + βpXp + ε其中,X1、X2、...、Xp是p个自变量,β0、β1、β2、...、βp分别是截距项和各自变量的系数,ε是误差项。
多元线性回归模型通过估计各系数的值,可以得到各自变量对因变量的影响情况,以及各自变量之间的相关关系。
3. 岭回归岭回归是一种用来处理多重共线性问题的线性回归方法。
在多元线性回归中,如果自变量之间存在较强的相关性,会导致参数估计不准确,岭回归通过对参数加上一个惩罚项来避免过拟合,从而提高模型的稳定性和泛化能力。
岭回归模型可以用如下的方程式来表示:Y = β0 + β1X1 + β2X2 + ... + βpXp + ε - λ∑(β^2)其中,λ是岭参数,用来平衡参数估计和惩罚项之间的关系。
残差序列不存异方差说明
残差序列不存异方差说明
残差序列不存在异方差说明该序列的方差是齐性的,即在不同值上的波动程度是一样的。
异方差性是指时间序列在不同观测值上的方差不相等,而残差序列是实际观测值与模型预测值之间的差值。
如果残差序列不存在异方差性,那么说明模型的预测值与实际观测值之间的差异在不同时间点上是相似的,这有助于我们更好地理解和拟合时间序列数据。
为了判断残差序列是否存在异方差性,可以使用各种检验方法,例如图检验、ADF检验、帕克检验和怀特检验等。
如果通过这些检验方法发现残差序列存在异方差性,则说明模型需要进一步调整,例如采用对数转换或加权最小二乘法等方法来处理异方差问题。
因此,残差序列不存在异方差性是模型拟合优良的一个标志,有助于提高预测的准确性和稳定性。
残差分析在数学建模中的应用
残差分析在数学建模中的应用杜世平(四川农业大学生命科学与理学院数学系,四川雅安625014)摘要:残差分析在回归模型诊断中起着非常重要的作用,它虽然看似是一种原始和简单的方法,但在实际应用中有时却是十分有效的. 本文结合实例运用S-Plus 软件通过描绘残差图,并结合假设检验方法对所建模型进行诊断,最后通过引入新的变量和删除异常点得到了比较满意的模型.关键词:多元回归;残差分析;线性模型;S-Plus 中图分类号:O212.4 文献标识码:A1 引言多元统计分析是数理统计学近年来迅速发展的一个分支,多元分析方法是一种很有用的数据处理方法,回归模型是数学建模中一种非常重要的模型,而线性回归是多元分析中用得较多的一种统计分析方法,广义地讲,“线性模型”的概念是针对参数而言.多元线性回归模型及其基本假设为01122p p y x x x ββββ=+++++"ε) (*)其中,y 为因变量;(1,2,,j x j ="p 为自变量;0j ββ、 (1,2,,j )p ="为自变量系数,称为模型参数.对一个实际问题,如果我们获得组观测值,则线性回归模型式可表示为n 101112121120121222201122p p p p nn n p np y x x x y x x x y x x x 2n ββββεββββεββββ=+++++⎧⎪ε=+++++⎪⎨⎪⎪=+++++⎩"""""""写成矩阵形式为Y X βε=+ 基本假设如下:(1) 因变量y 与自变量j x 之间存在(*)式的线性统计关系.(2)j x 是确定性变量,可以控制或预先给定,且j x 之间不存在线性关系或较强的统计相关性.(3) 各误差项i ε为独立随机误差,服从2(0,)N σ分布.基金项目:国家“八六三”高技术项目 (2006AA10Z179);国家自然科学基金项目(30300219)作者简介:杜世平(1970-),男,四川渠县人,副教授,主要从事应用统计和生物数学方面的研究.模型的回归方程为Y X β=,在满足基本假设的条件下,由最小二乘法求得正规方程,从而可得参数的最佳线性无偏估计.即1ˆ()T T X X X Y β−=,()1rank X p =+ 但在实际应用中.当取得一组实测数据时,这组数据是否符合或近似符合上述假设,就成为一个重要的问题.这就需要对所建的回归模型进行诊断,而残差分析是回归模型诊断的一个重要组成部分.本文拟结合实例讨论残差分析在回归模型诊断中的一些应用问题, 即当用一组数据建立回归模型时,如何考察它是否满足模型所要求的假设条件及如何加以校正和补救.2 残差分析所谓“残差”,即因变量的实际观测值与其回归估计值(拟合值)的差,,它蕴含了有关模型基本假设的重要信息.如果回归模型正确的话, 我们可以将残差看作误差ˆi i e y y=−i i e i ε的观测值,它应符合模型的假设条件,且具有误差i ε的一些性状.利用残差所提供的信息来考察模型假设的合理性及数据的可靠性称为残差分析.残差有多种形式,上述为普通残差.为了更深入地研究某一自变量与因变量的关系,人们引进了偏残差.此外, 还有学生化残差、预测残差等.以某种残差为纵坐标,其它变量为横坐标作散点图,即残差图 ,它是残差分析的重要方法之一.通常横坐标的选择有三种:(1) 因变量的拟合值;(2)自变量 ˆi i e y y=−i ˆyj x (1,2,,j =")p ;(3)当因变量的观测值为一时间序列时,横坐标可取观测时间或观测序号.残差图的分布趋势可以帮助判明所拟合的线性模型是否满足有关假设.如残差是否近似正态分布,是否方差齐次,变量间是否有其它非线性关系及是否还有重要自变量未进入模型等.当判明有某种假设条件欠缺时, 进一步的问题就是加以校正或补救.需分析具体情况,探索合适的校正方案,如非线性处理,引入新自变量,或考察误差是否有自相关性等.i e 3 实例分析表1为某公司46名软件开发人员的档案资料.其中,资历为从事专业工作的年数;管理1为管理人员,0为非管理人员;教育1表示中学,2表示大学,3表示更高程程度.试建立薪金与资历、管理责任、教育程度的关系模型.7 11772 2 0 2 30 1446710 0 1 8 10535 2 0 1 31 1594210 0 2 9 12195 2 0 3 32 2317410 1 3 10 12313 3 0 2 33 2378010 1 2 11 14975 3 1 1 34 2541011 1 2 12 21371 3 1 2 35 1486111 0 1 13 19800 3 1 3 36 1688212 0 2 14 11417 4 0 1 37 2417012 1 3 15 20263 4 1 3 38 1599013 0 1 16 13231 4 0 3 39 2633013 1 2 17 12884 4 0 2 40 1794914 0 2 18 13245 5 0 2 41 2568515 1 3 19 13677 5 0 3 42 2783716 1 2 20 15965 5 1 1 43 1883816 0 2 21 12366 6 0 1 44 1748316 0 1 22 213526 1 3 45 19207170 2 2313839 6 0 2 461934620 0 13.1 一般多元回归分析结果设为薪金;y 1x 表示资历(年);21x =表示 管理人员,20x =表示非管理人员;,则中学:41,0,x ⎧=⎨⎩大学其它31,0,x ⎧=⎨⎩中学其它31x =,40x =;大学:30x =,; 更高:,.用S-Plus软件,可以得到的回归方程为41x =30x =40x =y 123ˆ11032.7343+546.12766882.5329-2994.1783147.73804y x x x =++x (Ⅰ)图1 残差与拟合值的关系图(左)及残差与管理-教育组合的关系图(右)项参数 标准误 t Pr(>|t|) (截距)11032.7343 383.4925 28.76910.00001x 546.1276 30.5411 17.8817 0.0000 2x 6882.5329 314.1445 21.9088 0.0000 3x -2994.1783 412.0486 -7.2666 0.0000 4x147.7380 387.9379 0.38080.7053其中,F ,20.9567R =226.4 =0 p =,剩余标准差(Residual standard error )=1028,模型整体上可用.但从因变量拟合值与残差的关系图(图1)看残差大体分成4个水平;参数估计(表2)变量ˆy4x 的值最大,为0.7053(显著水平为0.05),使人怀疑其回归系数不稳定. p 这需要对所建模型Ⅰ进行诊断,看是否满足假设条件,以便对所建模型进行改进.3.2 增加管理与教育的交互项多元回归分析结果从残差与管理—教育组合的关系图(图1)看残差全为正,或全为负,管理—教育组合处理不当 ,6种管理—教育组合混在一起,未正确反映. 应在模型中增加管理2x 与教育3x , 4x 的交互项.表3 管理与教育的组合组合 1 2 3 4 5 6 管理 0 1 0 1 0 1 教育1 12233增加管理与教育的交互项,并去掉异常数据(33号) 得到y 的回归方程为123423ˆ11203.7538+496.86397047.9997-1726.5042-348.3925-3070.59621835.9676yx x 24x x x x =++x x (Ⅱ)项参数 标准误 t Pr(>|t|) (截距)11200.0344 29.9946 373.40140.0000 1x 498.2944 2.1137235.7427 0.0000 2x 7041.1690 38.9200 180.91390.0000 3x -1737.0900 39.9647 -43.46560.0000 4x -356.3558 37.0163 -9.62700.0000 2x 3x -3056.3268 56.6565 -53.9448 0.0000 2x 4x1996.9828 50.871239.25560.0000其中,F ,20.9998R =36700 =0 p =,剩余标准差(Residual standard error )= 65.93,同模型Ⅰ相比较模型Ⅱ的2R 、值在增大,剩余标准差在减小,残差图十分正常(图2),计算得到的数据与原始数据拟合很好(图3),最终模型的结果可以应用. F图3 模型Ⅰ与模型Ⅱ拟合数据与原始数据的比较通过上面的实例可以看出,残差是一种重要的回归诊断量,它蕴含了有关模型基本假设的许多重要信息.残差分析就是对残差进行统计处理,从中提炼出这些信息的方法,它可以发现模型的缺陷,以便对所建模型进行修正.但在实际应用应注意:(1)残差图直观是其优点,但也带来了判断上的主观性,将残差图和相应的假设检验、方差分析结合起来“诊断”是一种较为理想的方法;(2)明显偏离其它数据的点,是强影响点还是异常点,在处理的时候要慎重.参考文献:[1] 陈希儒,王松桂.近代回归分析—原理方法及应用[M].台肥:安徽教育出版社,1987.[2] 王小明,S-Plus应用统计教程.数学模型(第3版)[M].上海:上海财经大学出版社,2005.[3] Trevor Hastie,Robert Tibshirani,Jerome Friedman.统计学习基础—数据挖掘、推理与预测[M].北京:电子工业出版社,2004.[4] Cook D R,Weisberg S.Residuals and inference in regression[M].New York,1982.[5]姜启源,谢金星,叶俊.数学模型(第3版)[M]. 北京:高等教育出版社,2003.[6]陆璇.应用统计[M] .北京:清华大学出版社,1999.The Application of Residual Analysis in Mathematical ModelingDU Shi- ping(Department of mathematics,College of Biology and Science,Sichuan Agricultural University Yaan 625014,China)Abstract: This paper introduces the application of residual analysis in multiple regression models. combine residual plot with hypothesis testing in S-Plus software which performs residual analysis and diagnosis by a example,and give some advices to improve the models at lastKeywords: Multiple Regression;Residual Analysis;Linear Model;S-Plus(2000MSC 62G05)。
残差分析报告
残差分析报告引言在统计学中,残差是指观测值与模型预测值之间的差异。
残差分析是一种重要的统计工具,用于评估统计模型的拟合程度和模型的假设是否成立。
本报告旨在进行残差分析,以评估模型的合理性并提供有关模型的改进建议。
数据集描述我们使用的数据集包含了100个样本观测值及其对应的预测值。
数据集中的预测值是基于一个线性回归模型得到的,并且我们假设模型满足线性关系假设以及误差项的独立同分布假设。
残差分析方法为了进行残差分析,我们首先计算每个观测值的残差。
残差的计算公式如下:残差 = 观测值 - 预测值接下来,我们将对残差进行如下的常用分析方法:1. 残差的分布图我们首先绘制残差的分布图,以探索残差是否呈现正态分布。
如果残差分布接近正态分布,则说明模型对数据拟合得较好。
2. 残差与预测值的关系图接下来,我们绘制残差与预测值的关系图。
通过这个图可以观察到残差是否随着预测值的变化而有规律地变化。
如果残差与预测值之间存在某种模式,可能表明模型在某个特定范围内表现不佳。
3. 残差与时间的关系图如果数据集有时间变量,我们可以绘制残差与时间的关系图,以观察残差是否随时间呈现某种趋势。
这可以帮助我们检测出可能和时间有关的结构,例如季节性或趋势。
4. 残差与自变量的关系图最后,如果数据集有多个自变量,我们可以绘制残差与每个自变量的关系图,以观察残差是否随自变量的变化而有规律地变化。
这可以帮助我们检测出可能存在的非线性关系或未建模的交互效应。
残差分析结果及建议经过以上的残差分析,我们得出以下结论和建议:1.残差的分布图显示残差近似正态分布,这意味着模型对数据的拟合效果较好,没有明显的偏离。
2.残差与预测值的关系图显示,残差随预测值的增加减小,但总体趋势比较平缓,说明模型在预测值较大的区域仍然可以较好地拟合数据。
3.残差与时间的关系图没有显示出明显的趋势或周期性,表明残差与时间无相关性。
4.残差与自变量的关系图显示,残差随自变量的变化而有规律地变化,可能存在非线性关系或未建模的交互效应。