
对应分析方法与对应图解读方法
对应分析方法与对应图解读方法——七种分析角度
对应分析就是一种多元统计分析技术,主要分析定性数据Category Data方法,也就是强有力的数据图示化技术,当然也就是强有力的市场研究分析技术。
这里主要介绍大家了解对应分析的基本方法,如何帮助探索数据,分析列联表与卡方的独立性检验,如何解释对应图,当然大家也可以瞧到如何用SPSS操作对应分析与对数据格式的要求!
对应分析就是一种数据分析技术,它能够帮助我们研究由定性变量构成的交互汇总表来揭示变量间的联系。
交互表的信息以图形的方式展示。
主要适用于有多个类别的定类变量,可以揭示同一个变量的各个类别之间的差异,以及不同变量各个类别之间的对应关系。
适用于两个或多个定类变量。
主要应用领域:
概念发展(Concept Development)
新产品开发(New Product Development)
市场细分(Market Segmentation)
竞争分析(Competitive Analysis)
广告研究(Advertisement Research)
主要回答以下问题:
谁就是我的用户?
还有谁就是我的用户?
谁就是我竞争对手的用户?
相对于我的竞争对手的产品,我的产品的定位如何?
与竞争对手有何差异?
我还应该开发哪些新产品?
对于我的新产品,我应该将目标指向哪些消费者?
数据的格式要求
对应分析数据的典型格式就是列联表或交叉频数表。
常表示不同背景的消费者对若干产品或产品的属性的选择频率。
背景变量或属性变量可以并列使用或单独使用。
两个变量间——简单对应分析。
多个变量间——多元对应分析。
案例分析:自杀数据分析
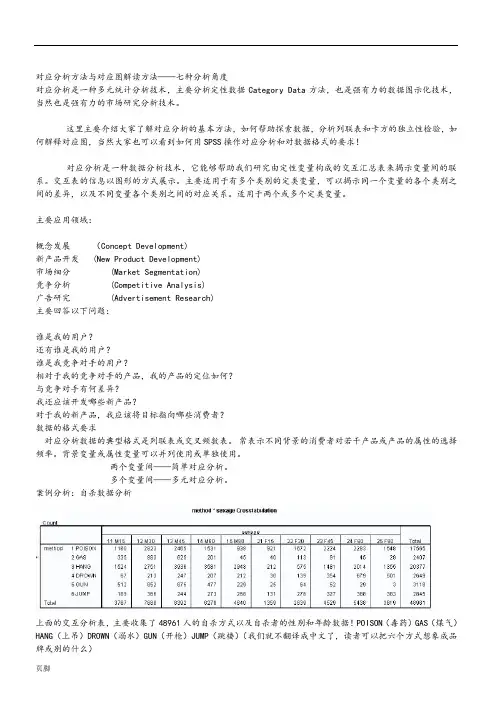
上面的交互分析表,主要收集了48961人的自杀方式以及自杀者的性别与年龄数据!POISON(毒药)GAS(煤气)HANG(上吊)DROWN(溺水)GUN(开枪)JUMP(跳楼)(我们就不翻译成中文了,读者可以把六个方式想象成品牌或别的什么)
当然,我们拿到的最初原始数据可能就是SPSS数据格式记录表,
其中,性别取值1-male 2-female,年龄取值1-5,分别表示不同年龄段。
要回答的问题就是:
1-不同性别的人在选择自杀方式上有什么差别?
2-不同年龄的人在选择自杀方式上有什么差别?
3-不同性别年龄的人在选择自杀方式上有什么差别?
我们首先,把性别字段乘上10加上年龄字段生成新字段sexage,取值就是11-15,21-25,然后分别用M/F与年龄组中值代表Sexage字段的变量值标,这样我们就可以进行简单对应分析了!
现在问大家,如果您瞧到上面的6×10的矩阵-列联表,您能瞧出什么差异?
现在我们采用SPSS软件进行对应分析!
(我现在用的就是SPSS17、0多语言版本,前两天听博易智讯的人说,现在SPSS已经有18、0版本了,不过从对应分析方法角度我还就是希望用11、5版本,因为可以自己拆分重新组合修改图形,现在的版本就是图片了,不能随心所欲的修改,不爽!)
分别定义好行列变量以及它们的取值范围!
对应分析中,6×10的列联表(交互表)可以得到行列维度最小值减1的维度,我们瞧到第一维度Dim1解释了列联表的60、4%,第二维度Dim2解释了列联表的33、0%,说明在两个维度上已经能够说明数据的93、4%,这就是比较理想的,当然我们也可以瞧卡方检验等!
下面我们主要解释如何解读对应图(小蚊子的博客中也有非常相似的解释,我非常欣赏她的博客)
首先对SPSS分析得到的对应图进行修饰与编辑,在零点增加两条中线!
解读方法:
1-总体观察:
我们从图上左右可以瞧出,左边全部就是M*,男性,右边F*全部就是女性,说明男女有显著差异;同时瞧横轴中线上方都就是年龄大的,下面都就是年龄小的,说明年龄有差异;这样就一目了然瞧出与回答了前两个问题;
2-观察邻近区域
我们从图上可以瞧出,老的男性比较喜欢HANG,GAS与GUN就是年轻男性的偏好;老的女性比较喜欢DAWN,年轻的女性比较偏好POISON;
3-向量分析——偏好排序
我们可以从中心向任意点连线-向量,例如从中心向GUN做向量,然后让所有的人往这条向量及延长线上作垂线,垂点越靠近向量正向的表示越偏好这种方法。
记住:就是垂点到GUN正向排名,从图中我们可以瞧出,希望GUN方法的人依次就是M15、M30、M45、M60、M80、F15等等;依次类推,我们还可以从中心向任意一种方法作垂线,都可以排出每种方法选择人群的偏好次序;当然,您也可以从中心往所有的人作向量,得到每一类人在选择六种方法上的偏好排名!
您就是否可以瞧出,F15年轻的女性对六个“品牌”的偏好不?
4-向量的夹角——余弦定理
接着,我们可以从向量夹角的角度瞧不同方法或不同人之间的相似情况,从余弦定理的角度瞧相似性!
从图上我们可以瞧出,当我们从中心向任意两个点(相同类别)做向量的时候,夹角就是锐角的话表示两个方法具有相似性,锐角越小越相似;也就就是说,GUN与GAS就是相似品牌,当如也就是竞争品牌,也具有替代性,如果这次开枪没有自杀成功,下次她一定选择毒气啦;我们也瞧出F15与F30的人比较相似,但F15与M80就有非常大的差异了,因为如果作向量她们就是钝角,几乎就是平角了!
5-从距离中的位置瞧:
越靠近中心,越没有特征,越远离中心,说明特征越明显
从这张对应图中我们瞧到,有些点远离中心,有些点靠近中心,这说明什么呢?从几何空间的角度,如果我对每一人都一样的好,在规范图上我就应该站在大家的重心,也就就是中心;这说明越靠近中心的点,越没有差异,(记住:没有差异并不代表不重要,只就是没有差异,因为统计的技术就是研究差异的技术,差异越大往往重要性就大!),越远离中心特征越明显,也就就是说,如果听到一个M80的人自杀了,估计您就会想到就是不就是HANG啦!
从品牌角度思考,说明越远离中的的品牌,消费者很容易识别,说明品牌特征(特色、特点)明显,越靠近中心的品牌,消费者不易识别,也说明您的品牌定位没有显著可识别的特征,没有差异认知!
6-坐标轴定义与象限分析
我们还没有定义坐标轴呢?从第一点的分析,其实我们很快就可以定义坐标轴的含义了!(当然有时候对应图的座位就是非常难定义的)
因此,落在第四象限的就是年轻的女性所喜欢的品牌!
7-产品定位:理想点与反理想点模型
我们可以在图上以POISON为定位点,以POISON为圆心,以它的利益为半径画圆,那么我们可以得出这样的结论:越先圈进来的人就就是最喜欢这个品牌的消费群,越先圈进来的品牌越可能就是竞争品牌;当然,您也可以以某类人作为圆心,同意解读;如果POISON就是市场不存在的,在调查中可以设定为理想点,这样我们就可以得到理想点模型,同理也可以得到反理想点模型分析!
8-市场细分与定位
最后,研究人员可以根据前面的分析与自身市场状况,进行市场细分,找到目标消费群,然后定位进行分析!最终选择不同的目标市场制定有针对性的营销策略与市场投放!
我们也可以尝试采用多元对应分析,但不如简单对应分析有意义!
对应分析方法与对应图解读方法
简单对应分析的优点:
定性变量划分的类别越多,这种方法的优势越明显,揭示行变量类别间与列变量类别间的联系,将类别联系直观地表现在二维图形中(对应图),可以将名义变量或次序变量转变为间距变量。
简单对应分析的缺点:不能用于相关关系的假设检验,维度要由研究者决定,有时候对应图解释比较困难,对极端值比较敏感。
对应分析方法与对应图解读方法
对应分析方法与对应图解读方法——七种分析角度对应分析是一种多元统计分析技术,主要分析定性数据Category Data方法,也是强有力的数据图示化技术,当然也是强有力的市场研究分析技术。
这里主要介绍大家了解对应分析的基本方法,如何帮助探索数据,分析列联表和卡方的独立性检验,如何解释对应图,当然大家也可以看到如何用SPSS操作对应分析和对数据格式的要求!对应分析是一种数据分析技术,它能够帮助我们研究由定性变量构成的交互汇总表来揭示变量间的联系。
交互表的信息以图形的方式展示。
主要适用于有多个类别的定类变量,可以揭示同一个变量的各个类别之间的差异,以及不同变量各个类别之间的对应关系。
适用于两个或多个定类变量。
主要应用领域:概念发展(Concept Development)新产品开发 (New Product Development)市场细分 (Market Segmentation)竞争分析 (Competitive Analysis)广告研究 (Advertisement Research)主要回答以下问题:谁是我的用户?还有谁是我的用户?谁是我竞争对手的用户?相对于我的竞争对手的产品,我的产品的定位如何?与竞争对手有何差异?我还应该开发哪些新产品?对于我的新产品,我应该将目标指向哪些消费者?数据的格式要求对应分析数据的典型格式是列联表或交叉频数表。
常表示不同背景的消费者对若干产品或产品的属性的选择频率。
背景变量或属性变量可以并列使用或单独使用。
两个变量间——简单对应分析。
多个变量间——多元对应分析。
案例分析:自杀数据分析上面的交互分析表,主要收集了48961人的自杀方式以及自杀者的性别和年龄数据!POISON(毒药)GAS(煤气)HANG(上吊)DROWN(溺水)GUN(开枪)JUMP(跳楼)(我们就不翻译成中文了,读者可以把六个方式想象成品牌或别的什么)当然,我们拿到的最初原始数据可能是SPSS数据格式记录表,其中,性别取值1-male 2-female,年龄取值1-5,分别表示不同年龄段。
聚类分析、对应分析、因子分析、主成分分析spss操作入门

Within-group linkage:组内平均连接法
• • • •
•
Байду номын сангаас
以两类个体两两之间距离的平均数作为类间距离。 d (d1 d 2 d 3 d 9 ) 9
将两类个体合并为一类后,以合并后类中所有个体之间的 平均距离作为类间距离。 d (d1 d 2 d 3 d 4 d 5 d 6 ) 6
输出结果
当采用“特征根大于1”的 方法提取因子时,所有变 量的共同度过均较高,各 变量的丢失信息较少,效 果理想。
此操作目的在于检验原始变量之 间是否存在一定线性关系,若线性 关系不显著,则不适合做因子分析
20
输出结果
看correlation矩阵,若对角线上元素的值较接近1,其 他大多数元素的绝对值均较小,说明变量之间相关性较 强,适合做因子分析。
因子 编号 特征 根值 方差 贡献率 累积方差 贡献率
23
软件操作
Method:因子旋转的方法,Varimax—方差最大 法, Quartimax— 四次方最大法, Equamax— 等量 最大法, Display:输出与因子旋转相关的信息,Rotated solution— 旋 转 后 的 因 子 载 荷 矩 阵 , Loading plot(s)—旋转后的因子载荷散点图
聚类输出结果
初始类中心情况 中心点偏移情况
最终类中心情况
最终类成员情况
15
基本介绍: 一种数据简化的技术; 将原有变量中的信息重叠部分提取并综合成因子,实现减少变量个数的目的; 提取出来的因子能够反映原来众多变量的主要信息; 原始的变量是可观测的显在变量,而提取因子是不可观测的潜在变量;
多元统计分析——对应分析
一般,若总体中的个体可按两个属性 与 一般 若总体中的个体可按两个属性A与 若总体中的个体可按两个属性 B分类,A有n类A1,A2,…,An,B有p类 分类, 有 类 分类 , 有 类 B1,B2,…,Bp, 属于 和Bj的个体数目为 属于Ai和 的个体数目为 nij(i=1,2, …,n;j= 1,2, …,p),nij称为 ( ) 称为 频数,则可形成n× 的二维列联表 的二维列联表, 频数,则可形成 ×p的二维列联表,简 称n×p表。 × 表 若所考虑的属性多于两个, 若所考虑的属性多于两个,也可按类似 的方式作出列联表,称为多维列联表 称为多维列联表。 的方式作出列联表 称为多维列联表。
列联表中列出了表格单元频数和在零假设下 的期望频数,可以看出, 的期望频数,可以看出,吸烟人中患病的数 目比期望数目大。 目比期望数目大。检验的结果只要看后面的 统计量部分的Chi-Square一行,其值为 一行, 统计量部分的 一行 7.469,p值为 值为0.006,所以应否定零假设,吸 , 值为 ,所以应否定零假设, 烟与患慢性支气管炎是不独立的。 烟与患慢性支气管炎是不独立的。
pij pij n 1 ∑ E( )= . pi. = p. j = i =1 p pi. p. j p. j p. j i.
N个点的重心为: ( P.1 , P.2 ⋯ P. p ) 个点的重心为: 个点的重心为
列联表
B1 A1 n11 A2 n21 B2 n12 n22 Bj Bp
… n1j
n2j
…
n1p n2p
n 1. n 2.
Ai ni1
ni2
nij
nip
ni.
An nn1 n.1
nn2 n.2
nnj n.j
对应分析方法与对应图解读方法 (2)

对应分析方法与对应图解读方法——七种分析角度对应分析就是一种多元统计分析技术,主要分析定性数据Category Data方法,也就是强有力的数据图示化技术,当然也就是强有力的市场研究分析技术。
这里主要介绍大家了解对应分析的基本方法,如何帮助探索数据,分析列联表与卡方的独立性检验,如何解释对应图,当然大家也可以瞧到如何用SPSS操作对应分析与对数据格式的要求!对应分析就是一种数据分析技术,它能够帮助我们研究由定性变量构成的交互汇总表来揭示变量间的联系。
交互表的信息以图形的方式展示。
主要适用于有多个类别的定类变量,可以揭示同一个变量的各个类别之间的差异,以及不同变量各个类别之间的对应关系。
适用于两个或多个定类变量。
主要应用领域:概念发展(Concept Development)新产品开发(New Product Development)市场细分(Market Segmentation)竞争分析(Competitive Analysis)广告研究(Advertisement Research)主要回答以下问题:谁就是我的用户?还有谁就是我的用户?谁就是我竞争对手的用户?相对于我的竞争对手的产品,我的产品的定位如何?与竞争对手有何差异?我还应该开发哪些新产品?对于我的新产品,我应该将目标指向哪些消费者?数据的格式要求对应分析数据的典型格式就是列联表或交叉频数表。
常表示不同背景的消费者对若干产品或产品的属性的选择频率。
背景变量或属性变量可以并列使用或单独使用。
两个变量间——简单对应分析。
多个变量间——多元对应分析。
案例分析:自杀数据分析上面的交互分析表,主要收集了48961人的自杀方式以及自杀者的性别与年龄数据!POISON(毒药)GAS(煤气)HANG(上吊)DROWN(溺水)GUN(开枪)JUMP(跳楼)(我们就不翻译成中文了,读者可以把六个方式想象成品牌或别的什么)当然,我们拿到的最初原始数据可能就是SPSS数据格式记录表,其中,性别取值1-male 2-female,年龄取值1-5,分别表示不同年龄段。
对应分析

对应分析对应分析方法(Correspondence Analysis)又称相应分析、关联分析,是一种多元相依变量统计分析技术,是通过分析由定性变量构成的交互汇总数据来解释变量之间的内在联系的。
同时,使用这种分析技术还可以揭示同一变量的各个类别之间的差异以及不同变量各个类别之间的对应关系。
特别是当分类变量的层级数比较大时,对应分析可以将列联表中众多的行和列的关系在低维的空间中表示出来。
而且,变量划分的类别越多,这种方法的优势就越明显。
对应分析的基本思想是将一个联列表的行和列中各元素的比例结构以点的形式在较低维的空间中表示出来。
它最大特点是能把众多的样品和众多的变量同时作到同一张图上,将样品的大类及其属性在图上直观而又明了地表示出来,具有直观性。
另外,它还省去了因子选择和因子轴旋转等复杂的数学运算及中间过程,可以从因子载荷图上对样品进行直观的分类,而且能够指示分类的主要参数(主因子) 以及分类的依据,是一种直观、简单、方便的多元统计方法。
该统计研究技术在市场细分、产品定位、品牌形象以及满意度研究等领域正在越来越广泛的运用。
方法原理◆将数据整理为交叉表,然后按照零假设成立的情况进行变量变换(计数资料连续化)。
◆分别对行变量和列变量进行因子分析,得到各自的因子分解方式和各类别的评分。
◆将行、列变量的因子分析结果结合起来观察,研究两变量各级别的关系。
要点◆是多维图示分析技术的一种◆与因子分析有关(分类资料的因子分析)◆通过图形直观展示两个/多个分类变量各类间的关系◆研究较多分类变量间关系时较佳◆各个变量的类别较多时较佳◆结果直观、简单例在研究读写汉字能力与数学的关系时,取得了232个美国亚裔学生的数学成绩和汉字读写能力的数据。
关于汉字读写能力的变量有三个水平:“纯汉字”意味着可以完全自由使用纯汉字读写,“半汉字”意味着读写中只有部分汉字(比如日文),而“纯英文”意味着只能够读写英文而不会汉字。
数学成绩有4个水平:A、B、C、F。
调查研究三十六法
调查研究三十六法一、观察法。
观察法可是调查研究里的一个基础又有趣的方法呢。
就像是我们平常看周围的人和事一样,只不过这个时候要带着目的去看。
比如说你想研究校园里同学们的阅读习惯,那就在图书馆、自习室这些地方悄悄观察呗。
看看大家都喜欢看什么类型的书,是抱着专业书啃的多呢,还是休闲小说更受欢迎。
这时候就像一个小侦探,眼睛要尖,把看到的各种细节都记在心里。
可别小看这种方法,有时候从人们的行为举止里能发现很多隐藏的信息,比直接问人家还准确呢。
二、访谈法。
访谈法就像是聊天,但是又比普通聊天更有针对性。
你可以找不同的人去聊,比如要研究大学生的职业规划,那就找大一的新生聊聊他们的憧憬,找大四的学长学姐聊聊他们的经验和教训。
在访谈的时候呀,可不能太严肃,就像朋友之间唠嗑一样。
你可以先从轻松的话题入手,像“最近吃啥好吃的啦”,然后慢慢引入到职业规划这个话题上。
而且要注意听对方说话,不要老是自己在那说个不停。
有时候一个好的访谈就像是一场愉快的分享会,双方都能从中学到东西。
三、问卷调查法。
问卷调查法是个很实用的方法哦。
你想了解很多人的想法,这个方法就很合适。
设计问卷的时候就很有讲究啦。
问题不能太复杂,不然大家看着就头疼,不想回答了。
比如说你想问大家对学校食堂的满意度,那就简单直接地问“你对食堂的饭菜口味满意吗”,然后给出几个选项,像“非常满意、满意、一般、不满意、非常不满意”。
而且问卷的排版也要好看,别密密麻麻的全是字。
还有哦,发放问卷的对象也要选好,要涵盖不同年级、不同专业的同学,这样得到的结果才更全面。
四、实验法。
实验法听起来就很科学的样子。
要是研究某种学习方法对成绩的影响,就可以找两组同学,一组用新的学习方法,一组用传统的学习方法,然后经过一段时间,看看两组同学的成绩有啥变化。
不过做实验的时候要控制好变量哦,除了学习方法不同,其他的条件,像学习时间、学习环境这些都要尽量保持一样。
这就像是在玩一个很严谨的游戏,每个规则都要遵守好,这样得到的结果才可靠。
对应分析
45岁的被访者更偏好燕京啤酒;20-29岁的年轻人更喜欢雪花。 应该说,在被访者背景资料的纵向对比中所占比例不大,而在
横向对比中所占比例较大;同样对于品牌之间的丛向对比与横向对比所 占比例基本一致;本例中的大部分信息主要体现在第一维度上。由于对 应分析综合考虑了行比例与列比例的差异,因此在同一图形中表现了品 牌与消费者背景间的内在联系。
由表5可以看出,第一维显示出7种啤酒品牌(变量)购买的数量逐 渐表少的变化方向。
图1 行点和列点的散布图 其中A代表纯生啤酒,B代表金辉啤酒,C代表雪花啤酒,D代表燕京啤 酒,E代表百威啤酒,F代表珠江啤酒,G代表其它。1代表20—29岁,2 代表30—39岁,3代表40—50岁,4代表高中,5代表大专,6代表大学本 科,7代表研究生及以上,8代表专业技术人员,9代表机关管理人员, 10代表机关一般职员,11代表企业管理人员,12代表企业普通员工,13 代表私营企业,14代表学生,15代表离退休,16代表其它。
0.0703 0.0391
0.0811 0.0608
0.0403 0.0726
0.0491 0.0800 0.0972
0.0625 0.0800 0.0139
0
0
0.0741 0.0247
0.0690 0.0345
0.0690 0.1034
0.0909 0.0727
0.0505 0.0606
0.0492 0.0820
0.1379 0
0
0.0909 0
0.0182
0.0101 0.0101 0.0101
0
0
0.0164
0.0741 0.0370 0
0
0
0
0.1333 0
对应分析图解读的七种方法
/xiaowenzi22
锐角
余弦定理:连接其中两点到原点(如城市4与城市5),各做一条射线, 两条线之间的夹角越小,说明他们越相关(余弦定理:夹角的余弦用来 表示相关性的大小),如果从产品角度上说具有竞争关系.
/xiaowenzi22
圆心定理:以某点(城市6)为圆点做半径不同的圆数个,其他点落入的 圆上的半径越短,则说明购买该产品的可能性越大,或者是具有相似行 为但属性(年龄等)不同的消费者.
/xiaowenzi22
/xiaowenzi22
原点定理:如果某点离圆心越远,则说明该点具有的个性越鲜明,与其 他点(产品)差异大,从统计学的角度说明越有意义.
/xiaowenzi22
象限二
象限一
象限三
象限四
象限分析:根据原点把整个图划分成四象限,每个象限代表着不同属性 的点(产品),具体原理可参见SWOT分析.
/xiaowenzi22
有待商榷
方向一
方向二Байду номын сангаас
方向三
发展方向分析:根据某点(城市6)所在位置向图内各方向做射线(发展 方向,以确定将遇到的竞争对手或困难,来确定企业发展方向.
/xiaowenzi22
市场细分:对密集点进行分割确定细分市场,这种方法是最经常用到的.
LOGO
/xiaowenzi22
�
以某点城市以某点城市6为圆点做半径不同的圆数个其他点落入的为圆点做半径不同的圆数个其他点落入的圆上的半径越短则说明购买该产品的可能性越大或者是具有相似行圆上的半径越短则说明购买该产品的可能性越大或者是具有相似行为但属性年龄等不同的消费者
第九章 对应分析
应用多元统计分析第九章对应分析对应分析又称相应分析,于1970年由法国统计学家J.P.Beozecri提出的.它是在R型和Q型因子分析基础上发展起来的多元统计分析方法,故也称为R-Q型因子分析.因子分析方法是用少数几个公共因子去提取研究对象的绝大部分信息,既减少了因子的数目,又把握住了研究对象的相互关系.在因子分析中根据研究对象的不同,分为R型和Q型,如果研究变量间的相互关系时采用R型因子分析;如果研究样品间相互关系时采用Q型因子分析.无论是R型或Q型都未能很好地揭示变量和样品间的双重关系.另方面在处理实际问题中,样本的大小经常是比变量个数多得多.当样品个数n很大(如n>100),进行Q型因子分析时,计算n阶方阵的特征值和特征向量对于微型计算机的容量和速度都是难以胜任的.还有进行数据处理时,为了将数量级相差很大的变量进行比较,常常先对变量作标准化处理,然而这种标准化处理对于变量和样品是非对等的,这给寻找R型和Q型之间的联系带来一定的困难.第九章什么是对应分析对应分析方法是在因子分析的基础上发展起来的,它对原始数据采用适当的标度方法.把R型和Q型分析结合起来,同时得到两方面的结果---在同一因子平面上对变量和样品一块进行分类,从而揭示所研究的样品和变量间的内在联系.对应分析由R 型因子分析的结果,可以很容易地得到Q 型因子分析的结果,这不仅克服样品量大时作Q 型因子分析所带来计算上的困难,且把R 型和Q 型因子分析统一起来,把样品点和变量点同时反映到相同的因子轴上,这就便于我们对研究的对象进行解释和推断. 第九章 对应分析的基本思想由于R 型因子分析和Q 型分析都是反映一个整体的不同侧面,因而它们之间一定存在内在的联系. 对应分析就是通过一个变换后的过渡矩阵Z 将二者有机地结合起来.具体地说,首先给出变量间的协差阵R S =Z'Z 和样品间的协差阵Q S =ZZ' ,由于Z'Z 和ZZ'有相同的非零特征根,记为12...m λλλ≥≥≥,如果R S 的特征根i λ对应的特征向量为i v ,则Q S 的特征根i λ对应的特征向量i u Zv =由此可以很方便地由R 型因子分析而得到Q 型因子分析的结果.对应分析的基本思想由A 的特征根和特征向量即可写出R 型因子分析的因子载荷阵(记为R A )和Q 型因子分析的因子载荷阵(记为Q A ).§9.1 什么是对应分析基本思想由于A和B具有相同的非零特征根,而这些特征根又正是各个公共因子的方差,因此可以用相同的因子轴同时表示变量点和样品点,即把变量点和样品点同时反映在具有相同坐标轴的因子平面上,以便对变量点和样品点一起考虑进行分类.第十章典型相关分析相关分析是研究多个变量与多个变量之间的相关关系.如研究两个随机变量之间的相关关系可用简单相关系数表示;研究一个随机变量与多个随机变量之间的相关关系可用全相关系数表示.1936年Hotelling首先将相关分析推广到研究多个随机变量与多个随机变量之间的相关关系,故而产生了典型相关分析,广义相关系数等一些有用的方法.第十章什么是典型相关分析在实际问题中,经常遇到要研究一部分变量和另一部分变量之间的相关关系,例如:在工业中,考察原料的主要质量指标(1,.....,p X X ) 与产品的主要质量指标(1,.....,p Y Y )间的相关性;在经济学中,研究主要肉类的价格与销售量之间的相关性; 在地质学中,为研究岩石形成的成因关系,考察岩石的化学成份与其周围围岩化学成份的相关性;在气象学中为分析预报24小时后天气的可靠程度,研究当天和前一天气象因子间的相关关系;第十章 什么是典型相关分析在教育学中,研究学生在高考的各科成绩与高二年级各主科成绩间的相关关系;在婚姻的研究中,考察小伙子对追求姑娘的主要指标与姑娘想往的小伙子的主要尺度之间的相关关系;在医学中,研究患某种疾病病人的各种症状程度与用科学方法检查的一些结果之间的相关关系;在体育学中,研究运动员的体力测试指标与运动能力指标之间的相关关系等.第十章 什么是典型相关分析一般地,假设有一组变量1,.....,p X X 与另一组变量1,.....,p Y Y (也可以记为1,....,p p q X X ++),我们要研究这两组变量的相关关系,如何给两组变量之间的相关性以数量的描述,这就是本章研究的典型相关分析.当p=q=1时,就是研究两个变量X 与Y 之间的相关关系.简单相关系数是最常见的度量.其定义为第十章 什么是典型相关分析当p ≥ 1 ,q=1时(或 q ≥ 1 , p =1) 设 则称为Y 与(X1,…,Xp) 的全相关系数.其实Y 对X 的回归为1(|)()()Y YX XX X E Y X x def x μμϕ-=+∑∑-且 并称R 为全相关系数 .第十章 什么是典型相关分析当p,q>1时,利用主成分分析的思想,可以把多个变量与多个变量之间的相关化为两个新变量之间的相关.也就是求α=(α1,…, αp ) '和β =(β1,…, βq ) ' , 使得新变量:V = α1X 1+…+αp X p = α 'X1~(,),0XX XY p YX YY X N Y μσ+∑∑⎛⎫⎛⎫∑∑=> ⎪ ⎪∑⎝⎭⎝⎭1/21YX XX XY YY R σ-⎛⎫∑∑∑= ⎪⎝⎭(,())Y x Rρϕ=W = β1Y 1+…+ βq Y q = β 'Y 之间有最大可能的相关,基于这个思想就产生了典型相关分析(Canonical correlatinal analysis).第十章 总体典型相关设X=(X1,...,Xp )及Y=(Y1,...,Yq)为随机向量(不妨设p ≤q),记随机向量Z 的协差阵为 其中Σ11是X 的协差阵,Σ22是Y 的协差阵,Σ12=Σ’21是X,Y 的协差阵. 第十章 总体典型相关我们用X 和Y 的线性组合V=a X 和W=b Y 之间的相关来研究X 和Y 之间的相关.我们希望找到a 和b,使ρ(V,W) 最大.由相关系数的定义:又已知⎪⎭⎫ ⎝⎛∑∑∑∑=∑22211211第十章总体典型相关故有对任给常数c1,c2,d1,d2,显然有ρ(c1V+d1, c2W+d2)=ρ(V,W)即使得相关系数最大的V=a'X和W=b'X并不唯一.故加附加约束条件 Var(V)=a'Σ11a=1,Var(W)=b'Σ22b=1.问题化为在约束条件Var(V)= 1,Var(W)=1下,求a和b,使得ρ(V,W)= a'Σ12b达最大 .第十章样本典型相关设总体Z=(X1,...,X p,Y1,…,Y q )’.在实际问题中,总体的均值E(Z)= 和协差阵D(Z)= 通常是未知的,因而无法求得总体的典型相关变量和典型相关系数.首先需要根据观测到的样本资料阵对其进行估计.已知总体Z的n个样品:第十章 样本典型相关样本资料阵为若假定Z ~N(μ,∑),则协差阵 的最大似然估 计为第十章 样本典型相关我们从协差阵 的最大似然估计S*(或样本协差阵S)出发,按上节的方法可以导出样本典型相关变量和样本典型相关系数.还可以证明样本典型相关变量和样本典型相关系数是总体典型相关变量和样本典型相关系数的极大似然估计.也可以从样本相关阵R 出发来导出样本典型相关变量和样本典型相关系数.第十章 样本典型相关典型相关系数的显著性检验:总体Z 的两组变量X=(X 1,...,X p )’和Y =(Y 1, …,Y q )’如果不相()()()()1(1,2,...,)t t t p q X Z t n Y +⨯⎛⎫== ⎪⎝⎭'()()11()()nt t t Z Z Z Z def Sn ∧=∑=--∑关,即COV(X,Y )=∑12=0,以上有关两组变量典型相关的讨论就毫无意义.故在讨论两组变量间相关关系之前,应首先对以下假设H 0作统计检验.(1) 检验H 0 : ∑12=0 (即λ1=0)设总体Z ~N p+q (μ,∑).用似然比方法可导出检验H 0的似然比统计量为(A ,A 11,A 22为离差阵)第十章 样本典型相关典型相关系数的显著性检验 (2)检验H 0(i): λi =0 (i =2,...,p )当否定H 0时,表明X,Y 相关,进而可得出至少第一个典型相关系数λ1≠ 0.相应的第一对典型相关变量V 1,W 1可能已经提取了两组变量相关关系的绝大部分信息.在实际问题中,经常迂到需要研究两组多重相关变量间的相互依赖关系,并研究用一组变量(常称为自变量或预测变量)去预测另一组变量(常称为因变量或响应变量),除了最小二乘准则下的经典多元线性回归分析(MLR),提取自变量组主成分的主成分回归分析(PCR)等方11221122||||||A S A A S S Λ==⨯⨯法外,还有近年发展起来的偏最小二乘(PLS)回归方法.第十一章什么是偏最小二乘回归偏最小二乘回归提供一种多对多线性回归建模的方法,特别当两组变量的个数很多,且都存在多重相关性,而观测数据的数量(样本量)又较少时,用偏最小二乘回归建立的模型具有传统的经典回归分析等方法所没有的优点。
初一地理图表绘制解读方法
初一地理图表绘制解读方法图标是一种很好的将初一地理数据直观、形象地“可视化”的手段。
下面是店铺为您带来的初一地理图表绘制解读方法,希望对大家有所帮助。
初一地理图表绘制解读方法:图表的类型及读法综观地理课本中的插图,大致可归纳下列几种重要的类型,现分析说明如下:(1)比较型。
这类插图是把两种属于同一范畴的地理现象加以比较,这类成对的相异地理现象,有时表面现象容易混淆不清,而它们的性质和成因是截然相反的,通过两张图的并列比较,一正一反,相得益彰。
如气旋与反气旋,冷锋与暖锋、冷锋天气与暖锋天气、亚洲的冬季风与夏季风、背斜与向斜、地垒和地堑等等。
这类插图有的本身来自对自然界直观的素描,形象生动逼真,如“地垒和地堑”通过插图解释成因,大大加强了科学效果。
对于这类比较型的一对插图要仔细对照从中找寻异同点。
比如从表面现象看,冷锋天气与暖锋天气都有降水过程,并且两图中都是暖气团在上,冷气团在下。
区别在于哪种气团“主动”,可让同学从冷气团箭头的指向,明辨冷锋和暖锋的不同含意。
(2)演变型。
这类插图反映的对象是呈动势的,有的是演变发展图,有的是运动变化图。
“地球的公转”一图是演变型插图的一例。
在观察此图时,要求同学注意下列几个问题:①地球公转的方向②地球自转的方向③地轴倾斜的方向④二分、二至的日期⑤太阳直射点的变化⑥北极圈内极昼和极夜的变化其它如大陆漂移示意图和习题中的意大利那不勒斯海岸边三根大理石柱的升降变化情况图,都是演变型的插图。
这些图类饶有兴趣,可以积极启发同学思维,引起对大自然奥秘探索的兴趣。
(3)关联型。
自然界各种地理现象,粗略一看,似乎杂乱无章,但是仔细一看,稍加分析就可发现它是有规律的,有章可循、互为关联的。
这类关联型插图很重要,它把繁杂的内容通过图表简明扼要地表述清楚。
如第三章“地球上的水”一幸中,通过阅读“水分循环示意图”,对复杂的水分循环便一目了然。
这类图在课本中占有相当的篇幅。
如第四章第二节中的地壳物质循环简略图式,对内外各种力作用的相互关系通过箭头联系起来,把物质循环规律模式和盘托出。